
本記事の執筆には Anthropic の Claude を使用しています。
はじめに
前回の記事で、MoE の 1 トークンが embedding から logits までどう計算されるかを追いかけ、プリフィルとデコードの非対称性(プリフィルは演算律速、デコードはメモリ帯域律速)を整理しました。
その中で、ds4 の routed expert を SSD からストリーミングするモードについて「速度低下が大きく、常用には向かない」と書きました。ただしあれはデコードまで含めた評価です。プリフィルに限定すると、この評価は変わります。
今回はその続編として、プリフィルに特化した重みの SSD ストリーミングを掘り下げます。ゴールは、routed expert の重みを SSD に置いたまま、プリフィルを GPU 計算律速で走らせるための条件を数字で詰めることです。具体的には次の 3 点を扱います。
- なぜプリフィルなら SSD ストリーミングが成立するのか(デコードとの構造的な違い)
- どういう実行順・パイプライン・ファイル配置にすべきか
- どのコンテキスト長から SSD 読み出しを計算の裏に完全に隠せるのか(損益分岐点)
背景として、プリフィルとデコードを別ノードに分ける disaggregated serving(Splitwise、DistServe など)の考え方があります。プリフィル専用ノードの主な成果物は KV キャッシュです(厳密には、これらの分離構成では最初の出力トークンもプリフィル側で生成し、KV キャッシュとともにデコード側へ渡します)。いずれにせよそのノードに求められるのは「重みを常駐させること」ではなく「重みを一度通してしまうこと」です。この割り切りが SSD ストリーミングと噛み合います。加えて、KV キャッシュは以降の全デコードの入力になるため、プリフィル側だけ高い精度の重みで回す非対称構成に意味がある可能性もあります(この点は要検証です)。
なお本記事の数値はすべて机上の試算例で、実測値ではありません。前提と計算式を明示しますので、SSD 帯域や GPU 性能を読者の環境の値に差し替えて再計算できるようにしています。モデルの数値(top-6、256 experts、43 層、routed expert 1 個 25.17M パラメータなど)は前回記事と同じく config.json(commit fd53f94)を出典とします。
まず確認: デコードの SSD ストリーミングはなぜ無理筋か
前回の数字で、デコード時のストリーミングが難しいことを先に確認しておきます。
デコードでは、トークンごとに router が 256 個中 6 個の expert を選ぶため、1 トークンあたり routed 重みだけで約 1.8GB(q2 ミックス時)、非 routed 込みで約 8GB の読み出しが走ります。これを全部 SSD から読むとすると、PCIe 5.0 x4 NVMe のシーケンシャルリード上限級である 14GB/s を仮定しても、
8GB ÷ 14GB/s ≈ 0.57 秒/トークン、つまり 2 t/s 弱
が理論上限です。しかも 6/256 の選択はトークンごとに変わるので、アクセスはシーケンシャルにならず、実際にはここからさらに落ちます。読んだ重みを 1 トークン分の計算にしか使えない、つまり読み出しコストが 1 トークンでしか償却できないことが本質的な敗因です。なお、後半のプリフィル試算に合わせて非 routed 約 7.1GB を常駐扱いにし、routed(q2 で 7.2MB × 6 × 43 ≈ 1.86GB/トークン)だけを SSD から読む前提に揃えると、帯域上限は 14GB/s ÷ 1.86GB ≈ 7.5 t/s まで上がります。ただしこれはシーケンシャル帯域を仮定した理想値で、実際は選択依存のランダム寄りアクセスになるためここまで届きません。いずれにせよ 1 トークンでしか償却できない構図は変わらず、素のストリーミングではデコード常用に向かない結論は同じです。
なお、これらの上限はすべての expert 読み出しが毎回 SSD まで到達する(キャッシュなし)前提の値です。実際の ds4 のストリーミングは、非 routed を常駐させたうえで、メモリ上に大きな expert キャッシュ(LRU に加え、プロファイル由来の静的ホットリストと、プレフィルで触れた expert をシードする仕組み)を持ち、ルーティング分布の偏りを拾う設計になっています。別記事で実測した範囲では、ロスレス MXFP4 版(145.3GiB)を 128GB の Mac で動かした場合、キャッシュに載るのは全 expert の約半分(5,737 / 11,008 個)にもかかわらずヒット率は 9 割前後(逆算値)に達し、ウォーム状態の生成で 18〜20 t/s が出ました。1 トークンあたりのルーテッド読みは約 3.2GB なので、全量を SSD から読むなら約 69GB/s が必要な計算であり、この差分をキャッシュが埋めていることになります。
つまりデコード側にも、モデルの大半がホスト RAM に収まり、ルーティングの時間的局所性が強いワークロードであれば、キャッシュで救える余地はあります。ただしこれはヒット率とメモリ容量に依存する話で、モデルが RAM を大きく超える場合や局所性の弱いワークロードでは冒頭の上限に近づきます。プリフィル側のストリーミングが局所性の仮定なしに成立するのとは、償却の構造が異なります(デコードは時間方向の再利用=キャッシュ、プリフィルはトークン方向の一括償却)。
| 観点 | デコード | プリフィル |
|---|---|---|
| 1 回の重み読み出しで計算するトークン数 | 1 | 数百〜数千(後述) |
| 読み出す expert | 6/256(トークンごとに変動) | 実質ほぼ全数(後述) |
| アクセスパターン | 選択依存でランダム寄り | 並べ替えでシーケンシャル化可能 |
| 読み出し総量 | 生成トークン数に比例 | モデル 1 周分で固定にできる |
なお、デコード列の「1」は単一ストリーム(バッチ 1)の場合です。複数セッションのデコードをバッチ化できれば、同じ expert 重みを複数トークンで償却できます(ds4 も 2 行以上でのバッチデコードを備えています)。本稿のデコード側の評価はバッチ 1 前提として読んでください。
この償却の違いを図にすると次の通りです。
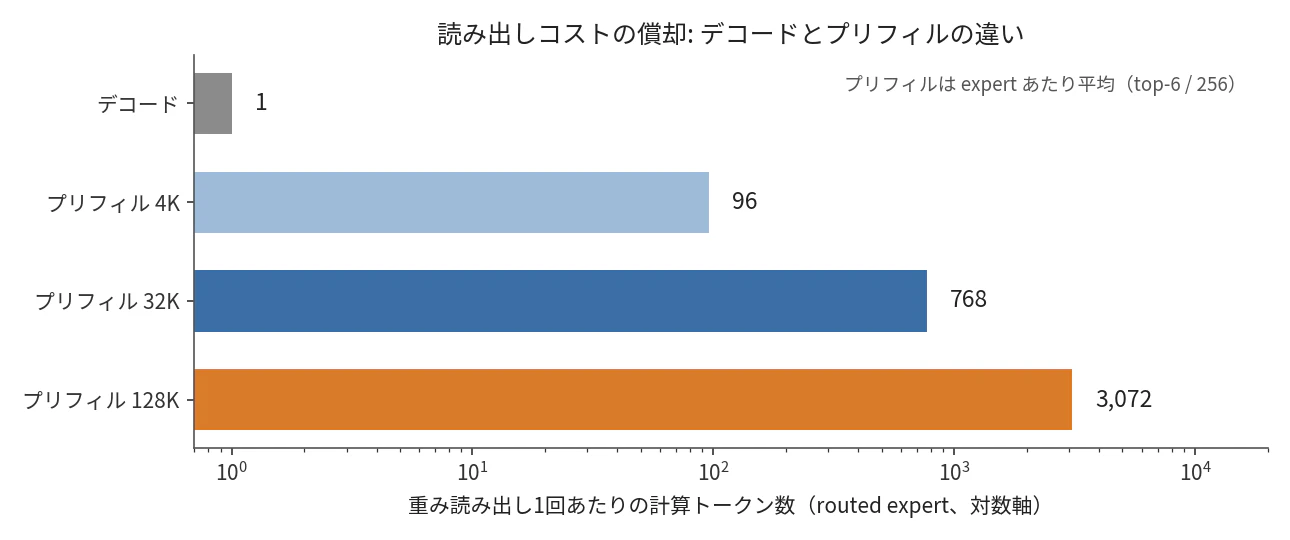
以降は、この表の右列を成立させる条件を順に詰めていきます。
プリフィルでは読み出しが償却できます
プリフィルでは N トークンを一括処理する間に、各層の重みを 1 回読めば済みます(そのためには実行順の工夫が要ります。後述します)。つまり SSD 読み出し量はコンテキスト長 N によらずモデル 1 周分で固定、routed expert などの重み行列 GEMM の計算量は N に比例します(attention には N 依存の追加項がありますが、後述の通りこちらは SSD を隠す側に働きます)。N が大きいほど、読み出し 1 バイトあたりの計算量が増えていく構図です。
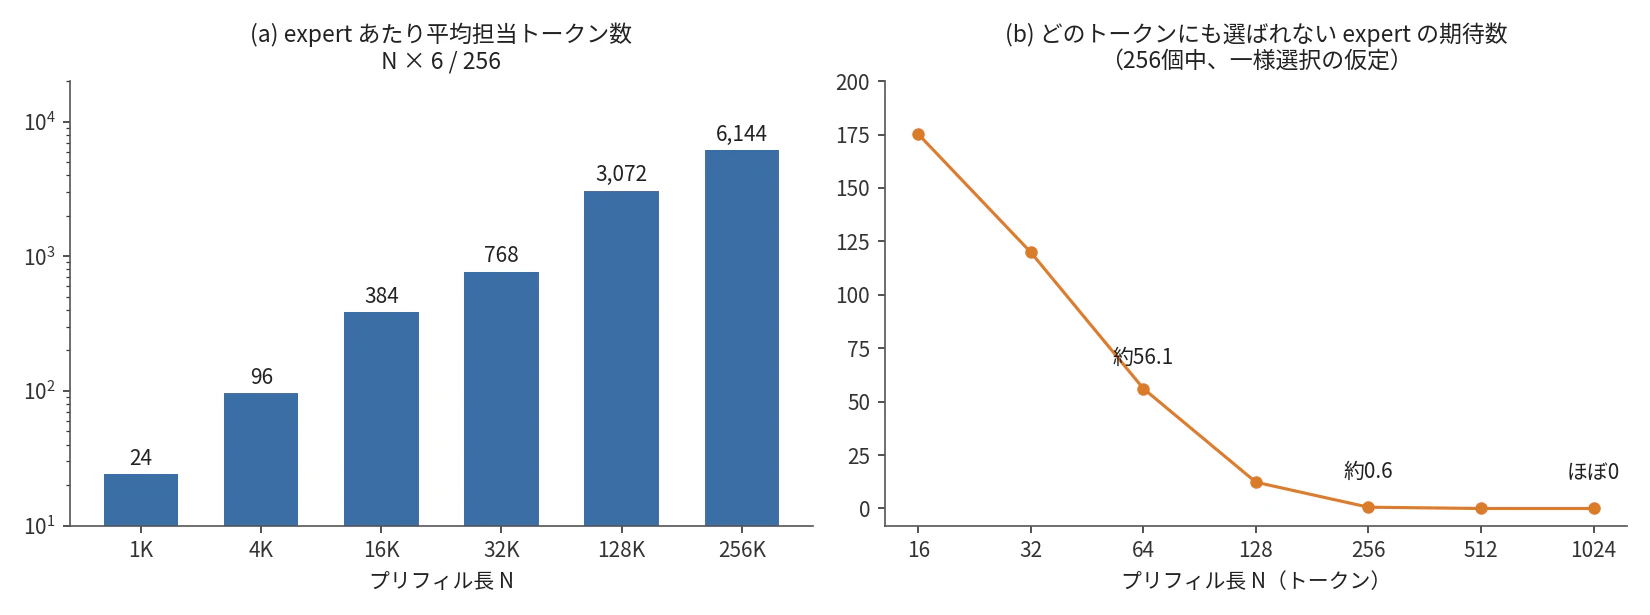
expert 単位で見ても同じことが言えます。top-6 / 256 experts なので、expert 1 個あたりの平均担当トークン数は
N × 6 / 256 ≈ N / 42.7
です。
| プリフィル長 N | expert あたり平均トークン数 |
|---|---|
| 1K | 24 |
| 4K | 96 |
| 16K | 384 |
| 32K | 768 |
| 128K | 3,072 |
| 256K | 6,144 |
1 回 SSD から読んだ expert 重みで計算できるトークン数が、コンテキスト長に比例して増えます。デコードの「1 トークンで使い捨て」と正反対で、これがプリフィルと SSD ストリーミングの相性の正体です。
Router を待つ必要もほぼありません
expert 重みは本来、router の出力が出るまでどれが必要か分かりません。しかし長いプリフィルでは、バッチ内のトークンが選ぶ expert の和集合はほぼ全 256 個に達します。選択が一様と仮定すると、ある expert が N トークンの誰からも選ばれない確率は (1 − 6/256)^N で、不使用 expert の期待数は次の通りです。
| N | 不使用となる expert の期待数(256 個中) |
|---|---|
| 64 | 約 56 |
| 256 | 約 0.6 |
| 1,024 | ほぼ 0 |
noaux_tc(auxiliary-loss-free)のロードバランスと、シーケンス内の極端な偏りを防ぐ sequence-wise balance loss(技術レポート 2.1 節)は選択を均す方向に働くので、一様仮定は方向性としては大きく外れないと考えられます。ただしこれらは極端な偏りを抑えるものであって、1 シーケンス内での独立同分布の一様選択を保証するものではありません(実分布の偏りは後述の「わかっていないこと」参照)。つまり数百トークンを超えるプリフィルでは、router の結果を待たずに、その層の全 expert を SSD 上の並び順で先読みしてしまって、無駄読みはほぼ生じません。
expert 側の事情をまとめて図にすると次の通りです。左が償却(expert あたりの担当トークン数)、右が全先読みの妥当性(不使用 expert の少なさ)です。
さらに V4 Flash 固有の事情として、最初の 3 層(層 0–2)はハッシュルーティングで、expert の割当はトークン ID から静的に決まります。この 3 層に限っては、計算を始める前からプロンプトのトークン列だけで必要 expert 集合が確定するので、router どころか attention の計算すら待つ必要がありません。
実行順が最重要です: チャンク主導ではなく層主導に
本記事でいちばん強調したい点です。SSD 読み出しを「モデル 1 周分」で済ませられるかどうかは、プリフィルの実行順で決まります。
通常の推論エンジンのチャンク化プリフィルは、チャンク単位で全 43 層を通します(チャンク主導)。重みを常駐させている前提ならこれで問題ありませんが、ストリーミングでは致命的です。チャンクごとに全層の重みを読み直すため、SSD 流量は
ceil(N / C) × W (C: チャンク長、W: ストリーミング対象の重み総量)
に膨らみます。たとえば N = 32K、C = 2K なら 16 周分です。
逆に、全 N トークンを層 L で処理し終えてから層 L+1 に進む層主導の順序にすると、重み読み出しはちょうど 1 周で済みます。
チャンク主導(通常の chunked prefill)
  chunk0: 層0 → 層1 → … → 層42   ← 全重みを読む
  chunk1: 層0 → 層1 → … → 層42   ← また全部読む
  ...                              計 ceil(N/C) 周

層主導(ストリーミング向き)
  層0:  token 0 … N-1 を一括処理   ← 層0の重みを読む(1回だけ)
  層1:  token 0 … N-1 を一括処理   ← 層1の重みを読む(1回だけ)
  ...                              計 1 周
読み出し総量を数字で比べると次の通りです。実行順だけで 1 桁半変わります。
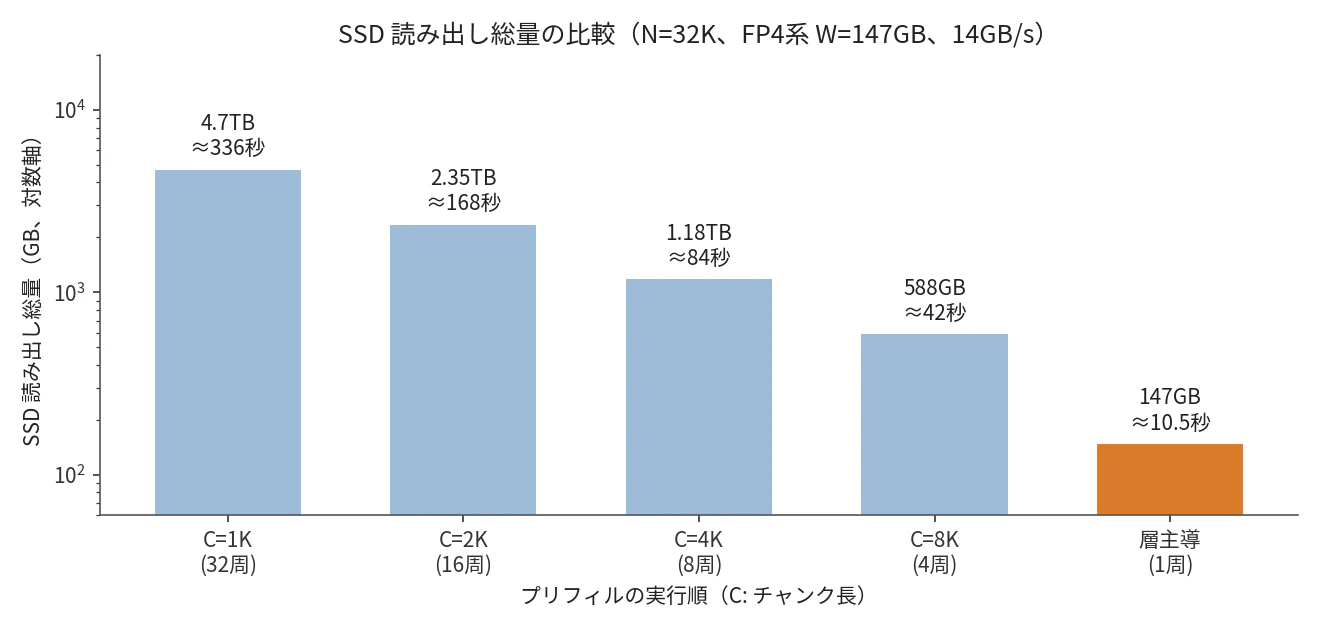
チャンク主導の主目的(活性化メモリの抑制やデコードとの混載)は、プリフィル専用ノードでは優先度が下がるので、実行順を入れ替える余地があります。
層主導の代償は、層境界の活性化を全トークン分保持することです。V4 Flash は mHC で残差ストリームが 4 本あるため、F16 なら
4,096 次元 × 4 本 × 2 byte = 32KB/トークン
で、32K トークンなら約 1.0GB、128K でも約 4.3GB です。VRAM に収まる規模と考えられます。
もう一つ、層主導には都合の良い副産物があります。プリフィル中、層 L で生成した KV は層 L の attention 計算(同じ層内で過去トークンを参照する計算)にしか使われず、層 L+1 以降のプリフィルでは参照されません。したがって層 L の処理が終わった時点で、その層の KV をホスト側へ退避できます。VRAM 上に置くのは常に 1 層分の KV だけで済み、プリフィルの成果物である KV キャッシュを層単位で外部へ書き出していく動きになります。KV を丸ごとデコード側ノードへ転送する disaggregated 構成とは、この点でも自然につながります。実際 Splitwise は、各層の KV を生成した直後に非同期転送を発行して次の層の計算と重ねる層単位の KV 転送を採用しており、ここで述べた層単位退避と同じ発想の一次事例になっています。
パイプラインの全体像
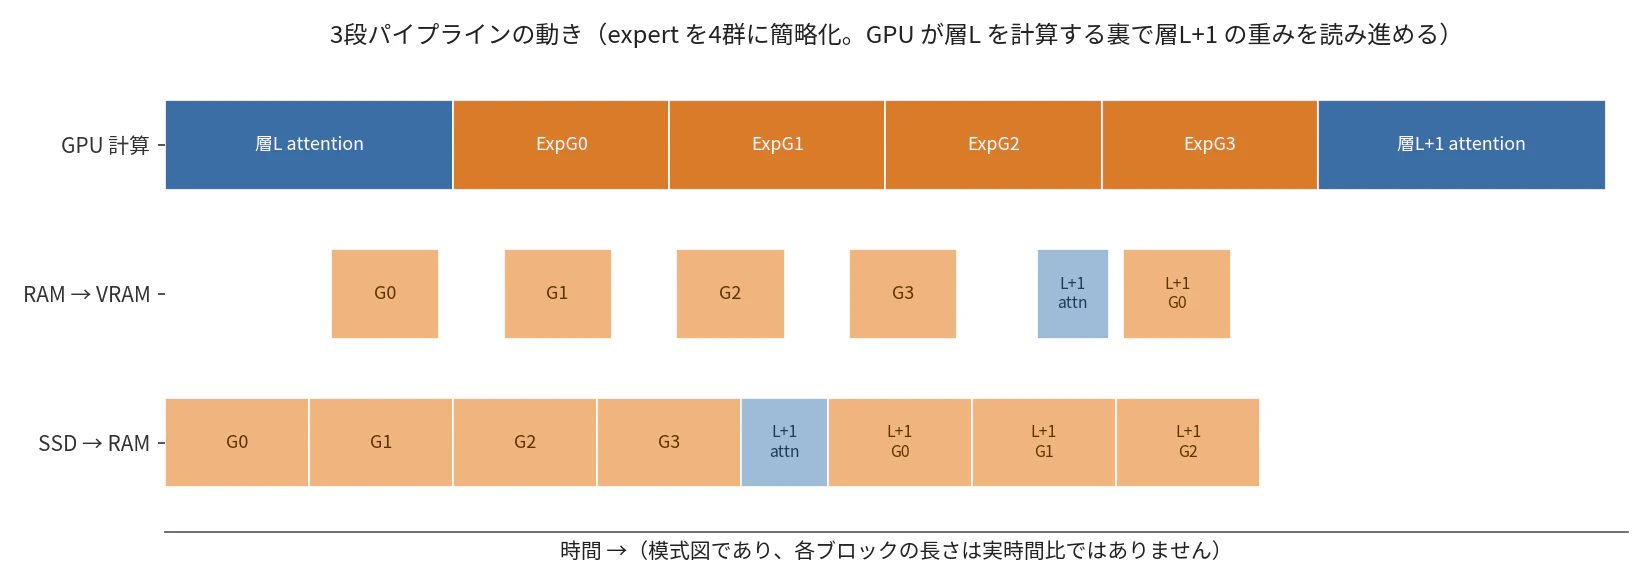
実行順が層主導に決まると、データの流れは次の 3 段になります。
NVMe SSD ──(async read)──▶ pinned RAM ──(async DMA)──▶ VRAM ──▶ GPU compute
この 3 段を完全に非同期化し、各段を別の重みで同時に走らせるのが基本形です。理想的には全体時間が
T ≈ max(T_SSD, T_PCIe, T_compute)
に近づきます。直列に待つと 3 項の和になってしまうので、この差は大きいです。なお T_PCIe は Gen5 x8 級の接続なら SSD 帯域より速く、律速になりにくいと考えられます。またホスト RAM を経由する以上、メモリコントローラには SSD からの書き込みと GPU への読み出しで、供給帯域の約 2 倍のトラフィックが乗ります。SSD 1 本の 14GB/s なら往復約 28GB/s で、デュアルチャネル DDR5 の帯域(DDR5-6000 で理論約 96GB/s)に対して余裕がありますが、SSD を増やす構成ではこの往復分を第四の段として確認する必要が出てきます(Appendix A 参照)。
転送と計算を重ねるという発想自体は DeepSeek も採用しています。技術レポート 3.1 節には、MoE の expert を小さな wave に分割し、現在の wave の計算・次の wave のトークン転送・完了済み expert の結果送信を同時に進める fine-grained なパイプライン(MegaMoE カーネル)が述べられており、本稿の「読み出しと計算のオーバーラップ」はこれと同型の考え方です。
先読みの戦略は重みの種類ごとに変えられます。
| 重み | いつ読むか | 根拠 |
|---|---|---|
| 層 L+1 の attention/共有系 | 層 L の計算中 | router に依存せず決定的に先読み可能 |
| 層 L の routed expert 群 | 層 L の attention 計算中から | 長いプリフィルではほぼ全数使うため router 待ち不要 |
| 層 0–2 の expert | プリフィル開始前 | ハッシュルーティングで静的に確定 |
| router / norm / mHC | 常駐 | ごく小さい |
タイムラインのイメージは次の通りです。
Expert ID の並べ替えでシーケンシャルリードにします
router の出力は expert ID として見るとランダムに並びますが、その順に処理する必要はありません。プリフィルの MoE 計算は、どのみちトークンを expert ごとにグループ化してから expert 単位の GEMM(grouped GEMM)にかけるのが定石です。このグループの処理順を expert ID の昇順、すなわちファイル上の並び順に固定してしまえば、SSD アクセスは層ごとに 1 本のシーケンシャルリードにできます。
SSD ──── contiguous read ───────────────────────────▶
        [Exp0][Exp1][Exp2] ……………………………… [Exp255]
GPU:     Exp0 計算 → Exp1 計算 → …(読み出しと並走)
ファイル配置もこれに合わせます。
weights.bin
  層0:  [attention/共有系][Exp0: gate|up|down][Exp1: …] … [Exp255]
  層1:  [attention/共有系][Exp0: gate|up|down] …
  ...
expert 内部でも gate/up/down を連続配置し、1 expert = 1 連続領域にします。NVMe はランダムリードも速い部類ですが、GB/s 級の重みストリーミングでは大粒度のシーケンシャルリードの方が帯域を安定して引き出しやすいためです。
読み出し方式にも触れておきます。mmap してページフォルト任せにするより、O_DIRECT + io_uring などによる明示的な大粒度リードの方がこの用途には素直と考えられます。ページキャッシュ経由だと、モデルがホスト RAM より大きい場合にキャッシュの追い出しが常時発生します。逆にモデルがホスト RAM に収まる場合は、2 周目以降が実質 RAM ストリーミングになる、という挙動の違いも設計時に意識しておく必要があります。NVMe から VRAM へ直接 DMA する GPUDirect Storage という技術もありますが、これは対応 GPU を使う場合の選択肢です。NVIDIA の公式ドキュメント(Installation and Troubleshooting Guide)は、GDS の対象を compute mode 対応の Tesla / Quadro 系 GPU(compute capability 6 以上)と明記しており、GeForce は対象に含まれていません。GeForce では cuFile の compatibility mode(CPU の bounce buffer を経由する実質 POSIX 経路)に落ちるだけです。したがってコンシューマ GPU を前提とする本稿では、GDS を前提にせず SSD → pinned ホスト RAM → VRAM を基本経路とします。なお対応 GPU であっても、ファイルシステムが GDS 非対応の場合や nvidia-fs ドライバが無い場合、バッファやオフセットが未整列の場合、GPU とストレージが NUMA ノードを跨ぐ場合などには compatibility mode へフォールバックするため、direct path の成立条件は構成依存です。
I/O 粒度: V4 Flash の expert は小さいので束ねます
expert をどの粒度で読むかを考えます。一般論としては、巨大な expert をチャンク分割して転送と計算をオーバーラップさせる話になりますが、V4 Flash では事情が逆です。expert 1 個(25.17M パラメータ)は精度別に次のサイズしかありません。
| 精度(実効 bpw の仮置き) | expert 1 個 | routed 1 層分(×256) | routed 全 43 層 |
|---|---|---|---|
| q2 ミックス(約 2.3) | 約 7.2MB | 約 1.85GB | 約 79.6GB |
| FP4 系(4.25) | 約 13.4MB | 約 3.42GB | 約 147GB |
| Q8_0(約 8.5) | 約 26.7MB | 約 6.85GB | 約 294GB |
bpw はブロックスケール等込みの実効値の仮置きで、±数%の幅があります。FP4 系の 4.25 bpw は、32 要素ブロックに 8bit スケール 1 個が付く形式を想定した値です。
13MB 級の I/O リクエストを層ごとに 256 回発行するより、複数 expert を 1 リクエスト(例えば 8〜16 expert で 100〜200MB 級)に束ねる方が、リクエスト発行やカーネル起動のオーバーヘッドを抑えられます。もっとも 13MB は NVMe にとってすでに十分大きな I/O で、束ねによる帯域の伸びは頭打ちになり得ます。NVMe の帯域はリクエストサイズとキュー深度(同時発行数)の組で決まり、大粒度リードなら浅いキューでも飽和に近づくことが知られているため、実際の束ね数は 1 / 2 / 4 / 8 / 16 expert × キュー深度を実測して決めるパラメータです。8〜16 はあくまで初期候補です。したがってダブルバッファも expert 単位ではなく expert 群単位で持つことになります。VRAM 上の配置は次の通りです(数値は後述の 128K プリフィル試算時のものです)。
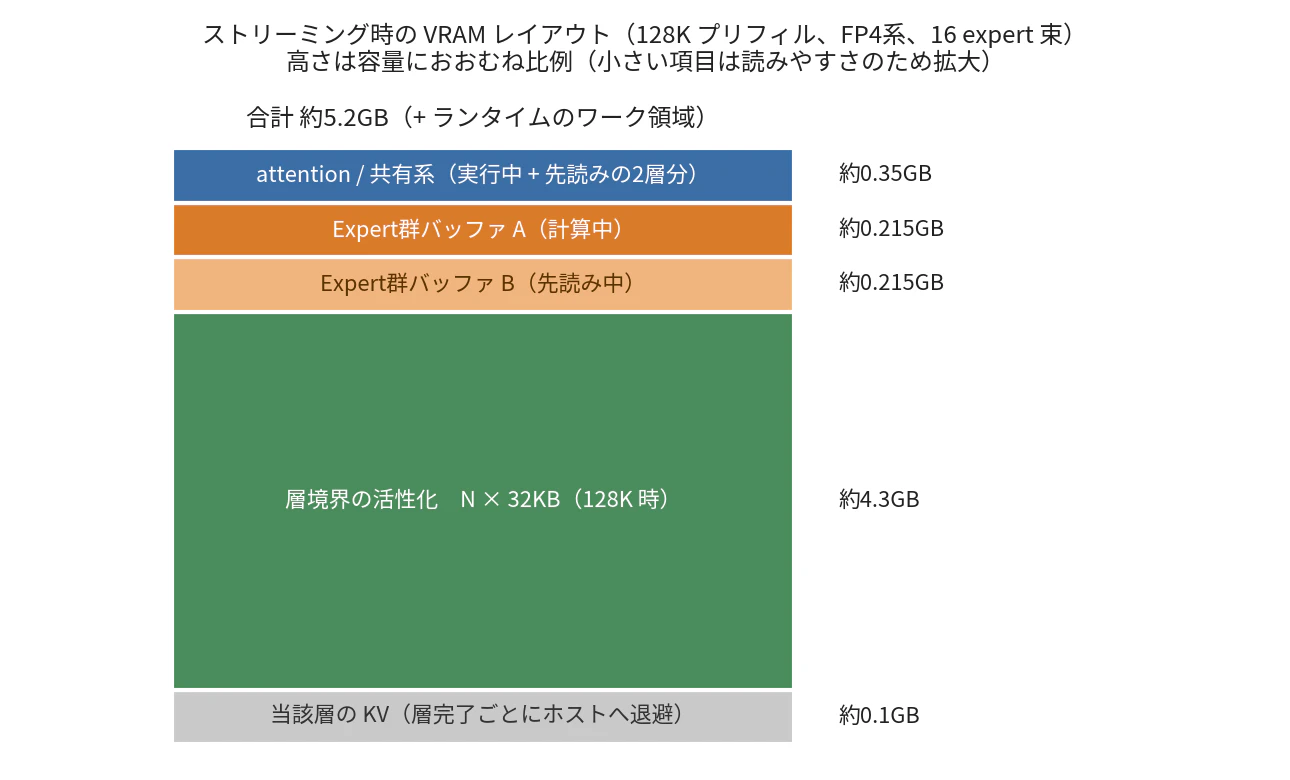
粒度の目安を計算しておきます。FP4 系・16 expert 束(214MB)の読み出し時間と計算時間を、プリフィル長別に比べると次の通りです。前提は SSD 14GB/s、GPU 実効 100 TFLOPS です。
| プリフィル長 N | expert 群(16 個)の計算時間 | 同・読み出し時間(214MB) | 判定 |
|---|---|---|---|
| 32K | 約 6.2ms | 約 15.3ms | 読み出しが露出(全体は 1 周分の読み出し時間で頭打ち) |
| 128K | 約 24.7ms | 約 15.3ms | 読み出しは計算の裏に隠蔽 |
この損益分岐を次節で一般化します。
成立条件の試算: どこから SSD 読み出しがタダになるか
数字を入れます。前提は次の通りです。
| 項目 | 仮定値 |
|---|---|
| SSD シーケンシャルリード帯域 BW | 14GB/s(PCIe 5.0 x4 NVMe の上限級) |
| GPU 実効演算性能 F | 50 / 100 / 200 TFLOPS の 3 水準 |
| ストリーミング対象の重み総量 W | q2: 79.6GB / FP4 系: 147GB(routed のみ) |
| トークンあたり計算量 | 総計算 26 GFLOPs(活性 13B × 2)、うち routed 分 13 GFLOPs |
非 routed 部(約 7.1GB)は常駐させる前提で W から除外します。ストリーミングに含めても読み出し時間は 0.5 秒程度の上乗せで、結論は変わりません。
まず固定費です。重みを 1 周読む時間は
T_SSD = W ÷ BW → q2 で約 5.7 秒、FP4 系で約 10.5 秒
で、これがどんなに短いプロンプトでも下回れないプリフィル時間の下限になります。
一方、計算時間は T_compute = 26 GFLOPs × N ÷ F で N に比例します。SSD 読み出しを計算の裏に完全に隠せる条件 T_compute ≥ T_SSD を N について解くと、損益分岐のコンテキスト長は
N^{*} = \frac{F \times W}{26\,\mathrm{GFLOPs} \times BW}
です。expert 読み出しを隠せるのが routed 部分の計算時間だけ、と保守的に見るなら分母を 13 GFLOPs に置き換えます(N* は 2 倍になります)。
| F \ W | q2 79.6GB | FP4 系 147GB |
|---|---|---|
| 50 TFLOPS | 約 11K〜22K | 約 20K〜40K |
| 100 TFLOPS | 約 22K〜44K | 約 40K〜81K |
| 200 TFLOPS | 約 44K〜87K | 約 81K〜162K |
範囲の左が楽観(attention 計算も含む総計算で隠蔽)、右が保守(routed 計算のみで隠蔽)です。この関係を図にすると次の通りです。
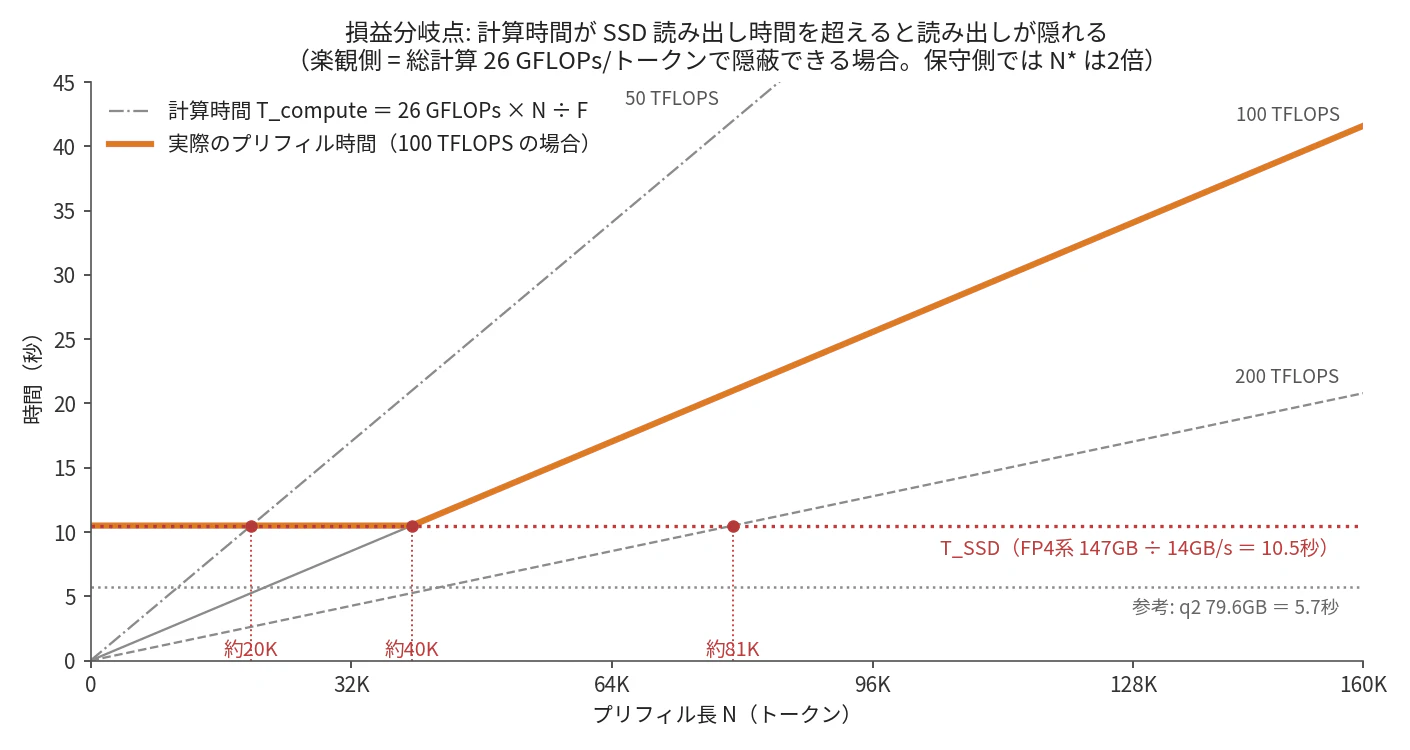
少し逆説的ですが、GPU が速いほど N* は大きくなります。計算が早く終わる分、SSD 読み出しが表に露出しやすくなるためです。SSD ストリーミングは、速すぎない GPU と長いコンテキストの組み合わせで最も自然に釣り合う方式と言えます。
N < N* の SSD 律速領域でも、スループットは N に比例して伸びます。読み出し量が固定だからです。F = 100 TFLOPS、FP4 系(W = 147GB)での見え方は次の通りです。計算時間は重み行列 GEMM の線形項(26 GFLOPs/トークン)だけで見積もっているため、計算律速側の値は上限側の机上値です(後述)。
| N | 律速 | プリフィル時間 | スループット |
|---|---|---|---|
| 8K | SSD | 10.5 秒 | 約 780 t/s |
| 16K | SSD | 10.5 秒 | 約 1,560 t/s |
| 32K | SSD | 10.5 秒 | 約 3,120 t/s |
| 64K | 計算 | 約 17 秒 | 約 3,850 t/s |
| 128K | 計算 | 約 34 秒 | 約 3,850 t/s |
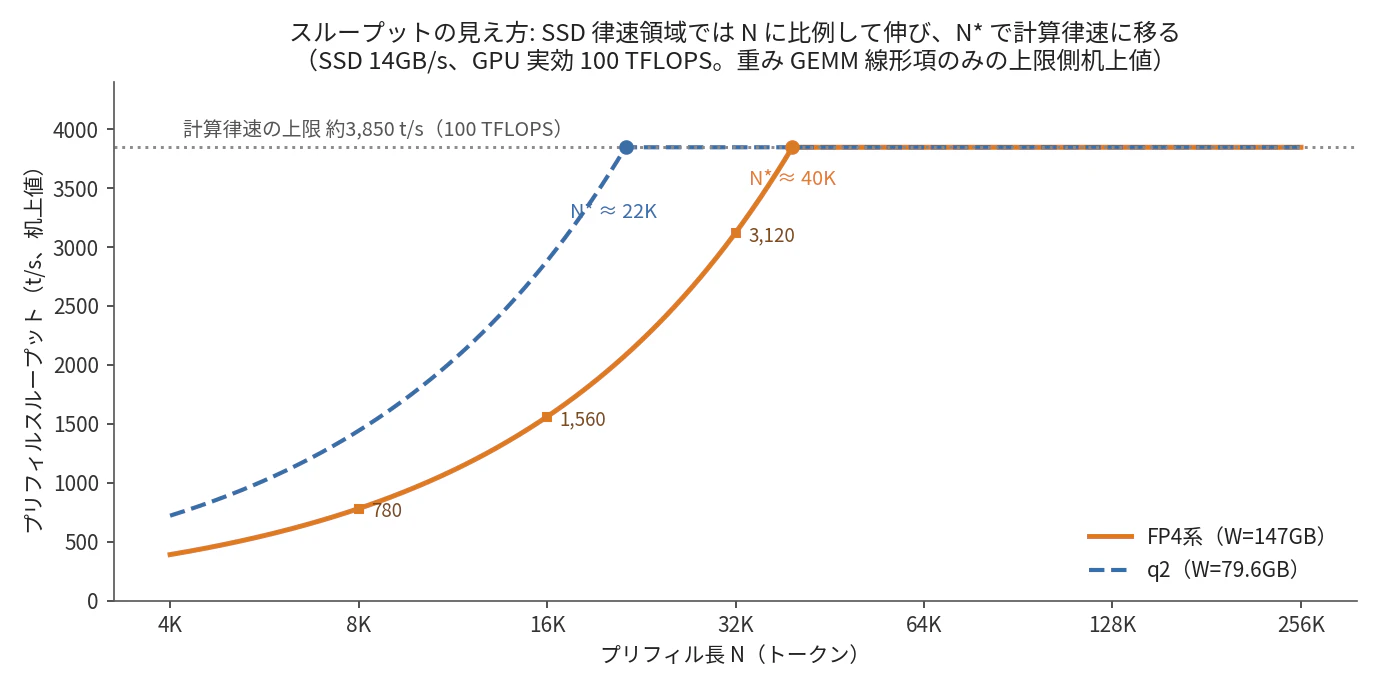
参考までに、ds4 README(commit c463029 時点)には Thunderbolt 5 接続の 2 台分散(Q4 分割ロード)で 8,192 トークンのプリフィル約 583 t/s という値があります。精度も構成も違うので直接比較はできませんが、SSD 律速の 780 t/s(机上値)という数字が荒唐無稽な水準ではないことの目安にはなると思います。
なお、コンテキスト依存の attention 計算は、1 トークンあたりで見ると N に応じて増加し、プリフィル全体では N の二次項として効いてきます。V4 Flash の CSA では、各 query トークンが先行する全圧縮ブロック(圧縮率 m=4 なので約 N/4 個)に対して Lightning Indexer のスコアを計算し(技術レポート式(16))、その上位 512 個を選ぶため(式(17))、プリフィル全体で O(N^2/4) の成分が生じます。HCA(圧縮率 128)も圧縮後 KV への dense attention なので O(N^2/128) の成分を持ちます。この二次項は二つの意味を持ちます。SSD 読み出しを計算の裏に隠せるかという損益分岐の判定に対しては、計算時間を増やす方向なので保守的(安全側)です。一方、上の表の絶対スループットに対しては、線形項だけを見ている分だけ楽観側(上限側)です。層内訳に仮定を置いた桁見積もりでは、二次項は線形項に対して N=32K で数%、64K で 1 割強、128K で 2 割強となり、計算律速の 64K・128K のスループットはこの分だけ下振れし得ます(32K は SSD 律速のため影響は小さいと考えられます)。
最後に、重みの置き場という観点で本方式の立ち位置を整理しておきます。
| 重みの置き場 | 供給帯域の目安 | FP4 系 147GB | q2 79.6GB | 備考 |
|---|---|---|---|---|
| VRAM 常駐 | 数百 GB/s〜 | 不可(コンシューマ級) | 不可(コンシューマ級) | デコードにもそのまま使える |
| ホスト RAM 常駐 + PCIe ストリーミング | Gen5 x8 で実効 25GB/s 級(理論 31.5GB/s、仕様範囲内の想定値) | 不可(128GB 機の場合) | 可 | 収まるなら SSD の上位互換 |
| SSD ストリーミング | 14GB/s 級 | 可 | 可 | 本稿の対象。長いプリフィル前提 |
q2 のようにホスト RAM に収まる規模なら、RAM 常駐 + PCIe ストリーミングが上位互換になります。SSD ストリーミングが本領を発揮するのは、FP4 系 147GB のようにホスト RAM にも収まらない精度・規模を、量子化を追加せずそのまま扱いたい場合です。
VRAM 収支: 常駐 147GB がバッファ数 GB になります
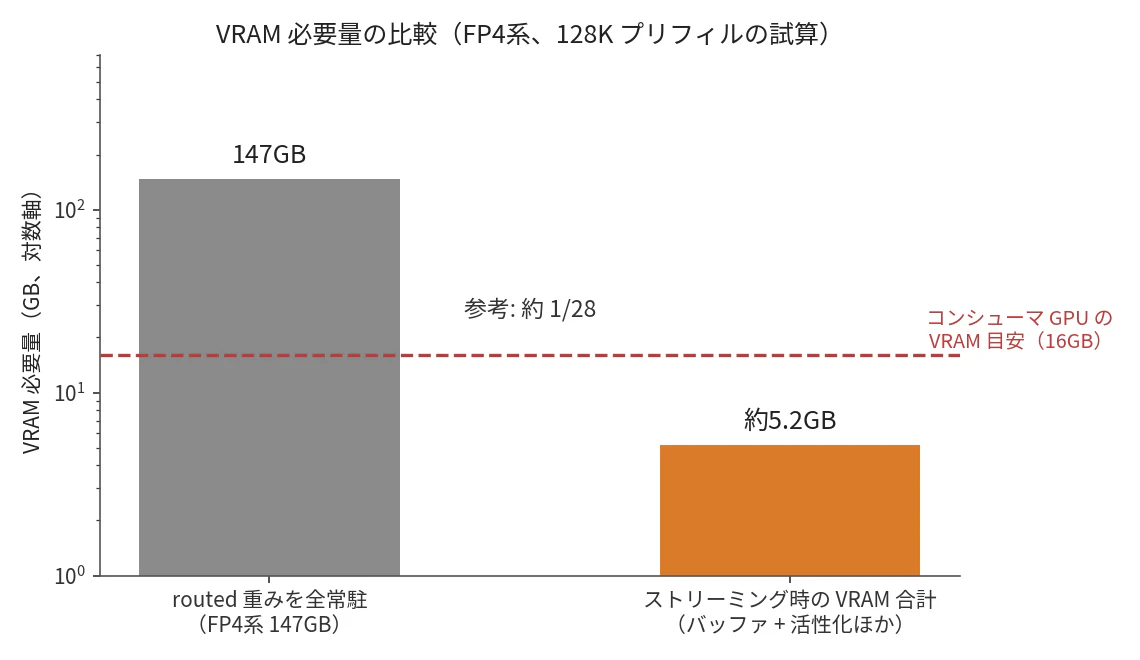
この方式の VRAM 所要を積み上げます。128K プリフィル、FP4 系、16 expert 束の想定です。
| 項目 | 目安 |
|---|---|
| attention/共有系(実行中 + 先読みの 2 層分) | 約 0.35GB |
| expert 群バッファ × 2(16 expert、FP4 系) | 約 0.43GB |
| 層境界の活性化(32KB/トークン × 128K) | 約 4.3GB |
| 当該層の KV + indexer KV(層完了ごとに退避) | 約 0.1GB + 退避バッファ |
| 合計 | 5〜6GB 台 + ランタイムのワーク領域 |
routed 重みの置き場として見ると、常駐なら 147GB(FP4 系)必要だったものが約 0.43GB の expert 群バッファに置き換わります。活性化などを含む作業 VRAM の合計でも 5〜6GB 台 + ランタイムで、ワークメモリや断片化を見込んでも 10GB 未満に収まり得る計算で、VRAM 16GB 級のコンシューマ GPU でも、284B クラスのモデルのネイティブ精度に近いプリフィルが設計上は視野に入る、というのがこの試算の含意です。もちろん机上の積み上げなので、実装次第で数字は動きます。なお非 routed 約 7.1GB を丸ごと常駐させる構成(先読み不要になる代わり VRAM を食う)も、活性化 4.3GB と合わせて 16GB にぎりぎり収まる計算です。
先行事例との位置づけ
重みや状態をメモリ階層の下位へ逃がす発想自体には先行事例があります。
- ZeRO-Infinity は学習側で NVMe オフロードを体系化しました
- FlexGen はスループット指向のオフライン推論で、大きな実効バッチに読み出しコストを償却するという本稿と同型の発想を weight/KV オフロードに適用しています
- LLM in a flash はフラッシュからの重み読み出しを前提に、読み出し粒度の最適化(row-column bundling など)を論じています
- Mixtral 系の expert オフロードや MoE-Infinity は、expert 活性の時間的局所性を使ったキャッシュと投機的先読みに新規性があり、主眼はデコード側(バッチ 1 の自己回帰生成)の最適化です。なお Mixtral オフロード論文自体は、プリフィルを層ごとに一括処理して各層の expert を一度だけロードする方式にも触れており、プリフィルを対象外にしているわけではありません
プリフィル限定・全 expert 逐次ストリーミング・層主導実行という本稿の組み合わせは、これらの延長線上にありつつ、投機や予測を捨てて「長いプリフィルなら全部使うのだから全部順番に読む」と割り切った形と位置づけられます。予測が要らない分、実装は素直になります。
わかっていないこと
- 本稿は全編机上の試算で、実測はこれからです。特に 3 段パイプラインの実効オーバーラップ率(コピーエンジンの本数、キュー深度、同期コスト)は実装しないと分かりません
- SSD の持続シーケンシャルリードは、サーマルスロットリングや SLC キャッシュの状況で公称値を下回ることがあります。14GB/s は上限側の仮定です
- expert ごとの担当トークン数には偏りがあり、小さいグループでの GEMM 効率低下があり得ます。noaux_tc 下の実分布は要実測です
- FP4 系 GEMM の実効効率(F の実効値)はカーネル実装依存で、試算の最大の不確定要素です
- N 依存 attention 項の桁見積もりは、CSA/HCA の層内訳(技術レポートには interleaved としか記載がありません)に仮定を置いています。係数には内訳仮定による幅があります
- ds4 本体のストリーミングモードが本稿のような層主導・シーケンシャル設計になっているかは未確認です。本稿は特定実装の解説ではなく、成立条件の整理です
- プリフィル側だけ精度を上げた場合の生成品質への効き(KV キャッシュ経由の影響)は未検証です
まとめ
- デコードの SSD ストリーミング(バッチ 1)は読み出しが 1 トークンでしか償却できず、全重みを読む場合で 2 t/s 弱、非 routed を常駐させ routed のみ読む場合でも 7.5 t/s 程度が帯域上限ですが、プリフィルでは読み出し量をモデル 1 周分に固定でき、コンテキストが長いほど有利になります
- 成立の鍵は実行順です。チャンク主導だとチャンク数だけ重みを読み直すため、層主導(全トークンを層単位で処理)に切り替えて 1 周で済ませます。代償は層境界の活性化保持(32KB/トークン)、副産物は KV の層単位退避で、後者は disaggregated 構成と好相性です
- router を待たない全 expert 先読み(数百トークン超で無駄読みほぼゼロ)、expert ID 昇順の並べ替えによるシーケンシャルリード、expert 群単位(100〜200MB)の多重バッファが設計の骨格です
- 14GB/s の SSD と 100 TFLOPS 級の GPU の仮定で、損益分岐は 2 万〜8 万トークン程度、それ未満でも 32K で 3,000 t/s 級(机上値)です。プリフィル時間の下限は重み 1 周の読み出し時間(q2 で約 5.7 秒、FP4 系で約 10.5 秒)です
- routed 重みの置き場は常駐 147GB が約 0.43GB の expert 群バッファに置き換わり、活性化などを含む作業 VRAM 全体でも数 GB 台に収まる計算で、ホスト RAM にも載らない規模の MoE をコンシューマ GPU でプリフィルする現実的な経路になり得ると考えられます
Appendix A: RTX 5060 Ti 16GB ×2 での試算
本文では GPU 実効性能 F をパラメータとして扱いました。ここでは具体例として、価格と消費電力的にコンシューマで組みやすい RTX 5060 Ti 16GB を 2 枚使う構成に、実測に基づく数字を当てはめます。
| 項目 | 公称値(1 枚あたり) |
|---|---|
| アーキテクチャ | Blackwell(GB206、第 5 世代 Tensor Core) |
| 演算ピーク | INT8/FP8 dense 約 190 TOPS、FP4 dense 約 379 TOPS(2:4 sparse で 759 AI TOPS) |
| VRAM | 16GB GDDR7、448GB/s(128bit) |
| ホスト接続 | PCIe 5.0 x8(カード自体が x8 ネイティブ) |
| 消費電力 | 180W |
問題は実効性能です。ピーク値からの逆算ではなく実測から見積もると、この GPU の MoE プリフィル実効はピークよりはるかに低くなります。実効 TFLOPS ≈ プリフィル t/s × 2 × 活性パラメータ数という逆算(attention 項などを含む近似で ±2 割程度の幅があります)で、次の 3 水準が置けます。
| 水準 | 実効の目安(1 枚) | 根拠 |
|---|---|---|
| 保守 | 約 30 TFLOPS | 同カードの llama.cpp 実測。gpt-oss-20b(MXFP4 MoE、活性約 3.6B)の pp2048 = 3,839 t/s → 約 27.6 TFLOPS。Qwen3 14B Q4_K の 942.6 t/s(約 26 TFLOPS)とも整合 |
| 中位 | 約 55 TFLOPS | 同カードの dense 7B(Q4_0)実測 pp512 = 4,196 t/s → 約 56.5 TFLOPS。MoE の grouped GEMM が dense 並みの効率に達した場合 |
| 楽観 | 約 110 TFLOPS | cutlass の NVFP4 blockscaled GEMM が大型 dense でピークの約 6 割(B200 で 58%、SM12x チュートリアルで約 60%)という報告を、MoE の小バッチ向けに割り引いた上限 |
ピーク比 26% にあたる 100 TFLOPS/枚のような値は楽観水準の下端に相当し、一般的な実装で日常的に出る値ではありません。2026 年 8 月時点では SM120(コンシューマ Blackwell)向けの FP4 grouped GEMM スタックは未成熟で、cutlass や FlashInfer には SM120 の NVFP4 MoE grouped GEMM の不具合報告が残っており、再現可能な実測は保守水準だけです。以下では保守 30 TFLOPS/枚を基準にします。なお保守水準の根拠である gpt-oss-20b は活性 3.6B と小さく、活性 13B の V4 Flash では GEMM 形状が大きくなるぶん効率がやや上がる(中位側に寄る)可能性はあります。
一点補足します。GeForce 系では Tensor Core の FP32 累算が per-tensor の FP16/FP8 経路で半レートに制限されます(RTX 5060 Ti 実機のマイクロベンチで FP16 は 103 → 51、plain FP8 は 206 → 102 TFLOP/s)。しかし MXFP4 や NVFP4 のようなブロックスケール経路はこの制限を受けず full-rate です(MXFP8 ブロックスケールは FP32 累算でも約 202 TFLOP/s)。つまり FP4 dense ピーク 379 TOPS が半減するわけではなく、実効が低い主因は累算制限ではなく、小バッチ grouped GEMM のカーネル効率(ピークの 1 割前後)と 128bit のメモリ帯域です。
接続と容量の観点は好都合です。このカードはもともと PCIe 5.0 x8 接続なので、CPU 直結の x16 を x8/x8 に分岐して 2 枚挿しても接続幅の損失がありません。ホスト→GPU は実効 25GB/s 級 × 2 系統となり、SSD 帯域 14GB/s より十分速いため T_PCIe が律速しにくい構図も本文の通りです。VRAM は本文試算のバッファ約 5.2GB に対して 1 枚 16GB と余裕があり、非 routed 約 7.1GB を各 GPU に常駐させる構成も収まります。
2 枚の分担は、各層の 256 expert を 128 ずつ受け持つ expert 分割が素直です。各 GPU は自分の担当分だけを SSD から読むので、読み出し総量はモデル 1 周分のまま変わりません。attention/共有系は両 GPU に複製するのが簡単です(計算は重複しますが routed に比べれば小さい規模です)。代わりに、router 後のトークン振り分け(dispatch)と結果の集約(combine)がホスト RAM 経由の PCIe 転送として発生し、これがこの構成で新たに加わるコストになります(転送量と隠蔽可否は要実測です)。層を前半と後半で分ける層分割も可能ですが、単一バッチの層主導実行では 2 枚が直列になり、マイクロバッチ化すると重みの再読が発生する点に注意が必要です。
帯域収支は実効値でこう変わります。計算律速の上限と損益分岐 N*(楽観基準)は次の通りです。
| 実効/枚 | 上限 t/s(1 枚 / 2 枚) | N*: 1 GPU + SSD ×1 | N*: 2 GPU + SSD ×1 | N*: 2 GPU + SSD ×2 |
|---|---|---|---|---|
| 保守 30 | 約 1,150 / 2,300 | 約 12K | 約 24K | 約 12K |
| 中位 55 | 約 2,100 / 4,230 | 約 22K | 約 44K | 約 22K |
| 楽観 110 | 約 4,230 / 8,460 | 約 44K | 約 89K | 約 44K |
(2 枚の値は expert 分割の dispatch/combine 通信と expert 間の負荷偏りを無視した理想上限です。DeepSeek 自身も expert 並列では dispatch/combine が通信段になるとしており、通信を計算に隠せるかは計算量と通信量の比で決まります)
N* は「これより長いプリフィルなら SSD 読み出しを計算の裏に完全に隠せる」という下限で、同じ計算能力どうしで比べるなら小さいほど扱いやすい値です。N* = F × W ÷ (26 GFLOPs × BW) より、GPU を 2 枚にすると(F が 2 倍)N* は 2 倍に伸び、SSD を 2 本にすると(BW が 2 倍)読み出し時間が半分になるぶん N* は半分に戻ります。1 GPU + SSD ×1 と 2 GPU + SSD ×2 の列が同じ値なのは、F と BW の比が同じだからです。ただし N* の列を構成間の優劣として横に読むのは誤りです。実際のプリフィル時間は max(T_SSD, T_compute) で決まるため、2 GPU が 1 GPU より遅くなる N は存在しません(保守実効なら N ≤ 12K で両者 10.5 秒の同着、それ以上では 2 GPU が速くなります)。1 GPU の N* が小さいのは、計算が遅いぶん SSD が相対的に隠れやすいという裏返しで、本文の「速すぎない GPU ほどストリーミングと釣り合う」の GPU 枚数版です。実効が下がると N* も比例して下がるので、SSD 読み出しを隠すこと自体はむしろ容易になります。保守実効なら、2 枚構成でも 24K を超えるプリフィルで SSD 1 本(14GB/s)は完全に計算の裏に隠れます。本文の逆説(速すぎない GPU ほどストリーミングと釣り合う)が、実測側からそのまま裏付けられた形です。代わりに絶対スループットは実効性能に律速されます。保守 30 TFLOPS/枚での 3 構成は次の通りです。
| N | 1 GPU + SSD ×1 | 2 GPU + SSD ×1 | 2 GPU + SSD ×2(28GB/s) |
|---|---|---|---|
| 32K | 28.4 秒 / 約 1,150 t/s | 14.2 秒 / 約 2,300 t/s | 14.2 秒 / 約 2,300 t/s |
| 64K | 56.8 秒 / 約 1,150 t/s | 28.4 秒 / 約 2,300 t/s | 28.4 秒 / 約 2,300 t/s |
| 128K | 113.6 秒 / 約 1,150 t/s | 56.8 秒 / 約 2,300 t/s | 56.8 秒 / 約 2,300 t/s |
(FP4 系 147GB、保守実効、GEMM 線形項のみの上限側机上値。N 依存の attention 項の分だけ実際はさらに下振れし、2 GPU 列は通信と負荷偏りを無視した理想上限です。楽観実効 110 なら計算律速の値はこの約 3.7 倍になります)
保守実効ではすべて計算律速なので、2 枚目の GPU は 12K 超のプリフィルで素直に効き、SSD の 2 本化はほとんど効きません。「32K 級は SSD を増やす方が効く」と言えるのは、実効 100 TFLOPS 級を出せるチューンドカーネルが前提の場合です。なお 5060 Ti は本文で触れた通り GPUDirect Storage の対象外なので、経路は常に SSD → pinned ホスト RAM → VRAM です。SSD を 2 本にして 28GB/s を供給する場合、ホスト RAM には書き込み 28GB/s + 読み出し 28GB/s ≈ 56GB/s のトラフィックが乗り、さらに expert 分割の dispatch/combine もホスト RAM 経由で加わります。デュアルチャネル DDR5(DDR5-6000 で理論約 96GB/s、実効はその 6〜7 割程度)では無視できない割合になるため、SSD ×2 構成では DDR5 帯域を第四のパイプライン段として確認する必要があります。どちらを増やすべきかは実効 F 次第で、SM120 向けカーネルが成熟して中位〜楽観水準に近づくほど、律速は SSD 側へ戻っていきます。本文の F = 50 / 100 / 200 の 3 水準との対応は、保守 2 枚 ≈ F = 60(F = 50 の行が最も近い)、中位 2 枚 ≈ F = 110(F = 100 の行)、楽観 2 枚 ≈ F = 220(F = 200 の行)です。
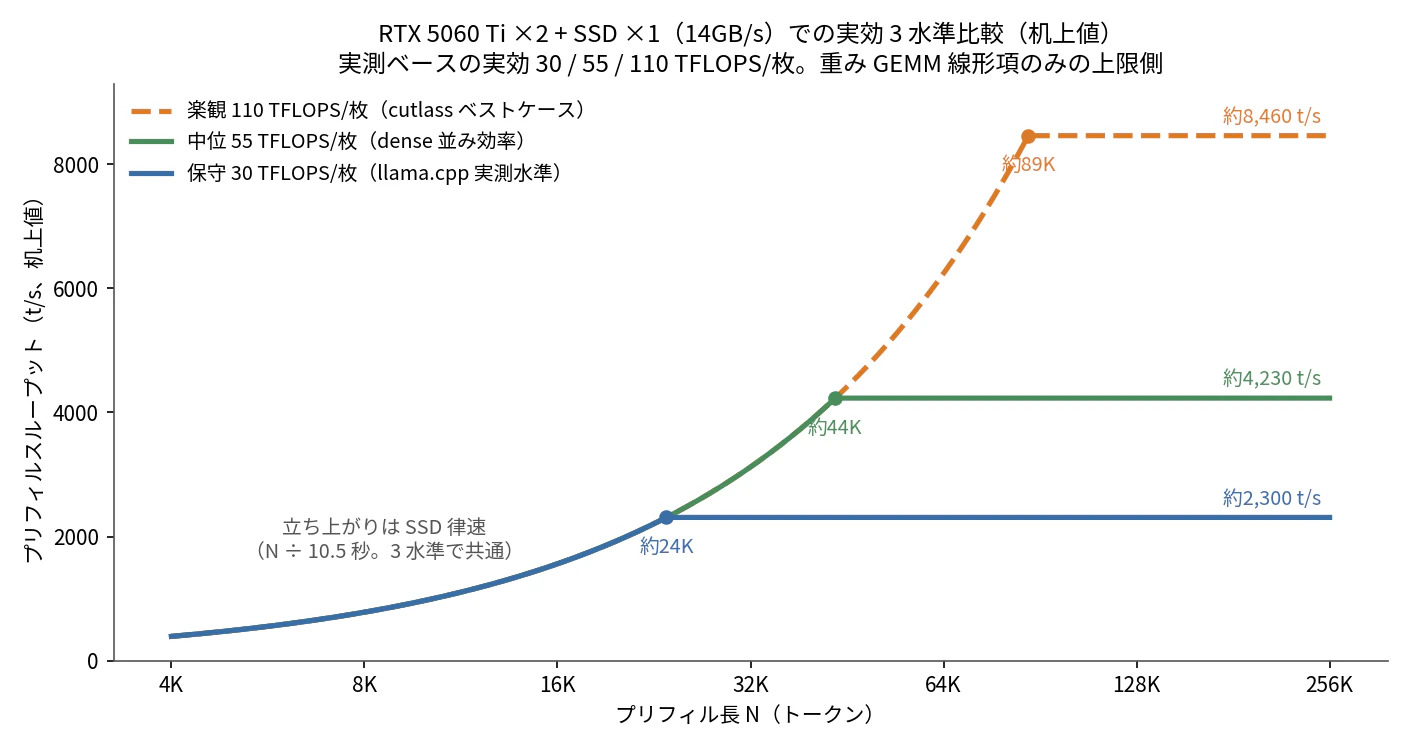
図は 2 枚 + SSD 1 本の構成で実効 3 水準を重ねたものです。立ち上がりの SSD 律速線(N ÷ 10.5 秒)はどの水準でも共通で、実効が高いほど飽和点(= N*)が右へ動きます。まとめると、RTX 5060 Ti ×2 では、現時点で再現可能な実装水準だと 128K プリフィルが約 1 分(2 枚、約 2,300 t/s)〜約 2 分(1 枚、約 1,150 t/s)、SM120 向け FP4 カーネルの成熟次第で約 15〜31 秒(約 8,460〜4,230 t/s)まで縮む余地がある、というのが実測を踏まえた見立てです。
参考資料
- 前回記事: MoEは1トークンをこう計算しています(https://qiita.com/sukimaengineer/items/cd76fec76d49a098abed)
- DeepSeek-AI, DeepSeek-V4 Technical Report, arXiv:2606.19348(2026 年 6 月)
- deepseek-ai/DeepSeek-V4-Flash, Hugging Face, config.json(commit fd53f94、2026 年 7 月時点)
- antirez, DS4 — DwarfStar 4 README(github.com/antirez/ds4、commit c463029、2026 年 7 月時点。KV 容量・分散プリフィル・SSD ストリーミングの各数値はこの README を一次情報とします)
- Patel et al., Splitwise: Efficient Generative LLM Inference Using Phase Splitting, arXiv:2311.18677(2023 年 11 月)
- Zhong et al., DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving, arXiv:2401.09670(2024 年 1 月)
- Rajbhandari et al., ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning, arXiv:2104.07857(2021 年 4 月)
- Sheng et al., FlexGen: High-Throughput Generative Inference of Large Language Models with a Single GPU, arXiv:2303.06865(2023 年 3 月)
- Alizadeh et al., LLM in a flash: Efficient Large Language Model Inference with Limited Memory, arXiv:2312.11514(2023 年 12 月)
- Eliseev and Mazur, Fast Inference of Mixture-of-Experts Language Models with Offloading, arXiv:2312.17238(2023 年 12 月)
- Xue et al., MoE-Infinity: Offloading-Efficient MoE Model Serving, arXiv:2401.14361(2024 年 1 月、v1 時点の題名。改版で題名変更あり)
- NVIDIA, GPUDirect Storage documentation(Overview Guide および Installation and Troubleshooting Guide。対応 GPU が compute mode の Tesla / Quadro 系に限られる旨は後者の CU_FILE_DEVICE_NOT_SUPPORTED 節)
- NVIDIA, GeForce RTX 5060 Ti 製品仕様(PCIe 5.0 x8、16GB GDDR7 448GB/s、第 5 世代 Tensor Core。TOPS 値は Blackwell アーキテクチャ whitepaper 由来の公開データベース値)
- ggml-org/llama.cpp, GitHub Discussions #15396(gpt-oss ベンチマーク集計)および #15013(CUDA 性能集計。RTX 5060 Ti の実測 pp 値の出典)
- flashinfer-ai/flashinfer, Issue #3628(SM120 実機の Tensor Core 命令別マイクロベンチ。FP32 累算とブロックスケール経路のレート比較)
- Colfax Research, CUTLASS Tutorial: NVFP4 Blockscaled GEMM on NVIDIA RTX Pro Blackwell GPUs (SM12x)
- NVIDIA/cutlass, Issue #3096 ほか(SM120 の NVFP4 MoE grouped GEMM 不具合報告)