
はじめに
前回、RTX PRO 6000 Blackwell を借りてQLoRAを回す構成を、AWS / GCP / Azure のリージョン単価まで比較して机上検討しました。
96GB×4で月100時間なら5〜6万円、1枚で70B級、4枚で235B〜355B級までは狙える。機材と予算の目処は、ひとまず立ちました。
では次は学習データを用意する番、というところで手が止まりました。
QLoRAで何を学習させられて、何は学習させても意味がないのか。そもそも事前学習とSFTでは何が違うのか。「学習データ」と一言で呼んでいるものの中身が、自分が理解できていないことに気づいたからです。
コーパスを作り始めてから方向を間違えていたと気づくのが、いちばん高くつきます。GPUを借りる前に一度整理しておくことにしました。この記事はその作業メモです。
「学習データ」と聞いて最初に思い浮かべるのは、たぶん次のようなものだと思います。
{
  "question": "always_ffとalways_combの違いは?",
  "answer": "always_ffは順序回路用、always_combは組み合わせ回路用です。"
}
これは間違いではありません。ただし、これはLLMの学習全体のうち、ごく一部の段階でしか使われない形式です。
LLMの学習は段階に分かれていて、段階ごとにデータの形式も、量も、狙いも違います。同じ「学習データ」という言葉で、まったく別のものを指しています。
調べてみると、自分が持っていた理解には明確な間違いもありました。この記事では、次の点を整理します。
- 学習の段階は5つに分けられること
- 事前学習の「次トークン予測」が、よく説明される図とは違う仕組みで動いていること
- SFTで実は一番大事なのが、データ形式ではなく損失をどこにかけるかであること
- GitHubのIssueを学習データに変換する具体的な手順
- SystemVerilog / Verilog というlow-resource言語で、研究者が何をやっているか
- 仕様書はRAGに渡すべきで、学習させるべきではない理由
RTL設計・検証の文脈を中心に書きますが、前半は言語を問わず共通の話です。
用語が多いので、先に一覧を置いておきます。
| 略語 | 正式名称 | ざっくり何か |
|---|---|---|
| SFT | Supervised Fine-Tuning | 指示と応答のペアで教師あり学習する段階 |
| CoT | Chain-of-Thought | 思考過程を明示的に書かせる/書かせたデータ |
| RLHF | Reinforcement Learning from Human Feedback | 人間の選好を報酬にした強化学習 |
| DPO | Direct Preference Optimization | 報酬モデルとRLループを省いた選好学習 |
| GRPO | Group Relative Policy Optimization | グループ内の相対比較で学習し、価値モデルを不要にした手法 |
| RLVR | RL with Verifiable Rewards | 自動検証できる結果を報酬にする強化学習 |
| LoRA / QLoRA | Low-Rank Adaptation | 少数の追加パラメータだけを学習する手法。Qは4bit量子化つき |
| DAPT | Domain-Adaptive Pre-Training | 既存モデルにドメインの事前学習を継ぎ足すこと |
| RAG | Retrieval-Augmented Generation | 検索した文書をコンテキストに入れて答えさせる方式 |
先に結論
調べる前に持っていた理解と、実際の対応関係を先に置いておきます。左の列には、正直なところ自分が思い込んでいたものも含まれます。
| 調べる前の理解 | 実際 |
|---|---|
| 学習データ = 質問と回答のペア | それはSFT段階だけの形式。全体の1割にも満たない |
| 事前学習は「文章を丸暗記」している | 全位置で同時に次トークンを予測している。暗記ではなく条件付き確率の推定 |
| 1文から1つの学習サンプルができる | 1文からトークン数ぶんの予測が並列に取れる |
| データは多いほどいい | 多様性がなければ増えても効かない。同じ内容の言い換え増幅は効果が薄い |
| 仕様書を覚えさせれば仕様に強くなる | 新規知識の注入はRAGのほうが大差で強い。学習は振る舞いを教えるもの |
| 高品質データは大量に要る | 振る舞いの獲得なら1000件規模でも成立する(ただし知識の底上げは別) |
段階ごとの整理は次のとおりです。
| 段階 | データ形式 | 規模の目安 | 学習の狙い |
|---|---|---|---|
| 事前学習 | 生テキスト・生コード | 10兆トークン超 | 知識と言語能力の土台 |
| SFT(Instruction Tuning) | 指示と応答 | 数百〜数十万件 | 指示に従う、回答スタイル |
| 推論データ | 問題+思考過程+答え | 数千〜数十万件 | 多段の推論 |
| 選好データ | prompt+良い応答/悪い応答 | 数千〜数十万ペア | 人間や検証器の好みへの整合 |
| エージェントデータ | 多ターンの操作履歴 | 数千〜数万軌跡 | ツールを使う手順 |
図にすると、量の差がはっきりします。
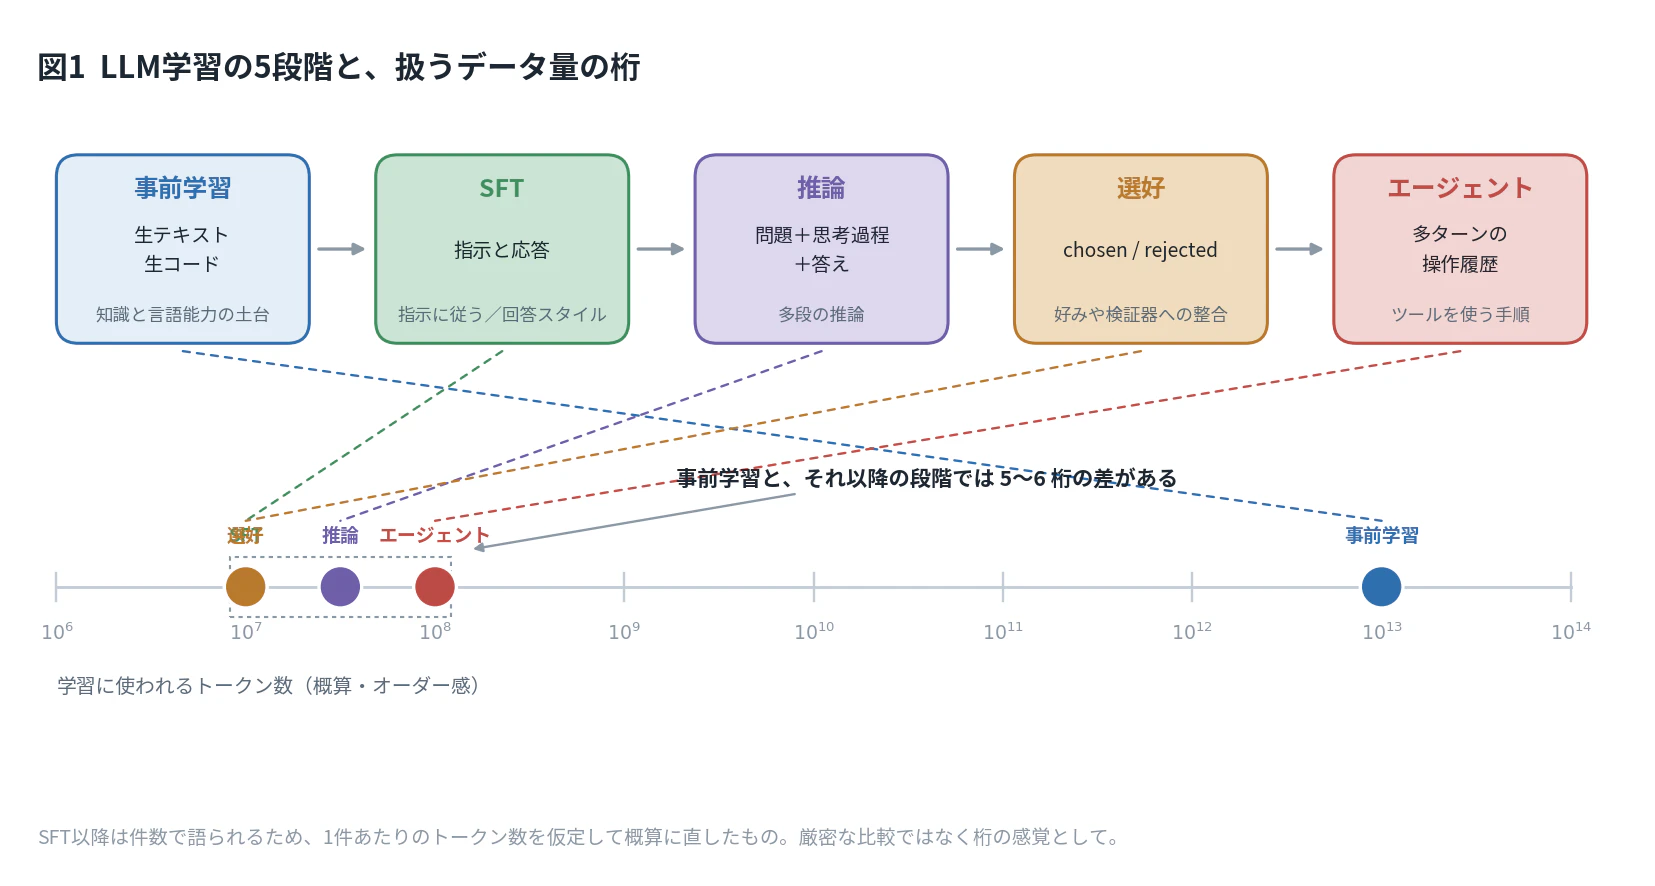
事前学習とそれ以降で、5〜6桁の差があります。個人がローカルで手を出せるのは、この図の右側だけです。
以下、順に見ていきます。
1. 事前学習データ
何を入力するか
Webページ、Wikipedia、書籍、論文、ニュース、技術文書、GitHubのソースコード、Q&Aサイト、数式、多言語文章。要するに、テキストとして手に入るものはだいたい入ります。
コードであれば、次のようなファイルがそのまま学習対象になります。
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n)
        count <= '0;
    else
        count <= count + 1'b1;
end
LLMはここから、always_ffの使い方、リセット記述、ノンブロッキング代入、カウンタ回路の典型パターンを、統計的に学習します。
「次トークン予測」の説明でよく省かれること
事前学習の解説では、次のような図がよく使われます。
入力: SystemVerilogのalways_ffは、フリップフロップなどの
正解: 順序
入力: SystemVerilogのalways_ffは、フリップフロップなどの順序回路を
正解: 記述
直感的には分かりやすいのですが、この図は実装を誤解させます。1文を何度も入力しなおして、1問ずつ解かせているように見えるからです。
実際は違います。長さNの系列を1回forwardするだけで、N個の予測が同時に得られます。
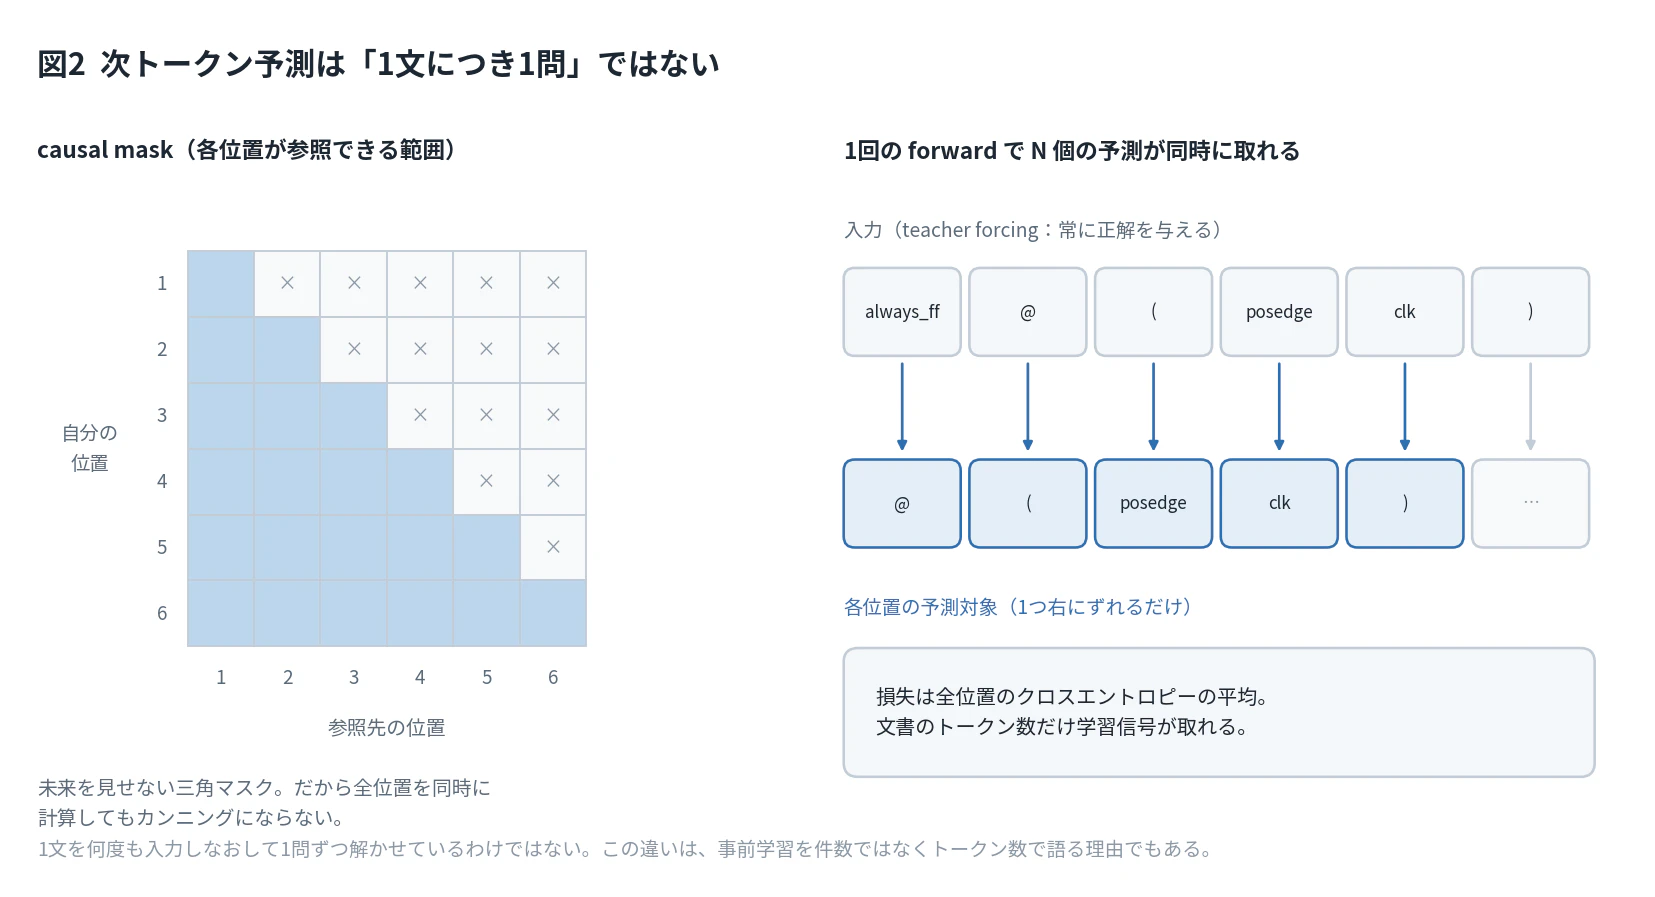
仕組みは2つです。
teacher forcing。予測時に、モデル自身の出力ではなく正解トークンを次の入力に与えます。これにより、途中で外しても後続の学習が壊れません。
causal masking。アテンションに三角行列のマスクをかけて、各位置から未来のトークンを見えなくします。位置tは1からtまでしか参照できないので、全位置を並列に計算してもカンニングになりません。
RTLの人向けの比喩で言うと、パイプラインの各ステージを1サイクルずつ順に流すのではなく、組み合わせ回路として全ステージぶんを一度に展開している、というイメージが近いです。マスクは、後段の信号が前段に回り込まないようにするための構造そのものです。
この違いは、実務でも効いてきます。1文書あたりの学習サンプル数はトークン数に比例するので、「何件のデータが必要か」という問いは事前学習では意味を持ちません。トークン数で語るのはこのためです。
なお、短い文書はcontext長まで連結して詰めます(packing)。パディングでGPUを遊ばせないためですが、文書境界をまたいでアテンションが効かないようにマスクを分ける必要があります。ここを雑にやると、無関係な文書の続きを予測させることになります。
損失の指数を取るとperplexityになります。感覚的には「次のトークンの候補が実質何通りに絞れているか」です。
実際に使われているコーパス
公開されているものだと、次のあたりが代表格です。
| コーパス | 規模 | 特徴 |
|---|---|---|
| FineWeb | 15兆トークン(論文時点。その後のバージョンで増えています) | CommonCrawl由来、96 dumpからキュレート、ODC-BY |
| FineWeb-Edu | 1.3兆トークン | 教育的価値の分類器でスコア3以上を残し、元の92%を除去 |
| The Stack v1 | 6.4TB / 358言語 | opt-out機構あり |
| The Stack v2 | 67.5TB / 600言語超、約9000億ユニークトークン | Software Heritage上に構築、StarCoder2の学習に使用 |
FineWeb-Eduのつくり方が面白いです。
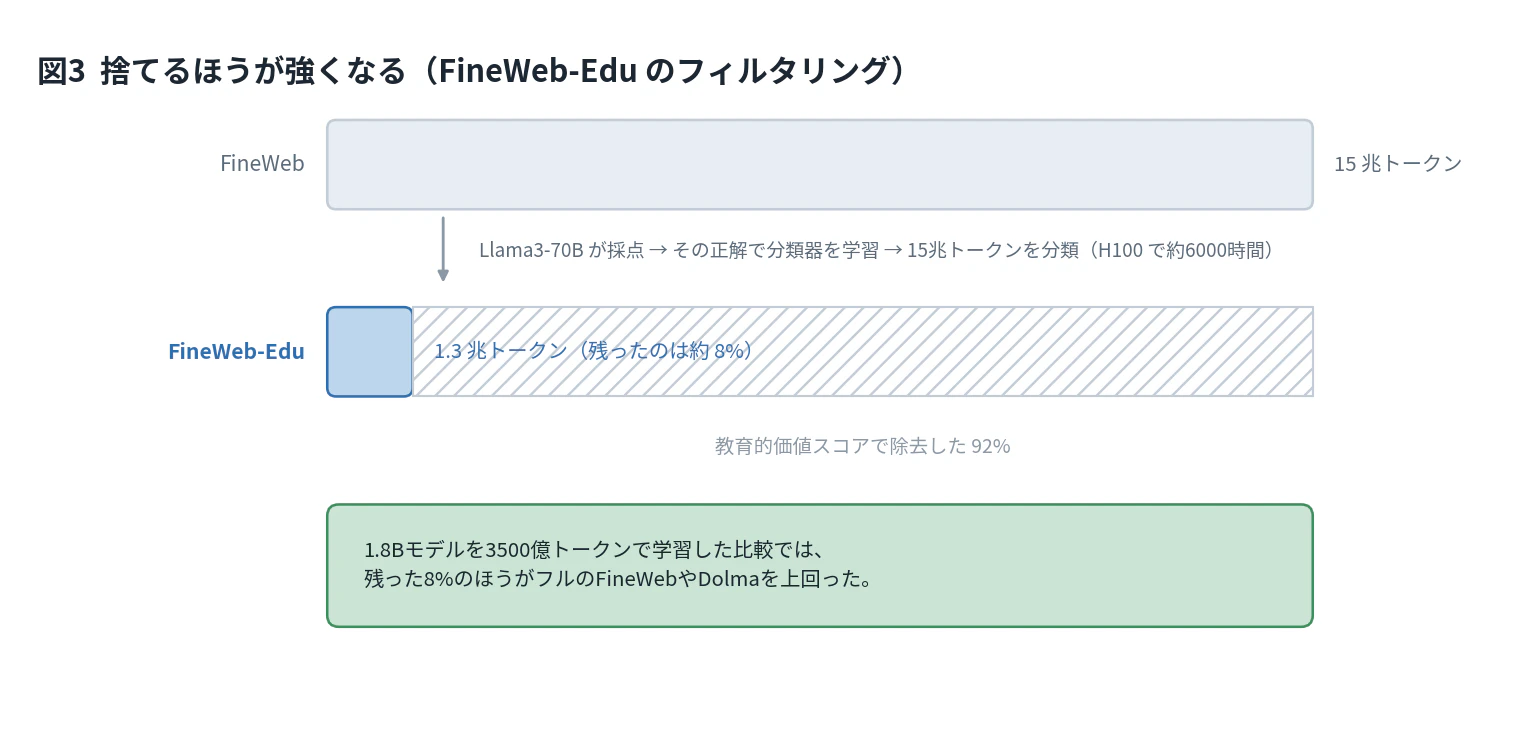
Llama3-70B-Instructに46万サンプルの教育的価値を0〜5点で採点させ、そのラベルで分類器を学習し、15兆トークン全体を分類しています。分類器は埋め込みモデル(Snowflake-arctic-embed-M)に線形回帰ヘッドを載せたものです。この分類だけでH100を6000時間ほど使っています。
そして残ったのは元の8%です。それでも、1.8Bモデルを3500億トークンで学習した比較では、フルのFineWebやDolmaを上回りました。捨てるほうが強くなる、という結果です。
The Stack v2は、許諾的ライセンスまたはライセンス表記なしのファイルだけに絞り込んでいます。開発者向けに「Am I in The Stack」という、自分のコードが含まれているか確認して除外申請できるツールも提供されています。
品質フィルタリングの定番は次の4つです。
| 手法 | 具体的な処理 | 目的 |
|---|---|---|
| 重複排除 | MinHash / LSHによる近重複、および完全一致 | 同じ内容の水増しを防ぐ |
| 品質分類器 | fastText系、教育スコアなど | 低品質ページを落とす |
| PII除去 | メールアドレスや公開IPの匿名化 | 個人情報の混入を防ぐ |
| 汚染除去 | 評価ベンチマークとの一致検出 | スコアの過大評価を防ぐ |
4つ目は地味ですが重要です。評価用の問題が学習データに紛れ込むと、スコアだけが上がります。ベンチマークの数字を読むときに、decontaminationの記述があるかどうかは見ておくと良いです。
1つ目の重複排除は、強くかければ良いというものでもありません。FineWebでは全dumpを横断するグローバルなMinHash重複排除を先に試していますが、20兆トークンから4兆トークンまで削っても、3500億トークン学習の比較で非重複排除データとほぼ同等にとどまりました。dumpごとに個別に重複排除するほうが、性能は大きく上がっています。消しすぎると、残るのが広告や定型文だらけの低品質なテキストになる、という説明がされています。
どれくらい学習させるのか
Chinchilla(Hoffmann et al., NeurIPS 2022)が示した計算最適な比率は、パラメータ数の約20倍のトークンでした。同論文のChinchilla-70Bは1.4兆トークンで学習し、3000億トークンで学習した280BのGopherを、推論コスト4分の1で上回っています。
ただし現在は、この比率をはるかに超えて学習させるのが普通になりました。推論コストのほうが支配的になったからです。
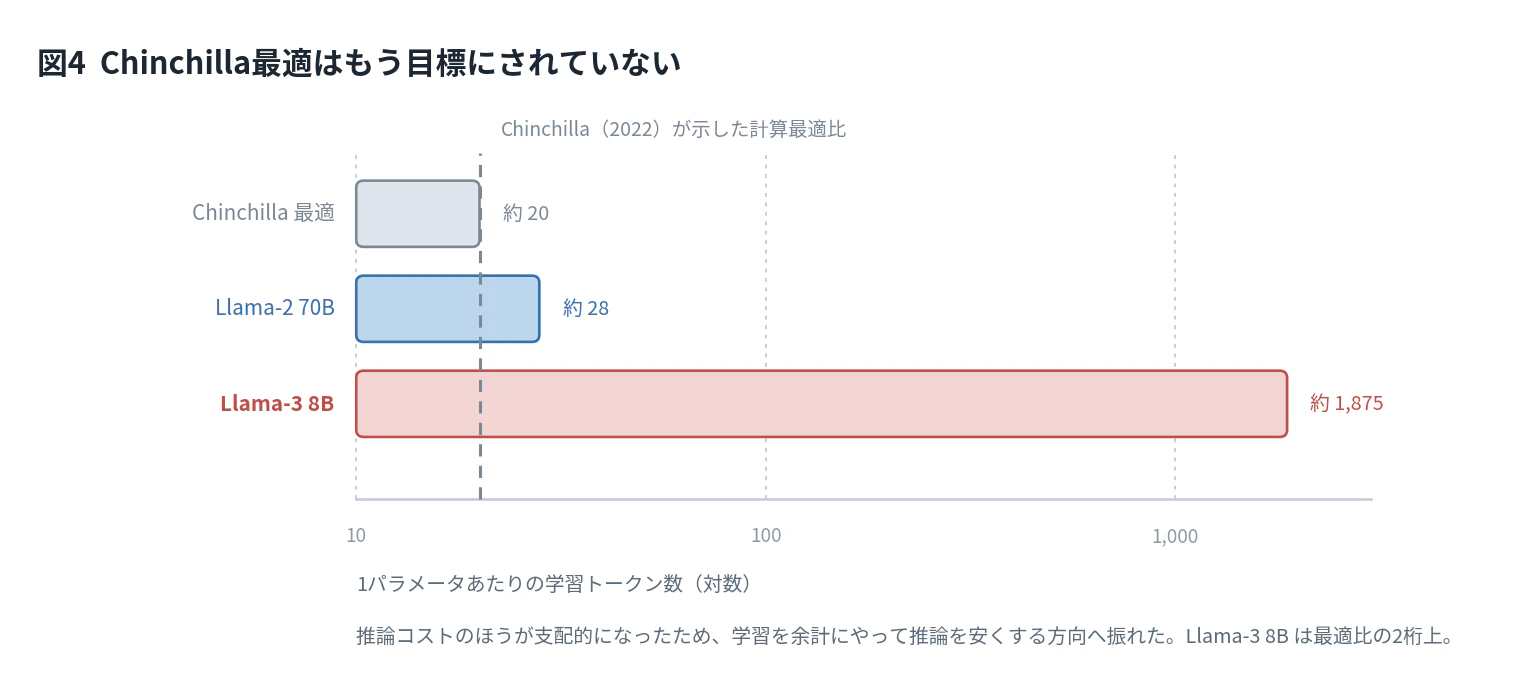
Llama-3 8Bは、Chinchilla最適の2桁上です。学習を余計にやって、推論を安くする、という判断です。
データは足りるのか
Epoch AIの推計(arXiv:2211.04325)では、品質と反復回数を調整した人間生成の公開テキストは約300兆トークン。トレンドが続けば2026年から2032年のあいだに使い切るとされています。over-trainが激しければもっと早まります。
そこで合成データを使うわけですが、ここには「モデル崩壊」の議論があります。
| 論文 | 設定 | 結論 |
|---|---|---|
| Shumailov et al., Nature 631 (2024) | 実データを合成データで置き換え続ける | 分布の裾が消えて崩壊する |
| Gerstgrasser et al., COLM 2024 | 実データに合成データを蓄積していく | テスト誤差が反復回数に依存しない上界を持つ。崩壊しない |
つまり、置き換えるとダメで、足すぶんには大丈夫、ということです。実務的な結論としては、フィルタした合成データを実データと混ぜて使うぶんには問題ない、という理解になっています。
SystemVerilogは圧倒的にデータが少ない
ここが我々の業界の事情です。PythonやCと比べると、公開されているVerilog / SystemVerilogのコードは桁違いに少ないです。The Stack v2の論文にもHDLの内訳の明示はありません。
そのため、RTL向けのLLM研究は「まずデータを作る」ところから始まります。この話は後半でまとめます。
2. Instruction Tuning用データ(SFT)
事前学習を終えたモデルは、文章の続きを書くのは得意ですが、指示に素直に答えるとは限りません。質問すると、質問の続きを書いてくることすらあります。
そこで、指示と応答のペアを学習させます。
データ形式
主要な形式は次のとおりです。
| 形式 | 構造 | よく使われる場面 |
|---|---|---|
| Alpaca | instruction / input / output | 単発タスク、初期のSFT |
| ShareGPT | conversations の配列 | 対話ログの再利用 |
| OpenAI messages | role / content の配列 | 現在の事実上の標準 |
| ChatML | 特殊トークンで役割を区切った1本の文字列 | 上記をモデルに渡す最終形 |
Alpaca形式は次のようなものです。
{
  "instruction": "次のSystemVerilogコードの問題点を説明してください。",
  "input": "always @(posedge clk) q = d;",
  "output": "順序回路では通常ノンブロッキング代入を使用します。q = d; を q <= d; に変更してください。"
}
messages形式だとこうです。
{
  "messages": [
    {"role": "user", "content": "always_ffとalways_combの違いを教えてください。"},
    {"role": "assistant", "content": "always_ffは順序回路用、always_combは組み合わせ回路用です。"}
  ]
}
このJSONがそのままモデルに入るわけではありません。学習前に、モデル固有の特殊トークンを含む1本の文字列に変換されます。ChatMLなら次のような形です。
<|im_start|>user
always_ffとalways_combの違いを教えてください。<|im_end|>
<|im_start|>assistant
always_ffは順序回路用、always_combは組み合わせ回路用です。<|im_end|>
この変換を担うのがchat templateで、HuggingFaceなら tokenizer.apply_chat_template です。学習時と推論時でテンプレートがずれると性能が落ちるので、自前でプロンプトを組み立てずにこれを使うのが安全です。
実は一番大事なのは損失のかけ方
形式の話よりも重要なのが、loss maskingです。
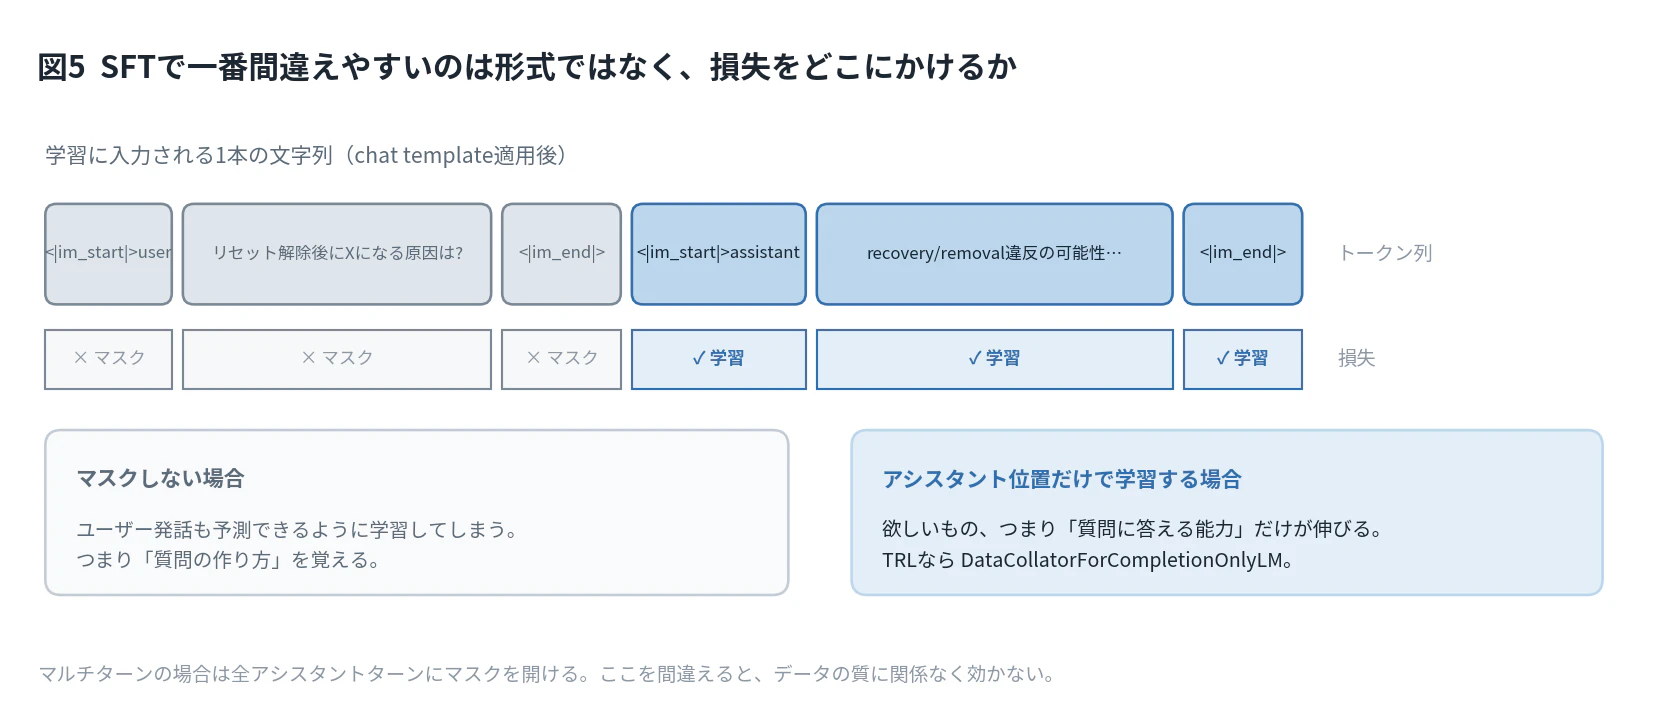
上の文字列をそのまま次トークン予測で学習すると、モデルはユーザーの発話部分も予測できるように学習してしまいます。つまり「質問の作り方」を覚えます。
これは望むものではありません。欲しいのは「質問に答える能力」です。
なので、ユーザー発話とシステムプロンプトの位置は損失をマスクし、アシスタント応答の位置だけで学習します。train on completions only、あるいはassistant-only lossと呼ばれます。
TRLでの指定方法は変わっているので注意してください。現在は SFTConfig のフラグで指定します。
| 用途 | 指定 |
|---|---|
| prompt-completion形式 |
completion_only_loss(デフォルトで有効) |
| 会話形式 | assistant_only_loss=True |
後者はchat templateに {% generation %} マーカーが必要です。以前よく引かれた DataCollatorForCompletionOnlyLM はまだ残っていますが、旧来の書き方になりました。
マルチターンの場合は、全アシスタントターンにマスクを開けます。
ここを間違えると、データがどれだけ良くても効きません。自前でSFTスクリプトを書く場合、最初に確認すべきポイントです。
何件必要か
LIMA(Zhou et al., arXiv:2305.11206)が、この問いに強い答えを出しました。
Stack ExchangeやwikiHowから750件、手書きで250件、合計1000件(約75万トークン)だけでLLaMA 65Bをファインチューンし、300件のテストプロンプトによる統制人間評価で、次の結果を出しています。
| 比較対象 | LIMAが同等以上だった割合 |
|---|---|
| GPT-4 | 43% |
| Bard | 58% |
| DaVinci003 | 65% |
論文の主張は、知識はほぼ事前学習で獲得済みで、SFTはスタイルの獲得にすぎない、というものです。
ただし、この結果は人間による選好評価で測ったものです。従来型のNLPベンチマークのスコアが同じように伸びるとは限らない、という留保は付きます。
現在のコンセンサスは、振る舞いや回答スタイルの獲得は少数高品質で足りるが、知識や能力そのものの底上げには規模と多様性が要る、というあたりです。
代表的なSFTデータセットには次のようなものがあります。
| データセット | 作り方 |
|---|---|
| FLAN / FLAN-v2 | 既存のNLPタスクを指示形式に変換 |
| Alpaca | Self-Instructで大規模モデルから自動生成 |
| Dolly 15k | 従業員による人手作成 |
| OpenAssistant | クラウドソースの対話ツリー |
| UltraChat | モデル同士の対話を大量生成 |
| Evol-Instruct / WizardLM | 指示を段階的に複雑化させる |
| Magpie | アラインメント済みモデルにテンプレートだけ与えて自己生成させる |
Magpieの発想が面白いです。空のユーザーターンのテンプレートだけを与えると、モデルが勝手に「ありそうな質問」を生成してくれる、という性質を使っています。
QLoRAの現実的な要件
今回の本題です。QLoRA(Dettmers et al., arXiv:2305.14314)は、ベースモデルを4bit(NF4)で凍結し、LoRAアダプタだけを学習します。
論文の主張は、65Bを単一48GB GPUで、33Bを24GBで、7Bを16GBで、16-bitのフルファインチューンと有意差なく学習できる、というものです。二重量子化(量子化定数をさらに量子化する)で65Bで約3GB節約しています。
VRAMの目安をまとめると次のとおりです。
| モデル規模 | 必要VRAMの目安 | 備考 |
|---|---|---|
| 7B / 8B | 16〜24GB | Unslothの公称値では8B・2048トークンでピーク約6.6GB |
| 33B | 24〜48GB | RTX 4090(24GB)でも可 |
| 65〜70B | 48GB | NF4ベース約35GB+アダプタ等で約8〜9GB |
ハイパーパラメータは経験則の世界です。
| 項目 | よく使われる値 |
|---|---|
| rank | 8〜64 |
| alpha | rankの1〜2倍前後 |
| target_modules | attentionとMLPの投影層 |
| 学習率 | フルFTより1桁大きめ(1e-4 前後) |
破滅的忘却(元の能力が失われる)は、低rank・低学習率・一般データを一部混ぜる、で緩和します。
上の表は手元のGPUを想定した目安です。クラウドで借りる場合の枚数と載るモデルの対応は前回の記事で整理しました。96GB×1で70B級、×2で120B級、×4で235B〜355B級というあたりが現実解になります。
3. 推論・問題解決データ
数学、プログラミング、論理問題では、最終回答だけでなく解く過程を含めます。
{
  "instruction": "8ビットカウンタが100MHzで動作しています。オーバーフロー周期を求めてください。",
  "output": "8ビットカウンタは256クロックで一周します。100MHzの周期は10nsなので、256 × 10ns = 2560nsです。したがってオーバーフロー周期は2.56μsです。"
}
コード修正なら、修正後コードだけでなく次の情報を含めます。
{
  "problem": "AXI Write Responseが返らない",
  "cause": "BREADYが常に0になっていた",
  "analysis": "AXIではBVALIDとBREADYが同時に1になったときに応答転送が完了する",
  "fix": "BREADYを応答待ち状態で1にする",
  "test": "BVALIDが遅延するケースを追加する"
}
暗記ではなく、原因分析・手順分解・修正方針・テスト追加という型を学ばせるためのデータです。
良い思考過程だけを残す
思考過程を人手で書くのは高コストです。そこで、次のような手法が使われます。
| 手法 | やること |
|---|---|
| STaR | モデルに解かせ、正解した軌跡だけを学習データに戻す。これを繰り返す |
| Rejection sampling FT | 大量にサンプリングして、正解のものだけをSFTに使う |
| 蒸留 | 強いモデルの思考過程を、小さいモデルに教師データとして与える |
失敗した軌跡は捨てるか、後述の選好データのrejected側に回します。
RLVR:検証可能な報酬
ここが近年の大きな変化です。
人間の好みで報酬を決めるのではなく、自動検証できる結果を報酬にする。これがRLVR(Reinforcement Learning with Verifiable Rewards)です。
数学なら答えが合っているか。コードならテストが通るか。人間の判断が要りません。DeepSeek-R1がGRPOでこれをやって、推論能力を大きく伸ばしました。
ハードウェア検証は、この考え方と相性が良い領域です。報酬にできる自動チェックが揃っているからです。
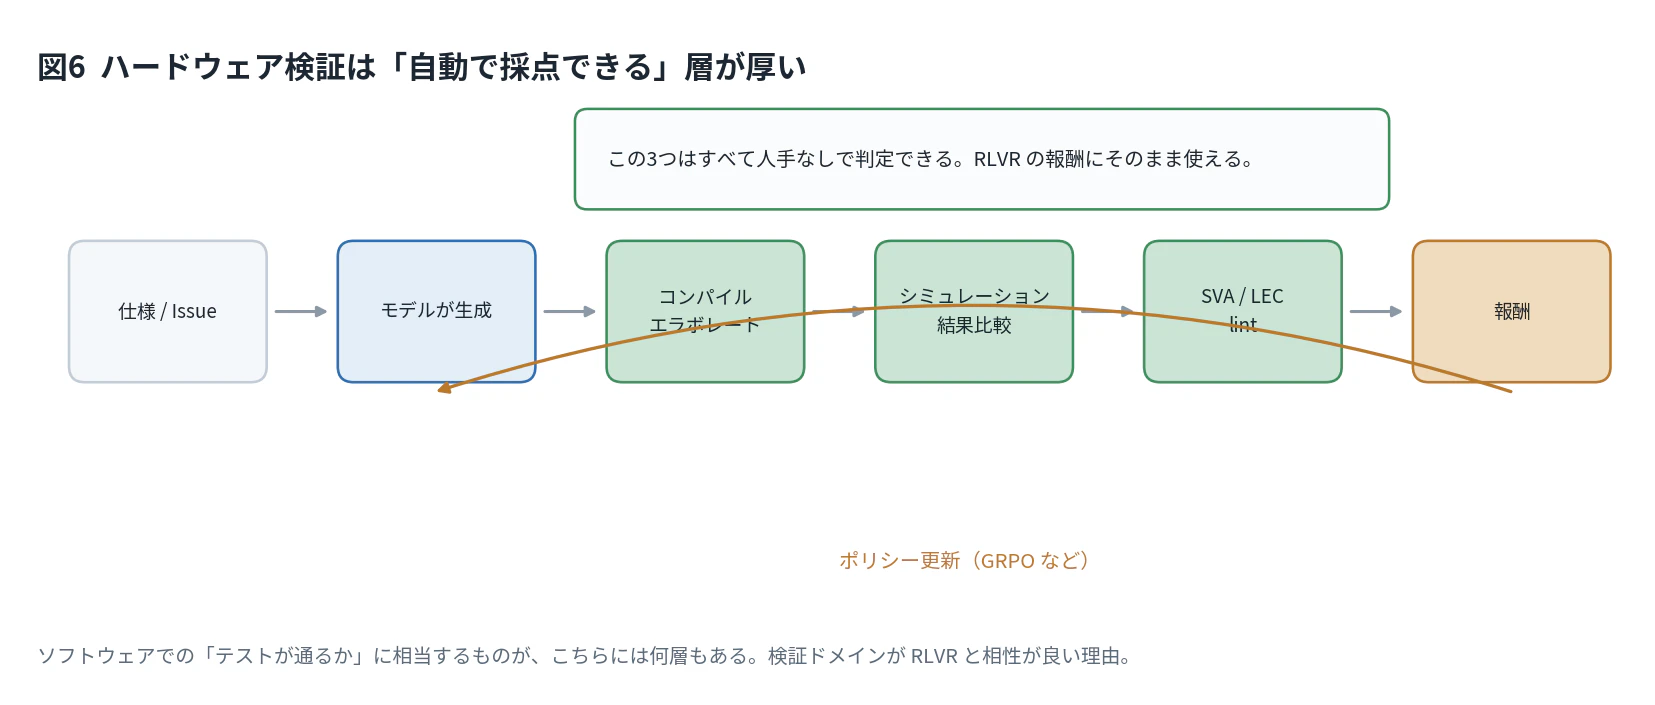
| 検証手段 | 何を報酬にできるか | 判定コスト |
|---|---|---|
| lint | コーディング規約適合 | 非常に低い |
| コンパイル / エラボレート | 構文と接続の妥当性 | 非常に低い |
| シミュレーション | ゴールデン参照との出力一致 | 低い |
| テストベンチ | 機能カバレッジ、テストのパス数 | 中 |
| SVA | プロトコル違反の有無 | 中 |
| 論理等価性チェック(LEC) | 参照実装との等価性 | 高い |
ソフトウェアの世界で「テストが通るか」に相当するものが、こちらには何層もあります。しかも、段階的に厳しくなる報酬を設計できます。
少数の高品質推論データ
s1(Muennighoff et al., arXiv:2501.19393)は、Gemini Thinkingから1000件の推論軌跡を蒸留し、Qwen2.5-32B-InstructをSFTしました。H100を16枚で26分、コストにして約25ドルです。
さらに、モデルが思考を終えようとしたときに「Wait」を挿入して思考を延長させる budget forcing という手法を組み合わせています。推論の長さを外から制御する、という発想です。
同じQwenベースで800倍のサンプル数を使ったR1-distillと比較できる位置づけで、推論能力も少数の高品質データで移植できることを示しました。
なお、思考が長ければ良いわけではありません。overthinkingでcontextを食い潰したり、かえって精度が落ちたりします。推論の予算管理は実用上の論点です。
4. 好み・評価データ
複数の回答のうち、どちらが良いかを学習させます。
質問が「このバグの原因を説明してください」だとします。
回答A:
コードがおかしいです。修正してください。
回答B:
ready信号をクロック同期せずに使用しているため、メタステーブル状態が発生する可能性があります。
2段フリップフロップで同期化するか、ハンドシェイク方式を使用してください。
データはこうなります。
{
  "prompt": "このバグの原因を説明してください。",
  "chosen": "ready信号をクロック同期せずに使用しているため、メタステーブル状態が発生する可能性があります。",
  "rejected": "コードがおかしいです。修正してください。"
}
これで、具体的で正確で読みやすい回答が優先されるようになります。
RLHFからDPO、そしてGRPOへ
古典的なRLHFは3段構えです。
SFT → 報酬モデルを学習 → PPOでポリシーを最適化
報酬モデルとvalue modelを別々に持つので、メモリも計算も重く、安定させるのが難しいという問題がありました。
その後の進化は、必要なモデルを減らす方向に進みました。
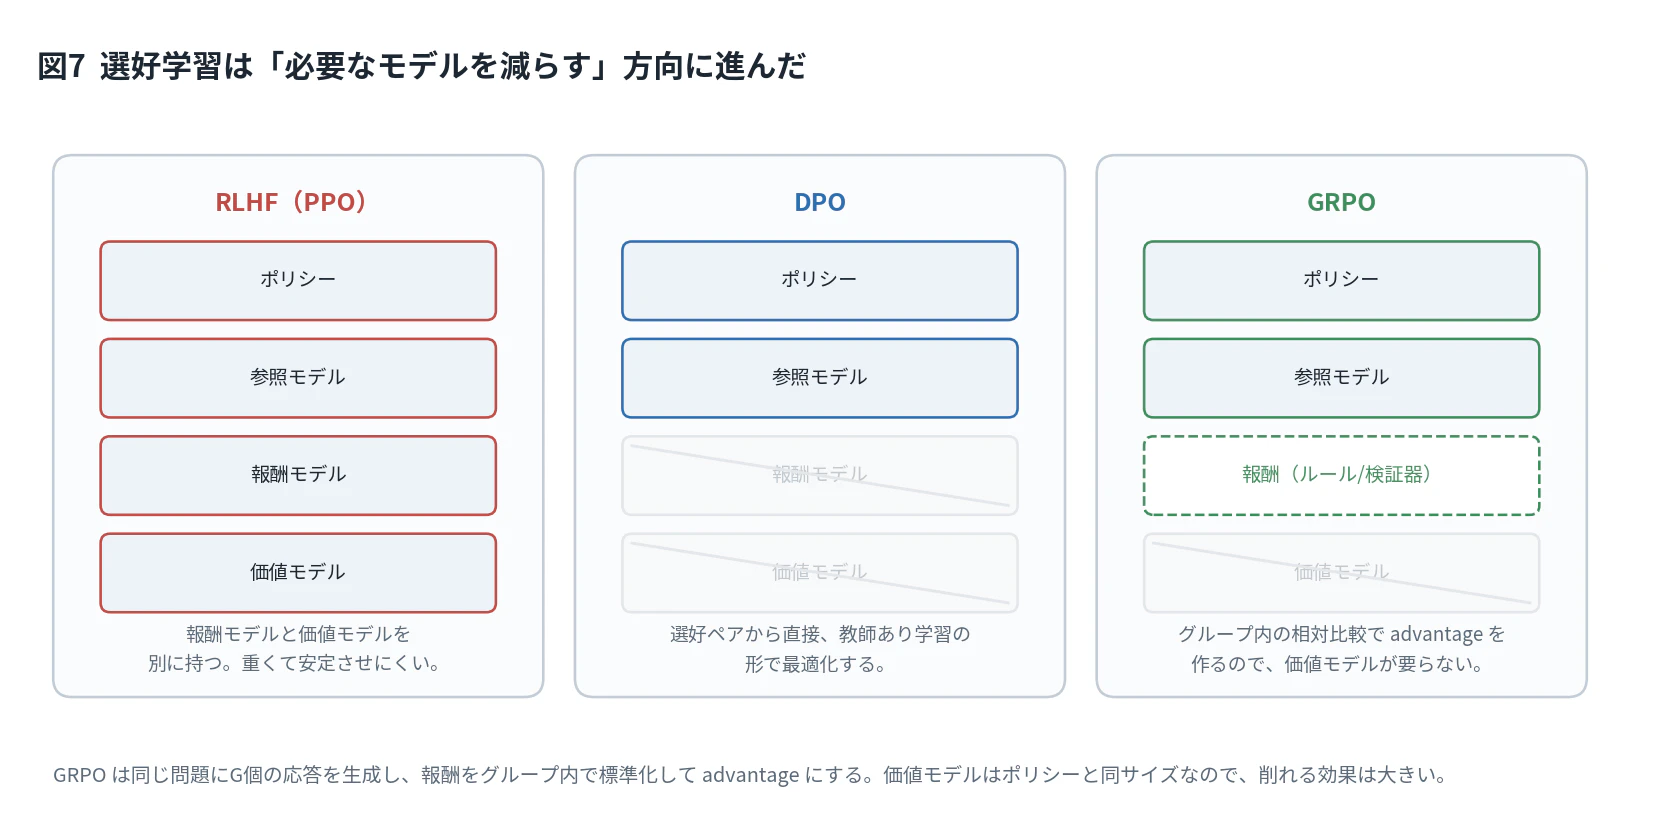
DPO(Rafailov et al., arXiv:2305.18290)は、報酬モデルとRLループを丸ごと消しました。RLHFの最適ポリシーが報酬の閉形式解を持つ性質を逆に使うと、chosen/rejectedのペアから直接、教師あり学習の形で最適化できます。扱いにくい分配関数が、ペアの差分を取る過程で相殺されるのが鍵です。
直感的には「良い答えの確率を、悪い答えより相対的に上げる。ただし元のモデルから離れすぎない範囲で」です。
GRPO(DeepSeekMath, arXiv:2402.03300)は、value model(critic)を廃止しました。同じ問題に対してグループでG個の応答を生成し、報酬をグループ内で標準化してadvantageにします。「他の候補と比べて良かったか」だけで学習するので、絶対的な価値関数が要りません。
criticはポリシーと同サイズのモデルなので、これを持たなくて済むのはメモリと計算の両面で効きます。DeepSeek-V3およびR1で採用されました。
2025年以降、GRPOの派生も増えています。
| 手法 | 主な変更点 |
|---|---|
| DAPO | Clip-Higher、Dynamic Sampling、トークンレベル損失などで、エントロピー崩壊と学習効率に対処 |
| GSPO (arXiv:2507.18071) | 重要度サンプリングをトークン単位から系列単位へ。MoEの学習を安定化。Qwen3で採用 |
| Dr. GRPO | 長さと標準偏差による正規化がもたらすバイアスを除去 |
| CISPO / GMPO | クリッピングと集約の設計を見直した派生 |
DPOの派生も多数あります。
| 手法 | 主な改善点 |
|---|---|
| IPO | 過学習の抑制 |
| KTO | ペア不要。良し悪しの単独ラベルで学習できる |
| ORPO | SFTと選好学習を1段階に統合、参照モデル不要 |
| SimPO | 参照モデル不要、長さ正規化 |
| cDPO | ラベルノイズへの対応 |
選好データセットとしては、HH-RLHF、UltraFeedback、Nectar、SHP、HelpSteer2 などが公開されています。AIに選好ラベルを付けさせるRLAIF / Constitutional AIも実用段階です。
報酬ハッキング
このパラダイムの弱点は、報酬モデルを騙す出力を学んでしまうことです。典型は長さバイアスで、とにかく長く書けば高スコアが出る、という抜け道を見つけます。
長さ正規化やKL制約で緩和しますが、根本的に消えるものではありません。RLVRが注目されているのは、検証可能な報酬なら騙しにくいから、という側面もあります。
5. エージェント・ツール利用データ
コードエージェント向けのモデルでは、回答文だけでなく、ツールをどう使うかを学習させます。
{
  "messages": [
    {"role": "user", "content": "AXIのBVALIDが上がらない原因を調べてください。"},
    {"role": "assistant", "content": "まずBVALIDの代入箇所を検索します。"},
    {"role": "assistant", "tool_call": {"name": "grep", "arguments": {"pattern": "BVALID", "path": "src/"}}},
    {"role": "tool", "content": "src/axi_write.sv:182: assign BVALID = write_done;"},
    {"role": "assistant", "content": "write_doneの生成条件を確認します。"}
  ]
}
さらに、次のような一連の操作履歴を学習させます。
grep
→ 関連ファイルを開く
→ 信号の代入元を追跡
→ テストを実行
→ エラーログを見る
→ 修正
→ 再テスト
コードエージェントの性能には、このデータがかなり効きます。
ここでも損失のかけ方
軌跡データでも、どこにlossをかけるかが問題になります。
| ロール | 損失 | 理由 |
|---|---|---|
| user | マスク | 学習すると「質問の作り方」を覚える |
| assistant(思考・アクション) | 学習する | ここが欲しい能力 |
| tool(返り値) | マスク | 学習すると「grepの結果を捏造する能力」がつく |
3行目が重要です。ツールの返り値は環境が返すものであって、モデルが生成すべきものではありません。ただしこれは実装上の設計原則として広く採られているもので、効果を定量比較した一次文献は見当たりませんでした。
SWE-benchの設計思想
SWE-bench(Jimenez et al., arXiv:2310.06770)は、12個のPythonリポジトリの実際のIssueから2294件のタスクを構築しました。OpenAIが人手で500件に厳選したSWE-bench Verifiedもあります。Pythonの経験がある93名の開発者が選別に関わり、各サンプルを3名のアノテータが独立にラベル付けしています。
タスクの構成が良くできています。
入力:
  - Issue本文(problem_statement)
  - リポジトリのスナップショット(base commit)

判定:
  - FAIL_TO_PASS : 修正前は落ちる。修正後は通る
  - PASS_TO_PASS : 修正前も後も通り続ける(回帰していない)
修正の正しさを、人間の主観ではなくテストの状態遷移で定義しています。エージェントの学習データを作るうえで、この設計は流用価値が高いです。
代表的なデータセットとフレームワークは次のとおりです。
| 名称 | 内容 |
|---|---|
| SWE-bench / Verified | 実Issueからのバグ修正タスク。2294件 / 厳選500件 |
| SWE-Gym / SWE-smith / R2E-Gym | エージェント軌跡を生成するための環境 |
| ToolBench / Gorilla / APIBank | API呼び出しの学習・評価 |
| APIGen / xLAM | 21カテゴリ・3673の実行可能APIから60k件を生成 |
APIGen(arXiv:2406.18518)のフィルタ設計は参考になります。フォーマット検証、実際の実行、意味の検証という3段階をかけていて、600件の人手評価で95%超が正確でした。
エージェント軌跡の生成では、rejection samplingで成功した軌跡だけを残すのが基本です。
GitHubのIssueを学習データにする
ここからが実践編です。修正済みのBug Issueがあるなら、それは良い学習データの原石です。
元のIssue
タイトル:
非同期リセット解除後にカウンタがXになる

問題:
リセット解除直後にcountがXになる場合がある

原因:
rst_nの解除をクロックに同期していなかった

修正:
リセット解除側に2段同期回路を追加した
SFT用に変換する
{
  "messages": [
    {
      "role": "user",
      "content": "非同期リセット解除後にレジスタがXになる原因を分析してください。\n\nalways_ff @(posedge clk or negedge rst_n) begin\n    if (!rst_n)\n        count <= '0;\n    else\n        count <= count + 1'b1;\nend"
    },
    {
      "role": "assistant",
      "content": "非同期リセットのアサートは問題ありませんが、解除がクロックエッジ付近で発生するとrecovery/removal違反が起きる可能性があります。一般にはリセットを非同期アサート・同期デアサートにし、解除側を2段フリップフロップで同期化します。"
    }
  ]
}
構造化して情報を落とさない
{
  "problem_summary": "非同期リセット解除後にcountがXになる",
  "reproduction": "rst_nをposedge clkの直前で1にする",
  "root_cause": "非同期リセットの解除がクロックに同期されておらず、recovery/removal違反が発生した",
  "related_files": ["rtl/counter.sv", "tb/counter_tb.sv"],
  "before_code": "always_ff @(posedge clk or negedge rst_n) ...",
  "after_code": "同期化したreset_n_syncをalways_ffで使用する",
  "reason": "非同期アサート・同期デアサートにするため",
  "additional_tests": [
    "クロックエッジ直前のリセット解除",
    "クロックエッジ直後のリセット解除",
    "短いリセットパルス"
  ],
  "incorrect_fix": "非同期リセットを単純に同期リセットへ置き換える",
  "review_comment": "リセット同期回路自体には非同期リセットを使用し、2段目の出力を各モジュールへ配布する"
}
各フィールドが何に効くのかを整理しておきます。
| フィールド | 何に使えるか |
|---|---|
| problem_summary | SFTの入力(質問文)になる |
| reproduction | 再現テスト生成タスクの正解になる |
| root_cause | 原因分析タスクの正解になる |
| before_code / after_code | コード修正タスクの入出力になる |
| reason | なぜその修正かを説明させる根拠になる |
| additional_tests | テスト提案タスクの正解になる |
| incorrect_fix | 選好データのrejected側にそのまま転用できる |
| review_comment | レビュータスクの正解になる |
incorrect_fix があるのがポイントです。誤った修正例は、後から作るのが難しく、かつ選好学習で価値が高いデータです。
SWE-bench型に写像する
自作のシミュレータやRTLのOSSプロジェクトを持っているなら、SWE-benchの設計をそのまま持ち込めます。
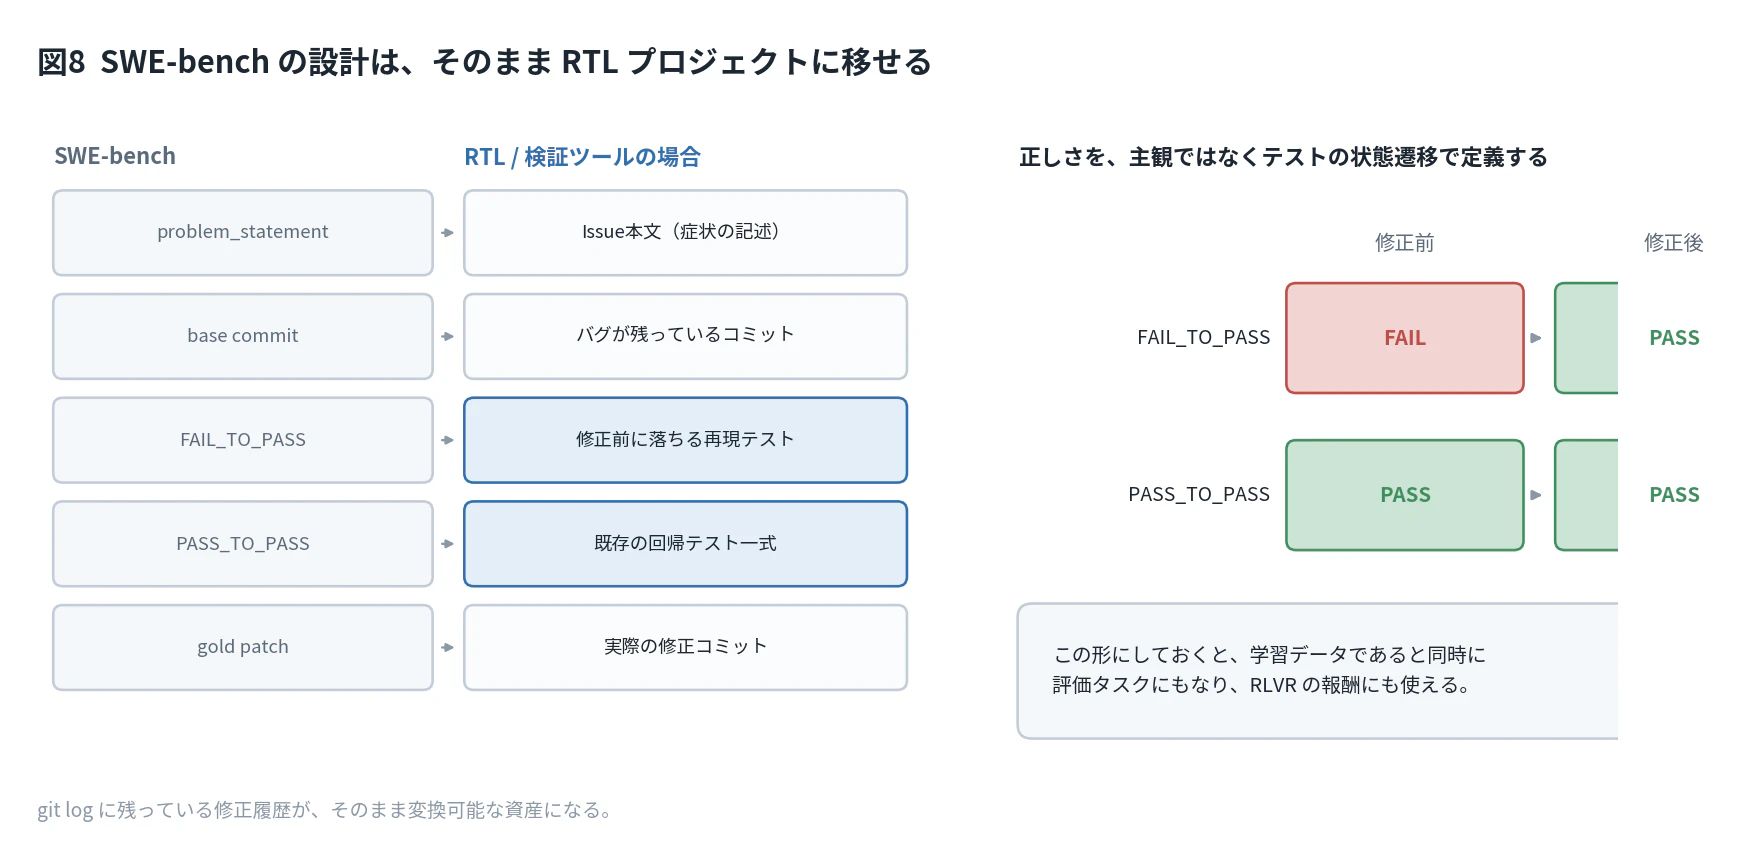
こうしておくと、学習データであると同時に、そのまま評価タスクにもなります。RLVRの報酬にも使えます。
git logに残っている修正履歴が、この形式に変換できる資産だということです。
1件から複数の問題へ展開する
元Issueが「AXIのBVALIDが上がらない」なら、次のように分割できます。
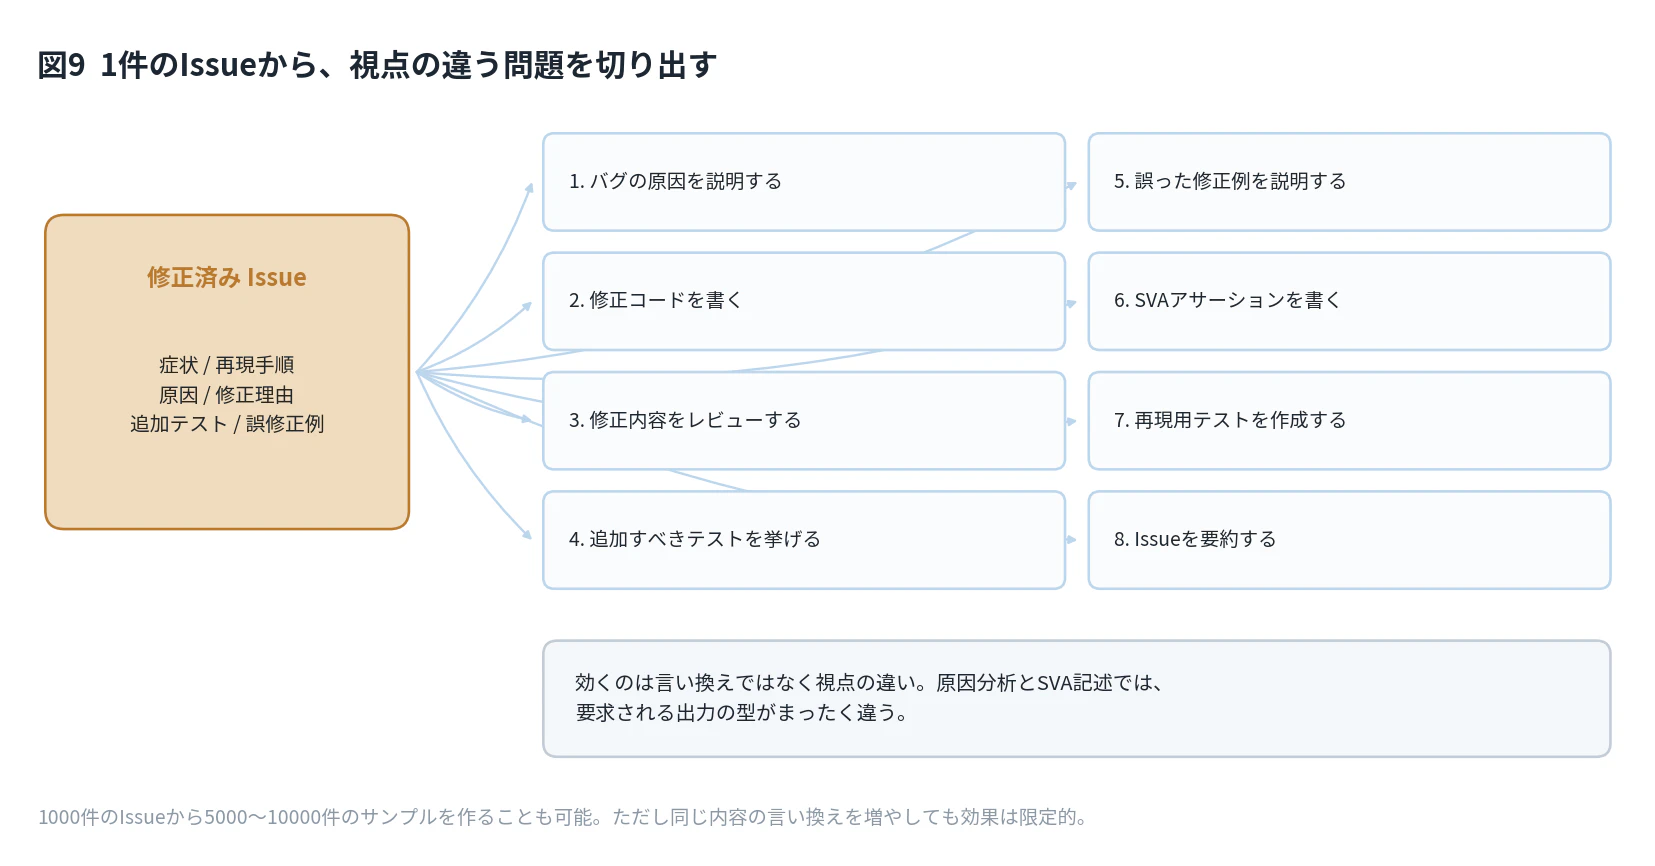
1000件のIssueから、品質次第では5000〜10000件のサンプルを作ることも可能です。
ただし注意があります。同じ内容を言い換えただけのデータを大量に増やしても、効果は限定的です。
| 増やし方 | 効果 |
|---|---|
| 同じ文の単純な複製 | ほぼない。FineWeb-Eduの追加ablation(1.8B・3500億トークン)でも、重複排除の有無で改善も劣化も見られなかった |
| 同じ内容の言い換え | 限定的。ただし新規知識の獲得では多少の改善が報告されている |
| 視点を変えたタスク化 | 効く。要求される出力の型が変わるため |
上の8分割が効くのは、言い換えではなく、視点が違うからです。原因分析とSVA記述では、要求される出力の型がまったく違います。
重要なのは件数ではなく、入力情報と正解の因果関係が明確で、正解コードと説明が本当に正しいことです。
RTL / 検証ドメインで何が起きているか
日本語圏ではあまり紹介されていない領域なので、まとめておきます。
データを作る側の研究
Verilogは公開データが少ないので、研究の主戦場は「どうやってデータを作るか」です。
| 手法 | アプローチ |
|---|---|
| VeriGen (arXiv:2308.00708) | GitHubと教科書からVerilogを収集してCodeGenをfine-tune。前処理不足で構文エラーが多いという教訓を残した |
| RTLCoder (arXiv:2312.08617) | GPT-3.5にRTLキーワードを与えて命令とコードの対を合成、コンパイルが通らないものは破棄 |
| OriGen (arXiv:2407.16237) | コードからコードへの拡張+self-reflection(コンパイラのフィードバックで反復修正) |
| CodeV (arXiv:2407.10424) | マルチレベル要約で説明とコードの対を生成 |
| CodeV-R1 (arXiv:2505.24183) | 正式名はQiMeng-CodeV-R1。RTL向けRLVR。testbench生成器でゴールデン参照との等価性を検証し、蒸留してからRLする |
CodeV-R1が特に参考になります。自然言語とVerilogを往復させて、その整合性をtestbenchで検証してデータをフィルタするラウンドトリップ方式を使っています。そのうえで、蒸留でまず推論の初期状態を作り、それからRLで伸ばします。
結果として7Bモデルで、VerilogEval v2で68.6%、RTLLM v1.1で72.9%(pass@1)。671BのDeepSeek-R1に匹敵する水準です。ドメイン特化と検証ループが効くことの証拠になっています。
合成データの落とし穴とベンチマークの現在地
VeriCoder(arXiv:2504.15659)が、なかなか厳しい数字を出しています。また、実務的なタスクを集めたCVDPの結果も厳しいです。
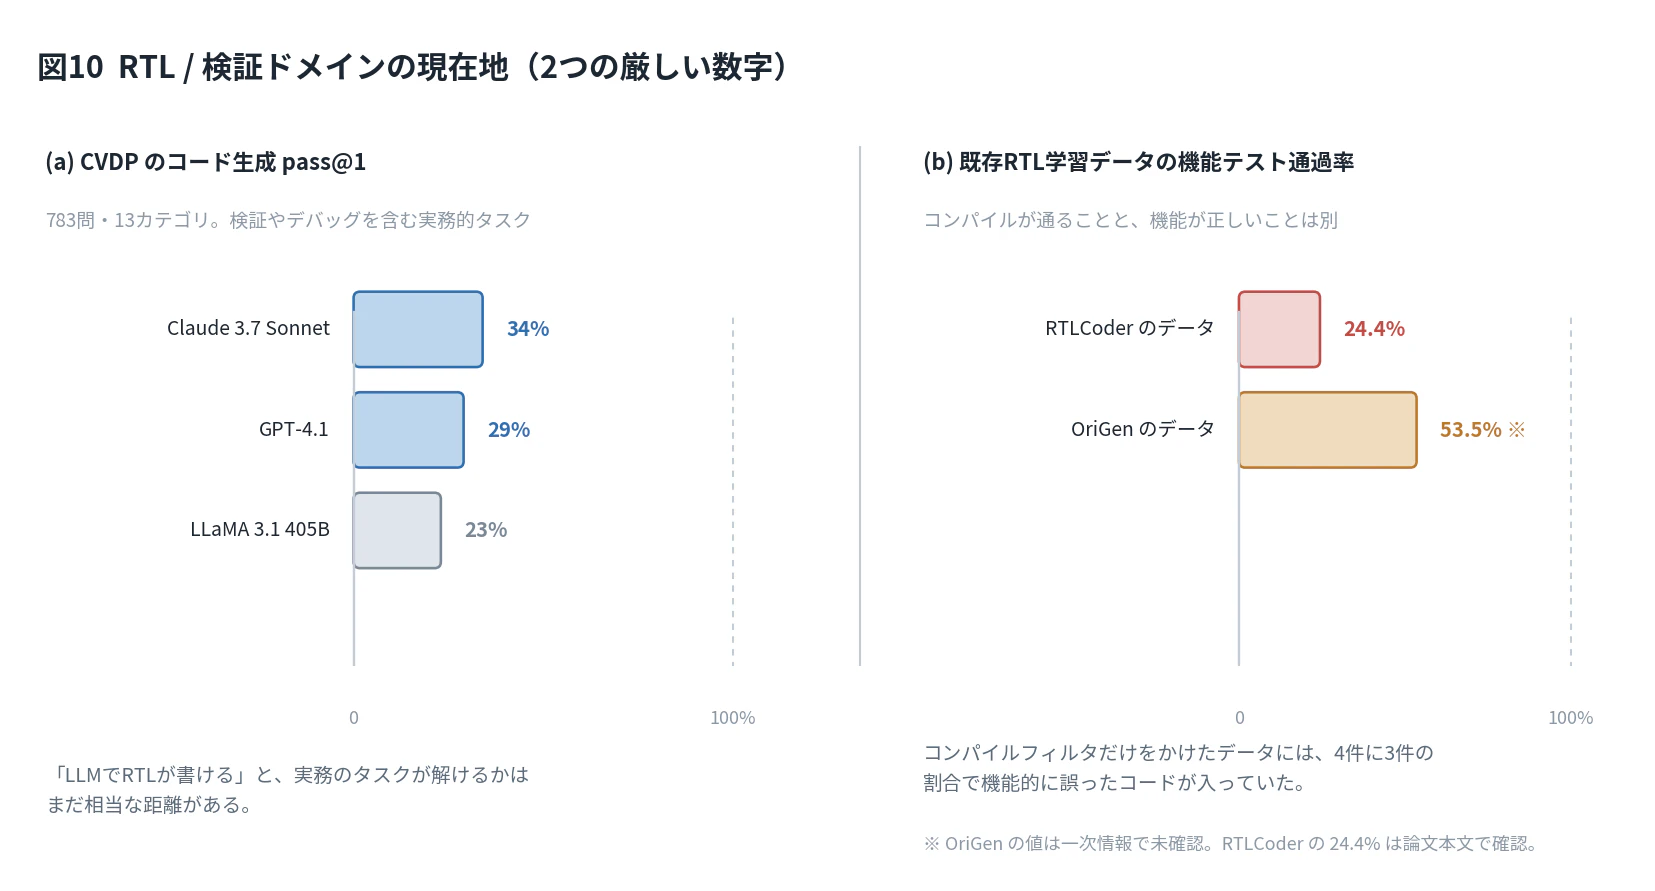
左(a)が示すのは、実務タスクの難しさです。CVDPは783問・13カテゴリで、RTL生成だけでなく検証・デバッグ・仕様整合を含みます。最良でもpass@1が34%です。特に、既存RTLの再利用と検証を伴うエージェントタスクが難しいという結果でした。
右(b)が示すのは、データの質の問題です。既存のRTL学習データセットについて、コードが機能テストを通過する率を測ったところ、RTLCoderのデータは24.4%でした。各コーパスから1000件をサンプルし、GPT-4o-miniで生成したユニットテストにかけた結果です。OriGenのデータは53.5%とされていますが、こちらは論文本文で数値を確認できていません。
つまり、構文が通ることと機能が正しいことは全然違います。コンパイルフィルタだけをかけたデータセットには、4件に3件の割合で機能的に誤ったコードが入っていたことになります。
我々の業界の常識ではありますが、学習データ生成でも同じ罠がある、というのは覚えておく価値があります。実行ベースの検証がどうしても必要です。
ベンチマーク
| ベンチマーク | 内容 |
|---|---|
| VerilogEval | HDLBits由来。Human subsetは156問、Machine subsetは143問 |
| VerilogEval v2 (arXiv:2408.11053) | spec-to-RTLタスク、in-context learning、失敗分類を追加。Machine subsetは廃止 |
| RTLLM v2 | 50設計(演算・メモリ・制御・その他) |
| CVDP (NVIDIA, arXiv:2506.14074) | 783問・13カテゴリ。単発形式とエージェント形式の両方を提供 |
| TuRTLe (arXiv:2504.01986) | 既存ベンチを統合。構文・機能・合成可能性・PPA品質・行文脈精度の5指標で測定 |
TuRTLeでは、DeepSeek R1のような推論モデルが一貫して優位でした。ただしトークン消費とレイテンシのコストは大きい、という但し書き付きです。
この1年の動き
2025年後半から2026年にかけて、この領域はさらに動いています。
| 名称 | 内容 |
|---|---|
| VeriRL (arXiv:2508.18462) | testbenchのフィードバックを報酬にしたRL |
| VeriMoA (arXiv:2510.27617) | 複数エージェントの混合(Mixture-of-Agents)による生成 |
| RealBench / ArchXBench / RTL-BenchLS | 実IP規模のより複雑な設計を対象にしたベンチマーク |
| NVIDIA HORIZON | git worktreeを進化させるエージェント。RTLベンチマークで100%完了を報告 |
ベンチマーク側では、Silicon Integration Initiative(Si2)のLLM Benchmarking CoalitionがCVDPを採用しており、業界標準化の動きが出ています。
検証側
SVA生成の研究も増えています。AssertLLM(ASPDAC'25, arXiv:2402.00386)は、仕様書からSVAを生成するタスクを3つの専門LLM(仕様解析・信号マッピング・SVA生成)に分解し、RAGを併用しています。I2C設計で89%が構文・機能ともに正しいという結果でした。ただしこれはarXiv版の数値で、ASPDAC proceedings版では評価プロパティ数が異なり86%になっています。
NVIDIAのFVEval(arXiv:2410.23299)はformal verification向けの評価ベンチマークです。NL2SVA-Human、NL2SVA-Machine、Design2SVAの3つのサブベンチマークで構成されます。
ドメイン適応の実例
ChipNeMo(NVIDIA, arXiv:2311.00176)は、LLaMA2をベースに、domain-adaptive pretraining(DAPT)→ SFT → RAG という構成で作られています。
| 項目 | 内容 |
|---|---|
| ベースモデル | LLaMA2 |
| 内部コーパス | 23.1Bトークン(設計・検証・インフラ・内部文書) |
| DAPTの計算量 | 事前学習の1.5%未満 |
| トークナイザ | 領域固有語に合わせて拡張 |
| 用途 | エンジニア向けアシスタント / EDAスクリプト生成 / バグ要約と解析 |
事前学習からやり直すのではなく、既存モデルにドメインを継ぎ足すのが現実解だということです。個人がやるなら、DAPTを省いてSFT + RAGから始めるのが妥当でしょう。
学習データとRAGの使い分け
仕様書は覚えさせない
IEEE 1800の仕様を使いたいとして、仕様書全文をQLoRAで覚えさせるのは効率的ではありません。
これは感覚論ではなく、実験結果があります。
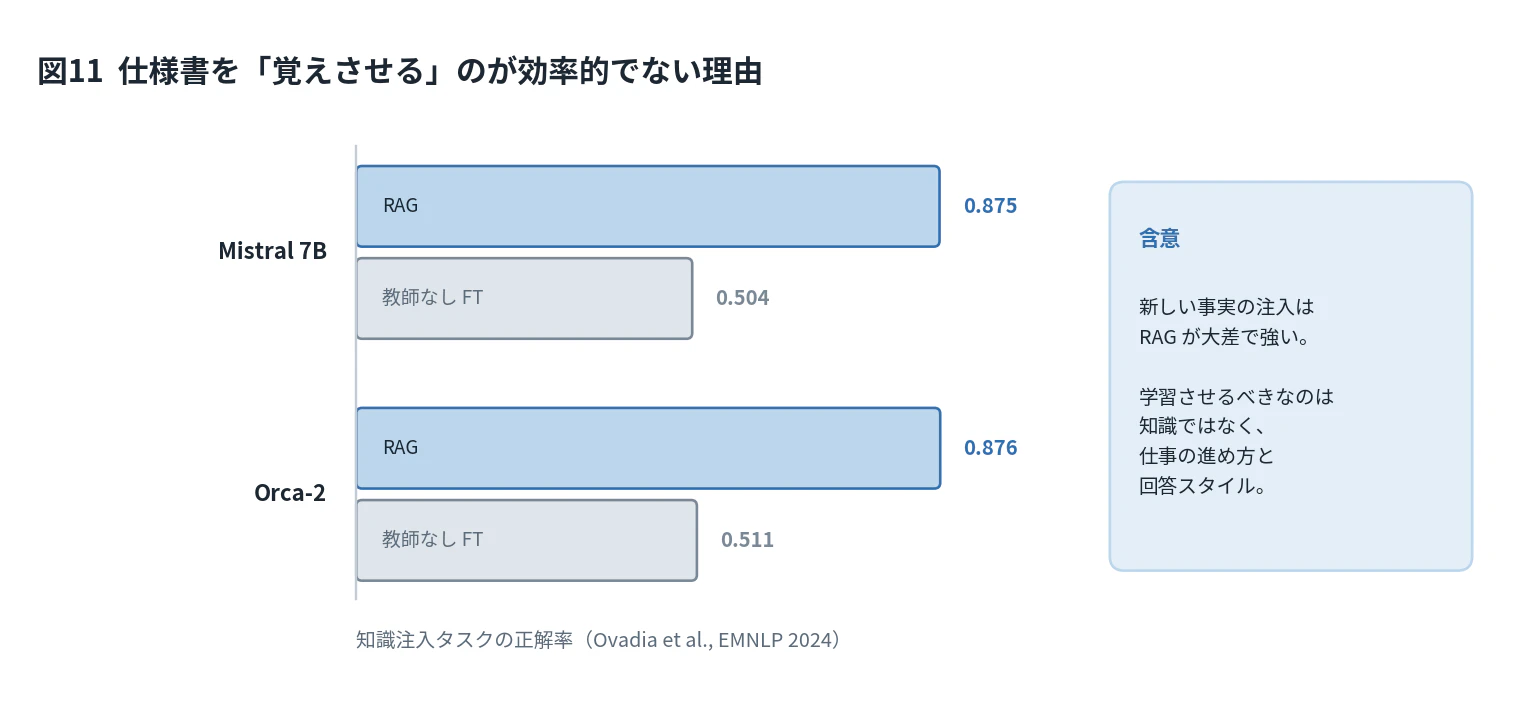
Ovadia et al.「Fine-Tuning or Retrieval?」(EMNLP 2024, arXiv:2312.05934)は、知識注入タスクでRAGと教師なしファインチューニングを比較しました。図の数値は、時事問題(current events)タスクにおける対数尤度精度です。差が大きすぎます。
LLMは教師なしファインチューニングでは新規の事実を学びにくく、多様な言い換えを与えてようやく少し改善する、という結果です。
なので、仕様知識はRAGか長いコンテキストで渡します。
IEEE 1800の該当箇所
+
現在のソースコード
+
エラーログ
一方、QLoRAで学習させるべきなのは次のような内容です。
仕様をどう調べるか
問題をどう切り分けるか
修正案をどう作るか
どんなテストを追加するか
仕事の進め方や回答スタイルです。
整理
| 学習対象 | 適した方法 |
|---|---|
| 一般的な言語・コード知識 | 事前学習 |
| 指示への回答方法 | SFT・QLoRA |
| 最新の仕様書や社内文書 | RAG・長コンテキスト |
| 回答の良し悪し | DPO・RLHF |
| 検証可能な正しさ | RLVR・GRPO |
| grepやテスト実行の手順 | エージェント学習 |
| 自社独自のバグ修正パターン | QLoRA・SFT |
| 正確なファイル内容 | RAG・リポジトリ検索 |
長いコンテキストが使えるようになってRAGは不要になるか、という議論もありますが、context rot(長文の中で情報を取りこぼす現象。古くはLiu et al. の lost in the middle として知られます)やコストの問題があり、当面は併用が現実的です。検索した文脈を与えたうえで正解を出すよう学習させるRAFTのような手法もあります。
修正済みのIssueから原因分析と修正の手順をQLoRAで学習させ、仕様書はRAGで渡す。これが一番効きやすい組み合わせだと思います。
ライセンスと機密の話
避けて通れない話題なので、簡単に整理しておきます。以下は一般的な整理であり、法的助言ではありません。
日本の著作権法30条の4は、著作物に表現された思想や感情を「享受」する目的ではない利用、たとえば情報解析のための利用について、必要と認められる限度で権利者の許諾なく利用できると定めています。非営利や研究目的に限定されていないので、商用のAI開発も対象に含まれます。
ただし但し書きがあります。著作物の種類・用途および利用の態様に照らして、著作権者の利益を不当に害することとなる場合は適用外です。
文化庁の「AIと著作権に関する考え方について」(2024年3月)は、享受目的が併存する場合は30条の4の要件を満たさないと整理しています。なおこの「考え方」自体に法的拘束力はありません。
| 論点 | 整理 |
|---|---|
| 情報解析目的の学習 | 30条の4の対象。非営利・研究に限定されない |
| 享受目的が併存する場合 | 対象外。意図的な過学習で学習元の表現を出力させる、特定作家の表現を再現する目的の少量FTなど |
| 但し書きに触れうる場合 | 情報解析用に販売されているデータベースを対価を払わず複製するなど |
| 規格書(IEEE 1800、AMBA等) | 著作物。生成物が表現を再現するなら話が変わる。RAGで渡すほうが安全 |
| 社外に出せない設計データ | memorization と抽出攻撃のリスク。ローカルで完結させるのが素直 |
| コードのライセンス | The Stack v2は許諾的ライセンスとライセンス表記なしに限定し、opt-out機構を提供 |
2024年3月の「考え方」以降も動きがあります。
| 時期 | 出来事 |
|---|---|
| 2024年5月 | 内閣府知財本部「AI時代の知的財産権検討会 中間とりまとめ」 |
| 2024年7月 | 文化庁「AIと著作権に関するチェックリスト&ガイダンス」 |
| 2025年5〜6月 | AI推進法(令和7年法律第53号)成立・施行。日本初のAI基本法だが推進型で、著作権法の改正ではない |
| 2025年8月 | 読売新聞グループ、日本経済新聞社、朝日新聞社がPerplexity AIを東京地裁に提訴 |
大手報道機関が生成AI企業を提訴したのは日本では初めてです。いずれも係属中で、まだ確定判決は出ていません。学習やデータ収集をめぐる実務は、この結果次第でまた変わる可能性があります。
仕様書はRAGで渡すほうが安全、というのは法務の観点でもあり、技術的にも正確です。方針が一致するので迷う必要がありません。
まとめ
- LLMの学習データは、段階ごとに形式も規模も狙いも違う。「質問と回答」はSFT段階の形式にすぎない
- 事前学習の次トークン予測は、1文を何度も入れ直すのではなく、causal maskingとteacher forcingで全位置を並列に学習している
- SFTで最も間違えやすいのは形式ではなくloss masking。アシスタント応答の位置だけで学習する
- 振る舞いの獲得は1000件規模でも成立する。ただし知識の底上げには規模と多様性が要る
- 検証可能な報酬(RLVR)が推論学習の主流になりつつある。ハードウェア検証は、コンパイル・シミュレーション・LEC・SVAと、報酬にできる検証手段が揃っている領域
- エージェントデータでは、ツールの返り値をマスクする。SWE-benchのFAIL_TO_PASS / PASS_TO_PASS設計は、RTLプロジェクトにそのまま写像できる
- 修正済みIssueは、症状・再現・原因・修正理由・テスト・誤修正まで構造化すると良質な学習データになる。1件を視点の違う複数の問題に展開できるが、単なる言い換え増幅は効かない
- 合成データは「構文が通る」と「機能が正しい」が別物。既存のRTLデータセットで機能テスト通過率が24.4%という報告もある。実行ベースの検証が要る
- 仕様書は学習させるよりRAGで渡す。新規知識の注入では、RAGが教師なしファインチューニングを大差で上回るという実験結果がある
自分の手元にあるIssue、コミット履歴、回帰テストは、そのまま学習データと評価タスクの原料になります。
整理してみて、着手前の想定はいくつか間違っていました。仕様書を覚えさせるつもりでいたのは方向が違っていて、それはRAGの仕事でした。件数を稼ぐことばかり考えていたのも見当違いで、効くのは量ではなく視点の違うタスクへの展開でした。loss maskingに至っては、そういう論点があること自体を知りませんでした。
いま気づけたのは良かったと思います。次は、修正済みIssueを構造化してコーパスにするところからです。
参考
前回の記事
- RTX PRO 6000 Blackwell を借りて QLoRA する ─ AWS / GCP / Azure を最安リージョンまで比較(机上検討)してみた話
一次情報(事前学習・データセット)
- FineWeb: arXiv:2406.17557 / https://huggingface.co/datasets/HuggingFaceFW/fineweb
- FineWeb-Edu: https://huggingface.co/datasets/HuggingFaceFW/fineweb-edu
- StarCoder2 and The Stack v2: arXiv:2402.19173
スケーリング則・データ枯渇
- Hoffmann et al., Training Compute-Optimal Large Language Models, NeurIPS 2022(Chinchilla)
- Villalobos et al., arXiv:2211.04325(データ枯渇の推計、ICML 2024)
- Shumailov et al., Nature 631, 755–759 (2024)(モデル崩壊)
- Gerstgrasser et al., arXiv:2404.01413(蓄積すれば崩壊しない、COLM 2024)
SFT・ファインチューニング
- Zhou et al., LIMA: Less Is More for Alignment, arXiv:2305.11206
- Dettmers et al., QLoRA, arXiv:2305.14314
- Xu et al., Magpie, arXiv:2406.08464
- TRL SFTTrainer ドキュメント(loss maskingの現行指定方法): https://huggingface.co/docs/trl/sft_trainer
推論・選好学習
- Rafailov et al., Direct Preference Optimization, arXiv:2305.18290
- Shao et al., DeepSeekMath(GRPO), arXiv:2402.03300
- Zheng et al., Group Sequence Policy Optimization(GSPO), arXiv:2507.18071
- Muennighoff et al., s1: Simple test-time scaling, arXiv:2501.19393
エージェント・ツール利用
- Jimenez et al., SWE-bench, arXiv:2310.06770
- SWE-bench Verified: https://huggingface.co/datasets/SWE-bench/SWE-bench_Verified
- APIGen / xLAM: arXiv:2406.18518
RTL / 検証ドメイン
- ChipNeMo: arXiv:2311.00176
- VeriGen: arXiv:2308.00708 / RTLCoder: arXiv:2312.08617
- VerilogEval v2: arXiv:2408.11053
- CodeV: arXiv:2407.10424 / OriGen: arXiv:2407.16237
- CodeV-R1(QiMeng-CodeV-R1): arXiv:2505.24183
- VeriCoder: arXiv:2504.15659
- CVDP (NVIDIA): arXiv:2506.14074 / https://github.com/NVlabs/cvdp_benchmark
- TuRTLe: arXiv:2504.01986 / https://github.com/HPAI-BSC/TuRTLe
- AssertLLM: arXiv:2402.00386 / FVEval (NVIDIA): arXiv:2410.23299
- VeriRL: arXiv:2508.18462 / VeriMoA: arXiv:2510.27617
RAG vs Fine-tuning
- Ovadia et al., Fine-Tuning or Retrieval?, EMNLP 2024, arXiv:2312.05934
- Liu et al., Lost in the Middle, arXiv:2307.03172
著作権・法制度
- 文化庁「AIと著作権に関する考え方について」(2024年3月、文化審議会著作権分科会法制度小委員会)
- 文化庁「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月)
- 内閣府知的財産戦略本部「AI時代の知的財産権検討会 中間とりまとめ」(2024年5月)
- 人工知能関連技術の研究開発及び活用の推進に関する法律(AI推進法、令和7年法律第53号)
数字の扱いについて
記事中の数値について、確度の差を注記しておきます。
| 項目 | 注意点 |
|---|---|
| 図1のトークン数 | SFT以降は件数で語られるため、1件あたりのトークン数を仮定した概算。厳密な比較ではなく桁の感覚として |
| FineWebのトークン数 | 論文時点で15兆。その後のバージョンで増えているが、正確な現行値は確認できていない |
| FineWeb-Eduのablation | 大規模ablationのモデルサイズは論文で1.71B。本文の1.8Bは丸めた値 |
| OriGenデータの機能テスト通過率 | 53.5%は二次情報。VeriCoder論文でRTLCoderの24.4%は確認できたが、OriGenの値は未確認 |
| AssertLLMのI2C結果 | arXiv版は89%、ASPDAC proceedings版は86%。評価プロパティ数が異なる |
| UnslothのVRAM値 | 開発元の公称値。独立した実測での検証はしていない |
| ベンチマークのpass@1 | 評価設定・温度・サンプル数に強く依存する。異なる論文の数値を横並びにするときは条件を揃える必要がある |
| CVDPの問題数 | 公式は783問だが、第三者論文が部分集合(336問)を参照している例がある |
| TuRTLeの評価モデル数 | 版によって幅がある |
| クローズドモデルの学習トークン数 | 開発元の自己申告値が中心。独立検証は弱い |
| QLoRAのVRAM要件 | 系列長・バッチサイズ・実装(Unsloth等の最適化の有無)で大きく変わる。表の値は目安 |
| ツール返り値のマスク | 実装上の設計原則として広く採られているが、効果を定量比較した一次文献は見当たらなかった |
| 著作権の記述 | 法域と事案に依存する。文化庁の「考え方」にも法的拘束力はない。Perplexity訴訟は係属中で確定判決がない。実際の判断は専門家に確認を |
| SystemVerilogがlow-resourceである点 | The Stack v2の論文にHDLの内訳の明示はない。RTL向け研究がデータ生成から始めている状況からの推定を含む |
商用EDAベンダのLLM製品については、学習データの方針がほとんど公開されていないため、この記事では触れていません。