

はじめに
前回、さらばAIスクラムチームでは、全11本にわたるAIスクラムチームの検証を一旦終了しました。GitHub CopilotでAIエージェントだけのチームを組成し、スクラム開発を回し、改善を重ね、最後には複数AIスクラムチームでの協業まで検証した形です。過去の検証記事は全て上述の前回記事にまとめていますので、よろしければそちらもご覧ください。
……というわけで、帰ってきました。 冒険は続いています!
ただし、今回は以前のチームをそのまま再開したわけではありません。AIスクラムチームに感じていた課題、特に、
- 人間と同じ時間の考え方でAIを動かすことの不自然さ
- 不必要なAI同士の連携によるコスト
このあたりを見直して、新しいAIスクラムチームを作りました。そうです、v2です。
ざっくり言うと、作業を時間ではなくコンテキストで切り、固定メンバーではなく役割と作業でAIエージェントを構成し、品質目標とモデルセットをプロファイルで切り替える形にしました。今回は、この新しいAIスクラムチームをどのような考え方で組み直したのかを紹介します。
なお、まだ検証・改善中ですので、コードは公開しておりません。完成版のご紹介というよりは、第二部の出発点として読んでいただければと思います。いずれはコード含めて公開したいと考えています。
人間のスクラムを再現すると、AIも人間のように困る
前回のAIスクラムチームは、「人間がやっているスクラム開発を、AIだけで再現できるのか」を確かめたくて始めたものでした。そのため、名前を付けたAIメンバーを用意し、1日8時間、5日間で1スプリントという仮想的な時間の中でスクラムを実施してもらいました。
これはこれでとても面白かったです。AI同士で相談し、レビューし、レトロスペクティブで改善策を考え実践していく。想像以上に人間のチームらしく動いてくれました。
その一方で、その「人間らしさ」が邪魔になる場面がちらほらと出てきました。
例えば品質関連作業を増やし続け機能開発の時間が減ったり、増員したAIエージェントのためにありもしないオンボーディング工数を設定したり、仮想的な8時間に作業を収めようと無理にタスクを分解し始めたりもしました。人間のチームであればわかる話なのですが、こちらとしては「いや、AIだしそこは……」となります。
さらに、全員で相談するイベントは、参加するAIを増やすほどやり取りが増えてしまいます。各AIが状況を読み、考え、発言し、その発言を別のAIが読み直す。当然そこにはトークンも時間もかかります。もちろんAI同士の相談が必要なシチュエーションもあるのですが、同じモデル同じエフォート(推論強度)かつ同じコンテキストでディスカッションすると、エコーチェンバーのようになってしまう危惧もあります。
つまり、当然と言えば当然ですが、人間の働き方を再現できることと、それがAIにとって効率の良い働き方であることは別だと思い至りました。
そこで今回は、役割や改善のループといったスクラムの素晴らしい要素を残しつつ、人間の時間や固定メンバーを前提にした部分を見直すことにしました。
時間ではなく、コンテキストで作業を切る
「何時間かかるか」より「何を一緒に考えるか」
今回、最も変えたかったのが作業の単位です。
人間の「この作業は半日くらい」は、ある程度共通の感覚として使えます。一方でAIの場合、モデルやツール、渡す情報、調査の必要性などで作業の進み方が大きく変わります。人間なら数時間かかる作業を一瞬で終えることもあれば、わずかな変更なのに前提の調査や検証を延々と続けることもあります。
もちろん実際の所要時間は重要です。ただ、AIに人間相当の作業時間を見積もらせ、それを仮想的な8時間に詰め込むことが、実際の実行のしやすさにつながるかというと、かなり怪しいと感じていました。
なにより重要となるのは、1つの作業を完了するために、どれだけの情報(コンテキスト)を共通に扱う必要があるかです。
関連のない修正を1つのセッションで次々に実施すると、過去の調査や判断がコンテキストに残りノイズになります。逆に、密接に関係する作業を細切れにしすぎると、そのたびに背景コンテキストを取得しなおし、かつ整合性を確認する必要が出てきます。大きくまとめすぎても、小さく分けすぎても、どちらも上手くいきません。
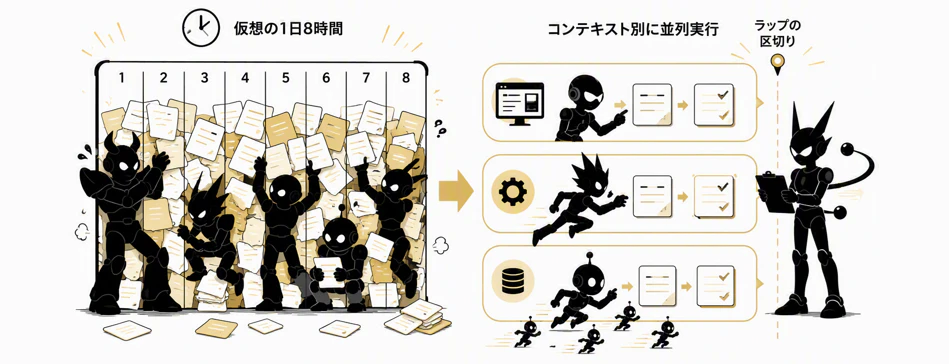
そこで新しいチームでは、作業を「独立した関心事が1つで、単独で検査でき、1セッションで完結できる単位」に分けました。基本は1セッション=1作業単位=1コンテキストです。別の作業に移るときは、そのセッションを使い回しません。
例えば、ある機能の実装とそれを確認するテストは、同じ作業として扱う方が自然です。一方で、その機能と関係のない画面の修正まで同じ担当に続けて渡す必要はありません。また共通のAPIや型に依存するなら、そこを確定してから、独立して進められる作業を並列にした方が効率も良いです。ただし他でも利用する情報は、Issueや決まった場所のファイルに残し、重要な判断などはもちろん共有化します。
なお、コンテキストトークン量を厳密に見積もる仕組みにしたいわけではありません。ストーリーポイントも残しています。一方で、時間換算ではなく、規模・複雑さ・不確実性の相対的な見積もりをAIにさせるようにします。作業時間から独立した作業コンテキストへ、作業分割の判断軸を変えたと考えていただければと思います。
デイリースクラムではなく、ラップスクラム
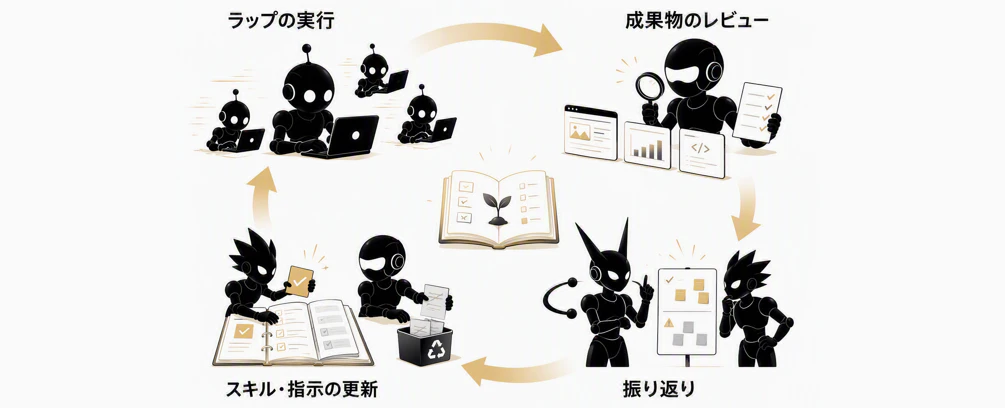
1日という単位を外したため、デイリースクラムもそのままでは使いづらくなります。そこで仮想的な1日の代わりに、1回の実行バッチを「ラップ」と呼ぶことにしました。「今日は8時間作業したから終わり」ではなく、「起動したAIたちの作業が終わったら終わり」というタイミングになります。
そのラップで着手できる作業を選び、依存関係や共有資源がぶつからないものを並列に実行する。区切りで結果や障害を確認し、次のラップを計画する。この検査・適応を「ラップスクラム」としました。「昨日やったこと、今日やること」ではなく、「前のラップでやったこと、このラップでやること」です。
スプリントも、利用者が確認できる到達状態で区切る
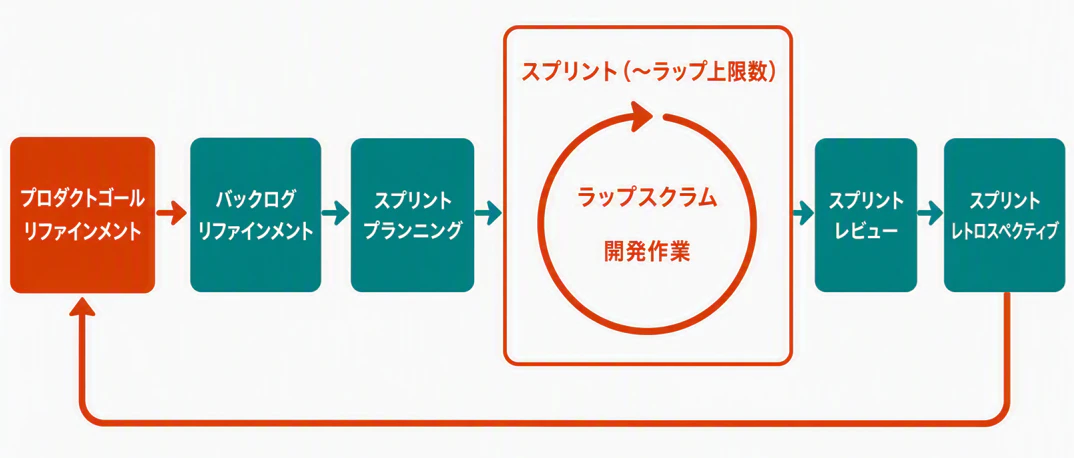
スプリント自体も固定の期間ではなく、利用者が触って確認できる到達状態を1フェーズとし、1フェーズ=1スプリントにしました。例えば「登録したXX情報を検索し、更新して保存できる」という価値のある状態です。
設計だけ、基盤だけではなく、利用者から見た価値で区切ります。スクラムでも、インクリメントは利用可能で完成の定義を満たしたものであることが求められます。今回はその考え方を残しつつ、「固定の期間」ではなく「利用者が確認できる到達状態」をフェーズの区切りにしました。残したいのは価値を届けることなので、そのための区切り方を変えてみた形です。人間の場合、突発的なイベントで時間がなくなり一部を次のスプリントにまわすなんかは良くあることかなと思いますが、AIに人間の勤務時間を模した区切りを課す必要はないので、一貫して終わらせるところまでやらせる形です。
ただしAIの実行時間はもちろん重要です。「達成するまで続ける」だけでは、終わらない可能性があります。そのため計画時に依存関係と並列に起動できる件数から想定ラップ数を出し、設定したラップ数上限を超える大きすぎるフェーズは分割します。実行中に想定ラップ数へ達しても未完了なら、見積もりを改定して続けるか、中止して組み直すかをAIスクラムチームに判断させます。とりあえず計画時のラップ数上限は6にしてみて検証しています。1ラップでだいたい4~8サブエージェントを並列に回す想定なので、1フェーズで多くても40作業前後が計画上限、という感覚です。この数字自体も、振り返りで調整していく対象です。
固定タイムボックスを外しているので、これはスクラムガイドそのままのスクラムではありません。スクラムを土台にした、AIチーム向けの派生運用です。名前は引き続きAIスクラムチームとしていますが、この点は先にお断りしておきます。あえて言うならAIラップスクラムでしょうか。スクラムの検査と適応は残し、区切り方だけをAI側に寄せたというような意味合いです。
まとめると、大きく変えたのは1日の代わりに1ラップで検査・適応することと、固定期間の代わりに利用者が確認できる到達状態でスプリントを区切ることです(下図のオレンジ色部分)。さらに、その到達状態をAIだけで決めないよう、人間とすり合わせる手順を「プロダクトゴールリファインメント」として明示しました。プロダクト全体で目指すものと、直近のフェーズで届けるものを、ここできちんと揃えます。
メンバーではなく、役割と作業を組み合わせる
前回のAIスクラムチームでは、「田中さんにこれをお願いして、伊藤さんにはこちらを」という形でAIエージェントたちを運用していました。名前や性格があると、見ている人間としてはとてもわかりやすく、愛着も湧きます。
ただし今回の仕組みでは、顧客、プロダクトオーナー、スクラムマスター、開発者という役割のみ定義し、必要な作業に応じてセッションを起動する形にしています。同じ開発者ロールであっても、設計作業と実装作業、レビュー作業では、使うモデルやエフォートを変えられるようにします。また必要に応じて多数のエージェントを並列実行することもやりやすくなりました。(前回は、tanaka_1、tanaka_2みたいな分身が生まれることがあり違和感がありました。。。)
「誰にお願いするか」より、**「どの責任を持つAIに、何並列で、何を渡して、何を返してもらうか」**を重視する形です。
今後検証を進める中で、セキュリティ担当など、本当に必要な役割だけは追加していきたいと考えています。
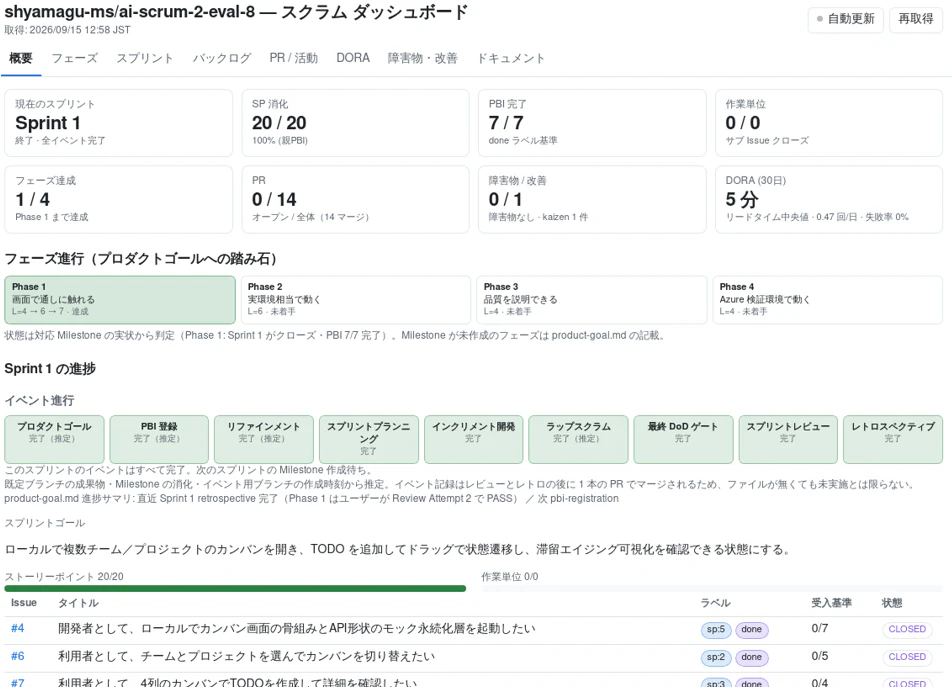
また進捗管理も、前回やったようなcsvとmdといったファイル運用ではなく、今回はGitHubのIssues、Milestones、Labels、PRを中心にしています。バックログはIssue、スプリントはMilestoneで管理し、実装の変更やレビューの履歴はPRにまとめます。なお、計画や振り返りは前回同様決まった場所のファイルに残します。こうすることでGitHub Copilot AppのCanvasなどでAIスクラムダッシュボードなんかも簡単に作れるようになります。下図は検証中のスプリント1終了時にキャプチャしたダッシュボードです。全体の見通しが一発でとれるのでとても良きです。
結果として、擬人化は以前より薄くなりました。少し寂しい気もしますが、キャラクターとしての楽しさと、実行する仕組みは分けて考えても良いかなと思っています。いや、本当に寂しい感じです。でも正しい気がします。
レビューは残す。ただし、何度でもやれば良いわけではない
以前のチームでは、AIの虚偽報告や手抜きに対して、AI同士の相互レビューが有効でした。この考え方は新しいチームでも残しています。レビューでは、実行したAIとは別セッション・別モデルファミリで確認する形です。
一方で、レビューを手厚くすると、レビュアーが「もっと良くできる点」を出し続け、いつまでも完成しないなんてこともあります。品質のための活動なのに、成果を届けるためのブロッカーのようになってしまっては困ります。
そこで今回は、合意した品質目標を満たしたか確認する手順をプロファイルセットとして準備しました。スプリントごとに「軽量・標準・エンタープライズ」という品質プロファイルを選び、どの段階で、どこまで検証・独立レビューするかを明示的に指示するようにします。
例えば軽量では、作業単位では自己検証と対象テストを行い、独立レビューはバックログ項目の完了時の1回に絞ります。一方、エンタープライズでは各作業単位にも全検証と独立レビューを置きます。これは「軽量だから要求を満たさなくて良い」という話ではありません。品質目標を勝手に下げず、証跡を取る場所と回数をスプリント単位で調整するための仕組みです。
レビューの指摘も、受入基準や完成の定義に違反するものと、それ以外の改善案に分けました。前者は修正しますが、後者は別のバックログ項目にするか、理由を付けて見送ります。レビューの場で、依頼していない要件を増やさないためです。特に最近のフロンティア級のモデルだと指摘が永遠のように続くなんていうこともあるので気を付けたいところです。
きちんと疑うことと、際限なく疑い続けることは違います。このあたりは、前回のAIスクラムチームで品質向上活動が積み上がったことへの対策でもあります。
AIに任せる前に、人間と到達点を揃える
もう1つ大事にしたいのが、「何を作るか」をAIだけで膨らませないことです。
AIは曖昧な指示を補ってくれるため、とても助かります。一方で「まずは簡単に動くものがほしい」と頼んだのに、立派な将来構想と大量のタスクが出来上がることもありますし、異常に細かい粒度での検証テストを揃えだしたりもします。間違いではないのですが、今そこまで求めていない、というやつです。
新しいチームでは、プロダクトゴールを決める際に、人間と対話する手順を明示しています(前述のプロダクトゴールリファインメント)。誰の課題なのか、何を達成したいのか、どの順番で進めるのか。そして直近のフェーズについては、動かす環境、機能、非機能、品質目標、レビューで見せるもの、対象外まで人間とAIスクラムチームで合意します。もちろんAI顧客のサポートはあるものの、ここが価値を決める最も重要なポイントだと考えています。
またレビューでは、必要なものが足りないだけでなく、不要なものを作りすぎていないかも確認します。次のフェーズも最初の計画をそのまま実行するのではなく、レビューの結果から組み替えていきます。
人間が毎回細かな実装を追いかけるのではなく、到達点と判断が必要な部分を押さえる。前回のAIスクラムチーム検証では、人間の認知負荷がかなり高かったため、この境界はきちんと設計しておきたいところです。
改善するチームは、そのまま残したい
ここまで色々変えましたが、以前のチームで一番残したかったのは、レトロスペクティブを通じた改善です。
ナレッジをまとめた回でも紹介したように、AIたちは設計を先に揃えたり、テストを先行させたり、並列開発の環境を分離したりと、様々な改善を積み重ねていました。失敗を次の作業へ反映し、チームの動きが変わっていくところは、見ているだけでワクワクしました。
今回は成果物の内容はもちろんのこと、想定と実際のラップ数の差、モデルの利用量、レビューの回数なども振り返る仕組みにしています。フェーズが大きすぎたのか、依存関係で待っていたのか、レビューを往復しすぎたのか。同じ「遅い」でも、原因によって変えるべきものは違います。
そして、改善策を記録して終わりにせず、実際の指示やスキル、モデル割当へ反映することを完了条件にしました。「次回から気を付けます」と書いても、次のセッションがその内容を知らなければ何も変わりません。
逆に、不要になったルールを減らすことも振り返りに含めています。改善のたびに注意書きを増やすだけでは、読ませるコンテキストも運用も重くなります。前のチームでもプロンプトの文章量は増えがちだったため、ここは最初から意識しています。
AIが長期記憶を持つ1人の社員として成長するというより、次のAIが使うプロセスとコンテキストを育てることで、チームとして改善していく形を目指しています。
モデルを組み替えて、期待するコストと成果物に近づける
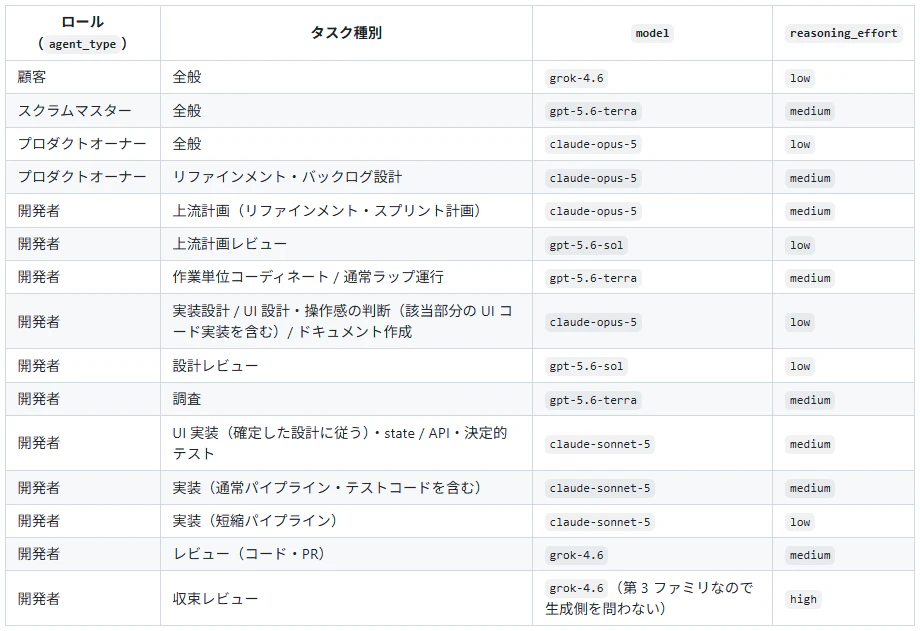
今回のAIスクラムチームでは、役割と作業の種類に対して、モデルと推論の強さを割り当てる表を用意しています。前回はイベントに相当するAgent Skillsの中で、どのエージェントをどのモデルとエフォートで動かすかを明記していました。しかしこれでは、新しいモデルが出たときの差し替えや、モデルの組み合わせの比較・管理がやりづらく、1つの表へ統合することにした形です。
このエージェントモデルの割当を、品質重視やバランス重視、コスト重視といったプロファイルとして、まとめて切り替えられるようにしました。以下はバランス重視の場合の、各エージェントのモデル割当表です。
もちろん、安いモデルへ変えればそのまま得になるとは限りません。期待に満たない成果物になってしまうことはもちろん、差し戻しややり直しが増えれば、結果として高くなる可能性すらあります。反対に、単純な仕事へ常に最上位のフロンティアモデルを使う必要もないはずです。
ここはまだ検証を進めているところですが、品質プロファイルとモデルセットを組み替えることで、期待するコストと成果物へ近づけられそうだと感じています。例えば、フロンティア級のモデルだけで数万円かけても期待に届かなかったケースがある一方、安いモデルを組み合わせて1万円以下で期待を満たしたケースもありました。ただし、条件を揃えた比較ではないので、「安いモデルの方が優秀だった」とは言えません。今のところは、最上位のモデルを並べればそれで良い、というほど単純ではなさそうだ、という感触です。下の画像は、バランス重視のモデルセットで1スプリントを走らせた際の、各セッションの実行状況と利用量です。
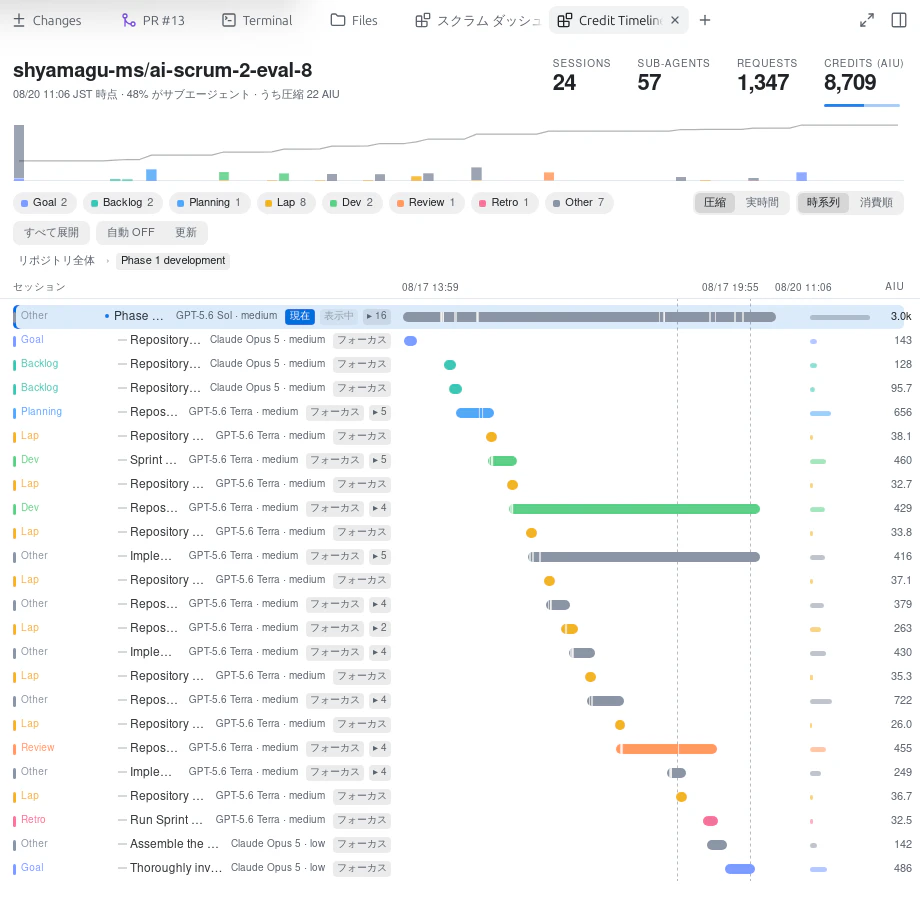
この実行の成果物には手応えがある一方、まだコストを抑える余地はありそうです。先に紹介した品質プロファイルとモデルセットの両方を、目的に合わせて調整していく検証をしています。
AIスクラムチーム、第二部へ
今回の新しいAIスクラムチームは、人間のスクラムを忠実に再現するところから、AIの特性に合わせて作業を進めるところへ、一歩踏み込んだものです。
時間ではなくコンテキストで作業を分け、必要な連携と検証は残し、重すぎる連携は減らす。そして結果を見て、チームの進め方自体を改善する。前回挙げた課題への対策を、今回は仕組みの側へ入れ直しました。もちろん、これですべて解決というわけではありません。ただ、現時点で検証している範囲では、前回引っかかっていた部分は確実に軽くなっている手応えがあります。とはいえ、細かな実装を追う負担を減らす代わりに、到達点を合意するための関与は増えています。総合的な人間の負荷については検証を通じて確認・改善していきたいポイントです。
一方で、実際の業務で使う場合は、必ずしも「AIスクラムチーム」を組む必要はないと感じています。
例えば、小規模なPoC開発や問い合わせ対応フロー、実装から設計書のリバース作成と整合性の確認、定期的な運用状況の分析など、もっと特定のプロセスにフォーカスしたAIチームにすれば、役割も入力も合格条件も絞れます。そこへ必要なレビューや人間の承認を入れる方が、業務として扱いやすいケースは多そうです。少なくとも、何をもって「うまくできた」とするかは、かなり明確になります。精度やコストも、その条件の中で改善していく方が進めやすいのではないかと考えています。
このAIスクラムチームは、汎用的なプロセスを実現するため、役割分担、モデル組合せ、コンテキスト分離、品質基準、改善ループを試す場としても、引き続き価値があると考えています。汎用的なチームで学んだものを、具体的な業務プロセスへ必要な部分だけ持って行ければと思います。
というわけで、AIスクラムチームの第二部を始めます。人間の都合で前回ほどのペースは難しい状況ですが、面白い結果や知見などは逐次共有できればと考えています。
今度はもう少し、AIらしい働き方で。
追伸) 新しいモデルがどんどん出てきています
この記事の執筆中にも、Opus5.5やGPT6 AstraやLunaなどの新しいモデルが続々と出てきています。そのためモデルの組み合わせについては検証方法を含めて考えないといけないなと感じています。
特に、今回ご紹介したAIラップスクラムのハーネスやループ設計といったところが、今後も増え続けるモデルにすぐに対応できるようにすべく、もっともっと軽量化していきたいと考えています。……というわけで、コードの公開はちょっと遅れそうです。ご容赦ください。