


Data Lake、Data Warehouse、Iceberg、RDBMS、Vector Search。
それぞれの役割は分かっていても、実際の設計で迷うのは、「どのデータを、どこに置くか」 です。
原本は Object Storage に残すのか。Iceberg で複数のエンジンから共有するのか。頻繁に JOIN するデータは Database に寄せるのか。PDF や SharePoint 文書を RAG で使う場合、Chunk、Embedding、Metadata はどこで管理するのか。
データ活用の世界では、構造化された業務データを管理する Data Warehouse と、大量・多様なデータを扱う Big Data が、長い間それぞれの文脈で発展してきました。その受け皿として Data Lake が登場し、現在は Data Lake の柔軟性と Data Warehouse の管理性・性能を組み合わせる Lakehouse が注目されています。
Oracle Autonomous AI Lakehouse を軸に整理していくと、単純な「Data Lake か Database か」という二択ではなく、データの用途、成熟度、アクセス頻度、共有範囲に応じて配置を考えることが重要だと分かります。
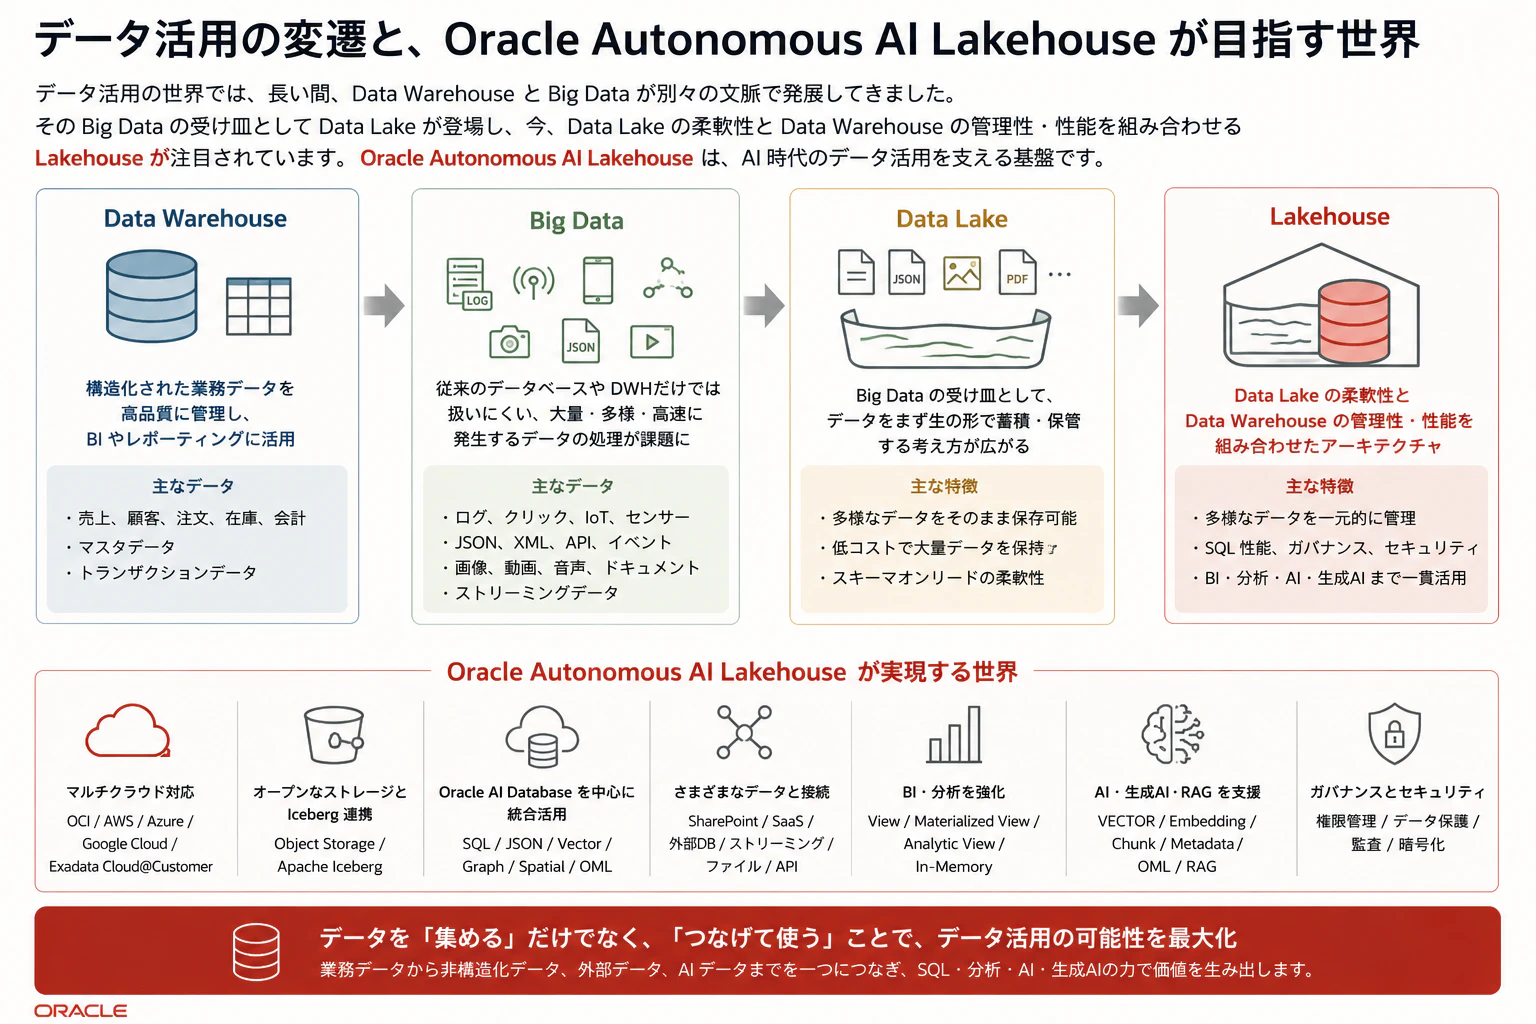
ということで今回は、2026年9月時点の Oracle 公式情報をもとに、Lakehouse で扱うデータと接続方法、そして実際に「どこに何を置くとよいか」を整理してみてみます。
本稿は実機による性能比較ではなく、Oracle 公式ドキュメントをもとにアーキテクチャとデータ配置方針を整理した記事です。
なお本稿では、データベースエンジンの機能を指す場合は Oracle AI Database、Autonomous 固有のサービスや機能を指す場合は Autonomous AI Database と表記します。
1. Lakehouse で扱うデータ
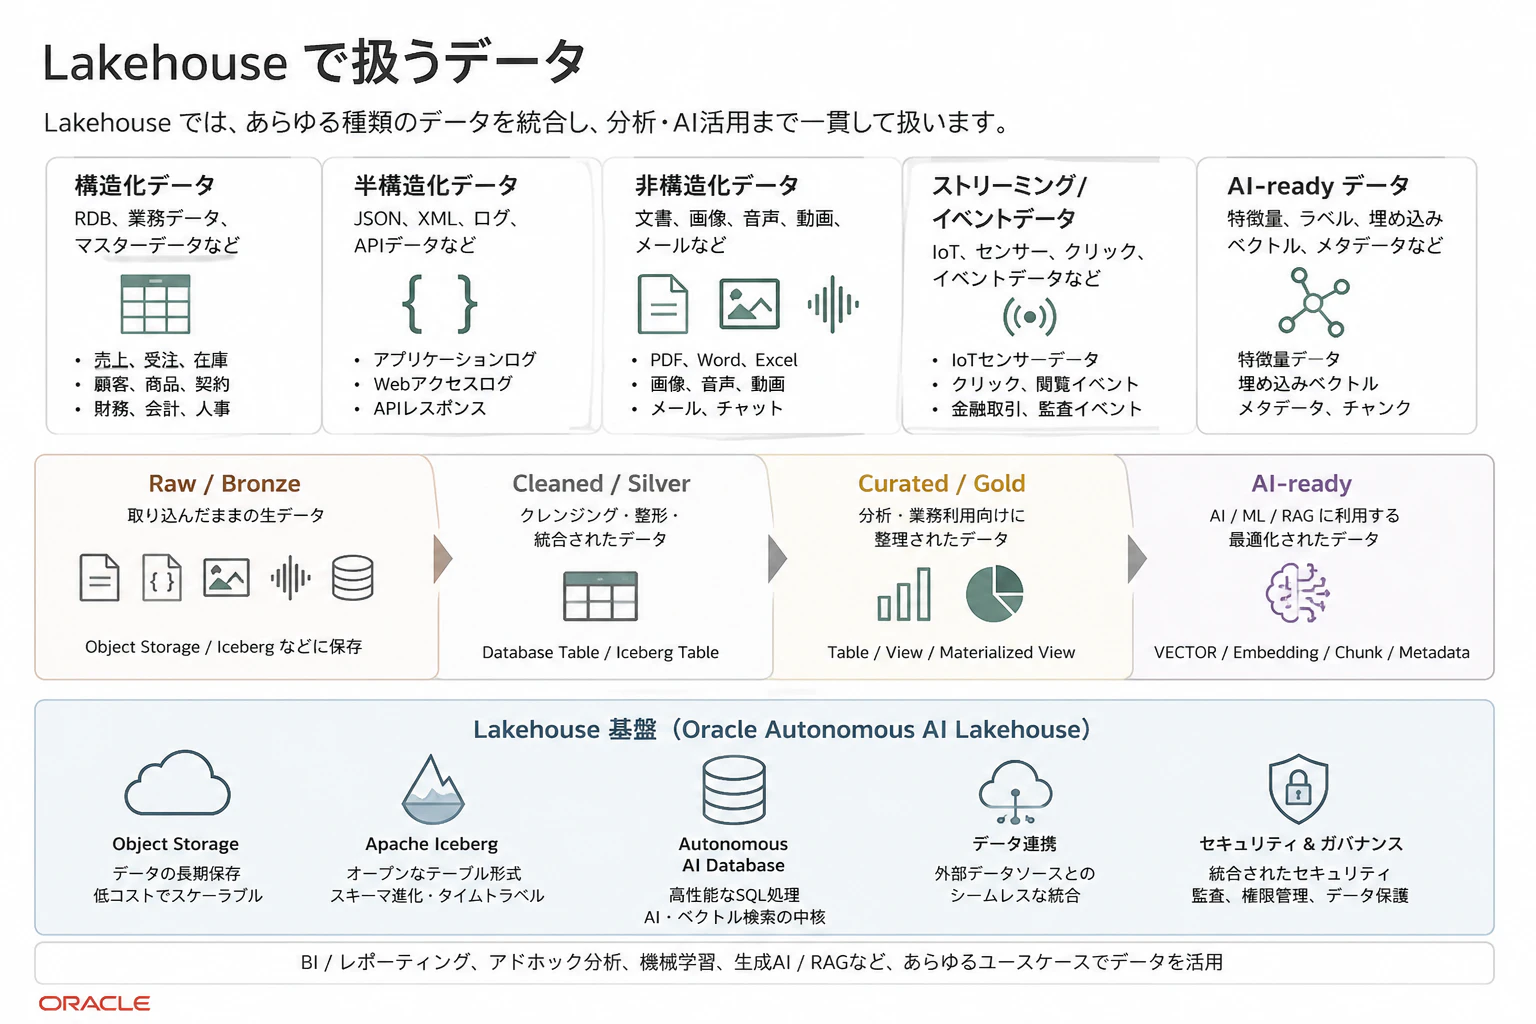
Lakehouse で扱うデータは、一言でいうと かなり幅広いです。
従来の Data Warehouse では、売上、顧客、注文、在庫、会計などの構造化データが中心でした。一方で Lakehouse では、構造化データに加えて、JSON、ログ、PDF、画像、音声、動画、IoT、イベント、Embedding なども扱います。
Oracle のドキュメントでも、Lakehouse は CSV や Parquet、Iceberg などのオープンなファイル・テーブル形式を利用し、構造化、半構造化、非構造化データを格納・処理するものとして説明されています。また、PDF、Word、画像などの非構造化データも Lakehouse の対象として挙げられています。
参考: Autonomous AI Lakehouse - Oracle Documentation
ここではまず「データの形」として、構造化・半構造化・非構造化の3つに分けます。
そのうえで、実務でよく登場するデータを用途と成熟度で整理すると、次のようになります。
データの形        → 構造化 / 半構造化 / 非構造化
実務上の分類      → 業務データ / ログ / IoT / 外部データ / 文書 / AIデータ
データの成熟度    → Bronze / Silver / Gold / AI-ready
データの形
| データ種別 | 具体例 | 主な用途 |
|---|---|---|
|
構造化データ 表形式で管理しやすいデータ |
売上、顧客、注文、在庫、会計、人事 | BI、KPI、レポート、業務分析 |
|
半構造化データ ある程度構造はあるが表に固定されないデータ |
JSON、XML、API レスポンス、アプリログ | イベント分析、アプリ分析、データ統合 |
|
非構造化データ 表形式にしにくいデータ |
PDF、Word、画像、音声、動画、メール | 検索、要約、RAG、AI 分析 |
Lakehouse の特徴は、この3種類をまとめて扱える点です。従来の DWH は構造化データが中心でしたが、Lakehouse ではログ、ファイル、画像、AI 向けデータなども対象になります。
実務でよく使われるデータ
| 種類 | 具体例 | 主な用途 |
|---|---|---|
| 業務・マスタ・トランザクション | 受注、売上、請求、顧客、契約、在庫、商品マスタ | BI、KPI、経営分析、データ統合 |
| ログ・イベント・ストリーミング | アプリログ、監査ログ、クリック、CDC、Kafka イベント | 障害分析、行動分析、即時検知 |
| IoT・地理空間 | 温度、圧力、振動、GPS、住所、配送ルート | 予兆保全、設備監視、物流最適化 |
| 外部データ | 天気、市場データ、人口統計、SNS、パートナーデータ | 需要予測、リスク分析、補助データ |
| 文書・画像・音声・動画 | PDF、契約書、仕様書、製品画像、通話録音 | 検索、要約、品質検査、生成 AI、RAG |
| AI・機械学習用データ | 特徴量、ラベル、学習データ、推論結果、Embedding | モデル学習、MLOps、セマンティック検索 |
ここで重要なのは、データの種類だけでなく、データの成熟度も分けて考えることです。
Lakehouse の世界では、Bronze / Silver / Gold というレイヤーでデータを整理する考え方がよく使われます。Databricks の Medallion Architecture では、Bronze は Raw、Silver は validated、Gold は enriched というように、データ品質の段階として説明されています。
参考: Databricks Medallion Architecture
Oracle Autonomous AI Lakehouse で考える場合も、この整理は非常に使いやすいです。ただし、Bronze / Silver / Gold は Oracle 固有の公式レイヤーではありません。本稿ではデータ配置を考えるための補助線として利用し、さらに AI・ML・RAG で使いやすい派生データを、独自の整理として AI-ready レイヤーに加えます。
Bronze / Silver / Gold + AI-ready のレイヤー
| レイヤー | データの状態 | 主な保存先 | 形式・実装例 |
|---|---|---|---|
| Raw / Bronze | 取り込んだままの生データ | Object Storage、SharePoint | Parquet、CSV、JSON、PDF、ログ |
| Cleaned / Silver | クレンジング、型変換、重複排除、結合済みデータ | Object Storage、Oracle AI Database | Iceberg Table、Database Table |
| Curated / Gold | BI や業務利用向けに整理されたデータ | Oracle AI Database、Object Storage | Table、View、Materialized View、Analytic View、Iceberg Table |
| Feature / AI-ready | AI / ML / RAG で使いやすい派生データ | 主に Oracle AI Database | VECTOR 列、Embedding Table、Chunk Table、Metadata Table |
つまり Lakehouse では、単に「いろいろなデータを置ける」だけでは不十分です。
生データ → 整形済みデータ → 分析用データ → AI 活用データ
のように段階的に管理することが多いです。
大切なのは、
生データを保持すること、
分析しやすい形に整えること、
業務で使える意味のあるデータにすること、
そして AI が使える形に変換することです。
まとめると、Lakehouse は DWH 的な業務データと Data Lake 的な多様な生データをまとめて扱い、BI、分析、機械学習、生成 AI、RAG へつなげる基盤です。
2. Oracle AI Database から見る Lakehouse
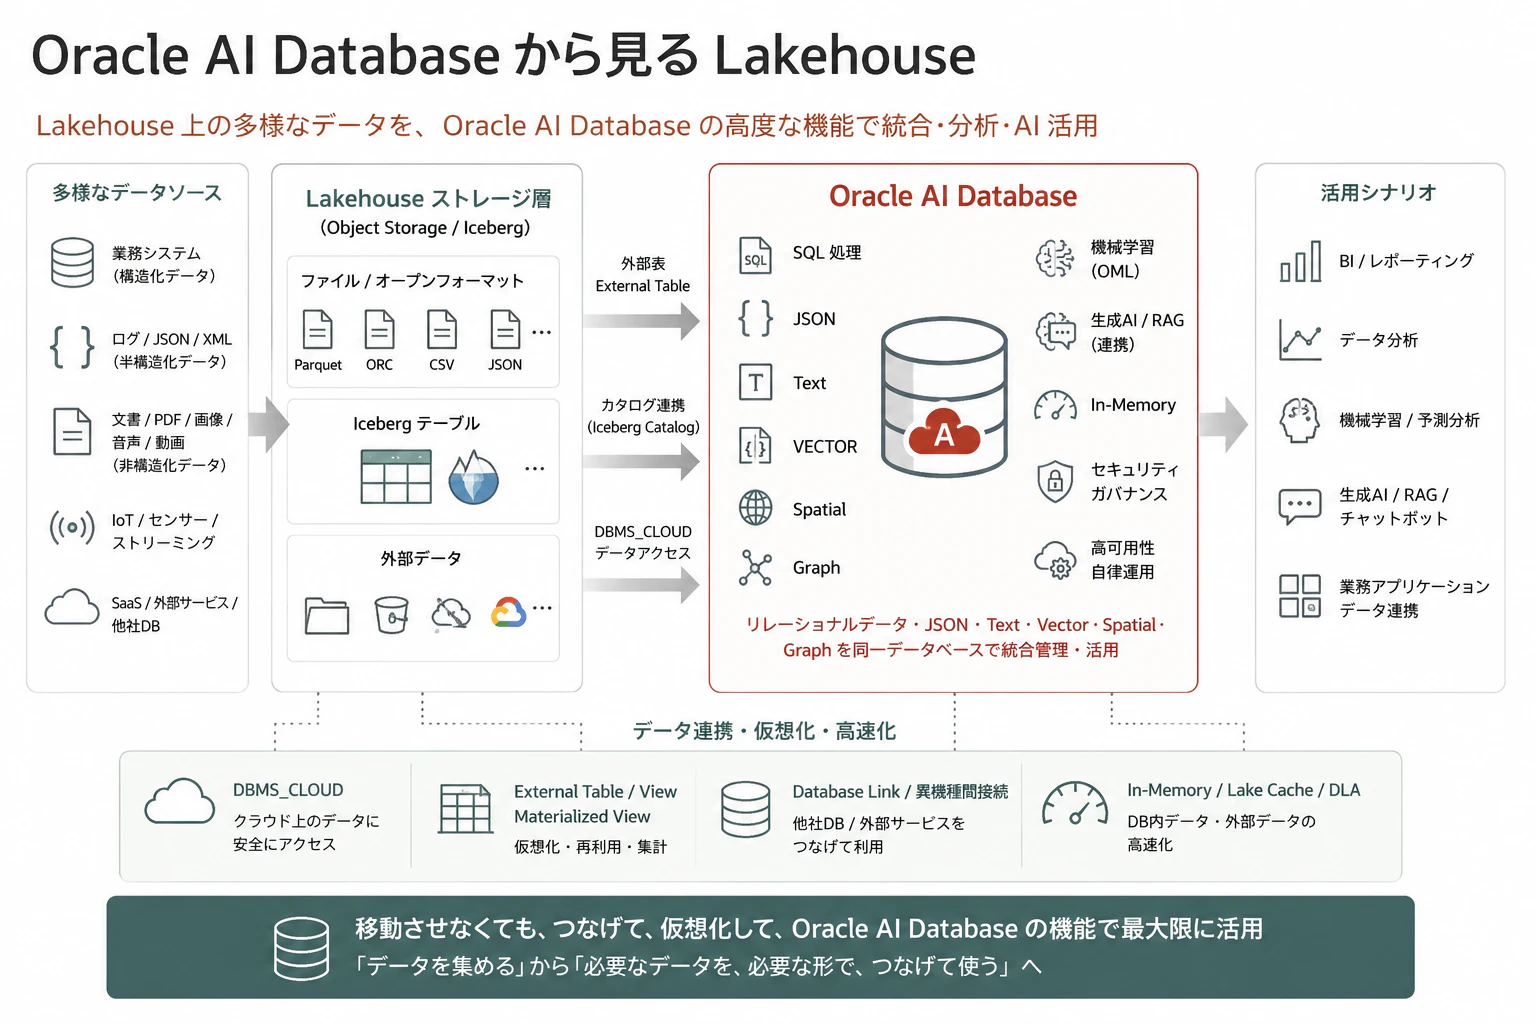
Oracle AI Database から Lakehouse を見ると、少し面白い見方ができます。
一般的な説明では、Lakehouse は Object Storage や Iceberg のようなストレージ層を中心に語られることが多いです。しかし Oracle の場合、Database 側が非常に強力です。Oracle Autonomous AI Database は、JSON、Graph、Vector、Oracle Machine Learning、Spatial などを扱える統合的なデータ基盤として位置づけられています。
参考: Autonomous AI Lakehouse - Oracle Documentation
つまり、Oracle AI Database は単なる「構造化データを入れる箱」ではありません。
Oracle AI Database では、リレーショナルデータだけでなく、JSON、Text、Vector、Spatial、Graph などを同じ Database の中で扱えます。特に JSON については、トランザクション、索引、宣言的な SQL クエリ、View などのリレーショナルデータベース機能と組み合わせてネイティブに扱えます。さらに、JSON データをリレーショナルデータと JOIN したり、外部表上の JSON を Database 内から問い合わせたりできます。
参考: JSON in Oracle AI Database
AI の観点では、Oracle AI Vector Search が重要です。Oracle AI Database 26ai では VECTOR データ型により、Embedding を業務データと同じ Database 内に格納できます。非構造化データを Embedding に変換し、セマンティック検索や RAG に利用できます。
参考: Oracle AI Vector Search Overview
この点が、Oracle らしい Lakehouse の特徴です。
Lakehouse の構成によっては、
- Lake にデータを置く
- 別のエンジンで分析する
- 別の Vector DB に Embedding を置く
というように、複数のコンポーネントを組み合わせることが多くなります。
一方で Oracle AI Database を使う場合は、次のように考えられます。
Object Storage / SharePoint / 外部 DB・SaaS
        ↓
External Table / Iceberg REST Catalog / DBMS_CLOUD / Database Link
        ↓
Oracle AI Database
        ↓
SQL / JSON / Text / Vector / Spatial / Graph / ML / BI / RAG
もちろん、すべてのデータを Database 内にコピーする必要はありません。Object Storage 上のファイルは外部表として問い合わせられます。Autonomous AI Database では、DBMS_CLOUD.CREATE_EXTERNAL_TABLE を使って Cloud 上のファイルに対する外部表を作成でき、OCI Object Storage、Azure Blob / ADLS、Amazon S3、Google Cloud Storage 互換ストレージなどが対象に含まれます。
参考: Query External Data with Autonomous Database
そのため、Oracle AI Database から見る Lakehouse は、次のように捉えると分かりやすいです。
Lakehouse ストレージ上のデータを、Oracle AI Database の SQL、ガバナンス、View、Materialized View、JSON、Vector、Text、Graph、Spatial、AI 機能で活用するアーキテクチャ
性能面では In-Memory も重要です。Autonomous AI Database の Database In-Memory は、リアルタイム分析や混在ワークロードの性能改善を目的とした機能で、テーブル、パーティション、サブパーティション、Materialized View、さらに外部表も In-Memory 化の対象として説明されています。そのため、In-Memory は「保存先」ではなく、高速化レイヤーとして考えることができます。
また、Autonomous AI Database には、外部データアクセスを高速化する Lake Cache と Data Lake Accelerator(DLA)があります。目的は共通していますが、Lake Cache は頻繁に参照する外部データを Database 内へキャッシュし、DLA は Oracle-managed VM cluster の追加コンピュートによって大規模な外部データのスキャンと処理を高速化する点が異なります。
高速化レイヤー
| 機能 | 主な役割 | 仕組み | 適したユースケース | 主な前提・制約 |
|---|---|---|---|---|
| In-Memory | Database 内データの分析高速化 | Table、Partition、Materialized View、外部表などを In-Memory Column Store に列形式で保持する | ホットデータ、繰り返し実行される分析、集計、JOIN | Autonomous AI Database では ECPU モデル、最低 16 ECPU |
| Lake Cache | 外部データの繰り返しアクセス高速化 | 外部表や Mounted Catalog Table のデータを Autonomous AI Database 内にローカルキャッシュする | 定期ダッシュボード、定型レポート、同じ外部データの反復参照 | Oracle AI Database 26ai でサポート。キャッシュ領域と更新方法の設計が必要 |
| Data Lake Accelerator | 大規模な外部データスキャンの高速化 | Oracle-managed VM cluster の追加コンピュートで外部データのスキャンと処理を高速化する | 大規模履歴データ、アドホック分析、広範囲スキャン | 現時点の対応は OCI、Azure、GCP。32~1024 ECPU、実割当分を課金 |
参考:
- Use Database In-Memory with Autonomous AI Database
- Use Lake Cache to Improve Performance for External Tables and Mounted Catalog Tables
- Data Lake Accelerator
3. Oracle Autonomous AI Lakehouse とは何か
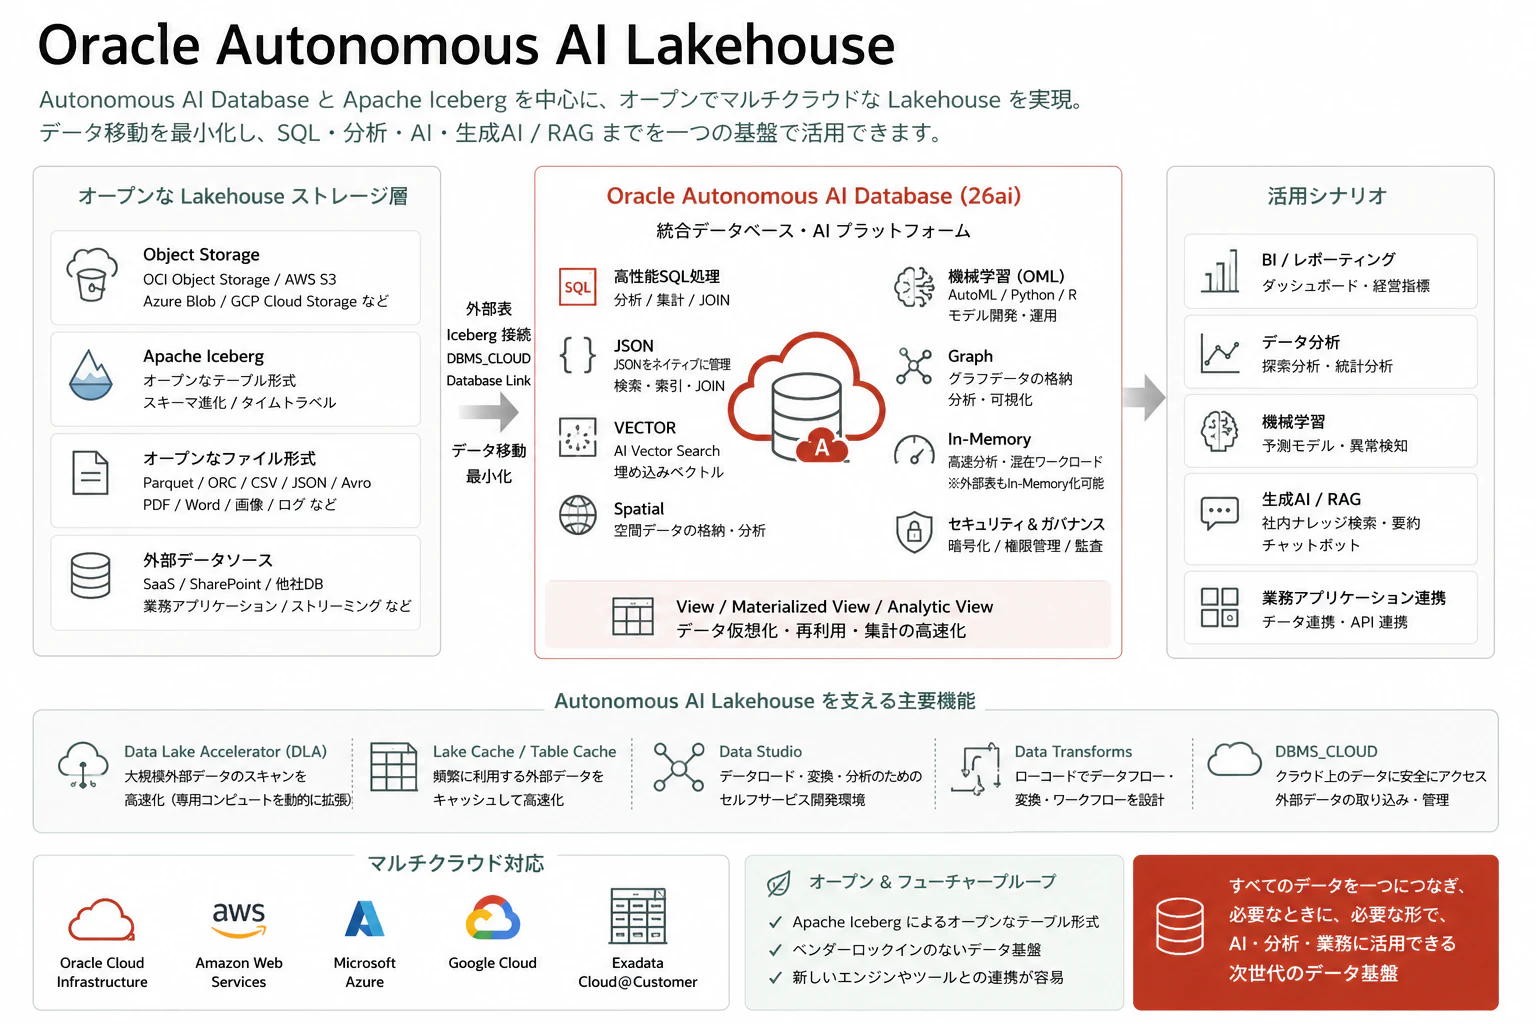
Oracle Autonomous AI Lakehouse は、Oracle Autonomous AI Database と Apache Iceberg を組み合わせた、オープンでマルチクラウド対応の Lakehouse プラットフォームとして位置づけられています。Oracle の製品ページでは、Autonomous AI Database とベンダー非依存の Apache Iceberg を組み合わせ、OCI、AWS、Azure、Google Cloud、Exadata Cloud@Customer 上のデータに対して AI と分析を実行できると説明されています。
参考: Oracle Autonomous AI Lakehouse
この説明で重要なのは、Iceberg です。
Apache Iceberg は、オープンなテーブル形式です。データを特定ベンダーの閉じた形式に閉じ込めるのではなく、複数のエンジンから読み書きしやすい形で管理するための重要な技術です。
Oracle Autonomous AI Lakehouse では、Iceberg テーブルをその場で問い合わせることができます。Oracle のドキュメントでは、Autonomous AI Database が Apache Iceberg テーブルの問い合わせをサポートしており、AWS Glue、Snowflake Polaris、Databricks Unity Catalog、JSON metadata などの構成にも触れられています。
参考: Query External Data in Apache Iceberg Format
Oracle の製品ページでは、Autonomous AI Lakehouse は Iceberg を通じて各クラウド上のオープンデータプラットフォームと統合し、Oracle AI Database 26ai の AI、機械学習、Graph、Spatial などを、事前に Database Table へコピーせずに利用できると説明されています。また、Data Lake Accelerator や Lake Cache により、外部データアクセスの性能向上も図れるとされています。
参考: Oracle Autonomous AI Lakehouse
ここでいう「データ移動なし」は、データをあらかじめ別の保存先へ複製しなくてよいという意味です。実際の問い合わせではネットワークを通じてデータを読み取るため、クロスクラウド構成ではレイテンシ、データ転送料、帯域、問い合わせ頻度も考慮する必要があります。
さらに、Oracle Autonomous AI Lakehouse で注目したいのが、Iceberg REST Catalog との統合です。
Autonomous AI Database Serverless では、2026年6月23日のアップデートで、DBMS_DCAT PL/SQL 26ai パッケージから Databricks Unity Catalog や Polaris などの Iceberg REST 互換カタログへ接続し、外部表として同期・問い合わせできるようになりました。
参考: Iceberg REST Catalog Integration with DBMS_DCAT
これは、とてもすごいことです。
なぜなら、Lakehouse の世界では、単に Parquet や Iceberg ファイルを Object Storage に置くだけでなく、「どのテーブルがどこにあり、どのスキーマで、どの権限で、どのエンジンから使えるか」を管理する Catalog が重要になるためです。
Iceberg REST Catalog に対応することで、Oracle Autonomous AI Lakehouse は、Oracle 内に閉じることなく、オープンなテーブル形式と外部カタログを利用したデータ活用へ参加できます。
つまり、Oracle AI Database から見る Lakehouse は、Oracle 内に閉じたデータ基盤ではなく、Databricks、Snowflake、AWS、OCI、Object Storage、Iceberg Catalog などとつながる、よりオープンなデータ活用基盤として考えることができます。
ここから見えてくるのは、Autonomous AI Lakehouse が単なる「データ保管場所」ではないということです。
むしろ、次のような役割を持ちます。
オープンな Lakehouse ストレージ
  - Object Storage
  - Apache Iceberg
  - Parquet / ORC / CSV / JSON
  - PDF / Word / 画像 / ログ

Oracle Autonomous AI Database
  - SQL
  - JSON
  - Text
  - Vector Search
  - Machine Learning
  - Graph
  - Spatial
  - View / Materialized View
  - In-Memory
  - Data Studio
  - Data Transforms

利用先
  - BI
  - レポート
  - データ分析
  - 機械学習
  - 生成 AI
  - RAG
  - 業務アプリケーション
つまり、Oracle Autonomous AI Lakehouse は、次のように考えるとよいと思います。
Open Lakehouse Storage と Oracle AI Database の統合により、分散したデータを SQL、BI、AI、RAG で活用するための基盤
4. Autonomous AI Database で広がるデータ接続
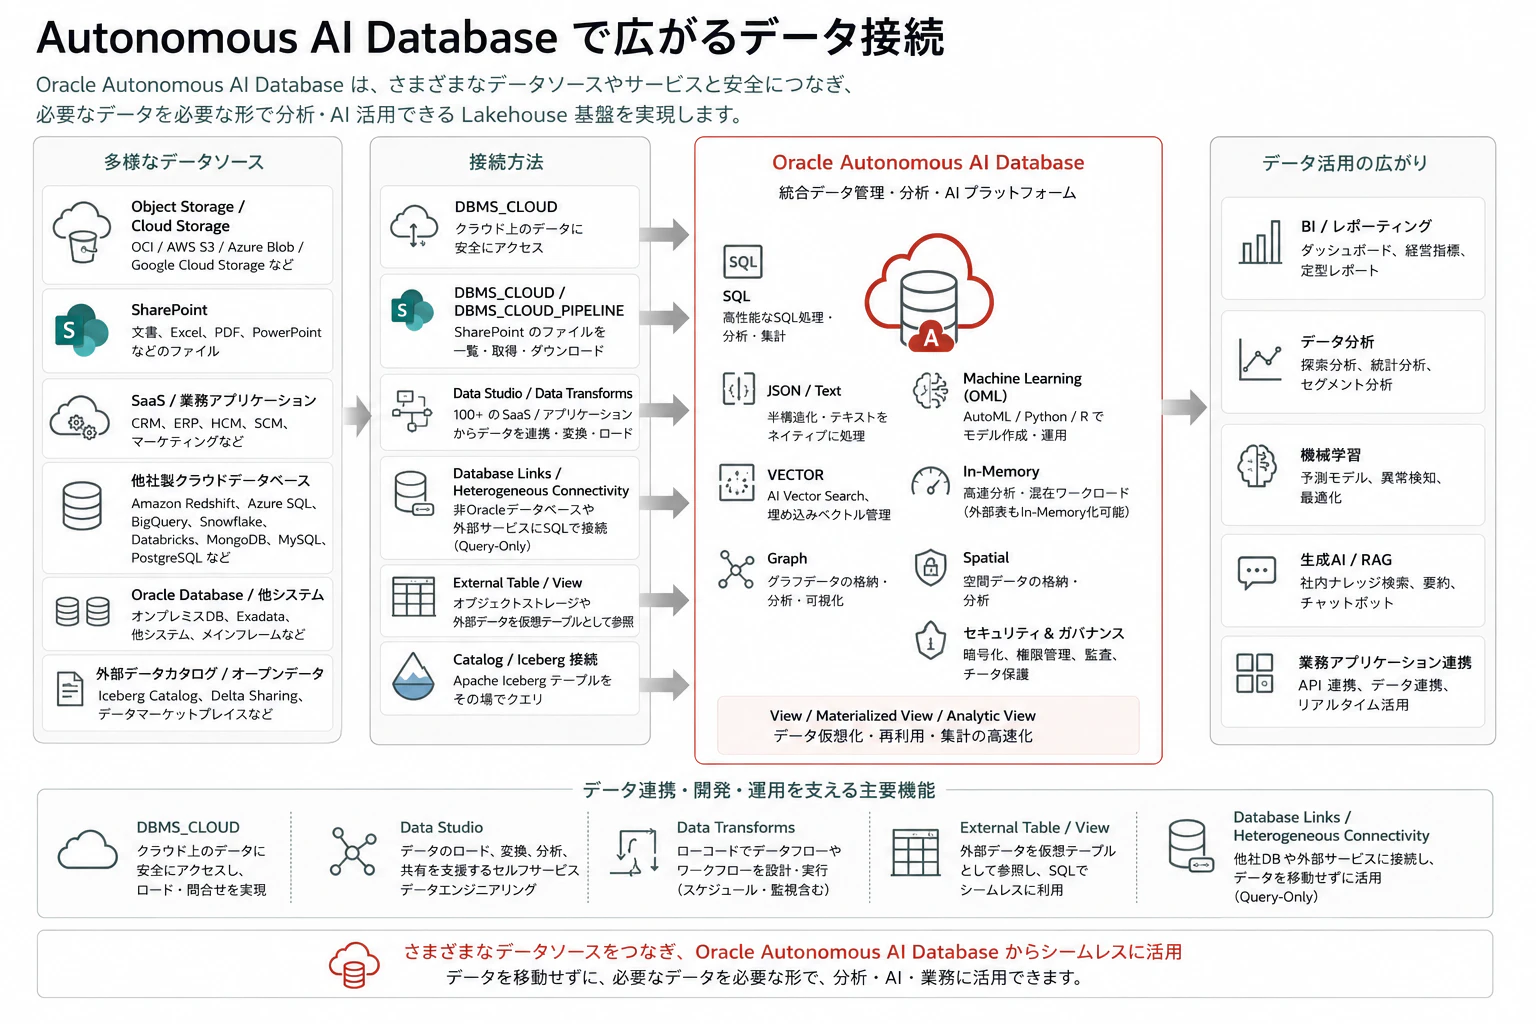
Oracle Autonomous AI Lakehouse の面白さは、Object Storage や Iceberg だけではありません。
Autonomous AI Database を中心に見ると、接続できるデータの範囲がかなり広がります。
対象は、クラウドストレージ、SharePoint、SaaS、業務アプリケーション、他社製クラウドデータベース、Oracle Database、外部データカタログなど、多岐にわたります。
さらに、Autonomous AI Database では Oracle-managed heterogeneous connectivity により、
非 Oracle データベースや一部の外部サービスに対して Database Link 経由で問い合わせる構成を取ることができます。
Oracle の製品ページでも、Autonomous AI Lakehouse はオープンテーブル形式や多数のデータベース・アプリケーションソースに接続し、構造化、半構造化、非構造化データをネイティブにサポートする統合分析プラットフォームとして説明されています。
参考: Oracle Autonomous AI Lakehouse
Object Storage / Cloud Storage
まず基本となるのは Object Storage です。
Raw / Bronze のデータ、つまり生ログ、CSV、JSON、Parquet、ORC、Avro、PDF、画像などは、Object Storage に置くのが自然です。Autonomous AI Database からは、外部表や DBMS_CLOUD を通じてこれらのデータを参照できます。
すべてのデータを最初から Database にロードする必要はありません。
必要に応じて、外部表として問い合わせる、ロードして Database Table にする、Materialized View で集計する、といった選択ができます。
SharePoint
業務データ活用で非常に面白いのが SharePoint 連携です。
多くの企業では、重要な情報がデータベースではなく、SharePoint 上の Word、Excel、PDF、PowerPoint に存在しています。従来、これらは分析基盤から見ると扱いにくいデータでした。
Autonomous AI Database では、DBMS_CLOUD と DBMS_CLOUD_PIPELINE を使って Microsoft SharePoint 上のファイルにアクセスできます。Oracle のドキュメントでは、SharePoint 上のファイルを list / retrieve し、外部コンテンツをダウンロードして後続の分析や索引作成に利用できると説明されています。さらに、DBMS_CLOUD_AI.CREATE_VECTOR_INDEX を使って SharePoint ファイルから直接 Vector Index を作成する例も示されています。
参考: Use DBMS_CLOUD with Microsoft SharePoint
これは Lakehouse の文脈ではかなり重要です。
なぜなら、SharePoint 上の文書を単なるファイルとして放置するのではなく、抽出テキスト、チャンク、Embedding、Metadata として Oracle AI Database 側に取り込み、RAG やセマンティック検索につなげられるからです。
ただし、SharePoint 文書を RAG 化する場合は、文書の取得だけでなく、SharePoint 側の閲覧権限をどのように同期し、検索時にフィルタリングするかも別途設計する必要があります。Access Control Metadata を保持するだけでなく、検索結果へ確実に権限制御を適用することが重要です。
SaaS / 業務アプリケーション
SaaS や業務アプリケーションとの接続も重要です。
Oracle Autonomous AI Lakehouse の Data Studio は、データのロード、変換、分析、共有を支援するセルフサービスのデータエンジニアリング機能として位置づけられています。Oracle の製品ページでは、Data Studio により、100 以上のアプリケーション、クラウドサービス、データベースソースと統合できると説明されています。
参考: Oracle Autonomous AI Lakehouse
また Data Transforms は、Autonomous AI Database 向けにデータロード、データフロー、ワークフローをローコードで設計するための機能です。データロード、結合、フィルタ、集計、マッピング、スケジュール、監視などを GUI ベースで扱えるため、SaaS データや業務アプリケーションデータを Lakehouse に取り込む際の実装手段になります。
参考: About Data Transforms
他社製クラウドデータベース / 異機種間接続
さらに、Autonomous AI Database では Oracle-managed heterogeneous connectivity により、非 Oracle Database への Database Link を作成できます。
Oracle のドキュメントでは、Amazon Redshift、Microsoft SQL Server、Azure SQL、Azure Synapse Analytics、Databricks、Google BigQuery、MongoDB、MySQL、PostgreSQL、Salesforce、ServiceNow、Snowflake、SharePoint などが db_type の例として挙げられています。ただし、この Oracle-managed heterogeneous connectivity は remote database に対して query-only で、更新はサポートされない点に注意が必要です。
参考: Create Database Links to Non-Oracle Databases with Oracle-Managed Heterogeneous Connectivity
この機能により、すべてのデータを事前に Oracle AI Database へロードしなくても、他社製データベース上のデータを参照し、Oracle 側のデータと組み合わせて分析できます。
一方で、リモート参照にはネットワークレイテンシ、データ転送料、接続先の負荷、クエリのプッシュダウン範囲などが影響します。高頻度に参照するデータや安定した応答時間が必要なデータは、ロード、Materialized View、Lake Cache なども含めて検討する必要があります。
これは Lakehouse の考え方を広げます。
従来は、
データを集めてから分析する
という考え方が中心でした。
しかし Autonomous AI Lakehouse では、
必要なデータを、必要な形で、Oracle AI Database からつなげて使う
という発想ができます。
5. どこに何を置くべきか
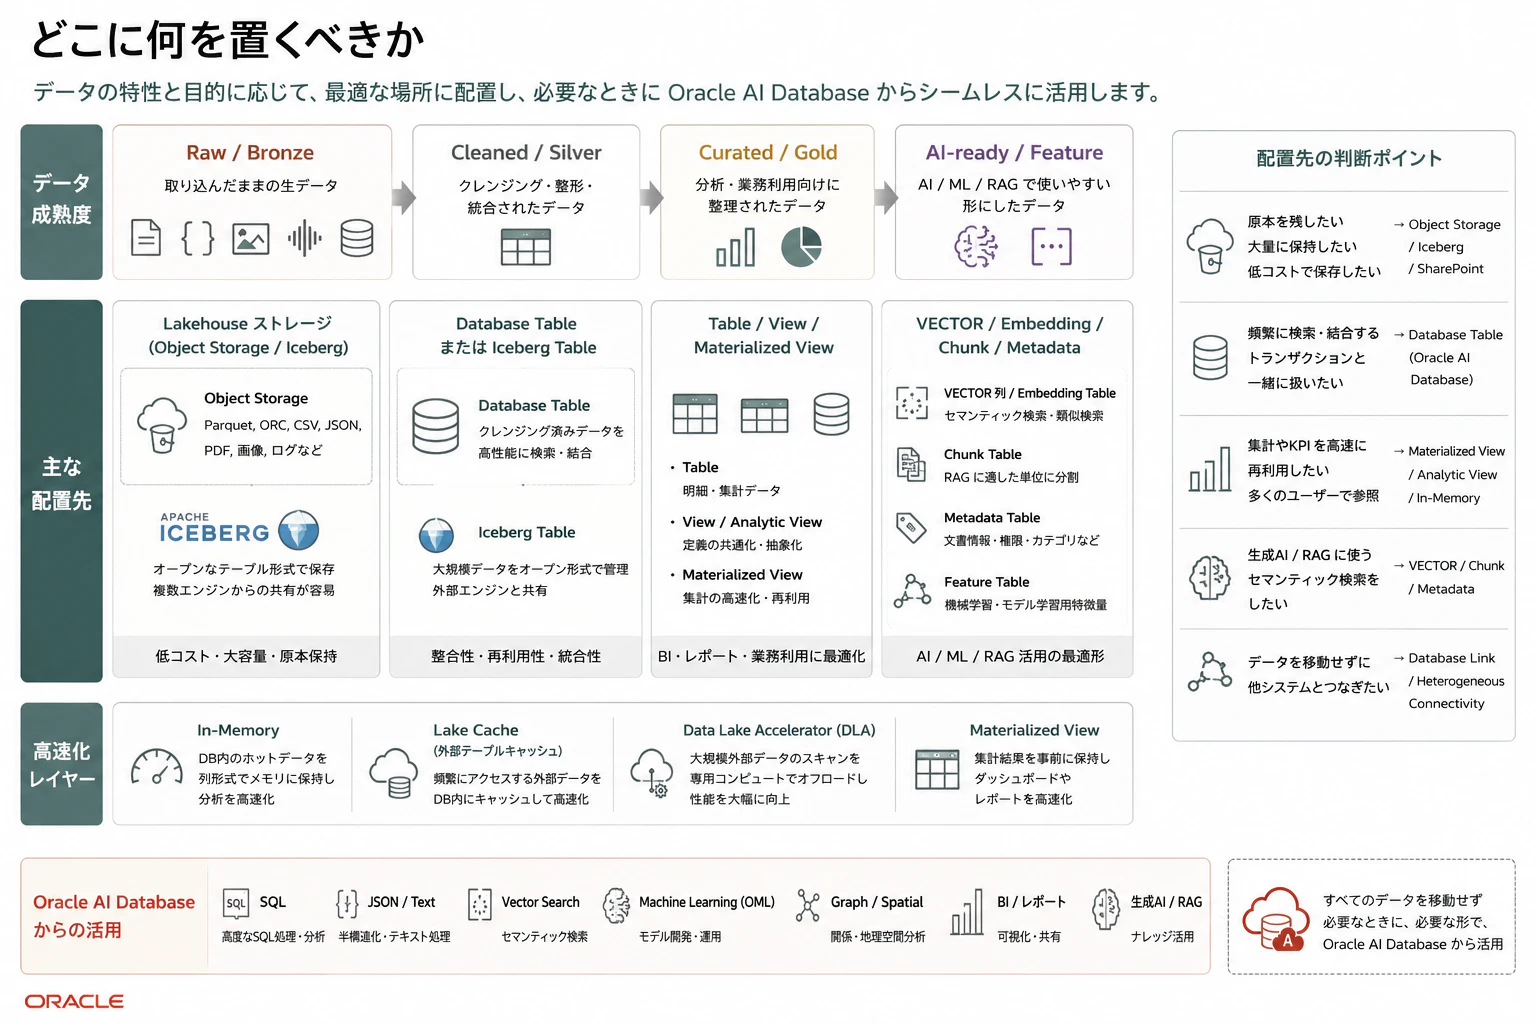
ここまで見てくると、扱えるデータと接続先がかなり広いことが分かります。
では実際に、どこに何を置くべきでしょうか。
私の整理では、Oracle Autonomous AI Lakehouse におけるデータ配置は、次の考え方が分かりやすいです。
ここで注意したいのは、保存先、データ形式、参照方法、高速化機能を同じものとして扱わないことです。
| 分類 | 主な例 | 役割 |
|---|---|---|
| 保存先 | Object Storage、SharePoint、Oracle AI Database、外部 DB / SaaS | データを実際に保持する場所 |
| ファイル/テーブル形式 | Parquet、ORC、CSV、JSON、Apache Iceberg | データをどの形式で管理・共有するか |
| 参照・連携方法 | External Table、DBMS_CLOUD、Database Link、Data Studio、Data Transforms | 保存先のデータへ接続・取り込みする方法 |
| 高速化レイヤー | In-Memory、Lake Cache、Data Lake Accelerator、Materialized View | 保存先を変えずに、または一部を保持して処理を高速化する仕組み |
| AI-ready の派生データ | Extracted Text、Chunk、Embedding、Metadata、各種 Index | AI、ML、RAG から使いやすくしたデータ |
この違いを分けたうえで、データごとの配置方針を整理すると次のようになります。
| データ / レイヤー | 主な保存先 | 形式・参照方法 | 理由 |
|---|---|---|---|
| Raw / Bronze | Object Storage、SharePoint | Parquet、CSV、JSON、PDF、画像、ログ | 原本性、低コスト、大量保存、再処理に向く |
| 生ログ / イベント / 履歴データ | Object Storage | Parquet、Iceberg Table、External Table | 増え続けるデータを保持し、複数エンジンから利用しやすい |
| 半構造化 JSON の原本 | Object Storage | JSON ファイルを External Table などから参照 | 原本を残し、必要に応じて構造化できる |
| 頻繁に JOIN / 検索する JSON | Oracle AI Database | JSON 列、Table、View、索引 | SQL、トランザクション、業務データと組み合わせやすい |
| Cleaned / Silver | Object Storage または Oracle AI Database | Iceberg Table または Database Table | 品質保証済みデータとして再利用しやすい |
| Curated / Gold | 主に Oracle AI Database | Table、View、Materialized View、Analytic View | BI、KPI、業務レポートに使いやすい |
| 高頻度分析データ | Oracle AI Database、または外部保存+キャッシュ | In-Memory、Materialized View、Lake Cache | レスポンス改善、ダッシュボード高速化に向く |
| PDF / Word / 画像などの原本 | SharePoint、Object Storage | DBMS_CLOUD、DBMS_CLOUD_PIPELINE などから参照・取得 | 原本管理、監査、再処理に向く |
| Extracted Text / Chunk / Embedding / Metadata | 主に Oracle AI Database | CLOB、Database Table、VECTOR 列、各種 Index | RAG と業務データ、権限情報を組み合わせやすい |
| Feature / AI-ready | Oracle AI Database、必要に応じて Object Storage | Feature Table、VECTOR Table、View、Materialized View | ML、AI、RAG、推論で再利用しやすい |
| 他社 DB の参照データ | 接続先 DB に保持 | Database Link / Heterogeneous Connectivity | 事前ロードせずに参照・結合できる |
| SaaS データ | SaaS に保持、または Oracle AI Database へロード | Data Studio / Data Transforms | 定期連携、変換、業務データ化に向く |
この表をさらにシンプルにまとめると、次のようになります。
保存先      → Object Storage / SharePoint / Oracle AI Database / 外部 DB・SaaS
形式        → Iceberg / Parquet / ORC / CSV / JSON / Database Table
参照・連携  → External Table / DBMS_CLOUD / Database Link / Data Studio
高速化      → In-Memory / Lake Cache / Data Lake Accelerator / Materialized View
AI-ready    → Extracted Text / Chunk / Embedding / Metadata / VECTOR / Index
ここでのポイントは、構造化データだから必ず Database、非構造化データだから必ず Object Storage と固定しないことです。
より実践的には、次の基準で考えるとよいです。
原本・大量・低頻度アクセスのデータは Lakehouse ストレージへ
ログ、履歴ファイル、PDF 原本、画像、JSON 原本、Parquet ファイルなどは、Object Storage に置くのが自然です。複数のエンジンからテーブルとして共有したい場合は、Object Storage 上で Iceberg Table として管理する選択があります。
これらは、あとで再処理したり、監査用に残したり、別のエンジンからも使う可能性があるため、オープンな形式で保持しておく価値があります。
品質保証済み・再利用されるデータは Database Table または Iceberg Table へ
クレンジング済み、型変換済み、重複排除済み、業務キーで結合済みのデータは、Silver レイヤーとして扱います。
Oracle AI Database で高速に JOIN、検索、AI 処理したい場合は Database Table にするのが自然です。一方で、複数エンジンから共有したい大規模分析データであれば Iceberg Table として管理する選択もあります。
BI・KPI・ダッシュボード用データは Gold として整理する
経営指標、部門別売上、顧客セグメント、在庫回転率、SLA、利用状況など、業務利用されるデータは Gold レイヤーとして整理します。
ここでは、Table、View、Materialized View、Analytic View が候補になります。高頻度に使われる集計は Materialized View、低頻度だが定義を共通化したいものは View、性能要件が高いものは In-Memory などを検討します。
AI-ready データは Database 側に寄せると扱いやすい
生成 AI / RAG で使う場合、原本ファイルそのものよりも、次のような派生データが重要になります。
| AI-ready データ | 内容 |
|---|---|
| Extracted Text | PDF や Word から抽出したテキスト |
| Chunk | RAG で検索しやすい単位に分割したテキスト |
| Embedding | Chunk や文書をベクトル化したもの |
| Metadata | 文書名、URL、権限、カテゴリ、作成日、部門 |
| VECTOR Index | セマンティック検索用の索引 |
| Text Index | キーワード検索・全文検索用の索引 |
| Access Control Metadata | 部門、所有者、閲覧権限、SharePoint URL、公開範囲 |
Oracle AI Database では、Embedding を VECTOR データ型として業務データと同じ Database に格納できます。これにより、セマンティック検索だけでなく、顧客、契約、製品、問い合わせ、権限情報などの構造化データと組み合わせた RAG を設計しやすくなります。
参考: Oracle AI Vector Search Overview
たとえば、SharePoint 上の技術文書を RAG 化する場合は、次のような配置が考えられます。
SharePoint
  - Word
  - PDF
  - Excel
  - PowerPoint

        ↓ DBMS_CLOUD / DBMS_CLOUD_PIPELINE

Oracle AI Database
  - Document Metadata Table
  - Extracted Text Table
  - Chunk Table
  - Embedding Table with VECTOR column
  - Vector Index
  - Text Index

        ↓

Select AI / RAG Application / Chatbot / BI / Search
この構成では、SharePoint は文書原本の置き場であり、Oracle AI Database は検索・分析・AI 活用のための実行基盤になります。
配置を決めるときに確認したい運用項目
データの種類だけで配置先を決めるのではなく、運用面も合わせて考える必要があります。
| 判断軸 | 確認すること |
|---|---|
| データ鮮度 | リアルタイム参照が必要か、日次・時間単位のロードでよいか |
| 権限・ガバナンス | 元システムの権限をどのように同期・強制するか |
| ネットワーク | クロスクラウドのレイテンシ、帯域、データ転送料を許容できるか |
| 参照頻度 | 低頻度の外部参照か、繰り返し使うためキャッシュ・ロードが必要か |
| 性能 | External Table のままでよいか、Lake Cache、DLA、In-Memory、Materialized View が必要か |
| データ管理 | Catalog、Metadata、Lineage、更新責任者をどこで管理するか |
6. まとめ:Lakehouse は「集める基盤」から「つなげて使う基盤」へ
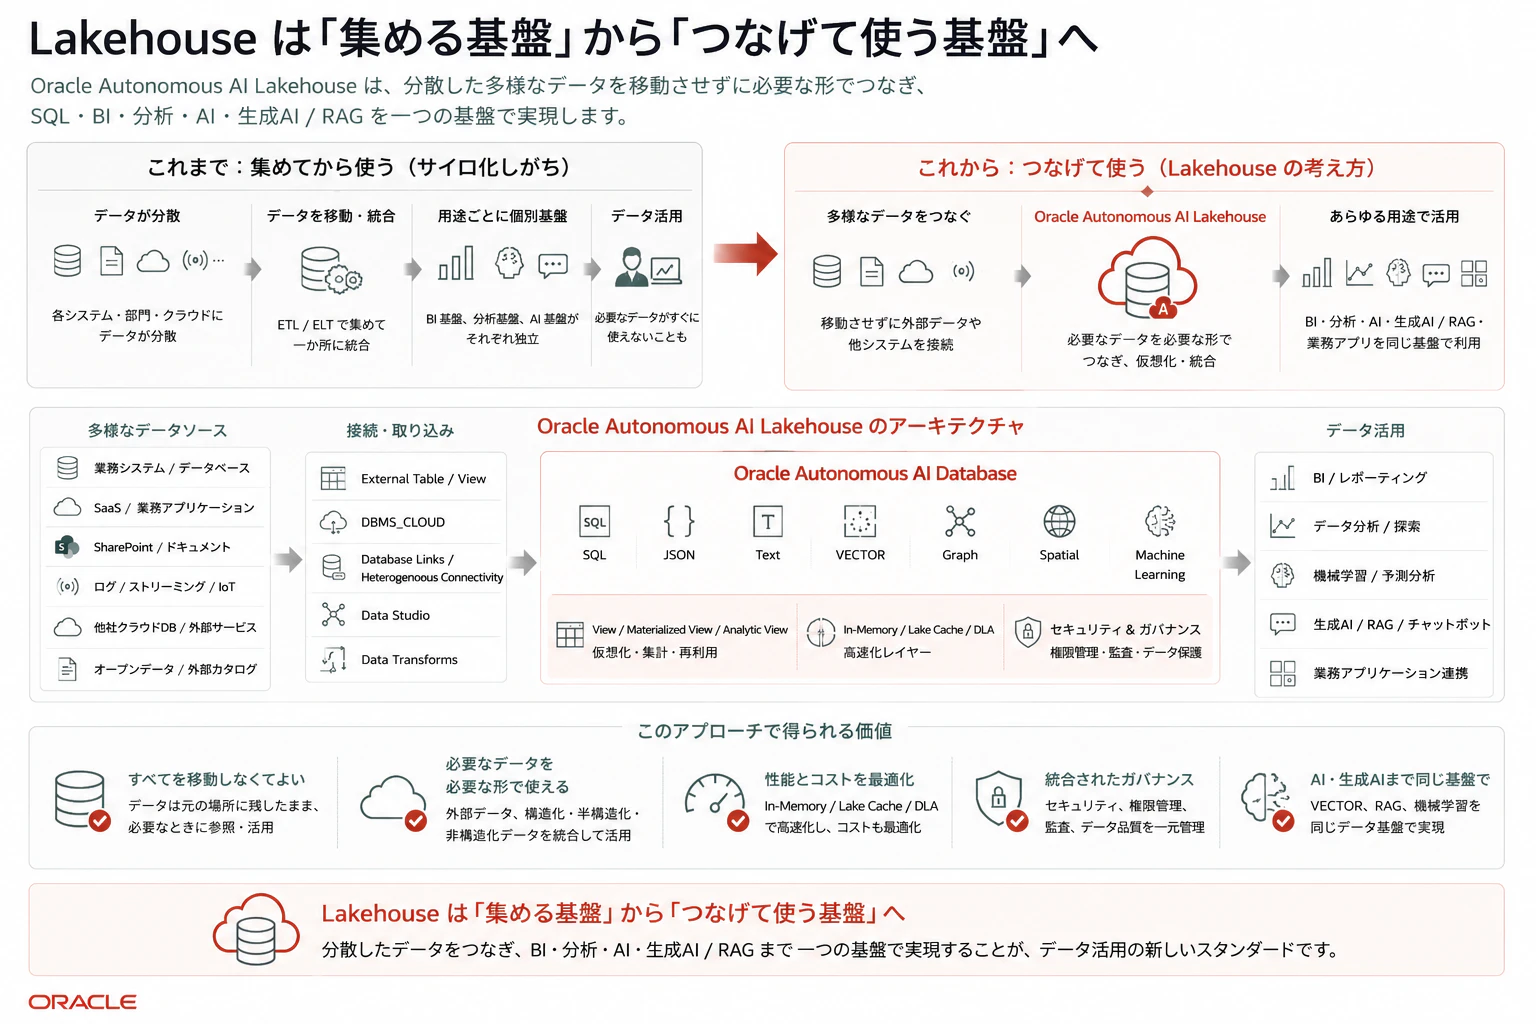
最後に、この記事の配置方針をまとめると次のようになります。
| 判断軸 | 保存先・実装の考え方 |
|---|---|
| 原本を残したい | Object Storage / SharePoint |
| 大量データを低コストで保持したい | Object Storage+Parquet / Iceberg |
| 複数エンジンで共有したい | Object Storage 上の Apache Iceberg |
| SQL で頻繁に JOIN したい | Oracle AI Database Table |
| JSON を業務データと一緒に扱いたい | Oracle AI Database の JSON 列 / Table |
| BI / KPI に使いたい | Table / View / Materialized View / Analytic View |
| 外部データを高速化したい | Lake Cache / Data Lake Accelerator / Materialized View |
| Database 内データを高速化したい | In-Memory / Materialized View |
| RAG に使いたい | Chunk Table / VECTOR 列 / Metadata Table / 各種 Index |
| 他社 DB を参照したい | Database Link / Heterogeneous Connectivity |
| SaaS データを取り込みたい | Data Studio / Data Transforms |
| SharePoint 文書を検索したい | DBMS_CLOUD / DBMS_CLOUD_AI / Vector Index |
今回整理してみて見えてきたのは、Lakehouse は Database を置き換える仕組みではなく、データの性質に応じて置き場所を選び、それらをつなげて使うための基盤だということです。
Oracle だけですべてを置き換えるのではなく、原本は Object Storage や SharePoint に残し、大規模な共有データは Iceberg で管理し、業務で頻繁に使うデータや AI-ready データは Oracle AI Database へ寄せる。それぞれの Cloud やサービスが得意なところを活かしながら、Oracle AI Database から SQL、Vector Search、AI、RAG へつなげていく構成がよさそうです。
Oracle Database を長く触ってきた人ほど、Database の中だけで完結するのではなく、Object Storage、Iceberg、SharePoint、他社 Cloud まで、Oracle Database からつなげて使えるところにグッとくるものがあると思います。
Oracle Autonomous AI Lakehouse を考えるときのキーワードは、**「集める」だけでなく「つなげて使う」**です。
次の検証候補としては、同じ Parquet / Iceberg データを External Table、Lake Cache、Data Lake Accelerator、Database Table から参照し、性能とコストの違いを実測できると、今回の配置方針がさらに具体的になりそうです。
■ 参考資料
-
Use Lake Cache to Improve Performance for External Tables and Mounted Catalog Tables
-
Create Database Links to Non-Oracle AI Databases with Oracle-Managed Heterogeneous Connectivity
■ おまけ
