
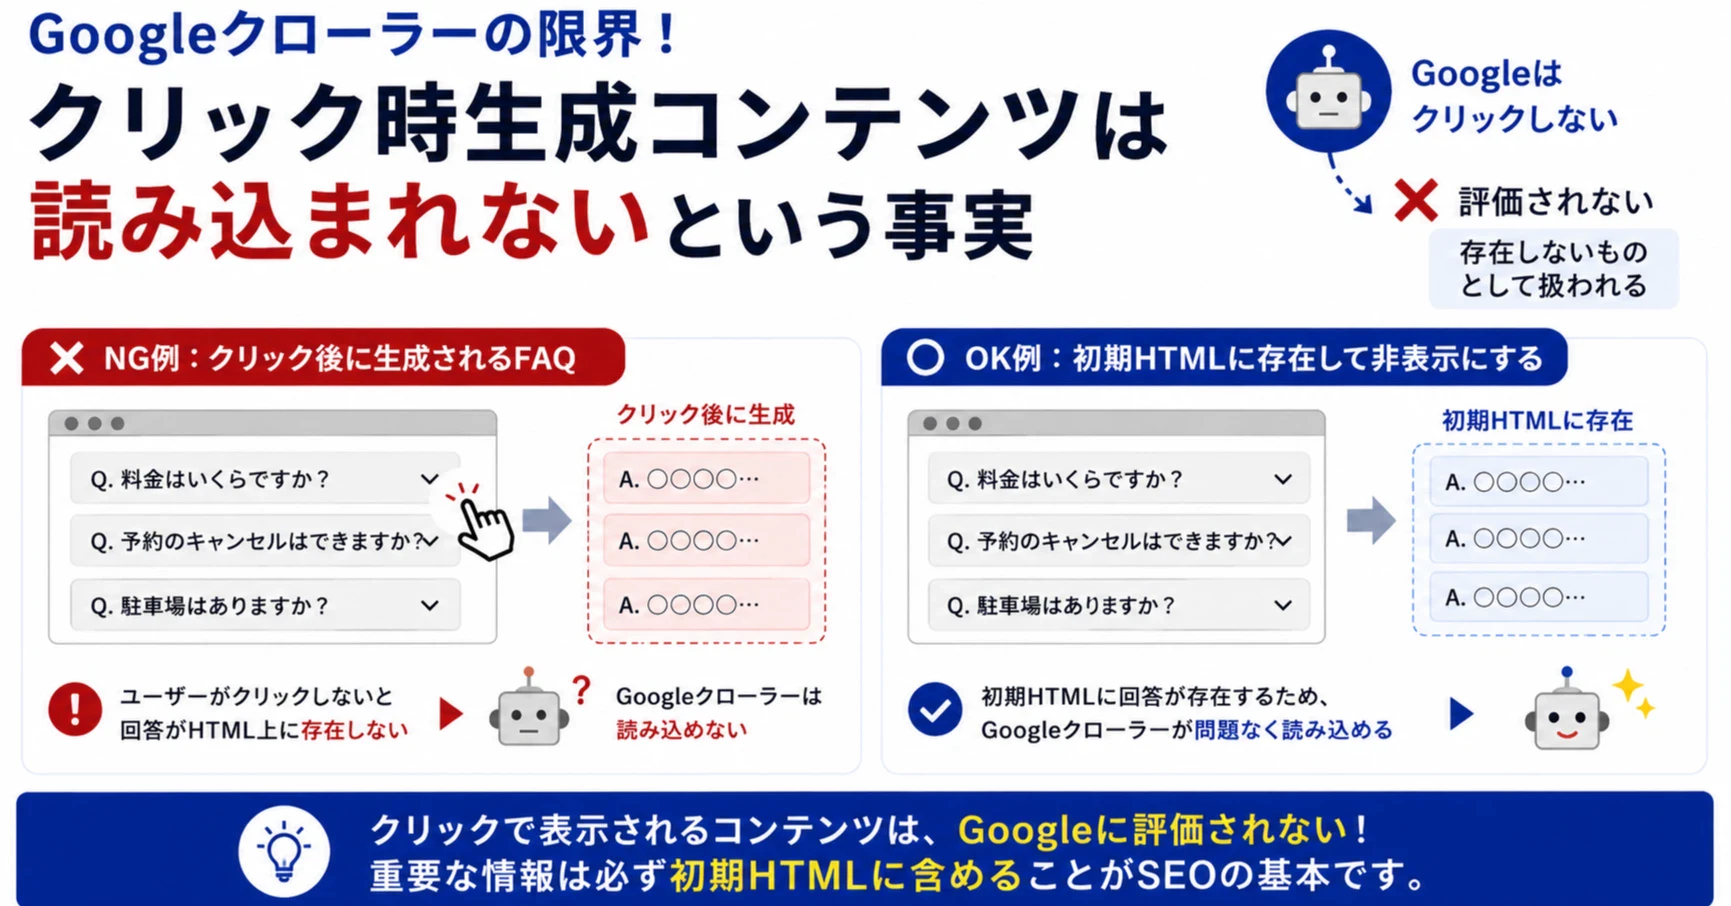
Webサイトの技術構成や演出が複雑化するなかで、SEO担当者やエンジニアが意外と落とし穴にはまりやすいのが「クローラーがどこまでのコンテンツを認識できているか」という点です。
アコーディオンUIや無限スクロールといったリッチなJavaScript実装は、ユーザーの利便性を高める一方で、作り方を誤るとGoogleにコンテンツを一切読んでもらえなくなります。
結論から言うと、Googleは「ユーザーがクリックした後に初めて生成されるHTMLコンテンツ」を読み込むことができません。
今回は、クローラーが認識できるコンテンツの境界線と、FAQや無限スクロールを実装する際の具体的なSEO回避策について詳しく解説します。
Googleクローラーが読み込めるコンテンツの境界線
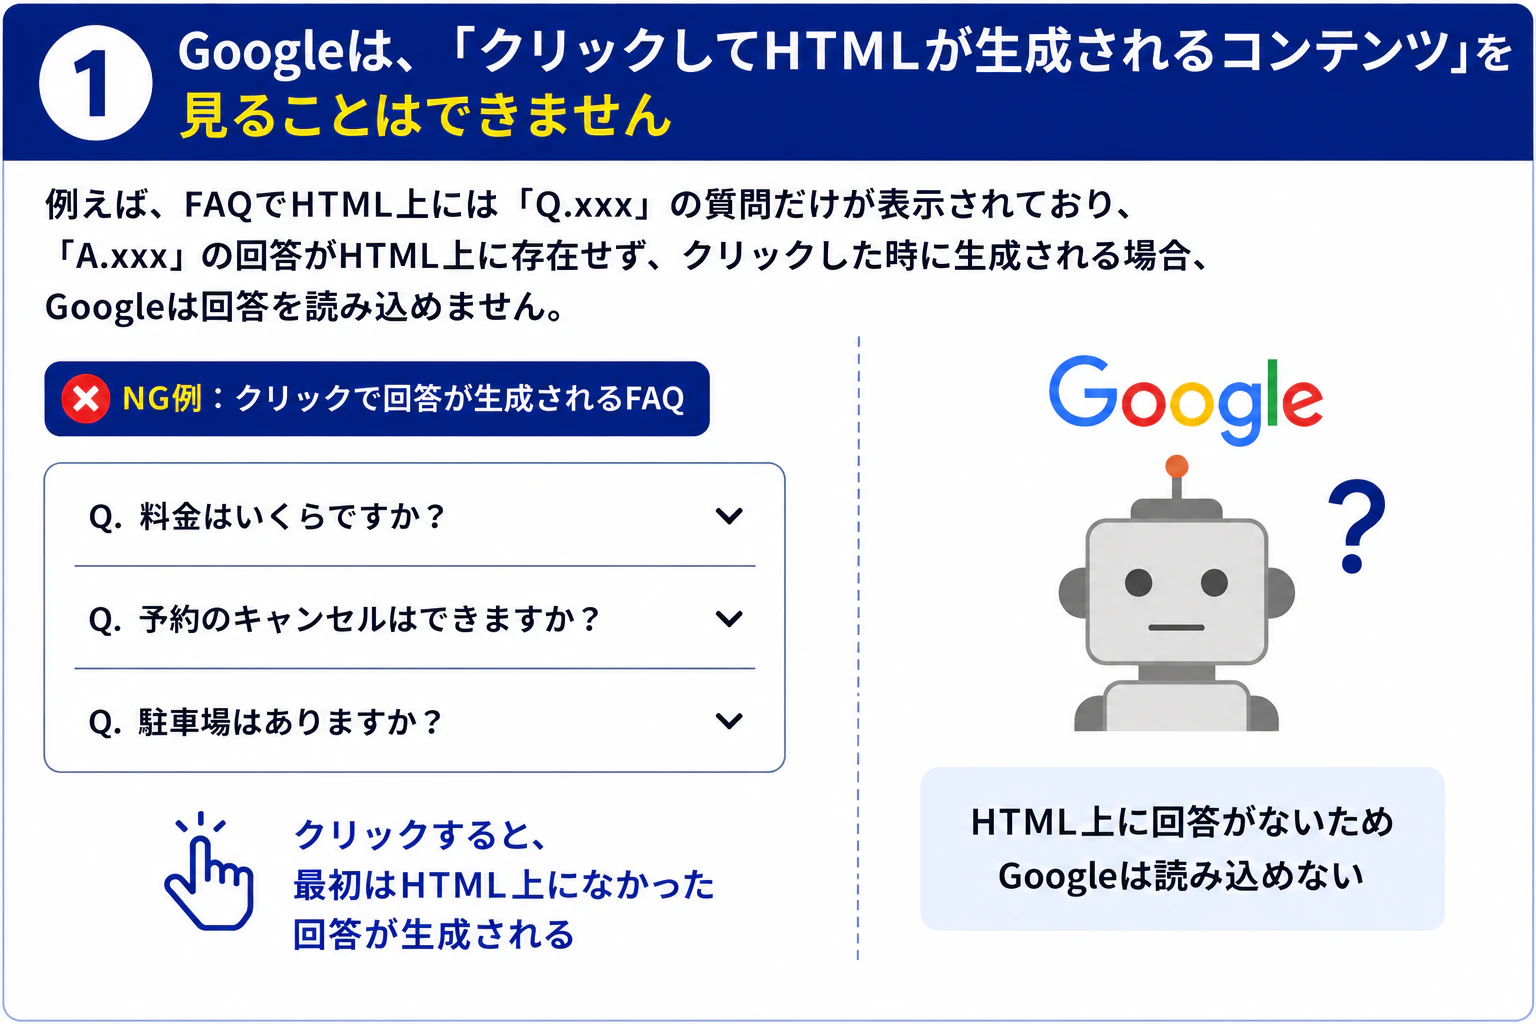
GoogleのクローラーがWebページにアクセスした際、読み込むことができるのは「ランディングした初期段階で生成されているコンテンツ」だけです。
これにはサーバーから返却された最初のHTMLだけでなく、ページの初期読み込み時に実行されたJavaScriptによって描写されたテキストも含まれます。
一方で、ページが開かれた後にユーザーが何らかのアクションを起こすことで動的に読み込まれるコンテンツは、クローラーの評価対象外になってしまいます。
- 初期レンダリング時(ランディング時)に存在するHTMLやJavaScript生成コンテンツ Googleクローラーは問題なく読み込み、インデックス可能
- ユーザーの「クリック」「ホバー」「スクロール」などの操作を契機に初めて描画されるコンテンツ Googleクローラーは操作を行わないため、存在しないものとして扱われる
つまり、画面上に見えていなくても初期読み込み時点でHTML上にデータが存在していれば問題ありませんが、操作後に初めて通信が発生して生成される仕組みになっている場合は、完全にスルーされてしまいます。
よくある失敗例:クリック後に回答が生成されるFAQアコーディオン
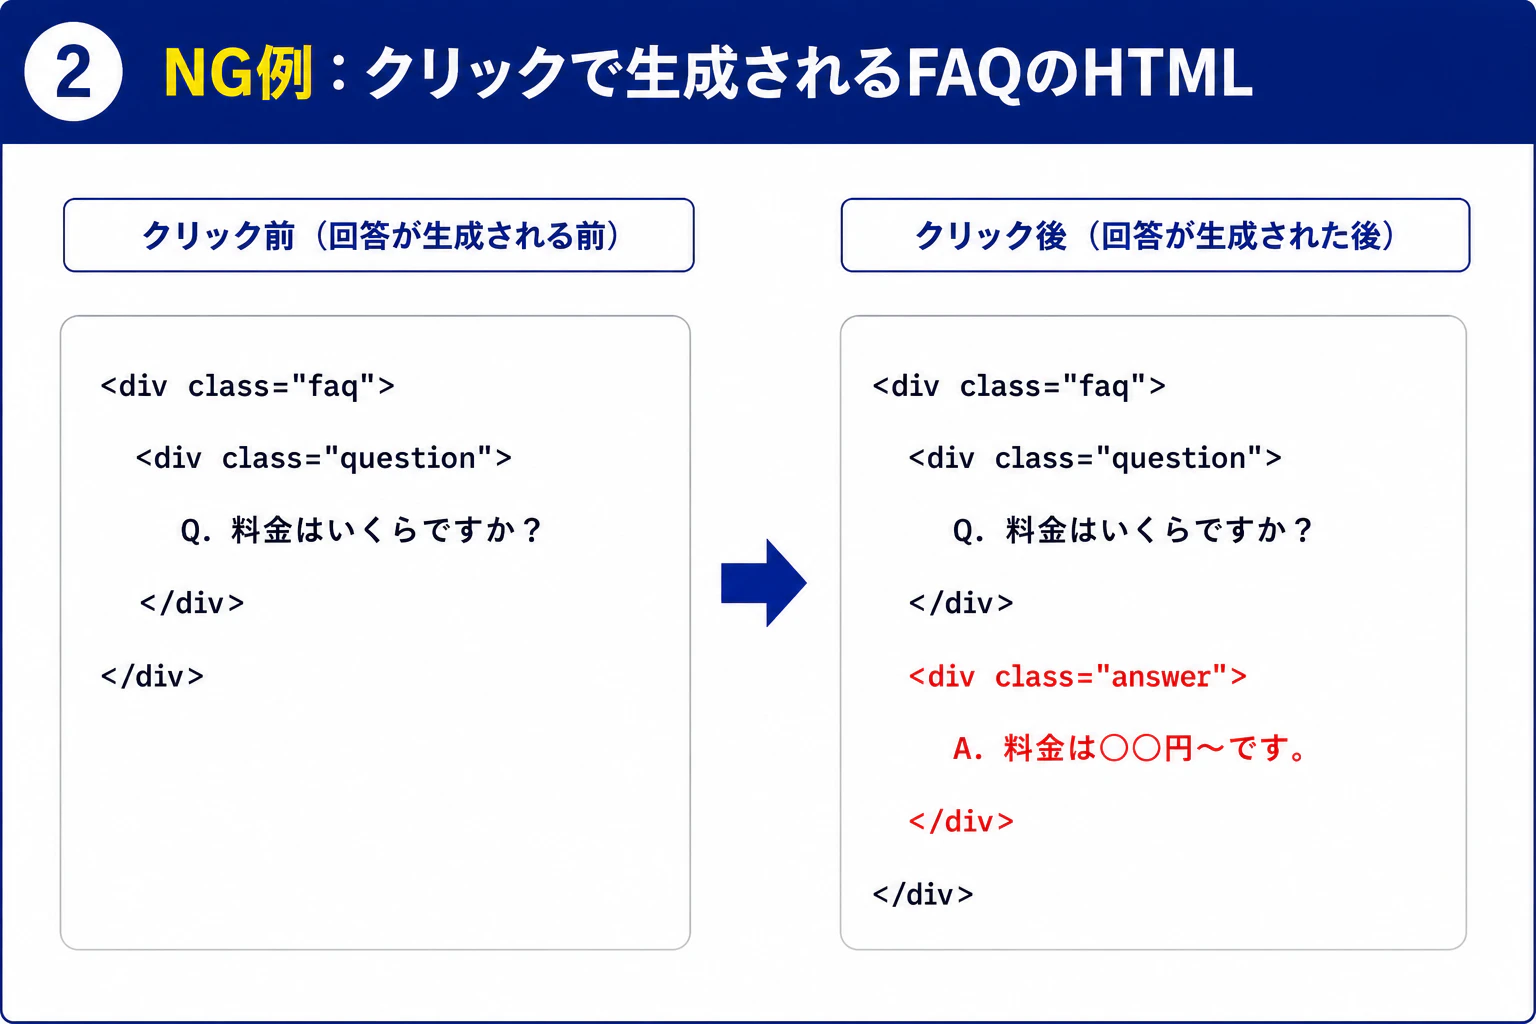
サイト内でよく見かけるFAQ(よくある質問)のモジュールで、この落とし穴によく遭遇します。
アコーディオン形式で「Q.〇〇〇」という質問だけが初期状態で表示されており、ユーザーが矢印やボタンをクリックした瞬間に非同期通信で「A.〇〇〇」の回答データを取得・描画するようなシステム構成です。
ユーザー目線では何ら不自由なく回答を読めているように見えますが、Googleから見ると「質問テキストしか存在しない質の低いページ」として評価されてしまいます。
回答部分にどれだけ魅力的で検索意図に沿ったキーワードが詰まっていたとしても、それらが一切検索エンジンに評価されないのは非常に大きな機会損失です。
対策は?
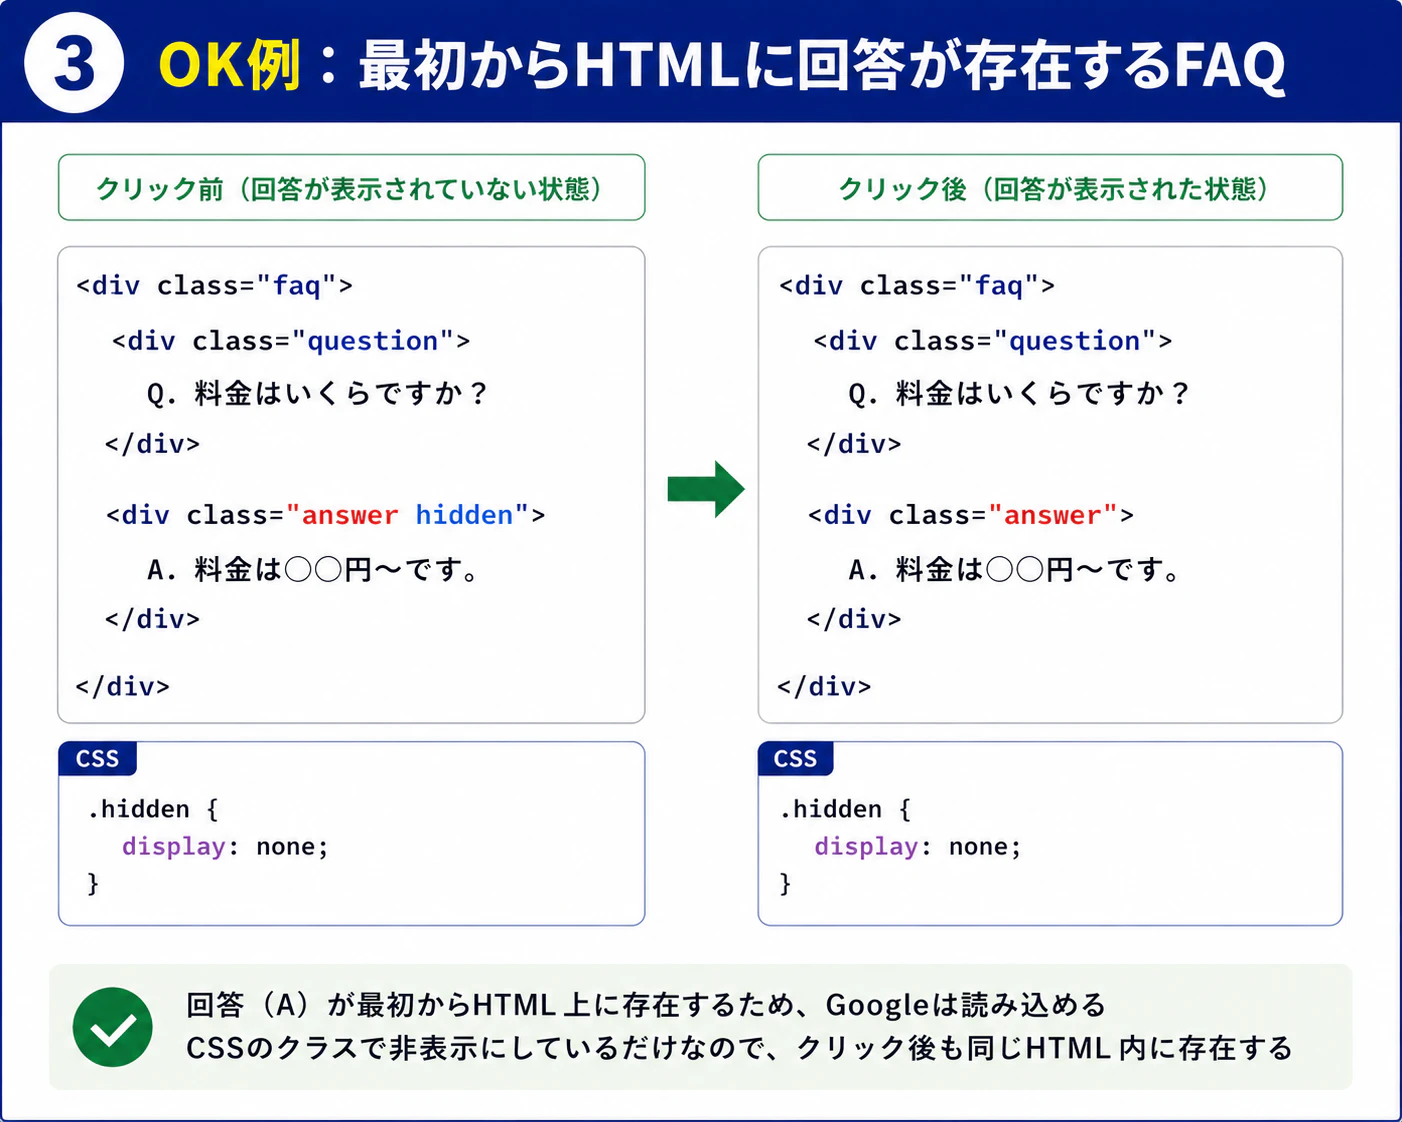
対策としては非常にシンプルで、回答テキストも初期のHTMLレンダリング時にあらかじめ読み込ませておき、CSSの非表示設定(display: none など)を使って初期表示だけ隠しておく手法が有効です。
この実装であれば、クローラーは初期HTMLの中から回答テキストを問題なく読み取ることができ、ユーザーがクリックした際にもCSSの切り替えだけでスムーズに表示させることができます。
無限スクロールにも潜むSEO上のリスク
クリックイベントと同様に注意が必要なのが、ユーザーがページの下部にスクロールしたタイミングで次々とコンテンツを非同期で読み込んでいく「無限スクロール」の実装です。
一覧ページやメディアサイトなどでよく採用されますが、Googleクローラーは人間のようにページを下にスクロールし続けて底なしにコンテンツを読み込むような挙動はしてくれません。
ファーストビュー付近の初期表示分だけを読み込んで処理を終了してしまうため、2ページ目以降に埋もれている大量のコンテンツやリンクが、検索エンジンから見ると存在しない状態になってしまいます。
せっかく大量の商品や記事を用意していても、無限スクロールの仕様のせいでクローラーが巡回できず、サイト全体のインデックス数が伸び悩む原因になります。
次回は、無限スクロールにおける場合、「どうすればGoogleに全てのコンテンツを見せることができるのか」について紹介します。