
何かと最近見かける Looped Transformer。
仕組み自体はかなり単純です。しかし、論文を追ってみると「同じTransformerを何回も使う」だけでは終わりません。
少なくとも僕は、名前だけ見て
Transformerの同じ層を何回か通すやつでしょ
くらいで止まっていました。
そこで今回は、
- なぜ同じTransformerを繰り返すのか
- 理論的には何がうれしいのか
- RNNとは何が違うのか
- なぜ最近また注目されているのか
- 何がまだ難しいのか
を、最近の論文まで含めて整理します。
対象は、Transformerの基本構造を知っている人です。
そもそもLooped Transformerとは
同じTransformer blockをdepth方向に繰り返し使うTransformerです。
普通のTransformerを4層とすると、

です。
各層は異なるparameterを持ちます。
数式では
h_{l+1}=F_{\theta_l}(h_l)
です。
一方、Looped Transformerでは同じblockを繰り返します。

つまり、
h_{t+1}=F_{\theta}(h_t)
です。
違いはこれだけです。
ただし、この違いによってTransformerの計算方法が変わります。
実際には何をしているのか
4 loopsの場合を順番に追います。
まずtoken列をembeddingして、最初のhidden state $h_0$ を作ります。

次に、Transformer blockを1回通します。
h_1=F_\theta(h_0)
ここは普通のTransformerと変わりません。
Self-AttentionとFFNを使ってhidden stateを更新します。
違いは次です。
出てきた $h_1$ を、同じTransformer blockへもう一度入れます。
h_2=F_\theta(h_1)
さらに、
h_3=F_\theta(h_2)
h_4=F_\theta(h_3)
と続けます。
全体では、

です。
同じparameterを使っていますが、毎回の入力 $h_t$ が異なります。
したがって、
同じ重みだから、毎回同じ処理結果になる
わけではありません。
同じ更新則を、変化していくhidden stateへ繰り返し適用する。
これがLooped Transformerの基本です。
最初の論文は?
depth方向に同じTransformerを繰り返す発想自体は、2018年7月の Universal Transformers まで遡れます。
Universal TransformerではSelf-Attentionをdepth方向に再帰的に適用し、さらにtokenごとに計算を止めるAdaptive Computation Timeも導入していました。現在のLooped Transformerに近い発想です。

図: Universal Transformerの概念図。sequence方向ではなくdepth方向に、全位置の表現をself-attentionと共有のtransition functionで並列に更新し続ける。出典: Dehghani et al., Universal Transformers, Figure 1
一方、「Looped Transformers」という名前を明確に使った研究の起点として追いやすいのが、
Giannou et al., “Looped Transformers as Programmable Computers”
です。
2023年1月30日にarXivへ公開され、ICML 2023に採択されました。
この論文は、現在のLLMのように大規模学習して性能を競う論文ではありません。
扱っているのは、より理論的な問いです。
「Transformerをloopさせることで、algorithmそのものを実行できるのか」
を調べています。
Looped Transformerを「計算機」として見る
Giannou et al. は、Transformerを単なる関数近似器ではなく、反復計算を実行する装置として扱いました。
一般的なalgorithmでは、同じ更新則を何度も使います。
例えばGradient Descentなら、
w_{t+1}=w_t-\eta\nabla L(w_t)
です。
毎stepで違うalgorithmを使うわけではありません。

と、同じupdate ruleを繰り返します。
Looped Transformerも同じ形です。
h_{t+1}=F_\theta(h_t)
つまり、
Transformer blockを1回分のupdate ruleとして学習し、それを繰り返せばalgorithmとして使えるのではないか
という発想です。
実際、Giannou et al. はloopさせたTransformerによって、基本的な計算、条件分岐、linear algebra、さらにはbackpropagationを含む処理まで表現できることを構成的に示しました。
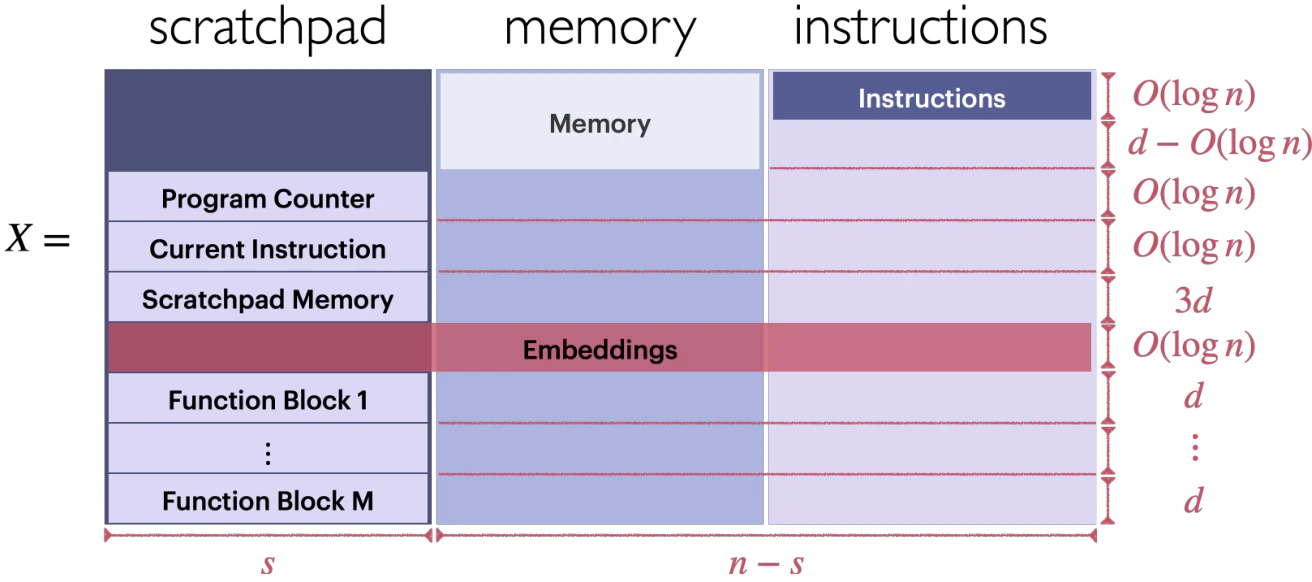
図: Looped Transformerへの入力X。scratchpad、memory、instructionsの3領域に分かれ、入力列がプログラムとデータを兼ねる。出典: Giannou et al., Looped Transformers as Programmable Computers, Figure 6(arXiv v1)
ここが、単なるparameter sharingとの大きな違いです。
目的はparameter数を減らすことだけではありません。
depthを、異なる関数の積み重ねではなく、algorithmの反復回数として扱える。
これがLooped Transformerを見る上で重要です。
2023年11月、実際に学習させてみた
続いて、
Yang et al., “Looped Transformers are Better at Learning Learning Algorithms”
が2023年11月21日にarXivへ公開され、ICLR 2024に採択されました。
こちらは、先ほどの
理論上algorithmを実行できる
から一歩進めて、
普通に学習させた場合にも、反復algorithmに近い処理を獲得するのか
を調べています。
対象はin-context learningによるlinear regressionなどのdata fittingです。
なぜ普通のTransformerより相性がいいのか
例えばGradient Descentでlinear regressionを解くとします。
更新は、
w_{t+1}=w_t-\eta X^\top(Xw_t-y)
です。
同じ式を何回も使います。
つまり問題そのものに、
s_{t+1}=G(s_t)
という反復構造があります。
一方、普通のTransformerでは、
h_1=F_{\theta_1}(h_0)
h_2=F_{\theta_2}(h_1)
h_3=F_{\theta_3}(h_2)
となります。
各stepで違う関数です。
Looped Transformerなら、
h_{t+1}=F_\theta(h_t)
です。
問題が持っている、
s_{t+1}=G(s_t)
という形と一致します。
つまりLooped Transformerには、
反復algorithmを学習しやすいinductive biasが最初から入っている
と考えられます。
Yang et al. はdata-fitting課題で、通常のTransformerに近い性能を10%未満のparameter数で実現したと報告しています。

図: in-context linear regressionでの結果。左は、30回のloopで学習したモデルが学習したloop数を超えても安定した解に留まる様子。右は、12層のTransformerと同程度の誤差を、parameter数1/12で達成している様子。出典: Yang et al., Looped Transformers are Better at Learning Learning Algorithms, Figure 2
Input Injection
ただし、単純に
h_{t+1}=F_\theta(h_t)
とすれば終わりではありません。
loopを何度も回すと、元の入力情報がhidden stateの変換の中に埋もれる可能性があります。
そこでYang et al. は、元の入力 $P$ を各loopで再び加えます。
h_{t+1}=F_\theta(h_t+P)
です。
処理としては、

となります。
感覚としては、
毎回、現在の途中結果だけでなく、元の問題も見直す
という処理です。
実際、単純なweight sharingよりも、学習時と異なるloop数に対して安定することが示されています。

図: input injectionありとなし(weight-tying)でのtest errorの比較。なしの場合、学習したloop数を超えると性能が悪化する。出典: Yang et al., Figure 3
さらに改良される
ここからLooped Transformerは、単純な「同じblockをloopする」形から広がっていきます。
2024年には AlgoFormer が登場しました。
構造は、

とします。
各部分で役割を分けています。
Pre Transformerが入力を反復計算しやすい表現へ変換する。
Looped Transformerが反復処理を担当する。
Post Transformerが最終結果を読み出す。
同じ処理全体を繰り返すのではなく、反復処理を担う部分を分けた構成です。

図: AlgoFormerの構造。pre-transformer、looped transformer、post-transformerの3部で構成される。出典: Gao et al., AlgoFormer, Figure 1
最近のLooped Transformerでも、この

という考え方が使われています。
2025年、LLM規模まで大きくなる
2025年2月には、
Geiping et al., “Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach”
が公開されました。
後にNeurIPS 2025へ採択されています。
この研究では、3.5B parameterのlanguage modelを800B tokensで事前学習しています。
重要なのは、
loop回数を推論時に増やして、hidden state上で追加計算する
点です。
通常のreasoning modelでは、

のように、追加のreasoning tokenを生成してtest-time computeを増やします。
一方、recurrent depthでは、

と内部状態側で計算を増やします。
つまり、
token方向ではなくdepth方向にtest-time computeを増やす
わけです。

図: Recurrent Depthモデルの構造。preludeが入力をlatent spaceへ埋め込み、共有のrecurrent blockを反復し、codaが出力へ復号する。出典: Geiping et al., Scaling up Test-Time Compute with Latent Reasoning, Figure 2
同論文では、推論時にrecurrent blockを追加で回すことで、特に数学やcodingなどのreasoning課題で性能が伸びることを報告しています。

図: 3.5Bのモデルで、推論時に反復を増やして計算量をかけるほど性能が改善する様子。出典: Geiping et al., Figure 1
これにより、Looped Transformerはparameter efficiencyだけでなくlatent reasoningにも使われるようになりました。
Ouroではさらに大規模化
2025年10月にはByteDance Seedなどから、
“Scaling Latent Reasoning via Looped Language Models”
が公開されました。
モデル名は Ouro です。
Ouroでは1.4B、2.6B parameterのLooped Language Modelを、最大7.7T tokens規模で学習しています。
特徴は、
難しい入力ほど多くのdepthを使う
というadaptive computationまで扱った点です。
つまり、

を目指します。
これが成立すれば、parameter数を増やさずに、問題ごとに計算量を変えられます。
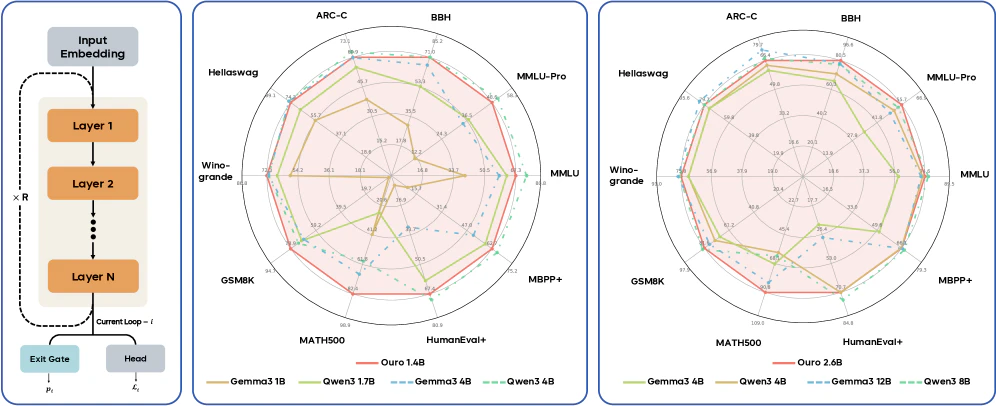
図: Ouroの概要。parameter共有のloop構造と、その性能がまとめられている。出典: Zhu et al., Scaling Latent Reasoning via Looped Language Models, Figure 1
Looped Transformerのメリット
メリットは大きく3つあります。
parameter数とdepthを分離できる
普通のTransformerでは、基本的にdepthを増やすとparameterも増えます。
例えば1 blockが $P$ parametersなら、12 blocksでは概ね、
12P
です。
同じblockを12回loopするならparameterは、
P
のままです。
parameterを増やさずeffective depthを増やせます。
ただし、12回blockを実行するので計算量まで12分の1になるわけではありません。
反復algorithmと形が合う
多くのoptimizationやreasoningは、
s_{t+1}=G(s_t)
という反復処理です。
Looped Transformerも、
h_{t+1}=F_\theta(h_t)
なので、構造が一致します。
これは単なるparameter削減以上に重要です。
何を学習しやすくするかというinductive biasそのものが変わります。
test-time computeをdepth側に増やせる
普通のTransformerは、学習後に勝手に層数を増やせません。
Looped Transformerなら同じblockを使うため、

と計算depthを変えられます。
これによって、
\text{model size}
と
\text{test-time compute}
をある程度切り離せます。
最近Looped Transformerが再び注目されている理由の一つです。
理論的には何が起きているのか
もう少し踏み込みます。
Transformer blockをResidual形式でかなり単純化すると、
h_{t+1}=h_t+\alpha f_\theta(h_t)
と書けます。
これを何度も繰り返します。
このときLooped Transformerは、deep networkとしてだけでなく、状態を繰り返し更新する過程としても見られます。

もし更新が安定していれば、
h_{t+1}\approx h_t
となる点へ近づく可能性があります。
つまりfixed point、
h^{*}=F_\theta(h^{*})
です。
この見方をすると、
「何層目の特徴か」ではなく、「反復計算がどこまで進んだか」
という解釈になります。
通常のTransformerとは、depthの意味が異なります。
RNNとは何が違う?
ここまで読むと、
それ、RNNでは?
となります。
共通点はあります。
どちらも同じparameterを使ってhidden stateを更新します。
RNNなら、
h_t=F_\theta(h_{t-1},x_t)
です。
ただし、繰り返す方向が違います。
RNN
sequence方向に状態を更新します。

Looped Transformer
同じtoken列に対して、depth方向に状態を更新します。

各loop内ではSelf-Attentionによってtoken間をまとめて処理できます。
特にdecoder-only LLMでは、

のように、
token方向のautoregressive recurrenceの内側に、depth方向のrecurrenceがある
と考えるとわかりやすいです。
そんなLooped Transformerですが、課題も多い
大きな問題の一つは、
「もっとloopすればもっと賢くなる」とは限らない
ことです。
8 loopsで学習したモデルを、推論時に100 loops回せば性能が上がる。
そう単純ではありません。
課題1:loop数の外挿
学習時に使ったloop数を超えると、
h_t
が意味のある方向へ更新され続ける保証はありません。
すぐfixed pointへ到達して、それ以上ほとんど変化しない可能性があります。
逆に、状態が不安定になる可能性もあります。
2026年には、loop数を増やした際のgradient oscillationやresidual explosionを扱う研究も出ています。

図: 通常のLooped Transformer(LT)とFully Looped Transformer(FLT)の構造の比較。FLTは、loop間の信号を全層に分配するFully Looped Architectureと、attention blockを再利用するAttention Injectionを持つ。出典: Fu et al., Simply Stabilizing the Loop via Fully Looped Transformer, Figure 1
つまり、
loopできることと、追加loopを有効利用できることは別です。
課題2:どこで止めるのか
adaptive computationをするなら、
この問題には何loops必要か
を判断する必要があります。
少なすぎれば必要な計算を終えられません。
多すぎれば計算量が増えます。
さらに2026年の研究では、単純なlearned halting gateが常に最適とは限らず、hidden stateの更新過程をどう学習させるか自体が重要だと報告されています。

図: 固定priorで学習した軌跡に単純なconfidence readoutを組み合わせた場合と、学習したlinear gateを使った場合の比較。出典: Popescu et al., Adaptive Depth in Looped Transformers, Figure 4
つまり、
停止判定だけを学習しても、この問題全体は解決しません。
課題3:parameterは減ってもlatencyは減らない
Looped Transformerはparameter-efficientです。
しかし、
1 block × 16 loops
なら、block自体は16回実行します。
したがって、
parameter efficiencyとcompute efficiencyは別です。
さらにloopを逐次実行するため、hardwareによっては普通のdeep Transformerより実行効率が下がる場合もあります。
「モデルが小さい = 速い」とは限りません。
課題4:本当に「考えている」のか分かりにくい
latent reasoningと呼ばれていますが、
h_1 \rightarrow h_2 \rightarrow h_3
と変化しているだけでは、
loop 1 = 情報抽出
loop 2 = 推論
loop 3 = 検証
になっているとは言えません。
同じblockを繰り返していても、algorithmicな処理を獲得していない可能性があります。
2026年には、
weight-tied Looped Transformerは、どんな条件なら本当にalgorithmを獲得するのか
を直接調べる研究も出ています。

図: 左は、1つの共有blockをT回適用するweight-tied looped transformer。右は、収束時間のスケーリング(一定、log n、線形)によって、loopが実現しているmechanismを見分ける考え方。出典: Zhang et al., When Does Recurrence Become an Algorithm?, Figure 1
反復によって何を計算しているのかは、まだ十分に分かっていません。
今後の方向性
個人的には、Looped Transformerではparameter削減よりも、計算量をparameter数から切り離せる点に注目しています。
これまでのTransformerでは、

という方向が中心でした。
reasoning modelでは、

という方向も増えました。
Looped Transformerでは、ここに第三の軸が入ります。

です。
つまり、
\text{width}
\text{token length}
に加えて、
\text{recurrent depth}
を計算量の軸として使えます。
個人的に特に気になるのは、「何回loopすべきか」をモデル自身が判断できるかです。
簡単な問題なら3 loops。
難しい問題なら30 loops。
さらに、答えが収束したら止める。
このような処理が安定して学習できれば、
固定depthのTransformerから、問題に応じて計算量を変えるTransformerへ移れる
可能性があります。
一方、これができなければ、Looped Transformerは、
parameterは少ないが、同じblockを何回も実行するモデル
という範囲にとどまります。
そのため今後は単純なbenchmark精度だけでなく、
- 各loopでhidden stateが何を更新しているのか
- loop数と問題難度が対応するのか
- 学習時より深いloopへ外挿できるのか
- fixed pointへ収束しているのか
- どの時点で計算を止めるべきか
あたりが重要になると思っています。
まとめ
Looped Transformerは、一言で言えば、
同じTransformer blockをdepth方向に何度も使うTransformer
です。
仕組み自体は単純です。
ただし、その意味は単なるweight sharingにとどまりません。
通常のTransformerが、
F_{\theta_4}
\circ
F_{\theta_3}
\circ
F_{\theta_2}
\circ
F_{\theta_1}
という異なる関数の合成なのに対して、Looped Transformerは、
F_\theta^T
という同じ関数の反復です。
この違いによって、
- Transformerを反復algorithmとして扱える
- parameter数とeffective depthを分離できる
- test-time computeをlatent space側に増やせる
という性質が出てきます。
2018年のUniversal Transformerでは、この考え方の原型がありました。
2023年にはLooped Transformerがprogrammable computerとして理論的に整理されました。
2024年にはlearning algorithmとの相性が調べられました。
そして2025年以降は、HuginnやOuroのようにLLM規模のlatent reasoningへ広がっています。
なので最近のLooped Transformerを見て、
「結局、昔のweight sharingでは?」
と言うのは半分正しいです。
ただ最近の研究では、
そのweight sharingを、test-time computeと反復algorithmのために使う
ところまで研究対象が広がっています。
参考文献
- Mostafa Dehghani et al., Universal Transformers, arXiv:1807.03819, 2018.
- Angeliki Giannou et al., Looped Transformers as Programmable Computers, ICML 2023, arXiv:2301.13196.
- Liu Yang et al., Looped Transformers are Better at Learning Learning Algorithms, ICLR 2024, arXiv:2311.12424.
- Yihang Gao et al., AlgoFormer: An Efficient Transformer Framework with Algorithmic Structures, arXiv:2402.13572.
- Jonas Geiping et al., Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach, NeurIPS 2025, arXiv:2502.05171.
- Rui-Jie Zhu et al., Scaling Latent Reasoning via Looped Language Models, arXiv:2510.25741, 2025.
- Tong Zhang et al., When Does Recurrence Become an Algorithm? Convergence Selection in Weight-Tied Looped Transformers, arXiv:2607.20594, 2026.
- Rao Fu et al., Simply Stabilizing the Loop via Fully Looped Transformer, arXiv:2605.18797, 2026.
- Andrei Cristian Popescu et al., Adaptive Depth in Looped Transformers: Diagnosing Learned Halting Gates and Trajectory Readouts, arXiv:2607.20519, 2026.