
Zindi「Bias Bounty Mapping Equity Challenge」に挑戦する:地図データと気候リスクの公平性を測る
開催中止
このコンペは開催されなくなったようです。
残念ですね。
1. はじめに
Zindiで公開されている Bias Bounty Mapping Equity Challenge は、オープン地図データの「描かれ方の偏り」を、GISとデータ分析で調べるコンペです。
テーマになっているのは、単純な地物分類や画像認識ではありません。
気候リスクにさらされ、社会的にも脆弱な地域ほど、オープン地図上でも十分にマッピングされていないのではないか?
という問いを、米国の Census tract(国勢調査区)単位で検証します。
災害時の避難経路、救急搬送、消防活動、物資輸送などでは、道路、建物、病院、消防署、学校といった地理情報が重要になります。ところが、地域によって地図データの整備密度が違えば、同じ災害リスクを抱えていても、情報基盤の面で不利になる地域が出てきます。
このコンペでは、Overture Maps の建物・道路・POIなどを、Census TIGER/Line Roads、Microsoft US Building Footprints、HIFLDの重要施設データなどと比較し、「どこで地図情報が不足しているか」を数値化します。
さらに、その不足が、
- 都市部 / 農村部
- Social Vulnerability Index(SVI)の高低
- Climate Vulnerability Index(CVI)の高低
- Tribal / non-Tribal
- Heat / Wildfire / Drought の高リスク地域
でどのように偏っているかも確認します。
通常のコンペなら「予測精度が高いか」で終わりますが、このコンペでは新しい Bias Scoring API が導入され、**「どこでは当たっていて、どの地域では外しているのか」**まで確認できるのが面白いところです。
公式ページ:
- https://zindi.world/competitions/bias-bounty-mapping-equity-challenge
- https://zindi.world/competitions/bias-bounty-mapping-equity-challenge/data
- https://zindi.world/competitions/bias-bounty-mapping-equity-challenge/leaderboard
2026年8月20日時点では、コンペ開始日は 2026年8月28日 です。まだ開始前なので、この記事では公開されている仕様を整理し、実データ公開後にすぐ試せるように現時点の攻略方針をまとめます。
2. コンペ概要
| 項目 | 内容 |
|---|---|
| コンペ名 | Bias Bounty Mapping Equity Challenge |
| プラットフォーム | Zindi |
| テーマ | オープン地図データのcoverage gapと公平性の分析 |
| 主な対象 | 米国 Census tract |
| 主な地図データ | Overture Maps |
| 主な比較データ | Census TIGER/Line Roads、Microsoft US Building Footprints、HIFLD、ACS、County Business Patterns |
| 脆弱性・公平性データ | CDC SVI、U.S. Climate Vulnerability Index、USDA RUCA、Tribal land boundaries |
| 気候ハザード | Heat、Wildfire、Drought |
| 評価指標 | RMSE |
| Bias評価 | Bias Scoring APIによる5種類のequity metric |
| 開始 | 2026-08-28 |
| 終了 | 2026-10-31 |
| チーム | 最大4人 |
| 提出上限 | 1日10回、全体300回 |
| Public / Private | 現在のInfoページでは約30% / 70% |
| 参加資格 | Open to all |
| AutoML | 使用不可 |
| 使用ツール | オープンソースの言語・ツールのみ |
| データライセンス | CC-BY-SA 4.0 |
| 賞金総額 | 10,000 USD |
| 1位 | 4,500 USD |
| 2位 | 2,500 USD |
| 3位 | 1,500 USD |
| Best Documentation | 500 USD |
| Best Bias Discovery | 1,000 USD |
| Zindi points | 10,000 points |
2026年8月20日時点では 477人がJoin、Activeは0人、LeaderboardへのSubmissionはまだ0件です。
したがって、現時点では「上位解法を分析する」段階ではなく、問題設定とデータ構造を理解し、開始直後に再現性のあるベースラインを作る準備をする段階です。
3. このコンペの目標
大きく分けると、やることは2段階あります。
3.1 Overture Mapsのcoverage gapを測る
まず、Census tractごとに Overture Maps がどの程度現実世界をカバーできているかを見ます。
比較対象として公開されているのは、次のようなデータです。
| 対象 | Overture側 | 参照データ |
|---|---|---|
| 建物 | Buildings | Microsoft US Building Footprints、ACS housing unit counts |
| 道路 | Transportation | Census TIGER/Line Roads |
| POI・施設 | Placesなど | HIFLD hospitals / fire stations / schools / EMS |
| 事業所 | Placesなど | Census County Business Patterns |
ここで重要なのは、単純な「件数差」ではなく、tractの面積、人口、住宅数、都市/農村差を考えながら比較することです。
たとえば、建物100件の差があったとしても、
- 人口密集地の100件
- 広大な農村部の100件
では意味が違います。
そのため、後述するように密度や比率へ変換して特徴量化する必要があります。
3.2 coverage gapが特定の地域へ偏っていないか調べる
次に、その不足が社会的・気候的に脆弱な地域へ集中していないかを見ます。
Bias Scoring APIでは、少なくとも以下の層別評価が行われます。
- Urban / Rural
- High / Low SVI
- High / Low CVI
- Tribal / non-Tribal
- High / Low Heat exposure
- High / Low Wildfire exposure
- High / Low Drought exposure
- 上記のintersectionalな組み合わせ
この部分が、普通のGISコンペと大きく違います。
「RMSEが小さいから良い」で終わらず、
その精度は、どの地域でも同じように出ているのか?
まで考える必要があります。
4. 評価指標
4.1 LeaderboardはRMSE
Leaderboardの主要評価は RMSE(Root Mean Squared Error) です。
RMSE = sqrt( (1 / n) * Σ(y_i - y_hat_i)^2 )
RMSEは大きな誤差ほど強くペナルティを与えます。
つまり、一部のtractだけ大きく外すモデルは不利です。
このコンペでは特に、
- 都市中心部ではよく当たる
- 農村部やTribal areaでは大きく外す
という状態が起きる可能性があります。
全体RMSEだけでなく、地域グループごとのRMSEもローカルで確認しておいた方がよさそうです。
4.2 Bias Scorecard
各Submissionは Bias Scoring APIでも評価されます。
公開されているmetric名は以下です。
- Coverage Disparity Ratio
- POI Desert Index
- Emergency Access Gap
- Road Network Equity Ratio
- Climate-Justice Composite
ただし、2026年8月20日時点で公開されているZindi / Humane Intelligenceのページでは、これら5指標の詳細な算式までは確認できません。
そのため、この記事では勝手に式を決めず、開始後に公開されるData DictionaryやAPI説明を確認してから実装します。
また、Bias Scorecardは現時点ではLeaderboard順位には直接影響しません。
ただし、Best Bias DiscoveryやBest Documentationを狙うなら非常に重要です。
5. 提供予定データ
ZindiのDataページでは、次のデータ群が公開されています。
5.1 Coverage gapを作るためのデータ
- Overture Maps extract
- buildings
- transportation
- POIs
- Census TIGER/Line Roads
- Microsoft US Building Footprints
- Census ACS housing unit counts
- HIFLD critical facility datasets
- hospitals
- fire stations
- schools
- EMS
- Census County Business Patterns
5.2 Bias APIの層別評価に使われるデータ
- CDC Social Vulnerability Index
- U.S. Climate Vulnerability Index
- USDA RUCA Codes
- TIGER/Line tribal land boundaries
- U.S. Drought Monitor
- USFS Wildfire Risk to Communities
- NOAA / CDC HeatRisk
- その他のheat / wildfire / drought補足データ
ここで注意したいのは、Leaderboard用の解法では原則としてコンペ提供データだけを使うというルールです。
一方、Best Bias Discoveryについては、追加の公開データを利用できると明記されています。ただし、追加データを使った分析は再現可能な形で記録しておく必要があります。
6. 4つのFocus Region
初心者向けに、4つのFocus Regionが用意される予定です。
6.1 Maricopa County, Arizona
Phoenix都市圏と周辺のTribal communitiesが対象です。
HeatとDroughtの両方が重要で、都市部と周辺地域の地図整備状況を比較しやすい地域です。
6.2 Northern California fire corridor
Butte、Shasta、Tehama Countiesが対象です。
Wildfireリスクと、道路・建物・重要施設のmapping coverageを見る地域です。
6.3 Eastern Oklahoma tribal statistical areas
Cherokee、Muscogee、Choctawのtribal statistical areasが対象です。
Tribal landとHeat / Droughtが重なる地域で、今回のBias Bountyらしい分析対象です。
6.4 South-Central Texas border region
Bexar CountyからRio Grande Valley周辺が対象です。
HeatとDroughtに加え、既存地図で十分に表現されてこなかったcoloniasの問題もテーマになっています。
最初から全米を対象にするとGIS処理量が大きくなるので、まずはこの4地域のどれか1つで処理系を完成させ、その後全米へ広げる方が進めやすそうです。
7. このコンペの難しさ
7.1 「地図にない」と「現実にない」を分ける必要がある
Overture Mapsに建物が少ないからといって、すぐにmapping gapとは言えません。
実際に建物が少ない地域かもしれないからです。
そこで、
- Microsoft Building Footprints
- ACS housing units
- TIGER/Line
- HIFLD
- County Business Patterns
など、異なる参照データとの比較が必要になります。
7.2 データセットごとに定義が違う
道路ひとつ取っても、
- Overtureのtransportation
- TIGER/Lineのroads
では分類体系や対象範囲が完全には一致しません。
POIについても、
- Overture Places
- HIFLD hospital
- HIFLD fire station
- school
- EMS
をそのまま1対1比較できるとは限りません。
比較前のカテゴリ対応表を作る作業がかなり重要になると思います。
7.3 件数だけでは比較できない
Census tractは面積も人口も大きく違います。
そのため、
building_count
road_length
poi_count
をそのままモデルへ入れるより、
building_count / tract_area
road_length / tract_area
poi_count / population
のような密度へ変換した方が比較しやすくなります。
7.4 空間的なleakageが起きやすい
隣り合うtractは似ています。
通常のRandom KFoldを使うと、隣接する地域がtrainとvalidationに分かれ、実力以上に良いスコアが出る可能性があります。
そのため、
- County単位
- State単位
- Focus Region単位
でまとめてholdoutする検証が必要です。
7.5 データの時点差がcoverage gapに見える可能性がある
これはかなり注意が必要です。
たとえばMicrosoft US Building Footprintsは衛星画像から生成されたデータで、地域によって元画像の撮影時期が異なります。
Overture Maps側のsnapshot時点と参照データの時点が違えば、
本当にマッピングが不足しているのか
それともデータの作成年が違うだけなのか
を区別しにくくなります。
開始後は各データのvintageやsnapshot dateを最初に確認したいところです。
8. 現時点で考えているベースライン方針
まだtrain / testファイルの詳細schemaが公開されていないため、ここでは開始前の設計案として考えます。
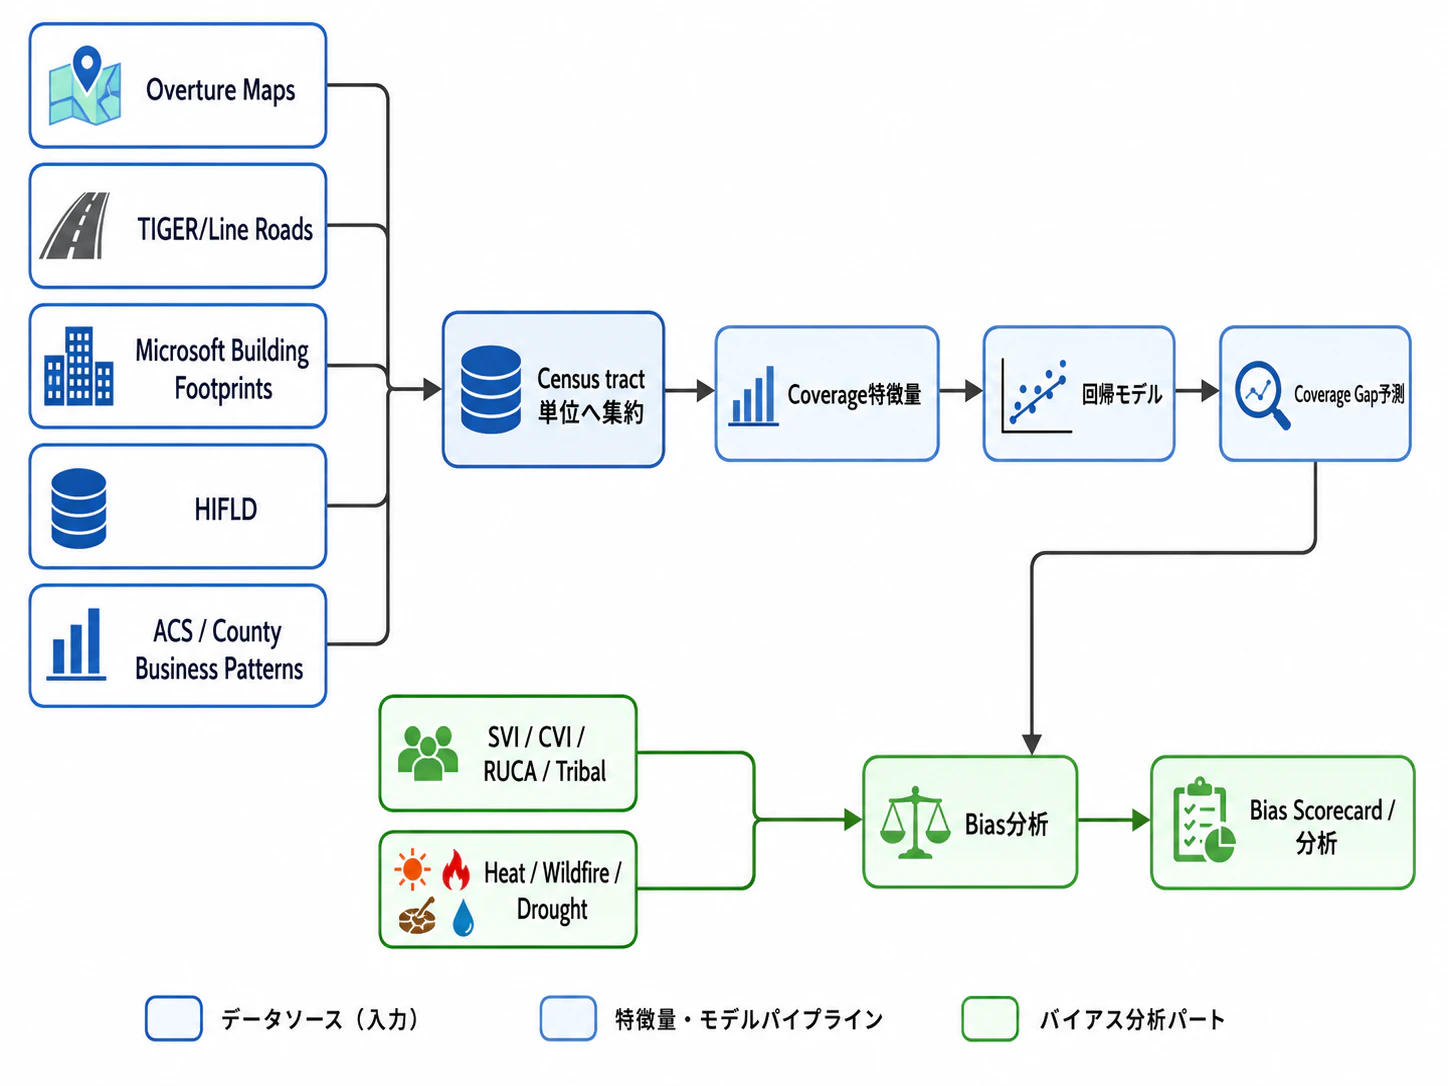
8.1 Step 1: GISでtract単位へ集約する
まず、すべての地理データを Census tract に集約します。
イメージは以下です。
8.2 Step 2: まず単純なcoverage ratioを作る
最初に試したいのは、機械学習より前のルールベースです。
建物
building_ratio =
    overture_building_count
    / reference_building_count
道路
road_ratio =
    overture_road_length
    / tiger_road_length
重要施設
facility_ratio =
    overture_matched_facility_count
    / hifld_facility_count
分母が0になるtractがあるので、実装では必ず例外処理が必要です。
さらにratioが極端な値になる場合があるので、
log1p- clipping
- winsorize
- missing flag
なども試します。
重要なのは、これらは公式のcoverage gap算式ではなく、あくまで特徴量候補という点です。
8.3 Step 3: density特徴量を追加する
次にtractの大きさを補正します。
| カテゴリ | 特徴量例 |
|---|---|
| 建物 | buildings / km² |
| 道路 | road km / km² |
| POI | POI / 1,000 population |
| 病院 | hospitals / 10,000 population |
| 消防署 | fire stations / 10,000 population |
| 学校 | schools / 1,000 housing units |
| EMS | EMS / 10,000 population |
このあたりは、絶対値よりも地域間比較がしやすくなります。
8.4 Step 4: 差分特徴量を作る
単純なratioだけでなく、
reference_count - overture_count
reference_density - overture_density
log(reference_count + 1) - log(overture_count + 1)
も試します。
特にRMSEでは極端なtractを大きく外すと不利なので、対数変換は有効かもしれません。
9. 現状で試したいモデル
まずは表形式回帰として始めます。
候補は以下です。
- Mean / Median baseline
- 線形回帰
- Ridge / ElasticNet
- Random Forest
- LightGBM
- XGBoost
- CatBoost
最初の本命は LightGBM です。
理由は、
- 欠損値を扱いやすい
- ratio、density、countが混ざった表形式データに強い
- 非線形な関係を捉えやすい
- feature importanceを確認しやすい
- CPUでも比較的速い
ためです。
その後、CatBoost / XGBoostと比較します。
9.1 SVIやCVIを最初から予測特徴量へ入れるか
ここは慎重に考えたいところです。
SVI、CVI、Tribal、Hazard exposureは、Bias Scorecardで評価するための重要な層別情報です。
これらを最初からモデルへ入れるとRMSEが改善する可能性はありますが、
「mapping coverageそのものを測っているのか」
「脆弱性属性からcoverage gapを推測しているだけなのか」
が分かりにくくなります。
そのため最初は、
Model A
地図・参照データ由来特徴量だけで予測
Model B
Model A + SVI / CVI / RUCA / Hazard
の2つを作り、
- RMSE
- Group別RMSE
- Bias Scorecard
- feature importance
を比較したいと思います。
これはBest DocumentationやBest Bias Discoveryを考えても、説明しやすい構成です。
10. 特徴量エンジニアリング
現時点で考えている特徴量です。
| カテゴリ | 例 |
|---|---|
| Geometry | tract area、perimeter、compactness |
| Buildings | Overture件数、Microsoft件数、count ratio、density、差分 |
| Roads | Overture総延長、TIGER総延長、length ratio、road density |
| POI | Overture POI数、カテゴリ別POI数、人口あたりPOI |
| Critical facilities | hospital、fire station、school、EMSの件数・不足率 |
| Housing | ACS housing units、building / housing unit ratio |
| Business | County Business Patternsの事業所数、POI / establishment ratio |
| Urbanity | RUCA |
| Vulnerability | SVI、CVI |
| Tribal | tribal intersection flag、tract内tribal area率 |
| Hazard | HeatRisk、Wildfire Risk、Drought |
| Spatial context | 隣接tract平均との差、county平均との差 |
| Missingness | sourceごとの欠損flag |
特に試したいのが 隣接tractとの差 です。
たとえば、
local_building_gap =
    tract_building_ratio
    - mean(neighbor_building_ratio)
のようにすると、全国一律の密度差ではなく、
「周辺地域と比べて、このtractだけ急に地図情報が少ない」
という状態を拾える可能性があります。
これはmapping equityのテーマとも相性が良さそうです。
11. GIS前処理で気を付けたいこと
11.1 CRS
緯度経度のまま面積や道路延長を計算しないようにします。
Focus Regionが米国本土なら、解析範囲に応じた投影座標系を使います。
CONUS全体を扱うなら、たとえばEPSG:5070のようなequal-area系も候補になります。
ただし、最終的にはコンペデータのCRSと対象地域を確認して決めます。
11.2 tract境界でclipする
道路や建物がtractをまたぐ場合、そのまま件数を数えると境界付近で偏りが出ます。
道路はtract境界でclipして長さを測り、建物は、
- centroidで所属tractを決める
- 面積按分する
など、ルールを固定しておきます。
11.3 duplicateを確認する
Overtureや参照データに重複があるとratioが崩れます。
最低でも、
- geometry hash
- source ID
- centroid距離
- IoU
などで重複候補を確認します。
11.4 road classを合わせる
高速道路だけを片方で数え、もう片方では生活道路まで数えると比較になりません。
まずカテゴリ対応表を作り、
motorway
primary
secondary
residential
service
...
のどこまで比較対象にするかを固定します。
12. 検証設計
このコンペでかなり重要なのがvalidationです。
現時点では以下を試す予定です。
1. Random KFoldで最初のベースライン
2. County GroupKFold
3. State GroupKFold
4. Focus Region holdout
5. Urban / Rural別RMSE
6. High / Low SVI別RMSE
7. Tribal / non-Tribal別RMSE
8. Hazard exposure別RMSE
9. Public LBとの差を記録
比較イメージです。
| 検証 | 目的 |
|---|---|
| Random KFold | モデルが最低限動くか確認 |
| County GroupKFold | 近隣tract leakageを減らす |
| State GroupKFold | 未知地域への汎化を見る |
| Focus Region Holdout | 地域ごとの強弱を見る |
| SVI stratified error | 社会的脆弱性による誤差差を確認 |
| Tribal stratified error | Tribal areaでの性能を確認 |
| Hazard stratified error | Heat / Wildfire / Droughtでの性能を確認 |
現在のZindi InfoページではPublic / Privateが約30% / 70%とされています。
Private側が大きいため、Public Leaderboardへ合わせすぎるより、ローカルvalidationを信用できる形にする方が重要です。
13. Bias Scorecardをローカルでも再現する
公式Bias Scoring APIの詳細式は開始後に確認するとして、ローカルでも最低限のgroup別誤差は出しておきます。
たとえば、
import numpy as np
import pandas as pd


def rmse(y_true: pd.Series, y_pred: pd.Series) -> float:
    """RMSEを計算する。"""
    error = y_true.to_numpy() - y_pred.to_numpy()
    return float(np.sqrt(np.mean(error ** 2)))


def evaluate_by_group(
    df: pd.DataFrame,
    target_col: str,
    pred_col: str,
    group_col: str,
) -> pd.DataFrame:
    """指定したgroupごとに件数とRMSEを集計する。"""
    rows: list[dict[str, object]] = []

    for group_value, group_df in df.groupby(group_col, dropna=False):
        rows.append(
            {
                "group": group_value,
                "n": len(group_df),
                "rmse": rmse(
                    group_df[target_col],
                    group_df[pred_col],
                ),
            }
        )

    return pd.DataFrame(rows).sort_values("rmse", ascending=False)
開始後は、
urban_rural
svi_group
cvi_group
tribal_flag
heat_group
wildfire_group
drought_group
の実際の列名へ合わせて使います。
全体RMSEだけでなく、
全体RMSE = 0.10
Urban    = 0.07
Rural    = 0.18
のような差が見えるようにしておくことが重要です。
14. 実装ディレクトリ案
指定記事と同じように、Notebookだけに処理を詰め込まず、再実行できる構成にしたいと思います。
zindi-mapping-equity/
├── data/
│   ├── raw/
│   ├── interim/
│   ├── processed/
│   └── submissions/
│
├── notebooks/
│   ├── 01_data_inventory.ipynb
│   ├── 02_mapping_eda.ipynb
│   ├── 03_coverage_baseline.ipynb
│   ├── 04_bias_analysis.ipynb
│   └── 05_model_comparison.ipynb
│
├── src/
│   ├── config.py
│   ├── load_data.py
│   ├── crs.py
│   ├── spatial_join.py
│   ├── aggregate_buildings.py
│   ├── aggregate_roads.py
│   ├── aggregate_facilities.py
│   ├── features.py
│   ├── validation.py
│   ├── bias_metrics.py
│   ├── train.py
│   └── predict.py
│
├── outputs/
│   ├── figures/
│   ├── models/
│   ├── metrics/
│   └── maps/
│
├── configs/
│   ├── feature_config.yaml
│   └── category_mapping.yaml
│
├── requirements.txt
└── README.md
GIS処理は、
- GeoPandas
- Pyogrio
- Shapely
- DuckDB Spatial
- Polars / Pandas
- LightGBM
あたりから始める予定です。
全国規模になってGeoPandasだけでは重くなった場合は、DuckDB SpatialやGeoParquetを使って中間集計を減らします。
15. ベースラインコードの考え方
現時点ではファイル名や目的変数列がまだ公開されていないため、下記は開始後にschemaへ合わせるための雛形です。
15.1 ratio特徴量
import numpy as np
import pandas as pd


def safe_ratio(
    numerator: pd.Series,
    denominator: pd.Series,
) -> pd.Series:
    """0除算を避けながら比率を計算する。"""
    result = numerator / denominator.replace(0, np.nan)
    return result.replace([np.inf, -np.inf], np.nan)


def add_coverage_features(df: pd.DataFrame) -> pd.DataFrame:
    """tract単位のcoverage特徴量を追加する。"""
    out = df.copy()

    # 建物のcoverage
    out["building_ratio"] = safe_ratio(
        out["overture_building_count"],
        out["reference_building_count"],
    )

    # 道路延長のcoverage
    out["road_ratio"] = safe_ratio(
        out["overture_road_length_m"],
        out["reference_road_length_m"],
    )

    # tract面積で正規化
    out["overture_building_density"] = safe_ratio(
        out["overture_building_count"],
        out["tract_area_km2"],
    )

    out["reference_building_density"] = safe_ratio(
        out["reference_building_count"],
        out["tract_area_km2"],
    )

    # 差分も残す
    out["building_count_diff"] = (
        out["reference_building_count"]
        - out["overture_building_count"]
    )

    out["road_length_diff_m"] = (
        out["reference_road_length_m"]
        - out["overture_road_length_m"]
    )

    return out
15.2 LightGBM baseline
import lightgbm as lgb
import numpy as np
import pandas as pd
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import GroupKFold


TARGET = "TARGET_COLUMN"      # 開始後に実際の列名へ変更
GROUP = "COUNTY_GEOID"        # County単位で空間leakageを抑える


feature_cols = [
    "building_ratio",
    "road_ratio",
    "overture_building_density",
    "reference_building_density",
    "building_count_diff",
    "road_length_diff_m",
]


X = train[feature_cols]
y = train[TARGET]
groups = train[GROUP]

oof = np.zeros(len(train))

cv = GroupKFold(n_splits=5)

for fold, (tr_idx, va_idx) in enumerate(cv.split(X, y, groups)):
    X_tr = X.iloc[tr_idx]
    y_tr = y.iloc[tr_idx]
    X_va = X.iloc[va_idx]
    y_va = y.iloc[va_idx]

    model = lgb.LGBMRegressor(
        objective="regression",
        n_estimators=1500,
        learning_rate=0.03,
        num_leaves=31,
        random_state=42,
    )

    model.fit(
        X_tr,
        y_tr,
        eval_set=[(X_va, y_va)],
        callbacks=[lgb.early_stopping(100)],
    )

    oof[va_idx] = model.predict(X_va)

rmse = mean_squared_error(y, oof) ** 0.5
print(f"OOF RMSE: {rmse:.6f}")
最初は特徴量を増やしすぎず、
building_ratio
road_ratio
facility_ratio
各density
各difference
tract_area
程度から始めます。
16. 最初に確認したいEDA
データ公開後、まず以下を確認します。
- train / testの行数
- 1行が本当に1 Census tractなのか
- GEOIDの形式
- Target列名
- Targetの分布
- 0付近への偏り
- 外れ値
- 欠損値
- Focus Regionの割り当て
- train / testの州・County構成
- tract面積分布
- building count分布
- road length分布
- Overture / reference ratio分布
- SVI / CVI分布
- Tribal tractの件数
- Heat / Wildfire / Drought高リスクtractの件数
さらに、地図で可視化します。
数値だけで見るより、
coverage gap
SVI
CVI
HeatRisk
Wildfire Risk
Drought
を重ねると、空間的な偏りを見つけやすくなります。
17. Best Bias Discoveryも狙いたい
このコンペには通常順位とは別に Best Bias Discovery があります。
これはかなり面白い部門です。
Bias Scoring APIで自動的に出る指標だけでなく、
自動評価では拾えていないが、現実の防災や気候レジリエンス上重要なcoverage gap
を発見し、その背景を説明します。
現時点で考えられる候補は、
- Tribal land境界付近でのcoverage急変
- urban / rural境界での道路coverage差
- colonias周辺の重要施設POI不足
- wildfire evacuation route周辺のroad mapping gap
- 高HeatRisk地域のEMS / hospital coverage不足
- 高Drought地域のcritical facility mapping gap
- 隣接tract間で不自然に大きいcoverage discontinuity
などです。
ただし、この部門で追加の公開データを利用する場合は、
- データURL
- 取得日
- ライセンス
- 前処理
- join key
- CRS
- 集計方法
まで残し、第三者が再現できるようにします。
18. チャレンジロードマップ
指定記事と同じように、段階を分けて進めます。
Step 1: データ一覧を確認する
開始日にDataページを確認し、ファイル名、schema、CRS、Target、Sample Submissionを整理します。
Step 2: 1つのFocus Regionだけ可視化する
最初から全米へ行かず、Maricopa Countyなど1地域で、
- Census tract
- Overture buildings
- TIGER roads
- Microsoft buildings
- HIFLD
を重ねます。
Step 3: Rule-based baselineを作る
building ratio、road ratio、facility ratioなどから単純なcoverage gapを作ります。
Step 4: LightGBMで最初のSubmission
tract単位の集約特徴量を使い、まず1回提出してRMSEとSubmission形式を確認します。
Step 5: Spatial validationへ変更する
Random KFoldからCounty / State GroupKFoldへ変えます。
Step 6: Bias analysisを追加する
Urban / Rural、SVI、CVI、Tribal、Hazard別のRMSEをローカルでも出します。
Step 7: Spatial context特徴量を追加する
隣接tract平均との差、County平均との差などを追加します。
Step 8: CatBoost / XGBoostと比較する
LightGBM単体より安定するか確認します。
Step 9: アンサンブル
ローカルvalidationで相関が低いモデルを組み合わせます。
Step 10: Best Bias Discovery用の分析を行う
地図上の不連続、境界、hazard overlapなどを重点的に確認します。
Step 11: 再現性を整える
raw dataからSubmissionと図表まで、一発で再作成できる構成にします。
19. 現時点での戦略
開始前の段階では、次の順番がよさそうです。
GIS集約
  ↓
単純なcoverage ratio
  ↓
LightGBM baseline
  ↓
Spatial validation
  ↓
Bias group別誤差
  ↓
Spatial context特徴量
  ↓
CatBoost / XGBoost
  ↓
Ensemble
  ↓
Bias Discovery
特に重要なのは、最初からSVIやCVIをモデルへ大量に入れることではなく、
地図そのもののcoverage差を、地図・参照データからどこまで説明できるか
を先に確認することだと思います。
その上で、脆弱性や気候リスクとcoverage gapがどのように重なるかを分析する方が、今回のテーマに合っています。
20. まとめ
Bias Bounty Mapping Equity Challengeは、GIS、機械学習、気候リスク、公平性評価が交差するかなり面白いコンペです。
通常の予測コンペと違い、単にRMSEを下げるだけではなく、
- 地図データはどこで不足しているのか
- その不足はどのコミュニティに集中しているのか
- 防災や救急対応にどのような影響がありそうか
まで考える必要があります。
現時点で特に重要だと考えているのは以下です。
- Overtureと参照データをCensus tract単位へ正しく集約する
- 件数ではなくratio・density・差分を見る
- Road / POIカテゴリの定義を合わせる
- Random KFoldだけで評価しない
- County / State単位のSpatial validationを使う
- RMSEと同時にgroup別誤差を見る
- SVI / CVI / Tribal / Hazardを説明変数と評価軸で分けて考える
- Bias Scorecardの詳細式は公開後に公式仕様を確認する
- Public Leaderboardへ合わせすぎない
- Best Bias Discoveryでは地図として説明できる発見を残す
2026年8月20日時点ではまだSubmissionがなく、本当の勝負は8月28日のデータ公開後です。
まずは 1地域 → tract集約 → coverage ratio → LightGBM → Spatial validation までを早めに完成させ、そこから特徴量とBias分析を強化していきたいと思います。
サンプルコードなどは次回作成します。
21. 参考リンク
- Zindi - Bias Bounty Mapping Equity Challenge
- Zindi - Data
- Zindi - Leaderboard
- Humane Intelligence - Bias Bounties on Zindi Preview
- Humane Intelligence - Bias Bounty
- Overture Maps - Schema
- U.S. Census Bureau - TIGER/Line Shapefiles
- Microsoft - US Building Footprints
- CDC/ATSDR - Social Vulnerability Index
- USDA ERS - Rural-Urban Commuting Area Codes
- Wildfire Risk to Communities - Download Data
- U.S. Drought Monitor - Data