
線状降水帯予測プロトタイプを作ってみる r001 ー 全体構成
1. はじめに
前回の記事にも書いていますが、線状降水帯の予測を考えるとき、最初から気象庁と同じ精度や運用を目指すのは現実的ではありません。
予測に使うデータ量が大きく、積乱雲の発生位置や発達のしかたには不確実性もあります。さらに、現在の気象庁ではLFMやLEPSのような高解像度の数値予報を使い、複数の予測結果を組み合わせながら豪雨の可能性を評価しています。
そこで、このプロトタイプでは目的を少し絞ります。
数値予報から強い雨のまとまりを抽出し、その位置、形、継続時間、予測のばらつきを整理し、過去の実況と比較できるところまでを作る。
これをr001の完成条件とします。
もう一つ、最初から決めておきたいことがあります。
予測データは固定しません。
r001では、できるだけ無償で利用できるデータから始めます。ただし、将来LFMやLEPSを使いたくなったときに、解析部分を作り直すのは避けたいところです。
そのため、データ取得部分をProviderとして分離し、解析側は「どこから取得したデータか」を意識しない構成にします。
2. r001で目指すところ
r001では、次の流れを一通り動かせる状態を目標にします。

対象とするのは、まず3時間程度先までの強雨域候補です。
結果として、少なくとも次の内容を確認できるようにします。
- どの地域に強雨域候補が出ているか
- 何時ごろから現れる予測か
- どのくらい継続する予測か
- 最大3時間雨量はどの程度か
- 雨域の面積はどの程度か
- 細長い形になっているか
- 複数の予測で位置がどの程度一致しているか
- 実際の雨と比べて、どの程度ずれたか
r001では、これをそのまま「線状降水帯が発生する」とは表示しません。
画面や出力では、
線状強雨域候補
または
強雨域候補
として扱います。
3. r001では行わないこと
最初から範囲を広げすぎると、予測方法そのものの検証ができなくなります。
r001では、次の内容は対象外とします。
- 気象庁の線状降水帯情報の再現
- 市町村単位での発生断定
- 避難指示などの防災判断
- AIだけによる発生判定
- 全国を対象とした24時間365日の本番運用
- スマートフォン向け通知
- 外部向け一般公開サービス
- 有償データを前提にした構成
これらは、r001の結果を確認してから段階的に追加します。
4. 全体構成
構成は、データ取得、正規化、解析、保存、API、表示、検証の7つに分けます。

解析部分はProviderから切り離します。
例えば、r001ではOpen-Meteo経由のMSMを使い、r002で公式LFMへ切り替えたとしても、
3時間積算
強雨域抽出
雨域追跡
複数予測比較
検証
は同じコードを使います。
5. データ取得部分を交換可能にする
5.1 Providerの役割
Providerが担当するのは、外部データを取得して、内部の共通形式へ渡すところまでです。

Providerごとに違ってよいのは、ここまでです。
例えば、
- JSON
- GRIB2
- 圧縮ファイル
- API
- ファイルダウンロード
といった違いはProviderの中で吸収します。
解析処理には、外部サービス固有のファイル名やURLを持ち込まないようにします。
5.2 最初に用意するProvider
r001では、次の2つを実装対象とします。
OpenMeteoJmaMsmProvider
Open-Meteoが提供するJMA MSMデータを読みます。
主な用途は、
- 現在の予測を使った処理確認
- API取得処理の確認
- 複数初期時刻の比較
- 強雨域抽出処理の動作確認
です。
Open-MeteoのJMA APIでは、MSMは約5 km格子、1時間間隔で提供されています。
ただし、無料APIは非商用利用向けです。
r001の技術検証には利用できますが、将来業務システムとして使う場合は、利用条件を改めて確認します。
DiasMsmArchiveProvider
DIASに保存されている気象庁GPVの過去データを読みます。
主な用途は、
- 過去豪雨の再現
- 過去の線状降水帯事例の検証
- 予測位置誤差の確認
- 判定条件の調整
です。
DIASのGPVアーカイブにはMSMやレーダー観測データが含まれています。
こちらも利用規約上、非商業的な研究・教育用途として提供されているため、r001では検証用データ源として位置付けます。
5.3 将来追加するProvider
次のProviderはインターフェースだけ決めておき、r001では本実装しません。
JmbscLfmProvider
JmbscLepsProvider
JmaCloudLfmProvider
JmaCloudLepsDetailProvider
将来、有償データへ移行するときに追加します。
2026年3月から、気象庁のLFMは水平格子間隔1 kmへ高解像度化されています。
また、LEPSは水平格子間隔2 km、21メンバー、21時間先までの局地アンサンブル予報です。
r001の解析ロジックをそのまま使い、
MSM 5 km
    ↓
LFM 1 km

単一予測の複数初期値比較
    ↓
LEPS 21メンバー
へ段階的に移行できる構成にします。
6. Providerインターフェース
実装時には、概ね次のような責務にします。
class ForecastProvider:
    """数値予報データ取得元の共通インターフェース。"""

    def list_runs(...):
        """利用可能な初期時刻を返す。"""

    def fetch(...):
        """指定した初期時刻・予報時間・領域のデータを取得する。"""

    def normalize(...):
        """外部形式を内部共通形式へ変換する。"""

    def metadata(...):
        """モデル名、解像度、取得元、利用条件などを返す。"""
実際のコードではProtocolまたは抽象基底クラスとして定義します。
Providerの切り替えは設定ファイルで行います。
forecast:
  provider: openmeteo_jma_msm
  area:
    west: 136.0
    east: 140.0
    south: 33.5
    north: 36.5
将来LEPSへ切り替える場合も、
forecast:
  provider: jmbsc_leps
のように変更できる形を目指します。
7. 内部の共通データ形式
Providerを交換可能にするには、外部データを共通形式へ変換する必要があります。
ここではForecastRunを基本単位にします。
ForecastRun
├─ provider_id
├─ model_id
├─ init_time
├─ valid_time
├─ lead_time
├─ member_id
├─ variable
├─ level
├─ unit
├─ grid
├─ values
├─ source_reference
└─ sha256
例えば、
provider_id = openmeteo_jma_msm
model_id    = jma_msm
init_time   = 2026-09-08T00:00:00Z
valid_time  = 2026-09-08T03:00:00Z
lead_time   = PT3H
member_id   = control
variable    = precipitation
unit        = mm
のように保存します。
時刻はUTCを正本にする
内部ではUTCに統一します。
画面表示のみ、
Asia/Tokyo
へ変換します。
複数モデルを扱うと、初期時刻や予報時間の定義がずれやすいため、ここは最初から固定します。
8. 保存形式
保存データは4種類に分けます。
Raw Data
取得したデータをそのまま残します。
data/raw/
ここにはAPI応答、GRIB2、圧縮ファイルなどを保存します。
Raw Dataは解析用に直接編集しません。
Grid Data
正規化した格子データです。
data/processed/grid/
Pythonではxarrayで扱い、保存形式はZarrを第一候補とします。
時間方向、メンバー方向、緯度経度方向をまとめて扱いやすいためです。
Candidate Data
抽出した強雨域候補です。
data/processed/candidate/
GeoParquetで保存します。
主な属性は、
candidate_id
run_id
member_id
valid_time
area_km2
max_rainfall_mm
major_axis_km
minor_axis_km
axis_ratio
centroid_lon
centroid_lat
geometry
とします。
Control Data
処理履歴や検証結果はDuckDBで管理します。
data/control/control.duckdb
例えば、
forecast_run
forecast_asset
candidate
candidate_track
ensemble_summary
validation_result
を保存します。
9. 解析処理
9.1 3時間積算雨量
時間間隔をそろえたうえで、移動窓を使って3時間積算雨量を作ります。
10:00~13:00
10:30~13:30
11:00~14:00
...
データの時間間隔が1時間の場合は、
10:00~13:00
11:00~14:00
12:00~15:00
のように扱います。
Providerによって時間解像度が異なるため、積算処理側では時間幅をハードコードしません。
9.2 強雨域候補の抽出
処理は次の順番です。

初期値は、気象庁が線状降水帯の直前予測で用いている条件を参考にします。
ただし、気象庁の情報では災害危険度なども組み合わせて判定しているため、このプロトタイプの結果を気象庁の「線状降水帯」と同じものとして扱いません。
閾値は設定ファイルへ出します。
candidate:
  accumulation_hours: 3
  rainfall_threshold_mm: 100
  min_area_km2: 500
  min_axis_ratio: 2.5
  min_max_rainfall_mm: 145
これにより、過去事例を使って条件を変更しながら比較できます。
10. 雨域追跡
1時刻だけ強い雨域が現れても、継続的な強雨とは限りません。
そのため前後時刻の候補を比較します。
t-1
 ↓
 t
 ↓
t+1
比較する項目は、
- Polygonの重なり
- 重心間距離
- 面積変化
- 最大雨量変化
- 長軸方向
- 移動速度
です。
同じ雨域と判断できたものをcandidate_trackとしてまとめます。
これにより、
発生時刻
終了時刻
継続時間
移動距離
移動方向
を求めます。
11. 複数予測の比較
r001では、LEPSの21メンバーはまだ使いません。
代わりに、MSMの複数初期時刻を比較します。
例えば、
09時初期値
12時初期値
15時初期値
18時初期値
について、同じ有効時刻の強雨域候補を比較します。

これは正式なアンサンブル予報ではありません。
r001では、
発生確率
ではなく、
候補検出Run数
Run一致率
位置のばらつき
として出力します。
LEPSへ切り替えたときは、この部分を21メンバー比較へ置き換えます。
12. 実況との比較
予測結果だけでは、方法が使えるか判断できません。
過去事例について、
予測
 ↓
強雨域候補
 ↓
実際の雨
 ↓
比較
まで行います。
最低限、次の指標を保存します。
| 指標 | 内容 |
|---|---|
| 発生有無 | 候補が実況でも確認できたか |
| 位置誤差 | 候補中心位置のずれ |
| 開始時刻誤差 | 予測と実況の開始時刻差 |
| 最大雨量誤差 | 最大積算雨量の差 |
| 継続時間誤差 | 強雨継続時間の差 |
| 空振り | 候補を出したが実況では確認できない |
| 見逃し | 実況では発生したが候補を出せない |
線状降水帯が発生した日だけを使うのではなく、発生しなかった大雨事例も含めるようにします。
13. API
解析結果はFastAPIから取得します。
最初は次の程度で十分です。
GET /api/runs
GET /api/runs/{run_id}

GET /api/candidates
GET /api/candidates/{candidate_id}

GET /api/tracks
GET /api/ensemble-summary

GET /api/validation
格子データそのものをすべてJSONにするのは避けます。
地図表示用には、
- PNG
- Cloud Optimized GeoTIFF
- 必要に応じてベクトルタイル
を使う構成を検討します。
14. Web画面
r001では画面を作り込みません。
OpenLayersで確認に必要なものだけ表示します。
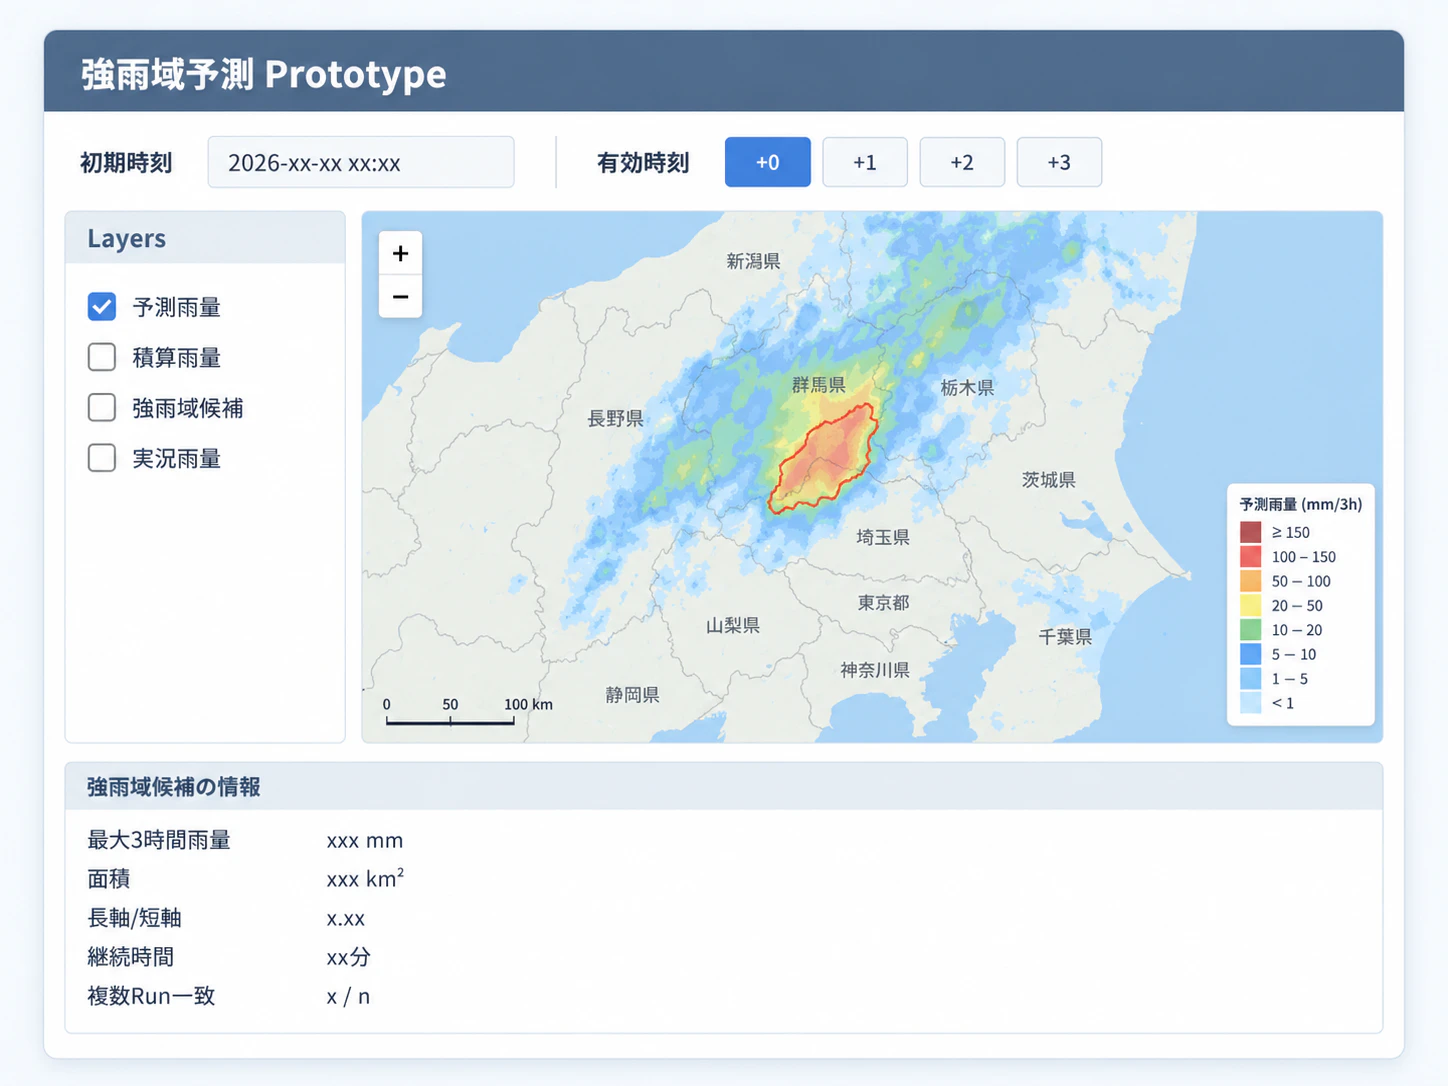
r001ではUIよりも、データ処理と検証を優先します。
15. Docker構成
Windows 11 + WSL2 Ubuntu環境で動かすことを想定し、Docker Composeでまとめます。
browser
   │
   ▼
nginx
   │
   ├──────────► frontend / OpenLayers
   │
   ▼
FastAPI
   │
   ├──────────► DuckDB
   ├──────────► GeoParquet
   └──────────► Zarr

worker
   │
   ├──────────► Provider
   ├──────────► rainfall accumulation
   ├──────────► candidate detection
   ├──────────► tracking
   └──────────► validation
r001ではCeleryやRedisは必須にしません。
処理時間や並列化の必要性が見えてから追加します。
16. ディレクトリ構成案
linear-rainband-prototype/
├─ compose.yaml
├─ .env.example
├─ README.md
│
├─ backend/
│  ├─ app/
│  │  ├─ api/
│  │  ├─ providers/
│  │  │  ├─ base.py
│  │  │  ├─ openmeteo_jma_msm.py
│  │  │  ├─ dias_msm_archive.py
│  │  │  ├─ jmbsc_lfm.py
│  │  │  └─ jmbsc_leps.py
│  │  │
│  │  ├─ domain/
│  │  │  ├─ forecast_run.py
│  │  │  ├─ rainfall_grid.py
│  │  │  ├─ candidate.py
│  │  │  └─ track.py
│  │  │
│  │  ├─ processing/
│  │  │  ├─ accumulation.py
│  │  │  ├─ candidate_detection.py
│  │  │  ├─ tracking.py
│  │  │  └─ comparison.py
│  │  │
│  │  ├─ validation/
│  │  │  ├─ observation_loader.py
│  │  │  └─ evaluator.py
│  │  │
│  │  └─ storage/
│  │     ├─ raw_store.py
│  │     ├─ grid_store.py
│  │     ├─ geoparquet_store.py
│  │     └─ duckdb_store.py
│  │
│  └─ tests/
│
├─ frontend/
│  └─ OpenLayers
│
├─ config/
│  ├─ providers.yaml
│  └─ candidate.yaml
│
├─ data/
│  ├─ raw/
│  ├─ processed/
│  │  ├─ grid/
│  │  └─ candidate/
│  ├─ validation/
│  └─ control/
│
└─ docs/
Providerをprocessingとは別ディレクトリに置くところが、この構成のポイントです。
17. 費用の考え方
r001
r001は、追加データ費0円を目標にします。
| 項目 | 想定 |
|---|---|
| Open-Meteo JMA MSM | 0円 ※非商用無料枠 |
| DIAS GPV Archive | 0円 ※研究・教育用途 |
| Python | 0円 |
| FastAPI | 0円 |
| DuckDB | 0円 |
| OpenLayers | 0円 |
| Docker Engine | 0円 |
| 既存PC | 追加購入なし |
| データ費合計 | 0円 |
電気代、インターネット回線、既存PCの費用は含めません。
また、Open-Meteo無料APIとDIASは利用条件があるため、0円というのは非商用の技術検証を前提とします。
将来の公式データ
2026年9月時点の気象業務支援センター公表額では、オンライン配信の情報別負担金は次のとおりです。
| データ | 月額・税別 |
|---|---|
| MSM | 7,800円 |
| LFM | 9,600円 |
| LEPS | 7,800円 |
このほか、契約形態に応じて基本負担金、通信設備負担金、開設時負担金などがあります。
気象庁クラウドでは、現在、
基本負担金       4,200円/月
情報別負担金     1,000円/月・データ種類
ID使用料         3,000円/月・ID
ダウンロード料      30円/GB
という構成です。
したがって、将来のLFM・LEPS移行では、
必要なファイルだけ取得する設計
にしておくことが費用面でも効いてきます。
r001ではこの費用を発生させません。
18. ログと再現性
気象予測は後から同じ条件を確認できることが大切です。
各Runには、
provider
model
initial_time
valid_time
member
取得日時
元データ識別子
SHA-256
設定ファイル
プログラムVersion
を保存します。
解析結果だけ残して元データを捨てる構成にはしません。
同じ入力と設定から同じ候補を再生成できるようにします。
19. テスト
r001からテストを入れます。
Providerテスト
- APIレスポンスを正しく読めるか
- GRIB2を正しく読めるか
- 時刻変換が正しいか
- 単位変換が正しいか
- 欠損値を誤って0にしていないか
積算雨量テスト
既知の小さな配列を使い、3時間積算値を手計算と比較します。
雨域抽出テスト
人工的に作った格子で、
- 1個の雨域
- 2個に分かれた雨域
- 細長い雨域
- 面積不足の雨域
を判定します。
追跡テスト
少しずつ移動する人工雨域を作り、同じTrackとして追跡できるか確認します。
回帰テスト
過去事例を固定し、コード変更によって候補抽出結果が不用意に変わっていないか確認します。
20. 開発Step
全体を6段階に分けます。
Step 1 データ取得と共通形式
Provider
 ↓
MSM取得
 ↓
時刻・単位・格子を正規化
 ↓
ForecastRun
 ↓
保存
完了条件
-
OpenMeteoJmaMsmProviderが動く -
DiasMsmArchiveProviderが動く - 同じ内部形式へ変換できる
- 元データとSHA-256を残せる
Step 2 積算雨量
完了条件
- 指定した時間窓で積算雨量を作れる
- 欠測を検出できる
- PNGまたはGeoTIFFで確認できる
Step 3 強雨域候補抽出
完了条件
- 閾値抽出
- 連結成分
- Polygon化
- 面積
- 長軸・短軸
- 最大雨量
まで計算できる。
Step 4 時間追跡
完了条件
- 前後時刻の候補を対応付けられる
- 開始時刻と終了時刻を出せる
- 継続時間を出せる
Step 5 複数予測比較
完了条件
- 複数初期時刻の予測を比較できる
- 候補検出Run数を出せる
- 位置、時刻、雨量のばらつきを出せる
Step 6 過去事例検証とWeb表示
完了条件
- 過去の発生事例を1件以上検証する
- 非発生の大雨事例も検証する
- 位置誤差、時刻誤差、空振り、見逃しを記録する
- OpenLayersで予測と実況を重ねて確認できる
ここまでをPrototype r001完成とします。
21. r001完成後
r001で方法の有効性が確認できたら、次の順番で拡張します。

r002
LFM 1 kmを追加し、MSMとの差を比較します。
r003
LEPS 21メンバーを追加し、正式なアンサンブル比較へ進みます。
r004
過去事例を増やし、
メンバー一致率
    ↓
実際の発生率
を調べます。
ここで初めて「発生可能性」として扱えるかを検討します。
r005
十分な検証データが蓄積した段階で、
- LightGBM
- ロジスティック回帰
- その他の統計・機械学習モデル
を比較します。
AIはこの段階からで十分です。
22. この設計で優先すること
このプロトタイプでは、精度を急いで上げるより先に、
- どのデータを使ったか分かる
- データ取得元を交換できる
- 同じ入力で再計算できる
- 強雨域をどの条件で抽出したか分かる
- 予測と実況を後から比較できる
という状態を作ります。
線状降水帯は予測が難しい現象なので、結果だけを表示しても、その数字が妥当か判断できません。
まずはMSMと過去データを使い、
どの条件なら候補を拾えるのか
どの程度位置がずれるのか
どんなときに空振りするのか
を確認できる仕組みを作ります。
そのうえでLFMやLEPSへ差し替えれば、データが細かくなった効果や、アンサンブル予報を使う効果も比較できます。
結構長い時間がかかりそうですが、頑張って作成して行きましょう。
23. 参考資料
-
気象庁 メソモデル(MSM)
https://www.data.jma.go.jp/suishin/cgi-bin/catalogue/make_product_page.cgi?id=MesModel -
気象庁 局地モデル高解像度化に関する資料
https://www.data.jma.go.jp/suishin/oshirase/pdf/20260217b -
気象庁 局地アンサンブル予報システム(LEPS)資料
https://www.data.jma.go.jp/suishin/oshirase/pdf/20260217c -
気象庁 アンサンブル予報データの解説
https://www.data.jma.go.jp/developer/weatherdataguide/appendix/2-2-h.html -
DIAS 気象庁GPVアーカイブ
https://search.diasjp.net/ja/dataset/GPV -
Open-Meteo JMA API
https://open-meteo.com/en/docs/jma-api -
Open-Meteo 利用条件
https://open-meteo.com/en/terms -
気象業務支援センター 情報提供負担金
https://www.jmbsc.or.jp/jp/online/c-onlineF.html -
気象業務支援センター 気象庁クラウド環境
https://www.jmbsc.or.jp/jp/online/x-online0.html -
気象業務支援センター 気象庁クラウド環境の情報提供負担金
https://www.jmbsc.or.jp/jp/online/c-onlineC.html