
最初に
前回は、損失関数について解説しました
損失関数は、AIの予測と正解のズレを数値で評価するものでした
しかし、間違いの大きさが分かっただけでは、予測は良くなりません
ここで、次の疑問が出てきます
「間違いを小さくするために、何を、どう変えればいいのか?」
今回は、そのための方法である 勾配降下法(Gradient Descent) について解説します
最後に、小さなニューラルネットワークを実際に動かしてみます
勾配降下法とは
勾配降下法とは、損失が小さくなる方向を勾配から調べ、重みやバイアスを少しずつ更新する方法です
ニューラルネットワークの計算には、入力に掛け合わせる「重み」と、その計算結果に足す「バイアス」があります
これらの数値によって、同じ入力に対する予測も変わります
つまり、ここでいう学習とは、 「予測が正解に近づくように、モデル内部の数値を調整すること」
損失関数で間違いを測り、勾配降下法でその間違いを減らすように調整します
坂道を下るイメージで考える
例えば、視界の悪い坂道で、低い場所へ下りたい場面を想像した場合、遠くまで見えなくても足元の傾きが分かれば、下りになっている方向へ少しずつ進めます
今いる場所の傾きを調べる
↓
下りになっている方向へ少し進む
↓
移動した場所で、もう一度傾きを調べる
このイメージを学習に置き換えると、地面の高さが「損失」、今いる場所が「現在の重みやバイアスの値」に当たります
一度に正解の場所へ移動するのではなく、現在地の情報を使って、損失の小さい場所を探していきます
なお、実際のニューラルネットワークでは地形が複雑なので、必ず一番低い場所に到達できるわけではありません
「勾配」って何?
ここで出てきた「勾配」は、坂道の傾きに相当するものです
重みを1つだけ考えるなら、 「その重みを少し増やしたときに、損失がどちらへ、どれくらい変化するか」 を表すのが、その重みに対する勾配です
重みやバイアスが複数ある場合は、それぞれについて計算した値をまとめて勾配と呼びます
| 勾配の符号 | 現在の重みを少し増やすと | 損失を減らすための更新方向 |
|---|---|---|
| プラス | 損失が増える方向 | 重みを減らす |
| マイナス | 損失が減る方向 | 重みを増やす |
重要なのは、勾配と反対の方向へ進むことです
勾配を使うから、そのまま足す」のではなく、基本的な勾配降下法では引き算をします
新しい重み = 今の重み − 学習率 × 勾配
バイアスも、同じ考え方で更新します
ここでの傾きは「重みの値と損失の関係」の傾きです
学習回数を横軸にしたグラフの傾きを使っているわけではありません
一歩の大きさを決める「学習率」
新式に出てきた 学習率(Learning Rate) は、勾配を使って更新するときの大きさを調整する値です
実際の更新量は「学習率 × 勾配」で決まります
坂道の例では、一歩の大きさを調整する役割に当たります
| 学習率 | 起こりやすいこと |
|---|---|
| 小さすぎる | 更新が小さく、学習がなかなか進まない |
| 適切な大きさ | 損失を減らす学習が進みやすい |
| 大きすぎる | 良い位置を飛び越え、損失が振動したり増え続けたりする |
つまり、 「大きくすれば速く学習できる」 というものではありません
重みやバイアスは学習によって更新される数値ですが、学習率は学習の進め方を調整する設定です
このような設定を 「ハイパーパラメータ」 と呼びます
実際の数字で見てみる
簡単な例で、重みがどう変わるかを確認します
ここでは計算を分かりやすくするため、バイアスは使いません
予測 = 入力 × 重み

入力:1
正解:2
最初の重み:1
最初の予測は「1 × 1 = 1」なので、正解の2から外れています
今回は、前回紹介した平均二乗誤差(MSE)を使います
データが1件なので、損失は「予測と正解の差を二乗した値」になります
損失 = (1 − 2)² = 1
この例では、損失は (重み − 2)² です
これを重みについて微分すると、勾配は 2 × (重み − 2) になります
最初の重みは1なので、勾配は −2 です
学習率を 0.1 にすると、重みは次のように更新されます
新しい重み = 1 − 0.1 × (−2)
           = 1.2
重みが増えたので、新しい予測も1.2になります
更新後の損失 = (1.2 − 2)²
             = 0.64
損失が1から0.64に小さくなりました
毎回、その時点の重みから勾配を計算し直して更新を続けると、以下のようになります
| 更新回数 | 重み=今回の予測 | 損失 |
|---|---|---|
| 0回 | 1.00000 | 1.00000 |
| 1回 | 1.20000 | 0.64000 |
| 2回 | 1.36000 | 0.40960 |
| 3回 | 1.48800 | 0.26214 |
| 4回 | 1.59040 | 0.16777 |
| 5回 | 1.67232 | 0.10737 |
この例では、重みが2に近づくほど予測が正解に近づき、損失も小さくなります
誤差逆伝播法との違い
ここで、ニューラルネットワークの学習でよく登場する、もう1つの言葉を紹介します
誤差逆伝播法(バックプロパゲーション) です
ニューラルネットワークには、たくさんの重みやバイアスがあります
それぞれの勾配を、出力側から入力側へ計算をたどって効率よく求める仕組みが、誤差逆伝播法です
勾配降下法とは、役割が異なります
| 名前 | 役割 |
|---|---|
| 誤差逆伝播法 | 各パラメータに対する損失の勾配を計算する |
| 勾配降下法 | 計算した勾配を使ってパラメータを更新する |
「勾配を計算する処理」 と 「重みを更新する処理」 は別、という点を押さえておくとこのあとのコードが読みやすくなります
ここまでの流れをまとめると、以下のようになります
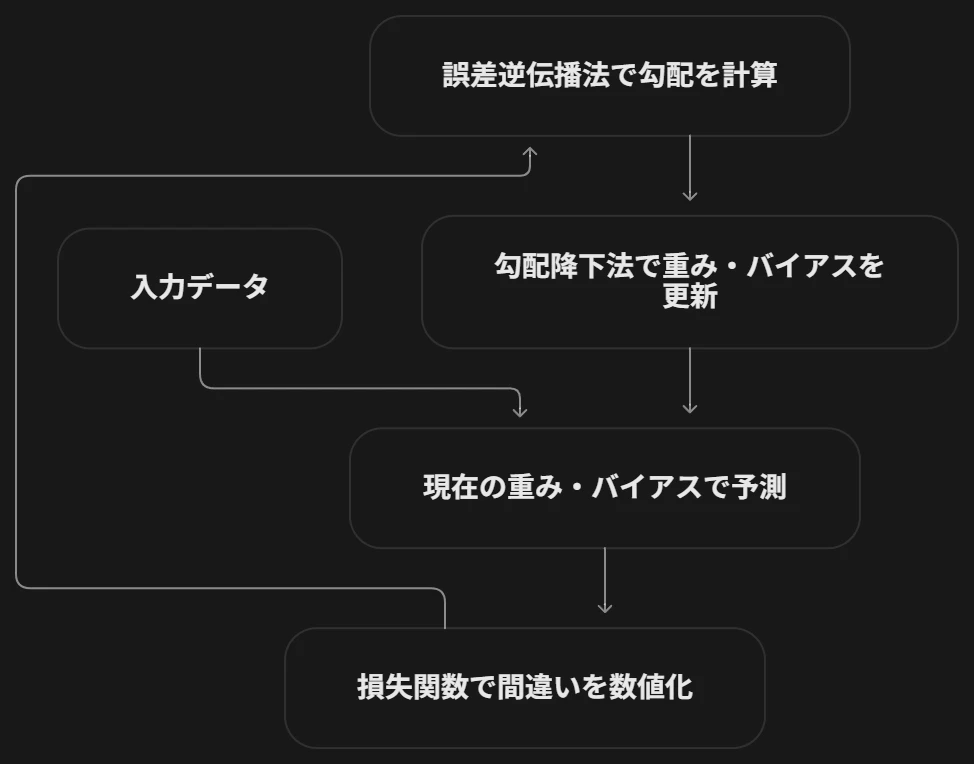
この処理を繰り返すことで、ニューラルネットワークの学習が進みます
小さなニューラルネットワークを作ってみる
ここからは、PyTorchを使って実際に動かしてみます
今回学習するのは、「入力を2倍して1を足す」という関係です
イメージは以下になります
入力:0.00 → 正解:1.0
入力:0.25 → 正解:1.5
入力:0.50 → 正解:2.0
入力:0.75 → 正解:2.5
入力:1.00 → 正解:3.0
これくらいの関係なら、もっと単純なモデルで十分ですが、今回は 「これまで説明した仕組みが、コードではどこに当たるのか」 を確認するため、あえてニューラルネットワークを使います
構成は
入力1個 → 隠れ層8個(ReLU) → 出力1個
ReLU関数を使うので、以下の記事を読むといいかもです
準備
掲載コードの動作確認環境は、Python3.10.6/PyTroch2.10.0+cu130です
GPUやCUDAがなくても動作するようにはしています
コード
以下を neural_network_intro.py として保存します
import platform
import torch
from torch import nn

def main() -> None:
    # CUDAを利用できる場合はGPU、利用できない場合はCPUで実行する
    use_cuda = torch.cuda.is_available()
    device = torch.device("cuda" if use_cuda else "cpu")

    print(f"Python: {platform.python_version()}")
    print(f"PyTorch: {torch.__version__}")
    print(f"PyTorchのCUDAバージョン: {torch.version.cuda}")
    print(f"CUDA利用可能: {use_cuda}")
    print(f"使用デバイス: {device}")
    if use_cuda:
        print(f"GPU: {torch.cuda.get_device_name(device)}")
    else:
        print("CUDAを利用できないため、CPUで実行します")

    # 初期値をそろえ、同じ環境で結果を比較しやすくする
    torch.manual_seed(0)

    # 学習データ。入力と正解を、同じデバイスに配置する
    # 1行が1件のデータ。形状は「データ数 × 数値の個数」
    x_train = torch.tensor(
        [[0.0], [0.25], [0.5], [0.75], [1.0]],
        dtype=torch.float32,
        device=device,
    )
    y_train = torch.tensor(
        [[1.0], [1.5], [2.0], [2.5], [3.0]],
        dtype=torch.float32,
        device=device,
    )

    # 入力1個 → 隠れ層8個(ReLU) → 出力1個
    # モデルも学習データと同じデバイスに移す
    model = nn.Sequential(
        nn.Linear(1, 8),
        nn.ReLU(),
        nn.Linear(8, 1),
    ).to(device)

    loss_fn = nn.MSELoss()
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05)

    with torch.no_grad():
        initial_loss = loss_fn(model(x_train), y_train).item()
        print(f"\n学習前の損失: {initial_loss:.6e}")

    model.train()
    for step in range(1000):
        optimizer.zero_grad()               # 前回の勾配をリセット
        prediction = model(x_train)         # 予測する
        loss = loss_fn(prediction, y_train)  # 損失を計算する
        loss.backward()                     # 勾配を計算する
        optimizer.step()                    # 重み・バイアスを更新する

    model.eval()
    with torch.no_grad():
        final_loss = loss_fn(model(x_train), y_train).item()
        print(f"学習後の損失: {final_loss:.6e}")

        # 学習に使っていない入力も、モデルと同じデバイスに配置する
        x_check = torch.tensor(
            [[0.2], [0.8]], dtype=torch.float32, device=device
        )
        predictions = model(x_check)

        for x_value, predicted in zip(x_check.flatten(), predictions.flatten()):
            # 正解の計算は結果確認用。モデルの予測には使用しない
            expected = 2 * x_value.item() + 1
            print(
                f"入力: {x_value.item():.1f}, "
                f"予測: {predicted.item():.3f}, 正解: {expected:.3f}"
            )


if __name__ == "__main__":
    main()
保存したら下記コマンドで実行します
python neural_network_intro.py
実行結果
動作確認環境では、次のようになりました
学習前の損失: 3.697508e+00
学習後の損失: 5.570655e-13
入力: 0.2, 予測: 1.400, 正解: 1.400
入力: 0.8, 予測: 2.600, 正解: 2.600
e-13は「10のマイナス13乗」を表す表記です。学習後の損失は、0に非常に近い値になっていますまた、学習に使っていない入力 0.2 と 0.8 に対しても、それぞれ正解の 1.4 と 2.6 に近い予測が得られました
表示桁数では一致していますが、内部の値が完全に同じという意味ではありません
モデルの予測処理に「2倍して1を足す」という式を直接書いたわけではありません
入力と正解の組を使って、モデル内部の重みやバイアスを更新した結果です
なお、コード末尾の expected は結果を確認するための正解計算であり、モデルの予測には使っていません
※ 初期値やPyTorchのバージョン、実行環境によって、結果の細かい数値は変わる場合があります
要注意ポイント
今回の説明とコードがつながるのは、次の部分です
loss = loss_fn(prediction, y_train)  # 間違いの大きさを測る
loss.backward()                     # 勾配を計算する
optimizer.step()                    # 重みやバイアスを更新する
loss.backward()を呼んだだけでは、 重みは更新されません
更新するのは、次の optimizer.step() です
また、PyTorchでは勾配が蓄積されるため、今回は各回の計算前に optimizer.zero_grad() で前回の勾配をリセットしています
損失が減れば、それで完成?
結論から言えば否です
まず、実際の学習では、損失が毎回きれいに下がるとは限りません
例えば、データを小さなまとまりに分けて更新するミニバッチ学習では、使用するデータの違いによって損失が上下することがあります
さらに、学習に使ったデータで損失が小さいことと、初めて見るデータでも良い予測ができることは別です
学習データにだけ合わせすぎる 「過学習」 が起こることもあるため、実際の開発では学習に使わないデータでの評価も必要になります
本記事では、作図に生成AIを使用しております
株式会社ONE WEDGE
https://onewedge.co.jp/
_______
株式会社ONE WEDGEは、Webシステム開発・SES・AI/DX支援を行うIT企業です。
生成AIを活用した業務効率化や次世代システム開発にも注力しており、企業の課題解決だけでなく、エンジニア一人ひとりの成長にも本気で向き合っています。
また、技術は「一人で学ぶもの」ではなく、「仲間と成長するもの」だと考え、社内外でのコミュニティづくりにも力を入れています。
_______