
「特徴語を抽出=形態素解析」ってなんかな?
■ふとした妄想
ゲーム攻略サイトから取得した攻略情報って、文章として提供されている。
この文章を一通り目を通し「攻撃力」や「回復量」等の情報をピックアップしていくと思う。
慣れてくると、「攻撃力が?倍以上のキャラ」という風の検索をするわけだが。
そもそも、どういう情報があるのかを「読んで」みないとわからない。
攻略情報としての文章って、かなり膨大な量で「場合によって1000キャラ以上!」で、「特徴語を自動抽出できる」と便利!
なんとかして、「機械的な処理をして自動で読み込みできないか」をAIに聞いてみた。
こういうのは「形態素解析」というのだそうで「特徴語を抽出」という処理らしい。
■「形態素解析」としてのAPI
JS/TSで、「形態素解析」をやってくれるパッケージとして以下があるらしい。
・MeCab/Kuromoji
・TinySegmenter
・Intl.Segmenter
最初の2パッケージは、
・かなり重いらしい
・アプリが肥大化・圧迫される可能性が高い
・バージョン管理が面倒
それに比べ「Intl.Segmenter」は、
・Web標準!
・ブラウザ環境標準!
※「Intl.Segmenter」は、ES2022環境のブラウザでサポートされたようです。
ということで、「Intl.Segmenter」でゲーム攻略情報の特徴語抽出を自動化してみようと思った。
■「Intl.Segmenter」API
APIは以下のページで説明してあります。
https://developer.mozilla.org/ja/docs/Web/JavaScript/Reference/Global_Objects/Intl/Segmenter
使い方としては、割と直感的で、APIの引数に以下を指定する。
・処理したい文書の「ロケール」
・処理結果で受け取れる、意味のある項目(書記素、単語、文)の指定
すると処理結果として、分解した結果「segments」が返ってくる。
「segments」は、ある程度意味のある単位で区切られた構成要素になっている。
[
 {segment: *意味のある文字列*, ,,,, , isWordLike: true/false},
 :
]
「isWordLike」は、文書の言語(ロケール)で「区切り文字」と認識した場合「false」、そうでない場合「true」になるみたい。
■処理結果の考察
「isWordLike」 で句読点やスペースは簡単に弾けることがわかった。
しかし!?
実際のゲームテキストを流し込んでみると……
『〜する』『〜の』『〜について』といった「単語としては成立しているけれどノイズになる言葉「が大量に抽出されてしまう問題にでくわした。
目標として、「想定される単語が入った辞書」を一切用意せず、特徴語を抽出したい。
■機能としての目標イメージ
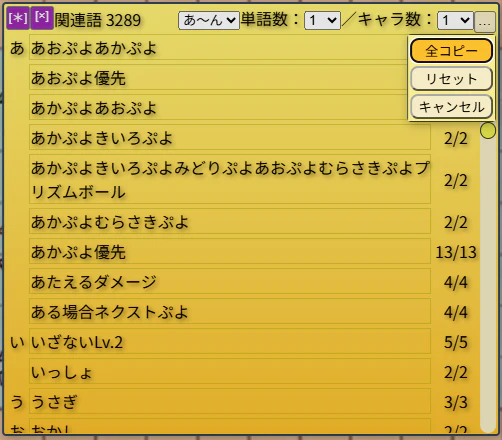
次回は、
このノイズをサクサク削ぎ落とすデリミタ(区切り文字)を考えてみる。