Pythonのforループ:要素を直接取り出すか、インデックス(range)を使うか?
Pythonでリストの要素を順番に処理する際、以下の2つの書き方をよく見かけると思います。
どちらも結果は同じですが、それぞれメリットや適した場面が異なります。本記事ではこれらの違いと使い分けについて解説します。
1. 要素を直接取り出すパターン
my_list = [1, 2, 3]
for val in my_list:
    print(val)
特徴
Pythonにおいて最も基本的で、推奨されるループの書き方です。
リストから要素が順番に1つずつ val に代入されます。
メリット
- コードがシンプルで可読性が高い: 「リストの中身を一つずつ処理する」という意図が明確です。
- 内部的に効率的: Pythonの「イテレータ」という仕組みを使って要素を順次取り出すため、シンプルかつ効率的に動作します。
適しているケース
- 単にリストの中身を読み取って処理するだけの場合
- 要素の値だけが必要で、それが何番目であるか(インデックス)を知る必要がない場合
2. インデックス(range)を使って取り出すパターン
my_list = [1, 2, 3]
N = len(my_list)
for idx in range(N):
    print(my_list[idx])
特徴
リストの長さ len() を取得し、range() 関数で 0 から N-1 までの連番(インデックス番号)を生成してループを回す方法です[cite: 1]。C言語やJavaなど、他のプログラミング言語に慣れている方には馴染みのある書き方かもしれません[cite: 1]。
メリット
インデックス(位置情報)を主軸にしているため、単に値を取り出す以外の操作が可能になります。
-
リストの書き換え:
my_list[idx] = val * 2のように、元のリストの該当箇所を直接更新できます。 -
前後要素の参照:
my_list[idx+1]のように、前後のデータと比較したり計算したりできます。 -
変則的なループ:
range(0, N, 2)(1つ飛ばし)やrange(N-1, -1, -1)(逆順)といった柔軟な指定が可能です。
適しているケース
- 要素の位置(何番目か)を利用した処理が必要な場合
- リストの要素自体を書き換えたい場合
- 現在の要素だけでなく、前後の要素(隣り合うデータなど)を参照したい場合
具体例:前後の要素を比較する
my_list = [10, 20, 35, 50]
for idx in range(1, len(my_list)):
    diff = my_list[idx] - my_list[idx - 1]
    print(f"{idx}番目と{idx-1}番目の差: {diff}")
実務におけるforループの使い分け基本ルール
実務では**「コードの可読性(読みやすさ)」と「Pythonic(Pythonらしい安全な記法)か」**が最も重視されます。
1. 基本の使い分けルール
| 書き方 | 実務での採用率 | 主な利用場面 |
|---|---|---|
for val in my_list: |
約80%(最頻出) | 値を順番に読み取るだけの処理全般(DBデータ処理、API応答の整形など) |
for idx, val in enumerate(my_list): |
約15% | 進捗ログの表示、行番号の付与、エラー箇所の特定など「位置」も要る時 |
for idx in range(len(my_list)): |
約5%(限定的) | 前後の要素比較(データ間の差分など)、変則的なステップ(1つ飛ばし等) |
2. 実務での具体的なシナリオ
① for val in my_list を使うケース(基本形)
要素を1つずつ取り出す処理(バッチ処理、データ整形など)は、バグの入り込む余地がないこの書き方が第一選択になります。
② enumerate を使うケース
画面表示やログ出力など、ユーザーや開発者に「何番目のデータか」を提示したい時に使います。
-
ログ出力:
print(f"[{idx+1}/{total}] {user_id} の処理完了") - データ加工: 何番目のデータかで処理を分岐(例: 1行目だけヘッダーとして扱う)
③ range(len) を使うケース
インデックスを直接操作しなければ実現できない「特殊なアルゴリズム」の時のみ使います。
-
隣接要素の参照: 現在の要素
my_list[i]と前の要素my_list[i-1]の計算 -
インデックスのスキップ:
range(0, len(my_list), 2)などの変則的なループ
3. 実務でのアンチパターン(注意点)
単に要素を取り出すためだけに range(len(my_list)) を使うのは非推奨(非Pythonic)です。実務のコードレビューでは enumerate または直接ループに書き換えるよう指摘されることがほとんどです。
また、複数のリストを同時に処理したい場合は range(len) ではなく zip() を使用するのが標準的なマナーです。
for-if-break と while の比較解説
for-if-break パターンと while パターンのコード比較と解説である。どちらも**「リスト内で最初に4より大きい値が現れる要素のインデックスを取得する」**処理を実行している。
1. コード1:for + if + break パターン
my_list = [1, 3, 5, 6, 4, 2]
N = len(my_list)
idx = None
for i in range(N):
    if 4 < my_list[i]:
        idx = i
        break
print(idx)  # 出力: 2
2. コード2:while パターン
my_list = [1, 3, 5, 6, 4, 2]
N = len(my_list)
idx = 0
while idx < N and my_list[idx] <= 4:
    idx += 1
print(idx)  # 出力: 2
3. 比較まとめ
| 比較項目 | コード1 (for + if + break) |
コード2 (while) |
|---|---|---|
| ループの制御方法 | 指定回数のループを条件合致で中断 | 条件が満たされる間継続 |
| 条件の記述 | 探したい条件そのもの(4 < val) |
探索を続ける条件(val <= 4) |
| 見つからない場合の値 | None |
N(リストの要素数) |
| 実務での評価 | 推奨(可読性が高く、無限ループの危険がない) | 可読性が低く、更新漏れによる無限ループリスクあり |
実務のPythonコードにおいては、意図が伝わりやすく見つからなかった場合のハンドリングが容易な**コード1(for + if + break)**が選択されることが一般的である。
リスト内要素の移動(右シフト)処理の解説
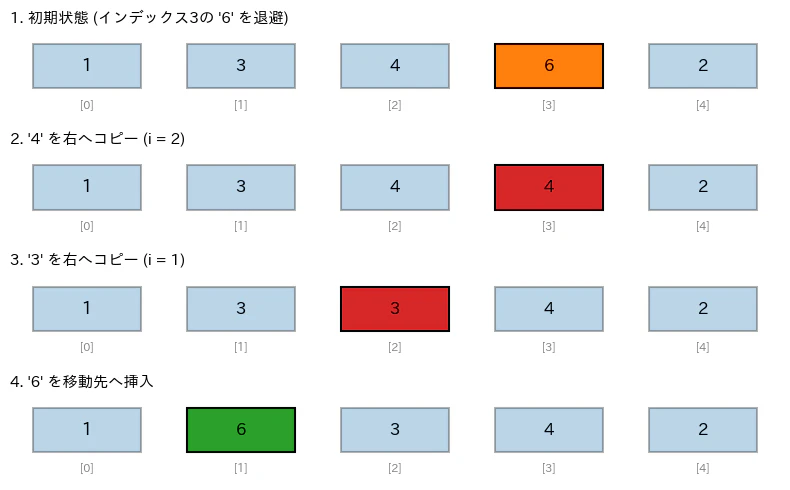
提供されたコードは、**「リスト内の指定した位置(from_idx)にある要素を取り出し、別の位置(to_idx)へ移動(挿入)する」**処理を行っている。移動対象の間に存在する要素は、右(後方)へ1つずつシフトされる。
挿入ソート(Insertion Sort)などの内部処理でよく用いられる基本操作である。
1. コードの動作ステップ(データトレース)
初期リスト: [1, 3, 4, 6, 2]
-
from_idx = 3(移動元要素:6) -
to_idx = 1(移動先インデックス)
| ステップ | 処理内容 | リストの状態 |
i の値 |
|---|---|---|---|
| 初期状態 | リストの定義 | [1, 3, 4, 6, 2] |
- |
| 値の退避 |
tmp = my_list[3](6 を退避) |
[1, 3, 4, 6, 2] |
i = 2 |
| ループ 1回目 |
my_list[3] = my_list[2](4 を右へ) |
[1, 3, 4, 4, 2] |
i = 1 に更新 |
| ループ 2回目 |
my_list[2] = my_list[1](3 を右へ) |
[1, 3, 3, 4, 2] |
i = 0 に更新(ループ終了) |
| 挿入 |
my_list[1] = tmp(6 を挿入) |
[1, 6, 3, 4, 2] |
- |
最終出力: [1, 6, 3, 4, 2]
2. 各コードブロックの解説
① 移動対象の退避と開始位置のセット
tmp = my_list[from_idx]  # インデックス3の「6」を一時退避
i = from_idx - 1         # シフト処理を開始する位置(インデックス2)にセット
② 要素の右シフト(while ループ)
while to_idx <= i:
    my_list[i + 1] = my_list[i]  # 要素を右(後ろ)へ1つコピー
    i -= 1                       # カウンタを左(前)へ進める
③ 退避させた要素の書き戻し
my_list[i + 1] = tmp # 退避していた「6」を移動先(インデックス1)へセット
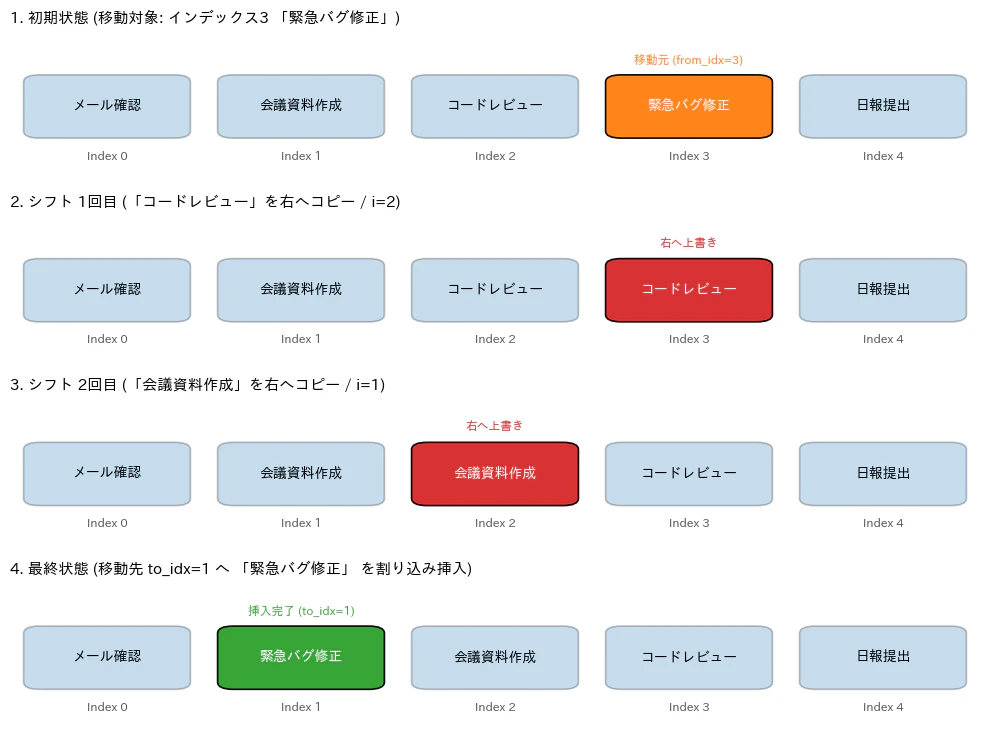
実務ではどのようなシーンで使われるか
実務での主な使用シーン
-
UI上の要素並び替え(ドラッグ&ドロップ処理): タスク管理アプリ(Trelloなど)やECサイトの表示順変更で、1つの要素を別の位置に移動させ、間の要素を1つずつ詰める/押し出す処理。
-
リアルタイムランキングの割り込み更新: ゲームや取引システムで、新しいスコアや注文が入った際に、該当する順位の位置へ割り込ませて下位データを押し下げる処理。
-
小規模・ほぼ整列済みデータのソート: 挿入ソート(Insertion Sort)の内部処理として、新しいデータを適切な位置へ挿入する処理。
# 業務タスクの表示順リスト
tasks = [
    {"id": 101, "name": "メール確認"},     # インデックス 0
    {"id": 102, "name": "会議資料作成"},   # インデックス 1
    {"id": 103, "name": "コードレビュー"}, # インデックス 2
    {"id": 104, "name": "緊急バグ修正"},   # インデックス 3
    {"id": 105, "name": "日報提出"}       # インデックス 4
]

# 「緊急バグ修正(インデックス3)」を「2番目(インデックス1)」に割り込ませる
from_idx = 3
to_idx = 1

# --- 手動シフトによる挿入アルゴリズム ---
target_task = tasks[from_idx]

i = from_idx - 1
while to_idx <= i:
    tasks[i + 1] = tasks[i]  # 1つずつ後ろへずらす
    i -= 1
tasks[i + 1] = target_task  # 目的の位置へ代入

# 結果の確認
for rank, task in enumerate(tasks, start=1):
    print(f"優先度 {rank}: {task['name']}")