
はじめに
Tesla V100 は 2017 年の GPU です。CUDA 13 ではサポート対象から外れ、Tensor Core は FP16 のみで、FP8 も FP4 も BF16 もありません。
この記事では、V100 32 GB を 2 枚使って MoE モデル Qwen3.8-Flash-Next を 256K トークンのコンテキストで動かし、
デコード約 88 tok/s、プレフィル約 650 tok/s を出すまでに llama.cpp v0.5.0 へ加えた変更を順に解説します。
モデルファイルとパッチファイルはHuggigfaceに公開しています。
現在はさらにカーネル高速化したv2パッチを公開していて、そちらだとNVlink接続がある場合平均120tok/sです。
https://huggingface.co/pentacoxian-dev/Qwen3.8-Flash-Next-IQ3E-Q8D-MTP-GGUF
最適化前の状態と今の状態は次のとおりです。
| 出発点 | 現在 | |
|---|---|---|
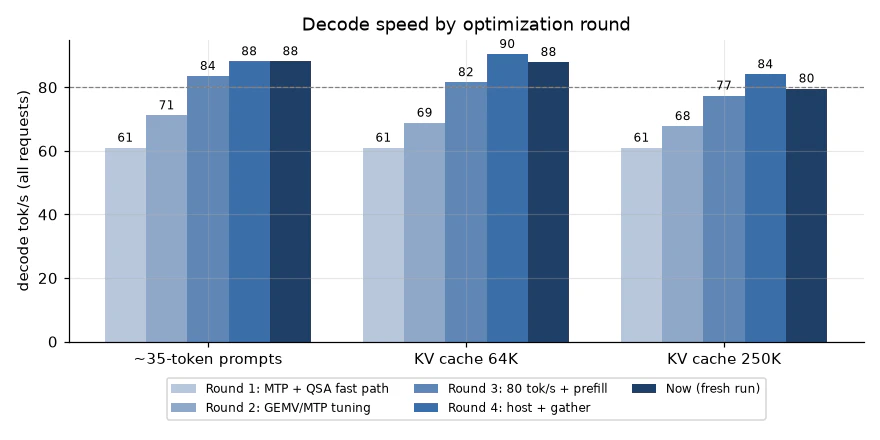
| デコード(短いプロンプト) | 30.2 tok/s(UD-IQ4_XS、64K ctx、tg128) | 88.2 tok/s |
| デコード(KV を 64K まで埋めた状態) | 35 tok/s(MTP あり、元の QSA 実装) | 88.0 tok/s |
| デコード(KV を 250K まで埋めた状態) | 測定不能なほど低速 | 79.6 tok/s |
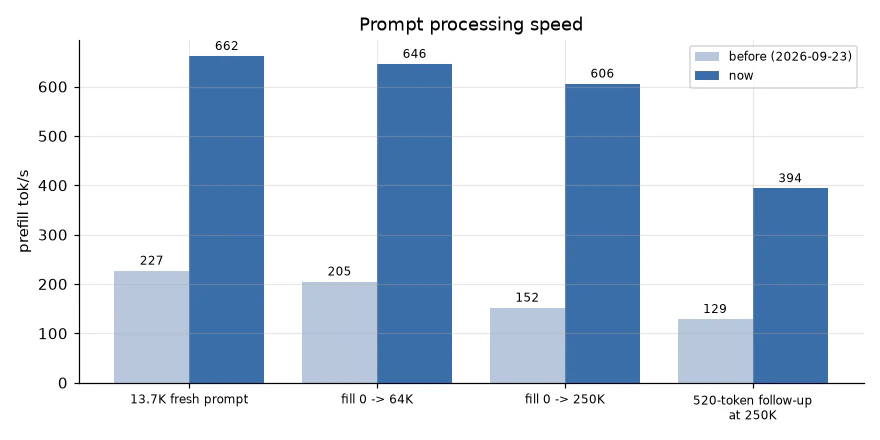
| プレフィル(13.7K トークン) | 227 tok/s | 662 tok/s |
| プレフィル(空から 250K まで) | 64K 以降は約 150 tok/s | 606 tok/s |
この表の「現在」の値はすべて 2026-09-24 に計測したものです。
変更はパッチにまとめてあります。
-
llama-v0.5.0-clean-20260924.patch:
この記事で扱うのは V100 向けの変更です。
1. 環境と対象モデル
ハードウェア
- GPU:Tesla V100-SXM2 32 GB ×2(sm_70)。NVLink NV2 で接続し、どちらも NUMA ノード 0 にあります。
- CPU:Xeon Platinum 8260 ×2(48 コア / 96 スレッド、AVX-512)
- メモリ:314 GB
- CUDA 12.9.1
- CUDA 13 は Volta をサポートしません。
- 使っているフォークは
cuda_fp4.hを必要とし、このヘッダは 12.8 以降にしかありません。 - そのため、Volta を扱える最後の 12.x 系である 12.9 を使用します。
モデル:Qwen3.8-Flash-Next(アーキテクチャ名 qwen4exp)
- 48 層の構成:Gated DeltaNet(GDN、線形アテンション系の再帰層)が 36 層、フルアテンション層が 12 層です。
- QSA(スパースアテンション):フルアテンション層にはインデクサがあります。インデクサは 4 トークン単位のブロックに点数を付け、各クエリは上位 512 ブロック(2,048 セル)と自分が属する書きかけのブロックだけを見ます。
- Hyper-connection:残差ストリームが複数本あり、サブレイヤーごとに mix と combine の処理が入ります。
- MoE:512 エキスパートから 10 個を選びます(共有エキスパートもあります)。
- MTP ヘッド:Multi-Token Prediction 用のヘッドで、投機的デコードのドラフトに使えます。
- PLE:27 GB の per-layer embedding テーブルがあります。
2. モデルファイルの組み立て
コードの話に入る前に、配信するモデルファイルの構成でかなり差が出ました。
次の 4 つを組み合わせた 80 GB の GGUF(Qwen3.8-Flash-Next-IQ3E-Q8D-MTP.gguf)を作りました。
-
ルーテッドエキスパートは UD-IQ3_XXS。 IQ4_XS(93.7 GB)では、一部のエキスパートがシステム RAM に溢れます。
V100 から PCIe 越しに CPU 側のエキスパートを使うと、量子化ビット数を下げて失う精度よりも速度の損失の方がずっと大きくなります。
エキスパートをすべて 64 GB の VRAM に載せただけで、tg128 は 30.2 → 42.3 tok/s になりました。 -
Dense テンソルは UD-IQ4_XS から取った Q8_0。 IQ3_XXS 版では dense 部分が Q6_K です。
V100 でデコードが使う小さなバッチサイズでは、Q8_0 の GEMV が Q6_K の約 2 倍速く、しかも精度も上がります。
scripts/merge_mtp.py --dense-fromで、エキスパートと dense テンソルを別々の量子化ファイルから取り出して結合します。 -
MTP ヘッドを Q8_0 で追加。 unsloth の GGUF には MTP ヘッドが入っていません。
そこで、元のチェックポイント(360 GB)からmtp.*テンソルだけ(約 8 GB)をストリーミングで変換し、ブロック 48 として末尾に追加します。 -
ドラフト専用の Q4_0 LM ヘッド(
blk.48.nextn.shared_head_head)。ドラフトは「提案」するだけで、採否はターゲットモデルが検証します。
そのため、出力ヘッドを粗く量子化しても出力の正しさは変わらず、受理率が少し下がるだけです。
実測では受理率の低下は検出できず、ドラフト 1 回あたりの時間は短くなりました。
PLE テーブル(27 GB)は行を引くだけなので、システム RAM(mmap)に置いたままにしています。
3. MTP 投機的デコード
デコード高速化の土台は MTP による投機的デコードです。
- 仕組み:各ステップで MTP ヘッドが 3 トークンのドラフトを出し、ターゲットモデルが 4 トークン(確定済みの 1 トークンとドラフト 3 つ)をまとめて検証します。
- ドラフト数の選び方:ドラフト数 2 / 3 / 4 はそれぞれ 77.2 / 77.6 / 75.1 tok/s でした(seq_rm 修正前の計測)。適応的な深さや確信度による打ち切りも試しましたが、いずれも固定の 3 より遅くなりました。
- 導入の効果:MTP を入れただけで 42 → 51〜52 tok/s になりました。
MTP の周辺では、次の 3 点を手直ししました。
3.1 Folded catch-up(LLAMA_MTP_FOLD)
MTP ヘッドは、ターゲットが受理したトークンの隠れ状態を自分の KV に書き込む「追いつき(catch-up)」処理を必要とします。
元の実装は、検証のたびに catch-up を独立したデコードとして実行し、しかも棄却される行まで計算していました。
パッチでは、検証バッチの catch-up 行をいったん保留します。accept() で何個受理されたかが分かったら、
受理された行と新しいトークンの行を、次の最初のドラフトパスと同じバッチで一度にデコードします。
これで 1 ステップあたりドラフトコンテキストのデコードが 1 回減り、棄却される行は計算しなくなりました(39.58 → 38.50 ms/step)。
3.2 MTP コンテキスト用の小さなマイクロバッチ(LLAMA_MTP_N_UBATCH=32)
ドラフトヘッドは語彙全体(248K)のロジットを出すため、計算バッファが n_ubatch に比例して大きくなります。
一方、ドラフトと catch-up で扱うのは数トークンだけです。
MTP コンテキストの ubatch を 32 にすると、GPU あたり 1.3 GB の VRAM が空きました。--fit もこの設定を考慮して配置を決めます。
3.3 CUDA Graph キャッシュの対象を小さなグラフまで広げる
フォークには、形の違うグラフごとに CUDA Graph を保持するキャッシュがあります。
ただし一定サイズ未満のグラフは対象外で、MTP の catch-up とドラフトの形が切り替わるたびにキャプチャが破棄されていました。
GGML_FT_GRAPH_CACHE_MIN_NODES でしきい値を下げ、小さなドラフトグラフもキャッシュに残るようにしました。
4. Hyper-connection の融合カーネルをマルチ GPU で使う(LLAMA_QWEN4EXP_HC_FUSION)
hyper-connection の mix / combine を 1 カーネルで行う実装を以前していました。
今回のパッチでは、CUDA デバイスごとに重みを持たない「所有者」オブジェクトを 1 つ作ります。
融合カーネルは自分がどのデバイスで動くかだけ分かれば実行できるので、これでレイヤー分割の 2 GPU 構成からも使えるようになりました。
- グラフの縮小:トークンあたりのノード数が 8,274 → 6,535 になり、約 1,700 ノード減りました。
- 速度:デコードは 16% 速くなりました(54〜55 → 61 tok/s)。出力は完全に同一です。
あわせて、hyper-connection の RMSNorm の後の gamma の掛け算について、reshape を先に展開するようにしました。
こうすると RMS_NORM と MUL がグラフ上で隣り合い、既存の RMS_NORM+MUL 融合が効きます。
5. QSA:コンテキスト長に依存しないデコード
最大の山場は QSA です。
5.1 元の実装の問題
元の実装は、トークンをデコードするたびに次の処理をキャッシュ全体に対して行っていました。
- 全ブロックのキーを平均プーリングし直す
- スコアを全セルに展開する
- 全セルをソートする
- キャッシュと同じ大きさのマスクで、全セルに dense なアテンションをかける
- ブロック表をホスト側で作り直す
選ぶのは 2,048 セルだけなのに、計算量はコンテキスト長に比例します。KV を 64K まで埋めると、デコードは 35 tok/s まで落ちました。
5.2 プーリング済みブロックキーのキャッシュ
最初に注目したのは、書き終わったブロックのプーリング済みキーは二度と変わらないという点です。
-
llama_memory_hybrid_idxに、ブロックごとにプーリング・正規化・回転を済ませたキーを 1 行ずつ保持する F32 キャッシュを追加しました。 - 更新するのは、各 ubatch が触れたブロックだけです。更新の入力は
touch_src、touch_dst、touch_posです。 - インデクサのキャッシュは K しか読まないため、V テンソルを確保しないようにしました。これで GPU あたり約 400 MB 空きました。
この差分更新が正しく動くのは、「単一シーケンスで、位置 p のトークンがセル p に入っている」(cell == position)配置のときだけです。
次のような操作で配置が崩れた場合は、blk_valid を落として元の実装に戻り、キャッシュが空になった時点で有効に戻します。
- シーケンスのコピー
- シフト
- 状態の完全リストア
- 位置と一致しないセルへの挿入
サーバーを 1 スロットで使う限り、この条件は常に成り立ちます。
5.3 固定コストの選択とアテンション
各クエリの処理は次のとおりです。
- プーリング済みの全ブロックに点数を付けます。スコアは、ヘッドごとの内積を ReLU にかけてヘッド方向に足したもので、元の実装と同じ定義です。
- 上位 512 ブロックを GPU 上で選びます。
- 自分が属する書きかけの tail ブロックを必ず加えます。
cell == position の配置では、ブロック b のメンバーはセル 4b〜4b+3 です。
そのため KV キャッシュを「4 セル × n ブロック」のビューとして見れば、ブロック単位の 1 行としてまとめて取り出せます。
数トークンのバッチ(デコードや検証)では、選んだセルの K/V 行を gather して、トークンごとに独立したストリームとして flash attention に渡します。
各ストリームは -inf マスクで FATTN_KQ_STRIDE の倍数まで詰め物をし、vec カーネルの条件を満たすようにしています。
結果は元のマスク付き dense パスと加算順序以外は同じで、計算コストはコンテキスト長に依存しなくなりました。
これで 64K でも 250K でも 60〜62 tok/s が出るようになりました(当時)。
5.4 長い行向けの radix top-k
ブロックの選択は、数万個のスコアから上位 512 を取る top-k です。元の実装はセグメント単位の完全ソートでした。
- これを radix select に置き換えました。各行を数回読むだけで済みます。
- 第 3 ラウンドでは、11 回あった起動を 5 回にまとめました。
- 桁ごとのヒストグラムを取るパスで、最後に終わったブロックがその桁を決めます。
- 初期化は最初のパスに、カウンタのリセットは最後のパスに畳み込みました。
- 深い位置では、1 ステップあたり約 90 回の起動が減りました。
-
test-backend-opsの TOP_K 全 462 ケースに通っています。
5.5 Q8_0 → F16 の高速な行 gather
選んだ K/V 行の gather には、汎用の dequantize gather を使っていました。
このカーネルは、1 スレッドが数値を数個扱うたびにインデックス計算をするので、その計算に時間の大半を取られていました。
1 行を 1 ブロックで処理し、各スレッドが Q8_0 ブロック(32 値)の 1/4 を展開する専用カーネルを書きました。
1 呼び出しが 40 → 約 12 µs になり、結果はビット単位で一致します。
5.6 プロンプト用のブロックスパースアテンションカーネル(qsa-attn.cu)
gather 方式は、プロンプトのような大きなバッチには使えません。512 トークン分の選択行を展開すると、GET_ROWS だけで 1.2 GB になるからです。
そのためプレフィルは依然としてキャッシュ全体への dense アテンションで、深い位置でのプレフィルはキャッシュが伸びるほど遅くなっていました。
第 5 ラウンドでは、Q8_0 の KV キャッシュから選択ブロックを直接読むブロックスパースアテンションを CUDA で書きました。
-
ノード表現:
GGML_OP_FLASH_ATTN_EXTノードのsrc[5]にブロック ID を入れ、op_params[6]にブロックサイズ(4)を入れて表します。
新しい ggml op は追加せず、fattn.cuの入口で振り分けます。 -
並列化:CUDA ブロック 1 つが(分割, KV ヘッド, トークン)の組を 1 つ担当します。
GQA 12 の場合、1 ワープが 3 クエリヘッドを受け持ち、ブロック内の 4 ワープが同じ K/V 行を L1 越しに共有します。 -
ブロックの読み方:ブロック ID とセルマスクは、先に動的共有メモリへ置きます。見えるセルが 1 つもない詰め物ブロックは
next_activeで丸ごと飛ばします。 -
softmax と統合:オンライン softmax を 4 セル単位で更新し、分割した結果を
qsa_attn_combineでまとめます。
デコードのような小さいバッチでは、各クエリのブロック列を分割して GPU を埋めます。 -
Hadamard 回転:回転済みの KV キャッシュ(
self_k_rot/self_v_rot)にも対応しました。q と K は同じ回転がかかっているのでそのまま使い、出力にだけ V の逆回転をかけます。 - 正しさの確認:乱数の Q8_0 K/V、1〜512 クエリ、マスク付き tail、詰め物ブロックの組み合わせで、倍精度 CPU 参照実装と約 1e-7 で一致しました。
ブロックの選択もバッチが大きいとメモリを食うので、スコア行列 [n_blk, heads, tokens] が約 64 MB に収まるようにトークン方向でチャンク分割しました。
選択はトークンごとに独立しているので、チャンクに分けても結果は変わりません。
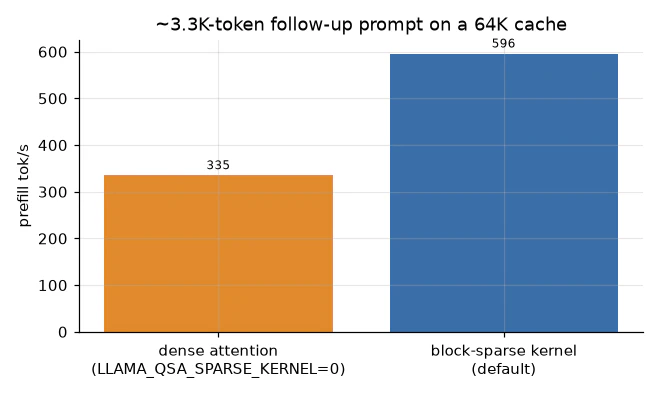
64K のキャッシュに 3,336 トークンの追加プロンプトを投げた場合、同じバイナリで比べてプレフィルは dense が 335 tok/s、スパースカーネルが 596 tok/s(1.78 倍)でした。
デコードは、4 トークン程度のバッチでは gather + flash attention の方が同等以上に速い(どちらも 1 呼び出し約 120 µs)ため、そのままにしています。
16 トークンを超えるバッチだけがスパースカーネルに回ります。
6. Volta 向け GEMV チューニング
デコードの大半は重みを読む行列ベクトル積(GEMV)です。検証バッチは 4 トークンなので、実際には ncols = 2〜8 の「細い GEMM」になります。
上流のブロック形状は新しい GPU に合わせて決められていて、V100 の実際の行列形状では無駄が出ていました。
| 変更 | 効果 |
|---|---|
| Q8_0 GEMV(ncols 2〜8)のブロック形状を行列形状で選ぶ。K が小さい行列は 1 ワープに複数行、K が長く行数の少ない行列は 1 行に多数のワープ | hc_up 18 → 13 µs、hc_down 13 → 11.5 µs |
| IQ4_NL の MoE を 1 ブロック 8 行に | 68 → 59 µs |
| 行数 16 以下・K 4096 以上の F32 GEMV(hyper-connection の注入、GDN の α/β、共有エキスパートのゲートなど)を split-K に | 11.7 → 6.6 µs |
| split-K を 1 回の起動に。最後に終わったブロックが部分和を分割順に足す | 2 カーネル版とビット単位で一致 |
| gate+up+SwiGLU の融合 GEMV を、Volta の検証バッチ(バイアスなし)にも適用 | 共有エキスパートの起動数が減る |
6.1 Volta 専用の IQ2_S MoE カーネル
UD-IQ3_XXS の中身には IQ2_S のテンソルも含まれます。gate+up を融合したエキスパート GEMV を調べると、律速はメモリ帯域ではなく IQ2_S の復号命令 でした。原因は 2 つあります。
- グリッドテーブルの参照が、L1 を通る 32-way のばらばらなロードになっている。
- 符号の処理に
__vcmpne4/__vsub4を使っているが、Volta ではこれらがエミュレーションで動く。
新しいカーネルは次のように作りました。
- グリッドテーブルとトークンの q8_1 活性化を共有メモリに置きます。
- 符号は普通の整数演算で適用します。グリッドのバイトは 0 にならないので、
(g ^ 0xFF) + 1 = -gの計算が隣のバイトに繰り上がりません。 - 各ワープは、(行, 32 重みグループ)を平坦にした空間にレーンを割り振り、遊ぶレーンが出ないようにします。
4 トークン × 10 エキスパートで 1 層あたり 124 → 75 µs になり、結果はビット単位で一致します(GGML_CUDA_IQ2S_VOLTA=0 で無効化)。
なお、Q8_0 と Q6_K の GEMV についても、別のブロック形状、persistent grid、共有メモリへのステージング、Q6_K の符号処理の整数化を試しました。
いずれも実際の重みでは効果が出ませんでした。
7. カーネル起動数を減らす
MoE、GDN、hyper-connection の組み合わせは、小さな要素ごとの演算を大量に生みます。V100 では 1 回の起動が数 µs かかるので、数百回単位で効いてきます。
-
要素ごとの演算チェーンの融合:scale→SiLU、add→softplus→mul、sigmoid→mul→add の 3 パターンを、ブロードキャストされるオペランドを含めて 1 カーネルで実行します。1 ステップあたり約 600 回の起動が減り、結果はビット単位で一致します(
GGML_CUDA_NO_ELEM_CHAIN=1で無効化)。 - 短い行の concat:GDN の畳み込み窓(状態 3 列+数トークン、10,240 チャネル)では、1 行に 1 ブロックを割り当てると大半のスレッドが遊びます。64 要素未満の行は 1 要素 1 スレッドの平坦なカーネルで処理するようにしました(18 → 約 3 µs)。
-
ロールバック用の状態コピー:GDN の畳み込み状態のスナップショットは、
contの後に 12 バイト行の 2D memcpy で取っていました。V100 では、12 バイトの行 10,240 本の 2D memcpy に約 16 µs かかります(コピーカーネルなら約 3 µs)。これをコピーカーネル 1 回にまとめ、検証 1 ステップあたり約 2 ms 減りました(42.31 ms/step まで)。 -
QSA の中間テンソルの不要なコピーをやめる:すでに連続しているテンソルに
ggml_contをかけていた箇所を除きました。
8. ホスト側のオーバーヘッド
GPU のカーネル時間の合計はステップ時間より数 ms 短く、その差はホスト側の処理でした。実際、最も大きく効いた変更のいくつかはホスト側のものです。
LLAMA_STEP_TIMING=1 と LLAMA_SPEC_TIMING=1 で、デコードの段階ごと、およびサーバーの投機的デコードのフェーズごとのホスト時間を記録できるようにして、原因を調べました。
8.1 greedy サンプリングの近道
温度 0 の greedy サンプリングでも、サンプラーチェーンは 248K 要素の候補配列を作り、部分ソートしていました。
最大値を動かしうる設定がチェーンにない場合は、ロジットを直接走査して argmax を取ります。
サンプリングと accept の時間は 1 ステップあたり 2.5 → 0.6 ms になりました(LLAMA_SAMPLER_NO_GREEDY_FAST=1 で無効化)。
8.2 seq_rm を位置インデックス経由で処理する
投機的デコードでは、毎ステップ、棄却したドラフトをターゲットとドラフトのキャッシュから取り除きます。
このとき seq_rm は 262,144 セルを全走査していて、3 つの 256K キャッシュに対して 1 ステップに何度も実行されていました。
シーケンスが持つ(位置 → セル)のインデックスを使い、[p0, p1) のセルだけを直接取り出すように変えました。
ホスト時間は 1 ステップあたり 1.6 ms 減りました(35.29 → 33.65 ms/step)。
8.3 GPU 上で argmax を取る(LLAMA_GPU_ARGMAX=1)
グラフの最後に出力行ごとの argmax を足し、ホストにはトークン ID だけを返します。
検証 4 行分のロジット(4 MB)は、実際に誰かが読むときだけコピーします(遅延コピー)。
コピー 1 回とホストでの 4×248K 要素の走査がなくなり、1 ステップあたり 0.9 ms 短くなりました。出力は同一です。
API に llama_get_argmax_ith() を追加しました。
次の ubatch が出力テンソルを上書きする前に、遅延中のロジットのコピーをストリーム順に積んでおくことで、正しさを保っています。
8.4 入力コピーの同期を 1 回にまとめる
ggml-backend のスケジューラは、ホストにある入力テンソルごとにブロッキングコピーと同期をしていました。MTP のドラフトパス 1 回で 15 回です。
これを全部キューに積んでから 1 回だけ待つように変え、1 ステップあたり 0.35 ms 減りました(GGML_SCHED_SYNC_INPUTS=1 で元の動作)。
他デバイスからのコピーを積む前に待つので、別の GPU の計算を待ってしまうことはありません。
逆に、ドラフトパス用に CUDA Graph を 2 系統用意して起動時間を削る案は効きませんでした。
ドラフトパスは GPU 律速(1 回約 1.3 ms、うち Q4_0 ヘッドが約 0.52 ms)なので、ホスト側の起動が速くなってもステップは短くならなかったです。
9. GDN 状態の gather を省く(deferred gather)
GDN 層は、毎ステップ、キャッシュからそのシーケンスの再帰状態(1 層あたり 3 MB)を GET_ROWS でコピーしてから GATED_DELTA_NET に渡していました。
CUDA バックエンドのグラフ評価器で、「GDN の状態入力にしか使われない GET_ROWS」を見つけたら計算を省き、
GDN カーネルがキャッシュの該当行を直接読むように変えました(state_rows / state_row_stride)。
これは第 4 ラウンドで一度実装したものの、実は一度も発動していませんでした。原因は 2 つです。
- 分割されたグラフでは、途中の reshape がそのグラフのノードに含まれない。
- ビューに対する
ggml_node_has_n_usesの使用回数が当てにならない。
view_src をたどって照合し、読み手を直接数えるように直しました。すると今度は illegal memory access が起きました。
ggml は、最後にスケジュールされた読み手が終わるとテンソルのメモリを再利用します。そのため、GDN が実行される時点では ids テンソルがすでに別のデータで上書きされていたのです。
行 ID をデバイスごとの永続スロットにコピーしておくことで解決しました。
スロットは遅延のたびに次のものを使うので、キャプチャした CUDA Graph もそれぞれ固有のアドレスを持てます。
結果は 32.20 → 31.84 ms/step で、出力は同一です(GGML_CUDA_NO_GDN_DEFER_GATHER=1 で無効化)。
教訓:ノードを飛ばす融合を ggml に入れるときは、飛ばした先で読むデータを必ず自前でコピーしておくこと。
10. プレフィルの高速化
13,754 トークンの新規プロンプトでの推移です。
| 変更 | プレフィル |
|---|---|
| 開始時(batch 256、ubatch 256) | 227 tok/s |
| batch 2048:1 回の呼び出しに ubatch が 8 個入り、2 GPU の処理が重なる | 258 tok/s |
| Volta の MoE でグループ化 MMQ を使う | 330 tok/s |
| MoE の MMQ タイル幅を 128 → 32 トークンに | 527 tok/s |
| ubatch 512 | 648 tok/s |
| (現在の計測) | 662 tok/s |
-
グループ化 MMQ:Volta では、MoE のプロンプト処理が「ホスト同期 + エキスパートごとの小さな GEMM」というフォールバックに入っていました。
7K トークンのプロンプトで約 17 万回の起動になります。
512 エキスパートでは 1 エキスパートあたりのトークン数が少ないので、どのバッチサイズでもグループ化 MMQ カーネルの方が速くなります。 -
タイル幅:ncols_max はバッチ全体ですが、各エキスパートが受け取るのは 5〜10 トークン程度です。
128 幅のタイルではほとんどの列が空回りします。実測では 8 / 16 / 24 / 48 / 64 / 128 のどれよりも 32 が速い結果でした(GGML_CUDA_MMQ_MOE_Jで変更可能)。 -
深い位置でのプレフィル:5.6 節のスパースカーネルで、空から 250K まで埋めても 606 tok/s を保つようになりました(以前は 64K を超えると約 150 tok/s)。
250K のキャッシュに対する約 520 トークンの追加プロンプトも、約 130 → 385〜404 tok/s になりました。
短い追加プロンプトは ubatch 1 個に収まるため、2 GPU の処理が重ならず、長いプロンプトより遅くなります。
11. 効果の推移
ラウンドごとのデコード速度
| ラウンド | 目標 | 主な変更 |
|---|---|---|
| 1 | 256K で 60 tok/s | 移植、モデル構成、MTP、HC 融合、QSA の固定コスト化 |
| 2 | — | GEMV 形状、ロールバックコピー、greedy の近道、Q4_0 ドラフトヘッド、folded catch-up |
| 3 | 80 tok/s とプレフィル高速化 | IQ2_S カーネル、要素ごとの演算の融合、seq_rm、グループ化 MMQ |
| 4 | 短・長コンテキストのデコード | 入力コピーの一括化、GPU argmax、Q8_0 gather |
| 5 | 長コンテキストのオーバーヘッドと深い位置でのプレフィル | スパースアテンションカーネル、GDN の gather 省略(修正版) |
短いプロンプトでの 1 ステップの時間
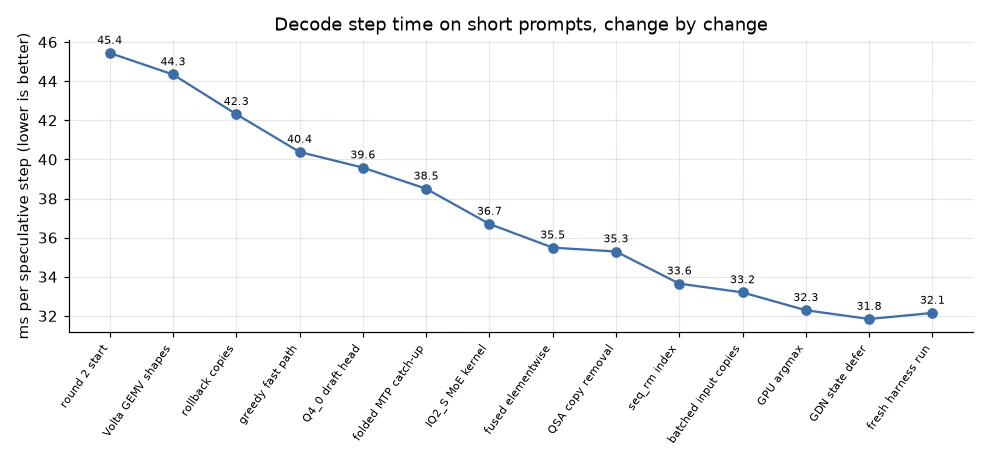
tok/s は、テキストによってドラフトの受理数が変わるため変動します。
そこで、1 回の投機ステップ(4 トークンの検証とドラフト 3 回)にかかる時間で比べます。
第 2 ラウンドの開始時は 45.4 ms でしたが、31.8 ms まで縮みました。
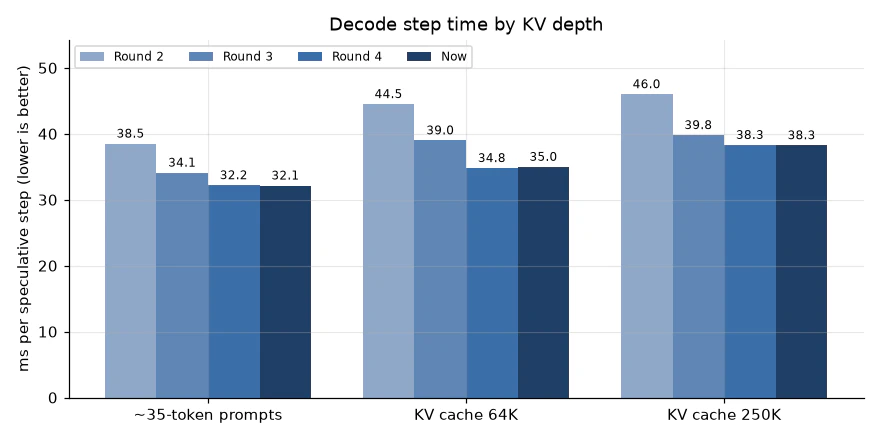
今回の再計測では、64K と 250K の tok/s が第 4 ラウンドより低く出ています(90.5 → 88.0、84.1 → 79.6)。
しかし 1 ステップの時間はどの深さでも 0.2 ms 以内で一致しています。
差の原因は、生成されたテキストでドラフトが受理されにくかったことです。
プロンプト別
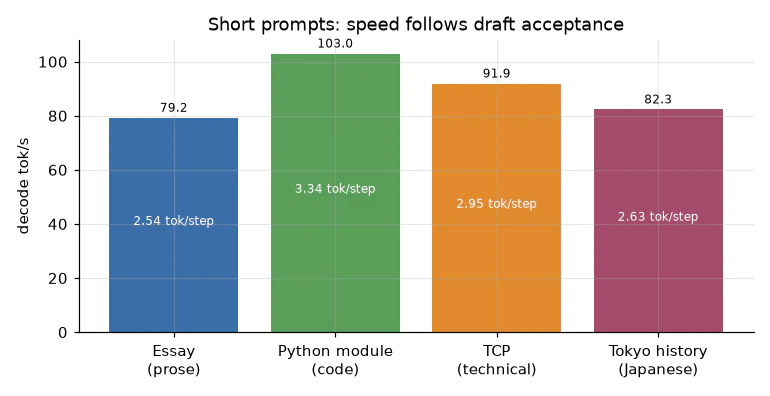
コード(3.34 トークン/ステップ)は 103 tok/s、英語の散文と日本語(2.5〜2.6 トークン/ステップ)は 79〜82 tok/s でした。
ステップの時間は同じでも、受理数によって速度が変わります。
12. いま 1 ステップの時間はどこに使われているか
Nsight Systems で、短いプロンプトの 385 ステップを計測しました。プロンプト処理のカーネルを除いた GPU カーネル時間の合計は、1 ステップ 30.6 ms です。
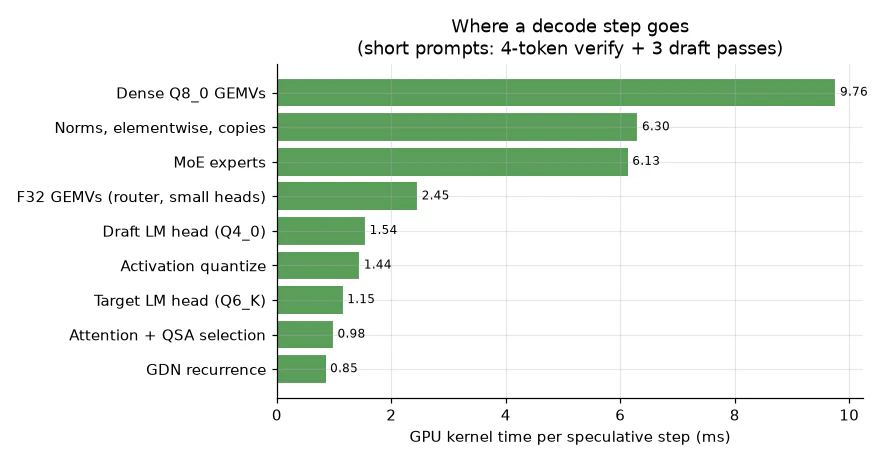
- 重みの読み出しが支配的:dense の Q8_0 GEMV が 9.8 ms、MoE エキスパートが 6.1 ms、LM ヘッドがターゲットとドラフトを合わせて 2.7 ms です。
- 細かい演算:正規化、要素ごとの演算、コピーの合計が 6.3 ms です。まだ起動回数の多さが目立ちます。
-
アテンションと GDN:短いプロンプトではアテンション(QSA の選択を含む)と GDN の再帰は合わせて 2 ms 未満です。
250K ではインデクサのスコア計算と top-k、K/V の gather が増え、ステップは約 6 ms 長くなります。
次に大きく伸ばせる余地があるのは、重みを読むバイト数(量子化の選び方)と、細かい演算のさらなる融合でしょう。
13. 試したが採用しなかったもの
- スパースアテンションカーネルで次のブロックをプリフェッチする案と、1 ステップで 2 ブロック処理する案。
どちらもレジスタが増えて占有率が下がり、512 トークン 1 層あたり 5.6 → 7.0 ms、8.5 ms と遅くなりました。
Volta の CUDA コアで書くスパースアテンションは、レジスタとレイテンシが律速です(有効なのは 96 レジスタまで)。 - top-k を 1 行 1 カーネルで処理する案。実際のスコアは少数のヒストグラムビンに集中するため、1 呼び出し 71 µs と遅くなりました。
- ヒストグラムの atomic をワープ内で集約する案。Volta では
__match_any_syncが遅く、逆効果でした。 - Q8_0 の K/V をそのまま渡し、flash attention 側で dequantize する案。
tile カーネルは結局 K/V を変換しますし、vec カーネルを強制しても速くなりませんでした。 - GDN の畳み込み状態の 4 つのロールバックコピーを 1 カーネルにまとめる案。4 回コピーするより遅くなりました。
-
topk_moeの配列をレジスタに置く案。遅くなりました。 - ターゲットのサンプリングをグラフ内(バックエンド)で行う案。遅くなりました。
- ドラフトヘッドを低い token id に絞る案。id は頻度順に並んでいないため、CJK と韓国語のトークンの 10〜50% に届かなくなります。
14. 正しさの確認
-
スモークテスト(決定的な API テスト 3 件:マーカー、算術、複数ターンでの名前の保持):3/3 で通過しました。
API キーがないと 401、あると 200 が返ることも確認しました。 -
test-backend-ops(CPU バックエンドとの比較):次の演算がすべて通りました。- MUL_MAT_ID(MoE のタイル幅を 8 に固定し、エキスパートが複数タイルにまたがる場合を含む)
- MUL_MAT、CONCAT、CPY、UNARY、SCALE、ADD、MUL
- SET_ROWS、GET_ROWS、ARGMAX、TOP_K
-
greedy 出力がバイト単位で一致した変更:IQ2_S カーネル、要素ごとの演算の融合、split-K、seq_rm、コピーの削除、入力コピーの一括化、GPU argmax、GDN の gather 省略。
いずれも適用前後で greedy 出力がバイト単位で一致しました。 - グループ化 MMQ:加算順序が変わるため、英語の散文の greedy 出力が冒頭数文より後で分岐します。他のテキストは変わりません。
-
QSA の新しいパスと元のパス(
LLAMA_QSA_DENSE=1)の比較:16K の深さで、ほぼ同点の 2 トークンが入れ替わる箇所を除き、同じ greedy テキストになりました。 - スパースプレフィルと dense プレフィルの比較:32K の深さでの追加質問への回答は、ファイルパスの言い回しが 1 箇所違うだけで、同じ内容でした。
15. 計測で気をつけたこと
- tok/s ではなく ms/step で判断する。 加算順序が変わるとテキストが変わり、受理数も変わります。そのため tok/s は変更の良し悪しを表しません。
- KV を埋めた状態では ±2 ms/step 程度ぶれる。 gather がインデックスを atomic の順序で書くので、ドラフトの提案が実行ごとにわずかに変わるためです。
-
ホストの共有に注意する。 同じホストで他のジョブ(ビルドなど)が動くと、壁時計時間の計測が狂います。
今回も、裏で動いていたビルドのせいで 110 ms/step という異常値が出たため、すべて計測し直しました。
小さな差は Nsight のカーネル時間の合計で確かめました。 -
VRAM の余裕は GPU あたり 512 MiB 残す。
--fitの余裕を 0 にすると OOM になりました。
おわりに
V100 で 256K コンテキストの MoE を実用的な速さで動かすのに効いたのは、主に次の3つでした。
- 計算量をコンテキスト長から切り離す:QSA の差分プーリングと固定コストの選択。
- ホスト側の無駄を削る:262K セルの全走査、入力ごとの同期、CPU での argmax。
- 小さな起動をまとめる:要素ごとの演算チェーン、top-k、split-K。
GEMV そのものを細かく調整しても、実際の重みではほとんど変化がありませんでした。
一方で、「IQ2_S の復号が命令律速になっている」のような Volta 特有のボトルネックを見つけた箇所では、大きく改善しました。
古い GPU でも、モデル構造の性質を実装に活かせば、まだかなり速くできます。