
この記事について
この記事は、DataOpsシステムにおけるデータ処理部分の構成要素についての学習を目的とするものである。
想定読者は以下の通り。
- Data管理システム(DataOpsシステム)を開発したいが各構成要素をどのように設計すればよいか学びたい人
- DBの読み書きを行うコンポーネントをどのように設計すべきか知りたい人
なお、本記事は以下記事におけるデータパイプラインの Data Processing を詳しく深ぼったものであるため、DataOpsの全体像が知りたい場合は以下記事を参照するのが良い。
DataOpsの Data Processing に求められること
DataOpsの Data Processing では以下のような事象を想定する必要がある。
- データ変換処理の追加に対して開いている必要がある
- 前処理、処理、後処理などのデータ処理の依存関係を管理する必要がある
- 定期実行、条件実行(トリガー実行)、手動実行を用途ごとに使い分ける必要がある
- 並列処理ができる必要がある
- データ処理は実行中断、再開などに対応している必要がある
これらを実現するためには、Data Processing をどのような構成で設計すればよいのかをまとめていく。
Data Processing の構成要素詳細
処理の追加に対して開いた実装
ユースケース例
DataOpsについて、データ処理の追加に開いていることは最も重要なことの一つである。例えば、以下のようなケースが考えられる。
- これまでKPIを集計してきた方法を追加したい、変更したい
- モデルに入力する前処理のアルゴリズムを変えたい
- メタデータ付与のためのアルゴリズムを変更したい、新たにメタデータを増やすための処理を追加したい
可変点と不変点の分離
処理の追加に開いている設計が重要なのは間違いないが、追加に開くということは、実装が抽象化することであるため、闇雲に開いた実装にすべきではない。追加に開くべき箇所を特定するために、「処理を追加したとき、具体的に何が変わるのか」を列挙して不変部分と分ける。
これはシステムによるが、今回は Microsoft AVOps を題材にする。
可変点
- 処理ロジックそのもの
- 処理ロジック動作環境(ハードウェア構成など)
不変点(もしくは選択肢が少ない)
- 入出力先: データ処理の入出力はともにクラウドストレージになる
- 状態遷移: 未実行、実行中、実行完了などの状態遷移
- 起動のされ方: 条件分岐やエラー時の処理などの組み立て方やジョブをキューとして管理する方法、これらはトリガー実行、定期実行、手動実行を具体的にどのように実現するかに該当
- デプロイ
これを実現するための実装について記述する。
処理ロジック追加時のインフラ定義を楽にする
データ処理ロジックを新たに追加するケースを考える。そのたびに、処理ロジックにあったインフラを容易する必要があるが、デプロイの手順は共通化しておきたい。そこで以下のような構成を目指す。
- ディレクトリ構成を処理ごとに統一
- デプロイ手順を統一
これを実現するために、例えば、以下のようなものがあげられる。
{job-name}
    |- app (実装ロジック)
        |- Dockerfile
        |- scripts
    |- infra
        |- build_and_deploy.sh
        |- IaC

    |- test
このようなディレクトリ構成をデータ処理ごとに作成することで以下が実現する。
- コンテナアプリとして実装(中身は隠蔽化)
- デプロイコマンド統一
- IaCにインフラ定義(AWS CDKなど)による分析処理に適したインフラ選択
処理とインフラは結合が強いので、同一ディレクトリに配置する。また抽象化が難しいため、ジョブごとに統一したインタフェースなどは定めない。
ジョブは種類ごとにDBで管理する。例えば、以下のようなテーブルを用意する。
- id
- job_name
- job_type
- job_dependency_id
- job_trigger_id
例えば、job_nameをデプロイ時に自動作成するようにするなどが継続的な運用の一つとしてあげられる。
また、job_typeで、以下のようなジョブを使い分けることが可能。
- コンテナを並列化した処理(EKSジョブ)
- Lambdaなどによる一時的な処理
このようにすることで、追加時は新たなjobディレクトリを追加して、共通のデプロイコマンドを叩くだけにすることで、DBを読んでジョブを実行する側は、ジョブの呼び出し型をテーブルを見ただけで変えることができる。
データ,トリガー,処理の分離
データ処理パイプラインが動く際,以下のような順で処理が行われる.
- 何の処理をどのデータに適用するかが決まる
- 何らかのトリガー(手動,イベント,定期)が起動
- トリガーに対応するデータ処理が起動
まず,何の処理をどのデータに適用するかであるが,これはデータベースで管理するのが良い.例えば以下のようなテーブルが挙げられる.
- ID
- 処理ID
- データID
このように処理とデータのマッピングを記録し,トリガー(何が起点で発火するのか)と分離することができる.こうすることで,処理はそのままでトリガーを変更することができる.
トリガーが発火して処理されたパイプラインは,独立した処理部へ行く.ここで重要なのは,処理部がトリガー,および,上述のテーブルと独立していることである.こうすることで,トリガーや処理とデータの組み合わせが変わったとしても,処理部を変更することなく処理を実行することができる.
job実行の際は,一つのjobを一単位としたテーブルを使用するのが良い.なぜならば,jobは上述のテーブルやトリガーに対して,1対Nの関係だからである.上述テーブルにjobの状態(成功,失敗,実行待ちなど)を記録してしまうと,際実行のたびに行が増えていってしまう.以下のようなテーブルを作るのが良い.
- ID
- 処理,データ組み合わせID
- ジョブ状態
- ジョブ実行時間
このようにしておくことで job が成功したのか,失敗したのか,失敗した場合どれに対していつ失敗したのかをトラックすることができる.
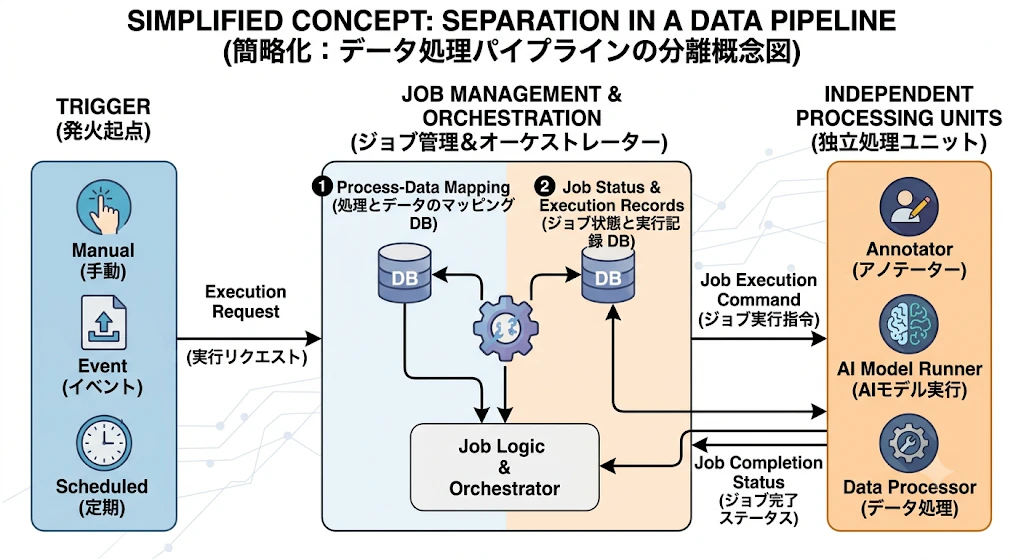
またトリガー部分とジョブ実行部分は切り離されているが,トリガー側からはジョブ管理,および,オーケストレーターがどのように実装されているのかは意識しないほうが望ましい.例えば,AWSで述べると,オーケストレーたー
依存関係管理
処理ロジックを追加していくと、あるジョブが別のジョブの完了を前提とするケースが必ず出てくる。例えば「モデル前処理をしないと、モデルに入力できない」という例があげられる。
これをどう管理するかも、前章のディレクトリ構成・デプロイ手順の統一と同じ発想で解決する。依存関係をコードではなくデータとして持つ。依存関係もテーブルで表現する。 こうすることで、依存先を追加する際もDBへ1行追加するだけでそれを表現できる。
実行前チェックとして依存を評価する
依存関係は「実行するかどうかを判断する層」でのみ評価する。ジョブ本体は自分がどのジョブに依存しているかを一切知らない状態にする。
1. 未処理データを検出(対象データ単位ごとに)
2. job_dependency_id が設定されている場合:
     └─ 依存先ジョブの、同一データ単位に対する実行状態を確認
          ├─ 完了している → 実行してよい
          └─ 未完了・未実行 → 今回はスキップ
3. 実行可能なもののみ、job_type に応じた呼び出し方でディスパッチ
ここで重要なのは、依存チェックの対象が「ジョブ」ではなく「データ単位」であることである。 ジョブAとジョブBという静的な関係だけでなく、「このデータに対する A の実行が終わっているか」というデータ単位×ジョブの組み合わせで判定する必要がある。同じジョブでもデータ単位が違えば独立して進行するため、依存関係の実体は「ジョブテーブルの参照」と「実行状態テーブルの参照」の両方を突き合わせて初めて成立する。未達は失敗ではなく「まだ実行できない」として扱う。
依存未達をエラーとして扱うと、監視が誤検知だらけになる。前段のジョブがまだ流れている最中というのは正常な状態であり、失敗ではない。そのため実行状態テーブルには以下のような値を用意する.
- 実行中
- 実行完了
- 実行失敗
- 再実行待ち(ジョブの前提条件未達を検知して返す)
依存未達を「再実行待ち」として明示的に分離しておくことで、アラートはエラー状態にのみ設定すればよくなる。トリガー側は次回の起動時に同じデータ単位を再評価し、依存が満たされていれば実行に進む。この再評価には無限ループを避けるための時間窓(例えば「一定時間以上経っても解消しない場合は本当に異常」という判定)を設けておくとよい。このようにすることで,際実行待ちの状態が延々と続くという状況を避けることができる.
コードで依存を書かない理由
依存関係を DAG ライブラリやワークフロー定義コードで表現する方法もあるが、ここではあえて採用しない。理由は、前章の「ジョブごとに統一したインタフェースを定めない」という方針と同じで、依存の書き方まで統一しようとすると、結局それがジョブ追加時に触る共通コードになってしまうからである。
DB のテーブルを唯一の真実の源にしておけば、依存を追加・変更するのに、トリガー側のデプロイが要らない
依存関係の全体像を見たいときは、テーブルを1回クエリすればよい(コードを横断的に読む必要がない)
ジョブ側の実装言語やコンテナの中身が何であっても、依存の表現方法は変わらない
という状態を維持できる。
イベント実行・定期実行・手動実行の使い分け
Data Processing の実行の起点として,イベント実行・定期実行・手動実行の3種類が挙げられる.処理の種類や処理するデータによってこれらの中から適したものを選択することが重要である.
それぞれのユースケース
まずは,それぞれの用途,代表的なユースケースを整理する.
| 実行起点 | 主な用途 | ユースケース例 |
|---|---|---|
| イベント実行 | 待たせてはいけないリアルタイム性が必要な即時処理 | 収集されたデータをアップロードしモデル入力前処理をモデル開発チームを待たせないようにすぐに行う. |
| 定期実行 | いつ来るかわからないデータを取りこぼさず処理する | クラウドにアップロードされたデータを数時間おきにクロールし,データカタログを作成する |
| 手動実行 | 開発中のシステムやユーザーが選んだ少数データへの処理 | データへのタグづけロジックをアップデートした際に以前のバージョンでタグづけしたデータ全てにタグを付け直す場合 |
イベント実行
機械学習モデル開発ではデータのアノテーションが大きなボトルネックになることがある.例えば,以下のような事象が発生する.
- 課題を改善するためにデータを追加したいがそこまでに1ヶ月を要してしまう
- アノテーションされたデータはすぐに使いたいのにデータ前処理が実行されずモデルの学習に使用できない
特に Data centric AI の中のデータによる課題改善では,課題を改善するデータ追加のスピードが肝になる.
また,ビジネスの意思決定をデータドリブンに行う場合でも使用されるデータの鮮度が悪ければ,正しい意思決定を行うことができない.
イベント駆動の実際の実装例としては完了マーカーファイルを置く というものが挙げられる.S3などのクラウドストレージ上にデータを保存してそのデータを処理するというケースを考える.データアップロード側は全てのデータアップロードを完了したら COMPLETED という空のファイルを置く.後段は,このファイルをイベントのトリガーとして処理を開始する.
例えば AWSのS3では,Object Created イベント を発火する機能を持っているので,これを AWS EventBridge経由で受け取ることで後段の処理を開始できる.
定期実行
データ車両からのデータアップロードは,走行終了後にドライバーが車庫でデータをアップロードしたり,通信環境などによって数時間 ~ 数日間を要する可能性がある.このように 「データが到着した瞬間」を補足する仕組みが存在しない場所 では,定期的にデータを見に行く必要がある.
またデータ分析の文脈においては,定期的なスナップショット をとることに意味があるケースが存在する.KPIのトラックなどがこれにあたる.
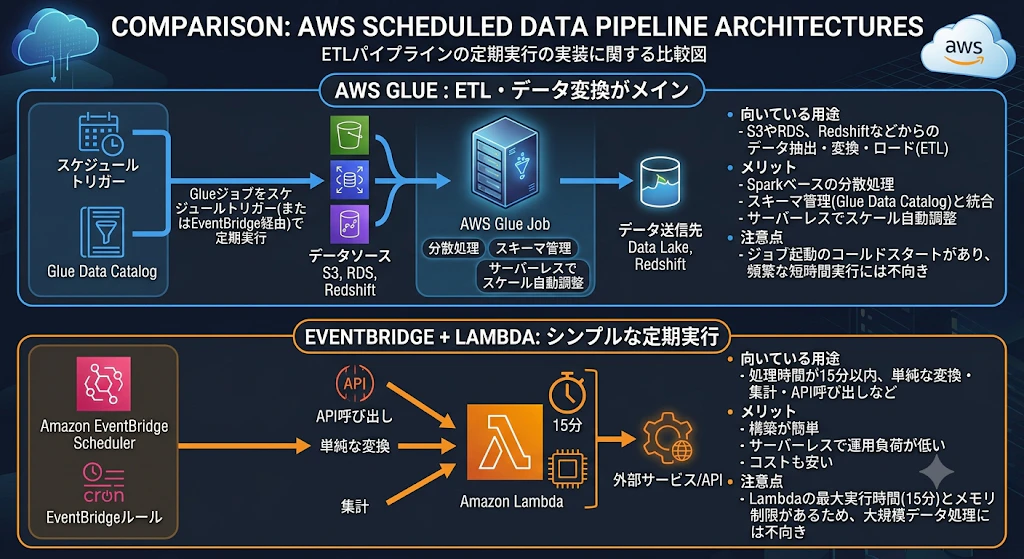
例えばAWSでは,AWS Glueを用いて実装することができる.
ETL・データ変換がメイン:AWS Glue
- 構成: Glueジョブをスケジュールトリガー(またはEventBridge経由)で定期実行
- 向いている用途: S3やRDS、Redshiftなどからのデータ抽出・変換・ロード(ETL)
- メリット: Sparkベースの分散処理、スキーマ管理(Glue Data Catalog)と統合、サーバーレスでスケール自動調整
- 注意点: ジョブ起動のコールドスタートがあり、頻繁な短時間実行には不向き
シンプルに EventBridge + Lambda でも定期実行を実装可能.
EventBridge + Lambda
- 構成: Amazon EventBridge Scheduler(またはEventBridgeルール)でcron式のスケジュールを設定し、Lambda関数をトリガー
- 向いている用途: 処理時間が15分以内、単純な変換・集計・API呼び出しなど
- メリット: 構築が簡単、サーバーレスで運用負荷が低い、コストも安い
- 注意点: Lambdaの最大実行時間(15分)とメモリ制限があるため、大規模データ処理には不向き
手動実行
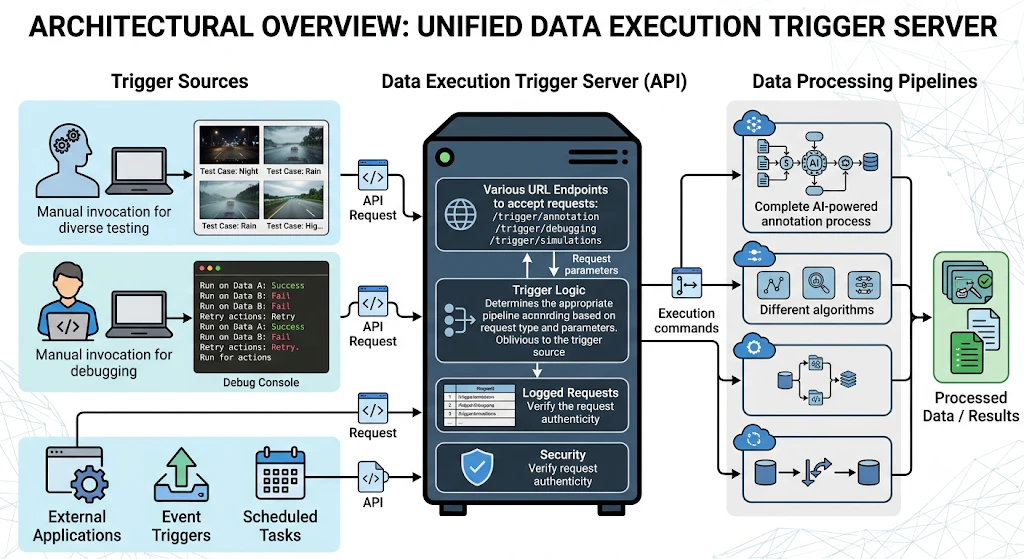
自動運転モデルのAuto Annotation 機能の実装時を想定する.この時,機能をテストするために少数のデータでテストすることになるが,その際にテスト設計者が選んだ多種多様なテストデータで実行したいとする.このような場合,パイプライン実行のトリガーはテスト設計者が送ることになる.
また,別のユースケースとして,データ処理機能のデバッグなどが挙げられる.機能開発時,データ処理パイプラインをデータAとデータBの両方に試し,Aには成功,Bには失敗したとする.デバッグを行い,再度AとBの両方にテストを行う.このような場合においても,デバッグを行なった開発者が手動実行により,パイプラインを実行できるのが望ましい.
このようなユースケースを実現するためのプラクティスとして,データ実行を行うトリガーをサーバー化し,APIリクエストにする方法が挙げられる.トリガーサーバー側は,どのデータに対して,どの処理を実行するかを受け取り,リクエストを出しているコンポーネントが手動なのか,自動なのかを意識しないようにする.
並列処理
処理するデータ量が増えれば増えるほど並列処理が重要になる.自動運転モデル開発で扱うデータ量は膨大である.例えばテスラ社は世界中の車両から絶えずデータがアップロードされ続けている.モデルの前処理にしろ,メタデータの付与にせよ,これらの処理の遅れはモデル学習や分析などの後段プロセスの遅れを招く.
実際に並列処理を実現するには,例えばAWSだとEKSを使用する必要がある.パイプラインを起動する側のトリガーは,同時に複数の処理および処理したいデータのデータをとってきて,後段のオーケストレーターに投げる.後段のオーケストレーターは,並列処理の制約(同時並列数など)を破らないように並列処理を行う.
処理の結果は結果を格納するDBに保存する.
実行中断、再開
データ処理は実行の中断と再会機能が不可欠である.例えば以下のような例がユースケースとして挙げられる.
- 数万単位のデータに対する実行時に最初の100データで処理にバグが判明し,処理を中断したい
- 数万単位のデータに対する実行時に最初の100データで実行を停止し,処理がうまく動いているかを確認し,残りを再実行したい
- データ処理プロセス内でバグがあり,処理がいつまで経っても終了せずずっと処理を動かすとリソースのための費用がかかるので処理を中断したい
- データ処理を実行しようとしたが,その前段の処理がまだ終了しておらず,中断状態にして前段の処理が実行されたら実行したい
これらは,前述のようにデータベース内に処理とデータごとの処理状態,(未処理,中断,完了など)を保存し,それを元に処理を作成するという実装で解決できる.
まとめ
ここまでData Processing パイプラインの開発時に意識すべきことを,自動運転モデル開発のデータパイプラインを事例としてまとめてきた.ただ,これは自動運転モデル開発に限らず,全てのデータ処理パイプラインの実装に通づることであるため,このプラクティスがデータパイプライン開発のどこかで少しでも役に立つことを期待する.
参考資料
- Create an autonomous vehicle operations (AVOps) solution
https://learn.microsoft.com/en-us/industry/mobility/architecture/avops-architecture-content - DataOps for autonomous vehicle operations
https://learn.microsoft.com/en-us/industry/mobility/architecture/avops-architecture-content