
本記事について
- データサイエンスプロジェクトやPhsical AIなどのデータを扱うプロジェクトにおけるデータ管理や思想の学習を目的とする
- 上記内容をMicrosoft AVOpsの DataOps 部分を具体例として扱い、DataOps の原則と照らし合わせることで設計思想と具体的な実装の橋渡しとなるように知識を体系化する
DataOps とは
定義
DataOpsという言葉には様々な定義が存在しているが、本記事ではDataOpsを
「複数のデータ利用者が迅速で拡張性と反復性の高いプロセスによって、未処理のRAWデータから価値のあるデータプロダクトに変えるためのプラクティス」
というように定義する。そして、上記目標を達成するためのデータ処理パイプラインを DataOps Pipeline と定義する。例えば以下のような例が挙げられる。
| DevOps の概念 | DataOps における対応物 |
|---|---|
| ソースコード | 生データ(センサーデータ、ログ、外部データ) |
| ビルドパイプライン | データ処理パイプライン(抽出・変換・エンリッチ) |
| 成果物(アーティファクト) | カタログ化されたデータセット、メタデータ、タグ、アノテーション |
| デプロイ | 下流(学習・シミュレーション・分析)へのデータ供給 |
| モニタリング | パイプライン実行状態・データ品質・リネージの監視 |
これを自動運転モデル開発に当てはめると以下のように具体化できる。
- 収集された運転データから精度の高い運転モデルを作成するためのデータセットを作成するための手法
- 現在の運転データセットの分布の穴を迅速に発見し、追加データ収集の意思決定をする手法
- 複数のデータ解析アルゴリズム候補(E.g. アクティブラーニング)がある際にそれらをスピーディーに実装、デプロイするための手法
なぜDataOpsが必要か
先ほどの自動運転データセット開発における事例を例に挙げてDataOpsの重要性を解説する。
例えば、精度の高い自動運転モデルを学習するためのデータセットを作成する際、以下のような点に気をつける必要がある。
- センサデータに欠損はないか、同期はできているか
- データセットにドメインの穴はないか(E.g. 昼のシーンばかりで夜のシーンが抜けることで夜の精度が悪くなる)
- データセットを作成する際のデータセットは効率的に選ばれているか
例えば、モデルを作成した時点で思ったような精度が出なかったとする。モデルアーキや学習手法に問題がなく、データセットに問題があるとすると、その原因を解析するわけだが、収集したデータをクリーニングせずに闇雲にアップロードしていた場合、データセットの各サンプルすべてを読み込んでセンサ欠損を調べるスクリプトを走らせることになる。一度だけであれば、それで問題がないかもしれないが、データセットのバージョンが更新され、再度精度が落ちた場合、センサ欠損解析処理を反復的にできる仕組みが整っていなければ、似たような実装をもう一度する必要があるかもしれない。
また、多様性のあるデータセットを作成したいとする。そのためには、データの各サンプルにタグ付けを行い、データセットの分布を解析できるようにする必要がある。「交差点左折」のタグをつけるためのアルゴリズムにはAさんが適しているものの、Aさんはクラウドにあまり詳しくなく、本質ではないデプロイ作業に多くの時間を費やしてしまうかもしれない。
上記のようなデータ処理作業を高速化することがプロジェクト成功への鍵になる。
DataOps に求められるべき性質
本記事では、DataOps pipeline システムが満たすべき性質を7つに体系化する。
-
単一の真実 (Single Source of Truth) — データの所在・状態・履歴を問い合わせられる唯一のカタログが存在する
例:センサデータが欠損しているかどうかはテーブルAのカラムaをみれば確実にわかる。各サンプルがどんなデータなのか(天気、シーン、データ形式など)を表すメタデータが十分にカタログに含まれている。 -
自動性 (Automation) — データが到着したら、人手を介さず登録・処理・集計が進む
例:データがアップロードされたら自動でセンサ欠損がないかどうかをチェックするスクリプトが走り、合格したデータだけデータカタログに登録され、エラー率集計がその都度走る -
冪等性・再実行性 (Idempotency / Reprocessability) — 同じ処理を何度実行しても壊れず、失敗からいつでも再開できる
例:データ集合Aに対してタグ付け処理を行った後、集合Bに対して同じタグ付け処理を実行。集合AとBは独立なものになっておらず、同じ処理を2度適用してしまうデータがあったとしても、まったく同じ結果のデータはDBに追加しないようにする -
観測可能性 (Observability) — どのデータがどの処理をどこまで終えたかを常に把握できる
例:データ収集からモデル学習を行う際、センサ同期、センサエラーチェック、モデル前処理という処理を順に実行する必要がある場合、それらのステータスを追えるようにする -
拡張性 (Extensibility) — 新しいデータ種別・新しい処理を、既存を壊さずに追加できる
例:収集データに新しいモデル前処理アルゴリズムや分析を適用する際、前のバージョンのものをそのまま使用できるようにしつつ、新しいものを適用できるようにする -
リネージ / Provenance — 「誰が・何が・どの版で作ったか」を常にさかのぼれる
例:走行データAがどの車で、どのドライバーからどこで収集されたものなのかをDBを見ればわかるようにする - 検索性能 — 大量データ(億単位以上のフレーム)に対して検索が現実的な速度で返る
DataOps pipeline の構成要素
一般的なDataOps pipelineの構成要素について整理する。ここでの pipeline は自動運転に限らない一般的な 「未処理のRAWデータから価値のあるデータプロダクトに変えるための」データフロー である。
[データ生成源] → ① Data Ingest(取り込み)
                    │  Landing Zone への受領、検証、匿名化
                    ▼
               ② Data Registration / Metadata Extraction(登録・メタデータ抽出)
                    │  カタログ(メタデータ DB)への登録、発見可能化
                    ▼
               ③ Data Processing / Labeling(加工・ラベリング)
                    │  データ単位の解析パイプライン、アノテーション
                    ▼
               ④ Data Aggregation(集計)
                    │  データ横断の統計、検索インデックス構築
                    ▼
               ⑤ Data Visualization / Search(可視化・検索)
                    │  ポータルによる可視化、シーン検索、手動オペレーション
                    ▼
               [下流消費者: モデル学習 / シミュレーション / 検証]

        ⑥ Common Infrastructure(共通基盤: ネットワーク、認証、IaC)が全体を支える
各ステージが解く普遍的な課題は次のようになる。
| ステージ | 普遍的な課題 | 自動運転での具体例 |
|---|---|---|
| ① Ingest | 信頼できない外部からデータを安全に受け取り、受領完了を確定させる | 車両からのアップロード、個人情報(顔・ナンバー)の匿名化 |
| ② Registration | 「何がどこにあるか」を機械可読なカタログにする | 車両・計測セッション・センサーストリーム単位の DB 登録 |
| ③ Processing | データ 1 単位ごとの解析・変換・ラベル付与 | 同期解析、モデル前処理、Auto Annotation、Auto Tagging |
| ④ Aggregation | データを横断した集計・インデックス化 | 日次統計、地図検索用サマリ、シーン類似検索ベクトル |
| ⑤ Visualization | 人間がデータを発見・確認・操作できるようにする | 走行ルート地図、動画プレビュー、パイプライン手動実行 |
| ⑥ Common Infra | すべてのコンポーネントが共有する足場 | 1 - 5 までを扱うクラウド環境など |
Microsoft の AVOpsの DataOps 部分と上記のDataOps Pipeline の構成要素を照らし合わせていく中で、上記性質を守るためにはどのような実装や構成が必要なのかを次の章からまとめていく。
Microsoft AVOps
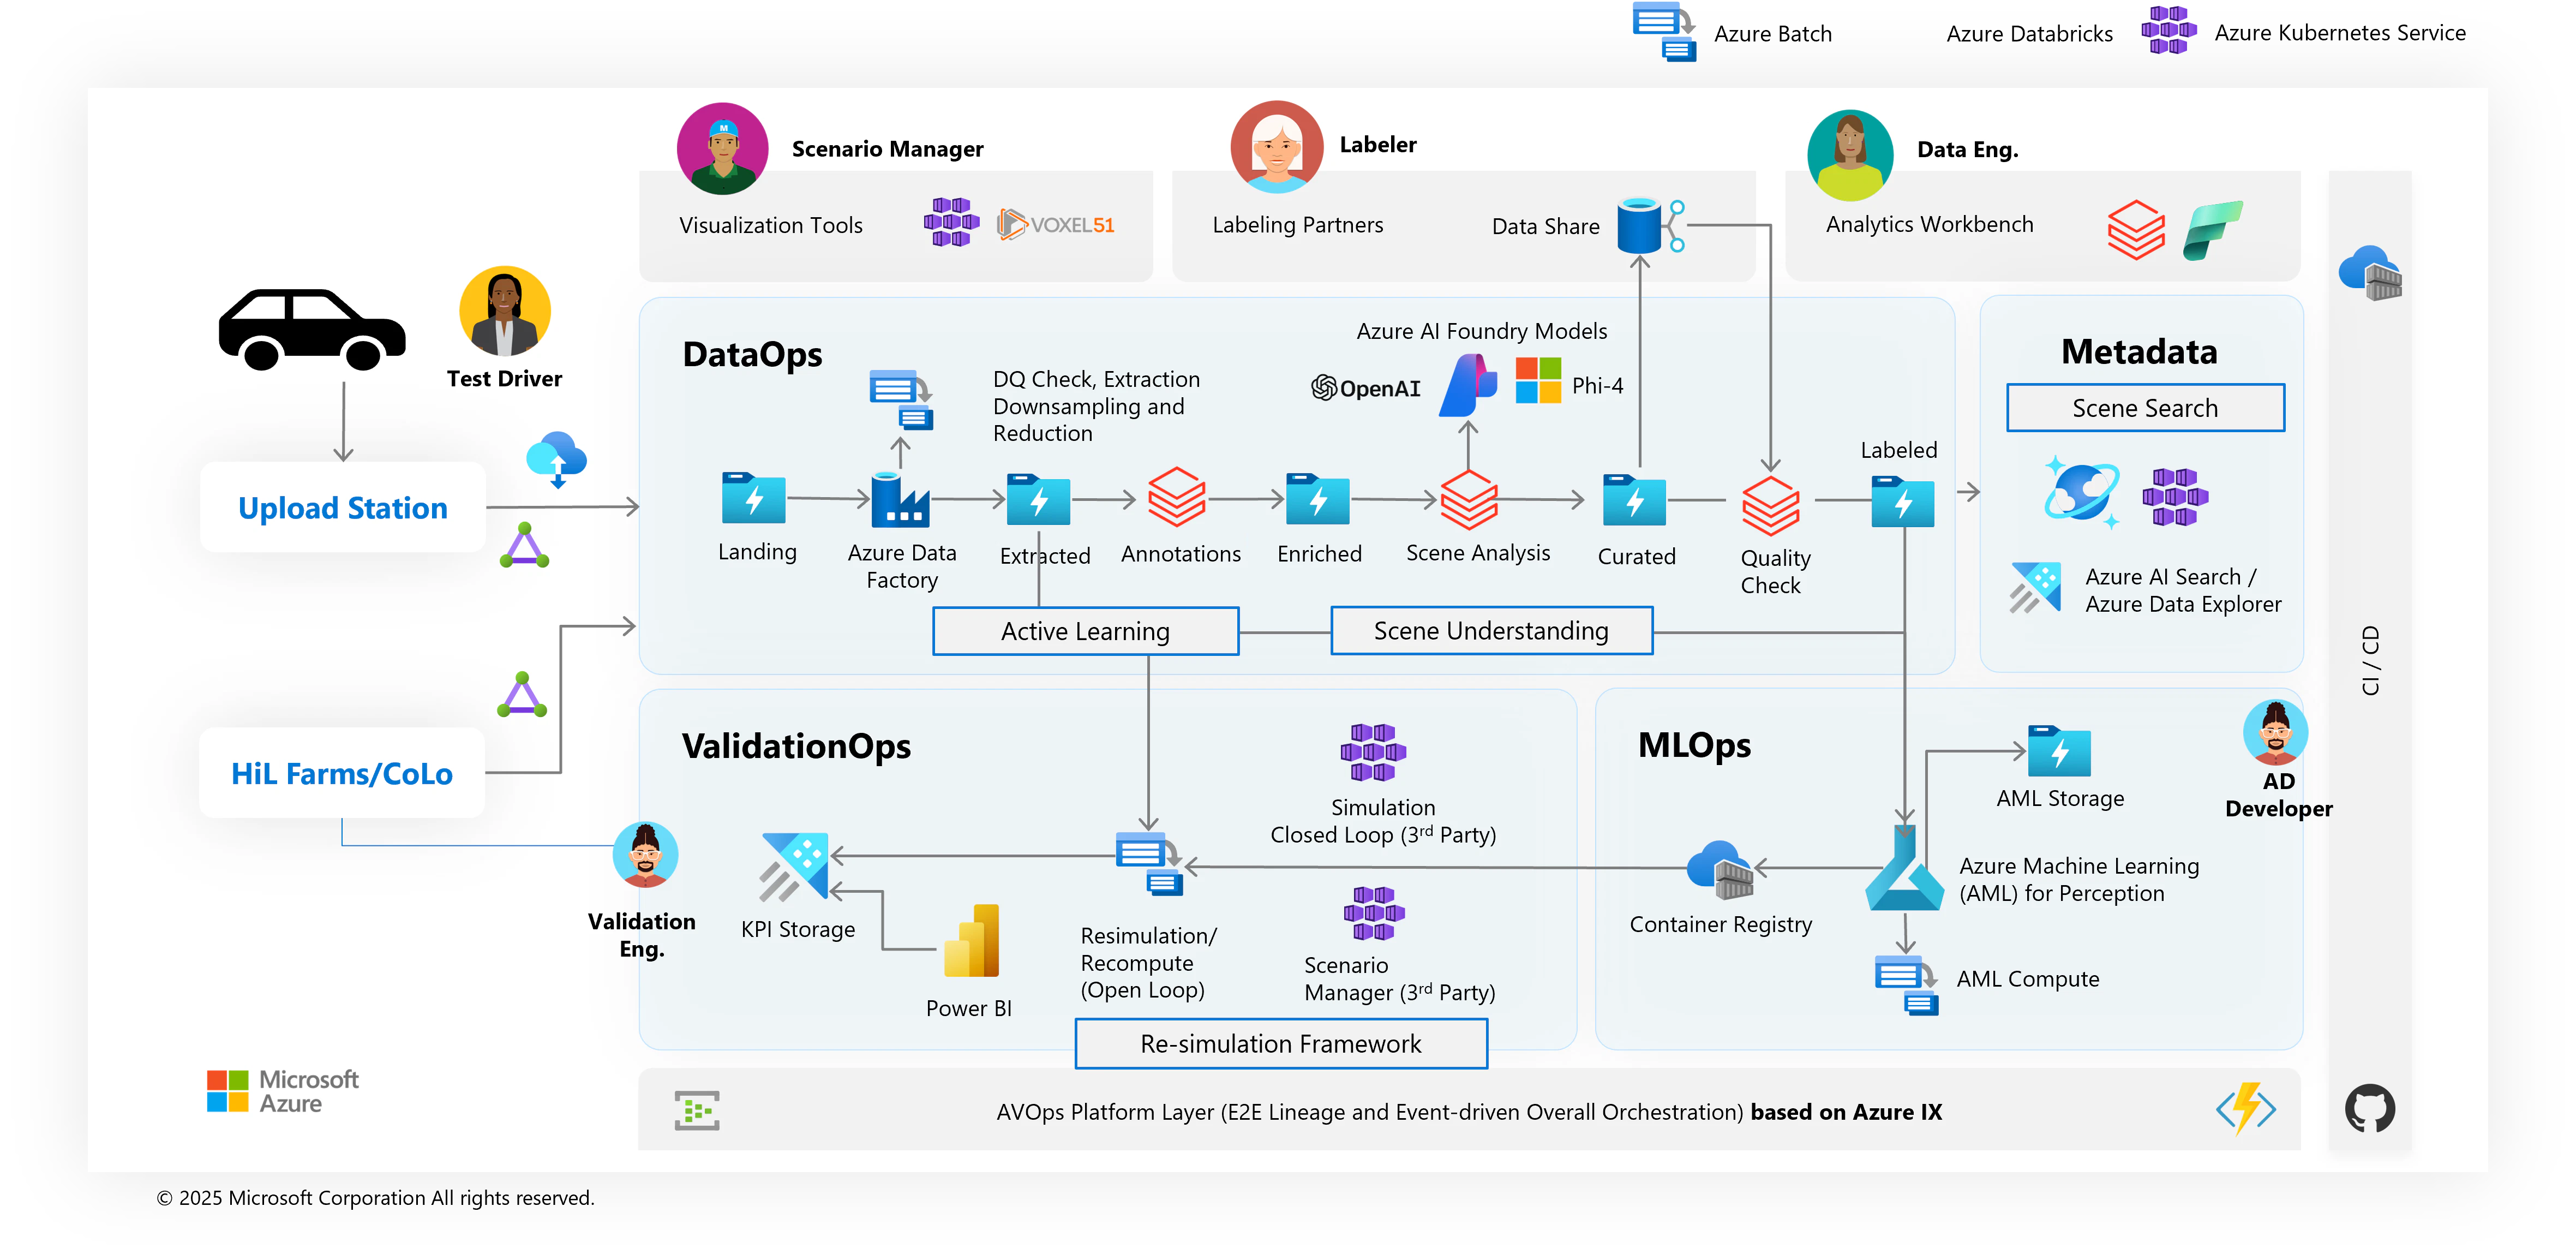
Microsoft AVOpsとは
Microsoft AVOps とは、自動運転モデルの学習、評価、改善を効率よく行うための Microsoft Azure のリソースを活用したソリューションである。以下の4つのコンポーネントで構成される。
-
DataOps
データ取集車からアップロードされたデータを抽出、アノテーション、キュレーション、ラベリングするデータパイプライン -
Metadata
DataOps で付与されたメタデータ(天気や道路、シナリオタグやセマンティックサーチのためにベクトル化されたデータ)を用いてシーンを検索するためのコンポーネント -
MLOps
モデルの実験管理や重みのバージョン管理を行うためのコンポーネント -
ValidationOps
Closed loop Simulation やOpen Loop Simulation を行い、モデルやデータセットのバージョンごとに精度検証を机上で行うためのコンポーネント
DataOps pipelineとのマッピング
ここからは、Microsoft AVOps と DataOps パイプラインをマッピングしつつ、それらがDataOps の満たすべき7つの性質を満たすためには、どのような実装が必要になるのかをまとめていく。
Data Ingest
Data Ingest 部分は Microsoft AVOps に照らし合わせるとAzure Data Factoryまでの部分に該当する。これらの部分についてまとめていく。
Landing
まず、自動運転における「データ」というのは、以下のようなセンサーのデータストリームに該当する。
- マルチカメラ
- LiDAR
- Radar
- GPS, Ego-motion
データ収集車はそれぞれローカルストレージを有しており、それらをクラウドにアップロードする必要がある。走行データは容量の大きなデータなので、それらをリアルタイムで常にアップロードし続けるのは非現実的である。したがって Upload Station の整備が必要である。
| DataOpsの性質 | 具体的な実装 |
|---|---|
| 自動性 | SSDをアップロードステーションに接続すると自動的にアップロードが走るようにする。もしくは、スケジュールによる自動トリガー。 |
| 冪等性・再実行性 | SSDからデータを完全にアップロードされた場合、COMPLETED などのファイルをクラウドに置く。これがないデータは途中でアップロードが失敗したとみなす。完全に重複したデータをアップデートした場合、それを削除する。したがって各データの単位を一意に示す識別子をあらかじめ収集データのメタデータとして含める(タイムスタンプなど) |
| リネージ | ドライバーは誰か、どのデータ収集車から収集されたデータかなどの必要そうなメタデータをあらかじめ収集データつけた状態でアップロードする |
| 検索性能 |
<storage>/raw/YYYY/MM/DD/<measurement-ID>/<data-stream-ID>/のような階層ファイル構造にすることで後段からの検索性を向上させる |
なお、Landing が必要なのは予算削減の理由もある。自動運転モデルのデータは容量が大きいため、クラウドストレージの費用も深刻な問題になる。したがって、一度データはアップロードするものの、一定時間たったら使用しないことが確定したデータは削除する必要がある。
一方で、データエンジニアリングの原則として、Rawデータは保持するという原則がある。したがって、組織のコスト制約を考慮したうえで安価だが遅いストレージにデータを移す、オンプレサーバーに保存するなどの戦略を考える必要がある。
アップロードされるデータはシミュレーションの合成データなども含めたさまざまなフォーマットが想定される。例えば以下のようなものが挙げられる。
-
Measurement Data Format version 4 (MDF4)
主に自動車のセンサーや電子制御ユニット(ECU)から取得した測定データを保存するバイナリファイル形式 -
ROS bag
ロボット用ソフトウェアプラットフォーム「ROS(Robot Operating System)」で使われるデータ録画・再生用のファイル形式
Data Regisration / Metadata Extraction
「何がどこにあるか」を機械可読なカタログにする役割を持つ。具体的には、クラウド上のデータのパスをDBに格納したり、走行時に付与されたドライバーや地域、時間などのメタデータをDBに格納する。タグ付けなどのデータの解析は次のステップで取り扱う。このステップを挟むことによって、以下の処理を低コストで実施することが可能になる。
- データへのパスがDBで管理されていることにより後から狙ったデータを取得する際も大きなデータを扱うことなく、DBに対してクエリを投げるだけで完結する
- 付与されたメタデータをDBに登録しておくことによって、ドライバーごとの絞り込みや収集場所ごとの絞り込みなどが容易になる
Azure Data Factory
Azure Data Factory は DataOps における Data Registration / Metadata Extraction を担当する構成要素である。Azure Data Factory は Data 分析システムの基本構成である。 ETL pipeline を実現するものである。
- 抽出(Extract):さまざまなシステム(アプリやデータベースなど)から必要なデータを集める
- 変換(Transform):集めたデータを分析しやすい形に整える。例えばROS bag 形式のファイルから使用するための画像を取り出す、センサ同期がとれている状態にするなどが挙げられる
- 格納(Load):加工したデータをデータウェアハウスなどの分析用システムに保存する。例えば、抽出された画像データをS3などのクラウドストレージに保存する、日付情報などのメタデータをデータカタログ(DB)に保存するなどが挙げられる
このうち、抽出(Extract)部分が DataOps における Data Regisration / Metadata Extraction に該当する。具体的には以下の処理が挙げられる。
-
Data Quality チェック
センサ値に異常や過剰な欠損がないかをチェックする。この時点で使い物にならないデータは削除し、後段で処理されるデータは信頼できるもののみにする (DawnSampling and Reduction) -
メタデータの取り込み
例えば走行中に記録されたドライバーからの情報などをJSONファイルなどに記録しておき、それをDBに取り込んで検索可能にする。
| DataOpsの性質 | 具体的な実装 |
|---|---|
| 単一の真実 | データごとのタグやDQの結果はすべて一つのDBカタログ (~=クラスター) に集約する。このクラスターを見ればデータの素性が確実にわかるようにする。 |
| 自動性 | 収集データがアップロードされた際にDQチェック、自動タグ付けがイベントドリブンで走るようにする。 |
| 冪等性・再実行性 | DQチェックやタグ付けが完了した場合、完了済みのファイルを置く。タグ付けジョブを走らせた際のタイムスタンプをDBに記録しておくことで、差分実行が可能になる。 |
| 観測可能性 | データの展開、メタデータ取り込みなどを、結果の保存などの各ステップをDBに記録していき、データの単位ごとにそれらの段階のうち、どこまでが終了しているかを抽出するクエリをあらかじめ作成してお吉き、ダッシュボードに表示する |
| 拡張性 | メタデータがJSONなどでアップロードされ、それをDBに格納する場合、JSONのスキーマが変更されることは想定できる(E.g. 新たにナビ情報を加えるなど)。それに対して対応できるように既知のフィールドはあらかじめDBのカラムとして作成しておき、それ以外の拡張されたものに関しては自由表記のJSONBなどで格納しておく。 |
| リネージ | メタデータ抽出パイプラインはDBでジョブ管理を行い、成功、失敗、中断などのステータスを記録する |
拡張性の部分について、もう少し深くまとめる。例えば、最初のメタデータファイルでは、以下の要素を収集していたとする。
- 時間
- 場所
- ドライバー
これに加えて「天気」のフィールドを追加する場合、JSONのフィールドが一つ増えるわけだが、それをそのままDBに格納してしまうと、天気 = 雨 のデータを検索する際に、いちいち、JSONBの情報をパースする必要が出てきてしまい、検索性を阻害してしまう。そのような場合、スキーマを 「頻繁に検索・集計に使われるフィールド」と「たまにしか使わない拡張フィールド」を分離 することが一つの解決策として挙げられる。
CREATE TABLE metadata_catalog (
    data_id UUID PRIMARY KEY,
    vehicle_id VARCHAR,
    timestamp TIMESTAMP,
    weather VARCHAR GENERATED ALWAYS AS (metadata->>'weather') STORED,  -- JSONBから自動抽出して固定カラム化
    scene_type VARCHAR GENERATED ALWAYS AS (metadata->>'scene_type') STORED,
    metadata JSONB  -- 新しく追加された未知のフィールドはここに全部入る
);

CREATE INDEX idx_weather ON metadata_catalog (weather);  -- 通常のB-treeインデックスが使える
このようにすると、メタデータアップロード側(データ収集車側)は、metadata という抽象的なフィールド内に weather や root などの追加情報をただ追加していけばよく、取り込み側は、上記 sql の weather にならって、1行追加するだけで、新たなデータを取り込むことができるようになる。さらにindex も張れるので、JSONBをいちいちパースするというアンチパターンを防ぎつつ、もとのメタデータファイルの拡張性を担保することが可能になる。
Data Processing / Labeling
Data Processing、Labeling はデータ 1 単位ごとの解析・変換・ラベル付与という定義になっている。これは ETLパイプラインにおけるTL (Transform と Load)に該当する。データごとにラベル、タグを付与してデータカタログに保存することによって所望の属性のデータの検索性を担保することができる。これがないと以下のような問題点が生じる。
- 「交差点」のデータを重点的に学習させたいのにどのデータが「交差点」のデータかどうか特定することが難しい
- 3月以前のデータはバグによりデータ欠損が生じているということがわかっているのにカタログがなく、どのデータがそれに該当するかが属人的にしかわからない
- 多様性を持ったデータセットを作成したいのにどのデータをデータセットに含めれば多様性を担保できるのかがわからない
Azure Data Factory
先ほどの Data Regisration フェーズでも触れたが、Data Processing / Labeling の文脈においても、Azure Data Factory は役割を持つ。例えば、以下のような処理が挙げられる。
- マップ情報やVLMを使用してシーンのタグを付与する
- 物体認識モデルやレーン認識モデルを使用してオブジェクトやレーンのラベルを付与
- 大規模モデルを使用した Auto Annotation
- 3rd party API を使用して天気のタグを付与
Microsoft AVOps のアーキテクチャ図を再掲する。
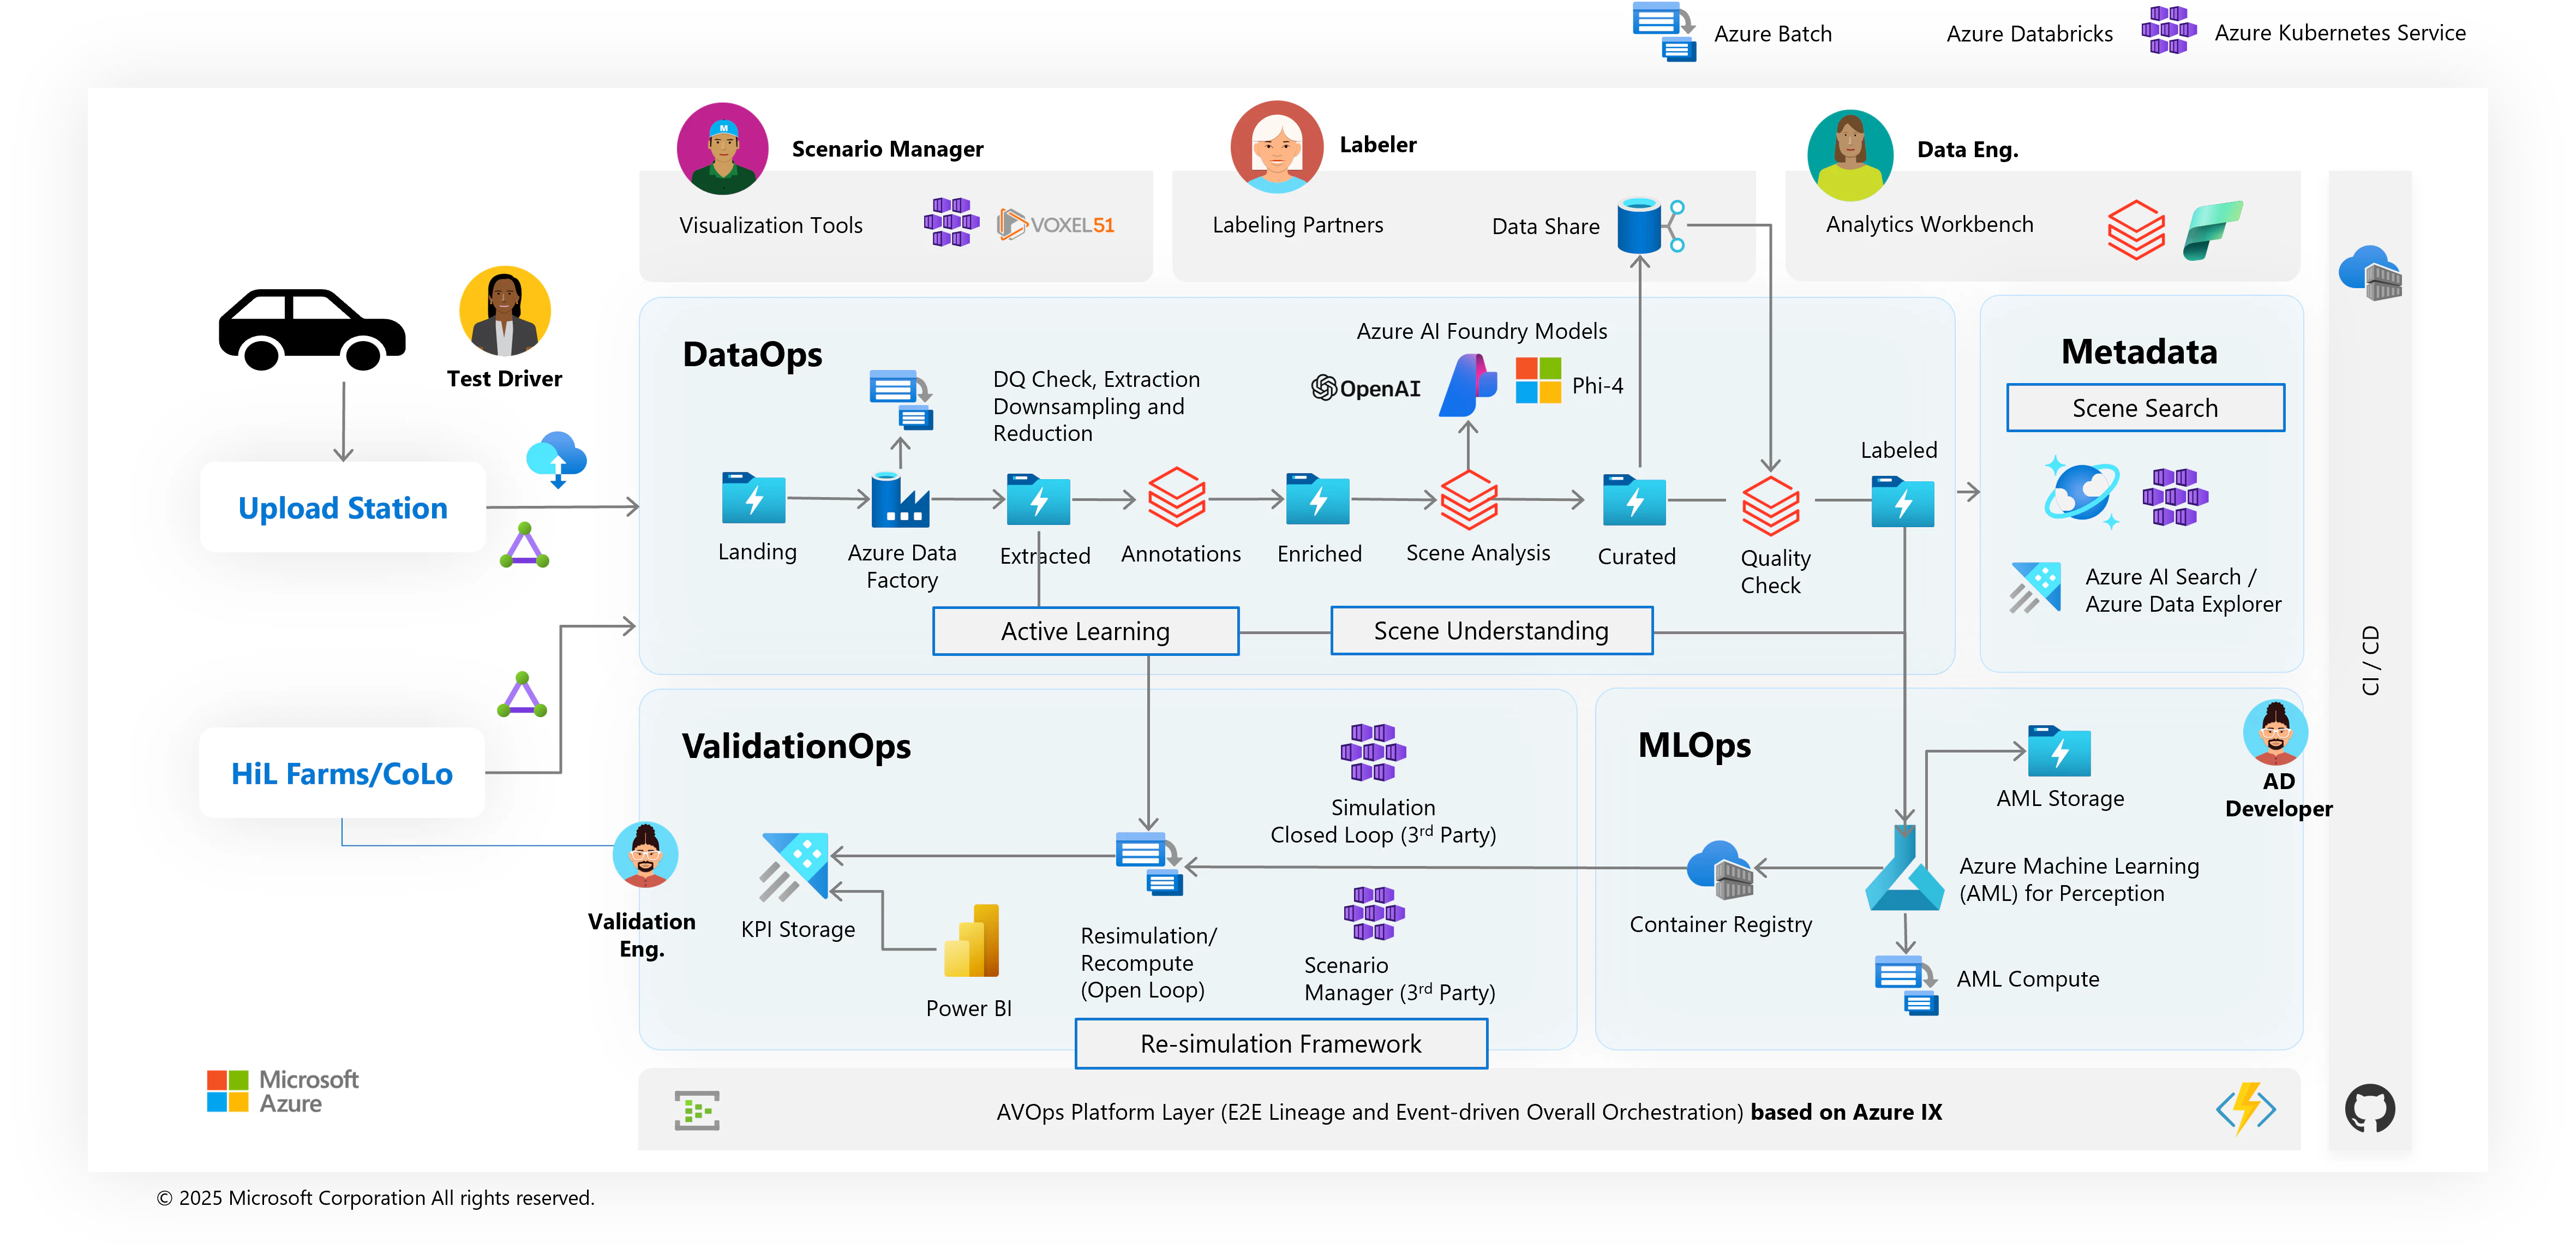
この図では、以下のような順でデータが処理されている。
- Azure Data Factory
- Annotations
- Scene Analysis
Azure Data Factory の出力はEnrichedとなっている。これは、天気、地図、物体データなどの追加メタデータが付与されたデータである。これは、Annotations の前に実施されているこれは、Active Learning に使用するためである。
Active Learning とは、限られた予算制約の中で未アノテデータプールの中からもっとも精度向上に寄与するデータをアノテ対象として選定するという手法である。 物体データ、地図、天気などのメタデータは、モデルの弱点の把握や未アノテデータからの検索に用いるための情報なので、アノテーション処理の前段に配置する必要がある 。
| DataOpsの性質 | 具体的な実装 |
|---|---|
| 単一の真実 | データごとのタグの結果はすべて一つのDBカタログ (~=クラスター) に集約する。このクラスターを見ればデータの素性が確実にわかるようにする。 |
| 自動性 | 収集データがアップロードされた際に自動タグ付けがイベントドリブンで走るようにする。 |
| 冪等性・再実行性 | タグ付けが完了した場合、完了済みのファイルを置く。タグ付けジョブを走らせた際のタイムスタンプをDBに記録しておくことで、差分実行が可能になる。 |
| 観測可能性 | タグ付け処理、結果の保存などの各ステップをDBに記録していき、データの単位ごとにそれらの段階のうち、どこまでが終了しているかを抽出するクエリをあらかじめ作成しておき、ダッシュボードに表示する。実行中、正常完了、失敗、再実行待ちなど |
| 拡張性 | データ変換パイプラインの追加を用意にする。具体的には、「何のイベントが発生したらジョブを実行するか」、「ジョブの実行」、「結果のDB保存」を分離 |
| リネージ | モデル入力のためのデータの前処理を実行する場合やタグ付け処理を実行する場合それらのジョブの実行や実行結果をDBに保存 |
Annotations
ここで示されている Annotations というのは、人による Annotation ではなく、自動のAuto-Annotation に該当する。自動運転における Anntotation はモデルの解くタスク(Perceitption, Planning, E2E, VLAなど)によって異なる。例えば以下の例が挙げられる。
- 3DBB, Lane, Segmentation, Depth, Voxel
- Ego trajectory, Agent trajectory
- Control signal
- Text
Scene Analysis
自動運転モデル開発、特に、Ego-trajectory を出力するタスクは、シナリオ分析が重要になる。シナリオの例として例えば以下のものが挙げられる。
- 交差点右左折
- 合流・分岐
- 先行車追従
近年のEnd-to-Endのモデル開発には、データセットにおけるこれらのデータの分布調整が大きな役割を持つ。例えば以下のようなユースケースが存在する。
- 現在のモデルをシナリオタグごとに精度評価
- 精度の悪いシナリオを分析・特定
- 未アノテデータの中から苦手なシナリオのデータを学習データに追加
このステップの出力は Curated つまり、学習データとして選別されたデータとなる。 これらのデータをアノテーションを依頼する外部組織に共有し、人手によるアノテーション結果を取得する。ただしこのステップが必要かどうかは、人手によるアノテーションが必要なタスクかどうかに依存する。
Quality Check
このステップでは、アノテーション精度をチェックする。データ品質はモデル精度に直結するので、しっかりとここのチェック機能を備えていくことが重要である。もし、アノテーション作業を組織外部にお願いする場合、受け入れテストをしっかりと行う必要がある。
Data Aggregation
データプロジェクトにおいてデータを集計し、意思決定を行うという場面は多く存在する。自動運転モデル開発プロジェクトにおいては、例えば以下のような意思決定が挙げられる。
- データを集計し足りないシナリオがあった場合狙ってデータ収集を行う
- モデルの出力結果をストアしシナリオごとの精度を集計する
- 学習データセットの分布を集計し多様性を評価する
これらの集計処理はKPI化され、定点観測することがある。そのような場合には、この集計処理をジョブとして定期実行する必要がある。また、集計処理の追加に開いたシステム構成にする必要がある。
| DataOpsの性質 | 具体的な実装 |
|---|---|
| 自動性 | 集計処理の定期実行 |
| 冪等性・再実行性 | 集計処理を行うSQLのGitによるバージョン管理、集計ジョブの実行日時やパラメータの記録、結果のスナップショットの記録などが必要 |
| 拡張性 | 集計ジョブの追加に開いている必要がある |
| 検索性能 | メタデータ検索、ベクトル検索(イメージサーチ、テキストサーチ)など複数の検索モードに対応させる |
Data Visualization
Aggregation により集計されたデータを可視化するステップである。ダッシュボードなどを用いて結果を表示する。自動運転データの文脈では例えば以下のような可視化があげられる。
- 棒グラフによるデータセット分布表示
- 折れ線グラフによるモデル精度KPIトラック
| DataOpsの性質 | 具体的な実装 |
|---|---|
| 自動性 | ポータルを開くだけで事前に集計された情報がグラフとして自動で表示される |
| 拡張性 | 集計ターゲットはプロジェクトの中で新しく加えられたり終了したりする → 集計の追加と削除に開いた設計にする |
Common Infrastructure
ここまででまとめてきたコンポーネントは共通のインフラ基盤で実装することで、機能開発者のインフラ整備の工数を減らすことができる。具体的には、** IaC (Infrastructure as Code) ** という Python や Typescript などでインフラの定義、デプロイ、管理ができる機能を使用することで、インフラを Github で定義することができる。
| DataOpsの性質 | 具体的な実装 |
|---|---|
| 拡張性 | 新しいコンポーネントの追加削除に開いている必要がある。具体的には、インフラのデプロイ、削除はすべてのコンポーネントで同じスクリプトを叩くだけにし、ディレクトリ構造もすべてのコンポーネントで統一する。また変更頻度の少ない共通のインフラ (EC2など) をコードで管理する |
MLOps, ValidationOps とDataOps の連携
DataOps の解説からは外れるが、AVOps を構成するMLOps, DataOps, ValidationOps のそれぞれの関係性をまとめる。
| xxxOps | 目的 |
|---|---|
| DataOps | データセット作成などの価値あるデータ変換の実装、管理の効率化 |
| MLOps | モデルの学習実験管理や重みバージョン管理 |
| ValidationOps | 学習済みモデルの精度検証、弱点把握、Validation |
MLOps
MLOpsは、DataOpsによって用意されたデータセットを使ってMLモデルを学習、改善し、エッジデバイスに組み込める形式に変換するという役割を持つ。MLOpsには以下の要素が必要とされる。
- モデルの学習、評価、バージョン管理 (CI/CD)
- 学習済みモデルをエッジデバイス(車載SoCなど) や検証、シミュレーションソフトウェアが読み込める形式へ変換
- データセットを受け取り、エッジデバイス向けに変換されたモデルを出力
ValidationOps
MLOpsが生成した学習済みモデルが、安全・性能・精度の基準を満たしているかを大規模シミュレーションや実機テストで検証する工程。モデルリリース時の Criteria としての機能を持つので、** 本番環境と近い評価環境 ** を用意する必要がある。具体的には、以下の点に気をつける。
- 製品に搭載するモデルが量子化されたものならば、検証するモデルは量子化されたものである必要がある
- 製品と同様の推論環境 (車載SoC) で検証する必要がある。E2Eモデルならば実車挙動との相関の大きなクローズドループシミュレーションにする必要がある
- リリース時の意思決定がしやすい Metrics, Criteria にする必要がある。例えば、衝突率、レーン逸脱率などのクリティカルな誤出力を引っ掛けられる指標でなければならない
- 学習済みモデルを受け取り、評価結果、および、モデル出力の分析結果を出力する
モデル精度改善のためのフィードバックループ
DataOps, MLOps, ValidationOps を連携させ、継続的に精度が向上させるフィードバックループを回す必要がある。
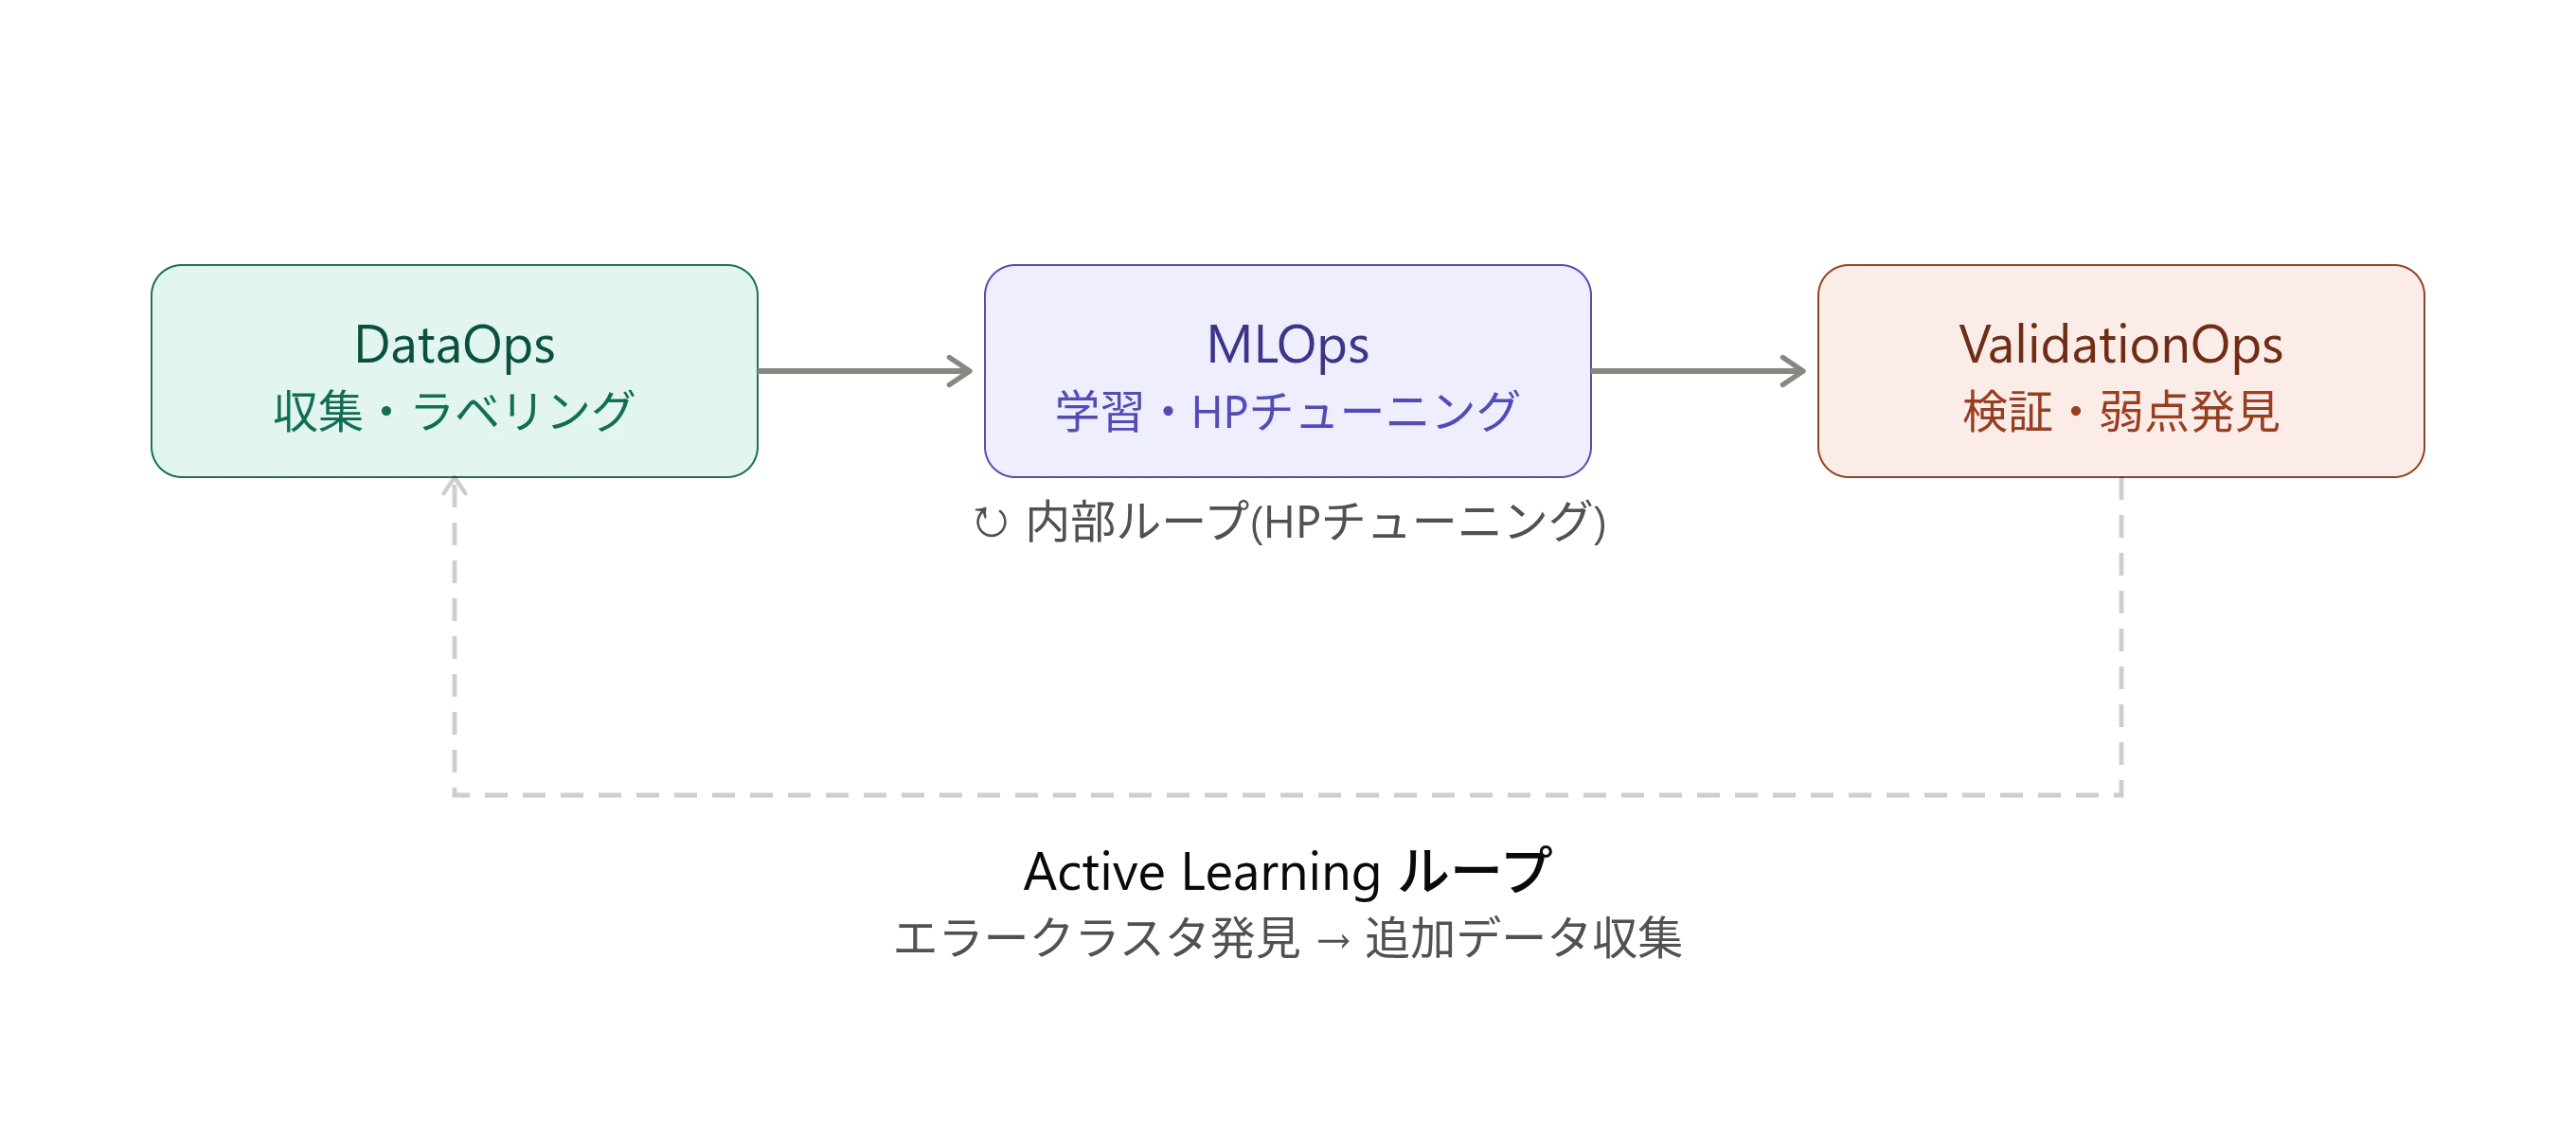
モデルの評価結果をものにデータセットの改善を行うアクティブラーニングのフローでは、ValidationOps評価出力結果を経てDataOpsに入力し、追加のデータを決定する必要がある。アクティブラーニングでは、モデルの弱点となるデータ集合(弱点クラスタ)探索する必要があるため、システム上そこが軽くなる必要がある。
具体的には以下のような実装が必要になる。
- ValidationOps: 一意のシーンIDに対してその評価値をテーブルで保持
- DataOps: 一意のシーンIDに対してそのメタデータ(タグやベクトル)をテーブルで保持
- これらを用いてエラーデータの偏りが最大になるクラスタを探す問題に落とす。最適な特徴量空間の探索が必要になるため、Pythonなどを用いて試行錯誤ができるような構成である必要がある
一方でMLOpsのハイパーパラメータチューニングはMLOpsコンポーネントに完結されるのが良いと考えられる。ハイパーパラメータチューニングは実験の試行回数が必要であるため、実機環境と同等の環境で思い評価をする必要のあるValidationOps は適していない。したがって、Train, Val の2つを使用して最適なパラメータをFixさせる。
まとめ
Microsoft AVOps をベースに DataOps に求められる性質や自動運転モデル開発におけるプラクティスをまとめました。具体的なソフトウェアの実装方法についての詳細には触れていないので、機会があれば別の記事でそれらについてまとめたいと思います。ご意見、ご指摘等ありましたら、コメントいただければと思います。
参考資料
- 実践DataOps、Harvinder Atwal 著、丸山大輔・松田和雄・關哲也 訳『実践DataOps』翔泳社、2024年
- Create an autonomous vehicle operations (AVOps) solution
https://learn.microsoft.com/en-us/industry/mobility/architecture/avops-architecture-content - DataOps for autonomous vehicle operations
https://learn.microsoft.com/en-us/industry/mobility/architecture/avops-architecture-content