
この記事について
この記事は、DataOpsシステムにおけるDBへの読み書きする部分の構成要素についての学習を目的とするものである。
想定読者は以下の通り。
-
Data管理システム(DataOpsシステム)を開発したいが各構成要素をどのように設計すればよいか学びたい人
-
DBの読み書きを行うコンポーネントをどのように設計すべきか知りたい人
なお、本記事は以下記事におけるデータパイプラインの Registration を詳しく深ぼったものであるため、DataOpsの全体像が知りたい場合は以下記事を参照するのが良い。
Data regisration コンポーネントに求められること
本章では Data regisration コンポーネントに必要な設計思想についてまとめる。具体的な記述選定に関しては次の章で触れる。
単一のデータアクセス窓口
最も重要な思想は、 DBへのアクセス経路を一つに絞ること である。DataOpsシステム全体では、以下のように複数のコンポーネントがDBにアクセスする。
- アップロード(Landing)されたデータのExtraction後のデータ登録
- データ処理 (Translation) により付与したメタデータの保存
- データ集計時の読み込み
これらの処理、コンポーネントがそれぞれ独自にDBへアクセスすると以下のような問題が発生する。
- スキーマ変更のたびに全コンポーネントを直さなければならない
- 認証情報(DBクレデンシャル)が各所に散らばる
- 論理削除やデフォルトフィルタのルールが実装ごとにブレる
- クエリの品質がコンポーネントごとにバラバラになる
DBに接続するコンポーネントを一つにし、他のコンポーネントはAPIとして、読み書きをそのコンポーネントに頼むことで上記の要素をすべて一箇所に集約することができる。スキーマの変更はAPI内に閉じ込められ、他のコンポーネントはAPIのインタフェースを見るだけでよくなる。
REST API とは
RESTは Representational State Transferという、Web (HTTP) の仕組みに沿ってAPIを設計するための「アーキテクチャスタイル」である。(プロトコルではない)核となるのは、
「操作したいデータ(=リソース)をURLで一意に表し、それに対する操作をHTTPメソッドで表現する」
というものである。RESTの求められる6つの制約は以下のとおりである。
- クライアント・サーバー分離 — UI と データ保存を分離し、それぞれ独立して進化できるようにする
- ステートレス — サーバーはクライアントの状態を保持しない。各リクエストは必要な情報をすべて自分で持つ(自己完結)
- キャッシュ可能 — レスポンスがキャッシュ可能かを明示し、通信を減らせるようにする
- 統一インターフェース — リソースの識別(URL)、標準メソッド(GET/POST/…)、自己記述的なメッセージで、一貫した予測可能な操作方法を提供する(RESTの中核)
- 階層化システム — 間にロードバランサやキャッシュ、ゲートウェイを挟んでもクライアントは気づかない
- コードオンデマンド(任意) — 必要に応じてサーバーがクライアントへコードを送れる
思想を一言でまとめると、「Web がすでに持っている仕組み(HTTP の意味論)を再発明せず、そのまま素直に使う」 ということである。URLには、getUser のように動詞は組み込まず、GETやPOSTなどのHTTPメソッドにどのような操作なのかを任せ、URLは操作の対象が何なのかだけを記述する。

RESTの思想に沿った場合の利点
- 予測可能性:/users/1 を見れば「ユーザーの1番」と誰でも分かる。ドキュメントを読まなくても他のリソース(/products/5 など)も類推できる
- スケーラビリティ:ステートレスなので、サーバーを増やしてもどのサーバーがリクエストを受けても処理できる(ロードバランスしやすい)
- キャッシュ効率:GET /users/1 は安全(副作用なし)と決まっているので、ブラウザや CDN が安心してキャッシュできる
- 標準ツールとの親和性:HTTP の仕組みに乗っているので、ブラウザ・プロキシ・監視ツールがそのまま活用できる
沿わない場合(RPC的・独自設計)の特徴
- エンドポイントごとに命名規則がバラバラになりやすく、getUser / fetchUserData / user_info などが混在してドキュメント依存が強くなる
- GET /deleteUser のように「取得するはずの GET」で削除してしまうと、キャッシュや事前読み込みで意図せずデータが消える危険がある
- サーバー側で状態を持つ設計になりがちで、スケールアウトが難しくなる
REST APIを使用した Data regisration 用コンポーネント
Data resisration 用のコンポーネントはAPIとして公開され、他のコンポーネントはこのインタフェースに従ってDBの読み書きを依頼するという構成であることが望ましい。REST APIはこれを実現する一つの手段である。
- クライアントは HTTP でサーバーにリソース操作を依頼するだけで、実際の DB 接続・SQL 発行はサーバー側が担う
- クライアントから見えるのは
/users/1のようなURLだけでありその裏がPostgreSQLなのかMySQLなのかは関係なくなる
具体例としてREST API化されたサーバーにPythonで記述されたクライアントからリクエストを投げる例を挙げる。
Python クライアント  ──HTTP(GET/POST/…)──▶  REST サーバー  ──SQL──▶  DB
        ▲                                                              │
        └──────────────  JSON レスポンス  ◀──────────────────────────┘
クライアント
DBを読む例
import requests

BASE_URL = "https://api.example.com"

def get_user(user_id: int) -> dict:
    # GET /users/1 → サーバーが DB から該当行を SELECT して JSON で返す
    resp = requests.get(f"{BASE_URL}/users/{user_id}", timeout=10)
    resp.raise_for_status()   # 4xx/5xx なら例外を投げる
    return resp.json()

user = get_user(1)
print(user)   # {'id': 1, 'name': 'Alice', 'email': 'alice@example.com'}
DBに書き込む例
def create_user(name: str, email: str) -> dict:
    # POST /users → サーバーが DB に INSERT し、作成された行を返す
    resp = requests.post(
        f"{BASE_URL}/users",
        json={"name": name, "email": email},
        timeout=10,
    )
    resp.raise_for_status()   # 成功時は通常 201 Created
    return resp.json()        # {'id': 42, 'name': 'Bob', ...}

def update_user(user_id: int, name: str, email: str) -> dict:
    # PUT /users/42 → サーバーが該当行を UPDATE
    resp = requests.put(
        f"{BASE_URL}/users/{user_id}",
        json={"name": name, "email": email},
        timeout=10,
    )
    resp.raise_for_status()
    return resp.json()

new_user = create_user("Bob", "bob@example.com")
update_user(new_user["id"], "Bob Smith", "bob.smith@example.com")
DBを削除する例
def delete_user(user_id: int) -> None:
    resp = requests.delete(f"{BASE_URL}/users/{user_id}", timeout=10)
    resp.raise_for_status()   # 成功時は 204 No Content が多い
注目すべきはいずれもSQLを一切書かず、HTTPメソッドを request ライブラリ経由で呼び出しているだけということである。このような設計にすることで、アクセスの方法を一元化することができる。
なお、pythonでアクセスする例をあげているが、もちろんcurlコマンドを使用することによってもアクセスできる。
サーバー側
では先程のようなアクセスを可能にするRESTサーバーを構築するにはどのようにする必要があるのか。ここでは2つの方法にふれる。
自分で作成
Python なら FastAPIとpsycopgを組み合わせることによってREST APIサーバーを構築することができる。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from psycopg_pool import ConnectionPool
from psycopg.rows import dict_row

app = FastAPI()

# コネクションプール(接続を使い回して高速化)
pool = ConnectionPool(
    "host=localhost dbname=mydb user=app password=secret",
    kwargs={"row_factory": dict_row},   # 結果を dict で受け取る
)

# 受け取るリクエストボディの型定義(バリデーション)
class UserIn(BaseModel):
    name: str
    email: str

# GET /users/1 → SELECT
@app.get("/users/{user_id}")
def get_user(user_id: int):
    with pool.connection() as conn:
        row = conn.execute(
            "SELECT id, name, email FROM users WHERE id = %s",
            (user_id,),          # ← プレースホルダで値を渡す(重要)
        ).fetchone()
    if row is None:
        raise HTTPException(status_code=404, detail="User not found")
    return row               # dict を返すと FastAPI が JSON 化

# GET /users?q=alice&limit=20 → 絞り込み SELECT
@app.get("/users")
def search_users(q: str | None = None, limit: int = 20):
    sql = "SELECT id, name, email FROM users"
    params: list = []
    if q:
        sql += " WHERE name ILIKE %s"
        params.append(f"%{q}%")
    sql += " LIMIT %s"
    params.append(limit)
    with pool.connection() as conn:
        return conn.execute(sql, params).fetchall()
例えば上記のように記述することによって GETメソッドを実装することができる。
自動でREST化
PostgRESTを使用すると上記のような APIエンドポイントを1行も書かずに用意することができる。
両者の使い分けの目安は、独自のビジネスロジック(入力チェック、複数テーブルにまたがる処理、外部サービス連携など)が必要なら自前実装、単純なテーブルの読み書きをすばやく公開したいだけならPostgRESTである。
契約(スキーマ)を成果物として共有
FastAPIによって定義されたRESTAPIは、返却の「型」が決まっているが、この型を理解して各コンポーネントはこのFastAPIサーバーに読み書きを依頼することになる。すると、各コンポーネントの開発者にAPIサーバーの型を共有することになるが、以下のような問題が生じることが考えられる。
- APIの仕様(= どのURLにどのメソッドをリクエストしたらどのようなデータが帰ってくるか) を理解してもらうためにドキュメントを作成する必要がある
- 仕様書のフォーマットが定まっていないとそれを他のコンポーネントからシステマチックに参照することができない
上記を解決するために、APIの仕様書のフォーマットの規格が決まっており、それがOpenAPIフォーマットである。
OpenAPIフォーマットが定められることにより、仕様書の規格が統一される。OpenAPIフォーマットの具体例は以下のとおりである。
{
  "openapi": "3.1.0",
  "info": { "title": "FastAPI", "version": "0.1.0" },
  "paths": {
    "/data_streams/{id}": {
      "get": {
        "summary": "Get Data Stream",
        "operationId": "get_data_stream_data_streams__id__get",
        "parameters": [
          {
            "name": "id",
            "in": "path",
            "required": true,
            "schema": { "type": "string", "title": "Id" }
          }
        ],
        "responses": {
          "200": {
            "description": "Successful Response",
            "content": {
              "application/json": {
                "schema": { "$ref": "#/components/schemas/DataStreamRead" }
              }
            }
          },
          "422": {
            "description": "Validation Error",
            "content": {
              "application/json": {
                "schema": { "$ref": "#/components/schemas/HTTPValidationError" }
              }
            }
          }
        }
      }
    },
    "/raw/{id}": {
      "get": {
        "summary": "Get Raw",
        "operationId": "get_raw_raw__id__get",
        "parameters": [
          {
            "name": "id",
            "in": "path",
            "required": true,
            "schema": { "type": "string", "title": "Id" }
          }
        ],
        "responses": {
          "200": {
            "description": "Successful Response",
            "content": {
              "application/json": { "schema": {} }
            }
          },
          "422": {
            "description": "Validation Error",
            "content": {
              "application/json": {
                "schema": { "$ref": "#/components/schemas/HTTPValidationError" }
              }
            }
          }
        }
      }
    }
  }
}
ポイントはどのURLにアクセスするとどのような型のデータが帰ってくるかがわかるという点である。
$ref で参照されていた型の本体は、components.schemas にまとまって定義されます。DataStreamRead の定義は次のようになる。
{
  "components": {
    "schemas": {
      "DataStreamRead": {
        "type": "object",
        "title": "DataStreamRead",
        "properties": {
          "external_id": { "type": "string", "title": "External Id" },
          "state": {
            "anyOf": [{ "type": "integer" }, { "type": "null" }],
            "title": "State"
          },
          "id": { "type": "string", "title": "Id" },
          "updated_at": {
            "anyOf": [{ "type": "string", "format": "date-time" }, { "type": "null" }],
            "title": "Updated At"
          }
        },
        "required": ["external_id", "id"]
      }
    }
  }
}
APIの仕様を更新するというシナリオを考える。一度ならまだしも、APIの仕様が変わるたびにドキュメントを作成するのは難しい。astAPIはOpenAPIフォーマットの仕様ファイルを自動エクスポートする機能 を有し、この課題を解決する。FastAPIはAPIエンドポイントを作成する際に responce_modelというAPIが返す型を Pydantic の型で指定する。app.openapi()というメソッドがそのPydanticの型を読み込み、OpenAPIフォーマットでエクスポートする。
DBスキーマ、Pydantic/SQLModel、OpenAPIスキーマの関係性は以下のとおりである。
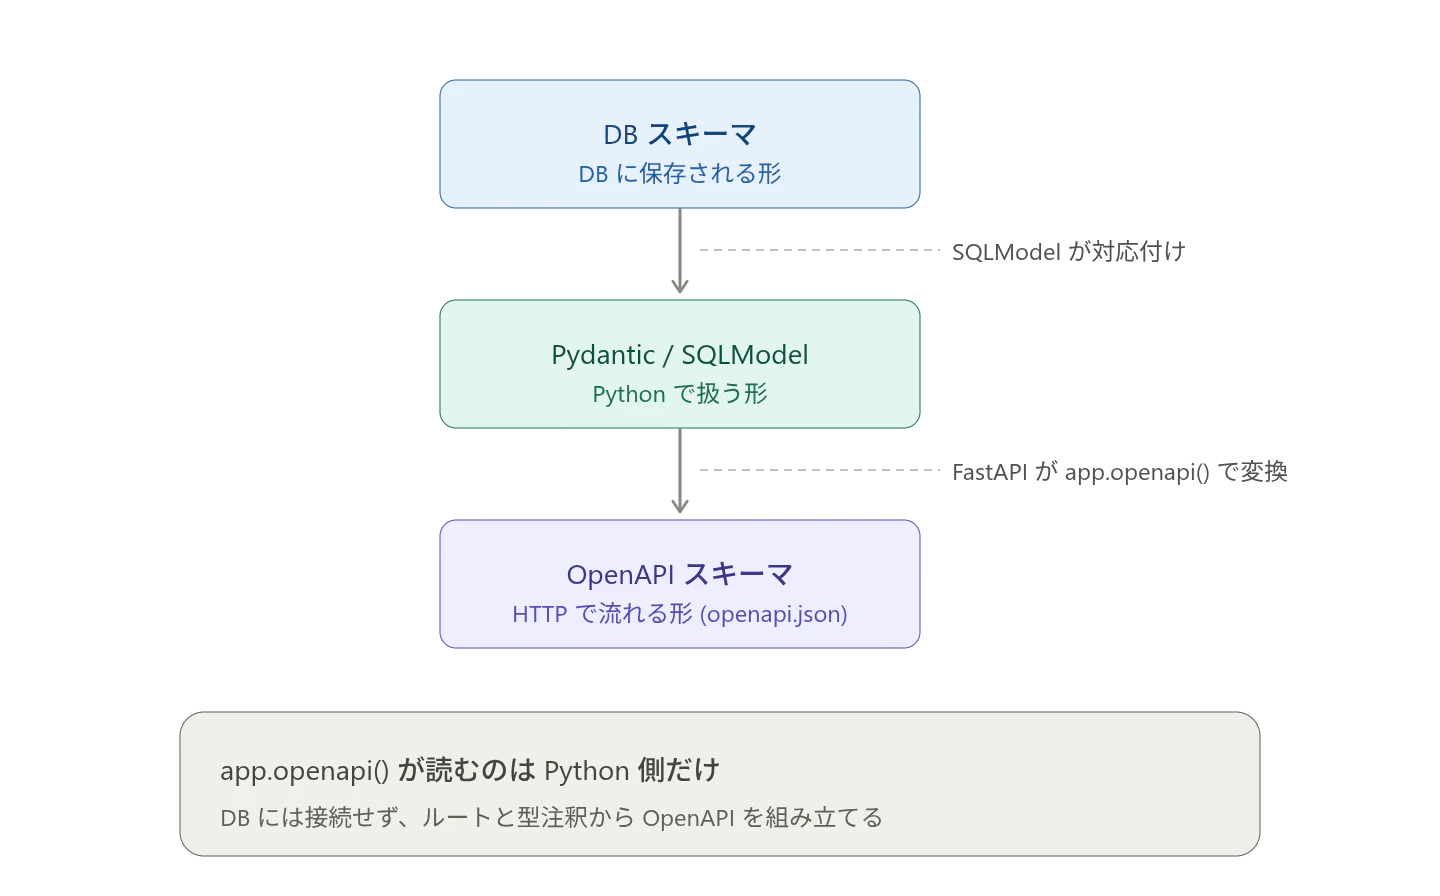
なお、SQLModelというのは、Pydanticの型定義機能と対応するテーブルを作成するSQLを生成する機能を併せ持つPythonライブラリである。
APIを使用するコンポーネントは、OpenAPIフォーマットを読み込むことによって、APIの仕様を理解し、それぞれ利用する。APIの仕様がアップデートされた場合、その都度OpenAPIフォーマットをエクスポートし、それを公開する。
ビルド/PR時のCI/CD
API仕様の更新を行う際に、以下のような課題に当たることがある。
- APIを使用するチームが事前に更新された後の仕様ファイルを入手したい
- API仕様の変更が破壊的変更でないかをデプロイ前にチェックしたい
上記要件を満たすためには、デプロイ前のビルド/PRの段階でAPIの仕様ファイル出力し、仕様を確認する必要がある。例えばPRを送る際に以下のような手順が必要になる。
-
app.openapi()から仕様書を生成 - 前バージョンとの差分を取る(
oasdiff,openapi-diffなどのツール) - 破壊的変更があればCIを落とす、あるいはレビュアーに警告する
この流れをCIに組み込む必要がある。
論理削除とバージョン管理を前提にする
メタデータ付与パイプラインによりデータのメタデータを付与するケースを考える。ここでいうメタデータとは、膨大な社内データが存在する際にそれを検索するための情報(タグ)をイメージすると良い。このタグを付与するシステムを継続的に運用していると以下のような問題が生じうる。
- どのデータに対してメタデータ付与を試みてどのデータには試みていないのかを調べる必要がある
- メタデータ付与ロジックをアップデートしたことによりすべてのデータにメタデータを付与しなおし、以前のロジックとの差分を取る必要がある
- 以前削除してしまったデータが後から必要になる
上記のような課題を解決するため、さまざまな状態を記録するためのテーブルを容易する必要がある。
必要とされるスキーマ
前述の課題を解決するためには、DBはそれぞれの処理、処理対象ごとに以下のような状態を保存できるテーブルを要する必要がある。メタデータ(=タグ付け)付与の例をあげて考える。
- 未処理: タグ付けを実効していない場合の状態
- 処理済み、かつ、利用可能: タグ付けを実施し、それが有効な状態
- 無効化: タグ付けを実効したが後から精度が壊滅的に悪いことがわかり使用しないようにしている状態
- 論理削除: 削除した行(ただし本当に消すのではなく削除フラグをつけるだけ)
- 物理削除: システムによってでなく手動でデータを削除したという状態
- 処理中: タグ付けパイプラインを付与している状態
バージョン管理
先程と同様にデータに対してメタデータ(タグ)を付与する例を考える。タグを付与するロジックをアップデートして、再度タグをつけ直すとした場合、以前のロジックとの差分情報が欲しくなることがある。そのような場合、タグの情報をロジックをバージョニングしつつ保存する必要がある。このような場合例えば、以下のようなテーブルを作成する必要がある。(なお、これが全てではなく最小構成で記述している)
タグ付けロジックテーブル
- id: ロジックid
- name: ロジック名
- tag_method_version: ロジックバージョン
- previous_version_id: 前バージョンのロジックid
タグ付け結果テーブル
- id: 結果id
- tag_method_id: ロジックid
- target_data_id: タグ付け対象データid
- state: 結果の状態
このようなテーブル構成で、先程の状態管理テーブルと合わせて以下のように使用する。
- ロジックアップデート
- ロジックテーブルをアップデート
- タグ付け実行
- 結果テーブルを参照し、親ロジックの結果があればそれを論理削除
- アップデートされたタグの状態を処理済み、かつ、利用可能にし保存
安全な再実行(冪等性)
DataOpsでは、大量データを定期的にクロール・処理するため、同じデータが何度も処理パイプラインに投入されることを想定して設計する必要がある。例えば、以下のような課題が生じうる。
- 15分に一回クラウド上のデータをスキャンしてDBに登録するが登録済みであるならば飛ばすという処理がないと同じデータを何重にも保存してしまう
- メタデータ付与パイプラインを新規追加データのみに実行したいのにも関わらずすべてのデータに実行してしまい費用がかさむ
- メタデータ付与パイプライン実行を途中で中断した場合、途中で以上終了してしまったデータに対して再度0から処理しないと、中断するたびに人がクエリを投げて掃除する必要が出てしまう
これらを防ぐため、DBは各データの各処理がどのくらいまで終わっているのかを保存し、DBを読み書きするコンポーネントはその情報を取得するためのAPIを容易する必要がある。
要求を満たすための技術選定の例
本章では、今まで述べてきた性質を満たすためには、どのような技術選定をするのが良いのかを例として挙げる。
なお、クラウド環境で動作することを想定し、AWSスタックを前提とする。
FastAPI
前述のようにスクリプトをAPI化できるライブラリ。
Aurora DSQL
AWSの分散データベース。
- PostgreSQL 互換:psql や既存の PostgreSQL エコシステム(ローカル開発では素の PostgreSQL)をそのまま使える。
- IAM 認証:DB パスワードの代わりに、有効期限付きの認証トークンを AWS の仕組みで発行する。クレデンシャルを埋め込まずに済む。
- サーバレス/分散:容量やスケーリングの管理負担が小さい。
ECS Farget + Private ALB
- ECS Fargate:常時起動する API サーバに向く。サーバ(EC2)の管理が不要なコンテナ実行基盤。データ登録APIは常に公開しておくことで深夜のデータ登録実行などにも対応できるようになる。
- Private ALB:社内資料のデータベースなどは、インターネットに公開する必要がない。プライベートサブネットに置くことでセキュリティを高めている。
Lambda
Landingされたデータをクローリングにより登録する処理などの定期実行、かつ、15分以内に終わる処理は、AWS Lambdaを使用する。
まとめ
- DataOpsにおいて必要なのはDB操作の口を一元化しAPIでラップすること
- APIスキーマは即時公開、共有、検証できる状態を保ち、データ登録APIを利用する側がスピーディーに更新に対応できるようにする必要がある