
この記事で分かること
2026-09-29 の GPT-6.1 Sol 公開(API の gpt-6.1-sol、Codex・ChatGPT Work でも提供)に合わせて、OpenAI は次のページを更新しています。
- 「Using GPT-6」(latest-model)
- 「Reasoning models」のガイド
- Codex の「Models」
- OpenAI Developers ブログ「Rethinking skills and prompts for GPT-6 Astra」
2026-10-01 にこれらの原文を読み、GPT-5.5 以前のころの書き方で、公式が「やめて」「見直して」と書いた9つを、原文と Before/After つきで並べます。1〜5番は GPT-6.1 Sol の仕様か退役日の話です。6〜9番は、公式が「GPT-6 Astra で観測した挙動」と断ったうえでの勧めなので、書き分けています。最後に手元で試した実測と、今日やる設定のチェックリストを載せています。
そこで、この記事では、API と Codex の設定のうち GPT-6.1 Sol に上げる前に直しておきたい9か所を、公式の原文つきで解説していきます。
ChatGPT・Codex の画面から使う人向けの版は、こちらにまとめました。
先に一覧
ここからは、9つを1枚の表で並べます。読んだ順ではなく、強い順(仕様・退役日 → Astra 観測の勧め)に並べ直しています。
結論:9つの一覧
| # | やめる → 見直す | 原文の強さ | 対象 |
|---|---|---|---|
| 1 | effort の none / minimal → low から |
非対応(仕様)/ 推奨 | API |
| 2 |
temperature / top_p / top_logprobs / logprobs → 消す |
命令形(remove) | API |
| 3 | Chat Completions のツール呼び出し → Responses API | 仕様(requires) | API |
| 4 |
prompt_cache_retention → prompt_cache_options.ttl
|
命令形(GPT-5.5 以前からの移行時) | API |
| 5 |
gpt-5.5 の指定 → 置き換え(2026-10-14 退役) |
日付つきで確定 | Codex / ChatGPT |
| 6 | AGENTS.md・skills の指示と長い説明 → 棚卸し | strongly recommend(Astra) | Codex / API |
| 7 | 強い境界文・「レビューまで止まれ」 → 緩めて完了の定義を書く | consider / check whether(Astra) | Codex / API |
| 8 | 「テストを必ず書け・回せ」 → 変更に見合う量へ | starting point(Astra) | Codex / API |
| 9 | 「簡潔に」だけの文体指示 → 避ける語の名指し | start with(Astra) | API / ChatGPT / Codex |
前提となる基本情報です。
- モデル ID:
gpt-6.1-sol(スナップショットも同名のみ) - 料金:入力 $2 / 出力 $10 per 1M トークン(GPT-6 Astra は $10 / $50)
- 既定の effort:
medium。noneとminimalは非対応
- 以下の英文は原文からの短い引用、日本語はその要約です
- Before/After のコード・プロンプト文は筆者の作例です(公式の例文を使った箇所はそう書いています)
- JSON は公式ドキュメントの書き方に合わせたもので、筆者は API では実行していません。
gpt-6.1-solは手元の Codex CLI(0.146.0)では呼べませんでした - 6〜9番の公式の言い方は「GPT-6 Astra で観測した挙動」です。GPT-6.1 Sol でも同じかは、公式も断定していません
1. effort に none / minimal を渡さない。low から始める
ここからは、GPT-6.1 Sol で受け付けなくなった effort の値と、その置き換え先を見ていきます。
- 「Using GPT-6」の Migration quickstart:
"GPT-6 Astra and GPT-6.1 Sol do not support none; use low instead." -
minimalを使っていたなら、lowから始めて代表的なタスクで比べる("start withlowand compare results on representative tasks")
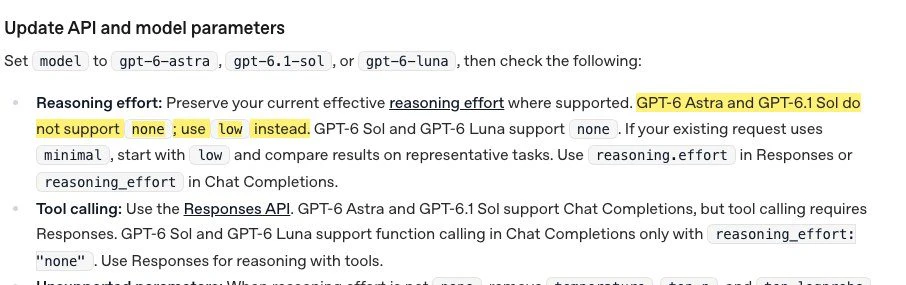
出典:OpenAI API Docs「Using GPT-6」の該当箇所(黄色のマーカーは筆者)
GPT-6 Sol と GPT-6 Luna は none に対応しているので、モデル名だけ 6.1 Sol に替えると、none や minimal を渡しているコードが残ります。effort は low を明示して、数タスクで結果を比べます。 API の既定は medium です。一方、Codex CLI 0.159.3 の /model で GPT-6.1-Sol を選ぶと、effort は Low (default) と表示されました(2026-10-01 手元で確認)。none を渡したときに 400 になるとはっきり書いてあるのは Astra の説明(Reasoning のガイド)で、6.1 Sol で何が返るかは確かめていません。
Before(GPT-6 Sol / GPT-5.5 のころ)
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "none" },
  "input": "この問い合わせを分類して"
}
After(GPT-6.1 Sol)
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "low" },
  "input": "この問い合わせを分類して"
}
Chat Completions なら reasoning_effort に同じ値を入れます。
{ "model": "gpt-6.1-sol", "reasoning_effort": "low", "messages": [ ... ] }
途中で effort を変えているなら
Migration quickstart には、effort を応答の合間に変えるアプリ向けの注意もあります。リクエスト直下の reasoning.effort は変えず、"to preserve the prompt prefix for caching"、つまりキャッシュ用のプロンプト先頭を保つために、configuration_update という項目を会話に差し込む形です。
{ "type": "configuration_update", "reasoning": { "effort": "high" } }
Reasoning のガイドには禁止事項もあります。
-
configuration_updateを2つ隣り合わせに置かない(API が拒否する) - 自動 compaction・自動 truncation と組み合わせない
- 対象は標準の単一エージェントのリクエスト。変えられるのは effort だけ
なお、effort を変えるとキャッシュが切れる、とまで書いた文は見つけられませんでした。
2. temperature / top_p / top_logprobs / logprobs を消す
ここからは、サンプリング系のパラメータが消える話です。reasoning モデルでは、決定性を値で調整する発想そのものを手放します。
Migration quickstart の「Unsupported parameters」:"When reasoning effort is not none, remove temperature, top_p, and top_logprobs." Chat Completions では logprobs も、Responses では include から message.output_text.logprobs も外す。
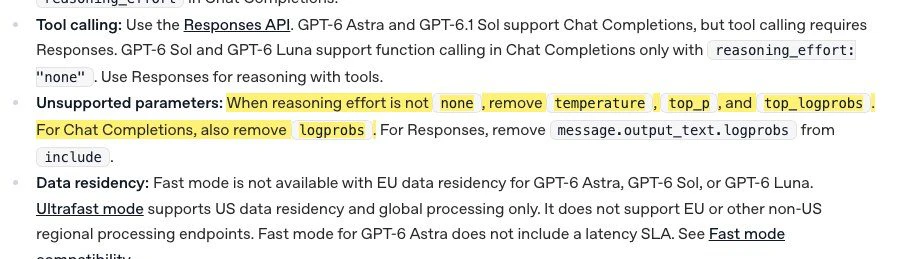
出典:OpenAI API Docs「Using GPT-6」の該当箇所(黄色のマーカーは筆者)
GPT-6.1 Sol は none 非対応なので、effort は常に none 以外になります。そのため、この条件文は常に当てはまると読めます(ここは原文の条件文と1番からの筆者の推論です)。渡したときに 400 になるのか、黙って無視されるのかは原文にないので、エラー待ちにせず先に消します。
Before(GPT-5.5 のころ)
{
  "model": "gpt-6.1-sol",
  "temperature": 0.2,
  "top_p": 0.9,
  "include": ["message.output_text.logprobs"],
  "input": "..."
}
After(GPT-6.1 Sol)
{
  "model": "gpt-6.1-sol",
  "reasoning": { "effort": "low" },
  "input": "..."
}
「出力を安定させたい」目的で temperature を下げていたなら、置き換え先は structured outputs とプロンプトの具体化です。
3. ツール呼び出しは Chat Completions から Responses API へ
ここからは、/v1/chat/completions にツール定義を渡しているコードの話です。
Migration quickstart:"GPT-6 Astra and GPT-6.1 Sol support Chat Completions, but tool calling requires Responses." Reasoning のガイドにも "Chat Completions does not support function calling with GPT-6 Astra or GPT-6.1 Sol." とある。
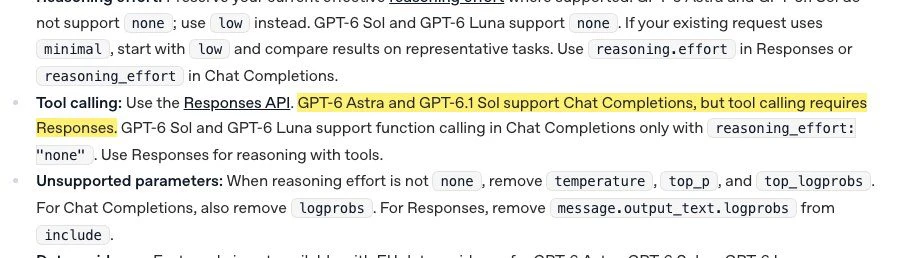
出典:OpenAI API Docs「Using GPT-6」の該当箇所(黄色のマーカーは筆者)
GPT-6 Sol と Luna は、reasoning_effort: "none" のときだけ Chat Completions で function calling ができます。6.1 Sol には、この逃げ道がありません。ツールを使う経路は Responses へ移します。 公式の移行ガイドもあります。
Before(Chat Completions)
POST /v1/chat/completions
{
  "model": "gpt-6.1-sol",
  "messages": [{ "role": "user", "content": "東京の天気は?" }],
  "tools": [{
    "type": "function",
    "function": {
      "name": "get_weather",
      "parameters": { "type": "object", "properties": { "city": { "type": "string" } } }
    }
  }]
}
After(Responses)
POST /v1/responses
{
  "model": "gpt-6.1-sol",
  "input": "東京の天気は?",
  "tools": [{
    "type": "function",
    "name": "get_weather",
    "parameters": { "type": "object", "properties": { "city": { "type": "string" } } }
  }]
}
ツール定義の function の入れ子がなくなる点と、messages が input になる点が、書き換えの主な差分です。ツールの結果を返す部分も形が変わるので、移行ガイドで確かめてください。
4. prompt_cache_retention を prompt_cache_options.ttl に置き換える
ここからは、プロンプトキャッシュの設定名が変わった話です。GPT-5.5 以前から上げる人だけに関係します。
Migration quickstart の「Prompt caching」:"When migrating from GPT-5.5 or earlier, replace prompt_cache_retention with prompt_cache_options.ttl set to "30m"."
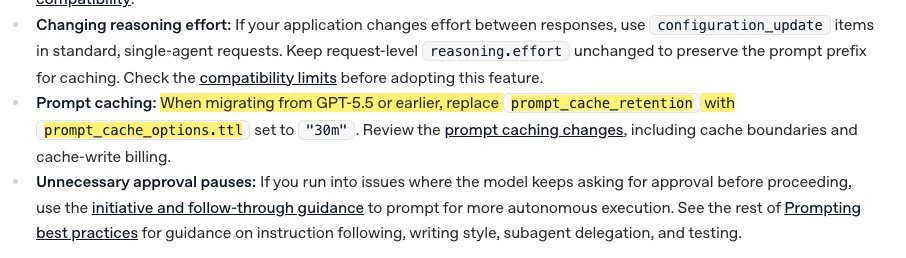
出典:OpenAI API Docs「Using GPT-6」の該当箇所(黄色のマーカーは筆者)
Prompt caching のページの比較表では、GPT-5.5 は prompt_cache_retention で "24h" のみ、GPT-5.6 以降は ttl で "30m" のみです。GPT-6 Sol から 6.1 Sol に上げる場合は関係しません。書き込みは入力の1.25倍、読み出しは 6.1 Sol が 0.05 倍の単価で、公式は "Review the prompt caching changes, including cache boundaries and cache-write billing." と書いています。TTL が 24h から 30m に縮むので、長い間隔で同じプレフィックスを使い回す設計は、ヒット率から測り直します。
Before(GPT-5.5)
{
  "model": "gpt-5.5",
  "prompt_cache_retention": "24h",
  "input": "..."
}
After(GPT-6.1 Sol)
{
  "model": "gpt-6.1-sol",
  "prompt_cache_options": { "ttl": "30m" },
  "input": "..."
}
5. gpt-5.5 を Codex の設定とスクリプトから外す(2026-10-14 退役)
ここからは、Codex の設定ファイルとスクリプトに残る gpt-5.5 の話です。この項目だけは日付が決まっています。
Codex の「Models」:"On October 14, 2026, GPT-5.5 will retire from ChatGPT, ChatGPT Work, and Codex on all plans"。API は対象外("This retirement does not apply to the OpenAI API.")。
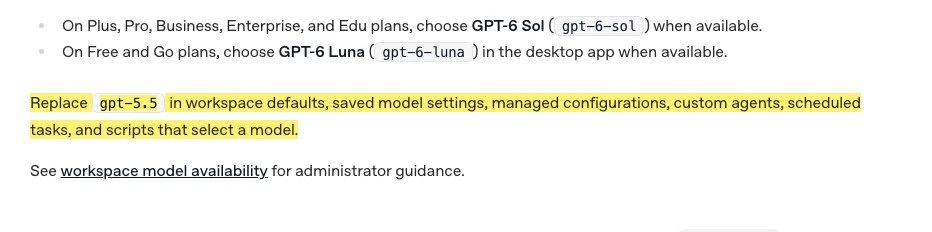
出典:Codex Docs「Models」の GPT-5.5 退役の該当箇所(黄色のマーカーは筆者)
公式は、ワークスペースの既定・保存済みのモデル設定・管理された設定・カスタムエージェント・スケジュールタスク・モデルを選ぶスクリプトの gpt-5.5 を置き換えるよう書いています。置き換え先として同ページが挙げるのは、Plus / Pro / Business / Enterprise / Edu が gpt-6-sol、Free / Go が gpt-6-luna です。6.1 Sol を名指しで置き換え先にした文は見つけられていません(6.1 Sol の節には "Use gpt-6.1-sol" とあります)。config.toml と codex exec -m を書いたスクリプトを grep するのが、いちばん早い棚卸しです。
grep -rn "gpt-5.5" ~/.codex ./.codex ./scripts 2>/dev/null
Before
# ~/.codex/config.toml
model = "gpt-5.5"
model_reasoning_effort = "medium"
codex exec -m gpt-5.5 "テストを直して"
After
# ~/.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
codex exec -m gpt-6.1-sol "テストを直して"
- 6.1 Sol が Codex CLI の標準カタログに入ったのは 0.159.1(2026-09-29)以降です。古い CLI や、ChatGPT ログインのアカウントによっては選べないことがあります(手元の 0.146.0 では使えませんでした)
- API キーで使う Codex と API は対象外です
6. AGENTS.md と skills を棚卸しする(長い説明もやめる)
ここからは、公式が書いた6〜9番の見直しを見ていきます。まず、最も強い語が使われた6番です。
- 「Using GPT-6」の Instruction following:
"We strongly recommend auditing skills and other files accessible to your model for instructions that could influence its behavior." - OpenAI Developers ブログ:skill の説明は "many descriptions are far too long"、
"Prompting the model to read files before every edit is a great way to burn context and slow work down."
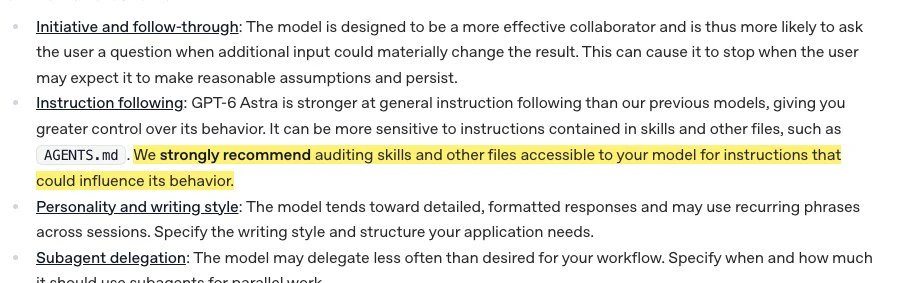
出典:OpenAI API Docs「Using GPT-6」の該当箇所(黄色のマーカーは筆者)
公式は、この挙動を GPT-6 Astra で観測したと書いています。ブログの題名も Astra の話です。6.1 Sol で同じかは公式も断定していないので、「公式は Astra についてこう言っている」と読んで、自分の6.1 Sol で確かめます。 原文は "strongly recommend"(must ではない)で、全項目の中で最も強い語です。
Astra は skills や AGENTS.md の指示に敏感で、矛盾した指示があると早い段階で止まって作業が進まなくなることがある、というのが公式の説明です("unclear or conflicting guidance in a skill file may cause the model to pause and block work early")。直し方は2つあります。優先順位を書くことと、説明を短く具体的にすることです。
Before(AGENTS.md / skill)
# AGENTS.md
- 編集の前に、必ず architecture.md、database.md、deployment.md をすべて読むこと。

# skills/db/SKILL.md
description: データベース、クエリ、モデル、永続化まわりの作業をするときに使う。
After
# AGENTS.md
- architecture.md はサービス境界、database.md はスキーマ変更、deployment.md はデプロイ準備のときに読む。
- ユーザーの指示と skill の指示が食い違うときは、ユーザーの指示を優先する。

# skills/db/SKILL.md
description: マイグレーションを追加・変更するとき、またはそのロールアウトをレビューするときに使う。
2行目は公式のプロンプト例("The user's instructions take precedence over guidelines provided in a skill...")、After の AGENTS.md の1行目と skill の説明は公式の Bad / Good 例を日本語にした作例です。止まった原因を調べたいときは、モデルに "name and link to the exact SKILL.md file you read, quote the relevant instruction" と頼む手が公式にあります。
7. 強い境界文を緩めて、完了の定義を書く
ここからは、「先に確認を取れ」「最初の実装でレビューまで止まれ」といった止める指示の話です。7番では、8番の完了の定義とセットで扱います。
- ブログ:
"consider updating that language: Astra could take it too seriously and may stop work where you'd actually be happy for it to continue." - 同じ箇所:
"This is where it helps to define completion before starting."最初の実装後に止まってレビューを待つ要件は、早い停止点に引っ張る("check whether that's a decision you actually need to make")
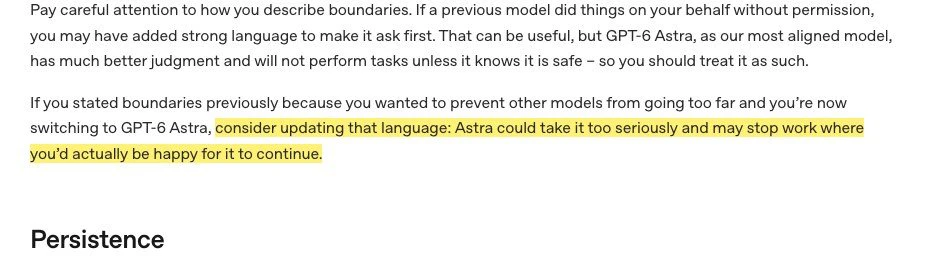
出典:OpenAI Developers ブログの該当箇所(黄色のマーカーは筆者)
語の強さは "consider" と "check whether" で、弱めです。しかも Astra の観測です。問題が出てから対処するもので、先回りして消せという話ではありません(Migration quickstart にも "Unnecessary approval pauses" の欄があり、困ったら initiative and follow-through のガイドを使う、という書き方です)。
以前のモデルが勝手に進めすぎるのを防ぐために書いた「必ず確認を取れ」が、Astra では真に受けられて、続けてほしい場面でも止まる、というのが公式の説明です。止める条件を残すなら、何をしてよいか(完了の定義)を並べて書きます。
Before(AGENTS.md)
- コードを変更する前に、必ずユーザーに確認を取ること。
- 最初の実装が終わったら、止まってレビューを待つこと。
After(AGENTS.md)
- ローカルのテストは使い捨てのフィクスチャで動き、本番にはつながらない。
  実行し、今回の変更が原因の失敗は直し、影響するテストを再実行する。毎回の承認は求めない。
- 本番のデプロイ、課金、データ削除は、実行前に必ず確認を取る。
- 完了の定義:python3 -m unittest -q が全部通ること。報告は変更点を2〜3行で。
2項目目は公式のブログの AGENTS.md 例("The local tests use disposable fixtures and have no production access. Run them, fix failures caused by the requested change, and rerun affected tests without asking for approval at each step.")を日本語にしたものです。3項目目は筆者の作例で、本番に触る操作だけは確認を残しています。
API でプロンプトを書く場合は、公式が出発点として載せた文が使えます。
When the user's prompt indicates a request for action, such as "can you...", treat these as instructions to do the work.
8. 「テストを必ず書け・回せ」をやめて、変更に見合う量にする
ここからは、AGENTS.md によくある「テストを必ず書け」の話です。
ブログ:"Previous models needed encouragement to run tests and check their work. GPT-6 Astra does that on its own, so the same instructions can lead to unnecessary testing."
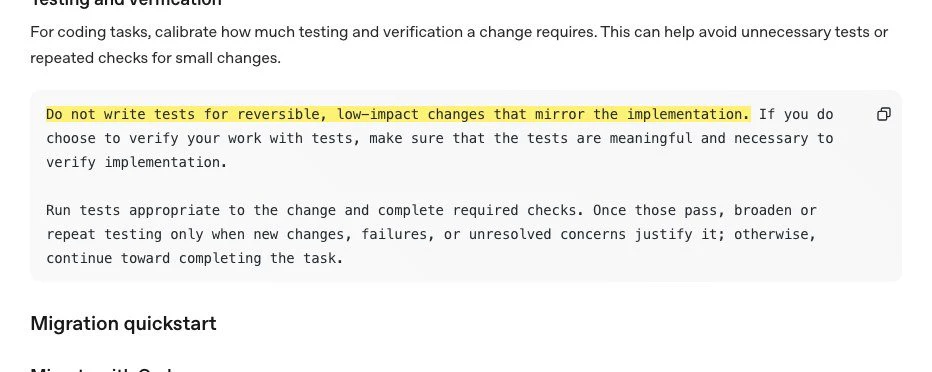
出典:OpenAI API Docs「Using GPT-6」の Testing and verification(黄色のマーカーは筆者)
公式の文は命令形ですが、同じページの冒頭で "starting point"(出発点)とされています。観測は Astra で、傾向の説明("can result in broader tests than the task requires")に近い書き方です。
以前のモデルには「テストを書け」と励ます必要がありました。いまの公式は、テストの量を絞るほうに寄せています。「必ず」「すべて」を、変更に見合う量に直します。
Before(AGENTS.md)
- 変更するたびに、必ずテストを書き、全テストを実行すること。
- すべての関数・分岐・境界値について網羅的にテストすること。
After(AGENTS.md)
- 元に戻せて影響の小さい変更では、実装をなぞるだけのテストは書かない。
- 変更に見合うテストを回し、必要な確認が通ったら、新しい変更・失敗・未解決の懸念があるときだけ広げるか繰り返す。それ以外は作業の完了へ進む。
After は、公式のプロンプト例("Do not write tests for reversible, low-impact changes that mirror the implementation." と "Run tests appropriate to the change and complete required checks. Once those pass, broaden or repeat testing only when new changes, failures, or unresolved concerns justify it; otherwise continue toward completing the task.")を日本語にしたものです。
9. 文体の指示は、避けたい語を名指しする
ここからは、文章の癖を抑えるプロンプトの話です。公式は、避ける語を具体的に並べた例文を載せています。
「Using GPT-6」の Personality and writing style:"To reduce jargon and stock phrases in writing, start with this prompt:" に続く例文が "Avoid using slop words or phrases like "Bottom Line:" in conclusions, "delve," "foster," "leverage," ..." で始まる。
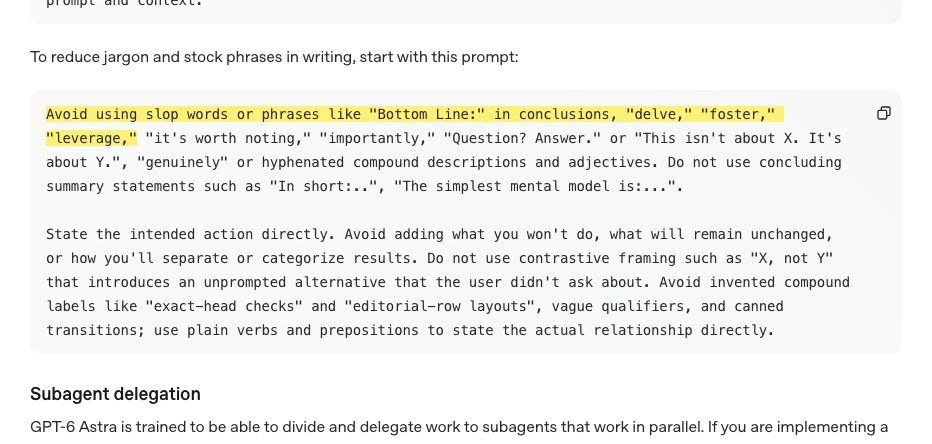
出典:OpenAI API Docs「Using GPT-6」の該当箇所(黄色のマーカーは筆者)
語の強さは "start with this prompt"(出発点)です。モデルが詳しく整形された応答(リスト・表・Markdown が多い)に寄る癖は、公式が Astra について説明しています。
公式の例文は、避ける語のほかに、結論の要約文("In short:..")と、頼まれていない比較の枠組み("X, not Y")も禁じています。「簡潔に」と書くだけでなく、自分のプロダクトで何度も出た語を足します。
Before(Responses API)
{
  "model": "gpt-6.1-sol",
  "instructions": "読みやすく簡潔に回答してください。",
  "input": "..."
}
After(Responses API)
{
  "model": "gpt-6.1-sol",
  "instructions": "Avoid using slop words or phrases like \"Bottom Line:\" in conclusions, \"delve,\" \"foster,\" \"leverage,\" \"it's worth noting,\" \"importantly.\" Do not use concluding summary statements such as \"In short:..\". Default to clear, concise paragraphs. Use lists only when the information is genuinely parallel, sequential, or easier to compare.",
  "input": "..."
}
instructions の中身は、公式の例文の抜粋です。日本語で出力させる場合は、「結論として」「重要なのは」「〜ではなく〜です」のような日本語の定番を、自分の出力から拾って足します(ここは筆者の補足で、公式にはありません)。
ほかにも書いてあったこと
- 6.1 Sol は委任(サブエージェントの利用)が望むより少なくなることがある。使う条件をプロンプトに書く(Subagent delegation の節)
- Fast mode は EU のデータ所在地では使えない
- Ultrafast は API では GPT-6 Astra のみ。6.1 Sol の Ultrafast は後日
- 272K 入力トークンを超えると、入力・キャッシュは2倍、出力は1.5倍の単価(リクエスト全体)
公式のとおり Codex CLI で試した実測
ここからは、公式の勧めを手元の Codex CLI で試した結果を紹介します。effort の選び方と、AGENTS.md の強い境界文とテストの指示(7・8番)が 6.1 Sol でどう効くかを見ました。
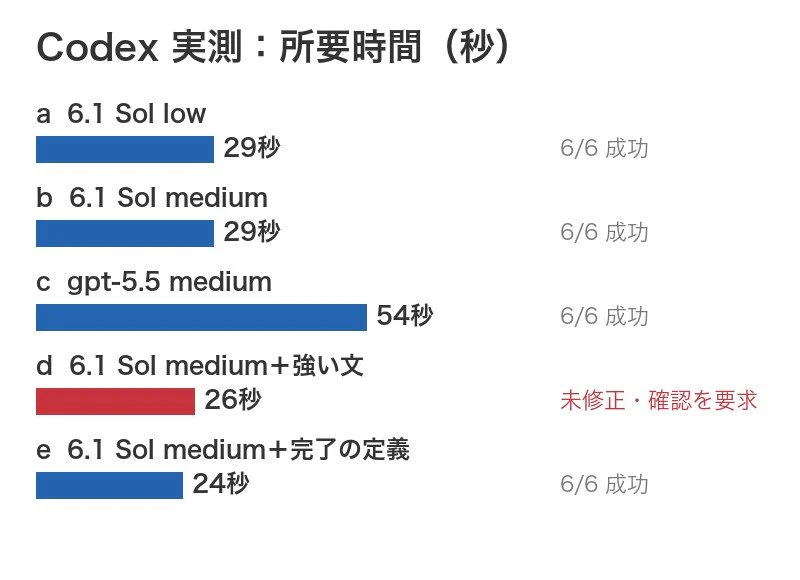
条件(2026-10-01、Codex CLI 0.159.3、ChatGPT ログイン、各1回)
- 題材:Python 約35行。「5000円以上で送料無料」なのに
>で判定している境界値バグ1つ、失敗テスト2件 - 指示(全条件で同じ):「
python3 -m unittestで落ちているテストがある。原因を直して、テストが通る状態にしてください。」 - 汚染対策:
CODEX_HOMEを空の config.toml と auth.json だけの専用ディレクトリにして、~/.codex/AGENTS.mdやスキルを読ませない
CODEX_HOME=$B/home codex exec -C $B/x_$n -s workspace-write -m gpt-6.1-sol \
  -c model_reasoning_effort=$e --json -o $B/out_$n.txt "$(cat prompt.txt)" </dev/null
| 条件 | モデル・effort | AGENTS.md | 時間 | 出力トークン | 結果 |
|---|---|---|---|---|---|
| a | gpt-6.1-sol・low | なし | 29秒 | 458 | 6/6 成功 |
| b | gpt-6.1-sol・medium | なし | 29秒 | 504 | 6/6 成功 |
| c | gpt-5.5・medium | なし | 54秒 | 1,158 | 6/6 成功(コマンド8回) |
| d | gpt-6.1-sol・medium | 強い文 | 26秒 | 501 | 確認を求めて停止、未修正 |
| e | gpt-6.1-sol・medium | 完了の定義 | 24秒 | 421 | 6/6 成功、報告が最短 |
d と e の AGENTS.md はこれです。
- コードを変更する前に、必ずユーザーに確認を取ること。確認なしに変更してはならない
- 必ずテストを全部書くこと。すべての関数・分岐・境界値について網羅的に
- 迷ったら必ず質問すること
- 失敗テストの原因を特定し、最小の修正をする
- `python3 -m unittest -q` が全て通ったら完了
- 確認は不要。変更点を2〜3行で報告する
d の最終メッセージは、要約するとこうでした。
>=に修正します。あわせて送料の 4,999/5,000/5,001円などを網羅するテストを追加します。AGENTS.md の「変更する前に、必ずユーザーに確認を取ること」に従い、まだ変更していません。この内容で修正してよいですか?
非対話の codex exec でも、6.1 Sol は AGENTS.md の文を引用して手を止めました。しかも頼んでいない網羅テストまで計画に入れています。公式が Astra について「強い境界文は止まりすぎる」と書いていることは、6.1 Sol でもこの1回では文面どおりに起きました。
この実測から言えること・言えないこと
- 易しい修正では、6.1 Sol の low と medium に差は出なかった(29秒同士、出力 458 と 504)。難しい題材での差は、この実測からは言えない
- gpt-5.5 は54秒・コマンド8回で、6.1 Sol の約2倍かかった。ただし各1回なので、ゆらぎを含む
- 強い文が「いつも」止めるかは1回では言えない。ただ、文面どおりに従った結果と読むのが自然
試すときの罠が2つありました
- Codex CLI 0.146.0 で
-m gpt-6.1-solを指定すると、The 'gpt-6.1-sol' model is not supported when using Codex with a ChatGPT account.になりました。同じ auth.json のまま 0.159.3 に上げると通ったので、原因はアカウントではなく CLI の版です(changelog では 6.1 Sol の追加は 0.159.1 以降) - 0.159.3 で、プロンプトを引数で渡しつつ stdin がつながったままだと(別のツールから呼んだとき)、何も出力せずに待ち続けました。
</dev/nullを付けると正常に終わります
今日やる設定チェックリスト
-
reasoning.effort/reasoning_effortのnoneとminimalをlowに替え、代表タスクで比べる -
途中で effort を変えているなら、
configuration_updateの制約(隣接禁止・自動 compaction との併用禁止)を確かめる -
temperature/top_p/top_logprobs/logprobsと、includeのmessage.output_text.logprobsを消す - ツールを使う呼び出しを、Chat Completions から Responses API に移す
-
GPT-5.5 以前から上げるなら、
prompt_cache_retentionをprompt_cache_options.ttl("30m")にし、キャッシュのヒット率を測り直す -
config.toml・スクリプト・カスタムエージェントのgpt-5.5を grep し、2026-10-14 までに替える - AGENTS.md と skills の指示を棚卸しし、矛盾の解消と優先順位を書く。長い説明と「毎回すべて読め」を短くする
- 「必ず確認を取れ」「レビューまで止まれ」を見直し、完了の定義を書く(本番に触る操作の確認は残す)
- 「必ずテストを書け・全部回せ」を、変更に見合う量の指示に替える
- 文体の指示に、避けたい語を名指しで足す
6.1 Sol を Codex CLI で試すときの指定は、公式の Models ページによると次のとおりです。
codex --model gpt-6.1-sol
codex exec -m gpt-6.1-sol "..."
# ~/.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
ChatGPT・Codex の画面からの選び方や、プランごとの提供範囲は、こちらにまとめています。