
GCP基盤のOSSに組み込んだ、AIが生成したコードの品質管理の仕組みです。後付け後付けでごちゃっとしてきたので(頭のなかが)整理してすっきりしました。コーディングからデプロイまでの品質がどう保証され、どう改善されていくかを整理したドキュメントです。
(2026.09追記)設計思想(層の責任分界、判例の二層、eval の構造的強制、人間判断の位置)を反映したOSSを作成しました。詳細は記事最下部です。
(2026.10追記)憲法ファイルを .clinerules → AGENTS.md に改名しました。本文の表記も置き換えています。
全体構造
Layer0では設計書を見てAIが開発します。以前はプレコミットのところで別のAIに検証させて、AI同士でわーわー話あってて可愛かったのですが、AIだけに検証させるのはコスト(お金と時間)的に効率が悪いので、Layer2で客観的な基準でチェックできるものはそちらでチェックしてもらって、そのあと別のAIに検証させる方式に切り替えました。AI同士の言い合いは、かわいかったので残念だけど。
Layer 2 の詳細:何を根拠に判定しているか
A,B,C,Eは外部標準にのっとってチェックし、Dはプロジェクト固有の判断をします。FはLLMが学習している「業界標準のコード品質パターン」を根拠にチェックしてくれる外部SaaSです。
| レイヤー | 根拠 | 判定主体 |
|---|---|---|
| A(gitleaks) | gitleaks公式デフォルトルールセット | OSSコミュニティ |
| B(Checkov) | CIS Google Cloud Platform Foundation Benchmark | CIS(国際標準団体) |
| C(terraform plan) | Terraform エンジンの差分計算 | HashiCorp |
| D(Gemini) |
AGENTS.md(憲法)+ logs/active_rules.md(判例) |
プロジェクト設計 |
| E(CodeQL) | GitHub公式セキュリティクエリ | GitHub Security Lab |
| F(CodeRabbit) | LLMが学習した業界標準 | CodeRabbit(外部SaaS) |
フィードバックループ
Layer 0(Claude Code)
Layer 0 は「AIにコードを書いてもらうフェーズ」。Claude Code に移ってからは永続化のメカニズムが3つに分業されました。
| 仕組み | 役割 | 共有範囲 |
|---|---|---|
CLAUDE.md / AGENTS.md |
設計思想と運用ルールの正典 | Git管理・全員共有 |
| Stop hook |
.tf 変更ターンで terraform validate を自動実行(構文エラーを次レイヤーに送らない) |
リポジトリ設定 |
| auto-memory | 個人の作業習慣・好みを Claude Code が自動で記憶 | マシンローカル |
writer(Claude Code)は CLAUDE.md を読んでコードを書きます。CLAUDE.md は @AGENTS.md で正典を取り込んでいるので、reviewer(Gemini)と writer は同じ設計思想を見ています(二段レビューの独立性は「別モデル+強制ゲート」で担保)。
特性: writer 自身が即座に自己検証するループ。構文レベルのエラーは自レイヤーで潰してLayer 1/2 に送らない。
Cline時代の「申し送りノート」(logs/ai-notes.md) はどうしたか
Cline時代はセッションをまたいで記憶が持てなかったのでlogs/ai-notes.md に人間が「次のセッションでこれ読んで」と申し送りを書いていました。Claude Code に移ってからは
-
設計思想やルールの更新 →
CLAUDE.md/AGENTS.mdに書く(writer が次回から読む) -
人間判断の判例 →
judgments.mdに書く(reviewer の D 側ループに合流) - 個人の作業習慣 → auto-memory が自動で覚える
の3経路に分業されたためai-notes.md は役割を終えました。既存エントリは適切なファイルに振り分けて廃止予定しました。
Layer 2 D(Gemini)
PRのたびに自動でファイルを読むため、ファイルを更新するだけでループが回ります。logs/judgments.mdは人間が判断したことをログとして残していてAIは読まない。(長くなる一方なので)logs/active_rules.mdはAIが判断に使うもので、同じトピックスに関しては上書きし、コンパクトさを意識。
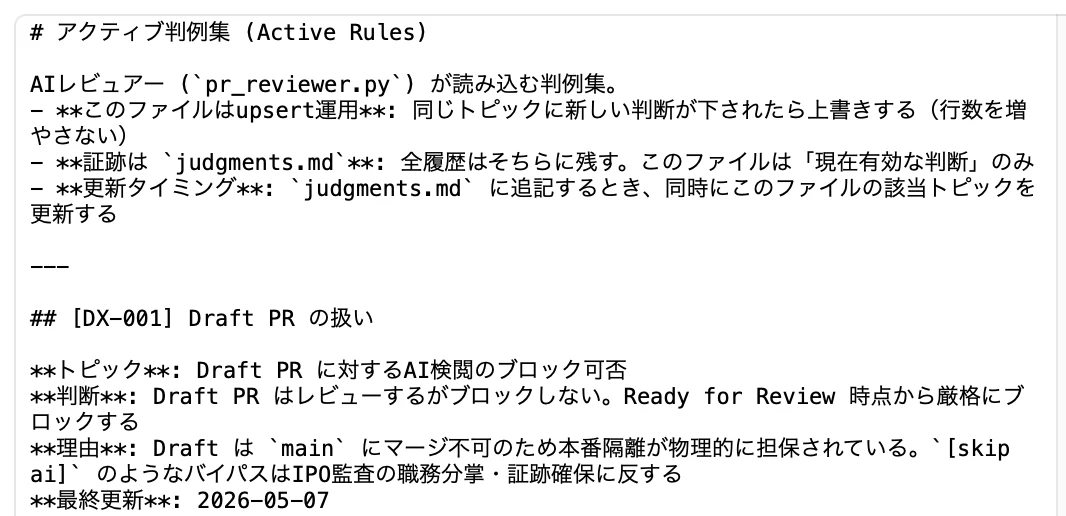
特性: 判例が積み重なるほど精度が上がる。人間の介入は「判断を書く」だけでOK。判定に関わる判例は試験問題(後述のeval)にもしておくと、同じ判定ミスの再発を機械が見張ってくれる。
Layer 2 D の精度は誰が保証するのか(eval / promptfoo)
Dの判例ループは「判例が積めば精度が上がる」と書きましたが、よく考えると「上がったかどうか、誰が確認してるの?」という問題が残ってました。AIにレビューさせているのに、そのAI自身の精度は誰も測っていない状態。
そこで promptfoo(OSS・MIT・サインアップ不要)で AIレビュアー用の模擬試験(eval) を作りました。合格にすべきdiff/不合格にすべきdiff(プロンプトインジェクションを仕込んだ意地悪問題も含む)をゴールデンセットとして evals/cases/ に置いて、検閲官に解かせて答え合わせします。
ポイントは3つ。
-
本番と同一のプロンプトをテストする: 検閲官のプロンプトを
prompts/reviewer_prompt.txtに外出しして、本番(pr_reviewer.py)と eval が同じファイルを読む。「evalは通るけど本番は別物でした」という形骸化が構造的に起きない。ついでにプロンプト自体も「審査基準の一部」としてAGENTS.mdと同じく PR の base コミットから読む(プロンプトを骨抜きにするPRを、骨抜き前のプロンプトで検閲する) -
採点はただの文字列一致: 合否は
RESULT: PASS / FAILの決定的マッチなので、採点用のAI(LLM-as-a-judge)は不要。コストはテスト対象のGemini呼び出し分の従量課金だけ(1回数円・30秒くらい) -
CIで強制: 検閲基準(
AGENTS.md・判例・プロンプト・evals)を変えるPRでは、CIがevalを自動実行して全問正解しないとマージできない。「手で回し忘れる」が構造的に消えた。無関係なPRでは走らないので、モデル側の一時障害が全PRを巻き込むこともない
特性: 「AIレビュアーのインジェクション耐性・判定精度」が、設計上の主張から回帰テストされ続ける主張に変わった。判例がそのまま正解データになるので、判例が増えるほど試験が厳しくなる。
Layer 2 F(CodeRabbit)
Dと同じくPRのたびに自動レビューが走るけど、Fは外部SaaSなので「ルールを覚えさせる」ことはできない。代わりに .coderabbit.yaml の path_instructions で「どこを・どの観点で見てもらうか」を絞り込む方式で精度を上げます。設定はGit管理下なので監査可能。判例の起点は D と共通の judgments.md。
特性: D が「ルールを覚える」のに対し、F は「観点を絞る」方向で精度が上がる。Fで対処できない判定は D に引き取る逃げ道がある。
チェック基準によるチェックの性質の違いとフィードバックの方向性の非対称性
A・B・C・E は外部標準に乗っているので「取りこぼし」は基本的に標準側の限界。Dはプロンプト・CLAUDE.md の書き方・active_rules.md の判例の充実度、すべてが精度に直結します。つまり D の取りこぼしは「判例が足りなかった」か「プロンプトの指示が曖昧だった」 が原因になる。そしてEが変わってるのは、判定基準は外部標準でありながら、CodeQLが見つけてくれたバグのパターンを、D(Gemini)の判例(active_rules.md)に人間が書き写して、Gemini側をどんどん賢くしていける点です! Fは判定の根拠は外部標準なので変えられないけど、観点・粒度・対象範囲は .coderabbit.yaml で細かく調整可能。
A の取りこぼし → .gitleaks.toml を見直す(allowlistが広すぎないか)
B の取りこぼし → .checkov.yaml の skip-check を見直す + judgments.md に記録
C の取りこぼし → plan レビューのプロセス(人間側)を見直す
D の取りこぼし → judgments.md に判例追加 → active_rules.md 更新
                  → 次のPRから自動的に精度が上がる
                  + evals/cases/ にケース追加 → 再発は回帰テストが機械検知
E の取りこぼし → クエリや設定を見直す
F の取りこぼし → .coderabbit.yaml の path_instructions を更新 + judgments.md に記録
                  → LLM が知らない領域なら active_rules.md(D側)に判例を寄せる
フィードバックループがそれらに「どう効くか」もまたそれぞれ違う。
外基準だから、プロジェクト内のルールだからっていう分け方で、フィードバックループがどう精度に作用するかがわかれるのではなく、作用方向の切り分けはフィードバックループで「判断ルール」に反映させられるか、させられないかです。
バグが出たときの切り分け
A・B・C・Eの修正は「穴を塞ぐ(除外を減らす)」方向、D・Fの修正は「判例を積む/観点を絞る」方向、という非対称性はここでも変わらないですね。
気づいたこと
1.フィードバックループが全部人力依存
judgments.md に書く → 人間がやらないと回らない
active_rules.md を更新 → 人間がやらないと回らない
.coderabbit.yaml 更新 → 人間がやらないと回らない
(2026.06追記)このうち「人間が回し忘れる」系はevalのCIゲート化で構造的に消しました。検閲基準を変えるPRは、回帰テストに全問正解しないと物理的にマージできない。判断そのものが人間に残るのは仕様です(後述の結論どおり)。
2.C(terraform plan)に自動ゲートがない
planは「見せるだけ」でブロックしない。OPA(Open Policy Agent)や Sentinel でplan内容を自動判定。
3.プロセス規律が仕組みじゃなくてルールで守られている
gcp-base への直接コミットを機械的に防ぐ仕組みがない。ブランチ保護ルールで「PR必須・レビュー1名以上」を強制しないと、人が増えたときに崩れる。
4.Datadogにメトリクスは飛んでいるがアラートがない
FAILが続いても誰にも通知されない。
(2026.06追記)よく考えたら「アラートを足す」ではなく「観測のタイミングが遅い」のが本質でした。FAILの傾向を事後に眺めるより、判定ミスをマージ前に機械検知するほうが品質に直接効果があるなと。なので品質担保の主手段はeval(回帰テスト)に置き換えて、Datadogは「事後可視化のオプション」という整理にしました。私の検証環境では配線ごとオフにしています(送信コードは残してあるので1行でONに戻せます)。
5.判例やログが長くなるとコスト(お金・時間)がかかる
どこまでコストがあがったら、どうするのか。
(2026.06追記)実測が出ました。eval 1回(7問)=数円・30秒くらい。判例が増えれば問題も増える設計なので比例して伸びますが、70問でも1回100円弱のオーダー。当面は気にしないことにします(判例を変えることはそこまで頻度は高くないので)。
6.バグ切り分けの自動化
CodeQL アラートをフィードバックループに自動で取り込む構想。
pr_reviewer.py はすでにdiff取得・Gemini呼び出し・GitHubコメント投稿の実装を持っているため、プロンプトを差し替えるだけで triage mode として転用できます。
となると。
AIに水平展開を任せたくなるけど「どこまでが同じ問題か」を決めるのは設計思想の話でAIには決められない。AIができるのは「候補を揃えること」までで「これは違反か例外か」「根本原因はどこか」の判断は人間に残るな、と。完全自動化を目指すと判例の信頼性が崩れるので 「人間の判断を要求するところまで運ぶ」 を自動化のゴールにするのが現実的だなと思います。そう、だから「どこでこの自動化のループをとめて こうなってますけど、どうしますか? ってAIに言わせるとこを決めて、そこで判断するのが人間の仕事。だから「気づいたこと1.フィードバックループが全部人力依存」は別に全部だめってわけではないんですよね。
ウォーターフォール式の開発現場にいたときは単体→結合→システム→出荷試験とわかれてて、バグで問題になるのは「このバグは、本来あのテストフェーズで出すべきだった」で、テストフェーズとバグの内容があっていることが、ものすっごく大事だったんですが「どのymlが、どのAIがこのエラーを検出すべきだったのか」っていう観点が、AI駆動開発でも重要だな、と思いました。
2026.05.17追記:
なんか使ってて、PRまでチェックがないのはなんだか「うーん」と思って、早く知りたいなって。そこでLayer1にcheckovとgitleak実装しますしました。secretの値がPRに出るの嫌だし。でもpre-commit は --no-verify で回避できるのでLayer2にもそのまま残す。1は開発者のセーフティネットで2は回避不能なゲートという役割分担。
2026.05.24追記:
Cline から Claude Code に乗り換え+ Layer 2 に F(CodeRabbit)を追加しました。それに伴って Layer 0 のフィードバックループの図を書き直しています。Cline時代に使っていた logs/ai-notes.md(申し送りノート)は、Claude Code には CLAUDE.md / auto-memory / judgments.md の3経路が揃っているので役割が消えました。既存の内容は適切な場所に振り分けて廃止予定。
2026.06.11追記:
「Dの精度は誰が保証する?」問題に答えを作りました。promptfoo でAIレビュアー用の模擬試験(eval)を導入しました(上の「Layer 2 D の精度は誰が保証するのか」参照)。Datadogまでいかない無料のツールで探して、サインアップもAPIキーも不要・採点は文字列一致だけ・1回数円、という軽さがいい。
で、導入初日からいろいろチェックが走りました。
- 検閲官(D)が、writer(Claude)の書いたCIスクリプトの「トークンをコマンドライン引数に展開する」甘い実装を正当にFAILしてくれた。writer/reviewer分離が初仕事をしました
- と思ったら今度は検閲官自身のマスク処理のバグが発覚しました。
${GITHUB_TOKEN}というただの変数参照まで[REDACTED]に書き換えてdiffを改変し、「壊れたコードが書かれている」と自分で作った幻に自分で誤検知してました。マスク対象から変数参照を除外して修正 - そして判例同士の干渉でGeminiが「これはテストデータか、実攻撃か」を77,000トークンぶん考え込んで無言になる熟考デッドロック。判例に「diffのパスを見て即決せよ。考え込むな」と判定手順を一行足したら思考が11kトークンに減って即答するようになりました。判例に「何を判断するか」だけではなく「どう判定するか(手順)」を書くとAIの判定が安定するということがわかって、すごい嬉しかったです!
- F(CodeRabbit)も「コスト表現がドキュメント間で不整合」「プレースホルダの連鎖置換に再注入の問題」の2件を正当に指摘。文脈を知らないレビュアーの存在意義を実証してくれました
ウォーターフォールの「このバグはどのフェーズで出すべきだったか」の観点で言うと、この4件は D・eval・eval・F がそれぞれ自分の担当のバグをちゃんと自分で出した、ということで、フェーズとバグの対応が綺麗に揃った初週でした。AI同士のわーわーは Layer 2 に引っ越して、まだ可愛いです。
かわいいいいい〜💞
2026.09.20追記:OSS にしました
この仕組みの「D と eval の部分」だけを切り出して、言語・クラウド非依存のテンプレートとして公開しました。gcp-base に後付けした状態から、他のプロジェクトに持ち込める形に分離した、というのが今回の作業です。
- テンプレート:
- エンジン:
gcp-base との違い
| gcp-base(この記事の本体) | ai-dev-kit(OSS) | |
|---|---|---|
| D の実体 |
pr_reviewer.py + Cloud Build(keyless / CI を書き換えられない) |
GitHub Action @v3(API キーで動く。改善はタグの付け替えで全利用者に届く) |
| 憲法のファイル名 |
AGENTS.md(2026.09.30 に .clinerules から改名) |
AGENTS.md(Cline の名前をやめて、AI エージェント向け指示の共通規約に合わせた。CLAUDE.md は @AGENTS.md で取り込む) |
| A・B・C・E・F | 同梱 | 同梱しない。スタックごとに差し替える「スロット」として README に書くだけ |
| eval | promptfoo | 同じ。本番と同一プロンプトを読む構造もそのまま |
| Layer 3 | terraform apply | 対象外 |
「変えてよい層(§B、判例、ゴールデンセット、モデル)」と「変えると強制力が消える層(fail-closed、base コミット参照、eval と本番の同一プロンプト、writer と reviewer の分離、判例の二層)」を README で分けて書いたのが、テンプレ化で一番気を使ったところです。
公開初日に何が起きたか(「どのレイヤーが出すべきだったか」で整理)
テンプレ自身に PR を出して動作確認したら、初週と同じで、いろいろ出ました。
| 起きたこと | 出したレイヤー | 出すべきだったレイヤー | 足したもの |
|---|---|---|---|
| eval-gate が動かない(promptfoo が Node 22 を要求、CI は Node 20) | eval(マージ前に止めた) | eval。正しく機能 | Node を上げた |
| 合格すべきケースに未使用 import が残っていて、Gemini がそれを口実にたまに FAIL | eval(同じコミットで PASS/FAIL が揺れた) | フィクスチャの作り方 | 「合格ケースに口実を残さない」 |
| テンプレ自身の PR が §A-5(1 PR 1 目的)で FAIL | D。正しい判定 | D。正しく機能 | 人間判断 → 判例 SCOPE-001 を PR で記録 → 再審査で PASS |
エンジンのバグ 3 件(claude-* を OpenAI 扱い、temperature を拒否するモデルで停止、変数がステータス投稿の関数を上書き) |
テンプレの PR(結合テスト) | エンジン自身の単体テスト(無かった) | 単体テスト 33 件 + CI + 必須チェック |
| Gemini 無料枠が 1 日 20 リクエスト。eval 6 問で使い切り、429 で 41 分かけて失敗 | 誰も出せない(環境) | 環境 | 直列実行 + リトライ、結局は有料枠(1 PR 5 円くらい) |
3 行目は、この記事の D のループ図がそのまま一周した初の実例です。FAIL → 「分割する?判例で許す?」と AI に聞かれて人間が判断 → 判例だけの PR を出す(それ自体が D と eval を通る)→ 元の PR を再審査 → PASS。判例は base コミットから読まれるので、判例をマージしてから元 PR を rebase する必要がある、というのも実地で分かりました。
4 行目は反省点で、エンジンで 1 日に 3 件はさすがに多い。どれも数行のテストで捕まる種類だったのに、エンジン側の CI が LLM のセルフレビューと CodeQL だけで、コードの挙動を機械的に確かめるものが無かった。ウォーターフォールで言う「単体テストで出すべきバグを結合テストで出した」なので、単体テストを足して必須チェックにしました。
D が D 自身の入力仕様をレビューした話
ゴールデンセットの fail ケースには注入文がそのまま入っているので、D の審査対象から evals/cases/ を外しました。すると D が「設定ファイルが参照しているケースファイルが PR に無い(欠落・重大)」と FAIL。見せていないだけなのに。そこで除外したファイル名の一覧をプロンプトに渡すようにしたら、今度は D が「そのファイル名は PR 作成者が自由に付けられる。<diff> と同じくデータとして扱うガードが無いのは fail-closed の抜け穴」と FAIL。正論だったので <excluded_files> で囲んで指示 0 のガード対象に入れました。検閲官が検閲官自身のプロンプトの穴を指摘してくる、というのはこの構造ならではで、まだ可愛いです。
やらかし
無料枠が尽きたときに Claude をレビュアーに切り替えて回したのですが、writer も Claude なので分離を自分で壊していました。しかも claude-sonnet-5 は temperature を固定できず、同じコミットで PASS と FAIL が出る。「別モデル+強制ゲート」は建前じゃなくて、揺れを抑える実用上の理由もあるんだな、と身をもって理解して Gemini に戻しました。
気づいたこと 3(ブランチ保護)は OSS 側では解消
両リポジトリの main に、コミットステータス AI PR Reviewer と eval-gate(エンジン側は pytest)を必須にしたブランチ保護を入れました。ジョブではなくコミットステータスを必須にするのがポイントで、フォークからの PR や Draft はレビューが走らないため、ジョブ必須だと素通り、ステータス必須だと pending で止まる(fail-closed)になります。