
はじめに
この記事では、Granite Time Series をwatsonx.ai 上のJupyter Notebook で使うためのハンズオンです。
今回使用するデータは、以下です。ダウンロードしてローカルに置いておくとスムーズです。
データ:https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv
watsonx とは
業務にAI を組み込むことにより、企業のさまざまな業務領域でAI のインパクトを拡大、加速するためのプラットフォームおよびAI アシスタントソリューション(公式より)
https://www.ibm.com/jp-ja/products/watsonx
watsonx.ai とは
従来の機械学習と、基盤モデルを活用した新しい生成AI 機能の両方を学習・検証・調整・導入できるAI 構築のための次世代の企業向けスタジオ(公式より)
https://www.ibm.com/jp-ja/products/watsonx-ai
Granite Time Series とは
IBM が提供するGranite モデルシリーズのひとつで、時系列データに対応した基盤モデルです。時系列基盤モデルは言語に特化した大規模言語モデルと同様に、膨大な時系列データを用いて事前学習されています。従来の時系列予測モデルとは異なり、特定のタスクに特化せず幅広い時系列予測タスクに対応可能となっており、さらに少ないデータからでも精度の高い予測が可能となっています。
Granite 時系列データ分析モデルは他社と比べて軽量なモデルとなっています。
Granite モデルはオープンなモデルであることが特長のひとつとなっており、このモデルも他のGranite モデルと同様にモデルの情報やトレーニングデータを公開しています。
https://www.ibm.com/granite/docs/models/time-series/
https://huggingface.co/ibm-granite/granite-timeseries-ttm-r2
想定されるユースケース
- シミュレーション・計画立案
- 需要予測に基づいた生産計画や在庫管理を最適化し、無駄を削減
- 再生可能エネルギーの発電量予測を活用した需給バランス調整で安定供給を実現
- 制御や最適化への直接活用
- リアルタイム制御ループに組み込み、自動的にパラメーターを最適化
- AIによる継続的な効率改善で、人手に頼らない安定運用を可能に
- 異常検知
- 現時点での挙動が「いつもと違う」ことを早期に検知
- 必要に応じてパラメーター調整やアラートで即時対応し、ダウンタイムを防止
- シナリオ分析
- 「もし◯◯が起きたら?」という条件を変えた未来をシミュレーション
- 需給ショック、気象変動、設備トラブルなどのリスクを事前に把握し、対策を検討
ハンズオン事前準備
ハンズオン事前準備では、
- IBM Cloud へのログイン
- apikey の取得
を実施します。apikey は、ハンズオン本編で使用します。
IBM Cloud にログイン
-
リンク (https://cloud.ibm.com/login) をクリックし、IBMid とパスワードを入力してログインする
-
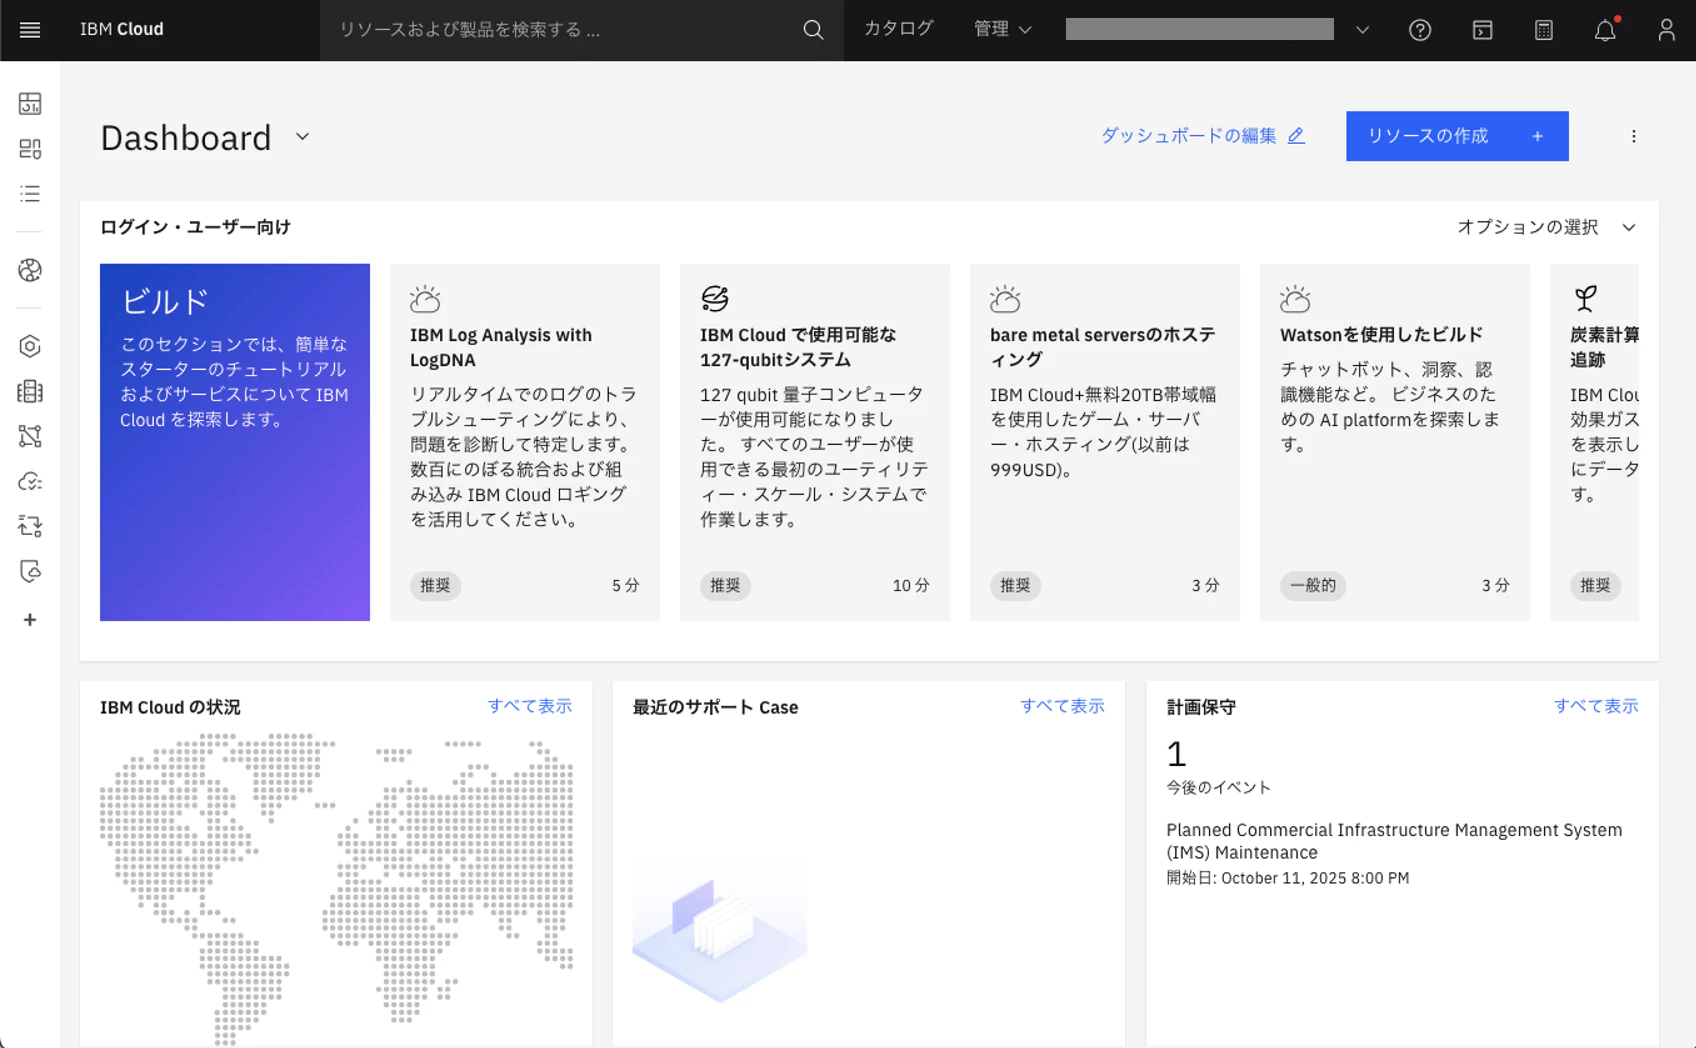
ログイン完了
apikey の取得
-
①
管理をクリック、②アクセス(IAM)をクリック

-
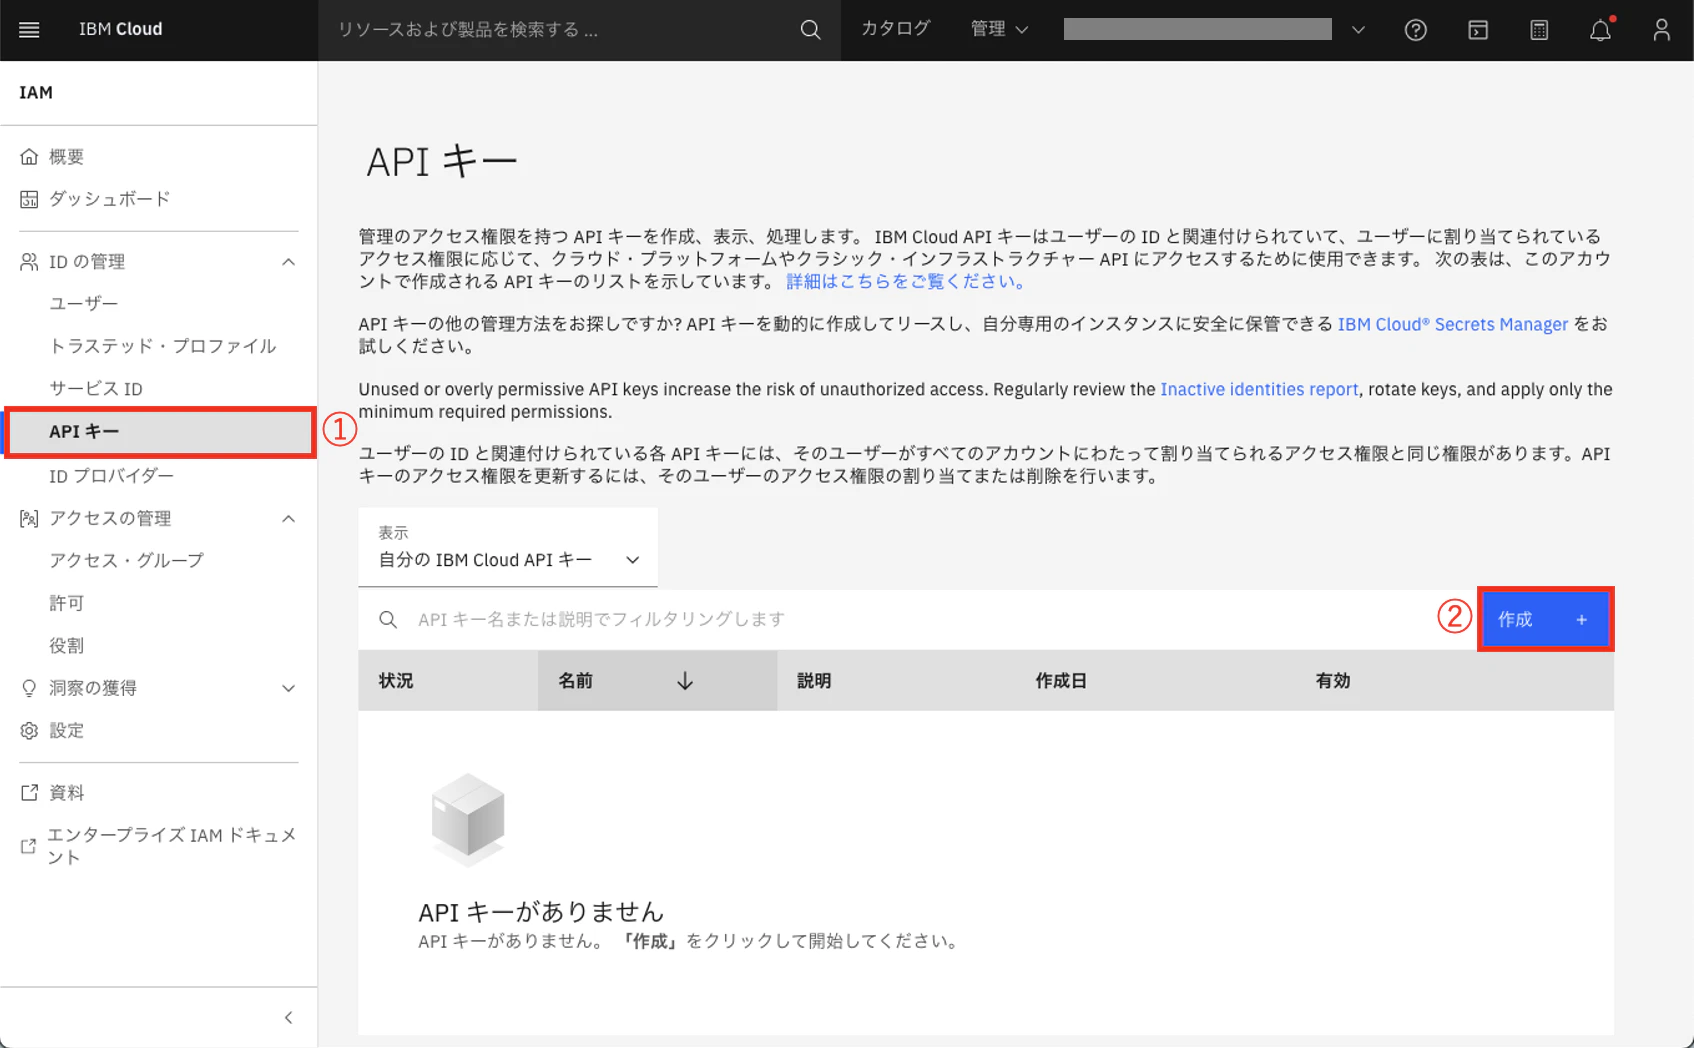
①
API キーをクリック、②作成+をクリック
-
①
名前に任意の名前を入力し、②作成をクリック

-
コピーダウンロードをして、いつでも使えるようにしておく

-
apikey の取得完了

ハンズオン本編
ハンズオン本編では、
- watsonx にログイン
- プロジェクトの作成
- サービスの関連付け
- プロジェクト・アクセス・トークンの作成
- csv ファイルをプロジェクトへアップロード
- 前処理
- 予測
を実施します。
watsonxにログイン
-
リンク (https://dataplatform.cloud.ibm.com/login?context=wx) をクリックし、IBMid とパスワードを入力してログインする

-
ログイン完了

プロジェクトの作成
-
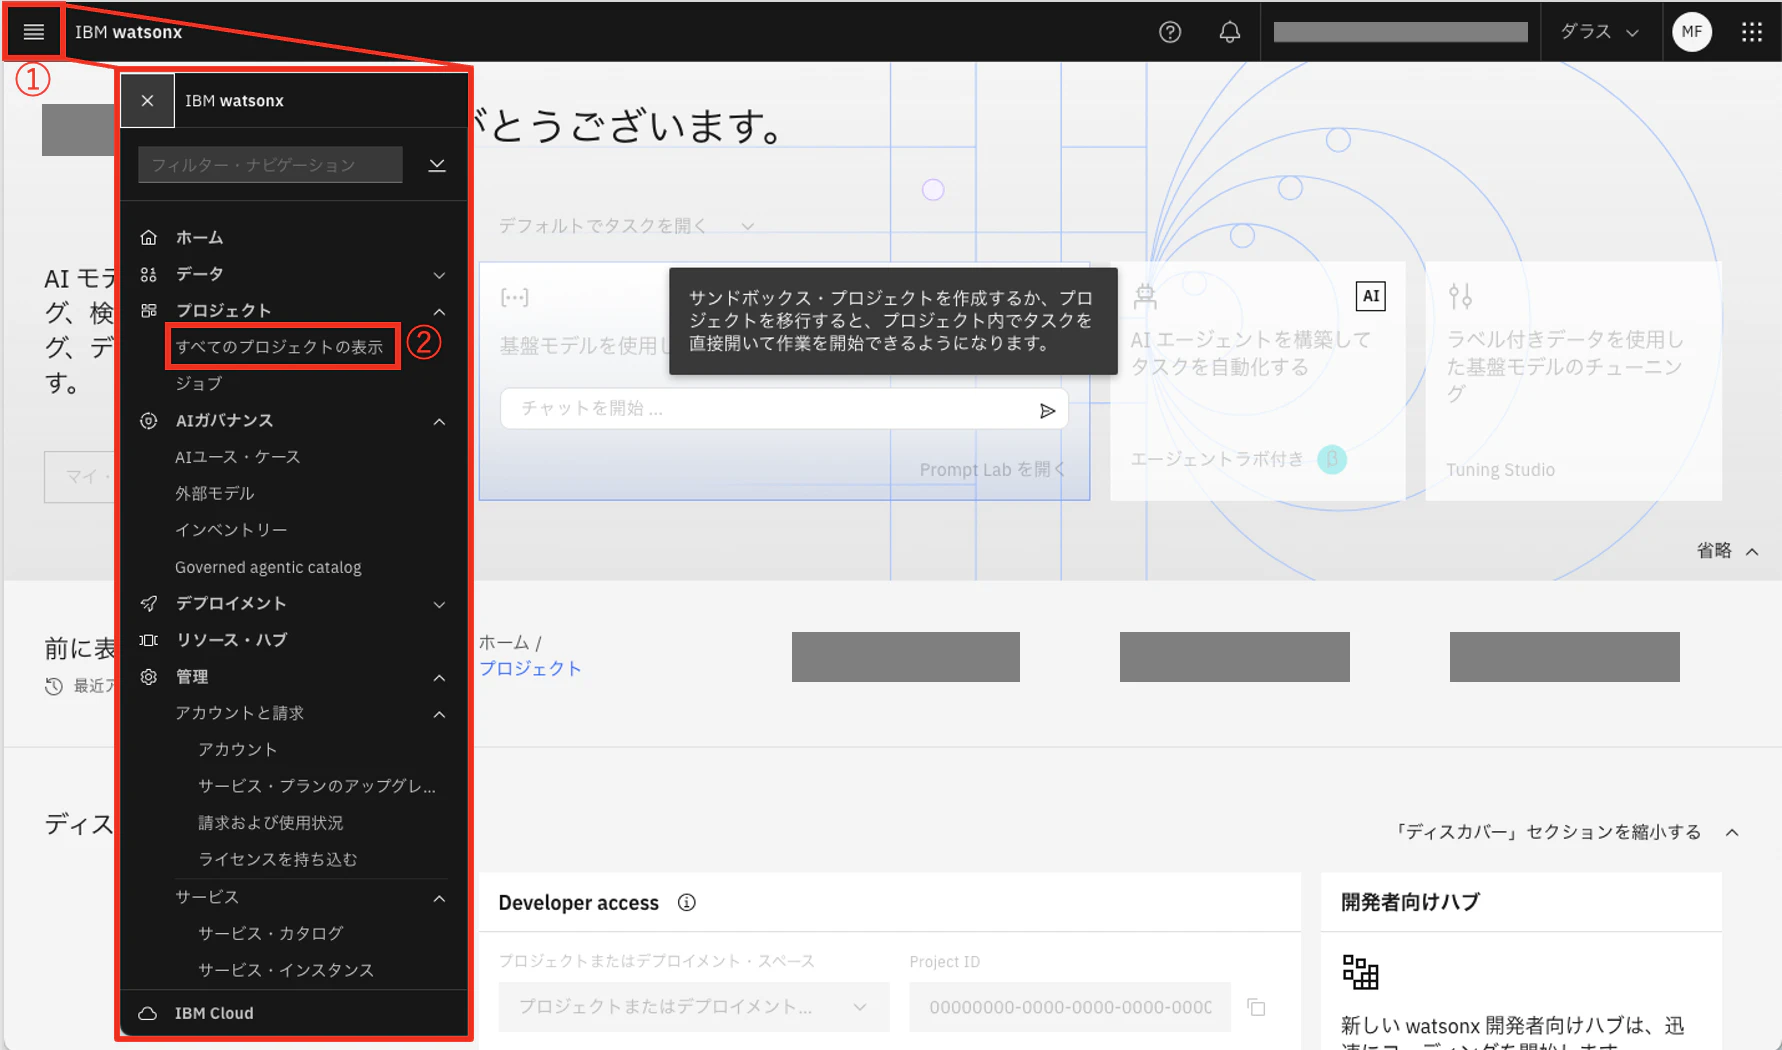
左上の①ハンバーガーメニュー から、②
すべてのプロジェクトの表示をクリックする
-
新規プロジェクト+をクリックする

-
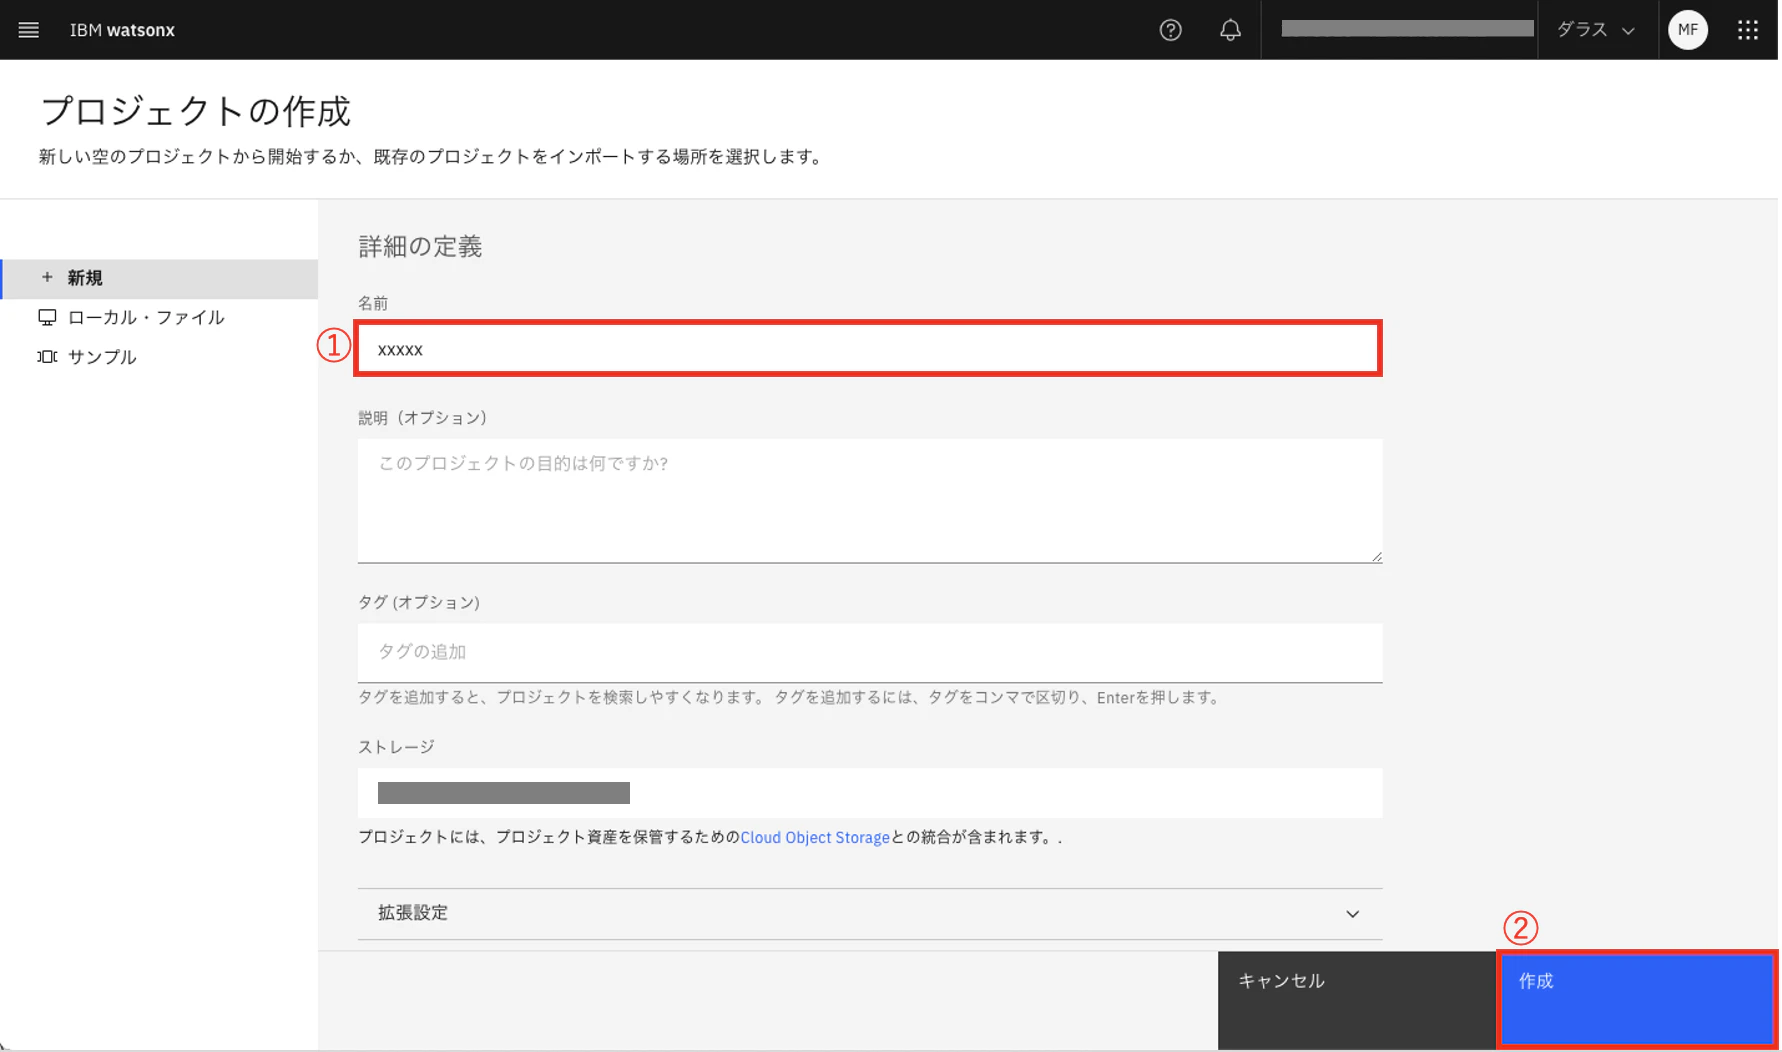
①
名前にxxxxx(xxxxxは任意) を入力し、②作成をクリックしてプロジェクトの作成は完了
サービスの関連付け
-
左上オレンジの箇所が、自身で入力した名前になっているか確認し、
管理をクリック

-
①
サービスおよび統合をクリックし、②サービスの関連付けをクリック

-
① タイプが
Watson Machine Learningのサービスにチェックを入れて、②関連付けをクリック

プロジェクト・アクセス・トークンの作成
-
①
アクセス制御をクリック、②アクセス・トークンをクリック

-
新規アクセス・トークン+をクリック

-
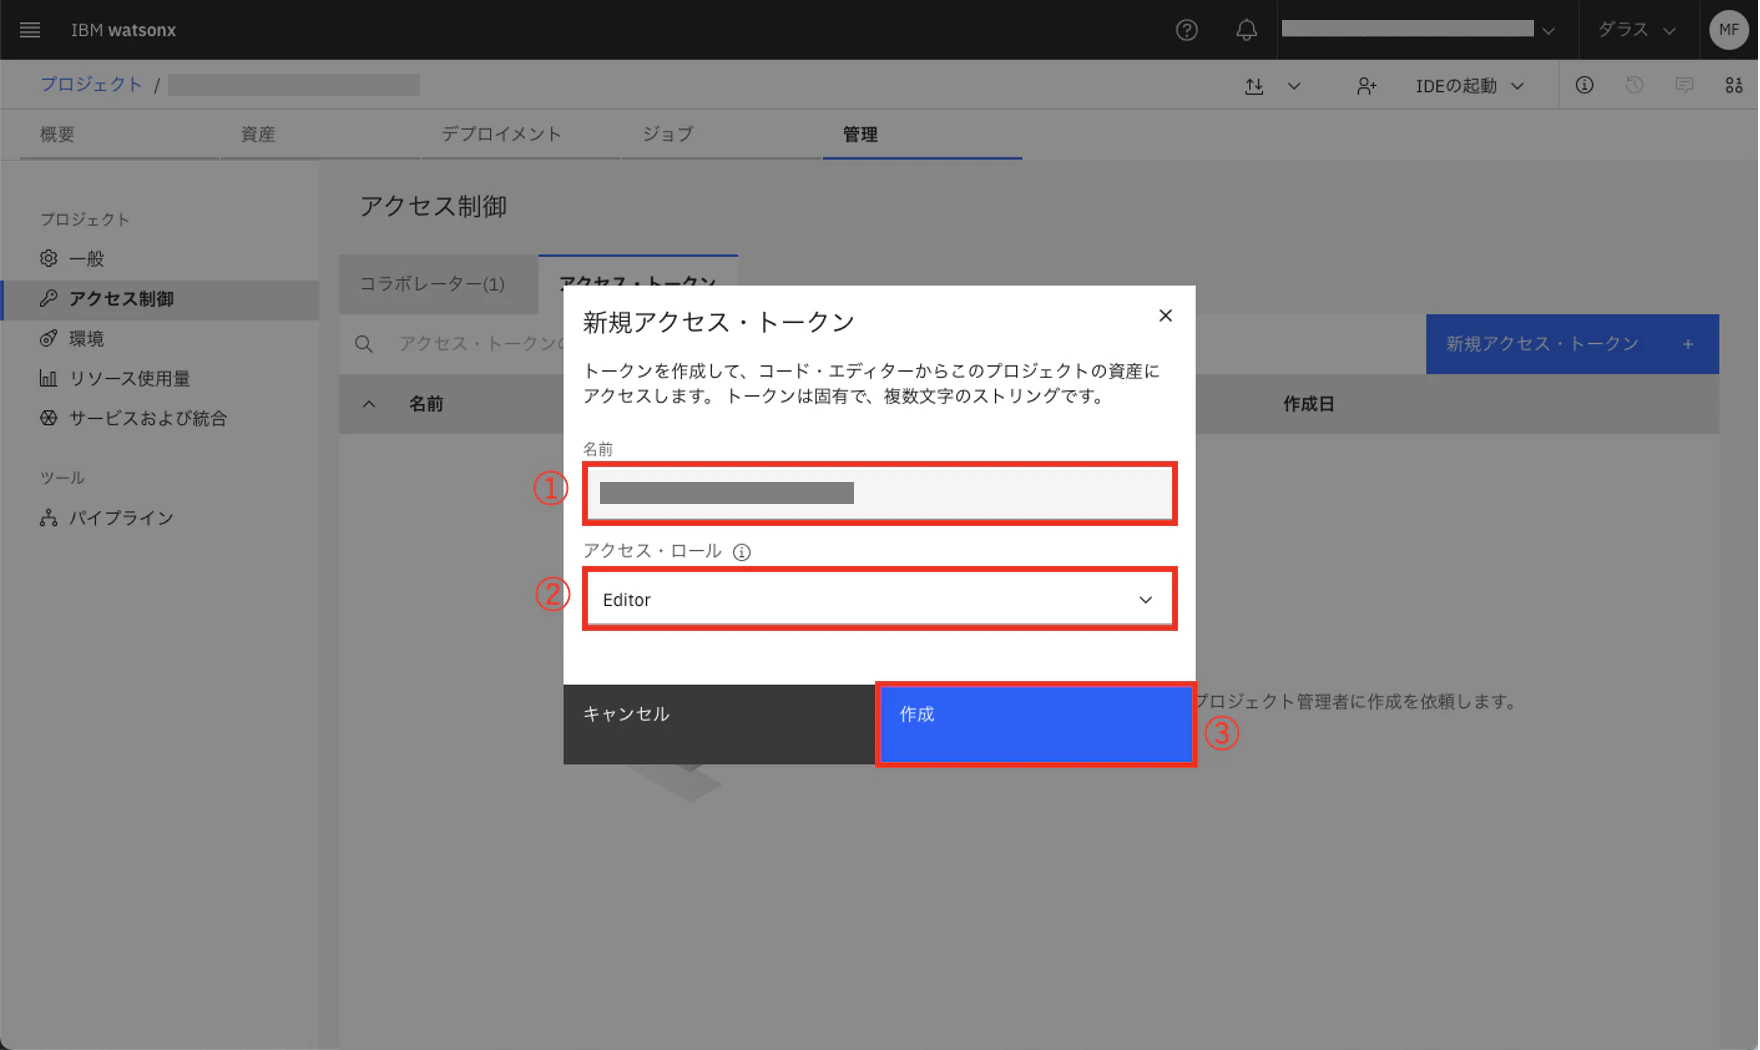
①
名前に任意の名前を入力し、②アクセス・ロールでEditorを選択、③作成をクリック
-
作成したアクセス・トークンが表示されたら完了

csvファイルをプロジェクトへアップロード
-
ローカルにダウンロードした
ETTh1.csvを置いておく -
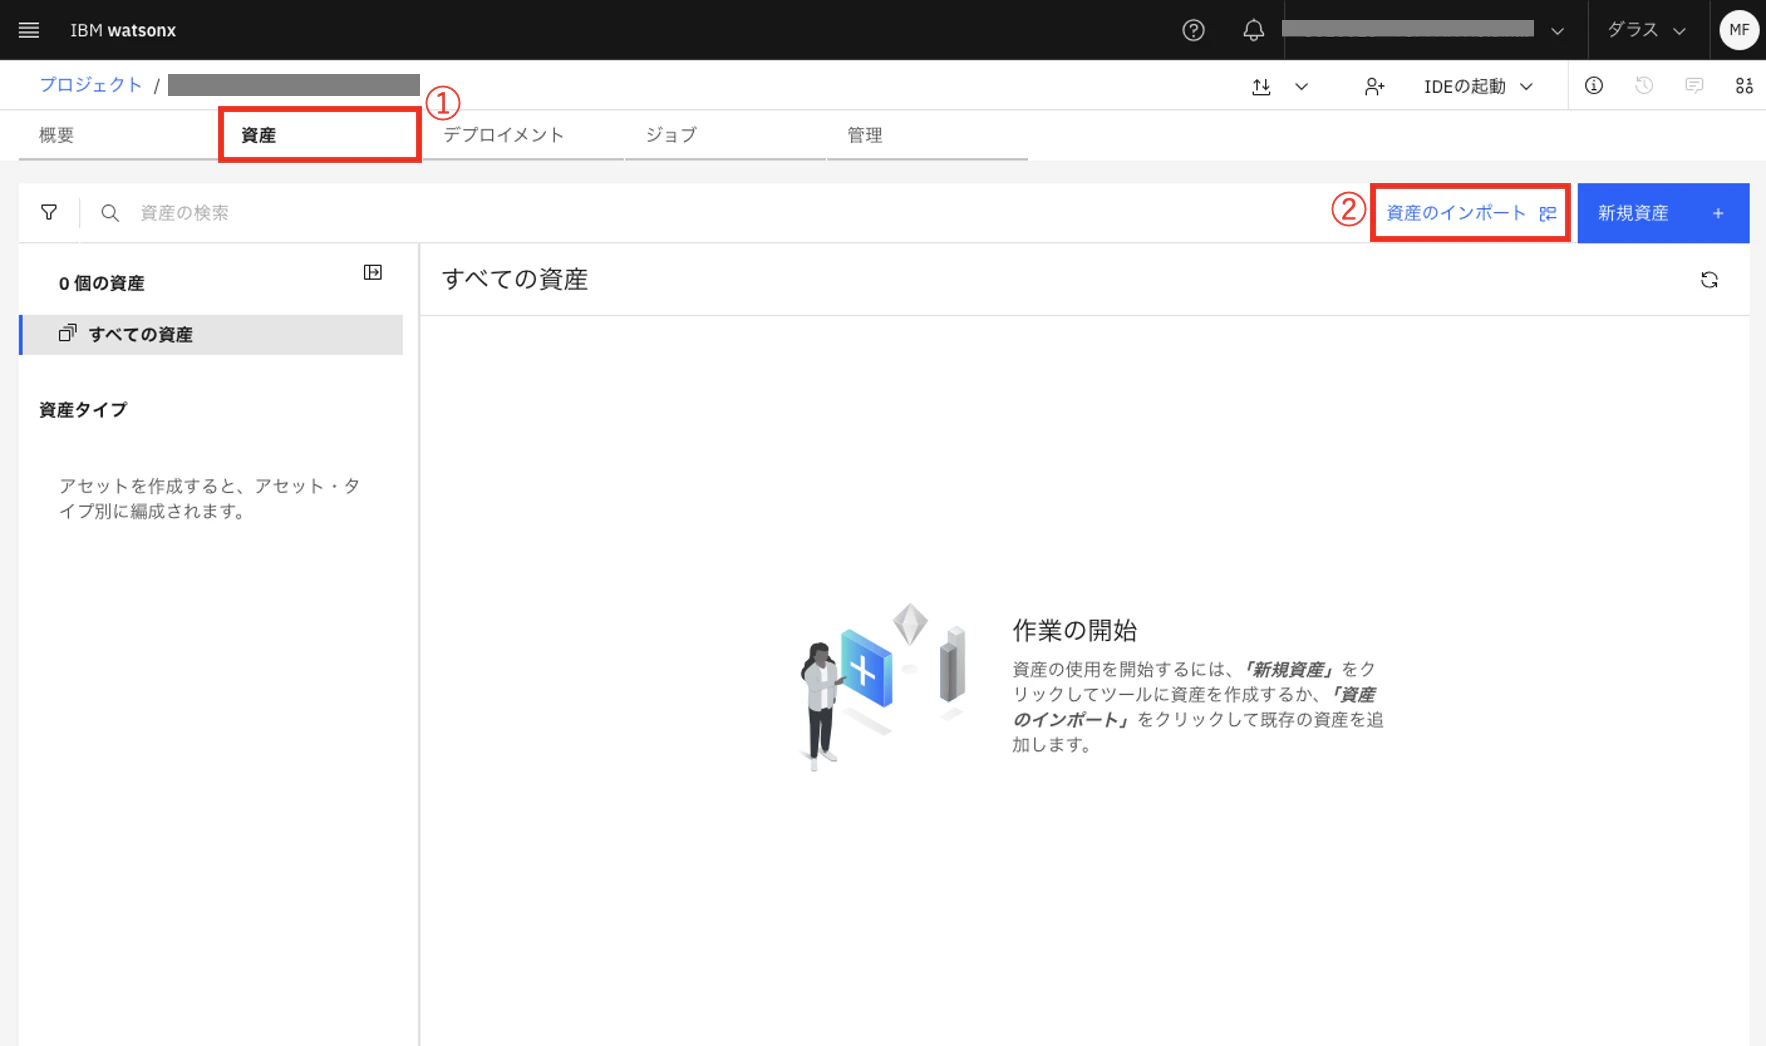
①
資産をクリック、②資産のインポートをクリック
-
①
ローカルファイルをクリック、②データアセットをクリック

-
参照をクリックし、ローカルに置いたGE_RMS.csvを選択

-
完了をクリックしてcsvファイルのインポートは完了

前処理
ノートブックを作成
-
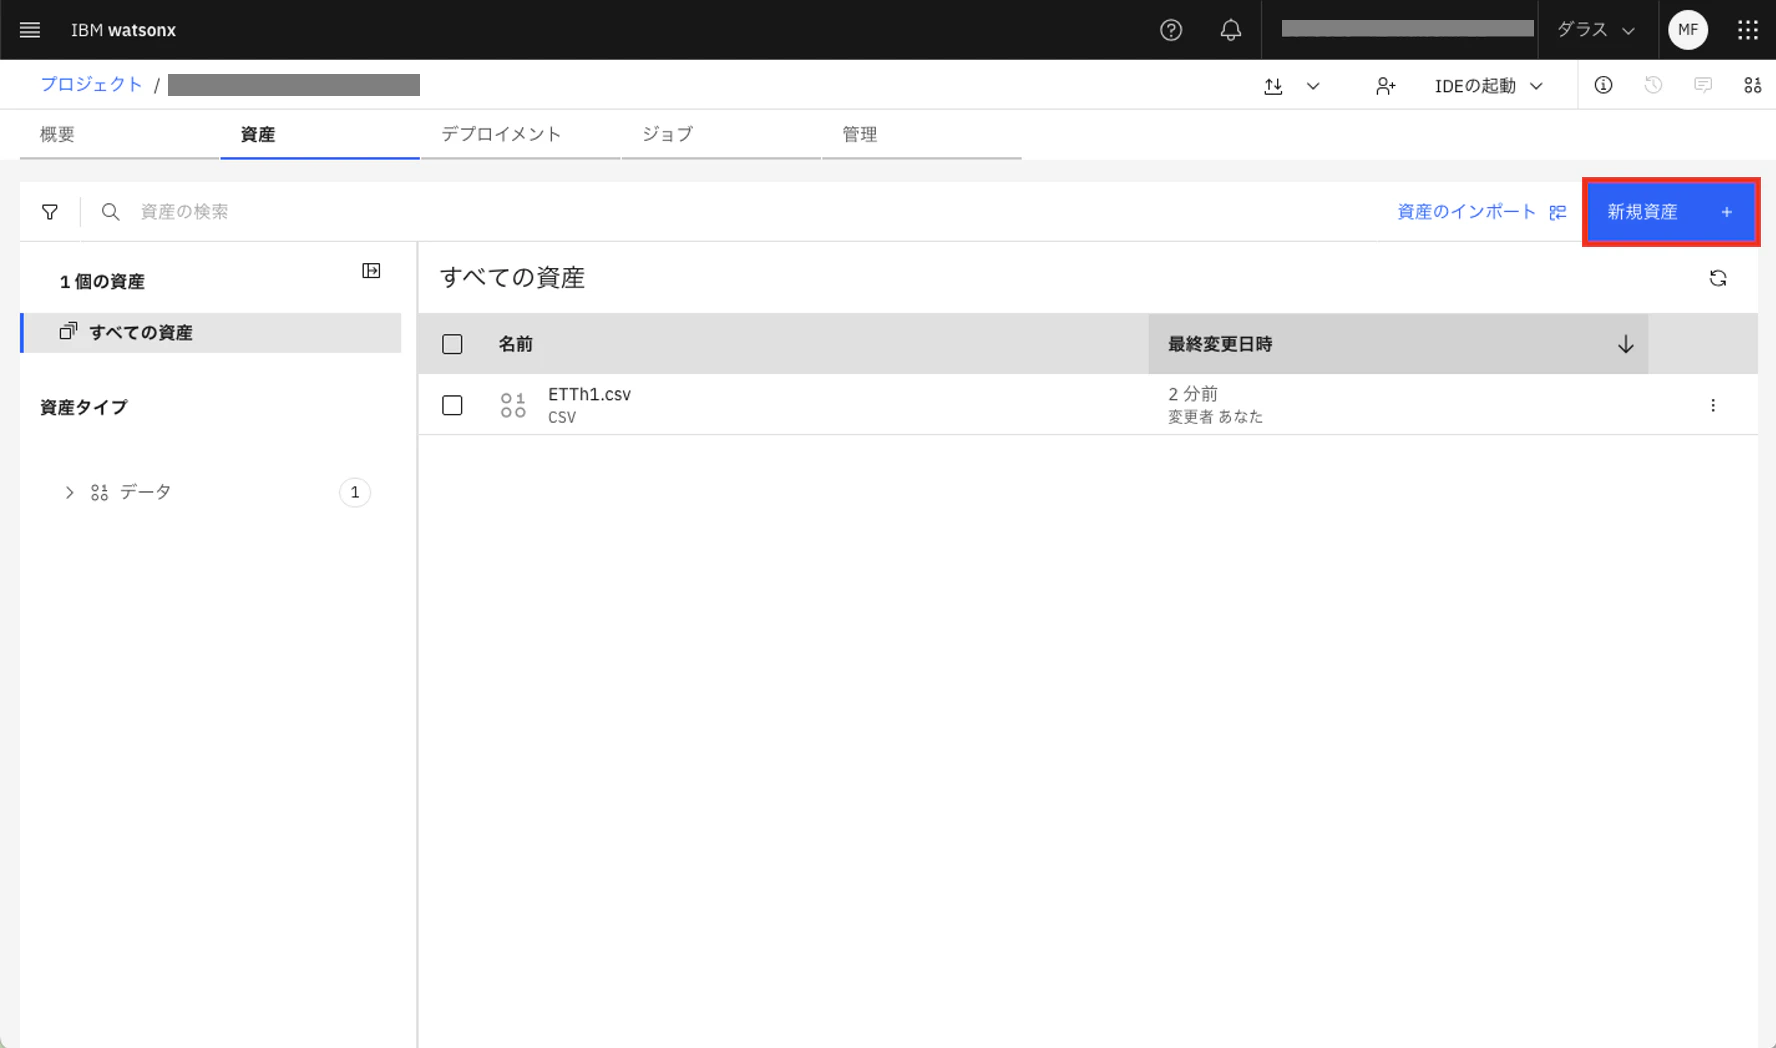
新規資産をクリック
-
①
pythonを検索バーに入力し、②Python またはR notebooks でのデータおよびモデルの処理 (Jupyter ノートブック・エディター)を選択

-
①
名前にpreprocessing.pyを入力し、②作成をクリック

-
ランタイムが終了するのを待つ

- 99%で3分くらい止まることがあるが、その場合はプロジェクトに戻って再度作成したnotebook を選択する
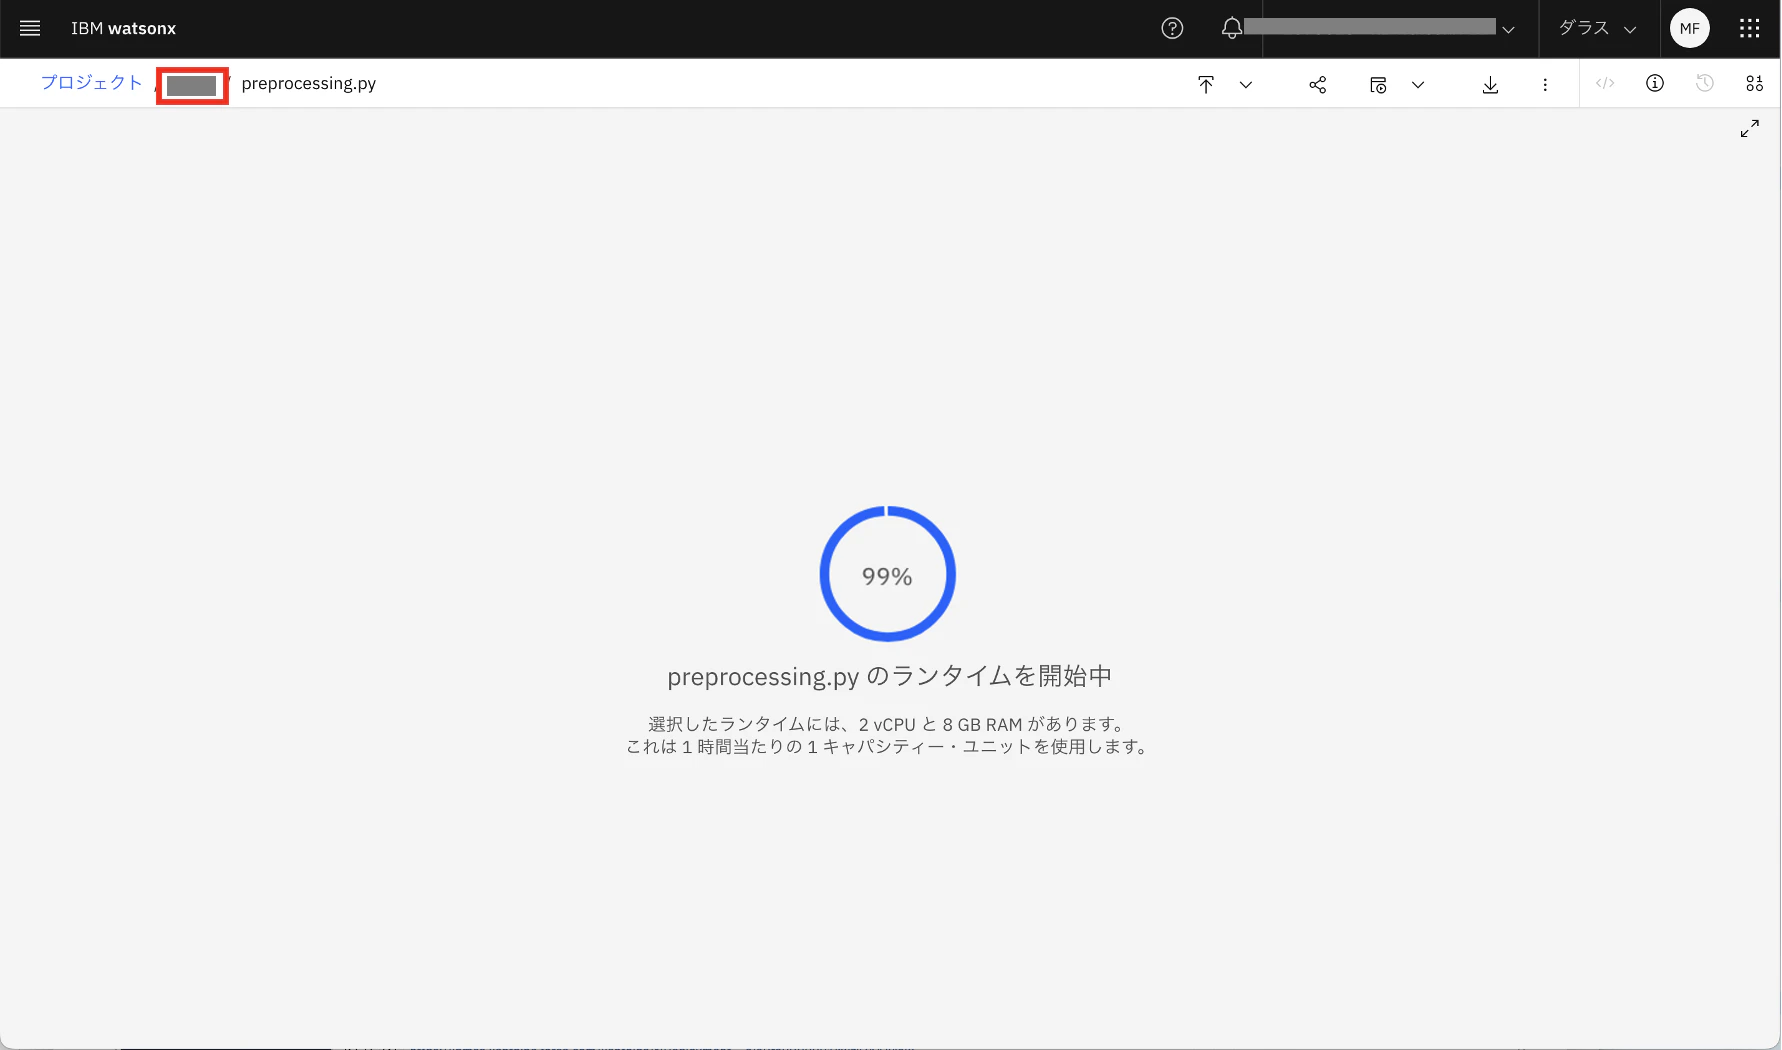

- 99%で3分くらい止まることがあるが、その場合はプロジェクトに戻って再度作成したnotebook を選択する
-
①
縦の3点リーダーをクリック、②プロジェクト・トークンの挿入をクリック
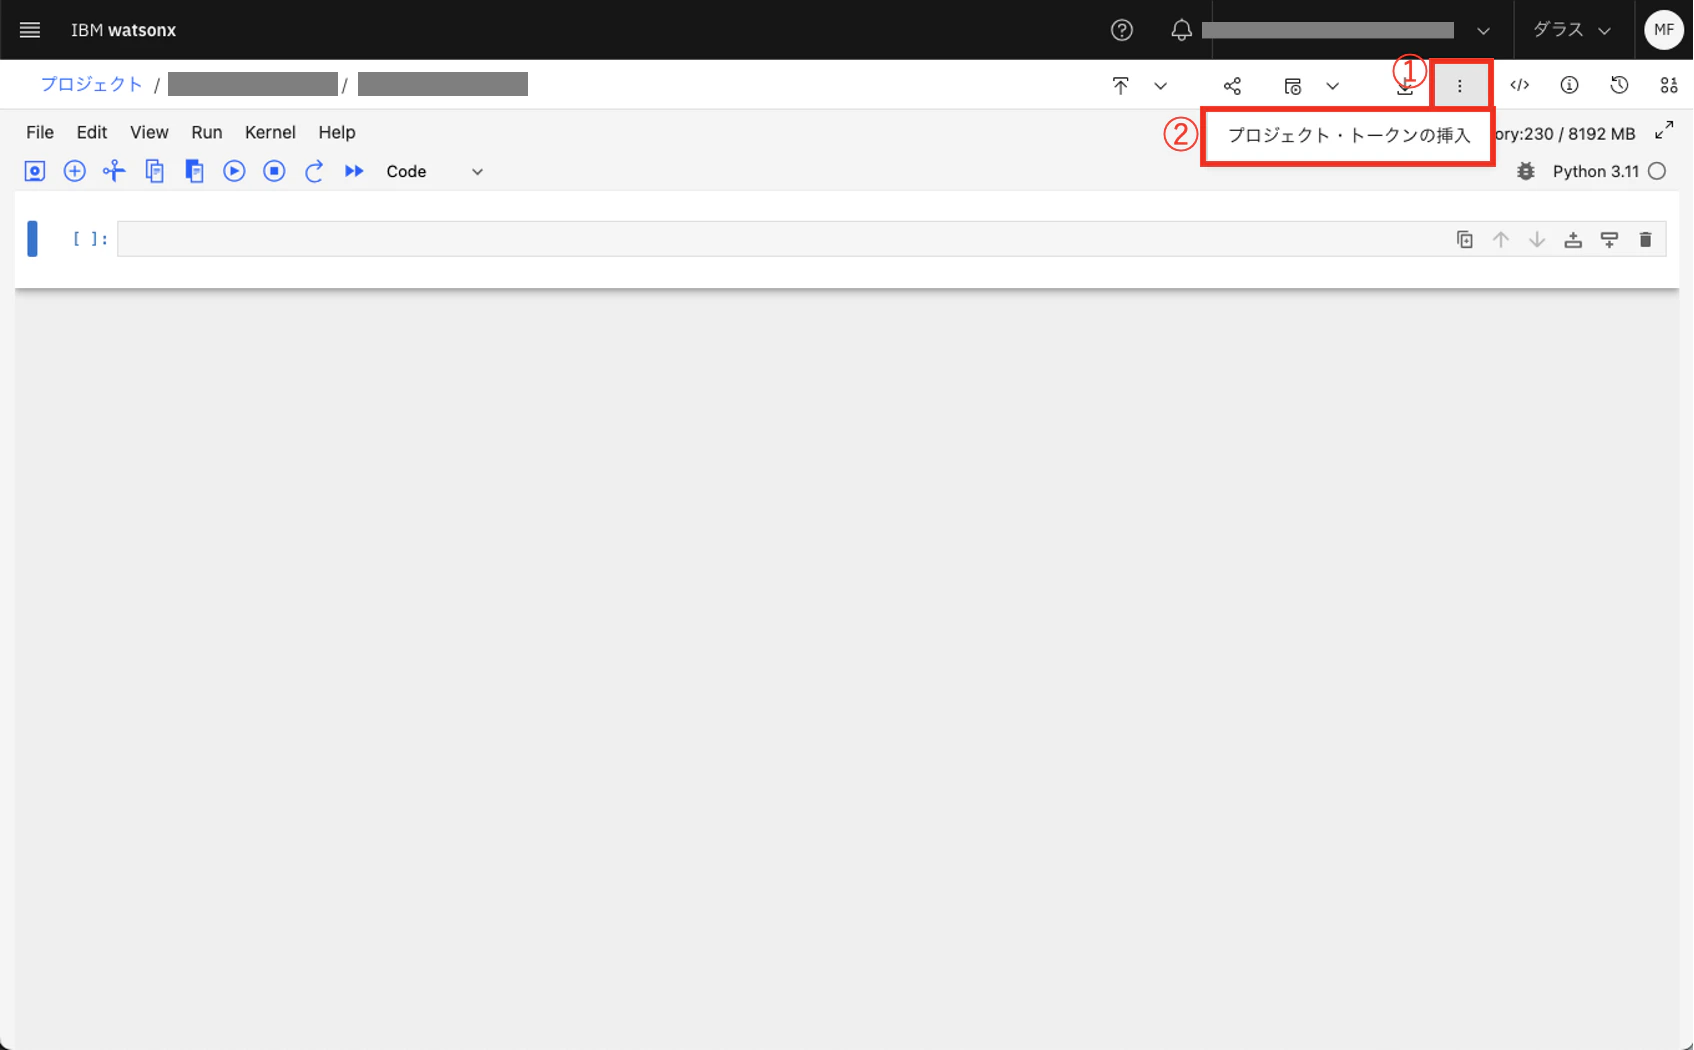
-
自動的に
project_idやproject_access_tokenが入力される
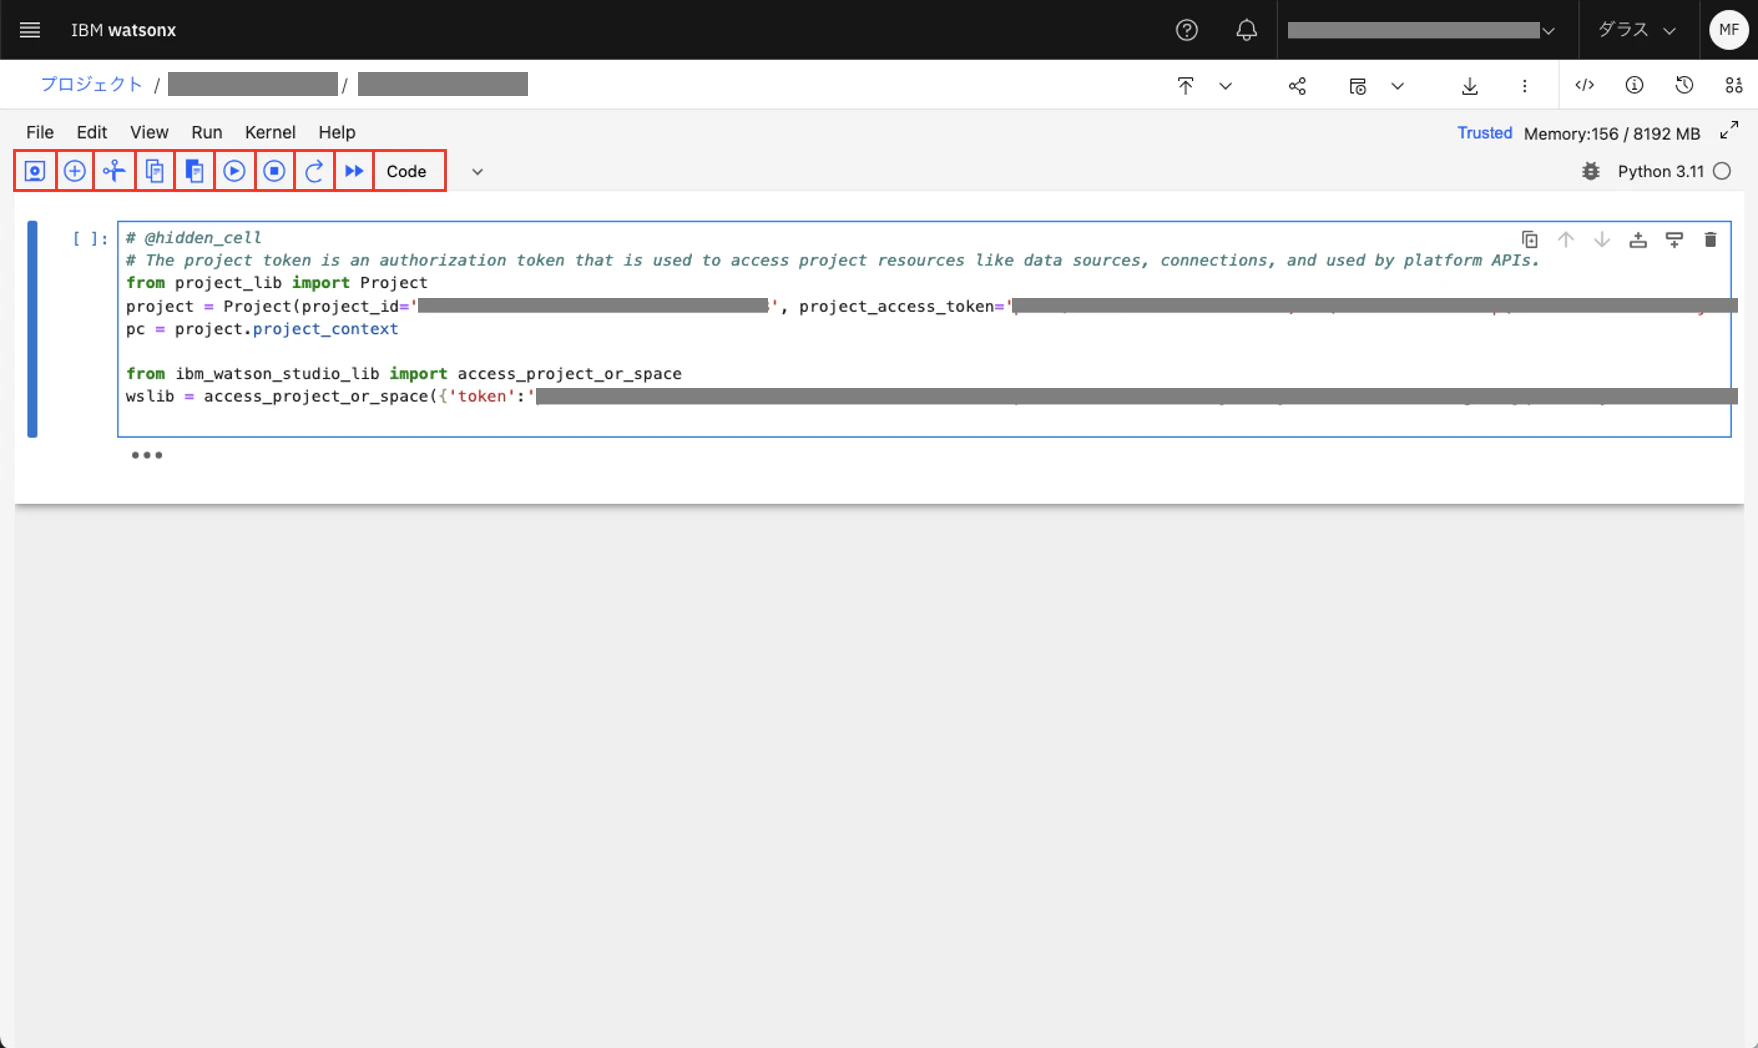
ノートブックの操作方法
 : 上書き保存 (Save and create checkpoint (= ⌘S))
 : 選択している行の下に1行追加 (Insert cell below (= ⌘B))
 : この行をカットする (Cut this cell (= ⌘X))
 : この行をコピーする (Copy this cell (= ⌘C))
 : この行にクリップボードからペーストする (Paste this cell from the cripboard (= ⌘V))
 : この行を実行する(Run this cell and advance (=Shift+Enter))
 : この行の実行を停止させる (Interrupt the kernel)
 : この行の実行を再開する (Restart the kernel)
 : この行の実行を再開し、すべての行を実行する(Restart the kernel and run all cells)
 : 行の種類を選ぶ (select the cell type)
この記事では出力を確認しながら1つずつ行を実行します。
実行
- 右上のコピーアイコンをクリックするとブロックごとにコピーができます。
-
1ブロック = ノートブックでの1行です。 - コピー(⌘C) したブロックをノートブックにペースト(⌘V) し、実行(Shift+Enter) をします。
#プロジェクトにアップロードしたcsvファイルをノートブックにダウンロード
wslib.download_file("ETTh1.csv")

#存在するファイルを確認
!ls

#ライブラリのインポート
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np

#「df」にcsvファイルを格納
df = pd.read_csv("ETTh1.csv")
#表示して格納できているか確認
df

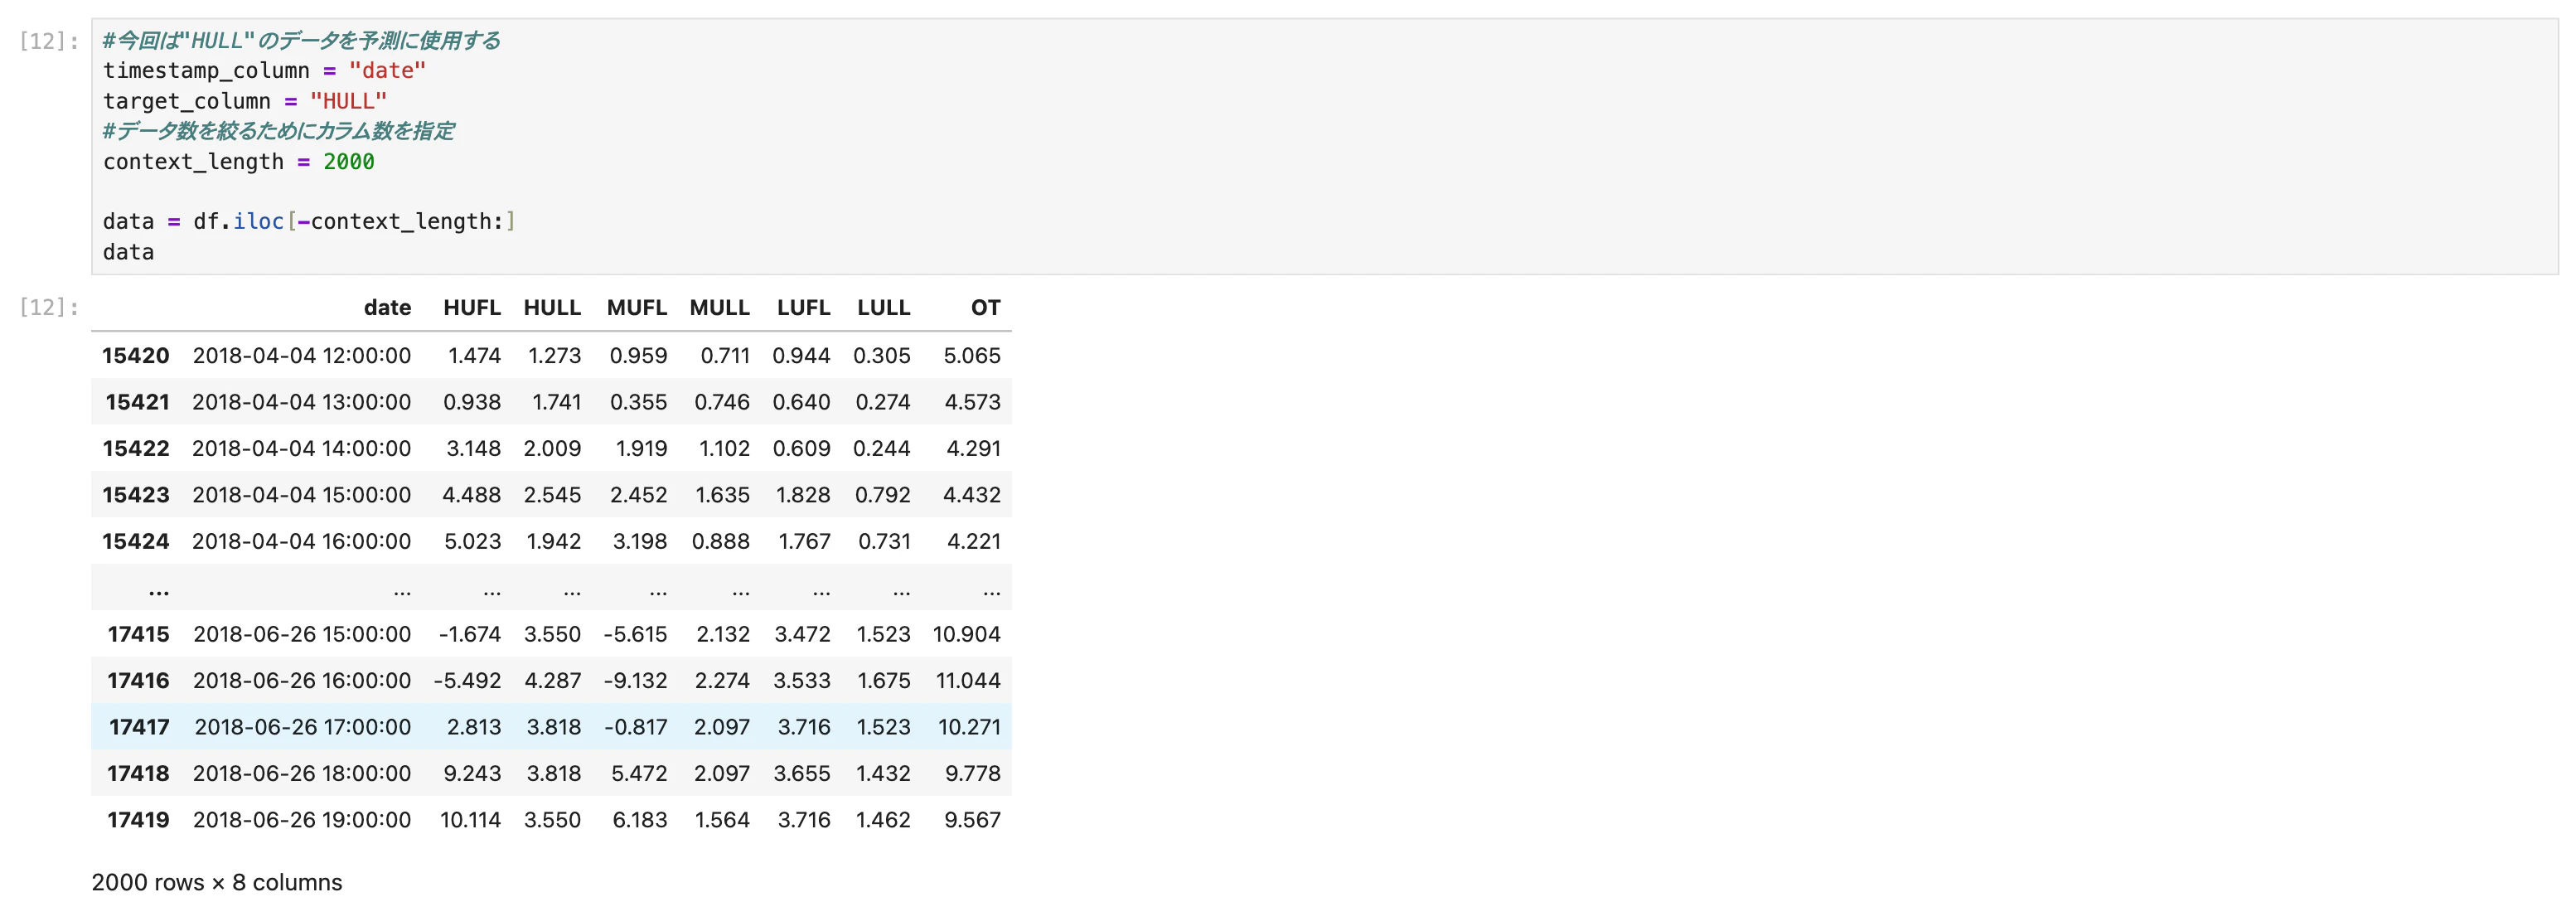
#今回は"HULL"のデータを予測に使用する
timestamp_column = "date"
target_column = "HULL"
#データ数を絞るためにカラム数を指定
context_length = 2000

data = df.iloc[-context_length:]
data
#プロット
plt.figure(figsize=(10,2))
plt.plot(np.asarray(data[timestamp_column], dtype='datetime64[s]'), data[target_column], label="Historical data")
plt.plot(np.asarray(future_data[timestamp_column], dtype='datetime64[s]'), future_data[target_column], label="True", linestyle='dashed')
plt.title("Actual Total Load")
plt.show()

#抽出したデータをcsvファイルにしてプロジェクト内に保存
df1 = pd.merge(data, future_data,  how='outer')
wslib.save_data("ETTh1_1.csv", df1.to_csv(index=False).encode(), overwrite=True)

-
基本的に自動保存だが、念のために左上の上書き保存マークを押して保存

-
プロジェクトの資産を見に行くと、ETTh1_1.csvがある

予測
ノートブックの作成(手順はpreprocessing.pyと同様)
-
新規資産をクリック
-
①
pythonを検索バーに入力し、②Python またはR notebooks でのデータおよびモデルの処理 (Jupyter ノートブック・エディター)を選択
-
①
名前にforecast.pyを入力し、②作成をクリック

-
ランタイムが終了するのを待つ
-
①
縦の3点リーダーをクリック、②プロジェクト・トークンの挿入をクリック
-
自動的に
project_idやproject_access_tokenが入力される
実行
#プロジェクトに保存したcsvファイルをノートブックにダウンロード
wslib.download_file("ETTh1_1.csv")

#存在するファイルを確認
!ls

#ライブラリのインポート
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np
#「df」にcsvファイルを格納
df = pd.read_csv(filepath_or_buffer="ETTh1_1.csv")
#表示して格納できているか確認
df

#定義
timestamp_column = "date"
target_column = "HULL"
#watsonx.aiの設定
from ibm_watsonx_ai import Credentials
credentials = Credentials(
    url="https://us-south.ml.cloud.ibm.com",
    api_key="{自身で取得したapi_key}",
)
#watsonx.aiに接続
from ibm_watsonx_ai import APIClient
client = APIClient(credentials)
client.set.default_project(project_id="{プロジェクト・トークンの挿入で表示されているproject_id}")

SUCCESS と表示されればOK
#TTMが使用できるか確認
for model in client.foundation_models.get_time_series_model_specs()["resources"]:
    print('--------------------------------------------------')
    print(f'model_id: {model["model_id"]}')
    print(f'functions: {model["functions"]}')
    print(f'long_description: {model["long_description"]}')
    print(f'label: {model["label"]}')

#使用するモデルにGRANITE_TTM_512_96_R2を定義
ts_model_id = client.foundation_models.TimeSeriesModels.GRANITE_TTM_512_96_R2

#TTMの設定
from ibm_watsonx_ai.foundation_models import TSModelInference
ts_model = TSModelInference(
    model_id=ts_model_id,
    api_client=client
)
#TTMのパラメータの設定
from ibm_watsonx_ai.foundation_models.schema import TSForecastParameters
params = TSForecastParameters(
    timestamp_column=timestamp_column,
    freq="1h",
    target_columns=[target_column],
)
#予測
import time
tmp = []
for i in range(len(df)):
    print(i)
    data = df.iloc[i:i+512,]
    if(data.shape[0] != 512):
        break
    response = ts_model.forecast(data=data, params=params)
    time.sleep(0.1)
    tmp.append(response["results"][0])

#予測結果をpickleに保管
import pickle
with open(f"{target_column}.pkl", "wb") as f:
    pickle.dump(tmp, f)
#ロードする
with open(f"{target_column}.pkl", "rb") as f:
    tmp = pickle.load(f)
#データ全体(青)と初めの512日分から予測した96日の予測値(オレンジ)のプロット
i = 0
plt.plot(np.asarray(df[timestamp_column], dtype='datetime64[s]'), df[target_column], linestyle="-")
plt.plot(np.asarray(tmp[i][timestamp_column], dtype='datetime64[s]'), tmp[i][target_column], linestyle="-")
plt.grid()

#3時間後の予測値を、予測したすべての分プロットするためのデータ準備
i = 2
preds = [
    {"Date": t["Date"][i], target_column: t[target_column][i]}
    for t in tmp
    if t.get("Date") and t.get(target_column)
]
#データ全体(青)と3時間後の予測値(オレンジ)を予測したすべての分プロット
df_preds = pd.DataFrame(preds)
plt.plot(np.asarray(df[timestamp_column], dtype='datetime64[s]'), df[target_column], linestyle="-")
plt.plot(np.asarray(df_preds[timestamp_column], dtype='datetime64[s]'), df_preds[target_column], linestyle="-")
plt.grid()

#3時間後の予測結果のデータをcsvファイルにしてプロジェクト内に保存
wslib.save_data(f"ETTh1_2_{target_column}.csv", df_preds.to_csv(index=False).encode(), overwrite=True)

- プロジェクトの資産に予測結果である
ETTh1_2_HULL.csvがある
