

概要
S3に書き込んだパーティションをGlue Data Catalogに即座に同期する最速の方法は、boto3を使ってcreate_partition APIを直接呼び出すイベント駆動アプローチです。クローラーやMSCK REPAIR TABLEと比較して、待ち時間を最小化し運用負荷も削減できます。
目次
はじめに
S3にパーティション形式でデータを保存し、Athenaでクエリするケースにおいて、S3とGlue Data Catalogの同期タイミングは重要な課題です。従来のアプローチには以下のような問題があります。
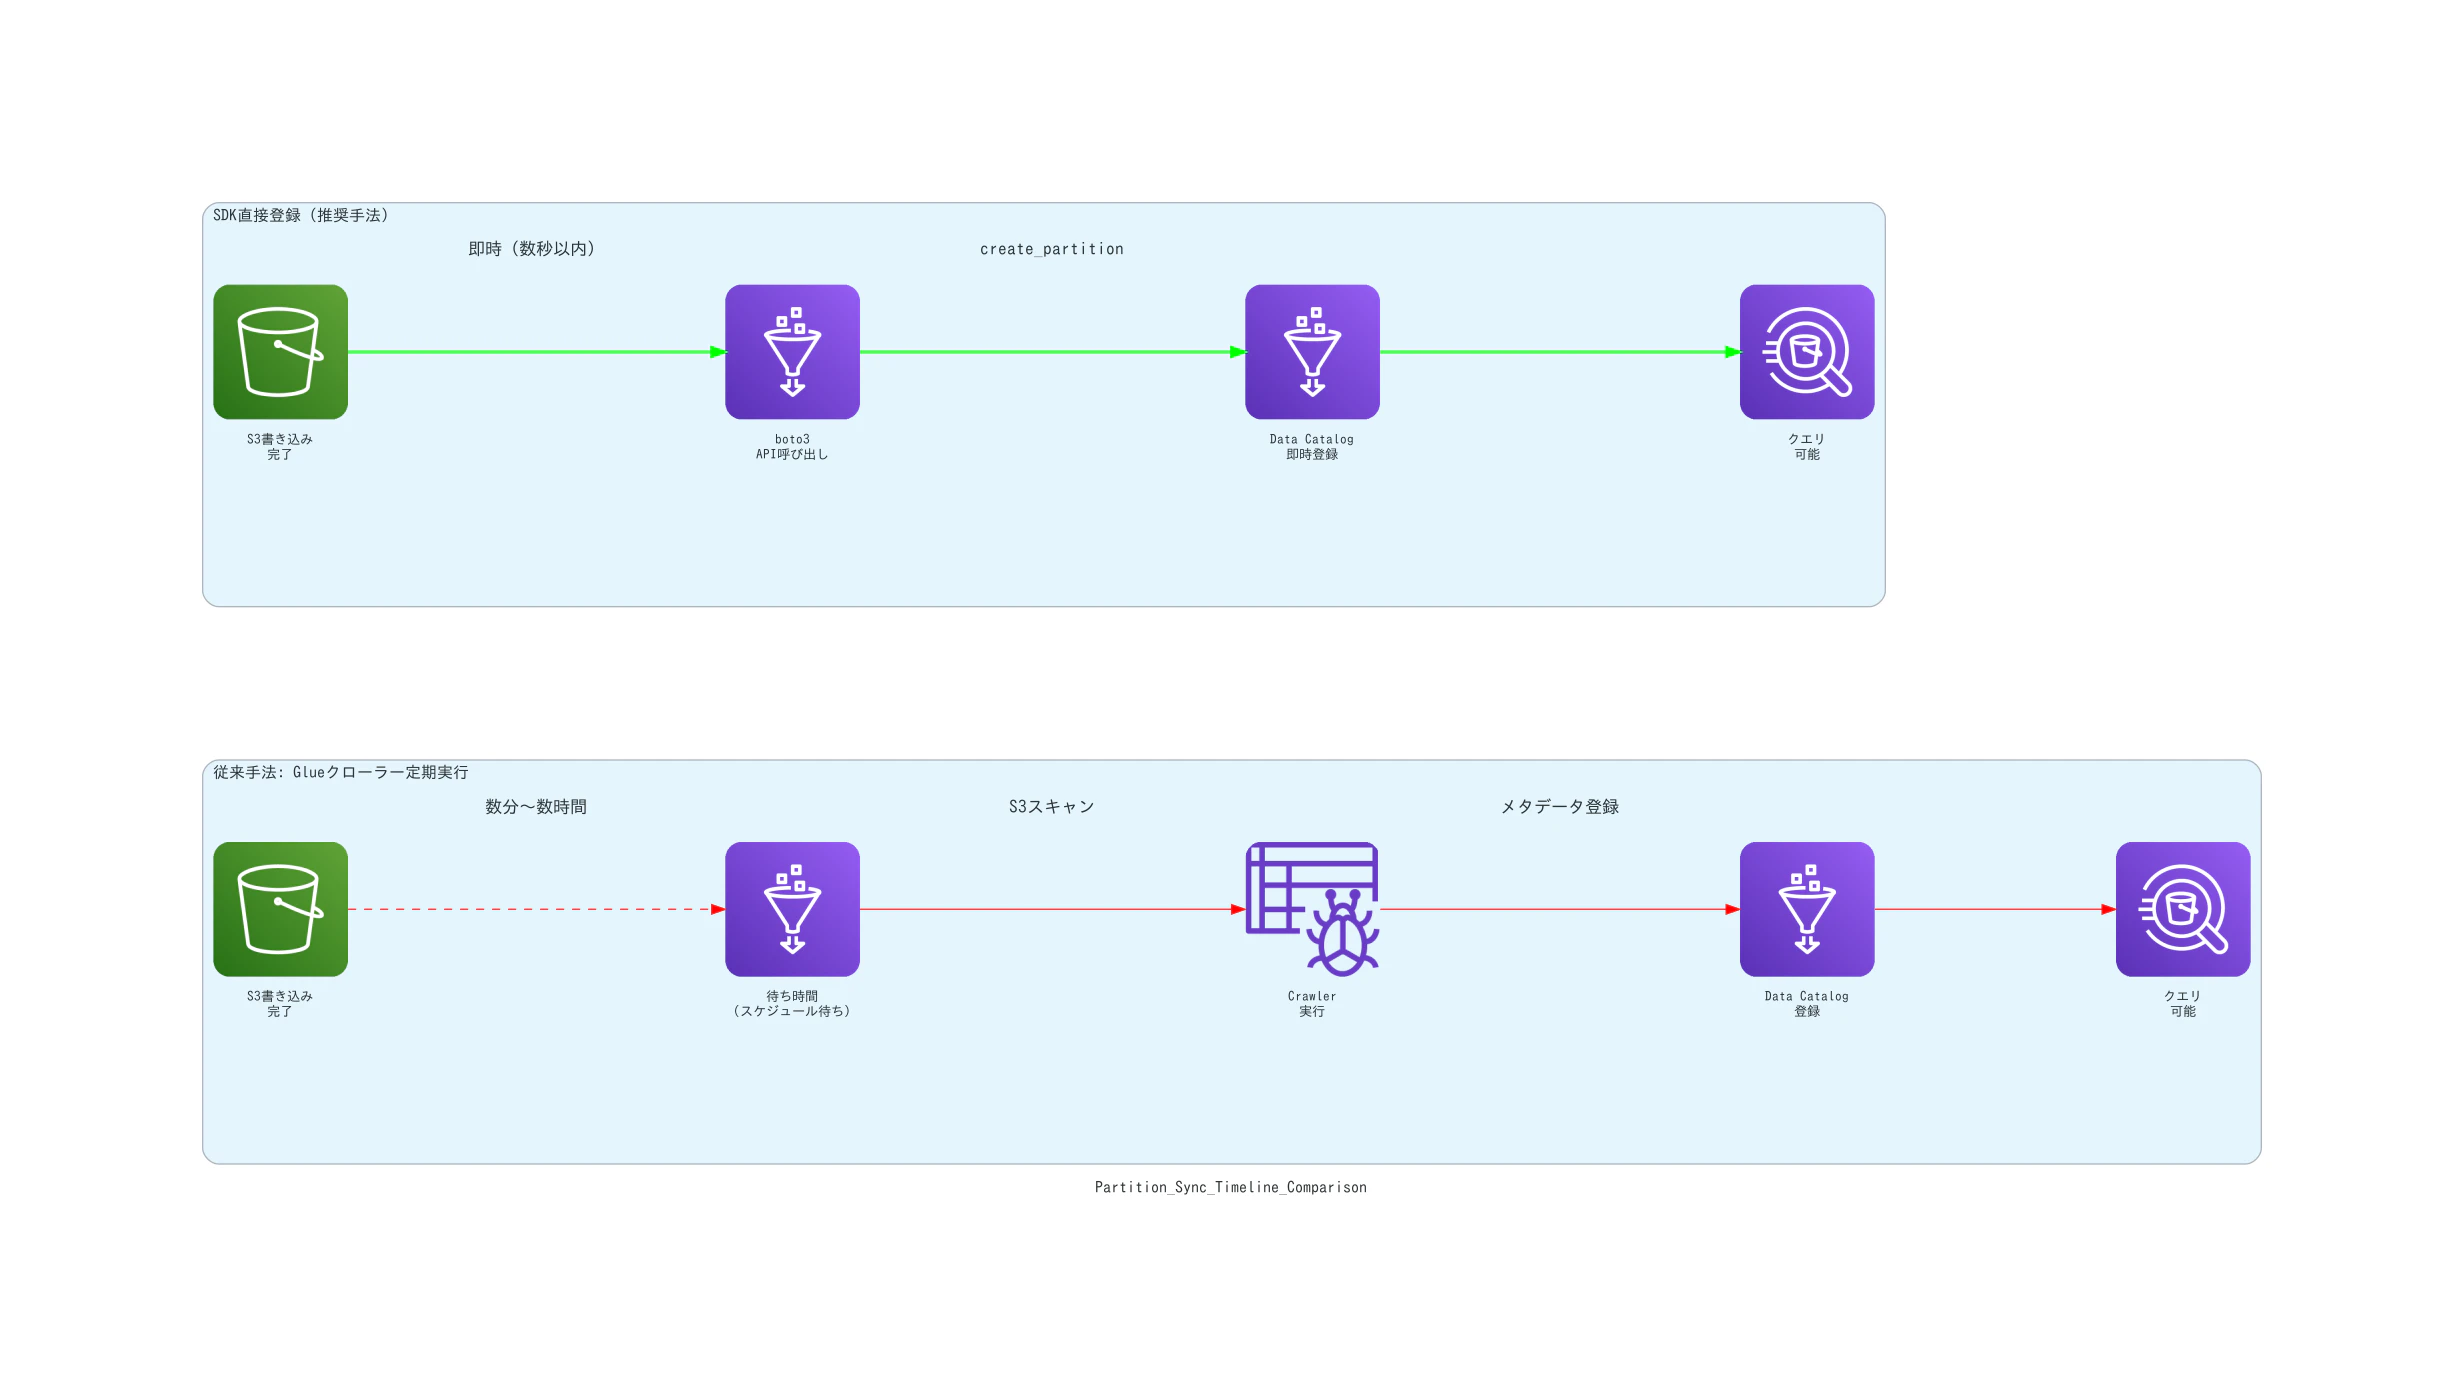
Glueクローラーの定期実行では、スケジュール実行のため新しいパーティションがすぐにクエリ可能にならず、遅延が発生します。また、S3全体をスキャンするためコストも読みにくくなります。
MSCK REPAIR TABLEは、S3バケット全体をスキャンしがちで実行時間が長く、大量のパーティションがある場合は特にパフォーマンスが低下します。
手動でのパーティション登録は、ヒューマンエラーによる抜け漏れが発生しやすく、運用負荷も高くなります。
これらの課題を解決するのが、S3へのデータ書き込み直後にboto3でパーティションをAPIから直接登録する方法です。
なぜSDK直接登録が最速なのか
以下の表は、主要なパーティション同期手法を比較したものです。
| 手法 | レイテンシ | S3スキャン | 運用負荷 | コスト透明性 | 自動化 |
|---|---|---|---|---|---|
| Glueクローラー(定期実行) | 高い(スケジュール待ち) | 全体をスキャン | 中 | 低い | 高い |
| MSCK REPAIR TABLE | 高い(全パーティション走査) | 全体をスキャン | 高い(手動実行) | 低い | 低い |
| 手動CreatePartition | 低い | なし | 非常に高い | 高い | 低い |
| SDK直接登録(本記事) | 最低(即時) | なし | 低い | 高い | 高い |
SDK直接登録が優れている理由は以下の通りです。
- 即時反映: S3書き込み完了直後にパーティション登録するため、待ち時間がほぼゼロです
- S3スキャン不要: パーティションキーとS3パスが確定しているため、探索処理が不要です
- 低コスト: API呼び出しのみで、クローラー実行やS3 ListObjects APIのコストが発生しません
- 自動化が容易: イベント駆動やETLパイプラインに組み込みやすい設計です
実装パターン2選
パターン1: ETL処理からの直接呼び出し
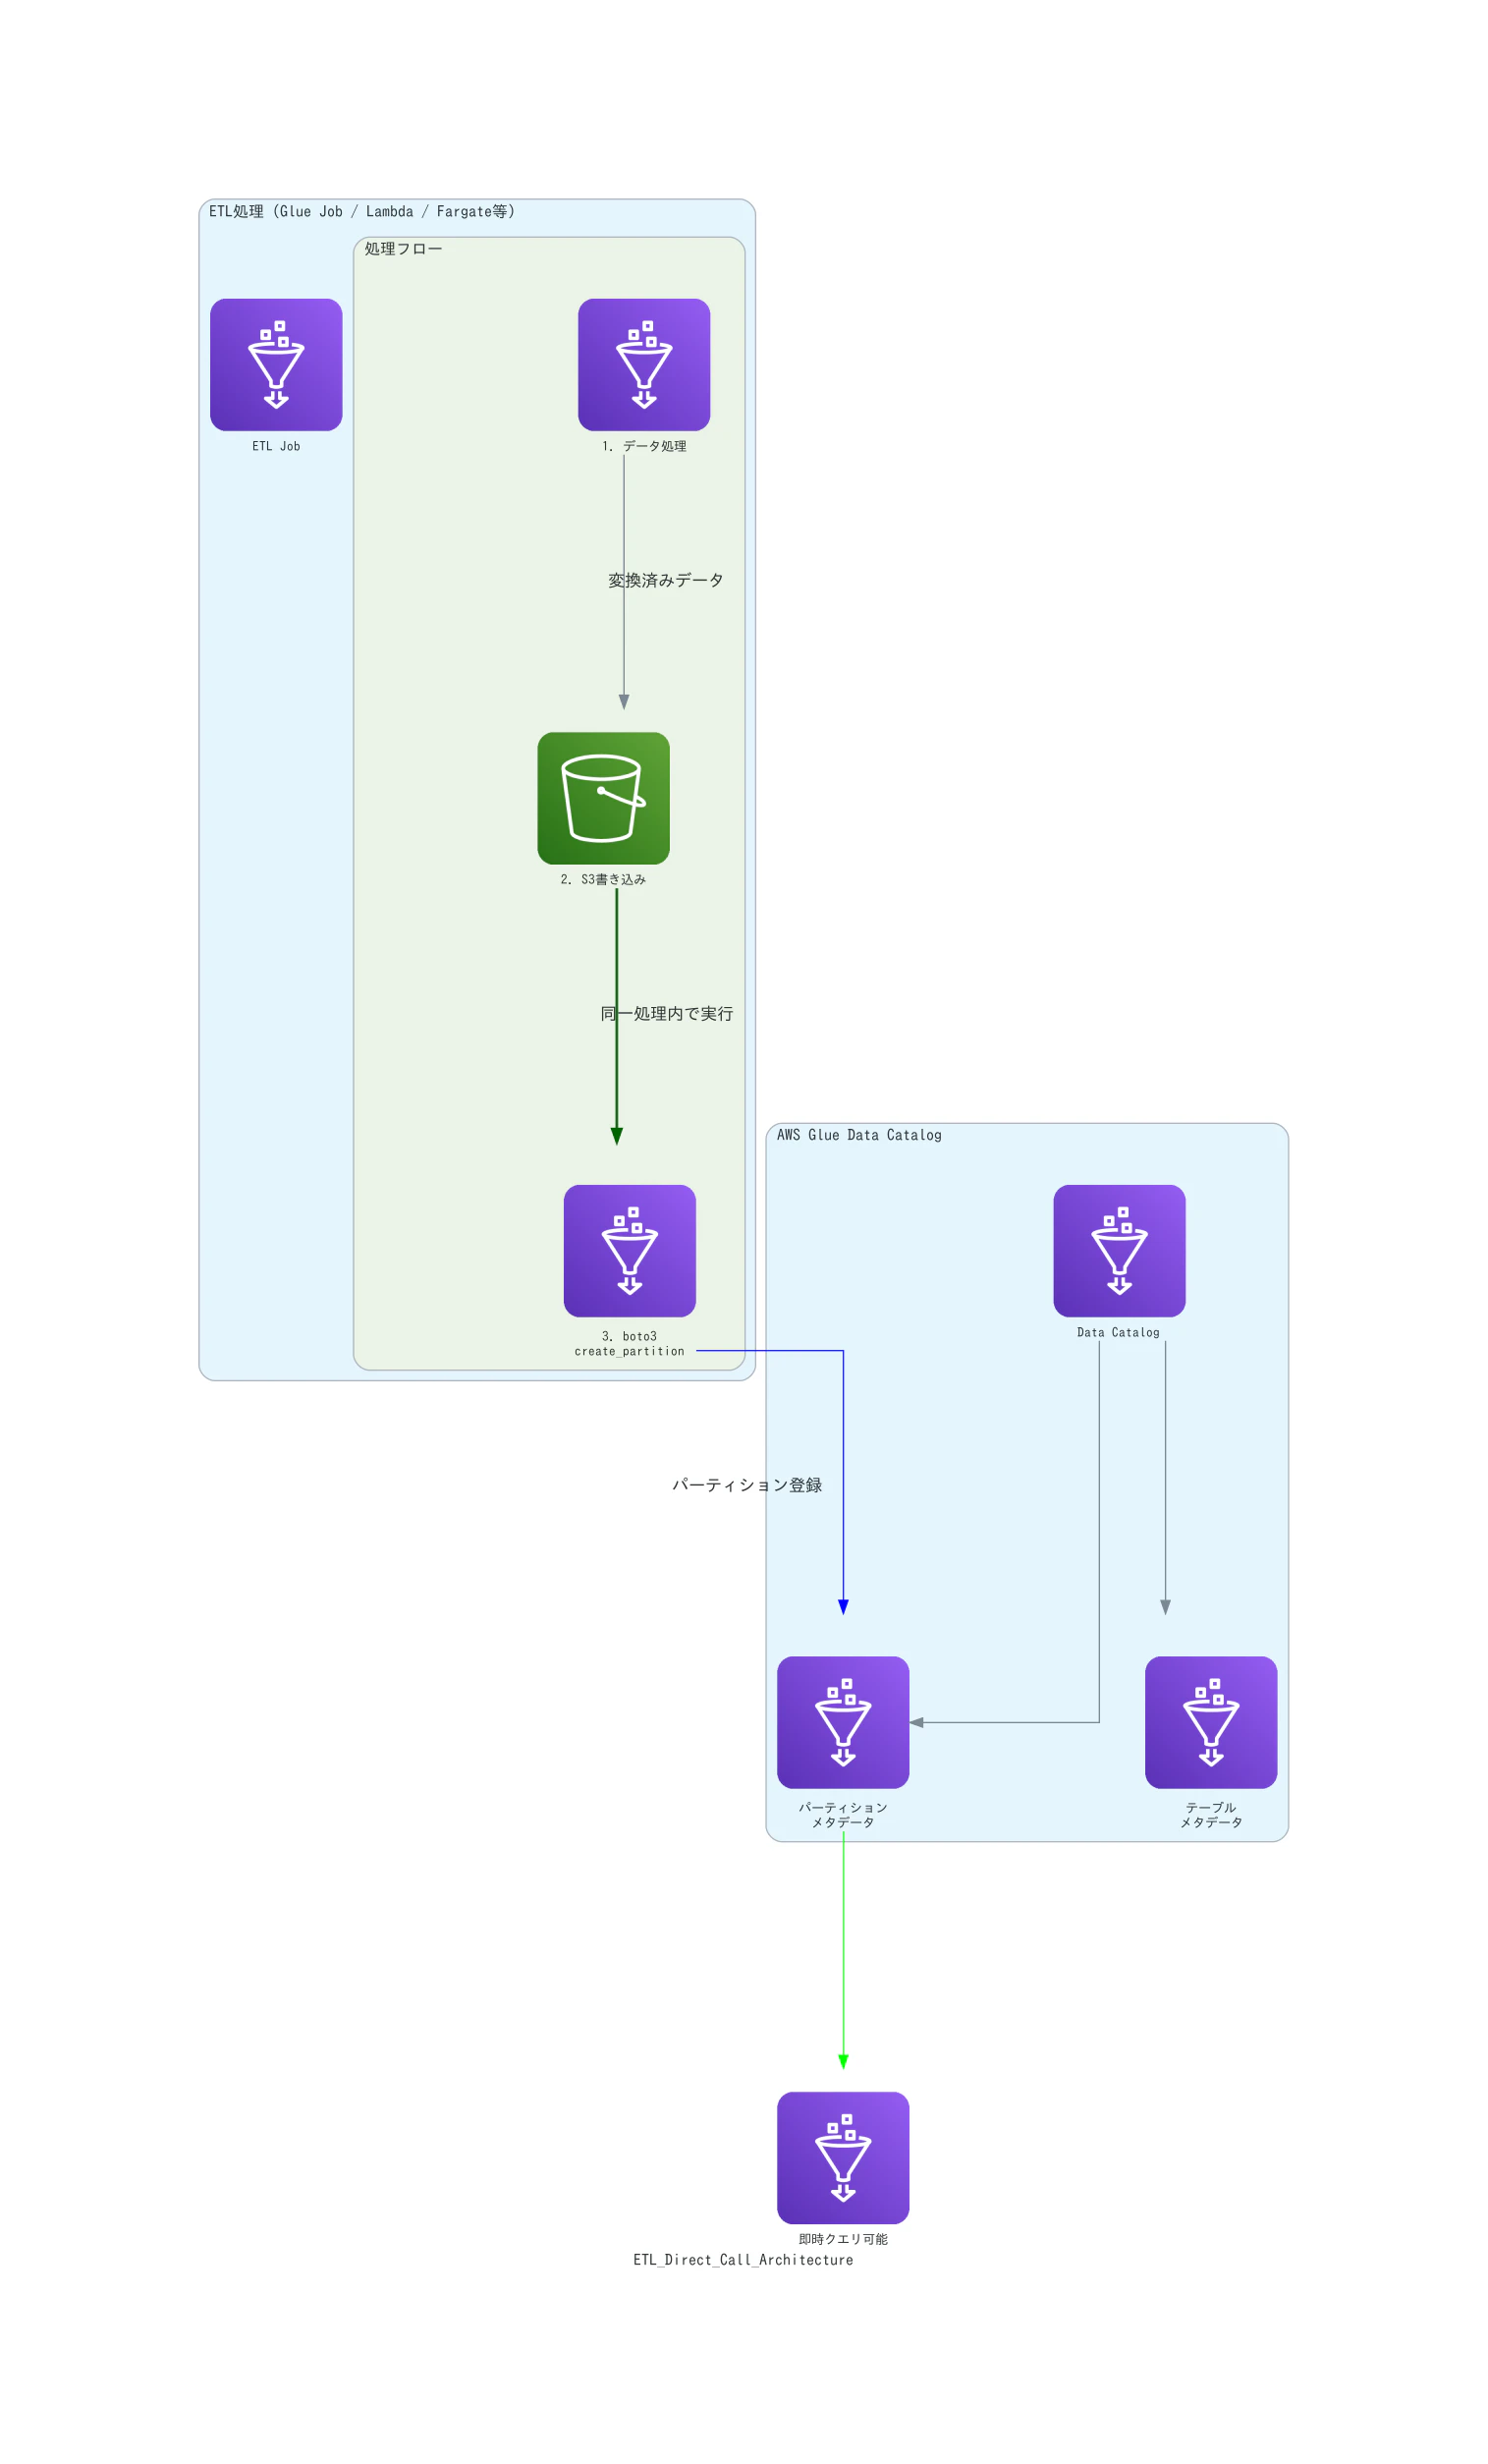
データ投入バッチやETL処理(Glue Job、Lambda、Fargate等)がS3にデータを書き込んだ直後、同じ処理内でboto3を使ってcreate_partitionを呼び出します。
メリット:
- 処理の一貫性が高く、トランザクション的に管理できる
- 追加のインフラが不要でシンプル
デメリット:
- ETL処理がパーティション登録の責任も持つため、コードが肥大化する可能性がある
パターン2: S3イベント駆動(EventBridge + Lambda)
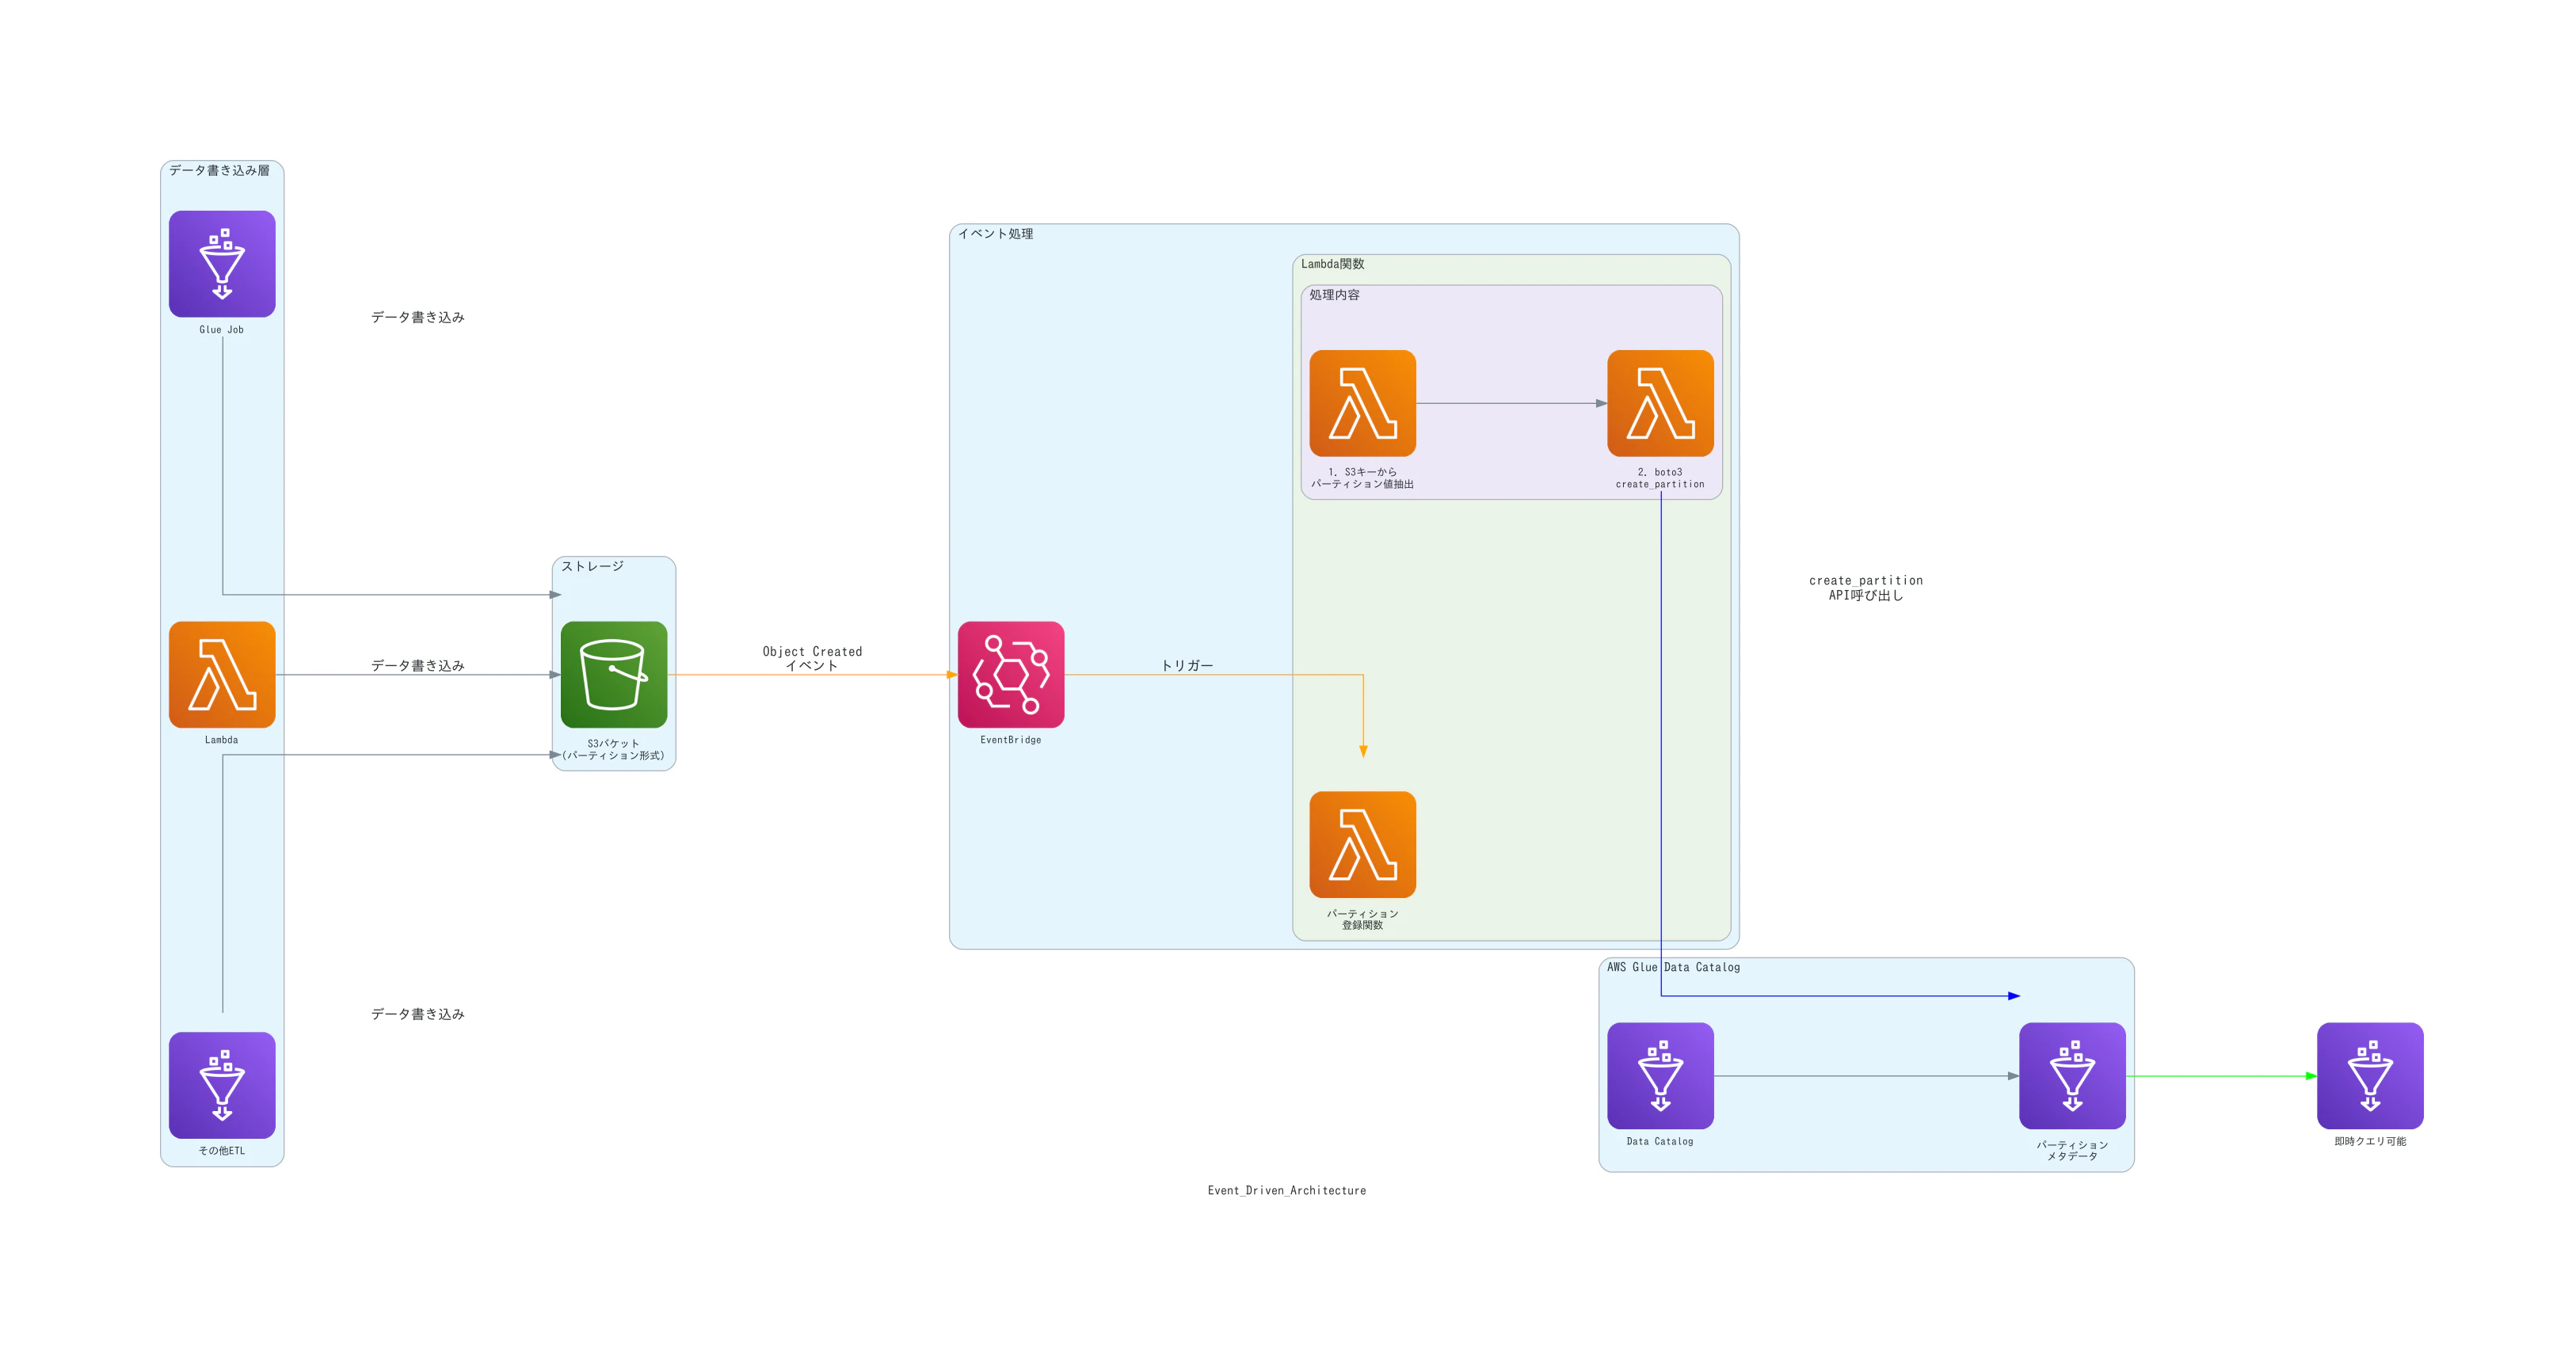
S3のObject Createdイベントを Amazon EventBridgeで受け取り、Lambdaがトリガーされてパーティション登録を行います。
メリット:
- 書き込み元が複数ある場合でも集約して処理できる
- ETL処理とパーティション管理の責任を分離できる
- 拡張性が高く、他の後処理も追加しやすい
デメリット:
- EventBridge、Lambda等の追加リソースが必要
- イベント配信の遅延が若干発生する可能性(通常は数秒以内)
boto3による実装方法
基本的な実装(単一パーティション登録)
以下は、boto3を使って1つのパーティションを登録する基本的な実装例です。
from urllib.parse import urlparse
import boto3

glue = boto3.client("glue", region_name="ap-northeast-1")

def s3_uri_to_path(s3_uri):
    """S3 URIをパスに変換"""
    p = urlparse(s3_uri)
    return f"s3://{p.netloc}/{p.path.lstrip('/')}"

def register_partition(db, table, s3_partition_uri, partition_values):
    """
    パーティションをGlue Data Catalogに登録する

    Args:
        db: データベース名
        table: テーブル名
        s3_partition_uri: パーティションのS3パス(例: s3://bucket/year=2026/month=04/day=14/)
        partition_values: パーティション値のリスト(例: ["2026", "04", "14"])

    Returns:
        "created" または "exists"
    """
    # 1) テーブル定義を取得してStorageDescriptorを継承
    t = glue.get_table(DatabaseName=db, Name=table)["Table"]
    base_sd = t["StorageDescriptor"]

    # 2) 既存チェック(冪等性の確保)
    try:
        glue.get_partition(
            DatabaseName=db,
            TableName=table,
            PartitionValues=[str(v) for v in partition_values]
        )
        return "exists"
    except glue.exceptions.EntityNotFoundException:
        pass

    # 3) StorageDescriptorを継承しつつLocationだけ差し替え
    sd = {k: v for k, v in base_sd.items() if k != "Location"}
    sd["Location"] = s3_uri_to_path(s3_partition_uri)

    # 4) パーティション登録
    glue.create_partition(
        DatabaseName=db,
        TableName=table,
        PartitionInput={
            "Values": [str(v) for v in partition_values],
            "StorageDescriptor": sd
        }
    )
    return "created"

# 使用例
db = "analytics"
table = "events"
s3_part_uri = "s3://analytics-bucket/events/year=2026/month=04/day=14/"
partition_values = ["2026", "04", "14"]

result = register_partition(db, table, s3_part_uri, partition_values)
print(f"Partition {result}")
このコードでは、AWS公式ドキュメント ( https://docs.aws.amazon.com/ja_jp/glue/latest/dg/aws-glue-api-catalog-partitions.html ) に記載されている『CreatePartition』APIを使用しています。
一括登録(batch_create_partition)
複数のパーティションを一度に登録する場合は、batch_create_partitionを使用するとAPI呼び出し回数を削減できます。
def batch_register_partitions(db, table, partitions):
    """
    複数のパーティションを一括登録

    Args:
        db: データベース名
        table: テーブル名
        partitions: [(s3_uri, [year, month, day]), ...] のリスト

    Returns:
        API レスポンス
    """
    t = glue.get_table(DatabaseName=db, Name=table)["Table"]
    base_sd = t["StorageDescriptor"]

    inputs = []
    for s3_uri, values in partitions:
        sd = {k: v for k, v in base_sd.items() if k != "Location"}
        sd["Location"] = s3_uri_to_path(s3_uri)
        inputs.append({
            "Values": [str(v) for v in values],
            "StorageDescriptor": sd
        })

    resp = glue.batch_create_partition(
        DatabaseName=db,
        TableName=table,
        PartitionInputList=inputs
    )
    # resp["Errors"]に AlreadyExistsException等が含まれる可能性があるため確認
    return resp

# 使用例
partitions = [
    ("s3://analytics-bucket/events/year=2026/month=04/day=14/", ["2026", "04", "14"]),
    ("s3://analytics-bucket/events/year=2026/month=04/day=15/", ["2026", "04", "15"]),
]
response = batch_register_partitions(db, table, partitions)
AWS公式ドキュメント ( https://docs.aws.amazon.com/glue/latest/webapi/API_BatchCreatePartition.html ) によると、batch_create_partitionは『最大100個のパーティションを一度に作成できます』。
IAM権限の設定
パーティション登録を実行するIAMロールには、以下の権限が必要です。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "glue:GetTable",
        "glue:CreatePartition",
        "glue:BatchCreatePartition",
        "glue:GetPartition"
      ],
      "Resource": [
        "arn:aws:glue:ap-northeast-1:123456789012:catalog",
        "arn:aws:glue:ap-northeast-1:123456789012:database/analytics",
        "arn:aws:glue:ap-northeast-1:123456789012:table/analytics/*"
      ]
    }
  ]
}
Lake Formationを使用している場合は、Lake Formation側のデータカタログ権限(テーブル権限、Data location permissions)も合わせて設定する必要があります。
実装時の重要ポイント
冪等性の確保
パーティション登録処理は冪等(何度実行しても同じ結果になる)にする必要があります。上記のコード例では、get_partitionで既存チェックを行い、既に存在する場合は登録をスキップしています。
別のアプローチとして、AlreadyExistsExceptionを無視する方法もあります。
try:
    glue.create_partition(
        DatabaseName=db,
        TableName=table,
        PartitionInput=partition_input
    )
except glue.exceptions.AlreadyExistsException:
    # 既に存在する場合は無視
    pass
パーティション値の型変換
パーティション値は必ず文字列で渡す必要があります。数値や日付オブジェクトをそのまま渡すと、型不一致エラーが発生します。
# 正しい例
partition_values = ["2026", "04", "14"]

# 誤った例(数値を渡すとエラー)
partition_values = [2026, 4, 14]  # NG
S3パスの形式
パーティションのS3パスは、Hiveスタイル(year=2026/month=04/day=14/)に従うことを推奨します。また、Glueテーブル定義のパーティションキーの順序と、S3パスおよびpartition_valuesの順序は一致させる必要があります。
運用上の注意点とベストプラクティス
APIレート制限への対処
Glue APIには呼び出しレート制限があります。大量のパーティションを短時間に登録する場合は、batch_create_partitionを使用し、必要に応じて指数バックオフでリトライ処理を実装してください。
S3イベントの考慮
S3の"フォルダ作成"イベントは発火しないため、実際のオブジェクト(ファイル)の作成をトリガーにする必要があります。空のパーティションフォルダだけでは、EventBridgeイベントは発生しません。
コスト比較
2026年4月時点の東京リージョン(ap-northeast-1)における料金は以下の通りです。
Glue Data Catalog:
- 最初の100万オブジェクトまで無料
- 以降、10万オブジェクトあたり月額1.00 USD
- 最初の100万アクセスまで無料
Glueクローラー:
- 1 DPU時間あたり0.44 USD
- 最低10分から課金
API呼び出し(create_partition):
- Data Catalogへのアクセスとしてカウントされ、月間100万アクセスまで無料
詳細な料金情報は、AWS公式の料金ページ ( https://aws.amazon.com/glue/pricing/ ) をご確認ください。料金は変動する可能性がありますのでご注意ください。
SDK直接登録では、クローラー実行コストやS3 ListObjects APIコストが不要になり、透明性の高いコスト構造を実現できます。
エラーハンドリング
失敗時の再試行戦略として、指数バックオフを実装することを推奨します。
import time
from botocore.exceptions import ClientError

def register_with_retry(db, table, s3_uri, values, max_retries=3):
    """リトライ機能付きパーティション登録"""
    for attempt in range(max_retries):
        try:
            return register_partition(db, table, s3_uri, values)
        except ClientError as e:
            if e.response['Error']['Code'] == 'ThrottlingException':
                wait_time = (2 ** attempt) + (random.randint(0, 1000) / 1000)
                time.sleep(wait_time)
            else:
                raise
    raise Exception(f"Failed after {max_retries} retries")
終わりに
S3へのデータ書き込み直後にboto3でcreate_partition APIを呼び出すイベント駆動アプローチは、パーティション同期の遅延を最小化し、運用負荷とコストを削減できる最適な方法です。
ETL処理からの直接呼び出しまたはEventBridge + Lambdaによるイベント駆動の2つの実装パターンから、要件に応じて選択できます。冪等性の確保、パーティション値の文字列変換、エラーハンドリングなどの実装ポイントを押さえることで、本番環境でも安定した運用が可能です。
次のステップ
Athenaのみが利用者で、パーティション構造が予測可能な場合は、Partition Projectionの利用も検討する価値があります。Partition Projectionを使用すると、AWS公式ドキュメント ( https://docs.aws.amazon.com/athena/latest/ug/partition-projection.html ) によれば『Athenaはパーティション値と場所をテーブルプロパティから計算するため、Data Catalogのパーティション登録自体が不要になります』。
ただし、Partition ProjectionはAthena専用の機能であり、Glue JobsやSpark等の他のツールがData Catalogのパーティション一覧に依存する場合は、本記事で紹介したSDK直接登録の方が適しています。
参考文献・参考サイト
- 「パーティション API」AWS Glue Documentation, https://docs.aws.amazon.com/ja_jp/glue/latest/dg/aws-glue-api-catalog-partitions.html
- 「BatchCreatePartition」AWS Glue Web API Reference, https://docs.aws.amazon.com/glue/latest/webapi/API_BatchCreatePartition.html
- 「CreatePartition」AWS Glue Web API Reference, https://docs.aws.amazon.com/glue/latest/webapi/API_CreatePartition.html
- 「Use partition projection with Amazon Athena」Amazon Athena User Guide, https://docs.aws.amazon.com/athena/latest/ug/partition-projection.html
- 「AWS Glue の料金」AWS, https://aws.amazon.com/glue/pricing/
- 「データカタログにアクセスする」AWS Glue Documentation, https://docs.aws.amazon.com/ja_jp/glue/latest/dg/access_catalog.html