
📚 参考書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は書籍の中でまとめているので、気になる方はそちらもどうぞ。
『ゼロから触ってわかった!いまのDatabricks AIがわかる本 ― 機械学習、RAG、Agent、Lakebase、Databricks Apps― 』
Databricksでの プロンプト設計・RAG構築・モデル管理・ガバナンス を扱うAIエンジニアの入門決定版。
生成AIとデータエンジニアリングの橋渡しに必要な“実務の型”を体系化しています。
資格本ではなく、実務基盤としてAIを運用する力 を育てる内容です。
https://link.amazon/B0eKLGVSk
####『ゼロから触ってわかった!AI Agent Observability入門― MLflow・Databricksで実践するAIエージェントの評価・監視・安全性・説明可能性』
本書は、AI Agentを「作って動かす」だけでなく、その品質をどう観測し、どう評価し、どう守り、どう説明可能にするかを体系的に学ぶための入門書です。
https://link.amazon/B04VaTlR3
Databricks AI Functionsとは?SQL・DataFrameからLLMを呼び出す基本
12-1. AI Functionsの全体像
これまでの章では、チャットやAgentのように、利用者からの質問へモデルが回答するオンライン処理を扱ってきました。
一方、企業が保有するテーブルには、問い合わせ文、レビュー、議事録、契約書、商品説明など、多くの文章データが保存されています。
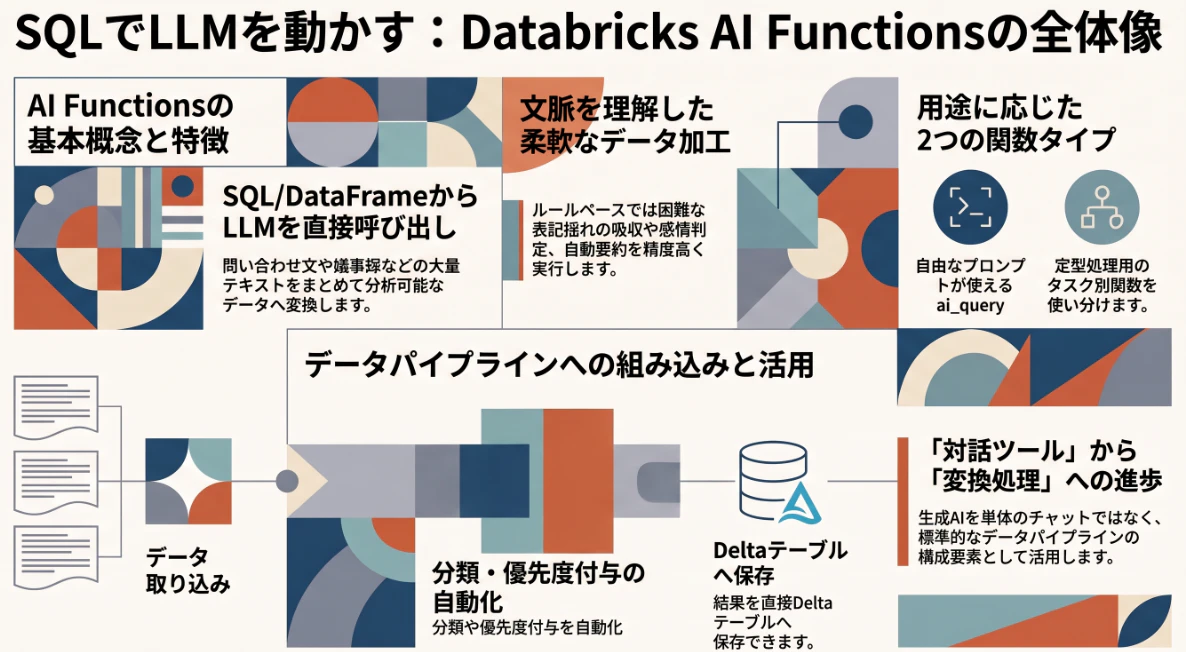
これらを1件ずつ画面からモデルへ入力するのではなく、SQLやDataFrameの処理としてまとめて加工する仕組みがAI Functionsです。
AI Functionsとは
AI Functionsは、DatabricksのSQLやPythonから大規模言語モデルを呼び出すための関数です。
通常のSQL関数では、文字列の結合、日付変換、集計など、あらかじめ決められた処理を実行します。
AI Functionsでは、LLMの文章理解能力をデータ変換に利用します。
例えば、テーブルに保存された問い合わせ文に対して、次のような処理を実行できます。
- 長い文章を要約する
- 日本語から英語へ翻訳する
- 問い合わせ内容を分類する
- 肯定的・否定的などの感情を判定する
- 氏名、日付、商品名などを抽出する
- 検索用の文章や説明文を生成する
つまり、LLMをチャット相手として利用するだけでなく、テーブルの列を変換する関数として利用する考え方です。
SQL処理へ生成AIを組み込む
AI Functionsは、通常のSQL関数と同じようにSELECT文の中で利用できます。
例えば、問い合わせテーブルのmessage列をモデルへ渡し、要約結果を新しい列として取得します。
SELECT
inquiry_id,
message,
ai_query(
'databricks-meta-llama-3-3-70b-instruct',
CONCAT(
'次の問い合わせを100文字以内で要約してください。',
message
)
) AS summary
FROM inquiries;
この処理では、各レコードのmessageがモデルへ渡され、生成された要約がsummary列として返されます。
生成結果は、通常のSQLと同様にテーブルへ保存したり、別の処理へ渡したりできます。
DataFrame処理でも利用できる
AI Functionsは、PySpark DataFrameの処理にも組み込めます。
[
from pyspark.sql import functions as F
result_df = source_df.withColumn(
"summary",
F.expr("""
ai_query(
'databricks-meta-llama-3-3-70b-instruct',
concat(
'次の文章を要約してください。',
message
)
)
""")
)
]
これにより、Pythonでデータ加工を行いながら、一部の列だけをLLMで変換できます。
既存のSpark処理を大きく変更せず、生成AIによる要約、分類、情報抽出などを追加できる点が特徴です。
ai_queryとタスク別関数
AI Functionsには、モデルへ任意のプロンプトを渡す汎用的なai_queryがあります。
ai_queryでは、利用するモデル、プロンプト、モデルパラメータ、戻り値の形式などを指定できます。
このほか、用途が決まっている処理では、要約、分類、情報抽出などのタスク別AI Functionsを利用できる場合があります。
自由度の高い処理にはai_query、定型的な処理にはタスク別関数というように使い分けます。
データパイプラインへ組み込む
AI Functionsは、Notebookで試すだけでなく、Databricks Workflows、Lakeflow Pipelines、Structured Streamingなどへ組み込めます。
例えば、次のようなパイプラインを構築できます。
1. 新しい問い合わせデータを取り込む
2. AI Functionsで内容を分類する
3. 優先度や担当部署を付与する
4. 結果をDeltaテーブルへ保存する
5. ダッシュボードや業務システムから利用する
このように、データの取り込みからAI処理、保存、活用までをDatabricks上でつなげられます。
通常のデータ変換との違い
従来のルールベース処理では、「この単語が含まれていれば返品」「評価が1なら否定的」といった条件を細かく定義します。
AI Functionsでは、文章全体の意味や文脈をLLMに判断させます。そのため、表現の揺れが大きい問い合わせや文書にも対応しやすくなります。
ただし、生成結果は常に同じとは限らず、誤った回答が含まれる可能性もあります。
そのため、実務では対象行の絞り込み、出力形式の固定、結果の検証、エラー時の再処理、トークンコストの管理が必要です。
整理すると、AI Functionsは、SQLやDataFrameの中からLLMを呼び出し、非構造化データを分析可能なデータへ変換する仕組みです。
生成AIを独立したチャット機能としてではなく、データパイプラインを構成する変換処理として利用できることが、AI Functionsの重要な特徴です。