
📚 参考書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は書籍の中でまとめているので、気になる方はそちらもどうぞ。
「ゼロから触ってわかった!Codex - AIエージェント時代のソフトウェア設計」
本書は、AIエージェントと共に開発する時代において、エンジニアが思考停止せず、主体的に価値を発揮し続けるための指針を提示します。
ツールの使い方ではなく、これからの開発の本質を理解したいすべてのエンジニアへ。
https://amzn.to/4o0repH
####『ゼロから触ってわかった!AI Agent Observability入門― MLflow・Databricksで実践するAIエージェントの評価・監視・安全性・説明可能性』
本書は、AI Agentを「作って動かす」だけでなく、その品質をどう観測し、どう評価し、どう守り、どう説明可能にするかを体系的に学ぶための入門書です。
https://link.amazon/B04VaTlR3
LLM-as-a-Collaborator入門:AIを「回答者」ではなく共同設計者として使う
AIは「回答者」ではなく共同設計者になる
AIとの協働で価値があるのは、完成したコードを受け取ることだけではありません。
Specや設計案を渡し、
- 矛盾や抜け漏れを探す
- 別の設計案を提示する
- トレードオフを比較する
- 検証方法を提案する
といった作業にも利用できます。
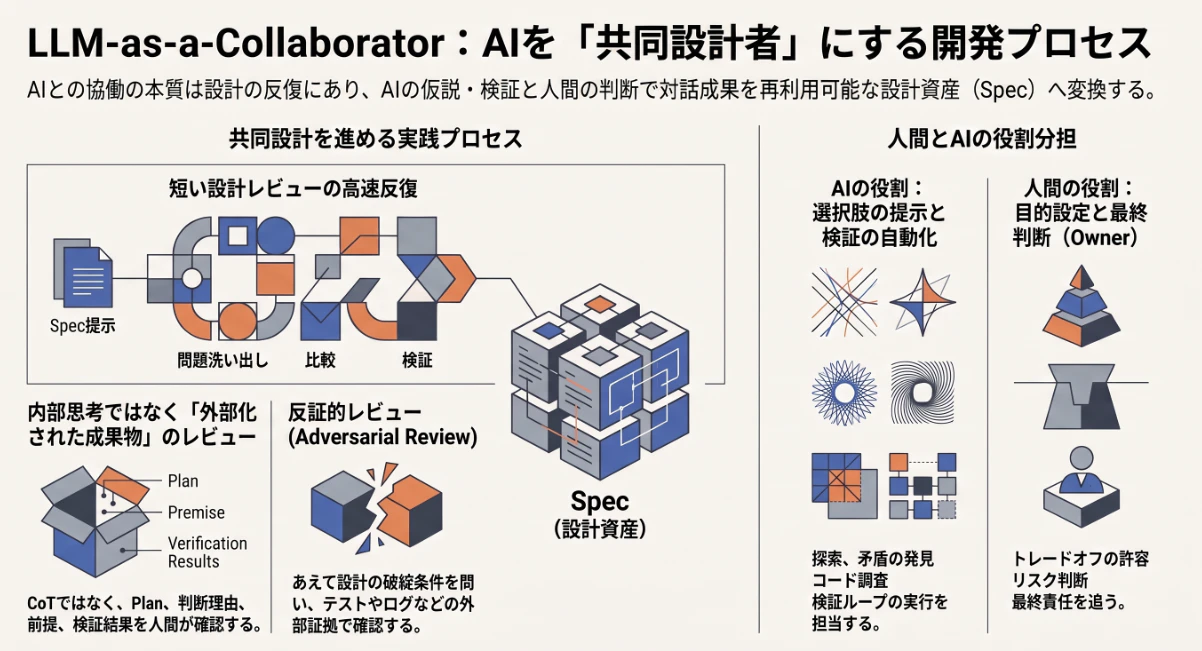
つまりAIを「答えを知っている存在」として使うのではなく、仮説を出し、設計を批判し、検証を支援する共同設計者として利用します。
初版でも、Specを提示し、AIから指摘を受け、人間が修正し、再び検証する反復を重視しました。この考え方自体は現在も有効です。
最初から正解を求めず、設計を反復する
設計は一度のプロンプトで完成させる必要はありません。
まず暫定的な案を作り、AIとの対話を通じて改善します。
たとえば、
Specを提示する
→ 問題点を洗い出す
→ 複数案を比較する
→ Specを修正する
→ 実装・検証する
→ 結果を設計へ戻す
という流れです。
重要なのは、AIの最初の提案を採用することではありません。
設計案を一つの仮説として扱い、反証や実行結果を使って徐々に収束させます。
この意味で、LLMとの対話は「質問と回答」よりも、短い設計レビューを何度も回す作業に近くなります。
内部思考ではなくPlanと判断根拠を見る
ここで、初版から修正すべき重要な点があります。
推論モデルに対して、内部の思考過程を詳細に出力させ、それをレビューすることを共同設計の中心に置くべきではありません。
OpenAIの推論モデルでは、生のReasoning Tokensは利用者へ公開されません。また、推論モデルへの指示でも「step by stepで考えて」と内部推論を細かく指定する必要はなく、Goal、制約、Done条件を明確にする方が推奨されています。
人間が確認すべきなのは、内部思考ではなく外部化された設計情報です。
たとえば、
- Plan ― どの順序で進めるのか
- 判断理由 ― なぜその案を採用したのか
- 前提 ― 何を事実として扱っているのか
- 根拠 ― どのコードや資料を参照したのか
- 検証結果 ― テストや実行で何が確認できたのか
です。
これはChain of Thoughtを読むこととは異なります。
判断をレビューできるだけの説明と証拠を成果物として残すことが重要なのです。
あえて反対側から設計を壊してみる
共同設計では、AIを賛成役としてだけ使わないことも重要です。
一度作った設計に対して、
- この設計が破綻する条件は何か
- 最も危険な前提は何か
- 別案の方が有利になる条件は何か
- セキュリティや運用上の弱点は何か
と問い直します。
初版ではこれを「あえて壊させる」と表現しました。
第2版では、これを**Adversarial Review(反証的レビュー)**として位置づけます。
ただし、AIが指摘した問題をそのまま事実とは扱いません。重要な指摘はコード、ドキュメント、テスト、ベンチマークなどの外部証拠で確認します。
設計の議論を実際の検証へ接続する
Codexを共同設計者として使う利点は、議論だけで終わらないことです。
たとえば「この変更は既存APIを壊す可能性がある」という懸念が出たなら、
- 影響する呼び出し元を検索する
- 既存テストを実行する
- 契約テストを追加する
- 実際のレスポンスを比較する
ところまで進められます。
Codexは作業内容を、引用、ターミナルログ、テスト結果などによって人間が確認できるよう設計されており、OpenAIもAgent生成コードは統合前に人間がレビュー・検証することを推奨しています。
つまり共同設計とは、会話で説得力のある案を作ることではありません。
設計上の主張を、実際に検証可能な問いへ変えることです。
対話から得た知識をSpecへ戻す
対話中に得られた重要な判断を、チャットの中だけに残してはいけません。
たとえば、
「互換性を維持する必要がある」
「このDBは変更しない」
「このテストをDone条件にする」
と決まったなら、Specやその他の適切な設計資産へ反映します。
そうしなければ、新しいSessionや別のAgentでは同じ前提が失われます。
AIとの対話は、一時的な会話ではなく、暗黙知を明示的な設計資産へ変換するプロセスとして利用します。
人間とAIでは責任が異なる
共同設計だからといって、人間とAIが同じ責任を持つわけではありません。
AIが得意なのは、
- 多くの選択肢を短時間で出す
- 矛盾やエッジケースを探す
- コードベースを横断して調査する
- 検証を繰り返す
ことです。
一方、人間は、
- 何を目的とするか
- どのトレードオフを許容するか
- どのリスクを受け入れるか
- 最終的に何を採用するか
を判断します。
Agentの自律性が高まっても、この最終的なOwnerの役割は残ります。
LLM-as-a-Collaboratorとは、AIに設計判断を丸投げすることではありません。
AIに案を出させ、反証させ、根拠と検証結果を集め、人間が判断できる状態を作ることです。
その過程で得られた知識をSpecやルールへ戻すことで、対話そのものが次の開発を改善する設計資産へ変わっていきます。
次節では、こうして得られた情報をDesign Doc、Goal、AGENTS.md、Skillsのどこへ配置すべきか、それぞれの役割分担を整理します。