
はじめに
前回の記事では、Google の Gemma 4 E4B を土台に、frontier LLM の精度と Jev の速さを持つ 4B の判定モデル Reflex-1 を作りました。
Reflex-1 が扱うのは、文章と画像です。今回はその続きとして、動画と音に取り組みました。見守りカメラに映った人が転んだ、防犯カメラに異常が映った、ガラスが割れる音がした。こうした現場で起きたことを、映像を外に出さずに、手元の機器でその場で判定できないか、という問いです。
前回の記事の最後に、各企業が自分たちの目的に合ったモデルを自分で作り、運用できるようにしたい、と書きました。今回は、現場の映像や音をお手本にして、判定を数分で作れる形にしています。土台には、Google が 2026 年 10 月 6 日に公開したばかりの EmbeddingGemma 2 を使いました。
課題
見守りカメラの転倒、防犯カメラの異常、ガラスの割れる音などを AI で判定したいとします。Gemini などの frontier LLM は動画を読めますが、1 回の判定に数秒から十数秒かかり、映像をクラウドに送る必要があります。判定専用 AI の Jev は速いものの、動画を読めません。どちらも重みが公開されていないため、現場の映像や音で学習させることもできません。
解決策
Google が公開した検索用のオープンモデル EmbeddingGemma 2(7.4 億パラメータ)を土台に、判定したいことのお手本を見せて学習させ、動画と音を判定する Reflex-2 を作りました。学習は判定ごとに数分で終わり、カメラの映像を流し見しながら判定できます。問い合わせの形式は Jev と同じです。
成果
| Gemini 3.8 Flash | Reflex-2 | |
|---|---|---|
| 転倒の判定(同じ 40 本) | 85.0% / 1 回 6.95 秒 | 97.5% / 1 回 0.28 秒 |
| 音 10 種の判定(同じ 40 本) | 85% / 1 回 3.66 秒 | 100% / 1 回 0.049 秒 |
| 防犯カメラの判定(同じ 40 本) | 95% / 1 回 16.1 秒 | 95% / 1 回 1.4 秒 |
| 見守りの流し見: 転んでから気づくまで | 8.3 秒、または見逃し | 1.2〜2.1 秒 |
| 重み / 手元で動くか | 非公開 / クラウドのみ | 1.5 GB / スマホで動く大きさ |
開発は GPU 1 台で 2 日、外部の費用は比較用の API 代 約 $1.3 でした。
コードと判定器は公開しています。
- GitHub: https://github.com/matu79go/reflex-2
- Hugging Face: https://huggingface.co/matu79go/Reflex-2
- Colab: https://colab.research.google.com/github/matu79go/reflex-2/blob/main/notebooks/quickstart.ipynb
下の 2 本は、Reflex-2 と Gemini 3.8 Flash に同じ映像・同じ音を判定させ、答えるまでの速さと正しさを比べた動画です。
動画 1: 家の中で人が転んだとき、何秒で気づけるか

「転んだ!」の瞬間から時計が動きます。Reflex-2 は転んでから 1〜2 秒でキャッチしました。Gemini は 1 回の判定に 4〜8 秒かかり、8 秒後にキャッチするか、3 場面中 2 場面で見逃しました(動画の全編)。
動画 2: 泣き声やガラスの割れる音を、聞いてすぐ聞き分けられるか

Reflex-2 は 0.05〜0.09 秒で 4 本とも正解しました。Gemini は 3〜10 秒かかり、ガラスを「足音」、目覚ましを「サイレン」と答えました(GIF なので音は出ません。音つきの動画)。
Reflex-2 とは
Reflex-2 は、Google の EmbeddingGemma 2 を土台に、動画と音を判定できるように改良したオープンモデルです。見守りカメラの転倒、防犯カメラの異常、泣き声やガラスの割れる音など、現場で起きたことを一瞬で見分けます。
土台の EmbeddingGemma 2 は、Google が 2026 年 10 月 6 日に Apache 2.0 で公開した、文字・画像・動画・音を同じ 768 次元のベクトルに変える検索用のモデルです。
- 発表: https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
- 開発者向けガイド: https://developers.googleblog.com/embeddinggemma-2-the-developer-guide/
- 重み: https://huggingface.co/google/embeddinggemma-2
| 項目 | 中身 |
|---|---|
| 大きさ | 740M(文字 270M、画像・動画 170M、音 300M)。使わない部分は外して読み込める |
| 出力 | 768 次元のベクトル 1 本(512・256・128 に切り詰め可) |
| 動画 | 1 秒 1 コマ、最大 32 コマ(長い動画は均等に間引く)。1 コマは標準 140 トークン(max_soft_tokens、70〜1,120) |
| 音 | 16 kHz モノラル。40 ms で 1 トークン |
| 文脈 | 8,192 トークン(全モダリティの合計) |
| 実行 | sentence-transformers 6.1 以降、Transformers、vLLM、LiteRT など |
スマホやノート PC で動くように作られています。ただし本来は「似たものを探す」ためのモデルで、素のままでは判定にはほとんど使えません(後述の表で、転倒は 53.8% = ほぼ当てずっぽう)。これを判定に使えるようにしたのが Reflex-2 です。
何がすごいのか
判定専用 AI の Jev は速いけれど、動画を読めません。Gemini などの frontier LLM は動画を読めるけれど、1 回の判定に数秒から十数秒かかり、映像をクラウドに送る必要があります。Reflex-2 は、動画を Jev のような一瞬の速さで、frontier LLM と同等以上の精度で、スマホで動く大きさで判定します。
| 数字 | 意味 |
|---|---|
| 約 2 秒 | 転んでから知らせるまで。Gemini 3.8 Flash は 8 秒、または見逃し |
| 25× | Gemini より速い動画の判定(1 回 0.28 秒 対 6.95 秒)。音は 75 倍(0.05 秒 対 3.66 秒) |
| 97.5% · 100% | 転倒・音の正答率。同じ問題で Gemini は 85%・85% |
| 0.7B · 1.5 GB | スマホで動く大きさの公開の重み。映像はクラウドに出さない。1 回の料金なし |
もう 1 つの特長は、現場の判定を、お手本から数秒で作れることです。転倒・侵入・ガラスの音など、判定したいことのお手本を数十本見せれば、その場で判定器ができます。重みが公開されていない Jev や frontier LLM には、自分の現場の映像や音で判定を学習させることはできません。
どのように動画判定モデルにしたか
今回は、ロジスティック回帰で学習させました。新しいのは、土台が動画と音を 1 本のベクトルにでき、しかもスマホで動く大きさだという点です。
動画(1 秒 1 コマ)/ 音(16 kHz)
   │  EmbeddingGemma 2(重みは固定。触らない)
   ▼
768 次元のベクトル 1 本
   │  判定器 = ロジスティック回帰(W: 768 × ラベル数、b)
   ▼
各ラベルの確率(転倒 97% など)
本体は reflex2/model.py の 1 ファイルです。順に見ていきます。
1. 動画からコマを取る(PyAV)
sentence-transformers に動画のパスを渡すと、内部で torchcodec を使ってデコードしようとします。torchvision 0.26 で read_video が消えたため、torchcodec が入っていない環境では ImportError になります。開発機(aarch64)ではここでつまずいたので、PyAV で必要なコマだけを取り出し、配列で渡しています。
def video_frames(path: str, fps: float = 1.0, max_frames: int = 32, start: float = 0.0, end: float | None = None) -> np.ndarray:
    """Frames sampled evenly over [start, end] at `fps`, at most `max_frames` (the model's default video budget).

    Returns uint8 [N, H, W, 3]. Decoding keeps only the frames it needs."""
    import av

    with av.open(path) as c:
        st = c.streams.video[0]
        st.thread_type = "AUTO"
        dur = float(st.duration * st.time_base) if st.duration else float(c.duration / 1e6)
        end = dur if end is None else min(end, dur)
        span = max(end - start, 1e-3)
        n = max(1, min(max_frames, int(span * fps)))
        want = list(start + np.linspace(0, span, n, endpoint=False) + span / n / 2)
        out, last = [], None
        for f in c.decode(video=0):
            last = f
            if f.time is not None and f.time >= want[len(out)]:
                out.append(f.to_ndarray(format="rgb24"))
                if len(out) == n:
                    break
        if not out and last is not None:  # window past the last timestamp: use the last frame
            out.append(last.to_ndarray(format="rgb24"))
    return np.stack(out)
最初は全コマをメモリに読んでから間引いていて、2 分半の映像だと 4,000 枚以上になり、1 本 4〜5 秒かかっていました。欲しい時刻のコマだけ残す形にして、切り出しは中央値 0.2〜0.4 秒になりました。
音は 16 kHz モノラルに変換します。
def audio_wave(path: str, sr: int = 16000) -> np.ndarray:
    """Mono float32 at 16 kHz (what the audio encoder expects)."""
    import av

    with av.open(path) as c:
        rs = av.AudioResampler(format="flt", layout="mono", rate=sr)
        chunks = [o.to_ndarray().reshape(-1) for fr in c.decode(audio=0) for o in rs.resample(fr)]
        chunks += [o.to_ndarray().reshape(-1) for o in rs.resample(None)]
    return np.concatenate(chunks).astype(np.float32) if chunks else np.zeros(0, np.float32)
2. 1 本のベクトルにする
動画・画像・音・文字のどれでも、768 次元の単位ベクトル 1 本にします。文字の前の task: classification | query: は、公式が用途ごとに決めている前置きです。<|video|> の位置に映像のトークンが入ります。
PREFIX = "task: classification | query: "
PROMPT = {"video": "A camera video. <|video|>", "image": "A camera image. <|image|>", "audio": "An audio clip. <|audio|>"}
    @torch.no_grad()
    def embed(self, x, kind: str | None = None) -> np.ndarray:
        """One 768-d unit vector for a video (path or [N,H,W,3] frames), an image (path / PIL / [H,W,3]),
        an audio clip (path or 16 kHz float array) or a text."""
        kind = kind or _kind(x)
        if kind == "text":
            inp = PREFIX + x
        else:
            if isinstance(x, str):
                if kind == "video":
                    x = video_frames(x, self.fps, self.max_frames)
                elif kind == "audio":
                    x = audio_wave(x)
                else:
                    from PIL import Image

                    x = Image.open(x).convert("RGB")
            inp = {"text": PREFIX + PROMPT[kind], kind: x}
        return np.asarray(self.st.encode(inp, normalize_embeddings=True), np.float32)
モデルの読み込みでは、GPU なら bfloat16、CPU なら float32 にし、使わないモダリティは外せます(音を外すと −300M)。
        self.device = device or ("cuda" if torch.cuda.is_available() else "cpu")
        dtype = torch.bfloat16 if self.device == "cuda" else torch.float32
        cfg = {}
        if "audio" not in modalities:
            cfg["audio_config"] = None
        if "video" not in modalities and "image" not in modalities:
            cfg["vision_config"] = None
        self.st = SentenceTransformer(model, device=self.device, model_kwargs={"torch_dtype": dtype}, config_kwargs=cfg or None)
        if tokens_per_frame:
            self.st[0].processor.video_processor.max_soft_tokens = tokens_per_frame
3. 判定器(ロジスティック回帰)
判定器は、ベクトルを標準化してから掛け算 1 回で各ラベルの確率を出すだけの、多クラスのロジスティック回帰です。
@dataclass
class Head:
    """Logistic-regression head over the embedding. probs = softmax(((x - mu) / sd) @ W + b)."""

    labels: list
    mu: np.ndarray
    sd: np.ndarray
    W: np.ndarray
    b: np.ndarray
    meta: dict = field(default_factory=dict)

    def probs(self, X: np.ndarray) -> np.ndarray:
        z = ((np.atleast_2d(X) - self.mu) / self.sd) @ self.W + self.b
        z = z - z.max(1, keepdims=True)
        e = np.exp(z)
        return e / e.sum(1, keepdims=True)
学習は L2 正則化つきの交差エントロピーを L-BFGS で解きます。凸問題なので、数百本なら CPU で数秒です。
def fit_head(X: np.ndarray, y: np.ndarray, labels: list, wd: float = 0.1, steps: int = 300, meta: dict | None = None) -> Head:
    """Multinomial logistic regression with L2, fitted by L-BFGS. Seconds on a CPU for hundreds of examples."""
    X = np.asarray(X, np.float32)
    mu, sd = X.mean(0), X.std(0) + 1e-4
    Xt = torch.tensor((X - mu) / sd)
    yt = torch.tensor(np.asarray(y), dtype=torch.long)
    W = torch.zeros(X.shape[1], len(labels), requires_grad=True)
    b = torch.zeros(len(labels), requires_grad=True)
    opt = torch.optim.LBFGS([W, b], max_iter=steps, line_search_fn="strong_wolfe")

    def closure():
        opt.zero_grad()
        loss = torch.nn.functional.cross_entropy(Xt @ W + b, yt) + wd * (W ** 2).sum()
        loss.backward()
        return loss

    opt.step(closure)
    return Head(list(labels), mu, sd, W.detach().numpy(), b.detach().numpy(), meta or {})
学習する数は W(768 × ラベル数)と b だけです。音の 10 種類なら約 7,700 個、転倒の 2 種類なら約 1,500 個です。JSON で保存すると数百 KB です。お手本から判定器を作る関数はこれだけです。
    def train_head(self, examples: dict, wd: float = 0.1, name: str | None = None) -> Head:
        """examples: {"label": [inputs...], ...}. Inputs are anything embed() accepts. Returns (and registers) a Head."""
        labels = list(examples)
        X = [self.embed(x) for lab in labels for x in examples[lab]]
        y = [i for i, lab in enumerate(labels) for _ in examples[lab]]
        head = fit_head(np.stack(X), np.array(y), labels, wd, meta={"n": len(y), "model": "embeddinggemma-2", "fps": self.fps})
        if name:
            self.heads[name] = head
        return head
4. 判定する
    def decide_vec(self, v: np.ndarray, head) -> dict:
        """Same as decide() on an embedding you already have (one embedding can serve many heads)."""
        h = self._head(head)
        probs = {lab: round(float(q), 4) for lab, q in zip(h.labels, h.probs(v)[0])}
        best = max(probs, key=probs.get)
        return {"choice": best, "confidence": probs[best], "probs": probs}
ベクトル 1 本を、転倒・侵入・ガラスの音など、いくつもの判定器に使い回せます。判定器を増やしても、重い部分(ベクトル化)は 1 回のままです。
学習なしの判定(答えの言葉とのコサイン類似度)も比較用に残しています。下の「学習前」の数字はこれで出したものです。
    def zero_shot_vec(self, v: np.ndarray, criteria: dict, temperature: float = 0.02) -> dict:
        names = list(criteria)
        T = np.stack([self.embed(criteria[n] or n, "text") for n in names])
        z = (T @ v) / temperature
        p = np.exp(z - z.max())
        p /= p.sum()
        probs = {n: round(float(q), 4) for n, q in zip(names, p)}
        best = max(probs, key=probs.get)
        return {"choice": best, "confidence": probs[best], "probs": probs}
5. カメラの流し見
カメラ用に、0.5 秒ごとに直近 4 秒(1 秒 2 コマ、最大 8 コマ)を判定します。判定器は 1 本まるごと(1 秒 1 コマ)で学習させたものを、そのまま窓に当てています。
    def watch(self, path: str, head, window: float = 4.0, step: float = 0.5, fps: float = 2.0) -> list:
        """Score a video the way a live camera would: every `step` seconds, judge the last `window` seconds.
        Returns [(t, probs), ...]."""
        import av

        with av.open(path) as c:
            st = c.streams.video[0]
            dur = float(st.duration * st.time_base) if st.duration else float(c.duration / 1e6)
        h, out, t = self._head(head), [], min(1.0, dur)
        while t <= dur + 1e-6:
            v = video_frames(path, fps, int(window * fps), max(0.0, t - window), t)
            p = h.probs(self.embed(v, "video"))[0]
            out.append((round(t, 2), {lab: round(float(q), 4) for lab, q in zip(h.labels, p)}))
            t += step
        return out
6. 問い合わせ口(Reflex-1・Jev と同じ形)
POST /v1/decisions で、Reflex-1 や Jev と同じ形のリクエストを受けます。入力は 1 回だけベクトルにして、全部の問いで使い回します(問い 2 つで、CPU では 17.6 秒 → 7.9 秒になりました)。
def decide(rf: Reflex2, req: dict, lock: threading.Lock) -> dict:
    x, kind = _input(req)
    out = {}
    with lock:
        v = rf.embed(x, kind)  # one embedding serves every question
        for name, q in req["questions"].items():
            if q.get("head"):
                if q["head"] not in rf.heads:
                    raise ValueError(f"unknown head: {q['head']} (available: {list(rf.heads)})")
                out[name] = rf.decide_vec(v, q["head"])
            else:
                out[name] = rf.zero_shot_vec(v, q["criteria"])
    return out
学習前と学習後
同じ EmbeddingGemma 2 でも、お手本で学習させる前と後で、正答率がまったく違います。採点には、学習に使っていない映像・音だけを使っています。学習にかかる時間は、お手本をベクトルにする時間(GPU 1 枚)と判定器の学習を足した目安です。
| お題 | 学習に使ったお手本 | 学習にかかる時間 | 素の EmbeddingGemma 2(学習なし) | Reflex-2(学習あり) |
|---|---|---|---|---|
| 転倒(知らない人の映像) | 約 120 本 | 約 1 分 | 53.8% | 95.7% |
| 防犯カメラの異常 | 120 本 | 約 3 分 | 63.5% | 92.5% |
| 音 10 種 | 320 本 | 約 30 秒 | 35% | 96.3% |
| 声の感情 8 種(知らない人の声) | 1,200 本 | 約 1 分 | 14% | 52% |
当てずっぽうは、転倒・防犯が 50%、音が 10%、声の感情が 12.5% です。AUC で見ると、転倒は 0.836 → 0.990、防犯カメラは 0.745 → 0.978 です。
お手本の数と精度(転倒、知らない人の映像で採点)
| お手本(各クラス) | 2 本 | 5 本 | 10 本 | 20 本 | 全部(約 60 本) |
|---|---|---|---|---|---|
| 正答率 | 70.2% | 85.6% | 88.6% | 93.3% | 95.7% |
| AUC | 0.818 | 0.939 | 0.950 | 0.984 | 0.990 |
コマの細かさ: 1 秒 1 コマのほうが良かった
転倒は一瞬の出来事なので 1 秒 4 コマのほうが良いと予想していましたが、逆でした。転ぶ前と後の姿勢の違いで、十分に見分けられているようです。
| 1 秒 1 コマ | 1 秒 4 コマ | |
|---|---|---|
| 正答率 / AUC | 95.7% / 0.990 | 93.8% / 0.975 |
| 1 本の判定(映像 7 秒) | 0.30 秒 | 1.29 秒 |
| GPU メモリ | 2.2 GB | 2.7 GB |
どのように応用していくか
ここからは、実際の現場を想定した 3 つの実例で、Reflex-2 と Gemini 3.8 Flash を同じ条件で比べます。どれも、学習に使っていない映像・音で採点した実測です。
Gemini には、Reflex-2 に渡したのと同じコマ(JPEG)や同じ音を渡し、0〜100 の点数か選択肢 1 つで答えさせました。Gemini 3.8 Flash は思考を切れないモデル(Reasoning is mandatory for this endpoint)なので、effort: minimal にしています。共通の問い合わせ部分はこうです。
def jpeg(a):
    b = io.BytesIO()
    Image.fromarray(a).save(b, format="JPEG", quality=85)
    return "data:image/jpeg;base64," + base64.b64encode(b.getvalue()).decode()


def ask(model, imgs, key):
    body = {"model": model, "max_tokens": 2000, "temperature": 0, "reasoning": {"effort": "minimal"}, "usage": {"include": True},
            "messages": [{"role": "user", "content": [{"type": "image_url", "image_url": {"url": u}} for u in imgs] + [{"type": "text", "text": PROMPT}]}]}
    req = urllib.request.Request("https://openrouter.ai/api/v1/chat/completions", data=json.dumps(body).encode(),
                                 headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"})
    t0 = time.time()
    r = json.load(urllib.request.urlopen(req, timeout=120))
    return r, time.time() - t0
実例 1: 高齢者の見守り — 転倒をすぐ知らせる
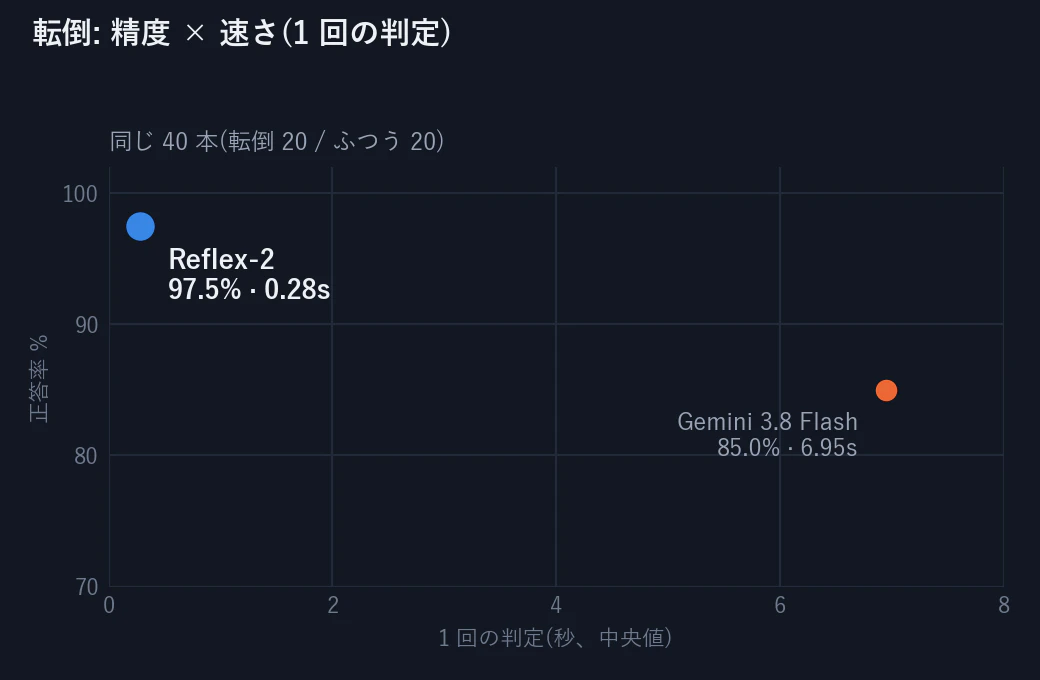
家の中のカメラ映像(GMDCSA24: 3 つの家・4 人の役者・転倒 79 本とふつうの動き 81 本、MIT License)で、転倒かどうかを判定させました。Reflex-2 は、160 本全体(学習に出ていない人の映像で採点)でも正答率 95.7% です。
| お題(同じ 40 本で比較) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 転倒か、ふつうの動きか | 85.0% | 97.5% |
| 1 回の判定時間(中央値) | 6.95 秒 | 0.28 秒 |
Gemini は転倒 20 本のうち 6 本を見逃しました(Reflex-2 は見逃し 0、誤報 1)。
評価のやり方: 1 人ずつ抜く
同じ人の映像が学習と採点の両方に入ると、人や部屋を覚えて当ててしまいます。そこで、4 人のうち 3 人で学習し、残り 1 人で採点、を 4 回繰り返しました。
def loso(H, y, subj, k, rng, wd=1e-1):
    """1 人ずつ抜いて採点。k > 0 なら学習側から 1 種類あたり k 本だけ使う。"""
    s = np.zeros(len(y))
    for p in sorted(set(subj)):
        tr = np.where(subj != p)[0]
        if k:
            tr = np.concatenate([rng.choice(tr[y[tr] == c], min(k, (y[tr] == c).sum()), replace=False) for c in (0, 1)])
        te = np.where(subj == p)[0]
        s[te] = probe(H[tr], y[tr], H[te], wd)
    return s
映像の長さだけで当たってしまわないかも確かめました。長さの対数だけを特徴にした判定器の AUC は 0.716 で、判定器(0.990)はそれを大きく上回っています。
        s_dur = loso(np.log(z["dur"])[:, None], y, subj, 0, np.random.default_rng(0), 1e-3)
        r["duration_only_auc"] = round(auc(y, s_dur), 4)
Gemini への問いはこうです。
PROMPT = ("These are frames sampled evenly (1 per second) from one home camera video. "
          "Rate how likely a person falls down in this video, from 0 (no fall, normal daily activity) to 100 (clearly a fall). "
          "Reply with the number only.")
転んでから何秒で気づけるか(カメラと同じ条件の流し見)
1 回の判定時間だけでは、実際の見張りで何秒で気づけるかは分かりません。そこで、カメラと同じ条件で両者に流し見させました。
- Reflex-2: 0.5 秒ごとに直近 4 秒を判定(上の
watch)。1 回 0.28 秒を足す - Gemini: 直近 4 秒を送り、答えが返った時刻の直近 4 秒を次に送る。待っている間に起きたことは見られない(実際の運用と同じ)
        dur, t, calls, alert = sc["duration"], min(1.0, sc["duration"]), [], None
        while len(calls) < a.max_calls and spent <= a.max_usd:
            end = min(t, dur)
            v = video_frames(sc["path"], fps=2.0, max_frames=8, start=max(0.0, end - 4.0), end=end)
            resp, lat = ask(a.model, [jpeg(x) for x in v], key)
            text = resp["choices"][0]["message"].get("content") or ""
            m = re.search(r"\d+(\.\d+)?", text)
            score = float(m.group()) if m else None
            cost = (resp.get("usage") or {}).get("cost", 0) or 0
            spent += cost
            calls.append({"window_end": round(end, 2), "sent_at": round(t, 2), "latency": round(lat, 3), "answered_at": round(t + lat, 2),
                          "score": score, "cost": cost})
            print(name, calls[-1], f"${spent:.4f}", flush=True)
            if score is not None and score >= 50:
                alert = round(t + lat, 2)
                break
            t = t + lat
| カメラの流し見(同じ映像) | 実際の転倒 | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|---|
| 椅子から落ちる | 3.4 秒 | 転んでから 8.3 秒 | 転んでから 1.9 秒 |
| 歩いて転ぶ | 2.7 秒 | 見逃し(4 回とも「ふつう」) | 転んでから 2.1 秒 |
| 前に倒れ込む | 2.6 秒 | 見逃し(4 回とも「ふつう」) | 転んでから 1.2 秒 |
| ベッドに横になる(ふつう) | — | 誤報なし | 誤報なし |
Gemini の 1 回の判定は 4.2〜7.6 秒でした。転ぶ前の 1 回目は正しく「ふつう」と答えますが、次の答えが返るのは転んでから数秒後で、しかも倒れた後の映像でも「ふつう」と答えた場面が 2 つありました。

下の折れ線が「転倒らしさ」、薄い赤の帯が実際の転倒です。ベッドに横になっても誤報は出ません(動画の全編)。
実例 2: 防犯カメラ — 侵入や異常に気づく
防犯カメラの映像(UCF-Crime の 2 分類版)が、侵入・暴行などの異常を含むか、ふつうの日常かを判定させました。1 本は中央値 75 秒の映像で、全体から均等に 32 コマを取っています。Reflex-2 は、評価用の 110 本全体でも正答率 92.5%(AUC 0.978)です。
| お題(同じ 40 本で比較) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 防犯カメラの映像が、異常か、ふつうか | 95% | 95% |
| 1 回の判定時間(中央値) | 16.1 秒 | 1.4 秒 |


評価のやり方
学習用 120 本(異常 60・ふつう 60)と評価用 110 本に分け、正則化の強さは学習用の中の 5 分割で選びました。映像の長さだけの判定器(AUC 0.655)も比べています。
def pick_wd(X, y, rng):
    """学習用の中の 5 分割で正則化を選ぶ。"""
    fold = rng.permutation(len(y)) % 5

    def oof(wd):
        s = np.zeros(len(y))
        for f in range(5):
            s[fold == f] = probe(X[fold != f], y[fold != f], X[fold == f], wd)
        return auc(y, s)

    return max([1e-3, 1e-2, 1e-1, 1.0], key=oof)
    wd = pick_wd(H[tr], y[tr], rng)
    s_probe = probe(H[tr], y[tr], H[te], wd)
    s_dur = probe(np.log(D[tr])[:, None], y[tr], np.log(D[te])[:, None], 1e-3)
Gemini への問いはこうです。
PROMPT = ("These are 32 frames sampled evenly from one surveillance camera video. "
          "Rate how likely the video contains an abnormal event (crime, violence, accident, fire, explosion, arrest, etc.) "
          "from 0 (completely normal everyday activity) to 100 (clearly abnormal). Reply with the number only.")
実例 3: 音 — 泣き声・ガラス・警報を聞き分ける
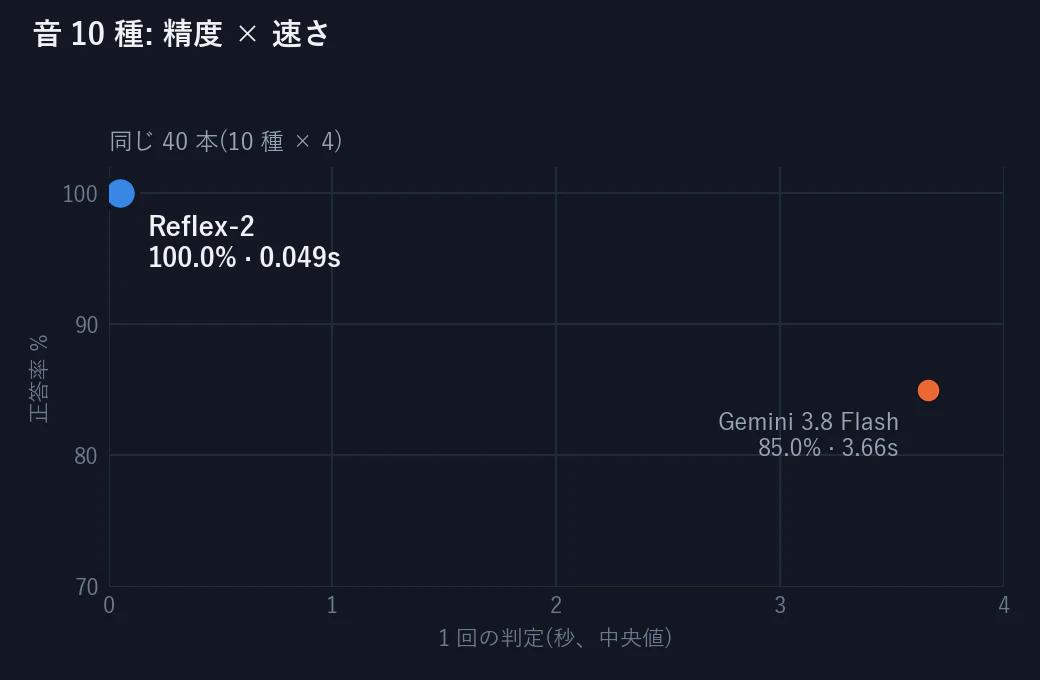
見守りと防犯で大事な 10 種類の音(赤ちゃんの泣き声・ガラスが割れる・サイレン・犬・ドアのノック・足音・咳・いびき・目覚まし・火のパチパチ)を、ESC-50 の 400 本で判定させました。Reflex-2 は、400 本全体(学習に使っていない音で採点)でも正答率 96.3% です。
| お題(同じ 40 本で比較) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 10 種類の音の聞き分け | 85% | 100% |
| 1 回の判定時間(中央値) | 3.66 秒 | 0.05 秒 |
(音つきの動画)
評価のやり方: ESC-50 の公式 5 分割
同じ録音から切り出した音が学習と採点に分かれないように、ESC-50 の公式の 5 分割を使い、1 分割ずつ抜いて採点しました(学習 320 本・採点 80 本を 5 回)。
    for k in sorted(set(fold)):
        tr = fold != k
        head = fit_head(H[tr], y[tr], CLASSES, 0.1)
        probs[~tr] = head.probs(H[~tr])
        pred[~tr] = probs[~tr].argmax(1)
Gemini には、Reflex-2 に渡すのと同じ 16 kHz モノラルの wav を input_audio で渡し、10 種類から 1 つ選ばせました。
def wav_b64(path):
    """16 kHz モノラルの wav にして base64(Reflex-2 に渡すのと同じ音)。"""
    a = (np.clip(audio_wave(path), -1, 1) * 32767).astype(np.int16)
    b = io.BytesIO()
    with wave.open(b, "wb") as w:
        w.setnchannels(1), w.setsampwidth(2), w.setframerate(16000), w.writeframes(a.tobytes())
    return base64.b64encode(b.getvalue()).decode()
    prompt = ("Which sound is this? Choose exactly one of: " + ", ".join(CLASSES) + ". Reply with the label only.")
    body = {"model": model, "max_tokens": 2000, "temperature": 0, "reasoning": {"effort": "minimal"}, "usage": {"include": True},
            "messages": [{"role": "user", "content": [{"type": "input_audio", "input_audio": {"data": b64, "format": "wav"}},
                                                      {"type": "text", "text": prompt}]}]}
Gemini が間違えたのは 6 本で、ガラスが割れる音を足音・ノック、サイレンを赤ちゃんの泣き声、目覚ましをサイレン、火のパチパチをノック・足音と答えました。
使い道は多種多様
動画と音を、スマホやカメラなどの機器で、一瞬で、現場のお手本から学んだ基準で判定できます。「実測」は今回確かめたもので、ほかも同じ方法で作れます。
| 分野 | 使い道 |
|---|---|
| 介護・医療 | 転倒・転落(実測)/ 夜間の徘徊、長く動かない / 咳・いびき(実測)、むせ・うめき声 / ベッドからの起き上がり |
| 家庭 | 赤ちゃんの泣き声(実測)/ 留守中のガラス破損(実測)・侵入 / 火のパチパチ音(実測)・目覚まし(実測)/ ペットの鳴き声(実測)・異変 |
| 防犯・店舗 | 侵入・暴行などの異常(実測)/ 閉店後のうろつき / 万引きらしい動き / 悲鳴・ガラスの音でかけつけ |
| 工場・建設・物流 | 作業者の転倒・転落 / 立入禁止区域への侵入 / 機械の異音・警報音 / フォークリフトと人の接近 |
| 交通・インフラ | 事故・落下物 / 駅ホームからの転落 / サイレン(実測)・警報音 |
| 公共・イベント | けんか・群衆の異常な動き / 置き去りの荷物 / 体調不良で倒れた人 |
| 農業・動物 | 家畜の異常行動・出産 / 害獣の侵入 / 鳴き声による体調の変化 |
| 放送・コンテンツ | 大量の映像・音声の自動仕分け / 危険な場面の自動検出 / 映像の中の出来事の検索 |
家・病院・店・工場の映像は外に出したくないことが多くあります。Reflex-2 はカメラのそばやスマホの中で判定するので、映像をクラウドに送る必要がなく、通信費も 1 回ごとの料金もかかりません。
frontier LLM・Jev・Reflex-1 とどう違うか
| frontier LLM (Gemini 3.8 / GPT-5.6) |
Jev (typesafe/jev-1.13) |
Reflex-1 (文章・画像) |
Reflex-2 | |
|---|---|---|---|---|
| 動画の判定 | ▲ 精度は高いが 1 本 7〜16 秒 | × 非対応 | × 画像のみ | ● 1 本 0.28 秒 |
| 音の判定 | ▲ 1 本 2〜13 秒 | × 非対応 | × 非対応 | ● 1 本 0.05 秒 |
| 転んでから気づくまで | ▲ 8 秒、または見逃し | × — | × — | ● 1〜2 秒 |
| 判定の作り方 | ● 問いを書く | ● 問いを書く | ● 問いを書く・学習も可 | ▲ お手本を数十本見せて学習 |
| 現場の判定を学習させる | × できない | × できない | ● 追加学習できる | ● お手本から数秒 |
| 手元で動く・軽さ | × クラウドのみ | × クラウドのみ | ● GPU 1 枚、9.8 GB | ● スマホで動く、1.5 GB |
| 重みの公開 | × 非公開 | × 非公開 | ● 公開 | ● 公開 |
| 1 回ごとの料金 | × 従量課金 | × 従量課金 | ● なし | ● なし |
| 要求の形式 | ▲ チャット | ● Decisions API | ● Jev と同じ形 | ● Jev と同じ形 |
● できる・強い ▲ 条件つき × できない。問いを文章で書いて判定させたいときは Reflex-1、動画や音の判定には Reflex-2、と使い分けられます。
評価: Gemini 3.8 Flash との比較
条件
- 同じ入力(同じコマ、同じ 16 kHz の音)を両方に渡しています。
- Reflex-2 はお手本で学習させた判定器、Gemini は学習なしです。学習なし同士で比べると、音の 10 種類は Gemini 85% に対して素の EmbeddingGemma 2 は 35% で、Gemini のほうが上です。お手本を数十本見せるだけでこれが逆転する、というのがこの記事の要点です。
- Gemini は思考を最小(
effort: minimal)にして、数字 1 つか選択肢 1 つで答えさせました。 - Reflex-2 は GX10(NVIDIA GB10)の GPU 1 枚、Gemini は OpenRouter 経由(通信込み)で、どちらも 1 本ずつ測りました。費用を抑えるため、比較は各お題 40 本(両クラス同数、音は各 4 本)です。
| お題(同じ 40 本) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 転倒 正答率 / 見逃し | 85.0% / 6 本 | 97.5% / 0 本 |
| 転倒 1 回の判定(中央値 / 最大) | 6.95 秒 / 23.7 秒 | 0.28 秒 / 0.74 秒 |
| 防犯カメラ 正答率 | 95% | 95% |
| 防犯カメラ 1 回の判定(中央値 / 最大) | 16.1 秒 / 26.7 秒 | 1.4 秒 / 1.7 秒 |
| 音 10 種 正答率 | 85% | 100% |
| 音 1 回の判定(中央値) | 3.66 秒 | 0.049 秒 |
| 1 本の費用 | $0.0003〜0.023 | 0 |
速さの内訳
GPU(NVIDIA GB10、1 枚): 転倒の映像 1 本(7 秒、1 秒 1 コマ)で判定 0.30 秒、GPU メモリは最大 2.2 GB です。音は 1 本(5 秒)0.049 秒です。
CPU だけ(Arm Cortex-X925、4 コア、float32): 転倒の映像 1 本で約 11 秒かかりました。判定は GPU と 18 本すべて一致しています(ベクトルの似ている度合い 0.998 以上)。
1 本の内訳を測ると、前処理は 0.02 秒で、ほとんどがモデルの計算でした。画像の入口では、1 コマを 16 × 16 の小片に分け、3 × 3 個ずつまとめて 1 トークンにします。140 トークンなら 1 コマ 1,260 個、70 トークンでも 630 個の小片を読み、4 コマなら 2,520 個です。ここが重さの大半です。
軽くする設定も試しました(転倒 160 本、知らない人の映像で採点)。
| 設定 | 正答率 | CPU 1 本 |
|---|---|---|
| そのまま(140 トークン、最大 11 コマ程度) | 95.7% | 約 11 秒 |
| 70 トークン・最大 8 コマ | 94.4% | 11.9 秒 |
| 70 トークン・最大 4 コマ | 91.3% | 7.5 秒 |
rf = Reflex2(tokens_per_frame=70, max_frames=4) # CPU 向けの軽い設定
スマホでは NPU や GPU を使う前提です。Google はスマホ向けの LiteRT 版も公開しています。
経緯: 自作の 8B 級より、Google の 0.7B のほうが上だった
Reflex-2 は最初、Reflex-1 と同じ Gemma 4 E4B(8B 級)に、声と画像の入口を足す自作の改造で作っていました。同じ判定器を載せて、声の感情 8 種(RAVDESS、学習に出ていない人の声で採点)で比べた結果です。
| Gemma 4 E4B(自作の改造) | EmbeddingGemma 2 | |
|---|---|---|
| 正答率(判定器あり) | 31.3% | 51.6% |
| 1 件の時間 | 0.15 秒 | 0.044 秒 |
| 重み | 16 GB | 1.5 GB |
速さ・大きさ・精度のすべてで負けたので、土台を EmbeddingGemma 2 に切り替えました。E4B の声の入口は話し声向けで、環境音は学習なしだとまったく聞き分けられませんでした(ESC-50 の 50 種類で 2.1% = 当てずっぽう)。
使い方
試し方は 2 通りあります。
方法 1: Google Colab で試す(インストール不要)
- https://colab.research.google.com/github/matu79go/reflex-2/blob/main/notebooks/quickstart.ipynb を開きます。
- メニューの「ランタイム」→「ランタイムのタイプを変更」で、GPU(T4 以上)を選びます。
- 上のセルから順に実行します。最初の実行で、土台の EmbeddingGemma 2(1.5 GB)が自動でダウンロードされます。
ノートブックでは次の 4 つを順に試せます。
- 公開データの転倒の動画と、ふつうの動きの動画を 1 本ずつ判定する
- 転倒の動画をカメラのように流し見させ、「転倒らしさ」の変化をグラフで見る
- 別の 3 人の動画 12 本(転倒 6 本・ふつう 6 本)をお手本に、自分の判定器を数秒で作る
- 学習なしで「寝室か、台所か」のような簡単な問いを試す
方法 2: 手元のパソコンで試す
Python 3.10 以上が必要です。GPU があれば速く動きますが、なくても動きます。
git clone https://github.com/matu79go/reflex-2
cd reflex-2
pip install -r requirements.txt
① 動画 1 本を判定する
from reflex2 import Reflex2

rf = Reflex2().load_heads("heads")      # 学習済みの判定器を読み込む(初回は土台のモデルを自動でダウンロード)
rf.decide("clip.mp4", "fall")           # clip.mp4 が転倒の場面かどうかを判定する
# {'choice': 'fall', 'confidence': 0.97, 'probs': {'adl': 0.03, 'fall': 0.97}, 'latency_ms': 290}
choice が判定結果(fall は転倒、adl はふつうの動き)、probs は各判定の確からしさ、latency_ms は判定にかかった時間(ミリ秒)です。
② カメラのように流し見する
rf.watch("camera.mp4", "fall")
# [(1.0, {'adl': 0.96, 'fall': 0.04}), ..., (4.5, {'adl': 0.03, 'fall': 0.97}), ...]
③ 自分の判定器を作る
head = rf.train_head({"glass": ["g1.wav", "g2.wav", ...], "other": ["o1.wav", ...]}, name="glass")
head.save("heads/glass.json")           # 保存しておけば、次からは load_heads で読み込んで使える
rf.decide("new_sound.wav", "glass")     # 新しい音を判定する
コマンドラインからも作れます。--label は 名前=ファイルのパターン です。
python scripts/train_head.py --out heads/my_head.json --label fall="clips/fall/*.mp4" --label normal="clips/normal/*.mp4"
python scripts/watch.py camera.mp4 --head heads/my_head.json --label fall
④ HTTP で使う(Reflex-1・Jev と同じ形)
python -m reflex2.server --heads heads --port 8098
POST /v1/decisions
{"video": "clip.mp4",
 "questions": {"fall": {"type": "choice", "head": "fall"},
               "room": {"type": "choice", "instructions": "Where is this?",
                        "criteria": {"bedroom": "a bedroom", "kitchen": "a kitchen", "office": "an office"}}}}
→ {"answers": {"fall": {"choice": "fall", "confidence": 0.9747, "probs": {"adl": 0.0253, "fall": 0.9747}},
               "room": {"choice": "bedroom", "confidence": 0.9494, "probs": {"bedroom": 0.9494, "kitchen": 0.0284, "office": 0.0222}}},
   "latency_ms": 7919}
(この応答は開発機の CPU で動かしたときの実際の出力です。GPU なら 0.3 秒前後です。)video・image・audio はローカルのパスか base64、state は文字です。
開発環境
| 項目 | 内容 |
|---|---|
| マシン | ASUS Ascent GX10 × 1 台(NVIDIA GB10 Grace Blackwell、CPU 20 コア、CPU と GPU で共有する統合メモリ 128 GB) |
| OS / ソフト | Ubuntu 24.04 (aarch64) · PyTorch 2.14 (CUDA 13) · Transformers 5.19 · sentence-transformers 6.1 · PyAV |
| 土台のモデル | Google EmbeddingGemma 2(Apache 2.0、重みは変更なし) |
| 改良 | お手本による判定器の学習(ロジスティック回帰、判定ごとに数分)・カメラの流し見・Jev と同じ形の問い合わせ口 |
| 開発期間 | 2 日。比較の計測と動画の作成を含む |
| 外部の費用 | 比較用の API 代(Gemini 3.8 Flash)合計 約 $1.3。学習にクラウドは使っていない |
注記
- 判定は、判定したいことのお手本で学習させて使います。素の EmbeddingGemma 2 のままでは、判定の精度は出ません。
- 分かるのは「いつ・何が起きたか」です。画面の中のどの人かを特定する用途には、人を見つけるモデルと組み合わせます。
- 評価は公開データ(役者が演じた転倒、防犯カメラ映像、効果音)で行いました。実際の現場では、その現場の映像や音をお手本にするのがおすすめです。
- 公開している判定器は転倒(GMDCSA24、MIT)だけです。防犯カメラの判定器は、UCF-Crime が研究用のデータのため公開していません。音の ESC-50 は CC BY-NC 3.0 なので、商用で使う場合は自分で集めた音で学習させてください。
データと出典
- EmbeddingGemma 2(Google、Apache 2.0)。Reflex-2 に Google の公認・関与はありません
- GMDCSA24: A dataset for human fall detection in videos(Data in Brief 2024、MIT License、出演者 4 人が一般公開に同意)
- UCF-Crime(Sultani, Chen and Shah, CVPR 2018、研究用)
- ESC-50(Piczak 2015、CC BY-NC 3.0)
- RAVDESS(Livingstone and Russo 2018、CC BY-NC-SA 4.0)
- Gemini 3.8 Flash の結果は筆者が OpenRouter 経由で測ったものです(API 代は合計 約 $1.3)
- 計測: 2026 年 10 月、ASUS Ascent GX10(NVIDIA GB10)1 台