
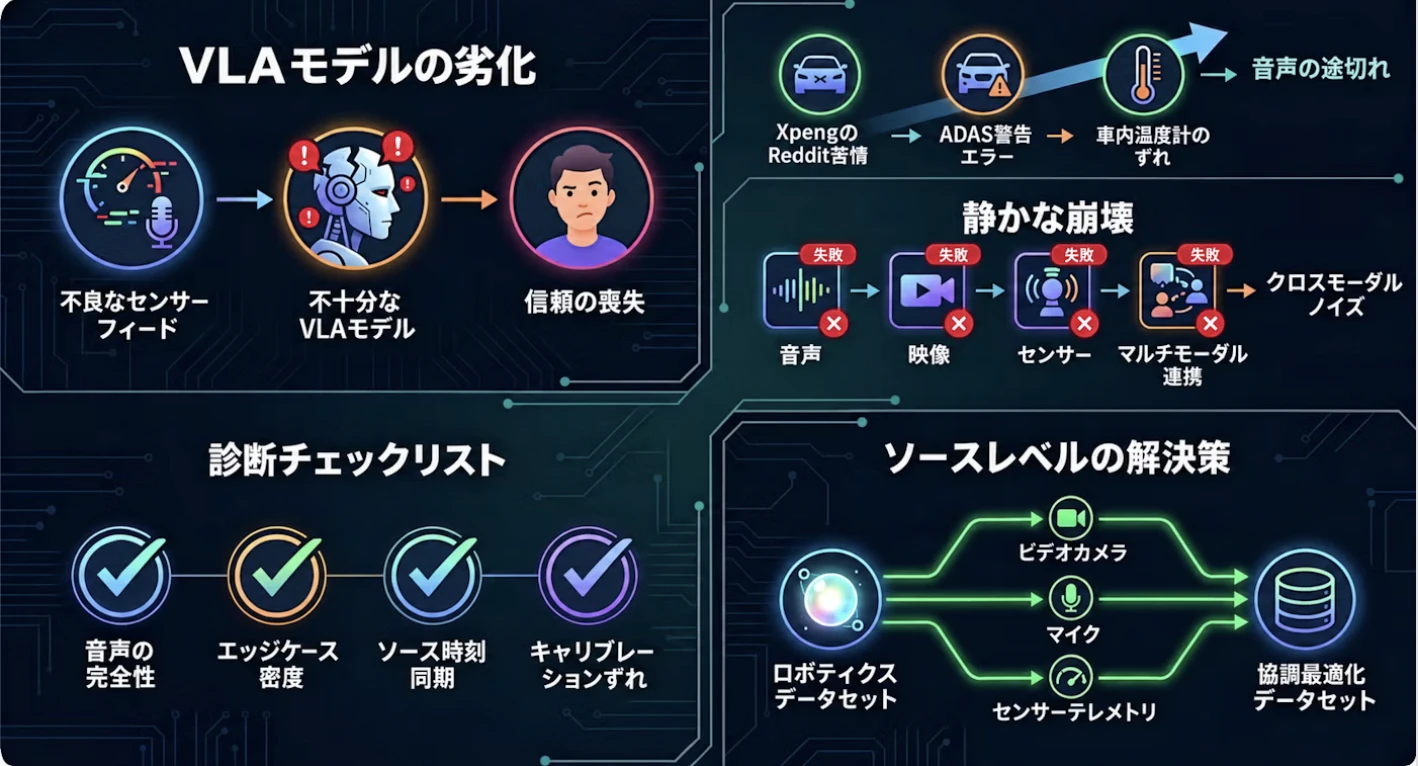
不適切なデータがいかに優れたマルチモーダルAIモデルを損なうか。著者による画像。
「自動車は、日々生じる些細な不満によって評価が完全に台無しになることがある」
これはXpengに関するRedditのスレッドのコメントからの引用であり、機械学習について書かれたものではありません。このユーザーは以下の点について不満を述べていました。
- 音声ストリーミングが頻繁に途切れること
- ADAS(先進運転支援システム)の警告音が不適切なタイミングで大音量で鳴ること
- 車内の温度計が現実よりも摂氏2度ズレて表示されること
これらはどれも致命的な故障ではありません。しかし、これらが重なることで、車両全体に対する信頼が損なわれていきます。
これと同じ信頼の低下が、VLAやADASモデルの学習パイプライン内部でも発生しています。マルチモーダルAIの学習データの質の低下は、単一の劇的なエラーとして表れることはめったにありません。音声、センサー、ビデオの各ストリーム間で生じる、蓄積された小さなズレ(非同期)として表れます。
この記事では、オーナーの上記3つの不満を共モーダルのアライメント(同期)ずれの例えとして用い、信号ノイズがモデルを破損する前に捕らえるためのチェックリストを提示します。
なぜマルチモーダルAI学習データの品質が低下するのか
多くの品質保証パイプラインは、各モダリティ(モダリティ=データの種類)を個別にチェックしています。
- 音声はS/N比(信号対雑音比)と明瞭度がチェックされます
- ビデオは解像度、フレームレート、バウンディングボックスのラベルがチェックされます
- センサー値は、想定される動作範囲と照合されます
各パスで「問題なし」と判定され、データバッチは学習用に承認されます。しかし、これらの個別チェックで見落とされるのが、ストリーム間の時間的・空間的な相互関係です。音声トラックが録音された正確なミリ秒単位と一致しているか、あるいは特定のタイムスタンプにおいてカメラが捉えた内容とセンサーの測定値が一致しているかといった点の検証が漏れてしまうのです。要するに、モダリティ間(クロスモーダル)のノイズは、単一のモダリティのルールに違反しないため、チェックを通り抜けてしまいます。
ここでVLA(Vision-Language-Action)の信号品質が低下します。同期がズレたストリームで学習されたモデルは、その矛盾を直接重み(パラメータ)として吸収してしまいます。自動チェックでフラグが立たなかった小さなズレが学習コーパス内に蓄積され、モデルの挙動が現実世界の物理法則を反映しなくなってしまうのです。
不満その1:音声データパイプラインの欠陥としてのコーデック問題
冒頭のRedditスレッドを例にとると、Xpengのオーナーたちは車内システムを通じたSpotifyのストリーミングが定期的に劣化すると報告していました。途切れや圧縮によるノイズなど、正式に苦情を申し立てるほどではないものの、ドライブのたびに気になる程度の問題です。しかし、根本的な原因が音楽サービス自体にあることは稀です。多くの場合、コーデック、伝送、再生に至るチェーンのどこかに不整合が存在しています。これはテスト時には見落とされやすいマイナーな規格の不一致ですが、運用時には持続して影響を与えます。
AIモデルを学習させる際の音声データパイプラインでも、これと同じ不整合が発生します。収録セッションごとに録音機器、圧縮設定、サンプルレートが異なると、コーデックの不一致により、対となる学習サンプル内に直接アーティファクト(ノイズ)が混入します。このような場合、音声トラックはもはやクリーンな信号ではなく、圧縮された近似値に過ぎなくなります。
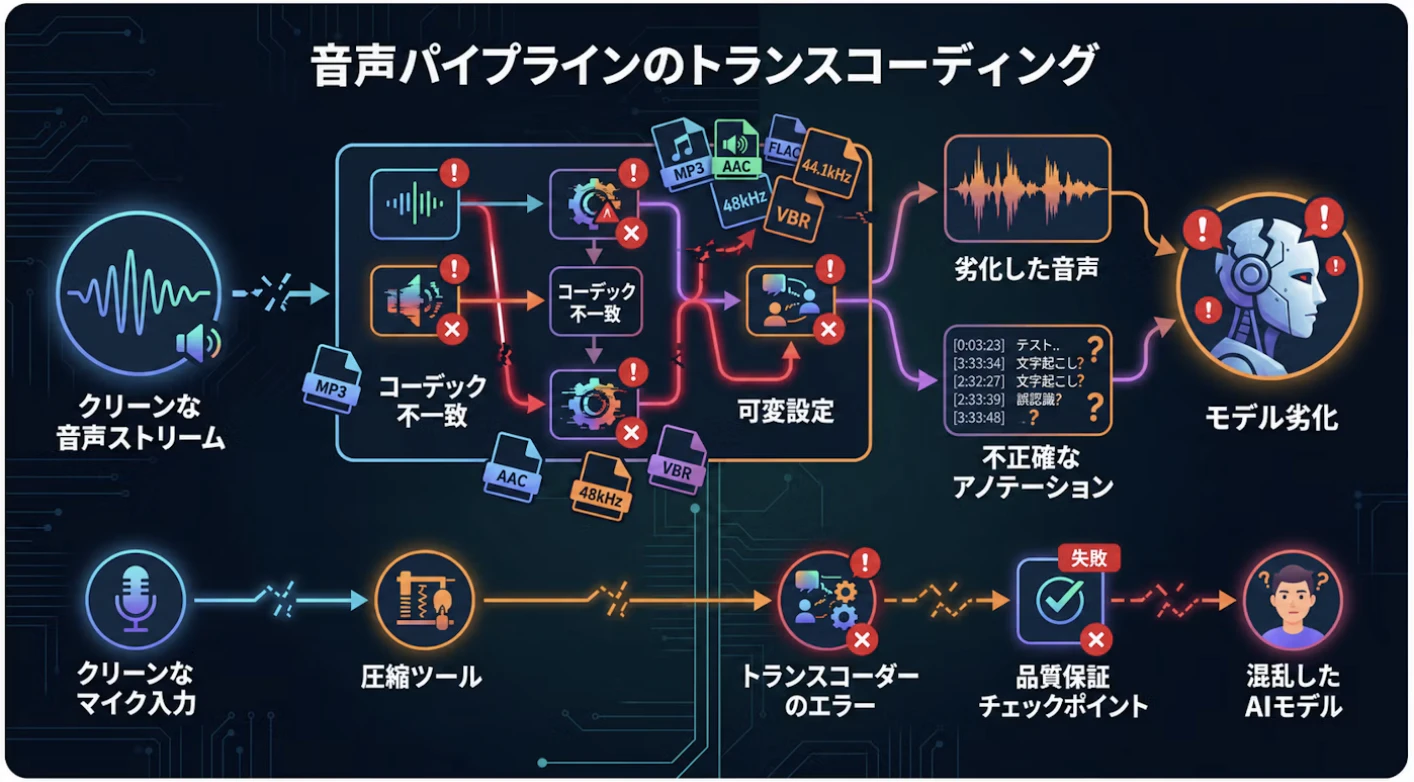
これは見た目以上に重要です。音声の再現性が低下すると、発話、環境音、そしてそれらに対応するはずの視覚的イベントとの間のクロスモーダルなアライメントが弱まるためです。データセット全体で音声自体が予測不能に改変されている場合、モデルは特定の音が特定の行動に伴うものであることを学習できません。
さらに、このダメージはアノテーション(ラベル付け)段階で増幅します。破損したソース信号から作業するアノテーターは存在しない情報をラベル付けできず、その出力にも元となるノイズが引き継がれます。つまり、マルチモーダルAIの学習品質は、アノテーションを開始する前に音声をクリーンに捉えられるかどうかに依存しているのです。
不満その2:エッジケースのカバー不足としての警報閾値の誤較正
もう1つの不満は、ADASの警報音が不統一な音量で鳴るというものでした。しかし、この不統一さはスピーカーのハードウェアの問題ではありません。十分に多様な実際の走行条件に対して閾値が調整(チューニング)されていないことを反映しています。つまり、システムは軽めの注意喚起で済む状況と、緊急の警告が必要な状況を確実に区別できていないのです。
この不統一さは、ADAS学習データにおけるギャップ(不足)の直接的な症状です。具体的には、適切な警報の強度が曖昧な「エッジケース(例外的な状況)」のデータ表現が不足していることです。学習データが日常的なシナリオに偏っていると、境界条件に関する十分な信号をモデルが受け取れなくなるためです。
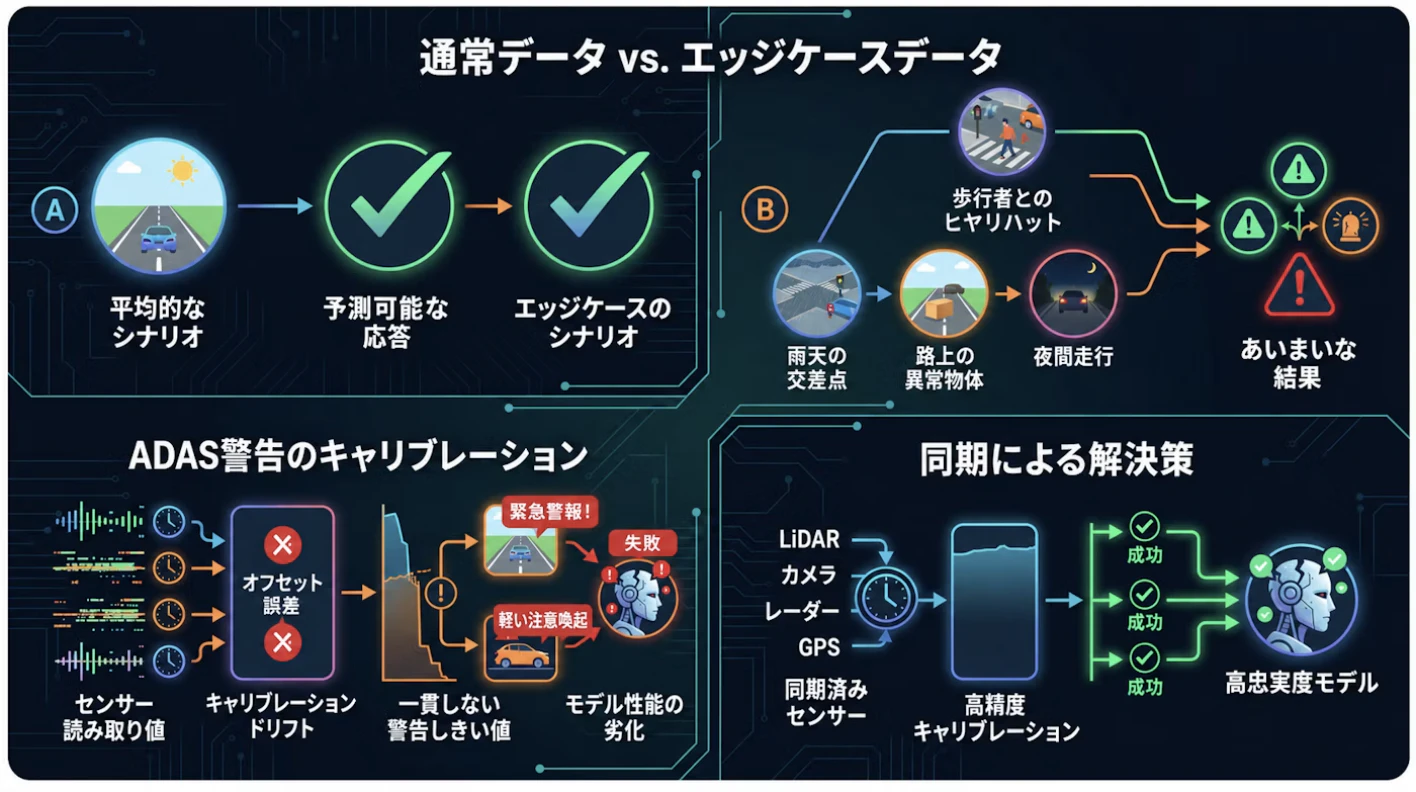
これは、出力層で表出するセンサーノイズを意味しています。検出された危険のタイムスタンプが、それを引き起こしたセンサーイベントと厳密に同期されていない場合、モデルは環境リスクとシステム応答の間で誤ったマッピングを学習します。結果として、モデルは実際の信号ではなくノイズに対してキャリブレーション(位置合わせ)を行ってしまうのです。
不満その3:系統誤差としてのキャリブレーション・ドリフト
Redditスレッドで報告された3つ目の不満は、最も目立たないものの、技術的には最も示唆に富むものです。車内の空調システムが、スマホの温度計よりも常に約2度ズレた値を表示することにオーナーが気づきました。このような持続的な偏りは、キャリブレーション・ドリフト(校正値のズレ)の典型例です。一度センサーがズレると、それが生成するすべての測定値に系統誤差が含まれるようになります。
このように修正されていないセンサーノイズは、車内よりも学習パイプライン内部で遥かに大きなダメージを与えます。なぜでしょうか?車内の温度計が2度ズレているだけならドライバーが少し不快に感じる程度ですが、同じようなドリフトを吸収した学習パイプラインは、AIモデルに「現実世界の体系的に誤った表現」を教えてしまうからです。この場合、記録された状態と実際の状態が一致せず、一貫してミスを犯すようになります。
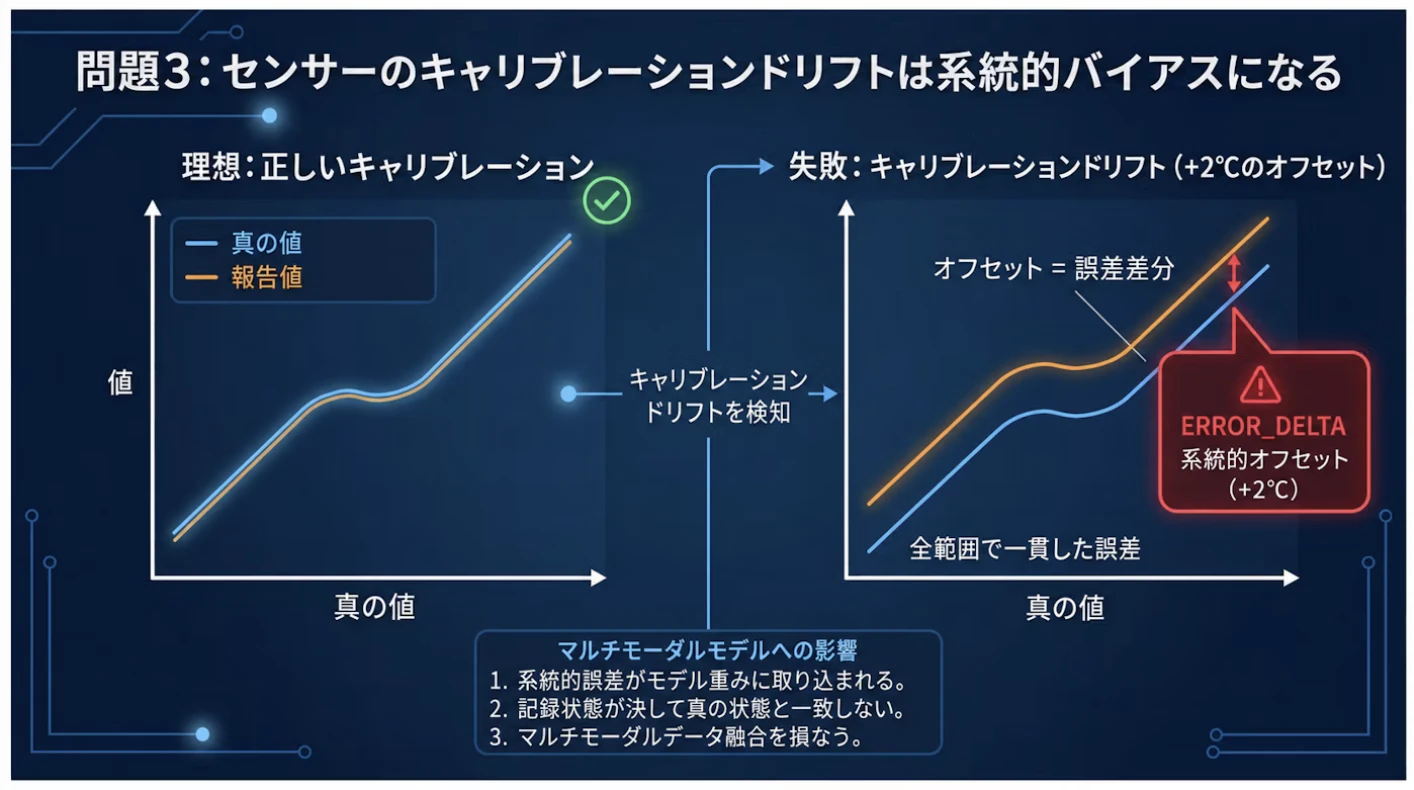
これこそが、マルチモーダル学習の研究において繰り返し浮上する時間的・物理的アライメントの問題です。修正されていない小さなセンサードリフトは、大規模化によって相殺されるようなランダムノイズではありません。特に、固定されたオフセット(偏り)が全くドリフトしていない他のストリームと並んで存在する場合、時間とともに複合化する「バイアス」となります。
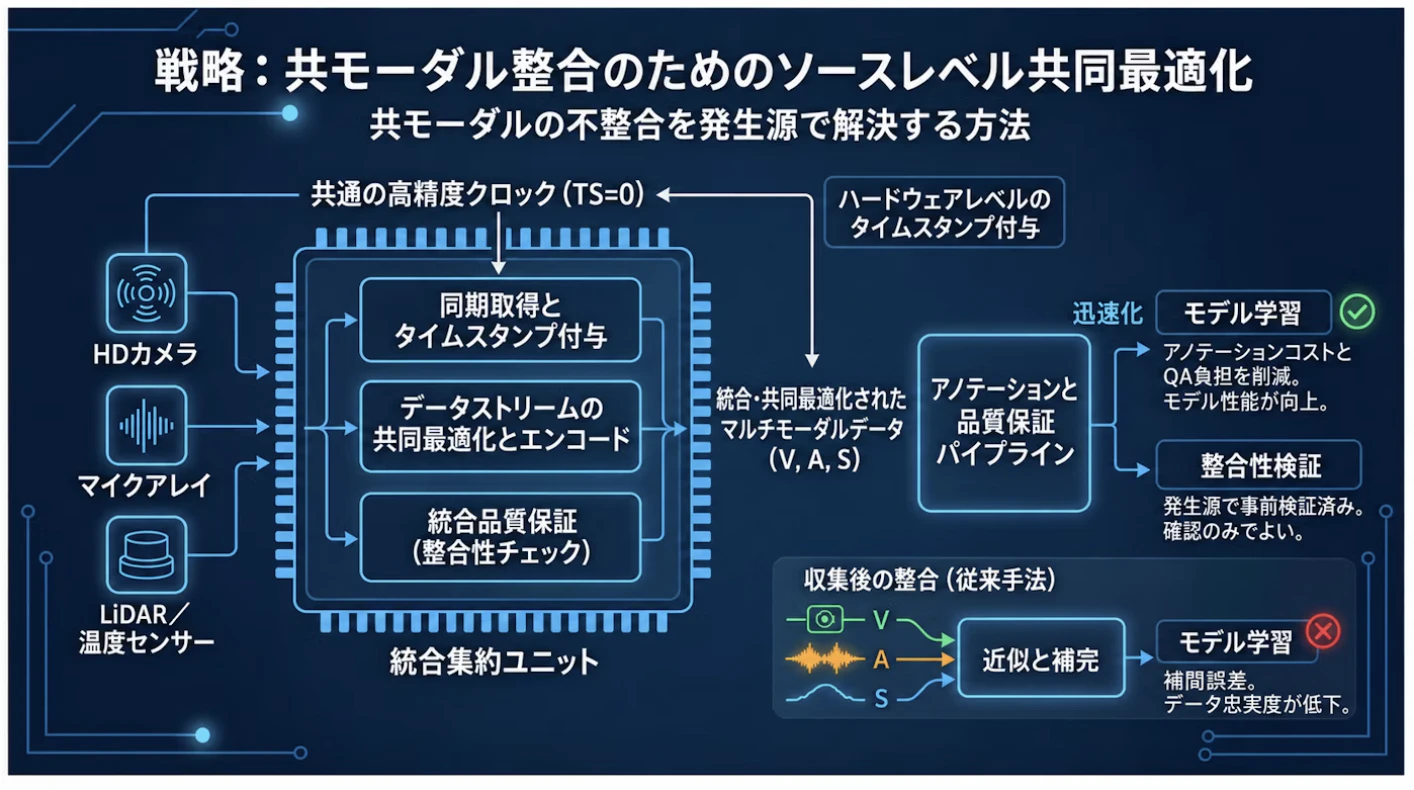
マルチモーダルの共同最適化(co-optimization)は、この問題を解決するために存在します。収集時点でセンサーストリームを較正および相互参照(クロスリファレンス)することで、ハードウェアのドリフトがデータセットに入る前に直ちに検出されます。
自己診断:マルチモーダルデータのための診断チェックリスト
上記の3つの不満点はそれぞれ、学習パイプラインにおける特定の検証可能な弱点を指し示しています。VLAアーキテクチャにマルチモーダルデータセットを投入する前に、以下の3つの技術的基準に基づいてデータパイプラインを評価してください。
マルチモーダルAI学習データの品質は、単一の基準だけで破綻することはめったにありません。これらのギャップの2つまたは3つすべてが気づかれないまま重複したときに破綻します。パイプラインが健全であると仮定する前に、3つすべての項目でスコアを測定してください。
1. ソース(発生元)における音声の完全性
- 問い:音声ストリームは、圧縮による信号損失なしに収集およびアノテーションされていますか?
- 確認方法:録音機器からアノテーションの時点に至るまでの全トランスコーディング工程で音声を追跡します。収集セッションごとにコーデック設定が異なる場合や、品質チェックの前に圧縮が適用されている場合は、検出されないまま対となるサンプルにノイズが混入している可能性があります。ソース段階でのクリーンな音声は、信頼性の高いアノテーションの前提条件です。
2. エッジケースのアノテーション密度
- 問い:センサーおよびアラートのデータには、平均的なケースだけでなく、アノテーションされたエッジケースが含まれていますか?
- 確認方法:日常的な条件が大半を占めるデータセットでは、条件が曖昧な場合にどう振る舞うべきかをAIモデルに教えることはできません。したがって、アノテーションの範囲に、適切な挙動を特定することが真に困難なギリギリのシナリオ、ヒヤリハット、特殊な構成が含まれているか確認してください。
3. ハードウェアレベルの時間同期
- 問い:ビデオ、音声、センサーのタイムスタンプは、ソース段階で相互に同期されていますか?
- 確認方法:収集後に適用されるアライメントは常に近似値に過ぎません。ストリームが共通のクロックを共有し、キャプチャ(収集)自体において同期されていることを確認してください。
データソースで共モーダルのアライメント不全を解決する方法
クロスモーダルノイズを排除するには、データ収集のソース段階にエンジニアリングの焦点を当てる必要があります。キャプチャ後に不整合を修正しようとすると補間や推定に頼ることになり、それら自体が二次的な近似値、つまり別のノイズを生み出すためです。
Bright Dataのようなソースレベルでの共同最適化を強調するデータプロバイダーは、最初のキャプチャ時から同期されたビデオ、音声、センサーテレメトリを収集することに注力しています。彼らは、ソース段階から共同最適化されたロボット工学データセット、コンピュータビジョンおよび画像データ、VLA学習用ビデオデータの構築に注力しており、事後的に不一致を調停する必要を無くしています。
収集時に共同最適化されたストリームは、後からアライメントの修正を行うよりも常に優れています。ソースレベルでの同期が正確だからです。また、この段階でのクリーンな入力は、アノテーションコストや後流でのクロスモーダルな品質保証の負担を軽減します。アノテーターがチェーンの初期段階で混入したノイズを補償する必要がなくなるためです。
VLAやADASモデルに供給するマルチモーダルAI学習データの品質を担当するチームにとって、これが自然な次のステップとなります。Bright Dataでは、同期されソースレベルでクリーンなデータが自社のAIモデルにもたらす効果を試したいエンジニア向けに、無料トライアルを提供しています。
結論
前述のRedditスレッドで車両オーナーによって提示された不満は、複雑な工学システムに関する根本的な真理を物語っています。つまり、放置された些細な非効率性が積み重なり、システムレベルの障害へとつながるということです。圧縮された音声コーデック、未較正の安全アラート、2度のセンサードリフトは、マルチモーダルAIモデルを劣化させるまさにその失敗モードを反映しています。
VLA開発におけるデータの品質が、単一の破滅的なエラーによって破壊されることはめったにありません。ズレたフレームが1つずつ蓄積し、日々侵食されていくのです。エンジニアリングチームのための解決策は、それらのエラーが本番モデルに現れる前に、ソース段階で信号のズレを解消することです。