
0. はじめに
CVPR2026から以下の論文のまとめ。
[1]Z. Zhang, et. al. GeoWorld: Geometric World Models
arXiv: https://arxiv.org/abs/2602.23058
project page: https://steve-zeyu-zhang.github.io/GeoWorld/
1. 概要
- GeoWorldは、World Modelのlatent spaceに双曲空間(Hyperbolic Space)を導入したPredictive World Modelである
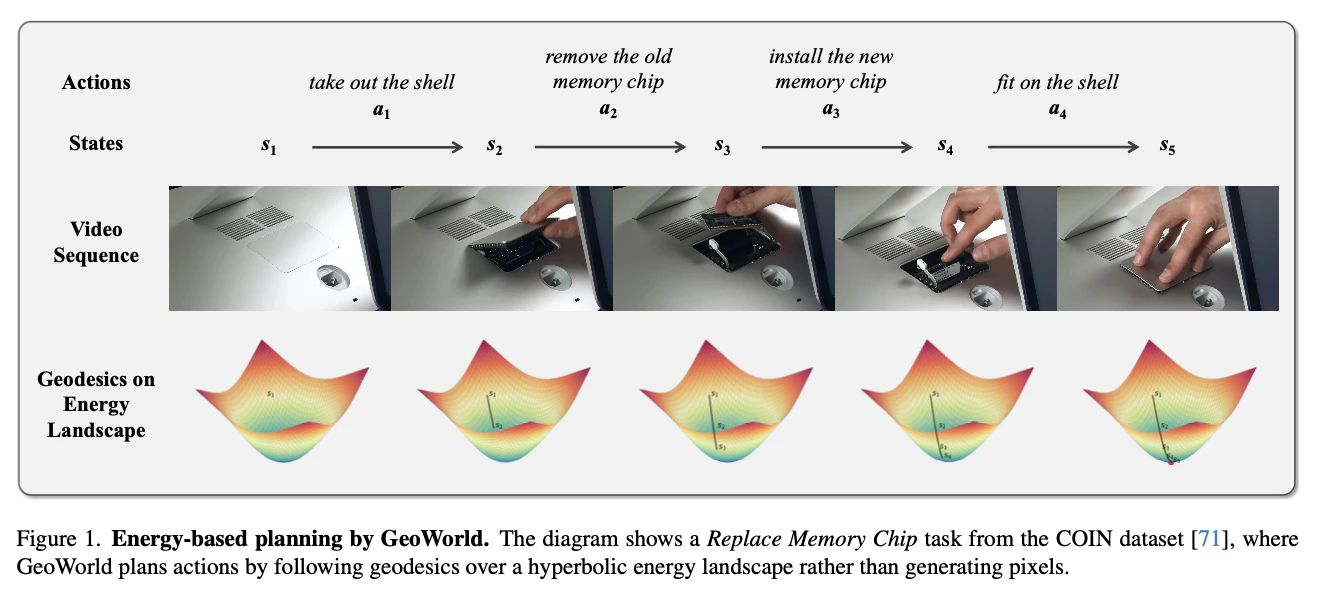
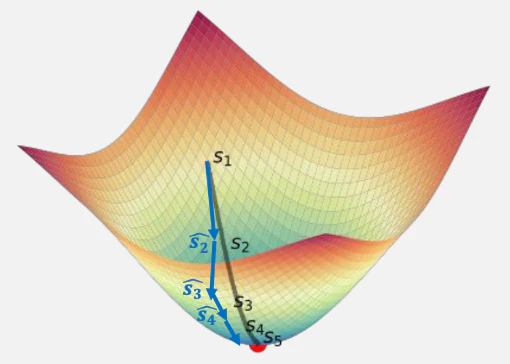
下図 Figure 1 のように対象とするのは離散的な状態。このplanningタスクである。 $s_1$ と $s_5$ (goal)が与えれた時に、実施する順番を学習する。
V-JEPA 2などのPredictive World Modelでは、画像や動画をEncoderによってlatent representationへ変換し、
(s_t, a_t) \rightarrow s_{t+1}
することで、画像そのものを生成せずlatent space上で未来を予測する。
GeoWorldの大きな特徴は、このlatent spaceを通常のユークリッド空間から双曲空間へ変更したこと。
主な提案は以下の2つ。
-
Hyperbolic JEPA (H-JEPA)
latent representationを双曲空間へ写像し、双曲空間上で未来状態を予測する -
Geometric Reinforcement Learning (GRL)
multi-step rollout全体の双曲距離を小さくするようPredictorを追加学習する
最終的には、学習したWorld Modelを使って複数のAction sequenceをシミュレーションし、goalへ到達するAction sequenceをCEM(Cross-Entropy Method)で探索する。
2. 背景
Predictive World Modelでは、現在状態 $s_t$ とAction $a_t$ から、
$$
(s_t,a_t)\rightarrow \hat{s}_{t+1}
$$
と未来のlatent stateを予測する。従来手法ではlatent representationは基本的にユークリッド空間上に存在する。
GeoWorldでは、これには以下の問題があると考えている。
問題1)階層的な状態を表現しにくい
ロボットなどのplanningでは、Actionによって未来が分岐し、階層が深くなるほど状態数は指数関数的に増加する。一方、$n$ 次元ユークリッド空間では半径 $r$ に対して利用可能な空間は多項式的に増加する。
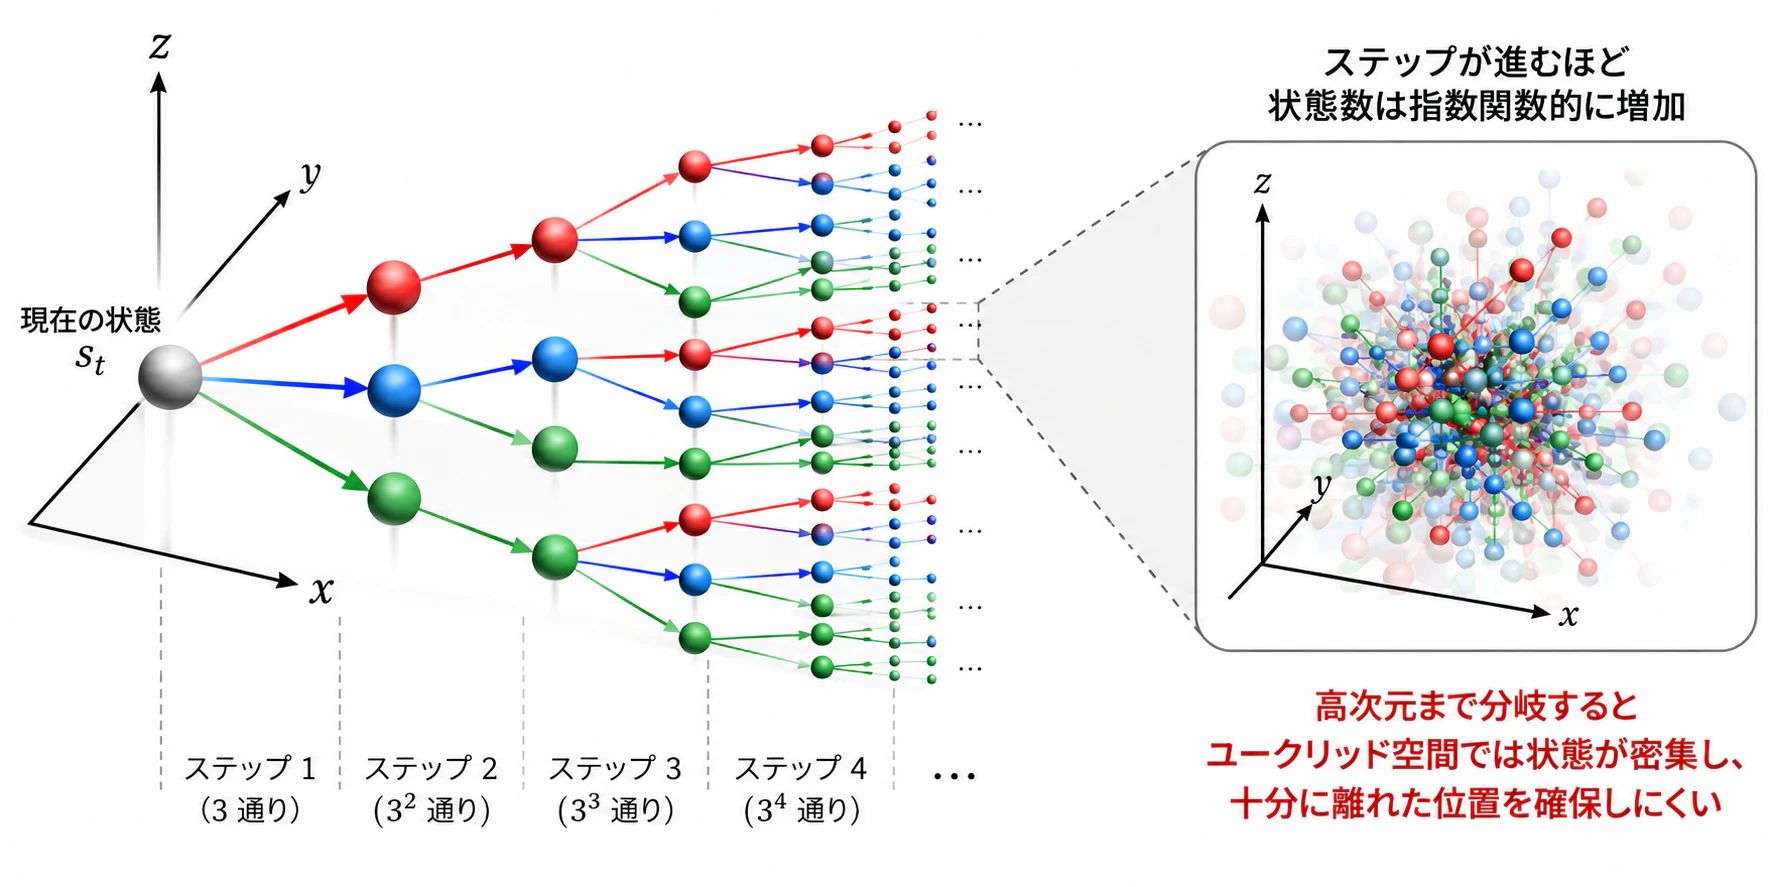
一方で双曲空間では、原点から離れるほど空間が指数関数的に広がるため、tree-likeな階層構造を比較的自然に表現できるという特徴がある。
問題2)Long-horizonで誤差が蓄積する
1-step predictionが正確でも、
s_t \rightarrow s_{t+1} \rightarrow s_{t+2} \rightarrow s_{t+3} \rightarrow \cdots
とPredictor自身の予測結果を再入力すると、誤差が徐々に蓄積する。
GeoWorldでは、
- multi-step rollout loss
- Geometric Reinforcement Learning
によってこの問題への対応を試みている。
3. 手法
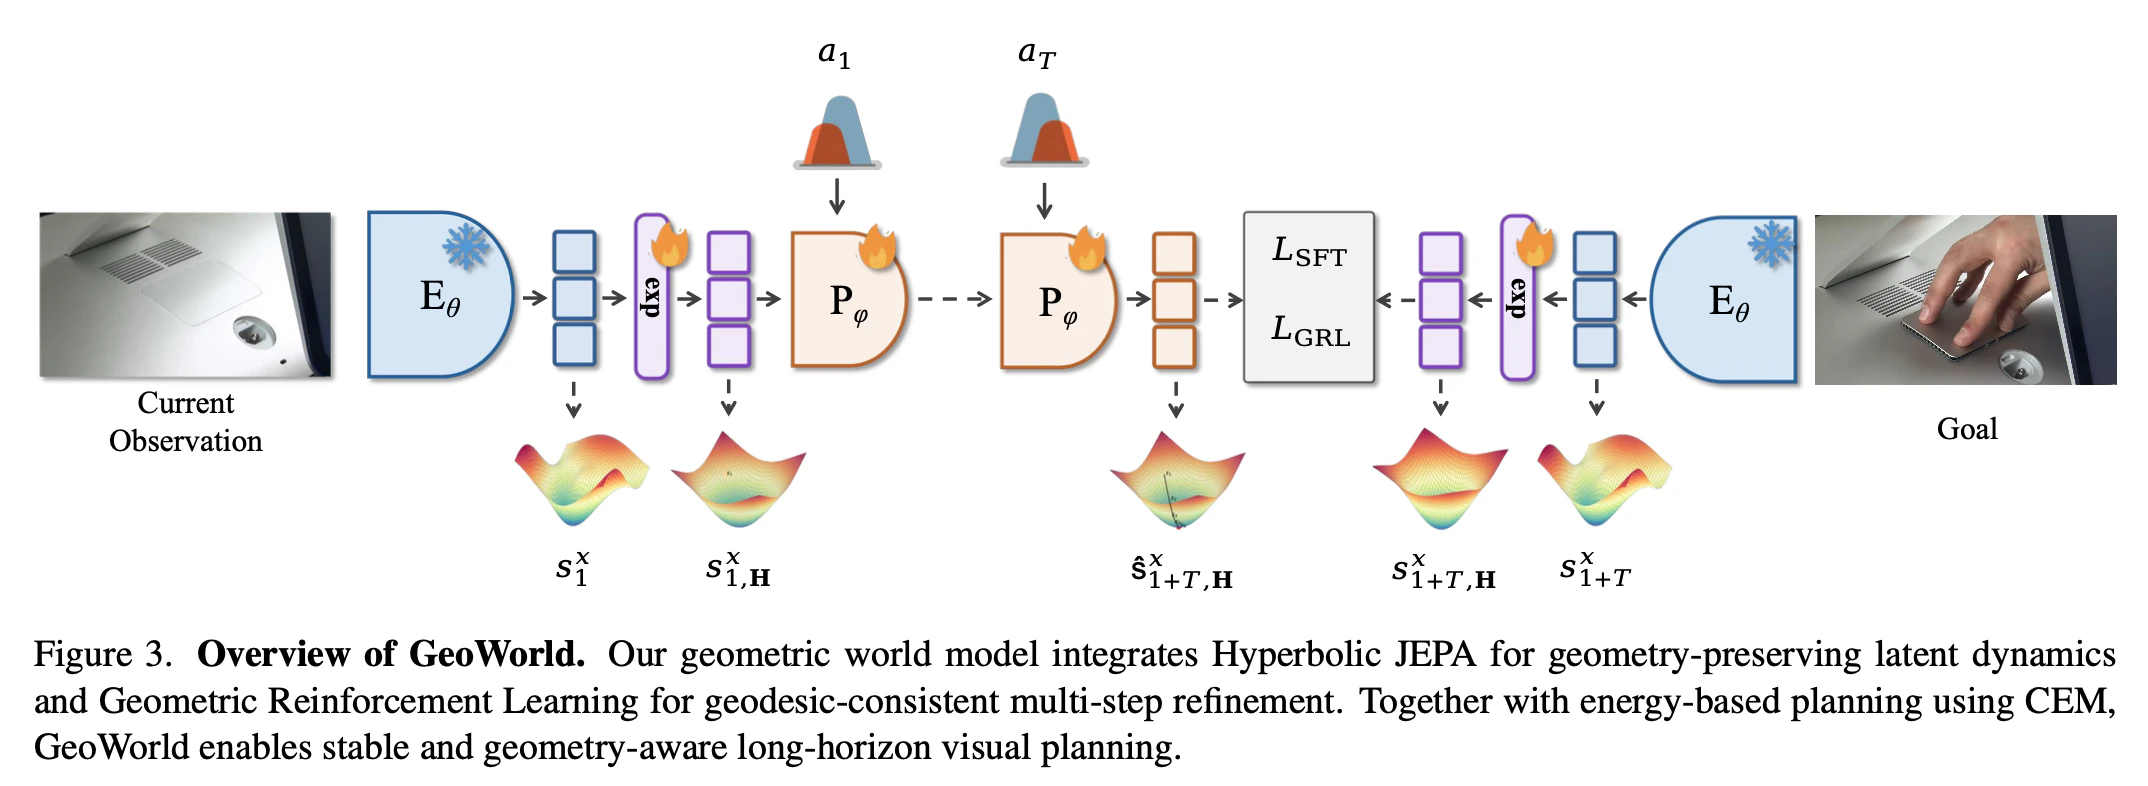
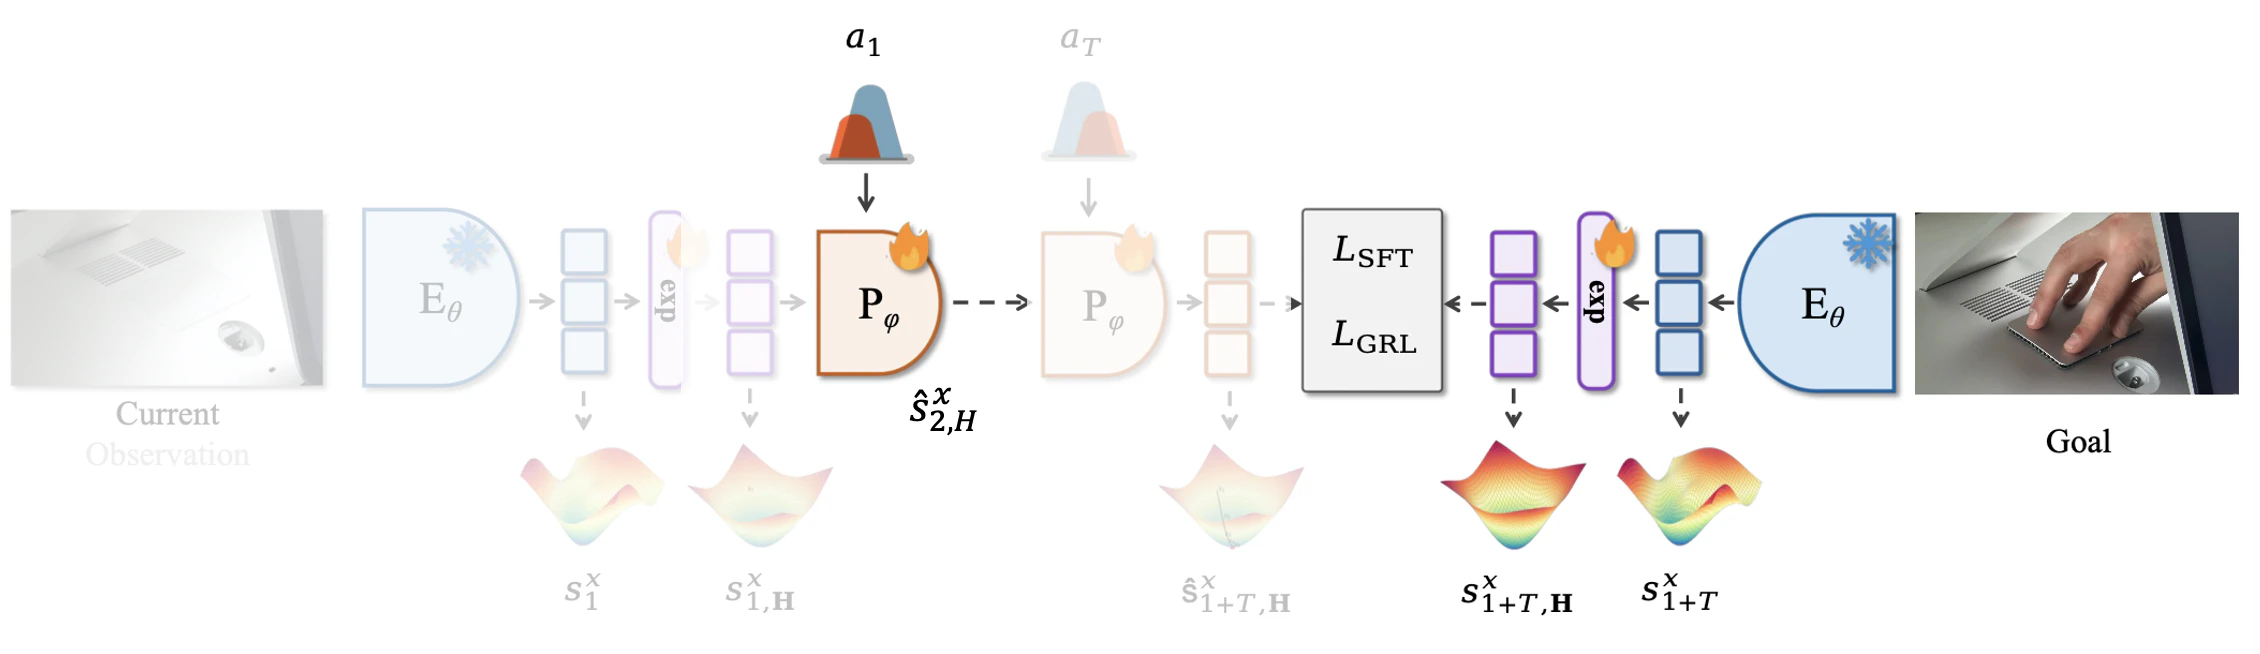
下図は全体の流れ。
3.1 Encoderでユークリッド空間のlantent vectorへ
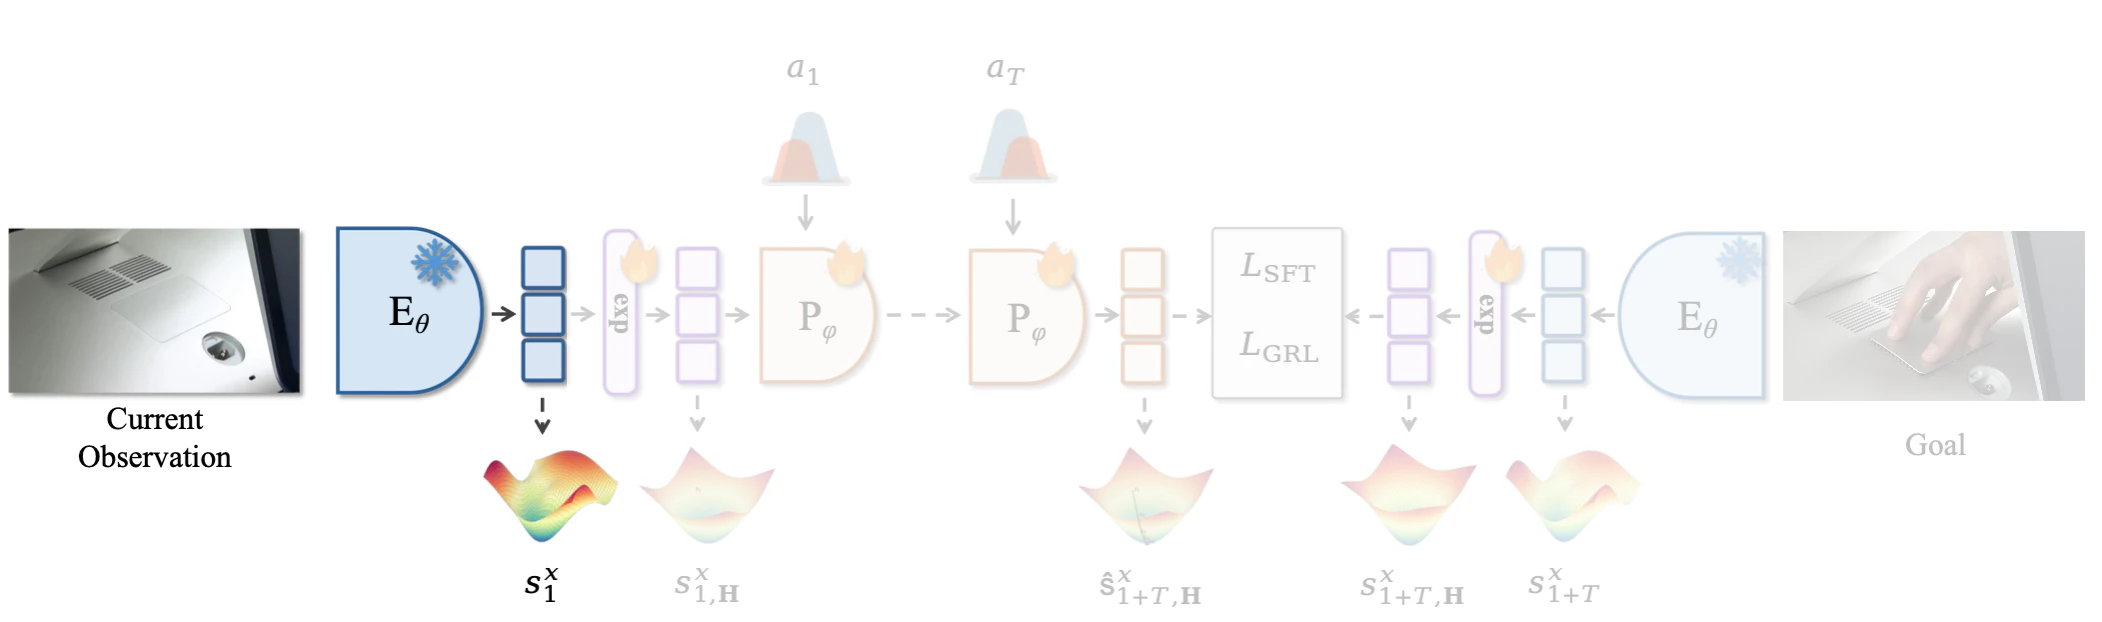
Encoder $E_\theta$ は、通常のユークリッド空間上のlatent vectorを出力する。
$$
s_t^x=E_\theta(x_t)\in\mathbb{R}^n
$$
3.2 双曲空間への写像
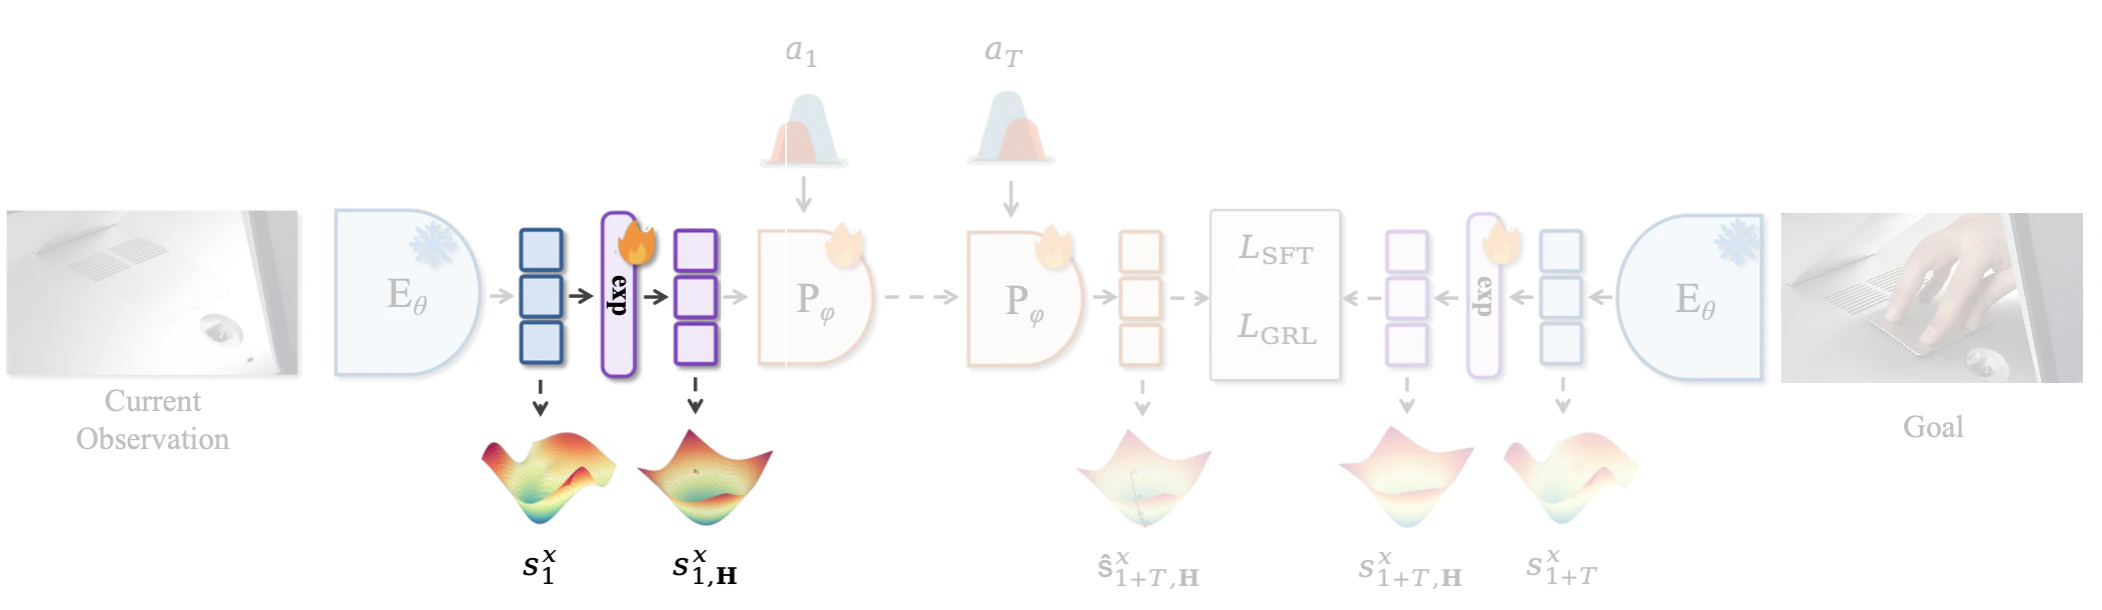
GeoWorldでは、このvectorを双曲空間の原点におけるtangent vectorとみなし、Exponential Mapを使ってPoincaré ballへ写像する。
s_{t,\mathbb H}^x
=
\exp_0(s_t^x)
=
\tanh(\sqrt{c}\|s_t^x\|)
\frac{s_t^x}{\sqrt{c}\|s_t^x\|}
$c$ :曲率に関係するパラメータ
$\tanh(x)$ は以下のような関数系だが、 $\tanh(\sqrt{c} ||s_t^x ||)$ だと右側のせいの部分だけ。
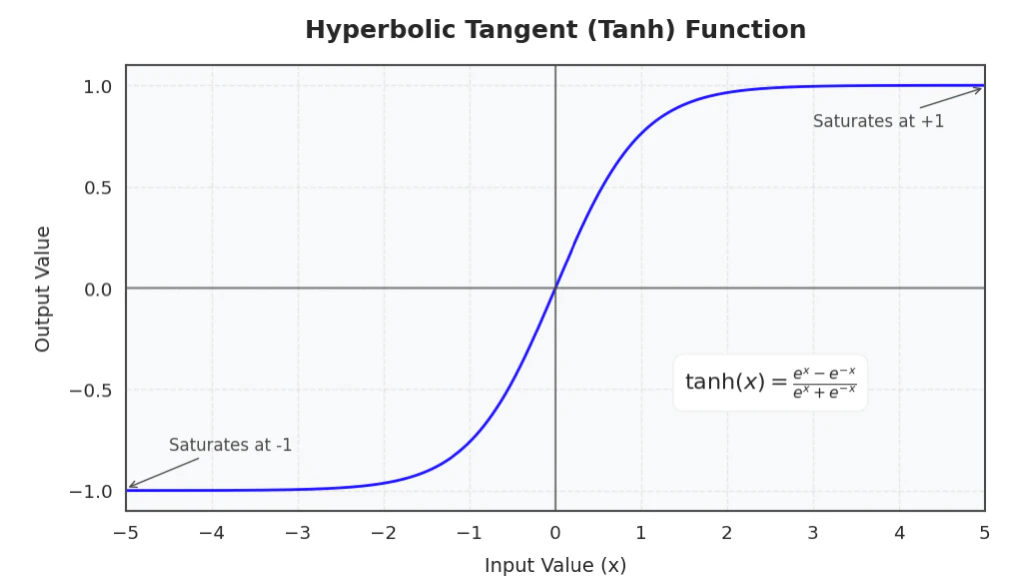
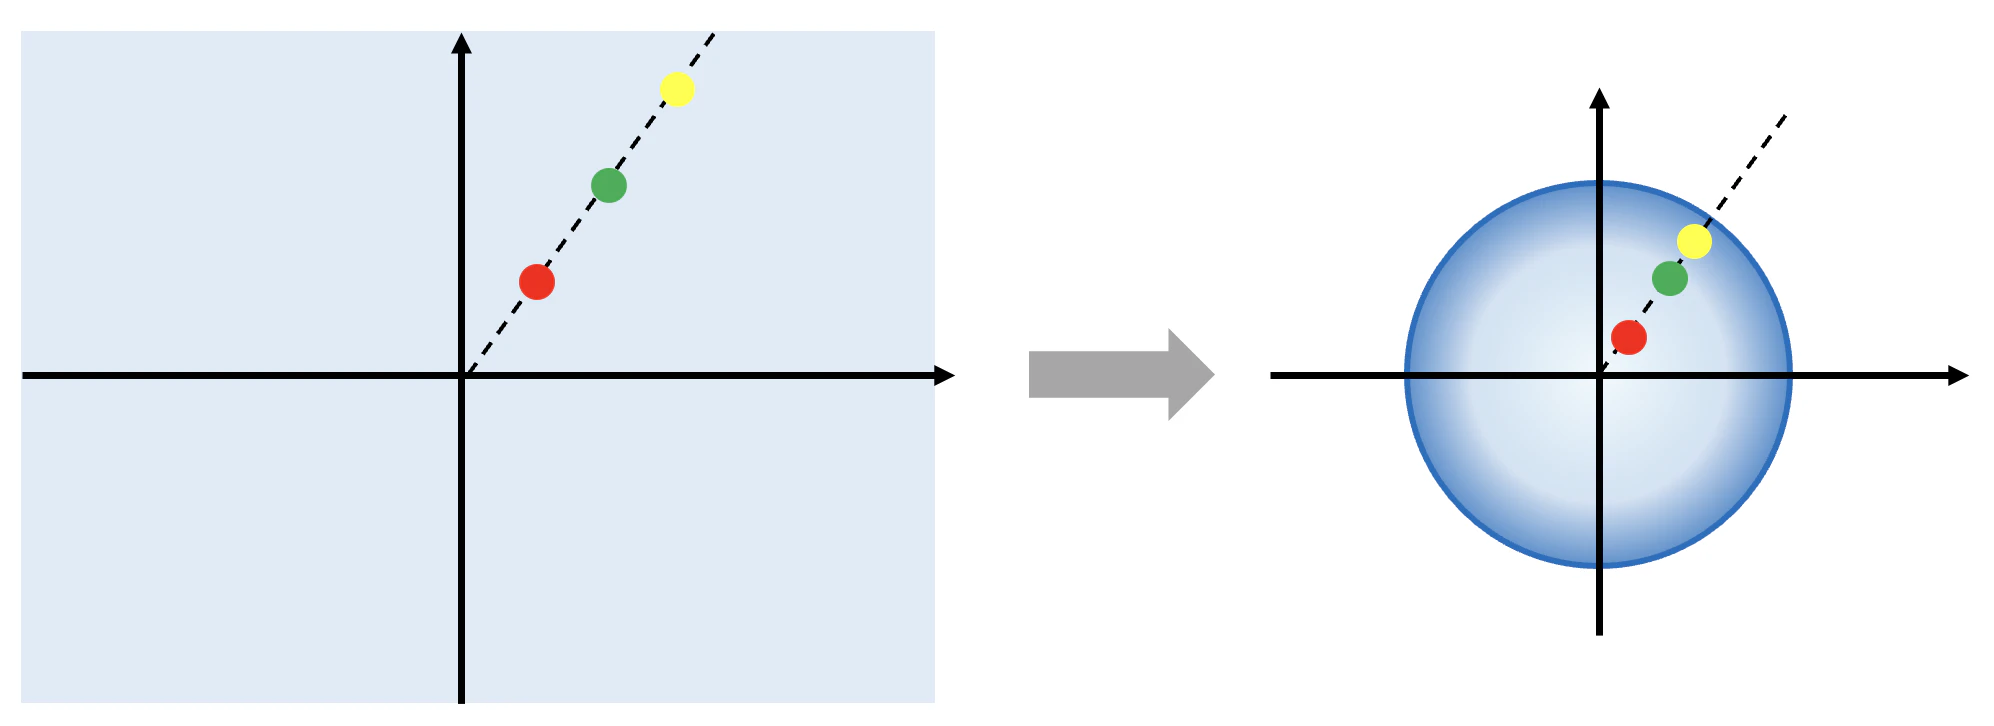
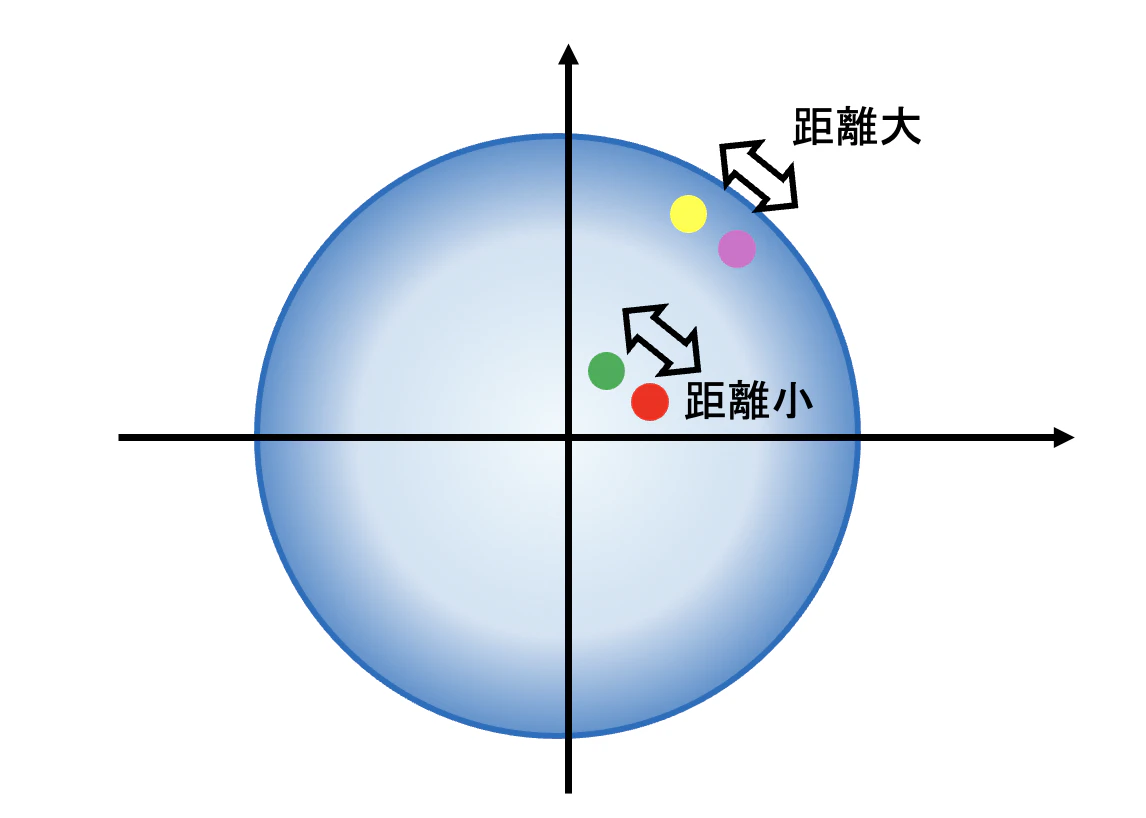
$\frac{s_t^x}{\sqrt{c}|s_t^x|}$ は n 次元空間上の方向を表すので、 $\tanh(\sqrt{c} ||s_t^x ||)\frac{s_t^x}{\sqrt{c} ||s_t^x ||}$ はn 次元空間上の半径1の球体内部を表し、特に球面付近に点が密集している。
直感的には、下図右のような感じ?
3.3 Predictor
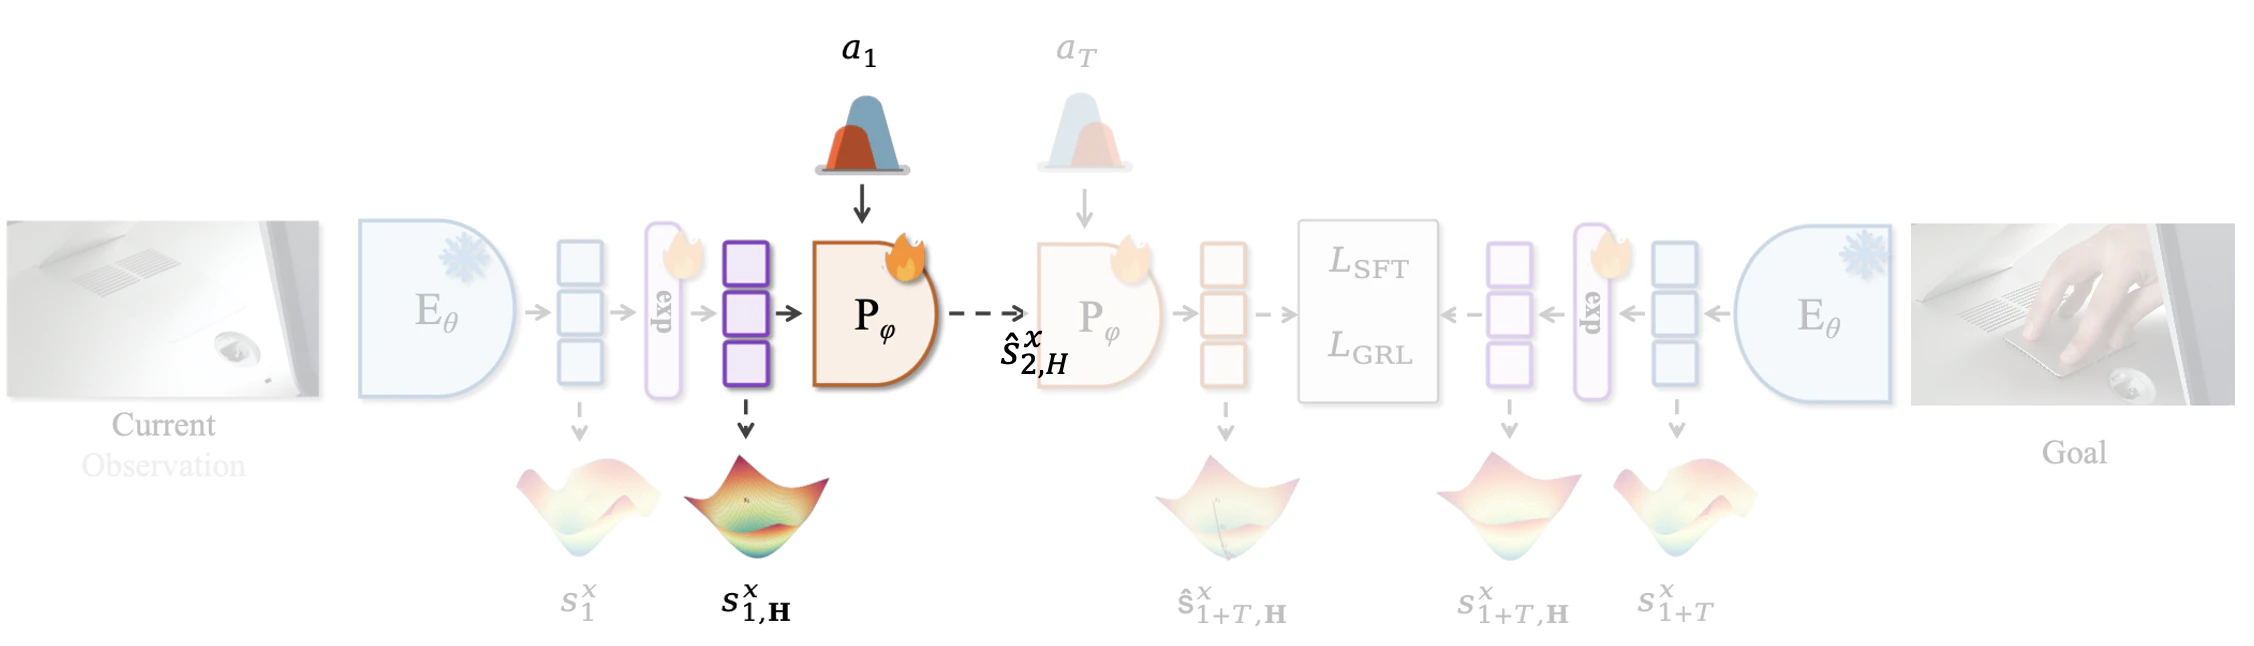
Action-conditioned Predictor $P_\phi$ は、 $(s_{t,\mathbb H},a_t)$ から次の状態 $\hat{s}_{t+1,\mathbb H}$ を予測する。つまり、
P_\phi(s_{t,\mathbb H},a_t)
=
\hat{s}_{t+1,\mathbb H}
というWorld Modelを学習する。
3.4 Loss
通常のEuclidean distanceやMSEではなく、Poincaré ball上の双曲距離(geodesic distance)を使用する。
d_{\mathbb H}(u,v)
=
\frac{1}{\sqrt c}
\operatorname{arcosh}
\left(
1+
\frac{2c\| |u-v \| |^2}
{(1-c\|u\|^2)(1-c\|v\|^2)}
\right)
わかりやすく $c=1$ として考えると、まず分子は二点 $u, v$ の距離的なもの。
一方で分母の $(1-c|u|^2)(1-c|v|^2)$ は $u, v$ が半径1の円周上に近づくと大きくなる。 よって分数全体では円周との近さで補正した距離。
以下は arcosh 関数のグラフ。
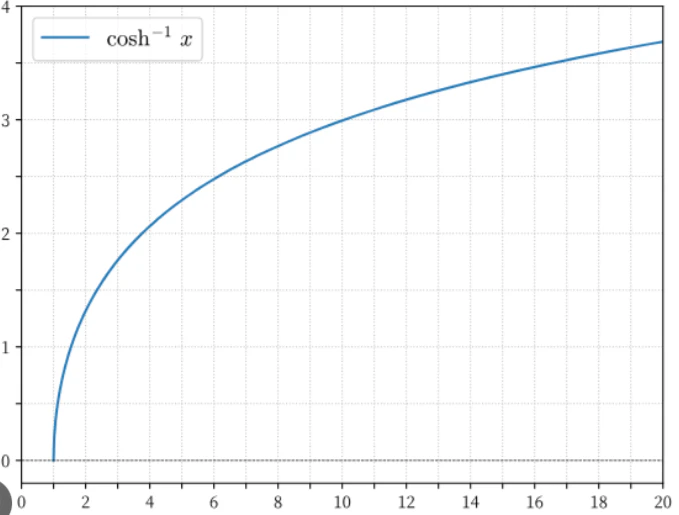
r方向は conh で写像したので、逆関数をとると、r方向における位置による重みは相殺されるだろう。一方で、θ方向の距離はより大きく評価される。
下図の双曲空間において、原点に近い「緑点 - 赤点」間は距離が小さいが、「黄点 - 紫点」間は距離が大きい。
Teacher Forcing Loss
(1-step predictionについて)次の観測を同様に encode -> 双曲空間に写像、したものとの hyperbolic distanceを計算する。つまり
\mathcal{L}_{TF}
=
\frac{1}{T}
\sum_t
d_{\mathbb H}
(
\hat{s}_{t+1,\mathbb H},
s_{t+1,\mathbb H}
)
として、予測状態と正解状態の双曲距離を小さくする。
Rollout Loss
さらにPredictor自身の出力を次の入力として利用する。つまり
\begin{eqnarray}
\mathcal{L}_{rollout} &=&
\frac{1}{T} \sum_t d_{\mathbb H} \left(P_\phi \left({\rm exp_0} \left(E_\theta \left(x_t \right) \right) , a_t, a_{t+1} \right), {\rm exp_0} \left( E_\theta \left(x_{t+2} \right) \right)\right) \\

&=& \frac{1}{T} \sum_t d_{\mathbb H} (\hat{s}_{t+2,\mathbb H}, s_{t+2,\mathbb H}) \\

\end{eqnarray}
を計算する。最終的なsupervised lossは、2-step分を加味して
\mathcal{L}_{SFT}
=
\lambda\mathcal{L}_{TF}
+
(1-\lambda)\mathcal{L}_{rollout}
とする。これによって、1-stepだけでなくmulti-step predictionにも耐えられるPredictorを学習を狙う。
3.4 Geometric Reinforcement Learning
Supervised Training後、さらに Geometric Reinforcement Learning(GRL) でPredictor $P_\phi$ をfine-tuning する。学習対象は引き続き World Model のPredictor $P_\phi$ 。
まず各stepのEnergy Costを、
c_t
=
d_{\mathbb H}
(
\hat{s}_{t+1,\mathbb H},
s_{t+1,\mathbb H}
)
とする。Rewardはその符号を反転して、
r_t=-c_t
とする。したがって、
予測が正しい
   ↓
Hyperbolic distance 小
   ↓
Energy 小
   ↓
Reward 大
となる。
そして1-stepだけでなくtrajectory全体について、
\sum_{t=1}^{T}
\gamma^{t-1}
d_{\mathbb H}
(
\hat{s}_{t+1},
s_{t+1}
)
を小さくするようPredictorを追加学習する。
さらに、予測trajectoryが双曲空間上でgeodesic-consistentになるよう、Triangle Inequality Regularization $\mathcal{L}_\Delta$ を追加します。
最終的には、
\mathcal{L}_{GRL}
=
\mathbb{E}
\left[
\sum_{t=1}^{T}
\gamma^{t-1}
d_{\mathbb H}
(
\hat{s}_{t+1},
s_{t+1}
)
\right]
+
\beta\mathcal{L}_{\Delta}
となる。
つまり、
- SFT:1-step / 2-stepの予測精度を学習
- GRL:長いtrajectory全体で誤差が小さくなるようPredictorを追加学習
と学習する。
この図で、$S_1$ 時点でパラメータを更新するために、$s_1$ と $\hat{s_1}$ との距離に割引率をかけたもの、$s_2$ と $\hat{s_2}$ との距離に割引率をかけたもの、・・・と足していき、報酬とする。
3.5 Planning
学習終了後はEncoderとPredictorをfreezeする。
現在状態 $s_1$ とgoal $s_{T+1}$ が与えられたとき、様々なAction sequenceをPredictorに入力する。
Action候補 A
s1 → ŝ2 → ŝ3 → ŝ4
                 ↓
              Goalとの距離

Action候補 B
s1 → ŝ2 → ŝ3 → ŝ4
                 ↓
              Goalとの距離
最終予測状態とgoalとの双曲距離、
d_{\mathbb H}
(
P(a_{1:T};s_1),
s_{T+1}
)
が最小になるAction sequenceを探す。
Action探索には**Cross-Entropy Method(CEM)**を使用する。
4. 実験と結果
4.1 使用したdataset
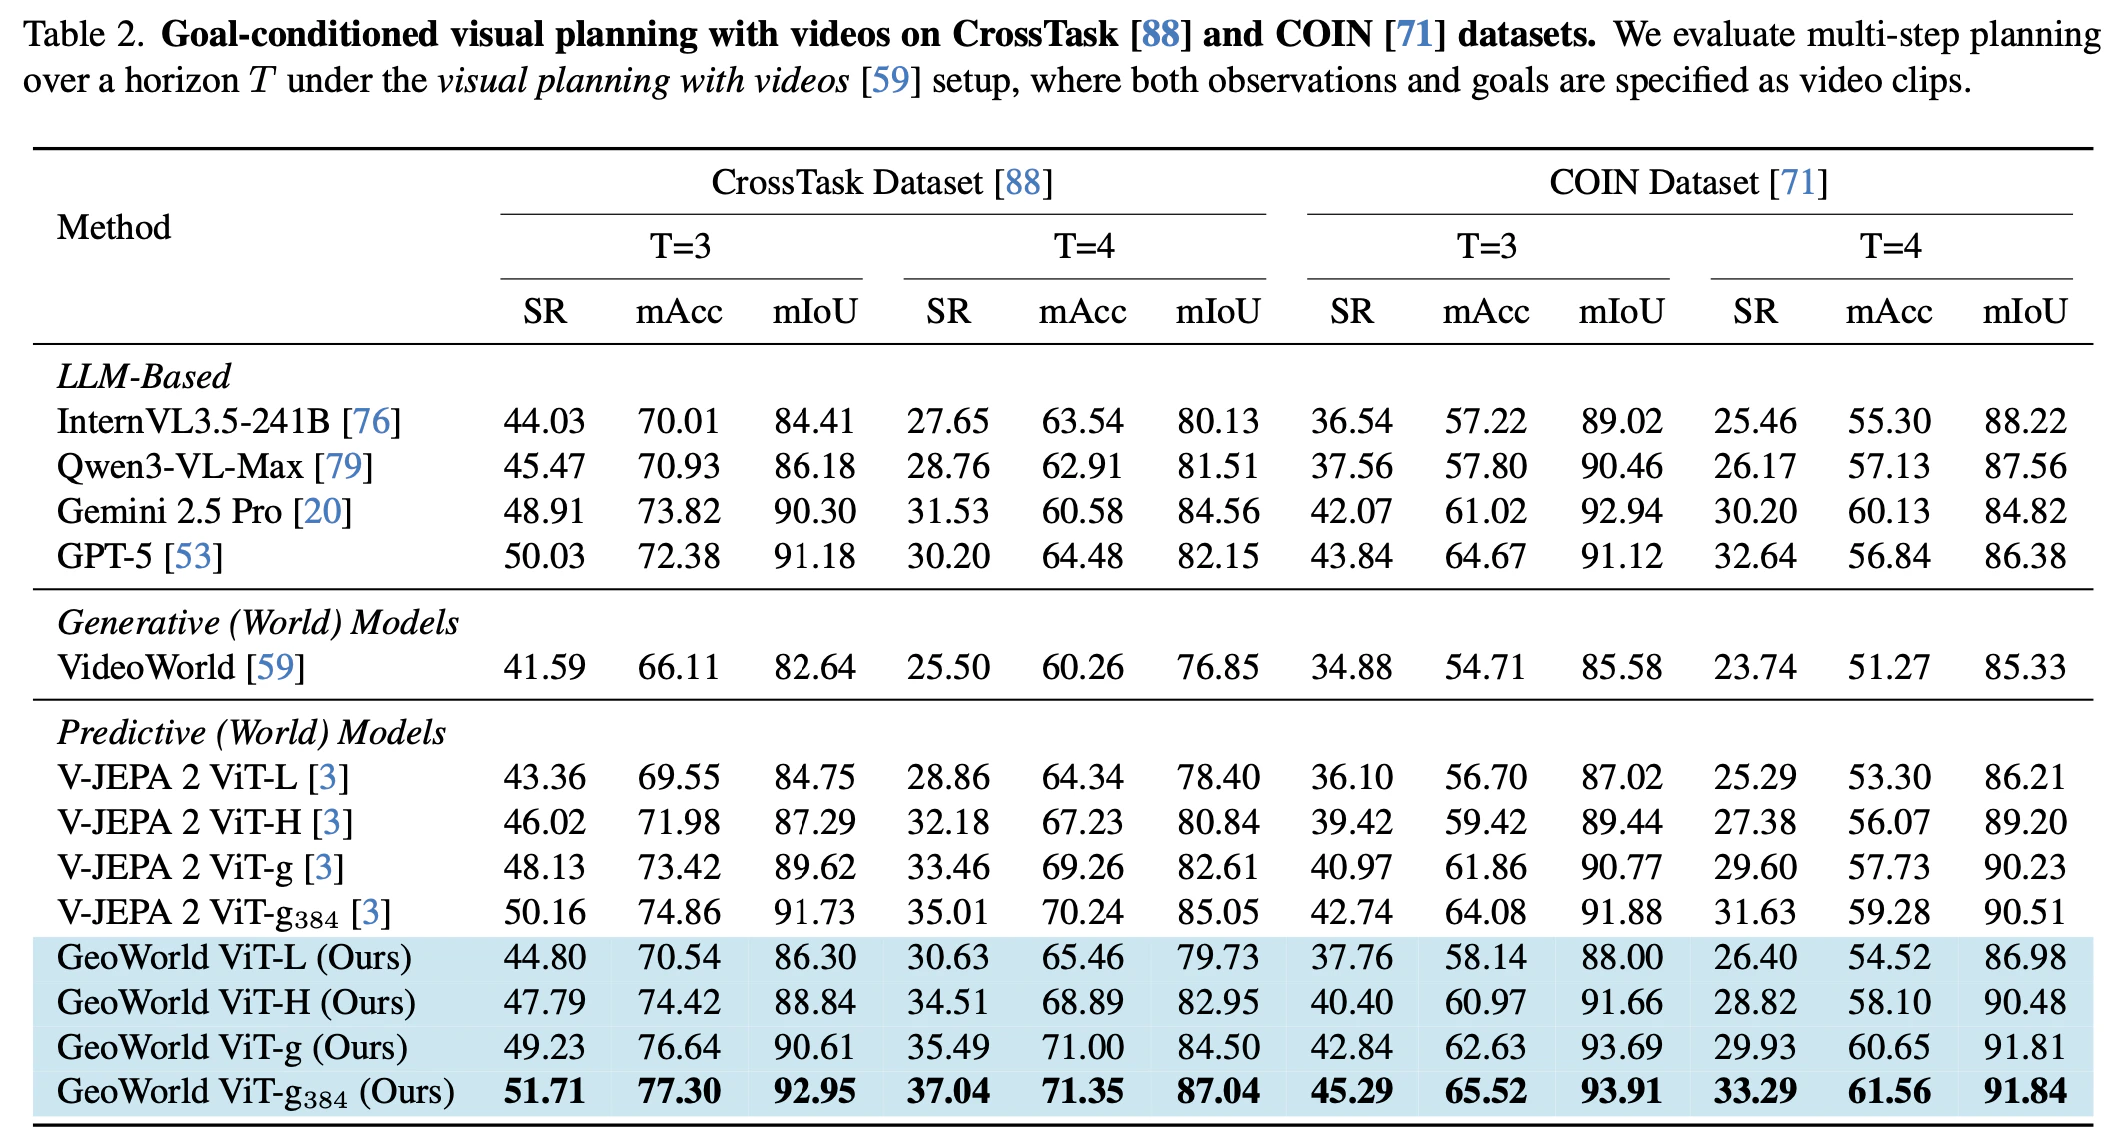
評価にはgoal-conditioned visual planning用の以下のdatasetが使用されている。
-
CrossTask
- 4.7K videos
- 83 tasks
- 105 actions
-
COIN
- 11,287 videos
- 180 tasks
- 778 actions
4.2 メトリクス
評価指標には、
- SR (Success Rate)
- mAcc (Mean Accuracy)
- mIoU
を使用している。
4.3 定量的評価1
特にV-JEPA 2との比較では、video-based planningにおいてViT-g/384を使った場合、以下の結果になっている。
4.4 定量的評価2
さらにCrossTaskでplanning horizonを長くすると、
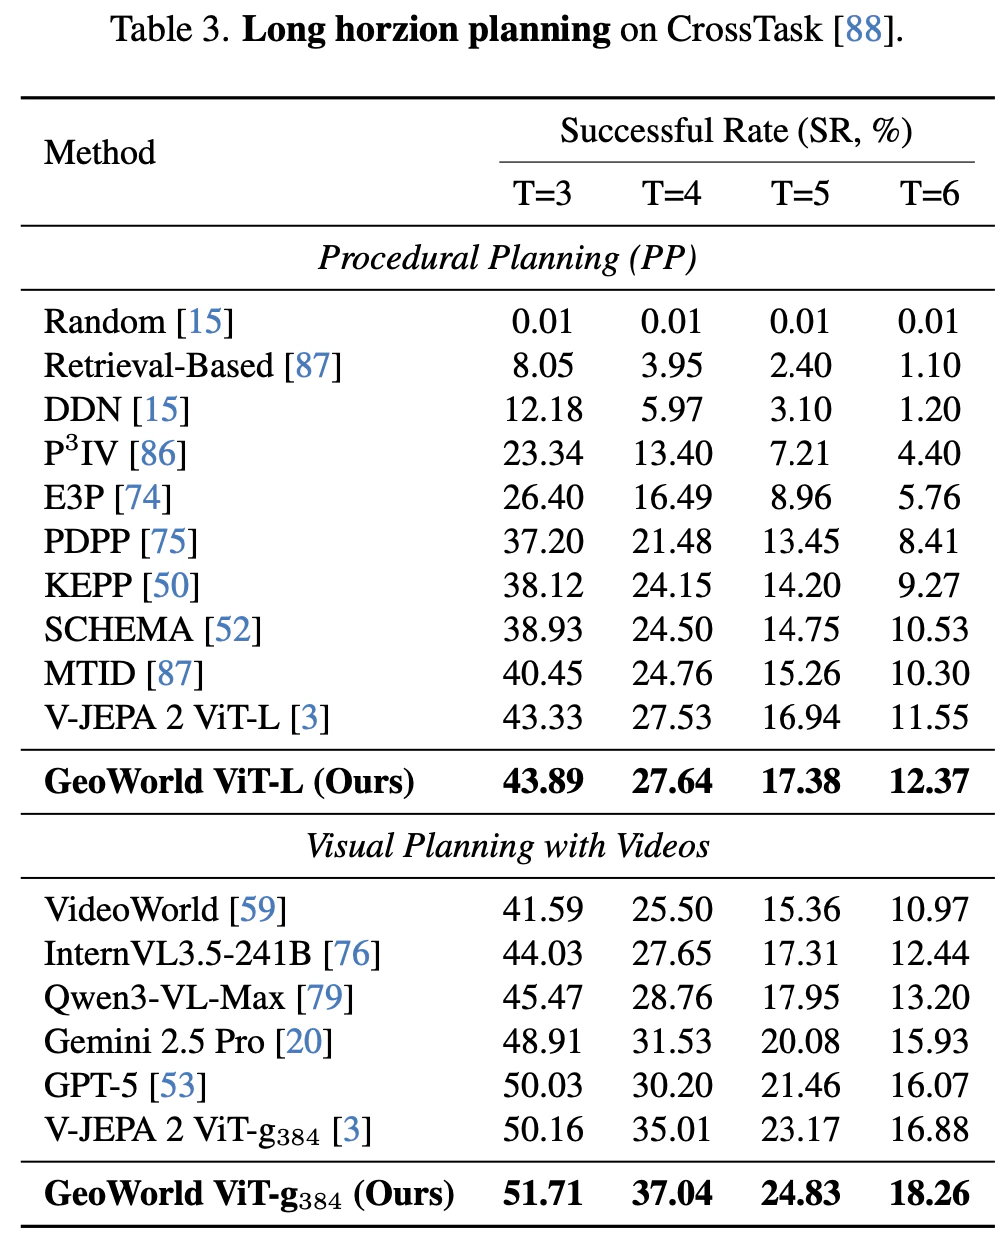
となり、long-horizonでもGeoWorldが改善している。
論文全体では、V-JEPA 2に対しておおむね、
- 3-step planning:SR 約+3%
- 4-step planning:SR 約+2%
の改善と報告されている。
まとめ
GeoWorldのポイントは、単純に「双曲空間を使った」ことだけではなく、
World Modelのlatent space自体に、planningに適したgeometryを持たせる
という考え方にある。
従来のPredictive World Modelではlatent representationを基本的にEuclidean spaceとして扱ってた。
GeoWorldでは、
Euclidean latent
      ↓
Hyperbolic latent
      ↓
Geodesic distanceによる学習
      ↓
Multi-step GRL
      ↓
Energy-based Planning
という構成にすることで、階層的・分岐的な状態遷移を表現し、long-horizon planningの改善を狙っている。
一方で、実験はCrossTaskやCOINのinstructional video上のaction-sequence planningであり、実ロボットの連続制御で直接検証したものではありません。また、ユークリッド空間でも高次元latentを使えば階層構造を表現できるため、「双曲空間でなければ表現できない」というものでもない。
その意味ではGeoWorldは、
「World Modelのlatent representationにどのような幾何構造を持たせるべきか」
という問いを明示的に扱った研究として興味深いと考えられる。
感想
- 厳かに双曲空間に写像している割には精度改善がわずかな気がする。ユークリッド空間から限定的なhyperbolic関数で双曲空間に写像するという手法は面倒臭い割には効果が低いか。
- 一方で強化学習で経路を学習する仕組みは効果があると思われ、こちらは今後も採用される可能性が高いか