
はじめに
「RTX 5060 Ti 16GB を 3 枚にしたのは無駄遣いではなかったのか?」シリーズの続きです。前々回・前回はこちらです。
- RTX 5060 Ti 16GB を3枚にした(3枚目は M.2 → OCuLink で外付け)
- RTX 5060 Ti 16GB×3 で Qwen3.8-27B を vLLM・SGLang・TensorRT-LLM で動かし比べてみた
vLLM や SGLang は、たくさんのリクエストをまとめて同時に処理するのが得意です。
それなら、たくさんの NPC が同時に LLM に問い合わせて、話したり動いたりする「鑑賞ゲーム」のようなものが作れるのではないかと考えて、やってみました。
動いているところの動画です。
知りたかったのは次の 2 つです。
- 処理が追いつくか。 1 台の PC の推論サーバーで、何体までなら待ち時間が気にならない速さで回せるか
- それらしく振る舞うか。 ローカル LLM に任せた NPC が、性格や記憶に沿った行動や会話をするか
作ったもの:llm-island
島で 100 体の住人が暮らすシミュレーションです。
- 住人は歩き回り、出会った相手と会話する。会話のあとは相手への好き嫌いや聞いた噂を覚える
- ときどき島の外から悪の魔物「ヤミゴースト」がやってきて、住人を爪でフリーズさせる。戦士は超能力で戦い、ヒーラーはフリーズした仲間を魔法の杖で助けに行く
- 何を言うか・どこへ行くか・助けに行くかは、住人ごとの LLM 呼び出しで決まる(ヤミゴーストが誰を狙うかも LLM が決める)
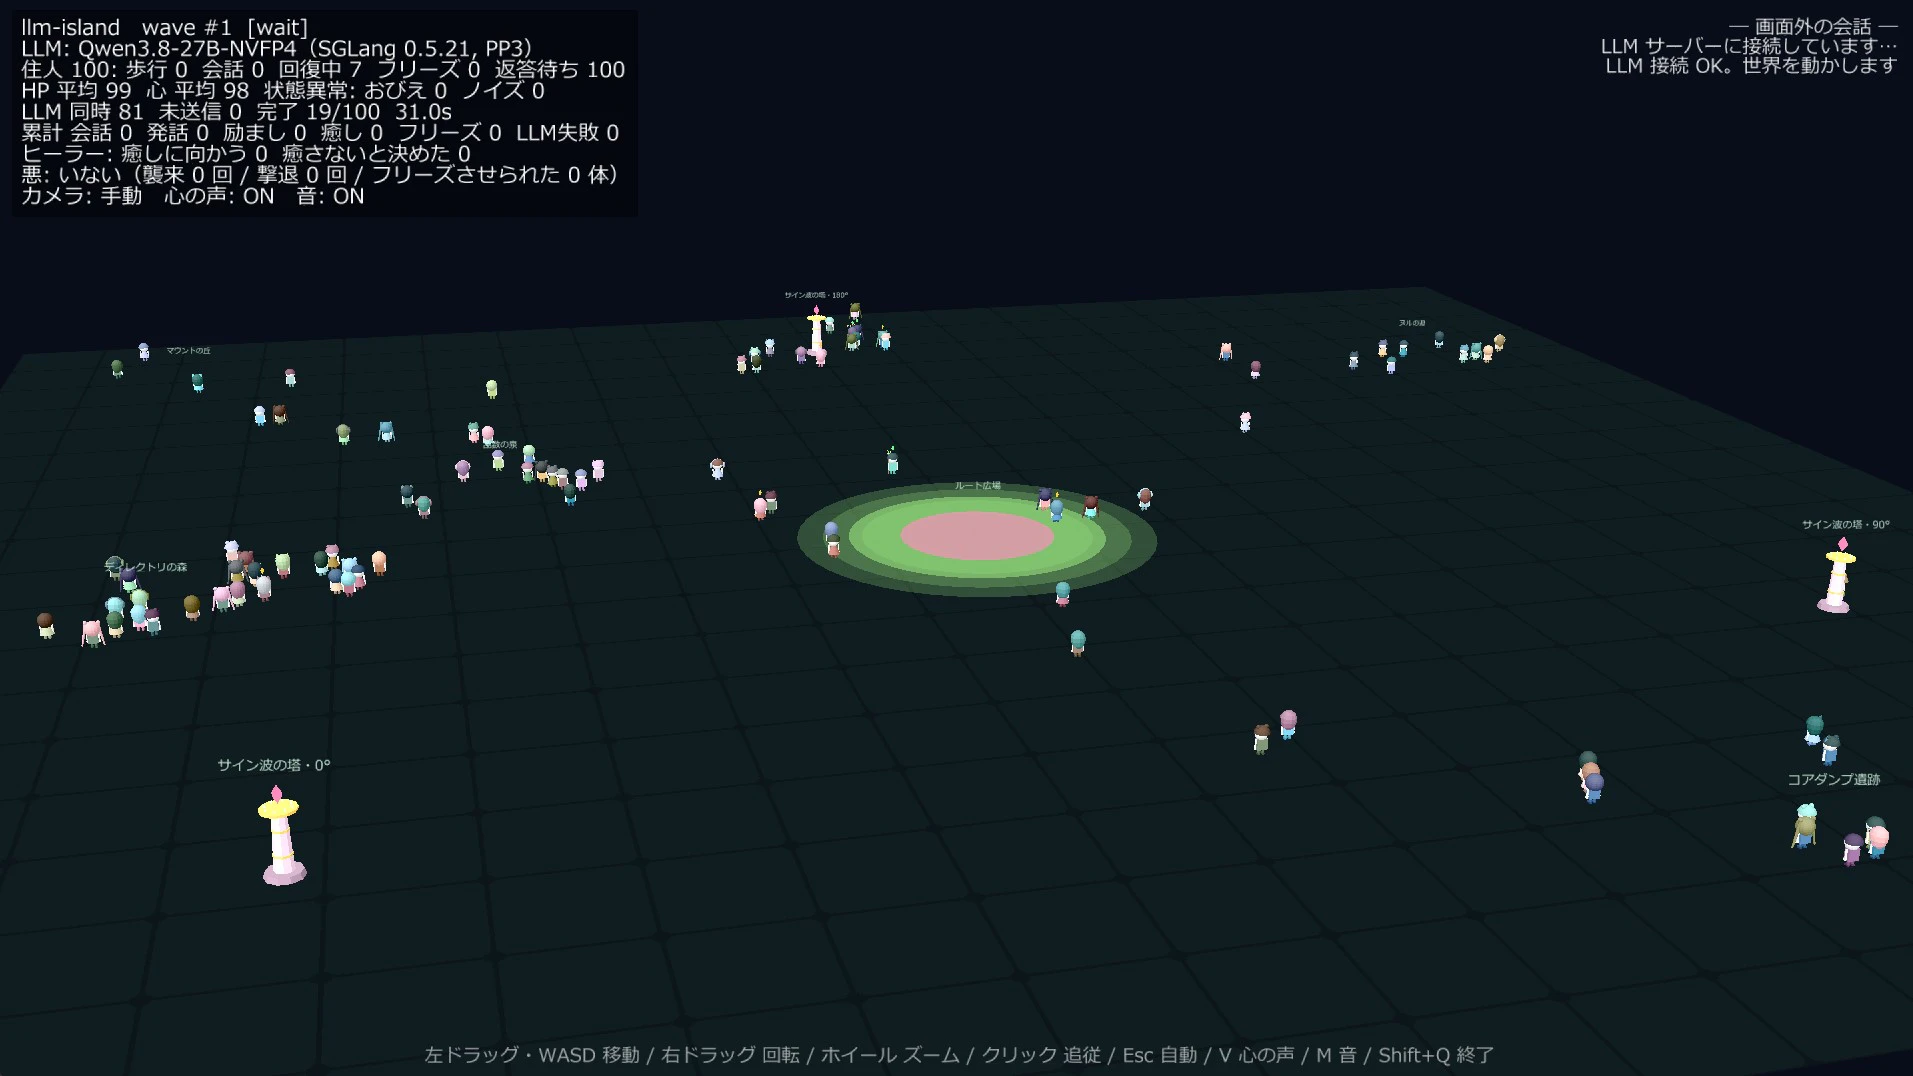
島の全体。起動直後の 1 回目のウェーブで、100 体全員が「どこへ行くか」の返答を待っているところ(左上は状況の表示)
住人 1 体が LLM に聞くことは、次の 4 種類です。
| 種類 | いつ | 返してもらうもの |
|---|---|---|
| 発話 | 会話中で自分の番のとき | セリフ、会話を終えるか |
| 移動の意図 | 前の行動が終わったとき・魔物に気づいたとき | どこへ行くか・誰を探すか・逃げるか戦うか、心の声 |
| 救助の判断 | ヒーラーがフリーズした住人のそばに来たとき | 杖で癒すか、そのときのセリフ |
| 会話の要約 | 会話が終わったとき | 振り返り、要約、好感度の変化、聞いた噂 |
ヤミゴーストも、島にいる間は同じしくみで LLM に「次に誰を狙うか・もう去るか」を聞きます(後述)。
Python だけで書いていて、3D の表示は Ursina です。
リポジトリ: https://github.com/lumavrenor/llm-island
結論
先に結論を書きます。
- 作れました。ただし 100 体くらいまで。 住人 100 体で、1 ウェーブ(後述。約 58 件の問い合わせ)が約 26 秒。200 体だと約 45 秒で、住人 1 体あたりの会話や行動の間隔も 2 倍近くになります
- まとめて投げる効果は大きい。 1 件ずつ順番に投げるのに比べて、約 8 倍の数をさばけました。ただし「100 件を同時に投げても 1 件と同じ速さ」にはならず、8 件でも 1 件の約 2 倍の時間がかかりました
- それらしい振る舞いは出ました。 性格どおりの口調、相手ごとの好き嫌い、苦手な相手を苦手なままにする態度、又聞きの噂などが、コードで決め打ちせずに出てきます。一方で、噂はあまり遠くまで広まりません
- ヤミゴーストとの戦いも LLM で回りました。 ヤミゴーストは撃ってくる戦士を避けて無防備な住人を狙い、住人は「ヤミゴーストが近い、急げ!」と声をかけ合い、ヒーラーはフリーズした仲間を起こしに行きます
テンポは「リアルタイムに会話が飛び交う」ではなく、「20〜30 秒ごとに島のあちこちで一斉に話が進む」感じです。
眺めるだけの鑑賞ゲームなら、これで十分に成り立ちました。
環境
| 項目 | 値 |
|---|---|
| GPU | RTX 5060 Ti 16GB × 3(計 48GB、P2P なし、PCIe。1 枚は画面出力も兼ねる) |
| OS | Windows 11 + WSL2(推論サーバーは WSL2 側、ゲームは Windows 側) |
| 推論サーバー | SGLang 0.5.21(OpenAI 互換 API) |
| モデル | Qwen3.8-27B NVFP4(KV キャッシュは fp8_e4m3、コンテキスト 8192) |
| 並列 | PP3(パイプライン並列 3 段) |
作り方のポイント
全員分を「ウェーブ」でまとめて投げる
住人ごとにスレッドや非同期タスクを作って LLM を呼ぶと、リクエストがバラバラに飛び、世界のデータを誰がいつ書き換えるのかもややこしくなります。
こうなると、Claude Code を使っていてもバグが取りきれません。そこで、LLM への問い合わせを「ウェーブ」という単位にまとめました。
- collect: 返答が必要な住人全員分のリクエストを集めて、一度に投げる
- wait: 全部返るまで待つ(その間も住人は歩き続ける)
- play: 結果をまとめて反映し、セリフのふきだしを見せる時間だけ待つ → 1 へ
メインループは毎フレーム World.update() を呼ぶだけで、その中で次のように状態を進めます。
def _wave_frame(self):
    match self.wave_state.update():
        case "collect":
            ...
            reqs = self._build_requests()
            self.wave = self.llm.submit(reqs)   # 全員分を一度に投げる
            self.wave_state.change("wait")

        case "wait":
            if not self.wave.is_done():          # 全部返るまで毎フレーム確認するだけ
                return
            self.play_sec = self._apply_wave(self.wave.results())
            self.wave_state.change("play")

        case "play":
            if self.wave_state.elapsed >= self.play_sec / self.speed:
                self.wave_state.change("collect")
- HTTP の送受信は裏のスレッド 1 本(asyncio)だけで行い、世界のデータには触らせません。渡すのはリクエストと結果のただのデータだけなので、ゲーム側はシングルスレッドのまま書けます
- 住人 1 体が出すのは 1 ウェーブに 1 件まで(発話 > 救助の判断 > 移動の意図、の優先順)。要約や魔物の判断は行動を止めないので、同じウェーブに追加で乗せます
- 返答を待っている間に状況が変わることがあります(魔物が来た、相手がフリーズした、など)。結果を反映する前に必ず確かめて、古い判断は捨てて聞き直します
- play の間に次のウェーブを投げておけば、GPU が空く数秒を埋めて少し速く回せます。ただ流れが一直線でなくなるので、デモではシンプルさを優先してやっていません
この作りだと、ウェーブ 1 回の時間 = 住人 1 体が次に話したり動いたりできるまでの間隔になります。
ウェーブの中でいちばん遅い 1 件を全員が待つので、ここが短いほど島がにぎやかになります。
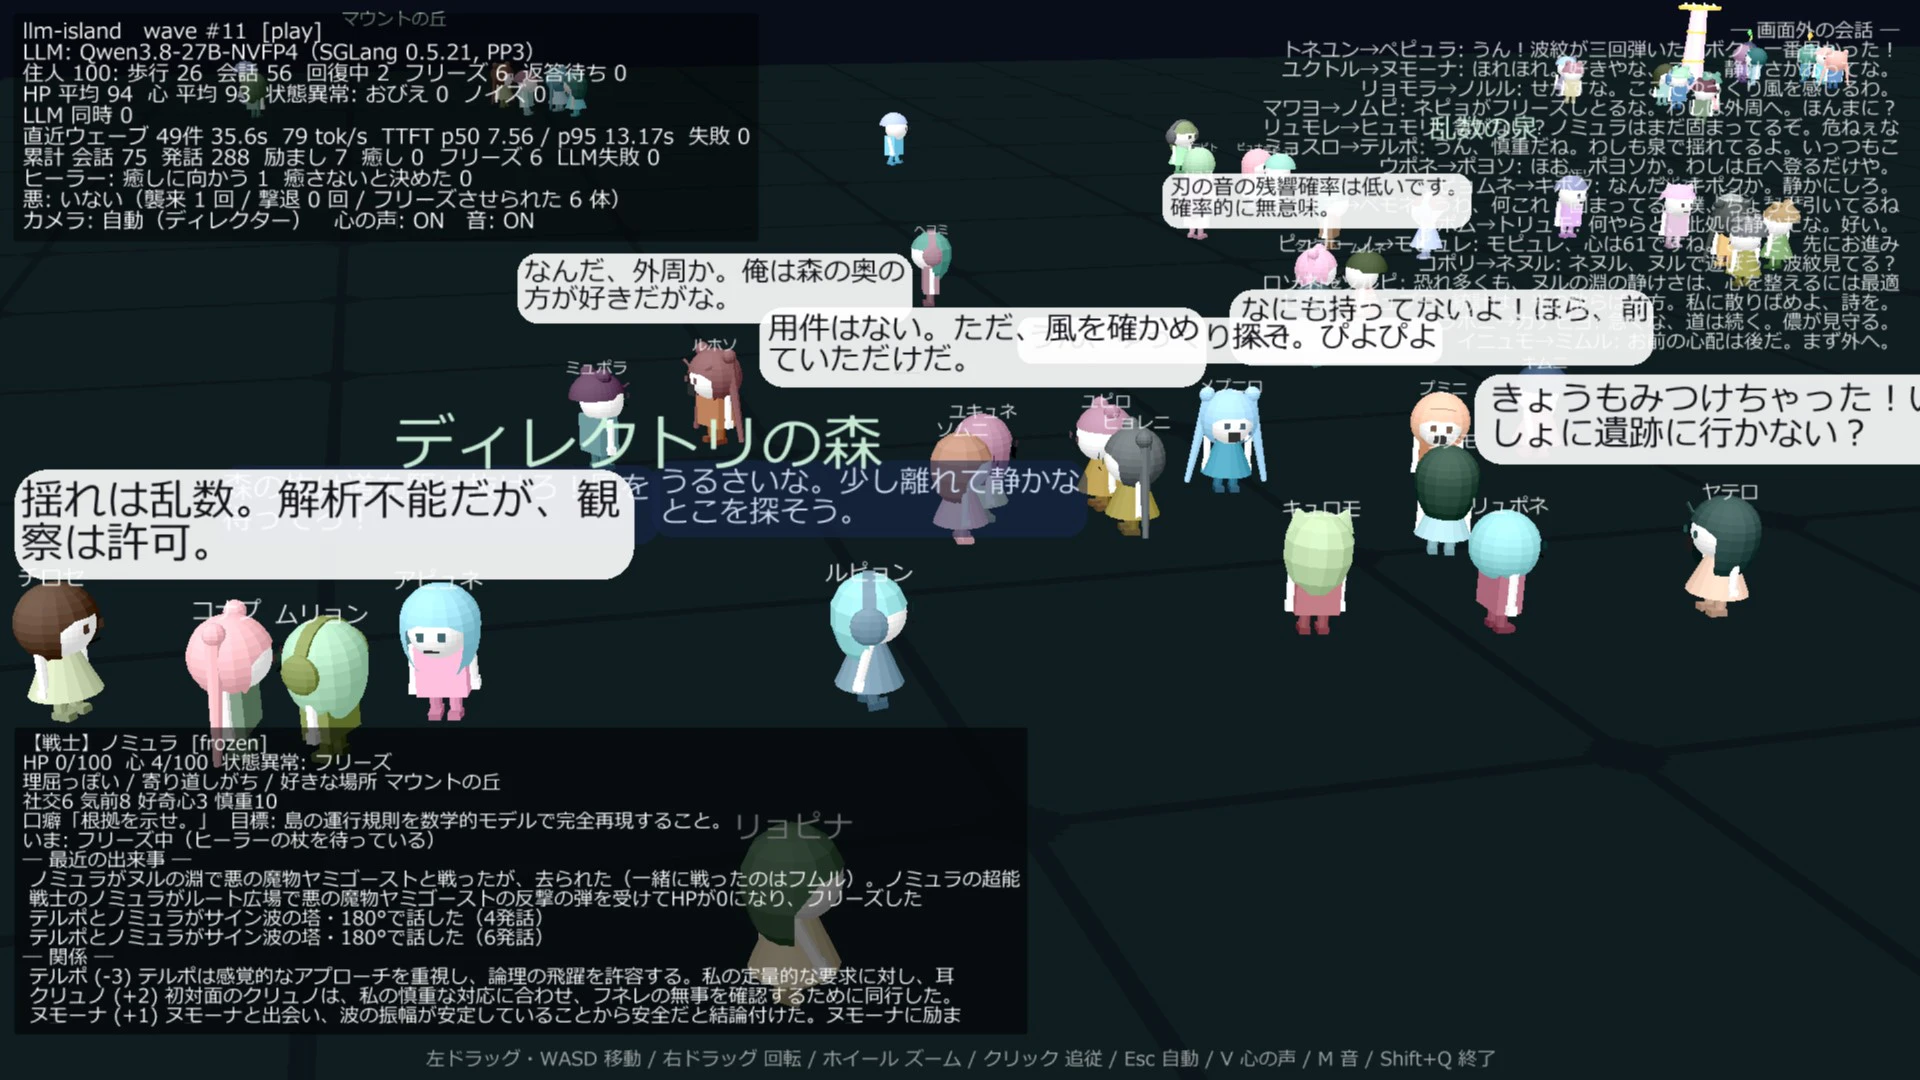
play の瞬間。返ってきたセリフが島のあちこちで一斉にふきだしになる。右上は画面の外の会話、左下はカメラが追っている住人の性格・最近の出来事・相手ごとの印象
返答は JSON スキーマで縛り、短くする
返答はすべて JSON スキーマで形を決めています(response_format の json_schema)。
例えば移動の意図を聞くと、住人はこういう JSON だけを返します。
{"intent": "seek", "target": "(会いたい住人の名前)", "pace": "fast",
 "manner": "早く会って話を聞いてほしい", "duration_sec": 60}
この形は、次の関数で作るスキーマで決めています。
def _intent(kinds) -> dict:
    return _obj({
        "intent": {"type": "string", "enum": list(kinds)},  # go_spot / seek / avoid / flee / fight など
        "target": {"type": "string"},
        "pace": {"type": "string", "enum": list(PACES)},
        "manner": {"type": "string"},                      # 心の声
        "duration_sec": {"type": "integer"},
    })
選べる意図は住人ごと・状況ごとに変えています(魔物に気づいていなければ flee は無い、戦士だけ fight がある、など)。
選べない行動はスキーマの時点で出せないので、反映側で弾く処理が要りません。
長さはスキーマでは縛らず、プロンプトで「40字以内」と頼んだうえで、反映するときに切り詰めています(文字数の制約をスキーマに書くと、制約デコードの実装差で 400 エラーになることがあるため)。
Qwen3 の thinking は常にオフにしています(chat_template_kwargs: {"enable_thinking": false})。
考えさせたいところは、JSON の項目の順番を使って「先に振り返りを書かせてから要約を書かせる」ようにしました。
推論サーバーの設定
python -m sglang.launch_server \
  --model-path Qwen3.8-27B-NVFP4 --served-model-name npc \
  --tp-size 1 --pp-size 3 \
  --context-length 8192 --mem-fraction-static 0.93 --kv-cache-dtype fp8_e4m3 \
  --max-running-requests 48 --max-queued-requests 192 \
  --cuda-graph-max-bs-decode 48 --disable-prefill-cuda-graph \
  --disable-radix-cache --reasoning-parser qwen3 \
  --host 127.0.0.1 --port 30000
試してわかったこと:
-
同時処理数(
--max-running-requests)がいちばん効く。ただし大きければ速いわけではない。 Qwen3.8 は層の多くが線形アテンションで、リクエストごとに大きな状態を持ちます。サーバーは起動時に同時処理数ぶんの状態を確保し、残りが KV キャッシュになります。100 にしたら KV キャッシュが足りず、実際に同時に動いたのは 9 件ほどでした。48 の方が速くなりました - 同時処理数を超えた分は待ち行列(
--max-queued-requests)で待ちます。ゲーム側で同時に投げる数を 100 件までにしている(1 ウェーブがそれより多いときは、超えた分をゲーム側で待たせてから投げる)ので、48 + 192 なら溢れません -
--cuda-graph-max-bs-decodeは同時処理数と同じにする。小さいと、それを超えたバッチが何倍も遅くなりました - P2P のない GPU 3 枚では、テンソル並列(TP2、2 枚)よりパイプライン並列(PP3、3 枚)の方が約 4 倍速くなりました(使う枚数が違うので、条件をそろえた比較ではありません)
処理は追いつくか
測り方
普段動かしている世界のセーブデータのコピーを使い、2 通りで測りました。
- ゲームを実際に動かす。 住人 100 体と 200 体で、本物の LLM を使って実時間 6〜9 分動かす。あわせて全ウェーブのリクエストをそのまま記録しておく
- 件数だけを変えて投げ直す。 1 で記録した実際のリクエストから K 件を選び、1 ウェーブとして一度に投げる(K = 1〜240)
「ゲームを動かす」だけだと件数を自由に選べず、「ダミーのプロンプトで測る」だけだと実際の出力の長さのばらつきが入りません。
実際のリクエストを記録して投げ直すことで、両方を見られるようにしました。
1 件ずつより約 8 倍さばける。でも「1 件と同じ速さ」ではない
一度に投げる件数を変えたときの、ウェーブ 1 回の時間です(2 の方法で、記録した実際のゲームのリクエストを投げ直したもの。各 2〜3 回測った範囲)。
| 一度に投げた件数 | 時間 | 1 件あたり | TTFT 中央値 |
|---|---|---|---|
| 1 | 3.2〜4.6 秒 | 3.2〜4.6 秒 | 0.5〜0.6 秒 |
| 4 | 6.6〜7.0 秒 | 1.7 秒 | 1.0〜1.1 秒 |
| 8 | 6.6〜6.8 秒 | 0.84 秒 | 1.3〜1.4 秒 |
| 16 | 9.8〜12.6 秒 | 0.6〜0.8 秒 | 1.9〜2.0 秒 |
| 24 | 11.0〜15.4 秒 | 0.5〜0.6 秒 | 2.5〜2.8 秒 |
| 48 | 19.2〜21.0 秒 | 0.43 秒 | 4.3〜4.7 秒 |
| 96 | 42.1〜44.7 秒 | 0.44〜0.47 秒 | 11.8〜13.5 秒 |
| 144 | 61.0〜66.2 秒 | 0.42〜0.46 秒 | 21.5〜29.3 秒 |
| 192 | 81.6〜91.0 秒 | 0.43〜0.47 秒 | 32.1〜34.6 秒 |
- 件数を 8 倍にしても、時間は 2 倍程度です(中央値で 1 件 3.4 秒 → 8 件 6.8 秒)。1 件から 4 件で約 2 倍になり、4 件から 8 件ではほとんど変わりません。1 件だけだと、3 段のパイプラインのうち 1 段ずつしか働かず、GPU が遊んでいるのだと思われます
- 16〜48 件で 1 件あたりの時間が下がりきります
- 48 件(同時処理の上限)から上は、件数に比例して長くなります。 1 件 ≒ 0.44 秒で一定。サーバー全体の出力は 120〜140 tok/s で頭打ちでした
「100 件同時に投げても 1 件と同じくらいで返る」はこの環境では成り立たず、100 件だと 1 件の 10 倍以上かかります。
それでも 1 件ずつ順番に投げるより約 8 倍速い(1 件あたり 3.4 秒(1 件だけのときの中央値)→ 0.44 秒)。
住人 100 体の普段のウェーブ(約 58 件)で言えば、1 件ずつなら 3 分以上かかるところが 26 秒で済んでいます。
測定で、同時処理 48 件 + 待ち行列 192 件 = 240 件ちょうどを一度に投げたら、30 件以上が失敗しました(どれも「返答が JSON として読めない」)。
ゲームでは同時に投げる数を 100 件までにしていて、それを超えた分はゲーム側で待ってから投げるので、この失敗は起きていません。
住人 100 体と 200 体
ゲームを実際に動かしたとき(1 の方法)の、落ち着いたあと(ウェーブ 4 以降)の値です。
| 住人 | 1 ウェーブの件数(中央値) | 1 ウェーブの時間(中央値・範囲) | 1 件あたり | 失敗 |
|---|---|---|---|---|
| 100 体 | 57.5 件 | 25.8 秒(19.8〜34.5) | 0.46 秒 | 0 |
| 200 体 | 115 件 | 45.4 秒(38.0〜72.3) | 0.43 秒 | 0 |
住人を 2 倍にすると件数も 2 倍になり、1 件あたりの時間は変わりません。
住人 100 体の時点で、すでに「件数に比例して長くなる」区間に入っていたということです。
1 ウェーブの件数が住人の数の 0.57 倍のまま動かなかったのもおもしろいところです。
ウェーブが長くなればその間に出会いが増えて、次のウェーブの件数が膨らみそうなものですが、返答を待っている住人は次のウェーブに乗らないので、自然に釣り合うようです。
なお、起動直後の 1 回目のウェーブは全員が行き先を聞くので、100 体で 39 秒、200 体で 82 秒かかりました。
プロンプトの長さがそのまま効く
プロンプトは平均約 1,200 トークン、返答は発話 40・意図 60・要約 110〜140 トークンほどです。
入力が長く出力が短い、プリフィル(prefill)の重い負荷です。
開発の途中で HP・心・状態異常・噂などをプロンプトに足したら、入力が 4 割ほど長くなり、ウェーブの中央値は 17 秒から 26 秒に伸びました(原因を分けて確かめてはいません)。
NPC に「覚えていること」を増やすほど、島のテンポは遅くなります。
radix cache は効かなかった
プロンプトの先頭の約 4 割は、全員に共通の文(世界の説明など)です。
SGLang の radix cache は、共通の先頭を一度計算したら結果を取っておき、次のリクエストではその分の計算を省く仕組みです。
これを有効にすれば速くなると思いましたが、このモデルでは速くなりませんでした。
キャッシュ自体は効いていて、1 件あたり約 4 割のトークンが使い回されていました。
遅くなった原因は、前に書いた線形アテンションの状態です。共通の先頭を使い回すには、KV キャッシュに加えて「先頭まで読んだ時点の状態」も取っておく必要があります。
状態は大きいのでその分メモリが減り、同時処理数が 48 件から 12 件に下げられて、約 2 倍遅くなりました。
設定を調整して同時処理数を 42 件まで戻すと、普段の設定との差はばらつきの範囲内になりました。
| 設定 | 同時処理 | 1 件あたり(24 / 48 / 96 件) |
|---|---|---|
| radix 無効(普段の設定) | 48 件 | 0.32〜0.36 / 0.24〜0.30 / 0.27〜0.30 秒 |
| radix 有効 | 12 件 | 0.53〜0.59 / 0.48〜0.54 / 0.51〜0.54 秒 |
| radix 有効 + 同時処理数を戻す調整 | 42 件 | 0.28〜0.36 / 0.28〜0.34 / 0.27 秒 |
線形アテンションを使わない普通のモデルなら、状態を取っておく必要がないので、有効のままの方が速い可能性があります。
この表は、ゲームのリクエストではなく、住人ごとに違う約 1,080 トークンのプロンプトを 24・48・96 件まとめて投げ、出力を 60 トークンにそろえて測りました(各 2 回)。
出力が短くそろっているぶん、1 件あたりは前の表(0.44 秒)より短くなります。前の表とは比べず、この表の行どうしで比べてください。
vLLM は SGLang より遅かった
同じ PC・同じモデルで vLLM 0.29.0 も試しました。SGLang と同じ構成(PP3・同時処理 48)に合わせて調整しましたが、1 分間に返せた数は SGLang の 6 割ほどで、100 件を一斉に投げたときは 2.6 倍の時間がかかりました。
| SGLang | vLLM | |
|---|---|---|
| 1 分間に返せたリクエストの数 | 146 回 | 91 回 |
| 100 件を一斉に投げて全部返るまで | 28 秒 | 73 秒 |
「1 分間に返せたリクエストの数」は、100 人がそれぞれ約 30 秒おきに話しかける負荷をかけて測りました。
vLLM でも、このモデルでは prefix キャッシュが効きませんでした。KV のブロックが 1,568 トークンと大きく、共通の先頭部分がそれより短いので、使い回せなかったためです。
ただし、比べたのはゲームに似せた負荷テストのスクリプトだけです。ゲーム本体を vLLM で動かしてはいません。
また、プロンプトを長くする前の時期に測ったので、上の件数の表(96 件で 42〜45 秒)とは条件が違います。比べられるのは、この表の SGLang と vLLM どうしだけです。
それらしく振る舞うか
ここは数字より、ログから拾った例で紹介します(名前もセリフもすべて LLM が作ったものです)。
性格どおりに話す
住人の性格(口調・好きなもの・苦手なもの)は最初に LLM で 100 体分作っています。
古風な住人は「〜申す」、理屈っぽい住人は「移動コストを最小化する」と、口調は最後まで性格どおりでした。
好き嫌いができ、苦手な相手は苦手なまま
会話のあとに、それぞれの視点で振り返りと好感度の変化を LLM に書かせています。
ガクツ → クウガ(−2)「ぶっきらぼうで嫌味な奴だ。…静かにしろと言ったのに逆切れするあたり、騒音そのものだな」
ピクピク → プーピ(+2)「行動派で、ボクと波長が合う」
この振り返りを次に会ったときのプロンプトに入れると、苦手な相手との再会でも態度が変わらず、悪い印象が続くようになりました。
一方で、励まされて機嫌を直した例もあります。
ザッブ → クウガ(前回 −1「また拒絶された」)⇒ 今回 +1「励まされて少しだけ機嫌が直った気がする。急かすのはやめよう」
噂が伝わる
会話の要約で、相手が話した「ほかの住人の話」を噂として取り出し、次の会話のプロンプトに入れています。
「噂話をしなさい」とは指示していません。それでも、聞いた噂をさらに別の住人に話す「又聞き」が起きました(30 分で 2 件だけですが)。
ジップが知っていた「キクイクがフリーズしている」という話がカオシに伝わり、カオシからさらにソルナへと伝わっています。
会う前に噂で聞いていた相手に、初対面でその話を持ち出すこともありました。
(チクブは「ケイジがフリーズしたらしい」とチカチカから聞いていた)
チクブ: ケイジ、元気?ハイルに助けてもらって一安心だな。ワタシもそばに居るよ。
ハイルが助けたことは、この噂には入っていません。ほかの出来事から知ったのか、LLM が付け足したのかは確かめていません。
うまくいっていないこと
- 噂はあまり遠くまで広まらない。 材料はプロンプトに入っているのに、セリフは目の前のこと(景色・気分・相手の様子)が中心で、第三者の名前が出るのはフリーズや救助が近くで起きたときがほとんどでした
- 噂の中身も、人柄の評判(「○○は嫌なやつ」)より「○○がフリーズしたらしい」のような出来事が中心です
- 話題を持ち出す動機(「今これを話したい」)を持たせるか、もっと長く動かして印象が育つのを待つか、まだ試しているところです
ヤミゴースト・戦士・ヒーラー
会話だけだと、島は穏やかすぎて眺めていても起伏がありません。そこで「困りごと」として、ときどき悪の魔物が来るようにしました。
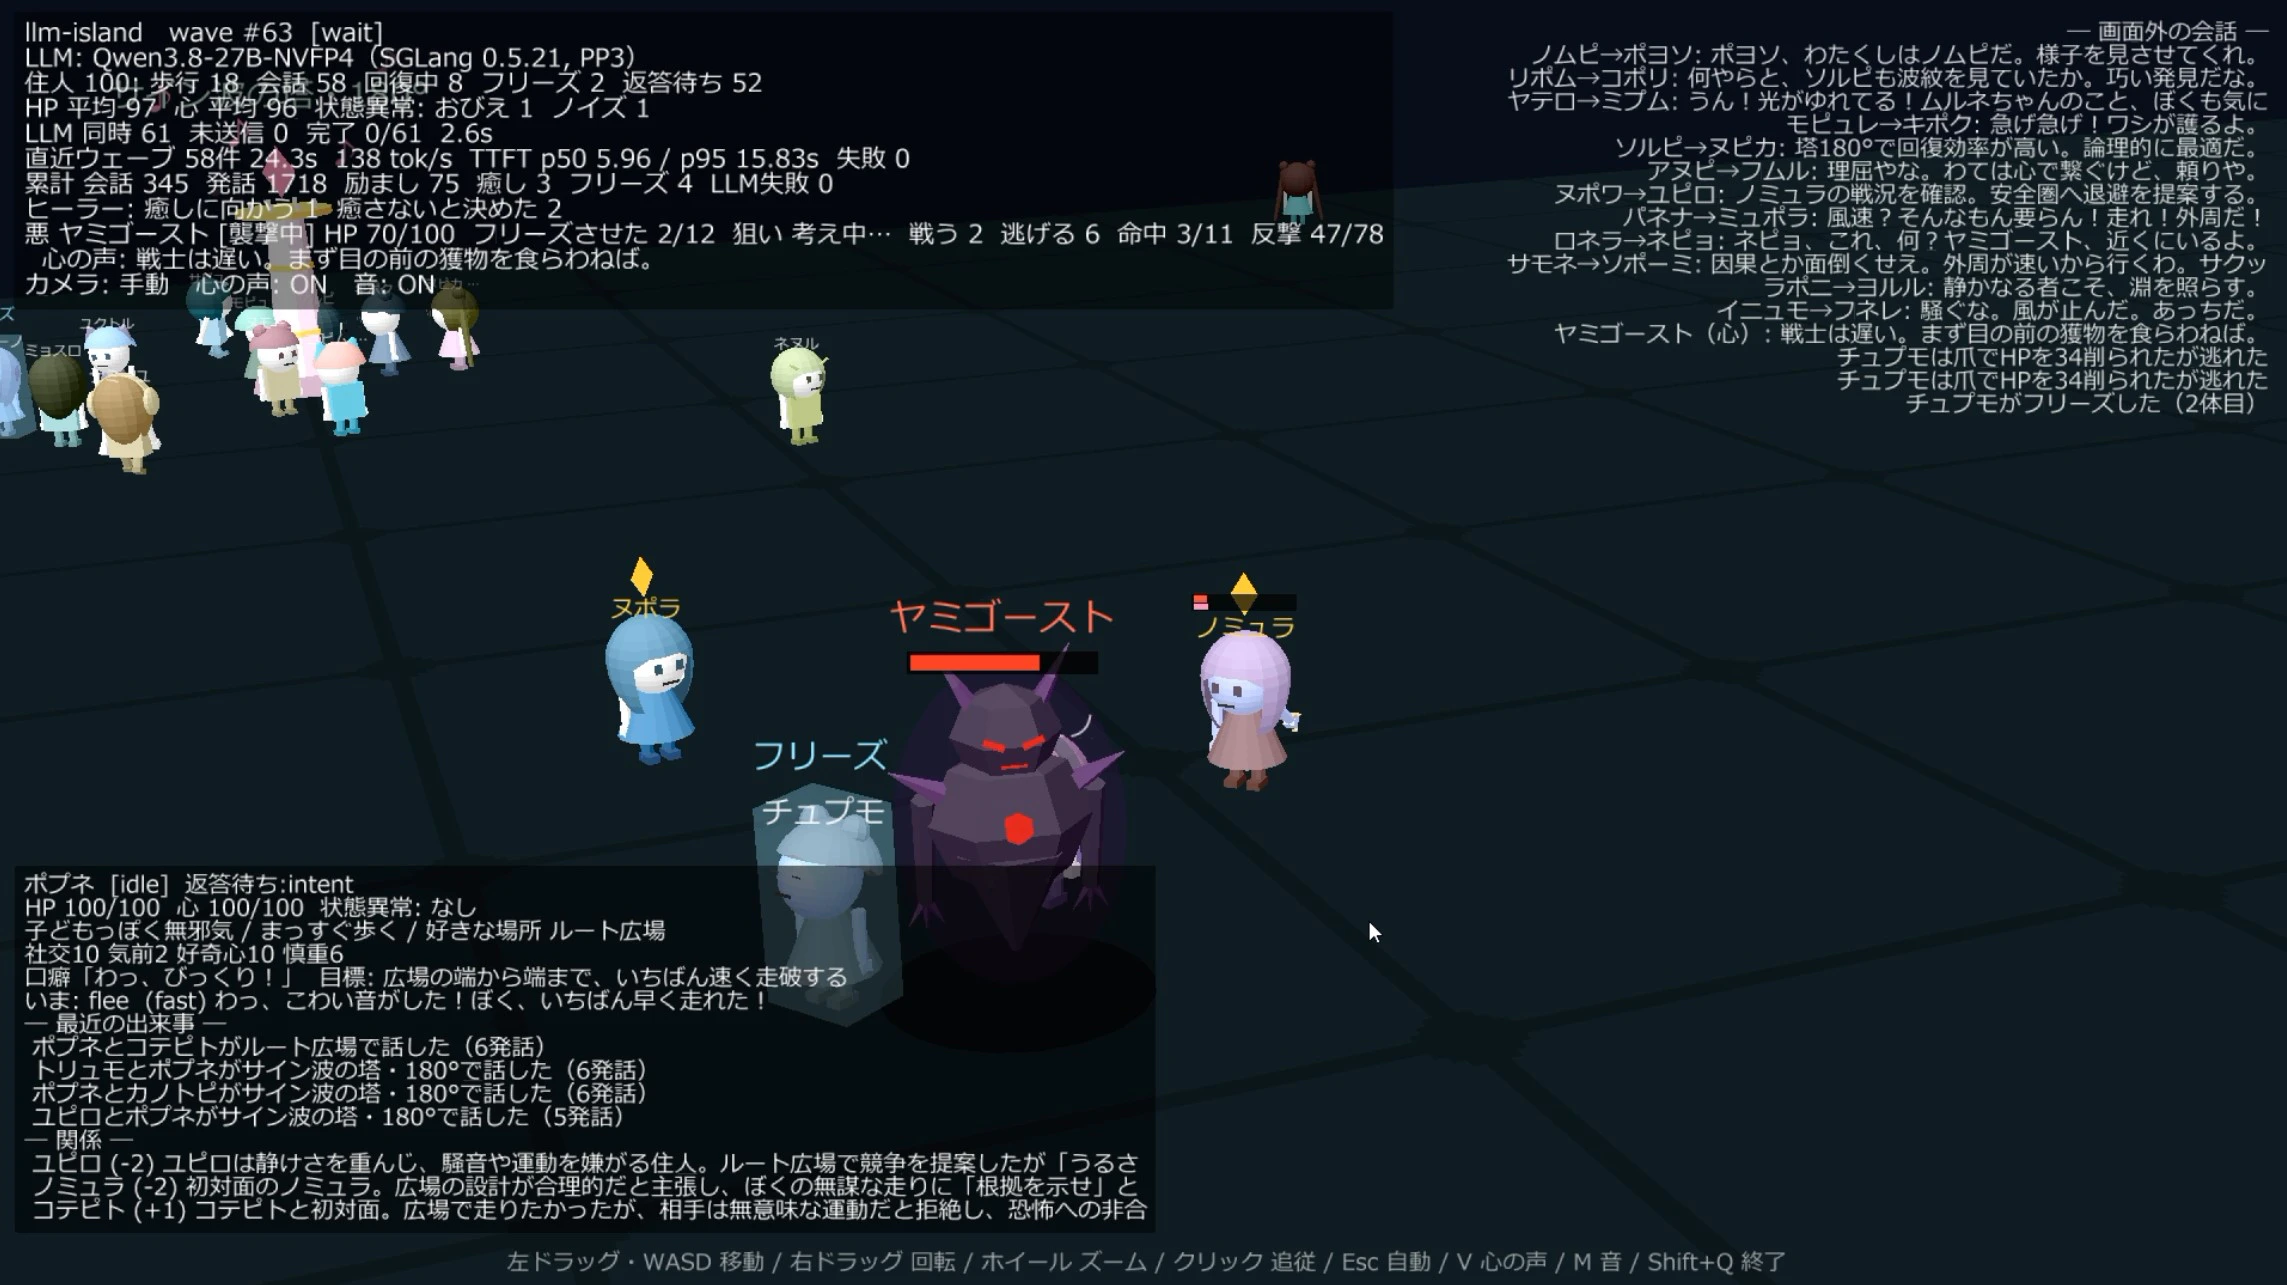
ヤミゴースト(中央)と戦士のヌポラ・ノミュラ。手前の青い箱は、爪でフリーズしたチュプモ。
左上の表示にはヤミゴーストの心の声「戦士は遅い。まず目の前の獲物を食らわねば。」が出ている
| 登場するもの | 数 | LLM が決めること | プログラムがやること |
|---|---|---|---|
| ヤミゴースト | 1 体(去ってから 7〜12 分たつと、また島の端に現れる) | 誰を狙うか・もう去るか、ひとこと、心の声 | 追いかける、爪で攻撃する、撃ってきた戦士に黒い弾で反撃する |
| 戦士 | 住人のうち 5 体 | 戦う(fight)か逃げる(flee)か |
fight の間、届く距離に入ったら 5 秒おきに超能力を自動で撃つ |
| ヒーラー | 住人のうち 3 体 | どのフリーズした住人を助けに行くか、着いたら杖で癒すか、そのときのひとこと | 3 秒の詠唱(その間は動けない)、終わったら HP 満タンで目覚めさせる |
| ほかの住人 | 残り | 逃げるか、ほかの行動を続けるか | 近づかれたら(35m 以内)気づいて、移動の意図を聞き直す |
LLM は「決めるだけ」、動きはプログラム
結論に書いたとおり、ウェーブ 1 回は 20〜30 秒かかります。超能力を 1 発撃つたびに LLM に聞いていたら、戦いになりません。
そこで、LLM には「誰を狙うか」「戦うか逃げるか」「癒すか」だけを決めさせ、追いかける・撃つ・詠唱するといった毎フレームの動きはプログラムが受け持つように分けました。
ヤミゴーストの判断も、住人と同じウェーブに 1 件だけ乗せます。聞き直すのは、次のようなきっかけがあったときです。
- 島に着いた、狙っていた住人をフリーズさせた、逃げられた(12 秒追っても届かない)
- 戦士に撃たれた、超能力が当たって HP が減った、ヒーラーが仲間を目覚めさせた
- 何もなくても 25 秒たった
プロンプトには、自分の HP、あと何体で満腹か、近い住人 10 体(距離・HP・戦士かヒーラーか)、撃ってきた戦士、これまでの襲来の結果を入れています。
返答はスキーマで hunt(狙う)か leave(去る)に限っています。
RAIDER = _obj({
    "action": {"type": "string", "enum": ["hunt", "leave"]},
    "target": {"type": "string"},   # hunt なら狙う住人の名前
    "say": {"type": "string"},      # 住人に聞こえるひとこと(片言で)
    "thought": {"type": "string"},  # 心の中の考え
})
性格づけは、システムプロンプトで「話し方は片言で、カタカナまじりの不気味な言葉。住人と仲良くすることはない」としただけです。
戦士の強さは、LLM を使わずにゲーム本体のシミュレーションのコードだけで「戦士 N 体 対 ヤミゴースト」の決闘を 200 回ずつ回し、戦士 3 体でほぼ五分(勝つ率 46〜58%)になるように決めました。
ただしこれは、住人の HP・心のしくみを入れる前のルールで測った値で、今のルールでは測り直していません。
ある襲来の記録
10 月 13 日に実際の LLM で動かした世界の、1 回目の襲来です(時刻は現れてからの世界の時刻。ひとことと心の声は LLM の返答そのまま)。
ヤミゴーストは HP 100 で現れ、戦士の超能力が 1 発当たるごとに 10 減ります。
| 時刻 | 出来事 |
|---|---|
| 0 秒 | ヤミゴーストが島の端に現れる |
| 49 秒 | キポクを狙う。 心の声「初狩り。近いのを切り裂いて、島をノイズで埋めろ。」 ひとこと「フリーズ、時間だ...」 |
| 103 秒 | 反撃の黒い弾を受けて、戦士ラポニがフリーズ |
| 114 秒 | HP 60。103 秒より前にラポニに撃たれたときの問い合わせの返答が届き、53m 先のヨルルに狙いを変える。 心の声「戦士は厄介だが、無防備なヨルルを先に仕留める。」 ひとこと「お前も…フリーズだ」 |
| 143 秒 | HP 20。今度はアピュネを狙う。 心の声「戦士は後回し。目の前の奴、今すぐフリーズさせろ。」 ひとこと「クッ…止まれぇ」 |
| 162 秒 | HP 10。6m まで迫っていた戦士ヌポラに狙いを変える。 心の声「戦士は守り固い。でも、近くにいる。先に倒さないと爪が届かない。」 ひとこと「電撃、やめて。爪で裂くぞ。」 |
| 168 秒 | 戦士 3 体(ロネラ 16 発中 5 発、ヌポラ 9 発中 3 発、ラポニ 11 発中 2 発が命中)に倒される |
| 187 秒 | ヒーラーのタミュネが杖で、フリーズしていたラポニを目覚めさせる |
「戦士は守りが固い」「急ぐ住人には追いつけない」という弱点をプロンプトで伝えてあるので、撃たれると無防備な住人に狙いを変え、追い詰められると目の前の戦士に向かう、という判断をしています。
ただし 114 秒のように、判断はウェーブの待ち時間のぶん、状況から遅れて届きます。
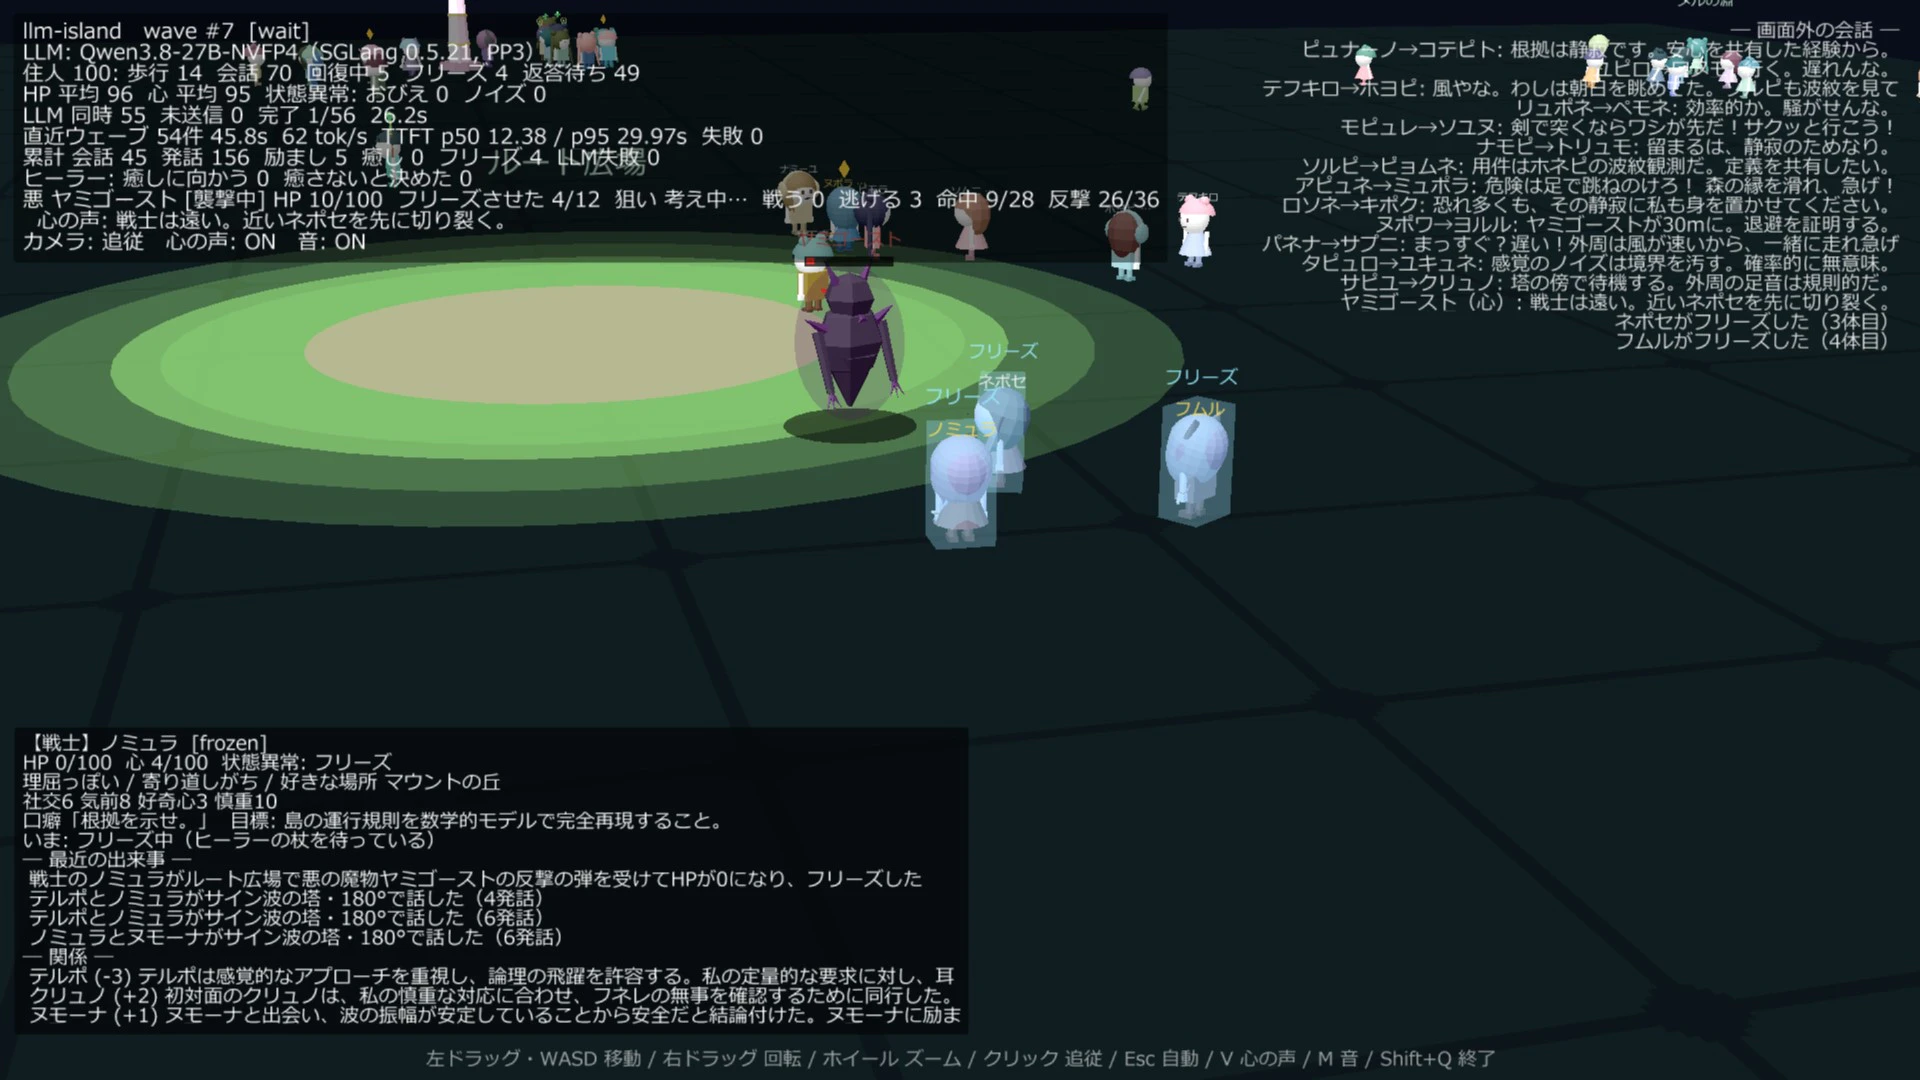
別の襲来。HP 10 まで追い詰められたヤミゴーストのまわりで、ノミュラ・ネポセ・フムルがフリーズしている。
このときの心の声は「戦士は遠い。近いネポセを先に切り裂く。」
襲来のあいだ、住人たちは会話の中で声をかけ合っていました(1・2 回目の襲来から)。
「ヤミゴーストか。拙者は退く。」
「結論から言うと、戦士が対応中。移動は無駄。」(理屈っぽい住人)
「待てない!ヤミゴースト、ウポネ狙ってるぞ!」
「待ってないでさっさと!ヤミゴーストが近いぞ、急げ!」
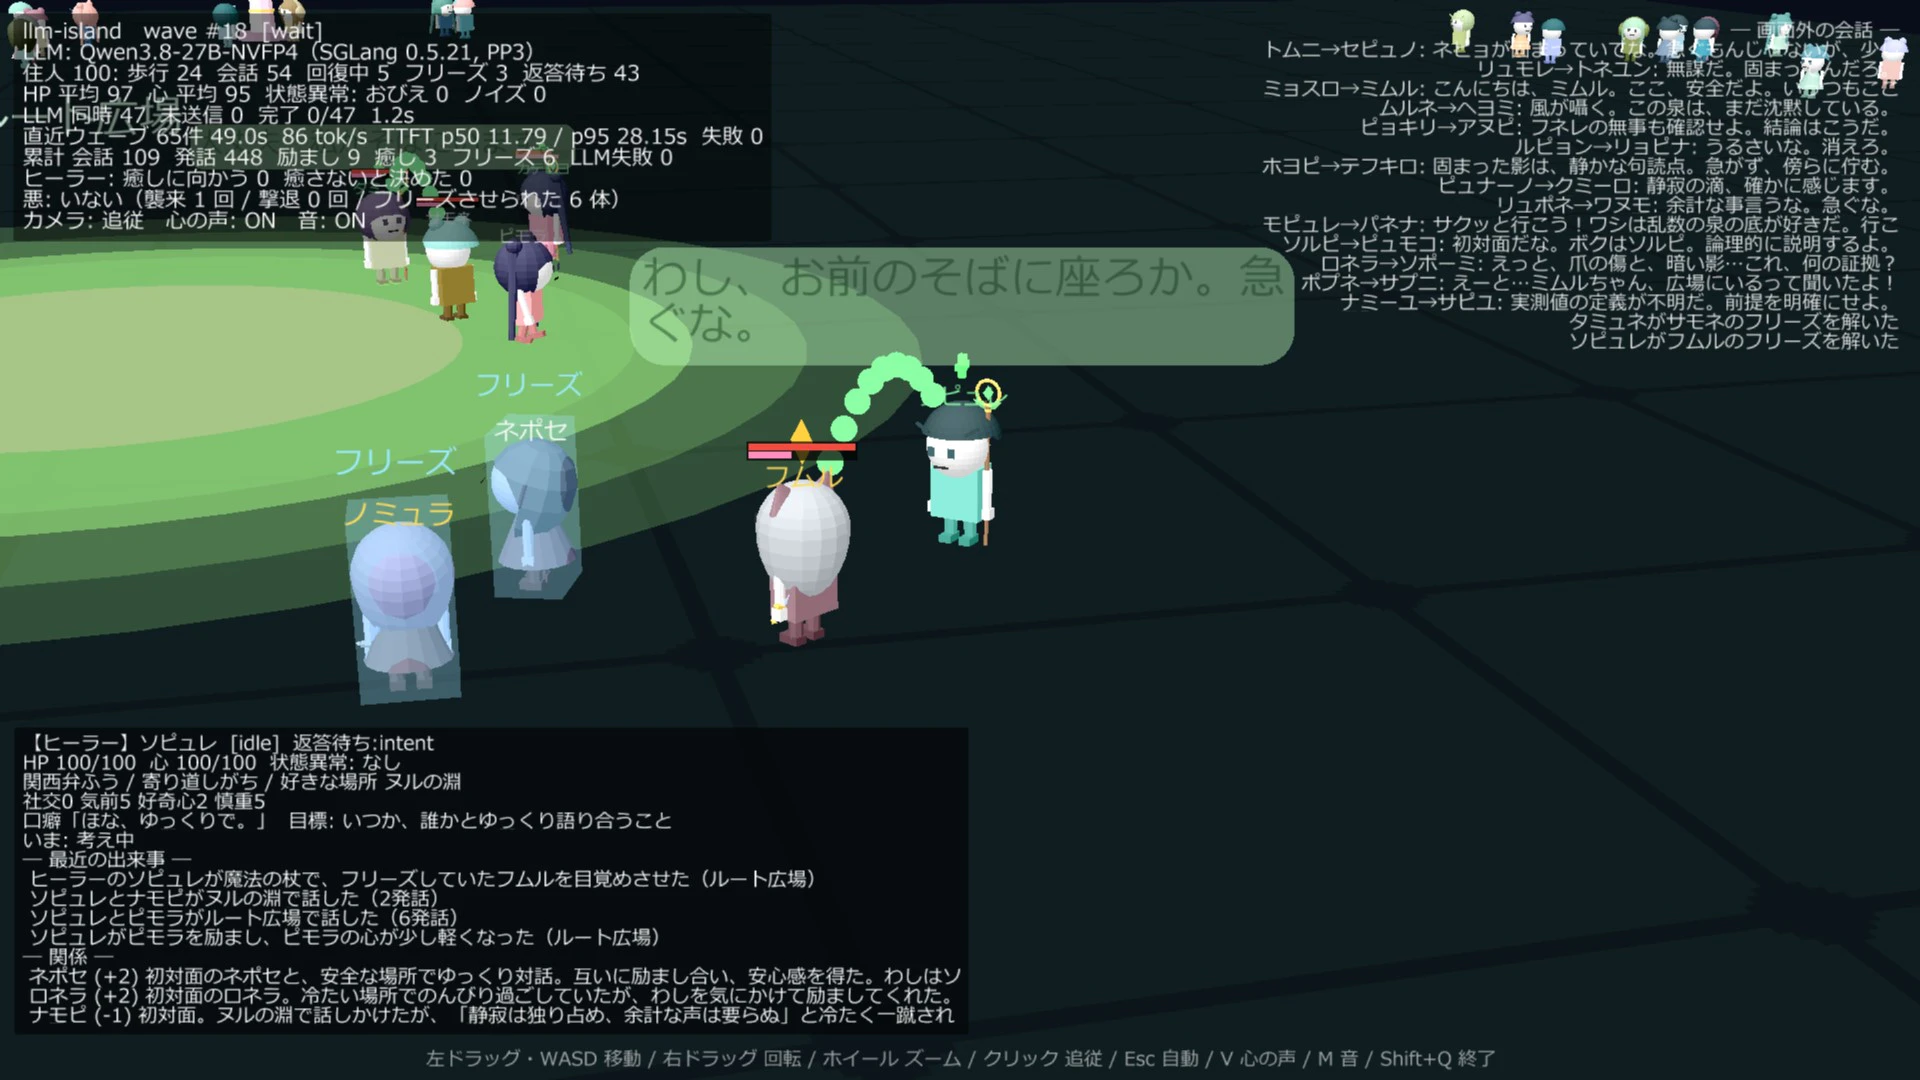
ヒーラーのソピュレ(右、杖を持っている)が、フリーズしていたフムルを目覚めさせたところ。奥のノミュラとネポセはまだフリーズしたまま
助けられた話は、そのあとの会話にも出てきます。
ラポニ「タミュネの杖で目覚めたのだ。朽ちゆくもよし、心は穏やか。」
(タミュネに)「杖の光、美しいわね。」 → タミュネの振り返り「杖の光を褒めてくれた。…励まし合いで心が温まりました。」
ヤミゴーストは「これまでの襲来」を覚えているので、負けが続くと心の声が変わります。
3 回目「前回負けたな。まず近い奴を切り裂く。」
4 回目「また倒されるか。速く爪を突き刺さなければ。」
ただ、この世界では 4 回の襲来がすべて戦士に倒されました(フリーズさせたのは 1 回あたり 0〜2 体)。
決闘のシミュレーションでは五分だったのに、実際は戦士の方が強く出ています。
4 回とも戦士 3 体が駆けつけて撃っていましたが、なぜ五分にならないのかはまだ確かめていません(決闘を今のルールで測り直していないのも、原因の候補です)。強さの調整は続けています。
まとめ
- LLM で考えて動く NPC の鑑賞ゲームは、ローカルの推論サーバー 1 台でも作れました。この環境では 100 体くらいまでが目安です
- コツは、NPC ごとに非同期で呼ぶのではなく、全員分を「ウェーブ」でまとめて投げること。推論サーバーのバッチ処理を使い切れるうえ、ゲーム側をシングルスレッドのまま書けます
- 「まとめれば 1 件と同じ速さ」ではありません。同時処理の上限を超えると、ウェーブの時間は NPC の数に比例して伸びます。NPC の数・プロンプトの長さ・テンポのどれかを選ぶことになります
- 性格・記憶・噂をプロンプトに入れるだけで、口調や好き嫌いは思った以上にそれらしくなりました。一方で、入れた噂を住人が自分から話題にすることは少なく、噂は遠くまで広まりません。話したくなる動機をどう持たせるかが、おもしろいところかもしれません
- 戦いのように速さが要る場面は、LLM には「誰を狙うか・戦うか・癒すか」だけを決めさせ、動きはプログラムに任せると、20〜30 秒おきの判断でも成り立ちました
リポジトリと動画
llm-island(GitHub)
動いているところの動画(YouTube)