
はじめに
「ログ収集エージェントが落ちただけなのに、なぜか本番のアプリまで止まった」
ECS Managed Daemons はまさにこれをやります。デーモンタスクが落ちると、ECS は そのコンテナインスタンスを丸ごと drain して入れ替え ます。デーモンのカバレッジを保証するための仕様なのですが、「メトリクス収集が死んだくらいで本番タスクを動かさないでほしい」というケースも当然あります。
2026年9月3日のアップデートで、ここに 非クリティカル(non-critical) という選択肢が入りました。本記事では Terraform で実際に構築して挙動を確かめます。結論から言うと Terraform AWS Provider にはまだ critical 引数が実装されていない ので、その回避策込みでまとめます。
この記事のポイント
- ECS Managed Daemons に
criticalパラメータが追加された。デフォルトはtrue(従来どおりの挙動) -
critical = falseにすると、デーモンが落ちてもインスタンスはACTIVEのまま。アプリタスクは走り続け、新規タスクも配置され続ける。インスタンス登録もブロックしない - 非クリティカルでも EventBridge イベントとアクションログは出るので、気づけなくなるわけではない
- Terraform AWS Provider v6.65.0 時点で
aws_ecs_daemonにcritical引数は無い。aws_cloudformation_stackでAWS::ECS::Daemonを包むのが現実的な回避策
そもそも Managed Daemons とは
Managed Daemons は、ECS Managed Instances(ECS 側が EC2 のライフサイクルを管理してくれるキャパシティプロバイダー)の上で、1インスタンスにつきちょうど1つデーモンタスクを常駐させる仕組みです。通常のタスク定義とは別に「デーモンタスク定義」という専用リソースを登録して使います。
ポイントは 順序が保証されている ことです。ECS はインスタンスをプロビジョニングしたあと、デーモンタスクを起動してからアプリタスクを RUNNING に遷移させます。なお critical はこの順序には影響しません。変わるのは 起動できなかったとき・途中で落ちたとき の振る舞いだけです。
参考: Amazon ECS Managed Daemons
今回のアップデート: critical / non-critical
critical は真偽値で、CreateDaemon / UpdateDaemon で指定します。
critical = true(デフォルト) |
critical = false |
|
|---|---|---|
| デーモンが起動失敗したとき | インスタンスが 登録されない | インスタンスは 登録される |
| デーモンが途中で停止・異常になったとき | ECS がインスタンスを drain して置き換える | インスタンスは ACTIVE のまま
|
| 既存のアプリタスク | 巻き添えで停止・再配置される | 走り続ける |
| 新規アプリタスクの配置 | 止まる | 続く |
| 起動失敗時の EventBridge イベント | 出る | 出る |
| デプロイのサーキットブレーカー | カウントされる | カウントされる |
何がうれしいのか
- 決済・注文処理など、絶対に落としたくないサービス。メトリクス収集が数分欠けても事業影響はないが、タスクが churn するほうが致命的
- 導入・検証中のエージェント。新しいセキュリティエージェントをまず non-critical で入れ、安定したら critical に昇格させる段階的導入
逆に、コンプライアンス上そのエージェントが動いていないインスタンスでワークロードを動かしてはいけないケース(監査ログ、EDR など)は critical = true のままにすべきです。機械的に全部 false にするのはおすすめしません。
やってみた
「わざと起動に失敗するデーモン」を作り、critical を切り替えたときにアプリタスクとインスタンスがどうなるかを観察します。Terraform で作るのは次の一式です。
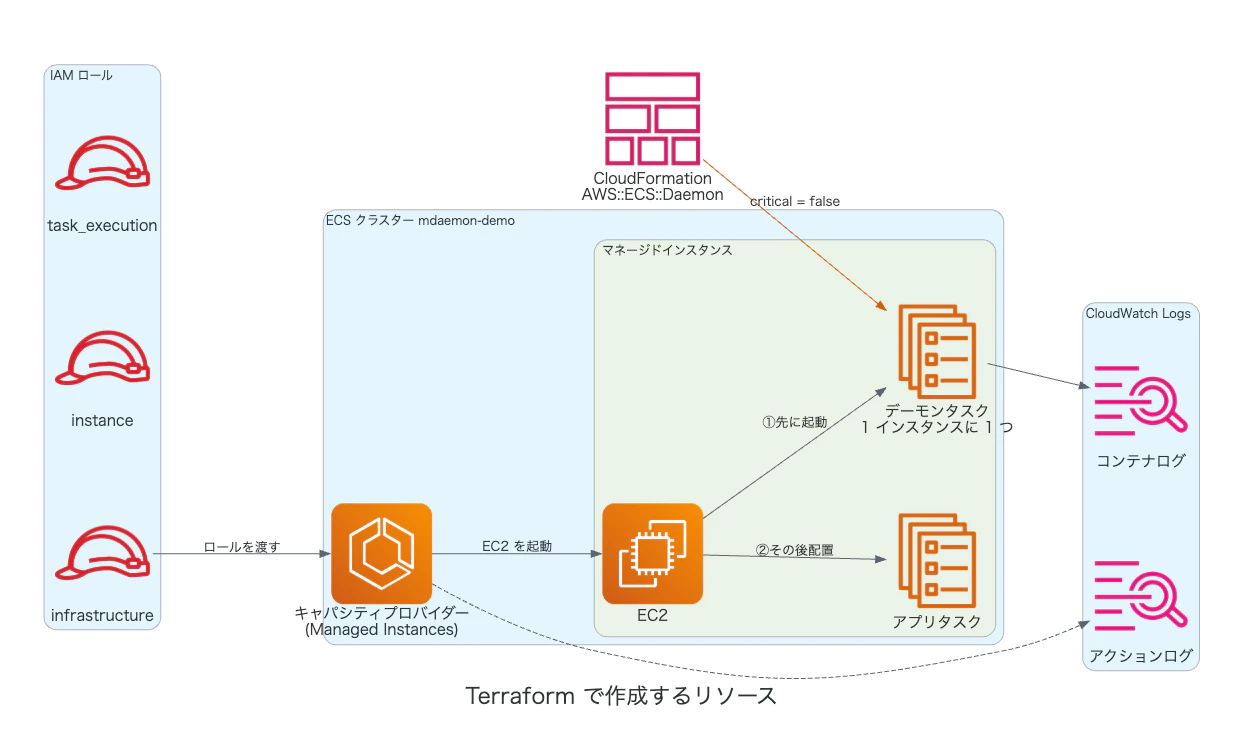
デーモンだけ CloudFormation を挟んでいるのが今回のポイントで、理由は手順3 で説明します。
前提条件
- Terraform v1.5 以上(検証は v1.5.6)、AWS Provider v6.65.0、time Provider v0.14.2
- AWS CLI v2.36.45 以上、リージョンは
ap-northeast-1 -
EC2 インスタンスが起動するので課金が発生します。 検証後は必ず
terraform destroyしてください
出たばかりの機能はドキュメントと実装がズレることがあるので、まず CLI でパラメータの存在を確認しておきます。
aws ecs create-daemon help | col -b | grep -A 6 -- '--critical | --no-critical (boolean)'
       --critical | --no-critical (boolean)
	  If the critical parameter of a daemon is true , and the daemon task
	  fails, stops, or becomes unhealthy, Amazon ECS drains the container
	  instance and stops the other tasks running on it. If the critical
	  parameter is false , the daemon task failure doesn't affect the
	  other tasks on the instance. The default value is true .
手順1: 土台一式
Managed Instances には3つのロールが要ります。
- インフラストラクチャロール(ECS が EC2 を起動・終了する)
- インスタンスロール(EC2 自身が ECS と通信する)
- タスク実行ロール(イメージ pull とログ出力)
土台の Terraform(クリックで展開)
# main.tf
terraform {
  required_version = ">= 1.5.0"
  required_providers {
    aws  = { source = "hashicorp/aws", version = "~> 6.65" }
    time = { source = "hashicorp/time", version = "~> 0.13" }
  }
}

provider "aws" { region = var.region }

variable "region" { default = "ap-northeast-1" }
variable "name" { default = "mdaemon-demo" }
variable "daemon_critical" {
  type    = bool
  default = false
}

# 既存のデフォルト VPC を利用(新規作成はしない)
data "aws_vpc" "default" { default = true }

data "aws_subnets" "default" {
  filter {
    name   = "vpc-id"
    values = [data.aws_vpc.default.id]
  }
  filter {
    name   = "default-for-az"
    values = ["true"]
  }
}

# マネージドインスタンス用(アウトバウンドのみ)
resource "aws_security_group" "mi" {
  name   = "${var.name}-sg"
  vpc_id = data.aws_vpc.default.id

  egress {
    from_port   = 0
    to_port     = 0
    protocol    = "-1"
    cidr_blocks = ["0.0.0.0/0"]
  }
}

# デーモンとアプリのコンテナログ
resource "aws_cloudwatch_log_group" "this" {
  name              = "/ecs/${var.name}"
  retention_in_days = 1
}

# Managed Instances に必要な 3 つのロール
locals {
  roles = {
    infrastructure = {
      service = "ecs.amazonaws.com"
      policy  = "arn:aws:iam::aws:policy/AmazonECSInfrastructureRolePolicyForManagedInstances"
    }
    instance = {
      service = "ec2.amazonaws.com"
      policy  = "arn:aws:iam::aws:policy/AmazonECSInstanceRolePolicyForManagedInstances"
    }
    task_execution = {
      service = "ecs-tasks.amazonaws.com"
      policy  = "arn:aws:iam::aws:policy/service-role/AmazonECSTaskExecutionRolePolicy"
    }
  }
}

resource "aws_iam_role" "this" {
  for_each = local.roles
  name     = "${var.name}-${each.key}-role"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Effect    = "Allow"
      Principal = { Service = each.value.service }
      Action    = "sts:AssumeRole"
    }]
  })
}

resource "aws_iam_role_policy_attachment" "this" {
  for_each   = local.roles
  role       = aws_iam_role.this[each.key].name
  policy_arn = each.value.policy
}

resource "aws_iam_instance_profile" "instance" {
  name = "${var.name}-instance-profile"
  role = aws_iam_role.this["instance"].name
}

# マネージドポリシーの PassRole は role/ecsInstanceRole* 限定なので自前で許可
resource "aws_iam_role_policy" "pass_instance_role" {
  name = "PassInstanceRole"
  role = aws_iam_role.this["infrastructure"].id

  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Effect    = "Allow"
      Action    = "iam:PassRole"
      Resource  = aws_iam_role.this["instance"].arn
      Condition = { StringLike = { "iam:PassedToService" = "ec2.*" } }
    }]
  })
}
手順2: クラスターとキャパシティプロバイダー
クラスターとキャパシティプロバイダーの Terraform(クリックで展開)
# cluster.tf
resource "aws_ecs_cluster" "this" {
  name = var.name
}

# EC2 のライフサイクルを ECS に任せる Managed Instances
resource "aws_ecs_capacity_provider" "mi" {
  name    = "${var.name}-mi"
  cluster = aws_ecs_cluster.this.name # managed_instances_provider では必須

  managed_instances_provider {
    infrastructure_role_arn = aws_iam_role.this["infrastructure"].arn

    instance_launch_template {
      ec2_instance_profile_arn = aws_iam_instance_profile.instance.arn

      network_configuration {
        subnets         = data.aws_subnets.default.ids
        security_groups = [aws_security_group.mi.id]
      }

      instance_requirements {
        vcpu_count {
          min = 2
          max = 4
        }
        memory_mib {
          min = 4096
          max = 8192
        }
      }

      storage_configuration { storage_size_gib = 30 }
    }
  }

  depends_on = [aws_iam_role_policy_attachment.this]
}

# ACTIVE になる前に紐づけると InvalidParameterException になるため待つ
resource "time_sleep" "capacity_provider_active" {
  depends_on      = [aws_ecs_capacity_provider.mi]
  create_duration = "120s"
}

resource "aws_ecs_cluster_capacity_providers" "this" {
  depends_on = [time_sleep.capacity_provider_active]

  cluster_name       = aws_ecs_cluster.this.name
  capacity_providers = [aws_ecs_capacity_provider.mi.name]

  default_capacity_provider_strategy {
    capacity_provider = aws_ecs_capacity_provider.mi.name
    weight            = 1
  }
}
手順3: 壊れたデーモンと、critical をどう渡すか
デーモンタスク定義は Provider が対応しているので素直に書けます。
デーモンタスク定義の Terraform(クリックで展開)
# daemon.tf
# わざと起動直後に落ちる「壊れた観測エージェント」
resource "aws_ecs_daemon_task_definition" "broken_agent" {
  family             = "${var.name}-broken-agent"
  cpu                = "256"
  memory             = "512"
  execution_role_arn = aws_iam_role.this["task_execution"].arn

  container_definition {
    name      = "agent"
    image     = "public.ecr.aws/docker/library/busybox:1.37"
    essential = true
    command   = ["sh", "-c", "echo 'agent booting...'; exit 1"]

    log_configuration {
      log_driver = "awslogs"
      options = {
        "awslogs-group"         = aws_cloudwatch_log_group.this.name
        "awslogs-region"        = var.region
        "awslogs-stream-prefix" = "daemon"
      }
    }
  }
}
問題はデーモン本体です。aws_ecs_daemon は critical に対応していない(awscc_ecs_daemon も同様)ので、Critical を持っている CloudFormation の AWS::ECS::Daemon を aws_cloudformation_stack で包んで書きます。
# Critical はここで渡す
Properties = {
  DaemonName              = "${var.name}-broken-agent"
  ClusterArn              = aws_ecs_cluster.this.arn
  DaemonTaskDefinitionArn = aws_ecs_daemon_task_definition.broken_agent.arn
  CapacityProviderArns    = [aws_ecs_capacity_provider.mi.arn]
  Critical                = var.daemon_critical
}
リソース全体(クリックで展開)
# daemon.tf(続き)
# aws_ecs_daemon は critical 未対応のため CloudFormation で作る
resource "aws_cloudformation_stack" "daemon" {
  name = "${var.name}-daemon"

  template_body = jsonencode({
    AWSTemplateFormatVersion = "2010-09-09"
    Resources = {
      Daemon = {
        Type = "AWS::ECS::Daemon"
        Properties = {
          DaemonName              = "${var.name}-broken-agent"
          ClusterArn              = aws_ecs_cluster.this.arn
          DaemonTaskDefinitionArn = aws_ecs_daemon_task_definition.broken_agent.arn
          CapacityProviderArns    = [aws_ecs_capacity_provider.mi.arn]
          Critical                = var.daemon_critical
        }
      }
    }
    Outputs = {
      DaemonArn = { Value = { "Fn::GetAtt" = ["Daemon", "DaemonArn"] } }
    }
  })

  depends_on = [aws_ecs_cluster_capacity_providers.this]
}

output "daemon_arn" {
  value = aws_cloudformation_stack.daemon.outputs["DaemonArn"]
}
手順4: 巻き添えを食う側のアプリサービス
30秒おきに生存ログを出すだけのタスクを1本置きます。これが「デーモンが落ちたときに止まるかどうか」の観測対象です。
アプリ側の Terraform(クリックで展開)
# app.tf
# 30 秒おきに生存ログを出すだけのアプリ
resource "aws_ecs_task_definition" "app" {
  family                   = "${var.name}-app"
  requires_compatibilities = ["EC2"]
  network_mode             = "awsvpc"
  cpu                      = "256"
  memory                   = "512"
  execution_role_arn       = aws_iam_role.this["task_execution"].arn

  container_definitions = jsonencode([{
    name      = "app"
    image     = "public.ecr.aws/docker/library/busybox:1.37"
    essential = true
    command   = ["sh", "-c", "while true; do echo \"app alive $(date -u)\"; sleep 30; done"]
    logConfiguration = {
      logDriver = "awslogs"
      options = {
        "awslogs-group"         = aws_cloudwatch_log_group.this.name
        "awslogs-region"        = var.region
        "awslogs-stream-prefix" = "app"
      }
    }
  }])
}

resource "aws_ecs_service" "app" {
  name            = "${var.name}-app"
  cluster         = aws_ecs_cluster.this.id
  task_definition = aws_ecs_task_definition.app.arn
  desired_count   = 1

  capacity_provider_strategy {
    capacity_provider = aws_ecs_capacity_provider.mi.name
    weight            = 1
  }

  network_configuration {
    subnets         = data.aws_subnets.default.ids
    security_groups = [aws_security_group.mi.id]
  }

  depends_on = [aws_ecs_cluster_capacity_providers.this]
}
手順5: アクションログを有効化する
What's New に「service action logs を記録する」とありますが、アクションログはクラスター単位でオプトインが必要です。CloudWatch Logs の vended log delivery で有効化します。
アクションログ有効化の Terraform(クリックで展開)
# observability.tf
# アクションログの配信先
resource "aws_cloudwatch_log_group" "action_logs" {
  name              = "/aws/vendedlogs/ecs/action-logs/${var.name}"
  retention_in_days = 1
}

resource "aws_cloudwatch_log_delivery_source" "action_logs" {
  name = "${var.name}-action-logs"
  # docs は EcsActionLogs だが API は ACTION_LOGS しか受け付けない
  # ValidationException: Provided LogType is not valid. Supported options are [ACTION_LOGS].
  log_type     = "ACTION_LOGS"
  resource_arn = aws_ecs_cluster.this.arn
}

resource "aws_cloudwatch_log_delivery_destination" "action_logs" {
  name          = "${var.name}-action-logs-dest"
  output_format = "json"

  delivery_destination_configuration {
    destination_resource_arn = aws_cloudwatch_log_group.action_logs.arn
  }
}

resource "aws_cloudwatch_log_delivery" "action_logs" {
  delivery_source_name     = aws_cloudwatch_log_delivery_source.action_logs.name
  delivery_destination_arn = aws_cloudwatch_log_delivery_destination.action_logs.arn
}
手順6: apply
terraform init
terraform apply   # デフォルトは daemon_critical = false
結果確認: critical = false のとき
critical の値はデーモンリビジョンで確認する
デーモンリビジョンに紐づく属性なので describe-daemon-revisions を叩きます。
DAEMON_ARN=$(terraform output -raw daemon_arn)
REV_ARN=$(aws ecs describe-daemon --daemon-arn "$DAEMON_ARN" \
  --query 'daemon.currentRevisions[0].arn' --output text)

aws ecs describe-daemon-revisions --daemon-revision-arns "$REV_ARN" \
  --query 'daemonRevisions[0].critical'
# false
インスタンスとアプリの状態
デーモンは起動に失敗し続けています。
aws ecs describe-daemon --daemon-arn "$DAEMON_ARN" \
  --query 'daemon.currentRevisions[0].{running:totalRunningCount,withoutDaemon:totalWithoutDaemonCount}'
# { "running": 0, "withoutDaemon": 1 }
withoutDaemon: 1 は「デーモンが乗っていないインスタンスが1台ある」という意味です。その1台とアプリサービスを見ます。
CI=$(aws ecs list-container-instances --cluster mdaemon-demo --query 'containerInstanceArns[]' --output text)

aws ecs describe-container-instances --cluster mdaemon-demo --container-instances $CI \
  --query 'containerInstances[].{ec2:ec2InstanceId,status:status,running:runningTasksCount}' --output table

aws ecs describe-services --cluster mdaemon-demo --services mdaemon-demo-app \
  --query 'services[0].{desired:desiredCount,running:runningCount,pending:pendingCount}'
ec2 = i-09c9f9921f4546f35 / status = ACTIVE / running = 1
service: { "desired": 1, "running": 1, "pending": 0 }
デーモンが死んでいるのにインスタンスは ACTIVE、アプリタスクは走り続けています。 停止済みタスクを見ると、落ちているのはデーモンだけだと分かります。
aws ecs list-tasks --cluster mdaemon-demo --desired-status STOPPED --query 'taskArns[]' --output text \
  | xargs aws ecs describe-tasks --cluster mdaemon-demo --tasks \
  --query 'tasks[].{td:taskDefinitionArn,reason:stoppedReason,exit:containers[0].exitCode}' --output table
# mdaemon-demo-broken-agent:2 | Essential container in task exited | 1
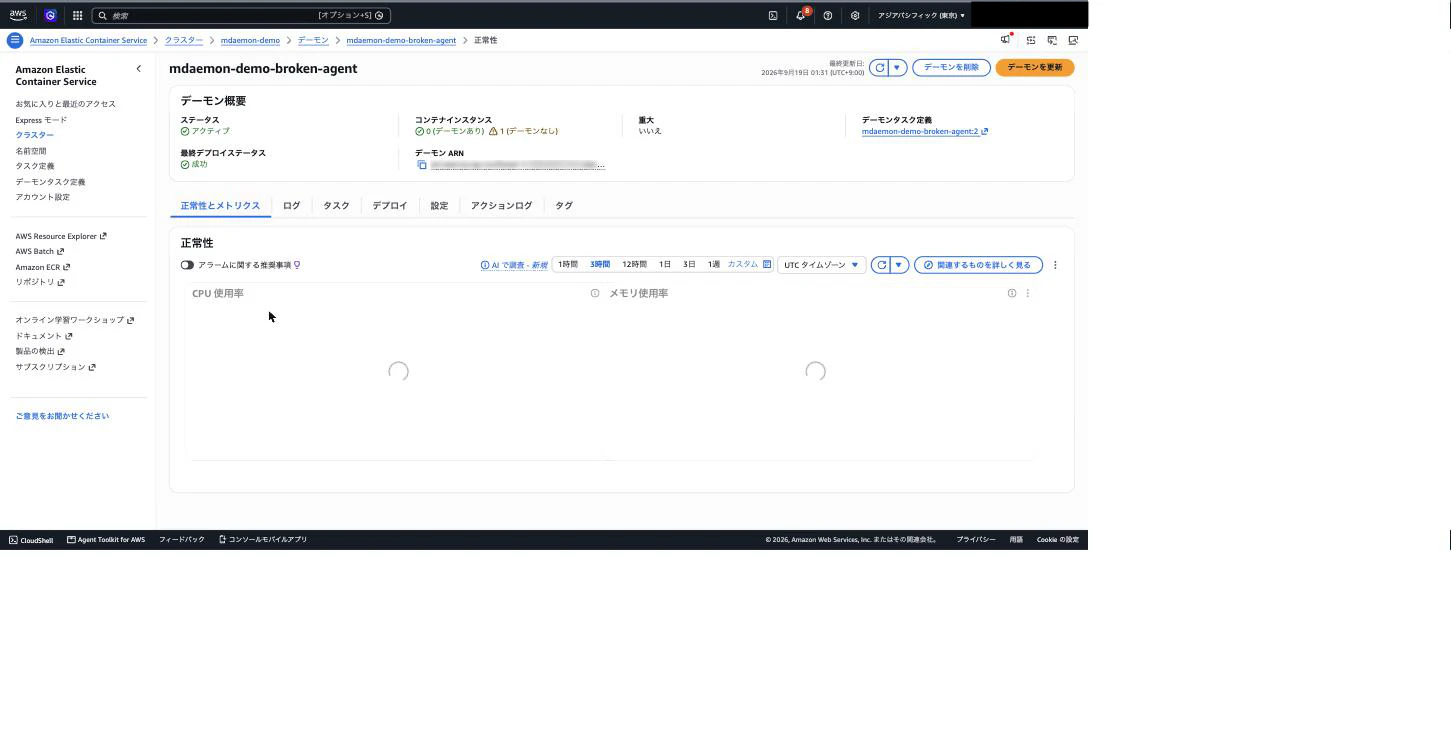
コンソールでも一目で分かります。「コンテナインスタンス: 0(デーモンあり)/ 1(デーモンなし)」という警告付きの表示なのに、「重大: いいえ」「最終デプロイステータス: 成功」です。
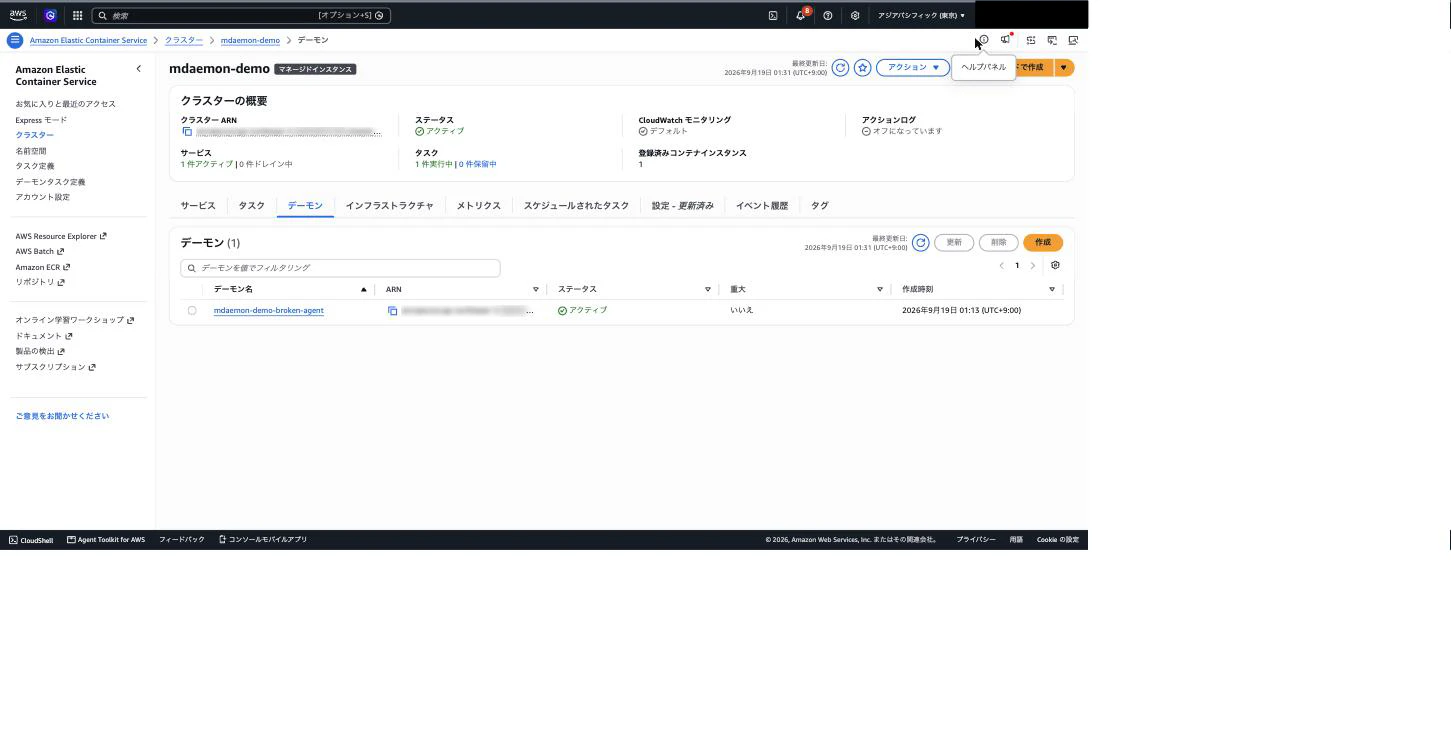
デーモン一覧にも「重大」列が増えていました。
結果確認: critical = true にすると何が起きるか
対照実験として true に切り替えます。Terraform の plan は CloudFormation スタックの差分(~ Critical = false -> true)として出ます。
terraform apply -var daemon_critical=true
45秒おきにインスタンスとサービスの状態を観察した結果がこちらです。
02:08:53 | instances= ['3cf4fb:DRAINING:1t', '7b5f1c:DEREGISTERING:0t'] | svc run=1   pend=0
02:09:39 | instances= ['3095ea:REGISTERING:0t', '3cf4fb:DRAINING:1t']   | svc run=1 pend=1
02:10:26 | instances= ['3095ea:DEREGISTERING:0t', '3cf4fb:DRAINING:1t'] | svc run=1 pend=0
02:11:13 | instances= ['62d137:REGISTERING:0t', '3cf4fb:DRAINING:1t']   | svc run=1 pend=1
02:11:59 | instances= ['62d137:DEREGISTERING:0t', '3cf4fb:DRAINING:1t'] | svc run=1 pend=0
02:12:46 | instances= ['624539:REGISTERING:0t', '3cf4fb:DRAINING:1t']   | svc run=1 pend=1
インスタンス ID が毎回変わっているのが分かるでしょうか。どのインスタンスも一度も ACTIVE にならず、観察していた約20分のあいだこの輪を回り続けました。
サービスの pending も 0 と 1 を行き来し、新しいアプリタスクを置ける場所がありません。コンソールでも「重大: はい」「最終デプロイステータス: 進行中」のまま止まらなくなります。

このループは手順5 で有効化したアクションログにも残ります。デーモンタスクの起動と drain が交互に記録されていました。
aws logs filter-log-events --log-group-name /aws/vendedlogs/ecs/action-logs/mdaemon-demo \
  --limit 5 --query 'events[].message' --output text | jq -r '.detail.eventName'
# DAEMON_SERVICE_UPDATED
# DAEMON_DEPLOYMENT_IN_PROGRESS
# DAEMON_TASK_STARTED
# DAEMON_DRAIN_COMPLETED

なお eventName の値はドキュメントに一覧が無く、これは観察されたものです。アラートに繋ぐなら EventBridge 側の detail-type: ECS Daemon Service Action / eventName: DAEMON_TASK_START_IMPAIRED を使うと、デーモンタスクの起動失敗だけを拾えます(参考: Daemon events)。
ここから戻るのが一苦労
この状態だと CloudFormation の UpdateDaemon がいつまでも完了しません。cancel-update-stack でロールバックさせようとしたのですが、ロールバック(= Critical を false に戻す更新)も 30 分以上 UPDATE_ROLLBACK_IN_PROGRESS のまま進まなくなりました。 デーモンのアクションログも途中で途切れたきりです。その間に aws_cloudformation_stack のデフォルトタイムアウト(30分)が先に来て、Terraform 側はこう落ちます。
Error: waiting for CloudFormation Stack (...) update: timeout while waiting for state to become
'CREATE_COMPLETE, UPDATE_COMPLETE, ...' (last state: 'UPDATE_ROLLBACK_IN_PROGRESS', timeout: 30m0s)
結局、デーモンを API から直接消して脱出しました。削除するとインスタンスがデーモン無しで作り直され、アプリサービスも復帰します。
aws cloudformation cancel-update-stack --stack-name mdaemon-demo-daemon
# それでも進まない場合はデーモンを直接削除する
aws ecs delete-daemon --daemon-arn "$DAEMON_ARN"
デーモンが消えると CloudFormation は UPDATE_ROLLBACK_FAILED に落ちるので、その後 terraform destroy が通ります。詰まるのは「起動できないデーモンを抱えたまま critical にした」場合なので、正常に動くデーモンなら起きない話ではあります。
料金と後片付け
ECS Managed Instances は EC2 インスタンス料金に加えて管理料金がかかります。critical は API パラメータなのでこれ自体の切り替えで課金は変わりませんが、検証が終わったら必ず片付けてください。
terraform destroy