

本記事は日本オラクルが運営する下記Meetupで発表予定の内容になります。発表までに今後、内容は予告なく変更される可能性があることをあらかじめご了承ください。
はじめに
LLM活用における設計対象は、単一の応答から自律的な業務フローへと拡張してきました。初期には、適切な応答を得るためにプロンプトを工夫することが中心でしたが、ここ最近では実務でLLMを活用するには必要な情報を適切に渡し、ツールを安全に実行させ、成果を検証しながら改善する仕組みまで設計する必要性が重視され、そのための考え方として〇〇エンジニアリングという呼称がつけられるトレンドがあります。
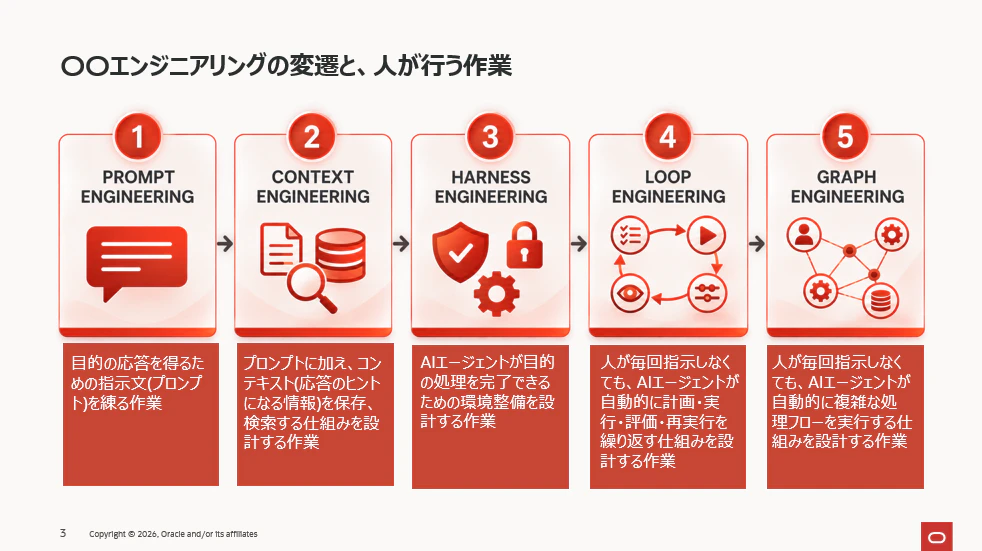
『エンジニアリング』という名前がついているということは、つまり『何らかの設計』をするという作業です。その観点で解説すると各エンジニアリングを以下のように説明することができます。
プロンプトエンジニアリング
LLMが登場して間もない頃は、LLM自体がまだそれほど精度の高いものでもなく、目的の応答を得るために、プロンプト(指示文)をあれやこれやと頑張って弄っていた時期があり、この作業につけられた名前がプロンプトエンジニアリングです。
コンテキストエンジニアリング
プロンプトだけでは、適切な応答が得られない、もしくは、LLMが知っている応答しか得られないため、LLMに与える応答のヒント(コンテキスト)となる文章を保存しておき、検索する仕組みを設計するという作業がコンテキストエンジニアリングです。代表的な例としてはRAGですね。
ハーネスエンジニアリング
LLMアプリの主流がAIエージェントに移行し、その複雑化した処理を確実に実行・完了できるよう、ツール、検証、状態管理、権限、完了判定などの仕組みが更に重要視されるようになりました。その設計作業を行うことをハーネスエンジニアリングと呼んでいます。
ループエンジニアリング
人が毎回指示しなくても、AIエージェントが自動的に計画・実行・評価・再実行を繰り返す仕組みを設計する作業をループエンジニアリングと呼んでいます。
グラフエンジニアリング
人が毎回指示しなくても、AIエージェントが自動的に複雑な処理フローを実行する仕組みを設計する作業をグラフエンジニアリングと呼んでいます。ループエンジニアリングよりも更に複雑なワークフローを設計するイメージです。
という感じで一見綺麗に区分けできているように見ますが、実際の実装はこのようにはいかず、その定義の区分けもかなりオーバーラップしているという状況です。特に最近矢継ぎ早に提唱されているハーネス以降はだいたい似通った考え方となっていますが、本記事ではその中でもループとグラフにフォーカスした内容でお贈りします。
ループエンジニアリングとグラフエンジニアリング
下図は従来とループエンジニアリングの考え方の違いなります。
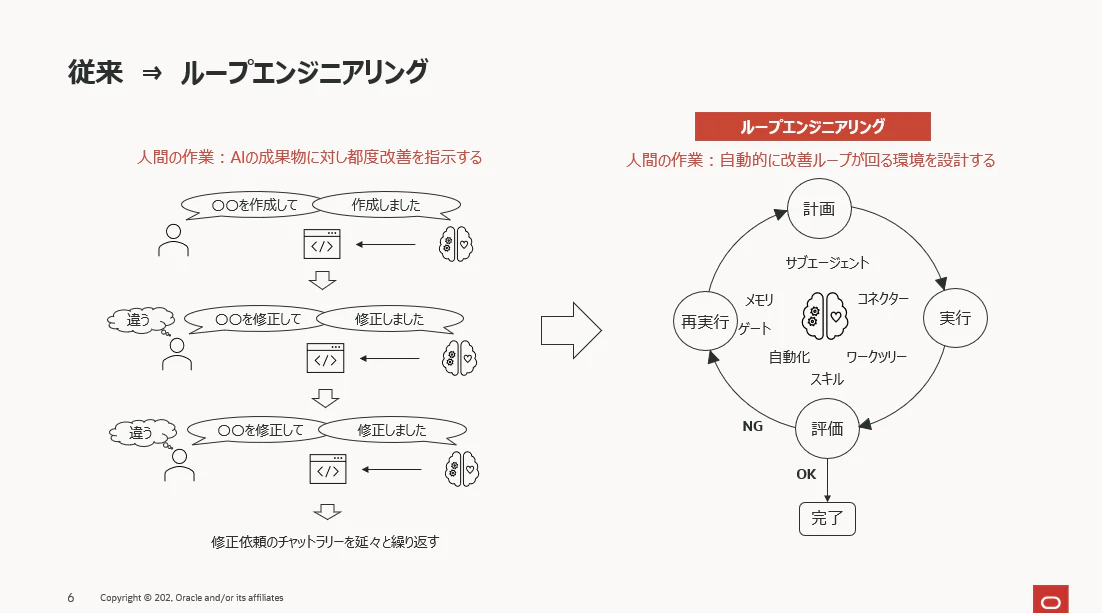
上図左のパターンは、人間がAIに指示をして、AIの成果物に対して改善指示をするということを延々と繰り返すという一般的なAIの使い方です。人間が学びながら何かを調査するというAIの使い方としては普通だと思いますが、例えば、アプリケーション開発をAIで実行する場合などは全く異なる話になります。つまり、AIが生成するアプリケーションコードのエラーを都度人間が延々と修正指示しているとキリがないということです。
このような場合は従来のやり方よりも、ループエンジニアリングのほうが向いています。AIが計画、実行、評価し、OKであれば完了、NGであれば最初からやり直しというループを自動的に回してくれるようにするために、LLM周辺に様々なしくみを配置するという設計を人間が行うというものです。
この場合、ループの中の評価処理が非常に重要になるということは直感的にご理解いただけると思います。この評価処理の合格条件を可能な限り定量的に抜け漏れなく定義する必要があります。そして、更に重要な点は、合格条件に一致するかどうかの評価処理をLLMの確立的処理に任せるのではなく、決定論的にLLMを使わないコードで評価することです。
この合否判定をLLMに任せ、そこで万一ハルシネーションが入ってしまうと上図のループが破綻する可能性があるからです。この考え方はハーネスエンジニアリングの中でゲート(合格の門をくぐるという意味合い)として定義されており、ループエンジニアリングやグラフエンジニアリングにも共通する重要な仕組みです。
そして、下図がループエンジニアリングとグラフエンジニアリングの違いです。
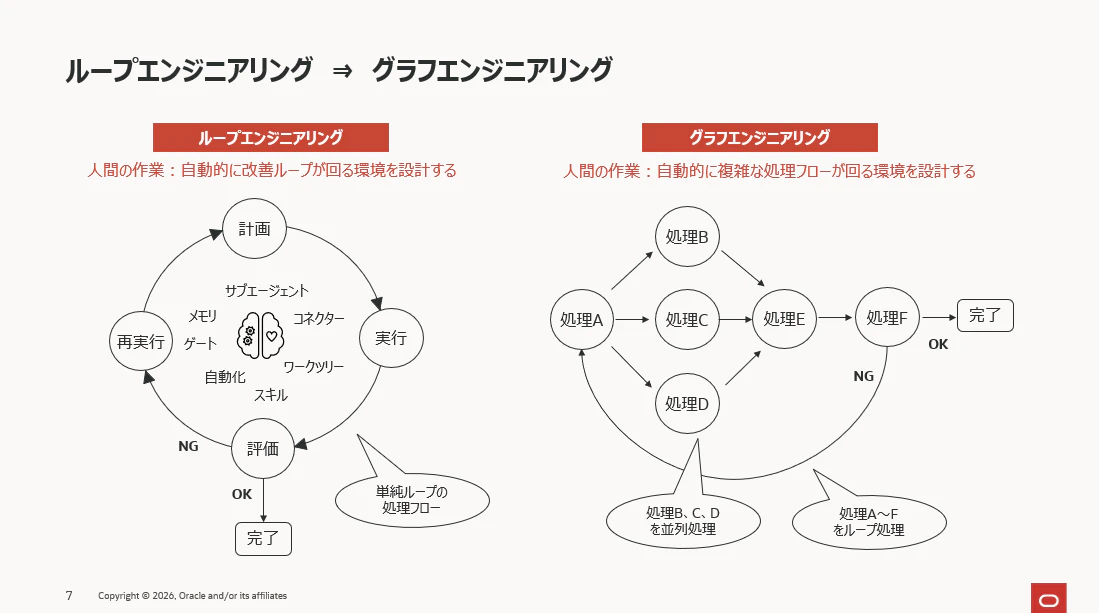
ループエンジニアリングでは、シンプルな一方向の処理フロー(ループ)を回すことが目的です。それに対してグラフエンジニアリングでは、より複雑な処理フロー(例えば並列処理であったり、ループ処理との組み合わせ)なども行えるように処理フローを定義するという実装になります。LLM周辺に様々なしくみを配置するという設計を人間が行うという作業は共通です。
これらは、どちらがより優れているとか、どちらが上位互換だという話ではなく目的や実装方法によって使い分けるというイメージが正しいと思います。
『グラフエンジニアリング』というキーワードの紆余曲折
ループエンジニアリングからグラフエンジニアリングというキーワードがバズるまでの時系列の経緯としては主に下記のような流れでした。
『Loop Engineering』 Addy Osmani氏による執筆(2026/6/7)
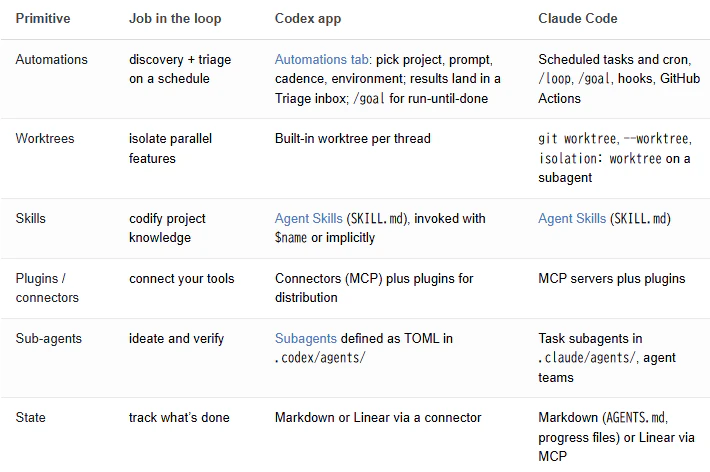
Loop Engineering を明確な用語として記事化。人が毎ターン指示するのでなく、「エージェントを動かすループ」を設計する、と定義。恐らく殆どの方が読んでいるであろう同氏の技術ブログ。この記事で下図のようなコーディングエージェント(Claude CodeやCodex)の様々な機能やGithubの機能の連携によるLoopエンジニアリングの具体的な実装が詳解されています。
『Loop engineering: Getting started with loops』 Anthropic社のClaude Code チームによる執筆( 2026/06/30)
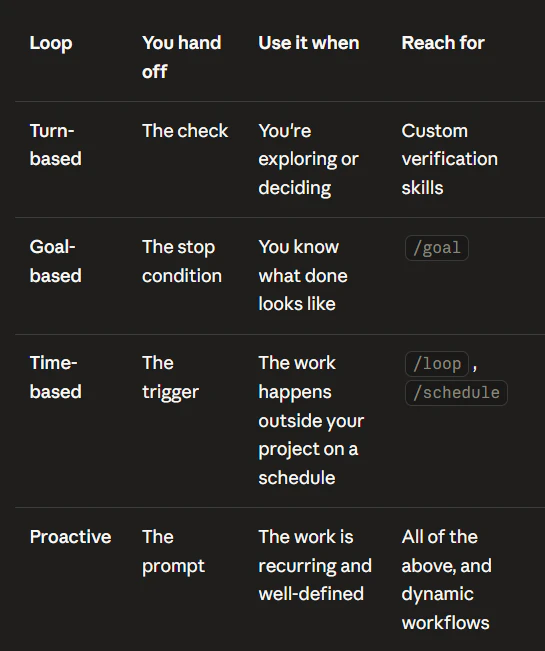
Anthropic社がループエンジニアリングというキーワードを公式に整理。「コーディングエージェントをプロンプトする代わりにループを設計する」という実践として、様々なタイプのループを解説しています。
OpenClaw開発者Peter Steinberger氏の投稿(2026/7/18 )
同氏の「まだループの話をしているのか、それともグラフへ移ったのか」という投稿が起点となり、Graph Engineering が話題化。これは「単一エージェントの反復」から「複数エージェントの接続構造」へ市場の関心が移ることになります。
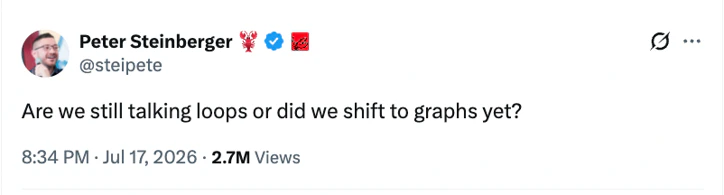
※既存技術に新たな名前を付けて、まるで新しい技術かのように誇大広告をするIT業界への揶揄ともいわれています。
『3 Years of Graph Engineering with LangGraph』LangChain社Sydney Runkle、Harrison Chase両氏による執筆(2026/7/22)
両氏は、「グラフでエージェントを表すこと」は新しくなく、LangGraph は約3年前からそのために存在している、と公式に位置付けています。そしてLangGraphでは既に当たり前になっているグラフベースのマルチエージェントオーケストレーションに新しい名前をつけただけと説明しています。
グラフベースのマルチエージェントオーケストレーション
グラフとは主に 『ノード』と『エッジ』から構成されるデータモデルです。ノードは具体的なもの(例えば、人、場所、製品、イベントなど)や抽象的な概念(例えば、アイデア、カテゴリ、トピックなど)を定義し、エッジはノード間の関係性を表します。例えばノードにSNSのアカウントユーザーを定義した場合、エッジは人とユーザー同士の関係性、ということでフォローしている、されているという情報を定義することになります。
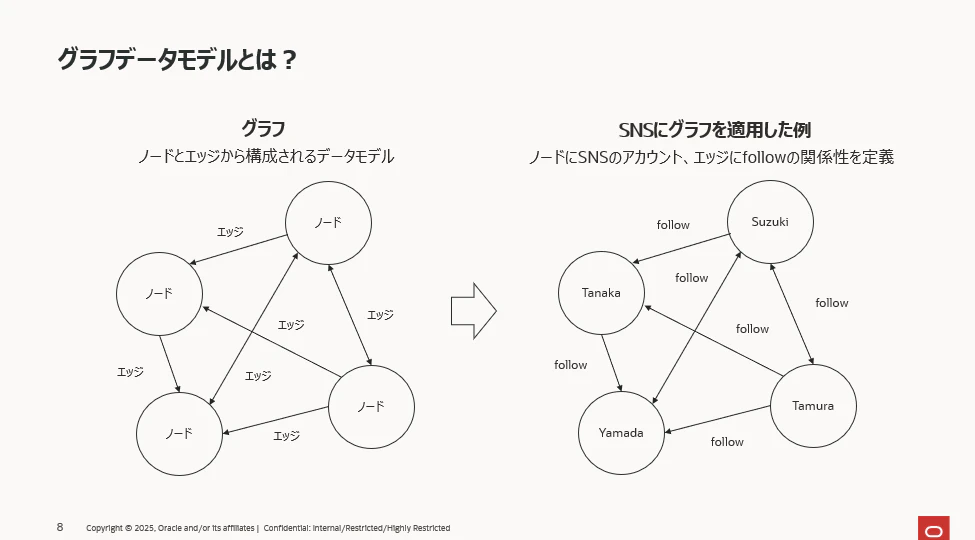
このグラフ技術は、RDBでは表現できない複雑なデータのスキーマ構造を定義しなければいけない技術領域で古くからグラフデータベースとして利用されてきました。 MetaやLinkedInなどのソーシャルメディアプラットフォームでは、ユーザー間の友人関係やフォロワー関係のモデル化に利用されていますし、金融機関などでは金融取引のトランザクションデータをグラフデータモデルで保持し、巡回取引などの不正トランザクションを一発のSQLクエリで即座に検知できる仕組みを実装しています。
そして、このグラフをマルチエージェントに適用する場合はちょうど下図のような実装になります。
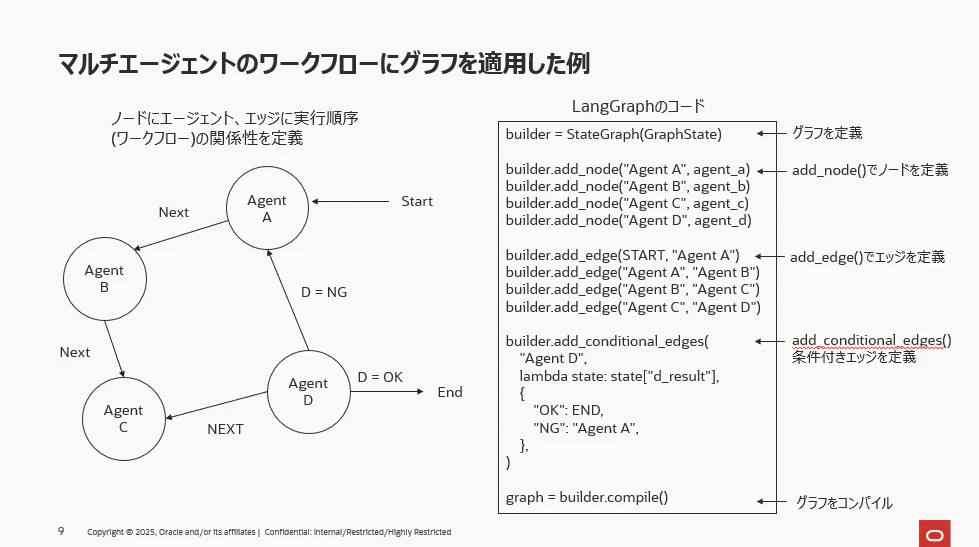
この4つのエージェントのオーケストレーションをLangGraphのコードにすると下記のようになります。
まずbuilderという名前でグラフを定義します。
builder = StateGraph(GraphState)
このグラフにadd_node()で4つのノードを定義します。
builder.add_node("Agent A", agent_a)
builder.add_node("Agent B", agent_b)
builder.add_node("Agent C", agent_c)
builder.add_node("Agent D", agent_d)
そして、add_edges()で各ノード間のエッジを定義します。
builder.add_edge(START, "Agent A")
builder.add_edge("Agent A", "Agent B")
builder.add_edge("Agent B", "Agent C")
builder.add_edge("Agent C", "Agent D")
最後の Agend Dだけはエージェントの処理結果がOKであれば、Endに遷移し、NGであればAgent Aに戻るような条件分岐になるため、通常のエッジ(add_edges)ではなく条件付きエッジ(add_conditional_edges)を定義します。
builder.add_conditional_edges(
    "Agent D",
    lambda state: state["d_result"],
    {
        "OK": END,
        "NG": "Agent A",
    },
)
最後にこのグラフをコンパイルして、グラフのワークフロー完成です。
graph = builder.compile()
このようにして複数エージェントの処理遷移をグラフ形式で定義することは今に始まったことではなく、LangGraphでは3年前からこのようなことをやっているというのが、LangGraphの開発元 LanChain inc.の両氏の主張です。(個人的には筆者もこれに賛同)
※この具体的な実装については過去の下記記事でも取り上げていますのでご興味ある方はご参照ください。
『How to Graph-Max with Codex and GPT-5.6 Sol』 OpenAI社Alex Francfort氏による投稿(2026/7/22)
上述の投稿に続いて、OpenAI社のAlex Francfort氏(ハーネスエンジニア)が、グラフエンジニアリングの具体的な実装ともとれる投稿を行いました。この投稿はCodexとSolを使った2ステップのレシピという内容で、1日で約60万回の閲覧数を記録したそうです。
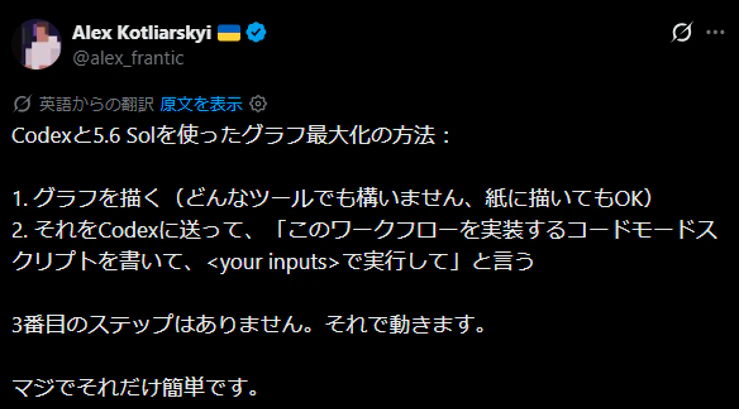
そして、同氏の投稿に添付されていたグラフの図が下記。
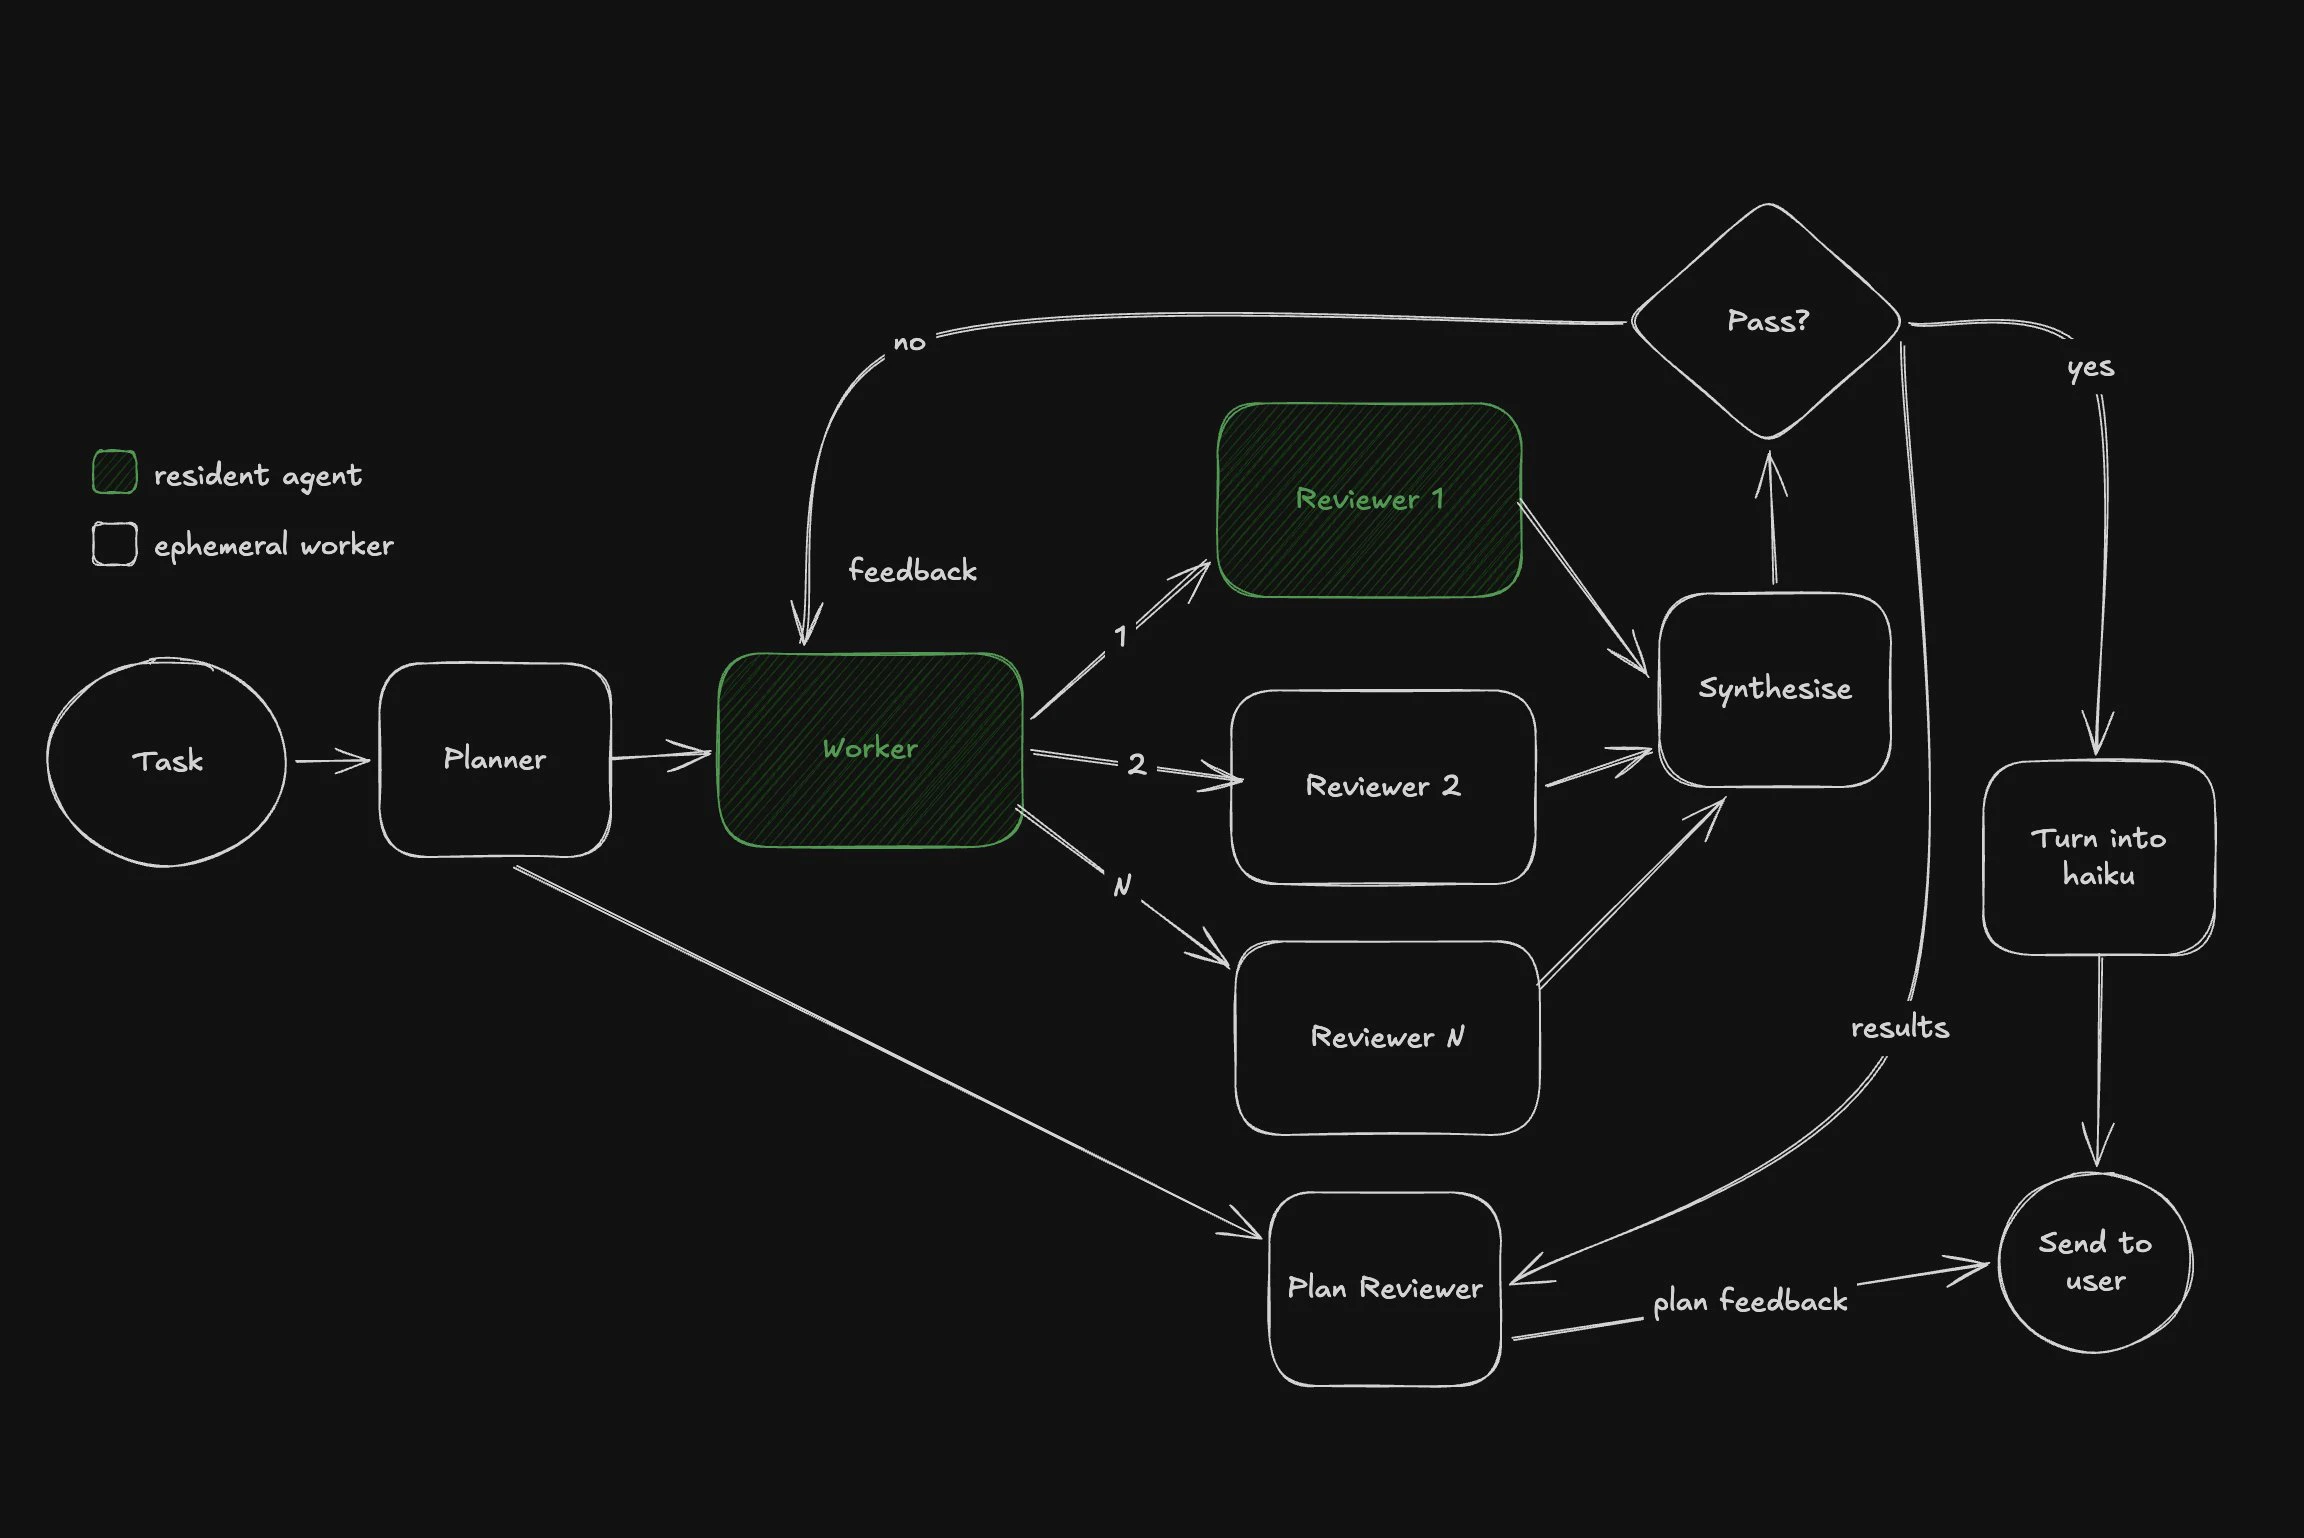
つまり、『この図とプロンプトをCodeに入力するだけ』というなんともシンプルなものです。
※たったこれだけの作業でグラフエンジニアになれる、というミームも含まれた投稿だとも言われています。
Graph-Maxを試してみる
ということで今回はグラフエンジニアリングのクイックスタートとも言える graph-max を試してみます。
グラフの理解
何はともあれ、まずはこのグラフの理解からです。
このグラフはユーザーの依頼内容に基づいて、
- Planner が作業計画を作り、
- Worker が実行し、
- 複数の Reviewer がその品質を確認し、
- そして Synthesise がレビュー結果を統合してその品質の合否を判定し、
- 不合格なら指摘を Worker に戻す
- そして Plan Reviewer は計画そのものも振り返る
というノード処理を遷移します。
また、このグラフ構造の特徴的な点としては、
- Workerから複数のReviewerに遷移する部分が並列処理
- Synthesiseの結果、不合格ならWorkerへ戻る部分が、修正と再レビューを繰り返すループ処理
になっています。
このグラフだとユーザーの依頼内容は例えば下記のように何でも対応できそうです。
- 「添付のコードをレビューして」
- 「〇〇について調査して結果を要約して」
- 「この設計書の不足点・矛盾点をレビューして」
実装シナリオ
今回は、コードレビューを行う処理をグラフエンジニアリングとして実装してみようと思います。
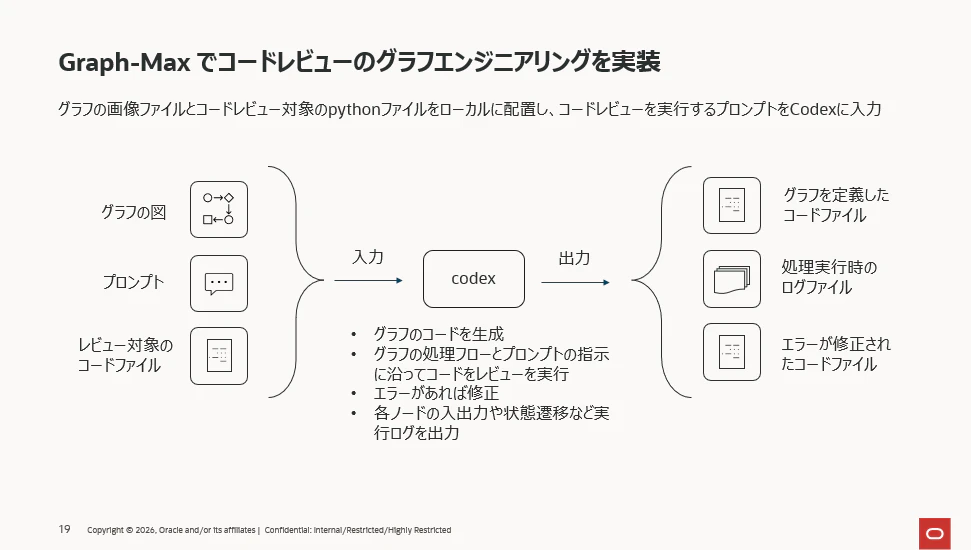
手順はGraph-Maxの投稿にあった通り下記3つを作成してCodexに入力するだけです。
- グラフの図
- プロンプト
- レビュー対象のコード(pythonスクリプト)
この3つをCodexに入力すると、主に下記4つをcodexが実行してくれるようにプロンプトを作成します。
- グラフの図からコードレビューの処理を実行するグラフのコードを生成
- 生成されたコードが実行し、コードレビューが始まる
- コードにエラーがあれば修正される
- グラフの実行ログをファイルとして出力(各ノードの入出力や状態遷移など)
Codexの処理が完了すると主に下記3つが出来上がっている状態になります。
- グラフを定義したコードファイル(投稿内にあるコードモードスクリプトのことです。)
- 処理実行時のログファイル
- エラーが修正されたコードファイル(もしエラーがあれば)
グラフの図を作成する
もとの投稿にあったグラフの図をそのまま使ってもいいのですが、もっと簡素化して下図のようにしてみました。Reviewerの数を一つにし、それに伴いSynthesizeもなしにしてみました。きっとcodexがよりシンプルなコードを生成してくれると思います。
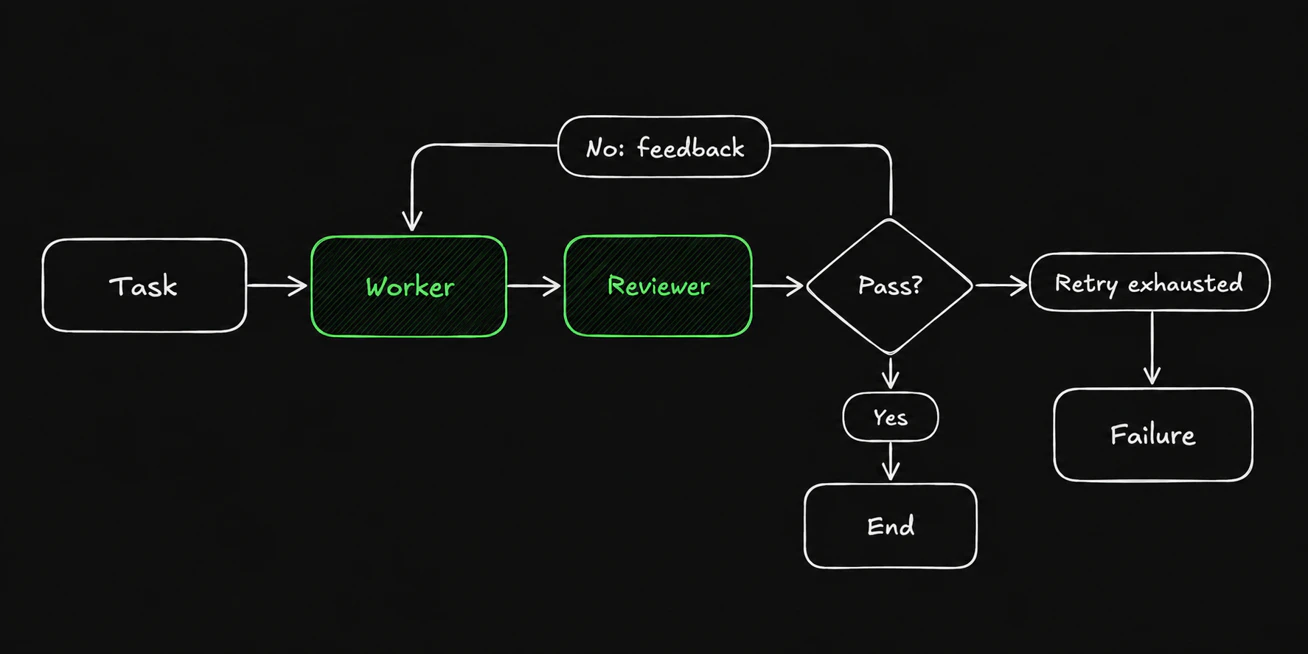
この画像ファイルをgraph_diagram.pngという名前で保存しています。
コードレビュー対象のPythonスクリプトを作成する
レビュー対象のコードは下記のような足し算のPythonコードにしてみます。(下記はエラーなしの正常系のコードですが、後で意図的にエラーを入れて異常系のgraph-maxの挙動も確認します。)
#test.py
def add(a: int, b: int) -> int:
	return a + b
print(add(1, 1))
こんなコードをレビューしてどうするんだと言われそうですが、今回はgraph-maxの挙動を確認することが目的なので、レビュー対象のコードや、グラフの図は適当で問題ありません。
プロンプトを作成する
そして要となるプロンプトの作成です。レビュー対象のコードと、グラフの図は結構適当でも大丈夫ですが、プロンプトはきっちりと作りこむ必要があります。
ローカルの画像ファイル graph_diagram.png を、実行可能なPythonの
コードモード・ワークフローとして実装し、実行してください。

①入力:
- 対象ファイル: test.py

②グラフ:
- Task → Worker → Reviewer → Pass?
- Pass?がNo → feedbackをWorkerへ返す
- Pass?がYes → End
- 再試行上限を超過 → Failure

③要件:
- ワークフローを `graph_engineering_workflow.py` としてLangGraphベースで作成する
- conda仮想環境はgraphengineeringを使う
- feedbackが空の初回実行では、Workerは対象ファイルを変更しない
- Reviewerは対象ファイルを独立して検査する
- [重要] Pass?はLLMではなく、決定論的なPythonコードとして実装する
- Pass?がNoの場合、Workerはfeedbackに基づいて対象ファイルを修正する
- ノード間の入出力をJSONで定義する
- 各ノード、エッジ、試行回数、Gate判定を記録する
- Workerによる修正は最大2回とする

④Gate:
以下をすべて満たした場合だけPassとする。

- `python <対象ファイル>` の終了コードが0
- 標準出力をstripした値が文字列 `2` と完全に一致
- 標準エラー出力が空
- Reviewerの出力がJSON Schemaに適合
- 未解決のhigh severityの問題が0件
- 未解決のmedium severityの問題が0件

GateがNoの場合、失敗した条件、期待値、実測値、標準エラーを
feedbackとしてWorkerへ渡す。

2回目のGate判定でも不合格の場合は、成功と報告せずFailureで終了する。

最終結果として状態遷移、Gate判定の根拠を表示する。
上記のプロンプト設計のポイントは以下の通りです。
①入力
ここは単にコードレビュー対象のファイル test.pyをしてするだけです
②グラフ
図のグラフの構造の概要をテキストで説明しています。図だけもグラフが作成されますが、このようなテキストでのコンテキストがあるほうが当然正確なグラフのコードが生成されます
③要件
今回の実行セッションでの処理要件を記載しています。
- codexが生成するコードレビューのグラフ定義のコードを生成し、graph_engineering_workflow.pyとして保存
- このコードにレビュー対象のコード test.pyを指定して実行
- 各ノードでの処理内容
- [一番重要なのがコレ] Pass?(処理完了の判定)をLLMではなくコード(決定論的なコード)で実装する ※ここをLLMまかせにしてしまうと、ループエンジニアリングがうまく動作しない可能性があります
- ノード間の入出力のフォーマット
- 処理の停止条件
- 実行履歴を出力
④Gate(処理完了の条件)
そして最も重要なことが、この処理完了の条件です。可能な限り定量的に記載することで間違いが起こらないようにします。要件に記載したように、この条件が満足したかをLLMで判定するのではなく通常のコードで判定し、LLMによるハルシネーションが入らないようにします。
簡単とはいいましたが、ここまでくるとそれなりに知識は必要だと理解していただけたのではないでしょうか。
- まずグラフを図に起こし、プロンプトにそのグラフ処理の概要を記載するためには、前述したようなグラフデータモデルについての知識が必要です。
- また、Codexが生成したグラフ処理のコードを読んで何を実行しているのか、正しいグラフが作られているのかがチェックできる程度の知識が必要です。
- そして、ハーネスやループの中で最も重要な概念である「処理完了の厳密な定義」を理解しておかないとプロンプトが設計できないということです。
codex cliで実行してみる
ここまで準備できたらコーディングエージェントに入力するだけです。
※codexでも、claude codeでもコーディングエージェントであれば何でも大丈夫です。
codex cliでの実行結果は下記の通りとなりました。
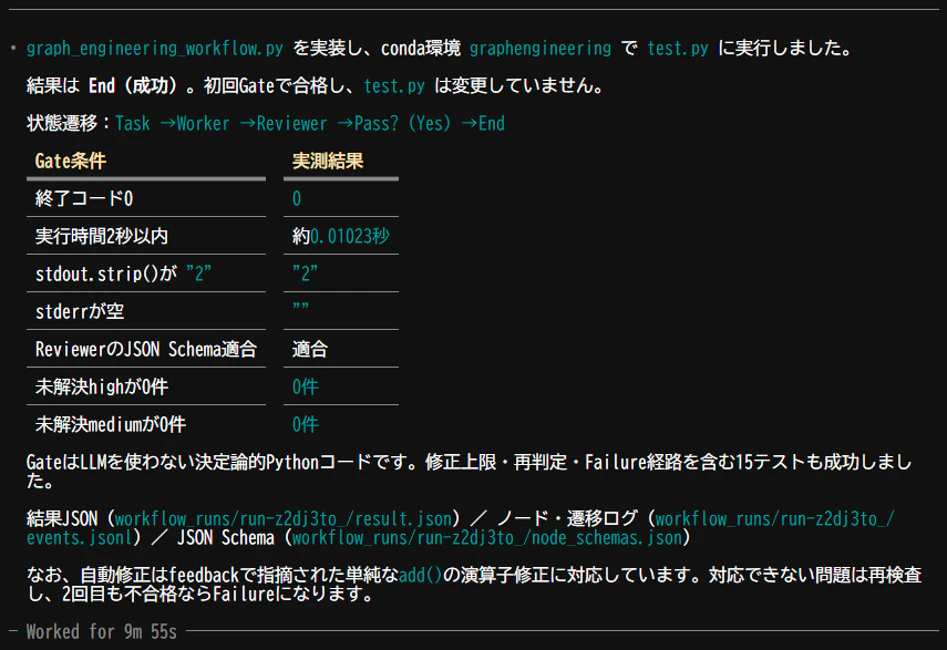
Codexがほぼプロンプト通りに処理を実行してくれていることがわかります。
ポイントは下記です。
- まず、LangGraphベースのグラフのワークフローのコードを graph_engineering_workflow.py で作成してくれました。これがコードレビューのプログラムです。
- 上記のプログラムでtest.pyのコードレビューをして正常完了しています。
- 今回のtest.pyの中身にはコードエラーはない状態でコードレビューをかけているので一回目のGateで合格しています。
- 『状態遷移』の項目にノード(本来はエージェント)の遷移が記されています。
- 7つあったGateの合格条件について合否を表にしてくれています。(それに加えて、codexが追加で8つ評価を追加してくれたようです。)
- ノード間の入出力情報やノード遷移の状態などをログとしてファイル出力しています。
実行後に作成されたファイルを確認
今回の実行でcodexが生成したファイルです。
- graph_engineering_workflow.py:これがCodexが図から生成したグラフ処理の定義そのものです。
- events.jsonl:ノードの入出力や状態遷移のログ
- results.json:実行結果のログファイルです。
以降はこのファイルを順に確認し、どのような処理が行われたかを確認します。
グラフはちゃんと作られたのか?を確認
codexが作成したLangGraphのコード graph_engineering_workflow.py を確認してみます。つまり、codexに入力した下記画像がちゃんとLangGraphのコードになっているのかを確認するということです。
まず、グラフの構造が下記コードでちゃんと定義されていることが分かります。(graph_engineering_workflow.py:562)
  builder = StateGraph(WorkflowState)

  builder.add_node("Task", task_node)
  builder.add_node("Worker", worker_node)
  builder.add_node("Reviewer", reviewer_node)
  builder.add_node("Pass?", gate_node)
  builder.add_node("End", terminal_node("End"))
  builder.add_node("Failure", terminal_node("Failure"))
StateGraphで、ノード間で共有する状態を持つグラフを作り、add_node()で6個の処理ノードを登録しています。図の通りです。
今回は挙動確認をしているだけなので単純なノードになっていますが、実システムではこれがエージェントになり、このエージェントに様々な処理や、MCP、スキルなどがぶら下がる感じになります。
そして次にエッジがadd_edge()で定義されていることがわかります。
  builder.add_edge(START, "Task")
  builder.add_edge("Task", "Worker")
  builder.add_edge("Worker", "Reviewer")
  builder.add_edge("Reviewer", "Pass?")
これにより、ノードの遷移順序は次のようになります。
START → Task → Worker → Reviewer → Pass?
Pass?以降のエッジは、add_conditional_edges()で定義しています。つまり条件付きエッジです。
これはGateの判定結果によってノードの遷移先が変わるからです。
  builder.add_conditional_edges(
      "Pass?",
      lambda state: state["gate"]["route"],
      {"Worker": "Worker", "End": "End", "Failure": "Failure"},
  )
つまり下記のように処理が完了してお役御免かどうかを判定する重要な処理ということです。
- Passがtrue(コードレビューの結果エラーなし)であれば合格なので End に遷移して処理完了
- Passがfalse(コードレビューの結果エラーあり)であれば不合格なので Worker に遷移してコードの修正のやり直(これがループです。)
Gateの終了条件がハーネスになっているかを確認
ハーネスで最も重要な点が、Gateの終了条件の判定をLLM任せにせず、普通のコードで決定論的に書くということでした。evaluate_gate()というユーザー定義関数の中の下記コードがその該当箇所です。(graph_engineering_workflow.py:325)
  failed = [check for check in checks if not check["passed"]]
  passed = not failed

  route = (
      "End" if passed
      else "Worker" if attempt < 2 and repair_attempts < 1
      else "Failure"
  )
evaluate_gate()の中で下記条件が passed になっているかを for文を回し順にチェックするコードが定義されていることが確認できました。
- 7つのGate条件をPythonで検査する
- すべて合格ならEnd
- 1回目の不合格ならfeedbackを付けてWorkerへ戻す
- 2回目も不合格ならFailure
判定結果のrouteをLangGraphの条件付きエッジが読み取り、次のノードへ遷移します。
  builder.add_conditional_edges(
      "Pass?",
      lambda state: state["gate"]["route"],
      {"Worker": "Worker", "End": "End", "Failure": "Failure"},
  )
つまり、LLMに合否を判断させず、Pythonコードだけで終了条件を決めており、これによってハーネスを実装していることがわかります。
ということで、図のグラフのコードは問題なく生成されていたことが確認できました。
実行結果のログファイルを確認
実行ログは results.json に出力されており、json viewerで確認してみます。
まず、root配下にtask、worker、reviewerといったノードとgate_history、transitions、resultsといった処理の状態を保存するエレメントがあることがわかります。
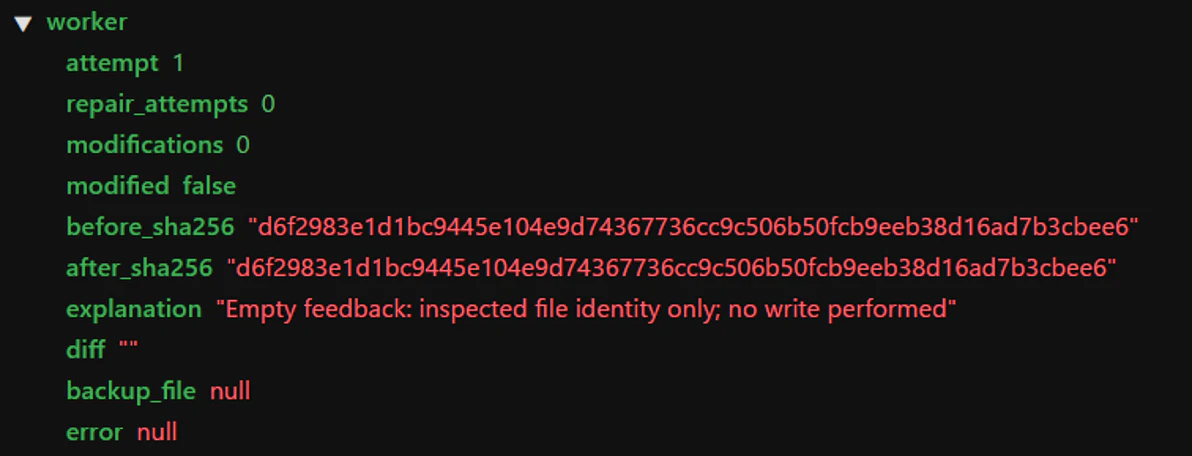
あまり細かく見てもしょうがないのでパッと見てわかるところだけ確認してみます。
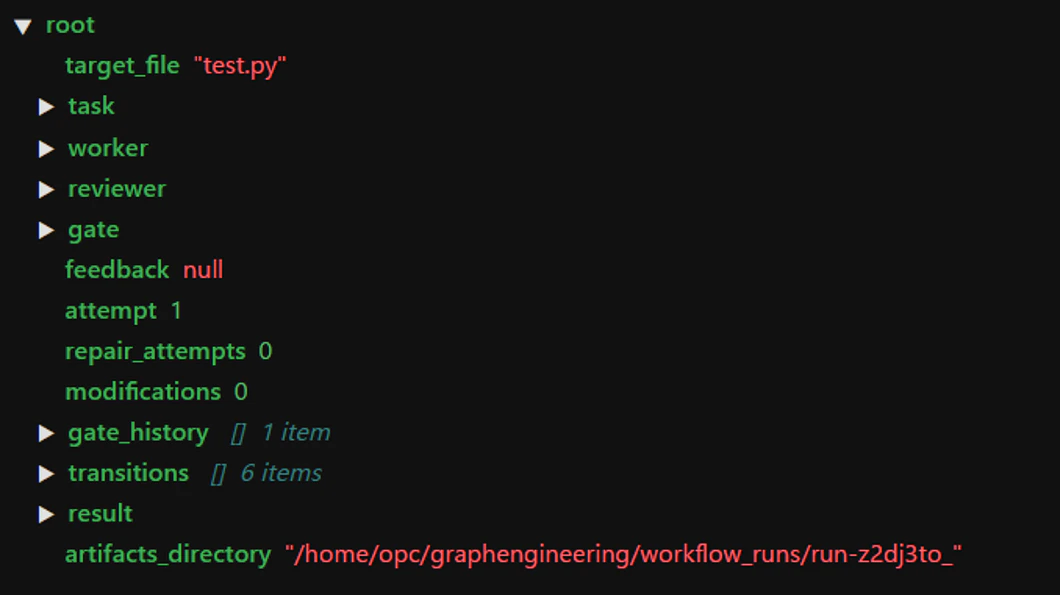
Workerを見てみると、attemptが1になっています。つまりworkerは一回のみの実行だったということです。今回は正常系のテストでコードにエラーはありませんので一回で合格したということです。(後で行う異常系のテストでは二回目のループで処理が完了するのでこの値が2になります。)
コードにエラーはありませんので、当然、Reviewerもattemptは1です。そして、Reviewerでは4項目がチェックされた旨が記録されています。(後で行う異常系のテストでは二回目のループで処理が完了するのでこの値が2になります。)
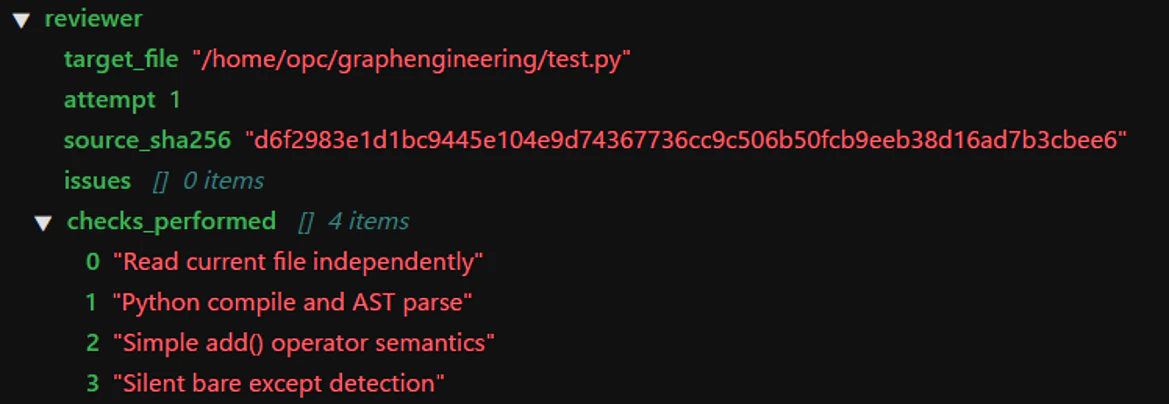
このような感じでグラフワークフローが実行された際の各ノードのログが確認できました。
レビュー対象のコードにエラーを入れて実行してみる(異常系のテスト)
もとのコードの a + b の箇所を a - b に変更してみます。コードとしては文法エラーではありませんが、Gateの合格要件の一つである『標準出力をstripした値が文字列 2 と完全に一致』を満たさないため、一回目のReviewerノードで不合格になり、Workerノードに戻され、修正後、二回目のReviewerノードで合格という流れが期待するノード遷移です。
#test_error.py
def add(a: int, b: int) -> int:
    return a - b

print(add(1, 1))
このエラーを検出し、修正できるかを確認できるか再度 codex で実行したところ、下記結果となりました。
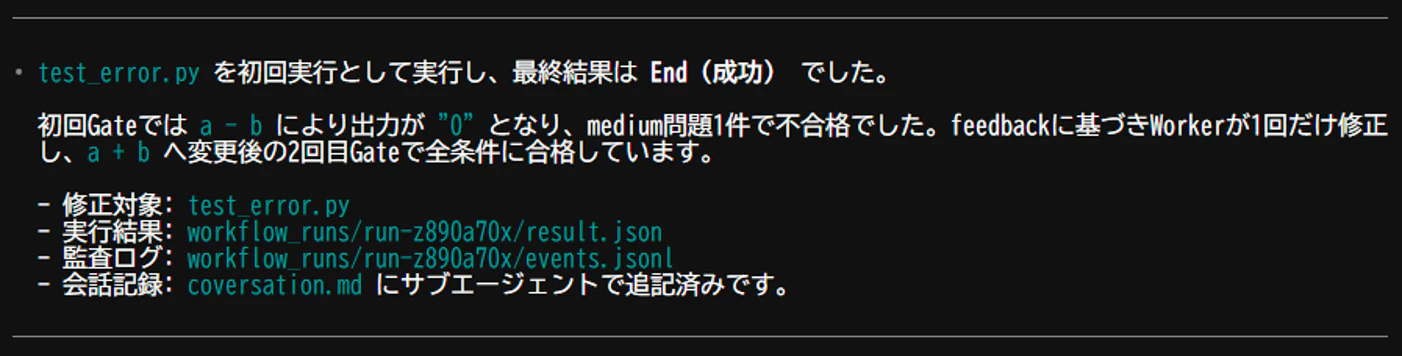
想定通り、一回目のGateでは不合格となり、そのフィードバックを元にコードが修正され、二回目のGateで無事合格、ループを抜け処理完了となっています。
そしてtest_error.pyはreturn a - bがreturn a + bに修正されていることを確認しました。
#test_error.py
def add(a: int, b: int) -> int:
    return a + b

print(add(1, 1))
実システムは当然こんなシンプルなグラフにはならないと思いますが基本はこのようなものです。
コーディングエージェントや外部機能と組み合わせて実用性を高める
ここまでは、グラフエンジニアリングの基本的な考え方に絞って紹介しました。上述した内容はあくまでグラフエンジニアリングのコンセプト的な部分のみのご紹介となり、さすがにこれで実運用というわけにはいきません。
実際には下記のような機能と組み合わせることになり、例えば、上述した処理と組み合わせるなら、という観点でいくつかご紹介します。(いずれもコーティングエージェントやGithubをお使いの方であればお馴染みの機能ということになります。)
-
目的・手順・終了条件の保存
グラフの目的、手順、終了条件をファイルで管理すると、実行のばらつきを抑えられます。全てをプロンプトに入力する必要はなく、例えば、グラフ固有の定義はgraph_engineering_workflow.md、リポジトリ全体のルールはコーディングエージェントの機能であるAGENTS.md(codex)やCLAUDE.md(Claude Code)に記載することもできます。 -
エージェントメモリ
events.jsonlや results.jsonのWorker、Reviewerの実行履歴、指摘、修正結果などのパートをデータベースへ保存し、ループ内でのエージェントの再実行時に過去の失敗を繰り返さないようにする仕組みが作れます。 -
実行ログの保存と分析
events.jsonlや results.jsonをデータベースへ集約し、実行ID、コミット、モデル、プロンプトのバージョンを関連付けることで、目的の処理がうまく動作しない場合の挙動分析に利用できます。 -
サブエージェントによる専門分担
Reviewerをセキュリティ、性能、保守性などのサブエージェントに分け、同じコードを異なる観点で独立してレビューさせ、Synthesiseノードなどで集約するような仕組みでエージェントを同時並列的に実行することができます。 -
エージェントスキル
Reviewerに専門的な観点でのレビューをさせる場合、そのノウハウをエージェントスキルとして予め設定しておき、くことでレビュー処理実行時にエージェントスキルを利用できます。 -
Gitブランチとworktreeによる作業分離
Workerによるコード修正が行われる際、Gitブランチやworktreeでその修正作業環境を分離できます。これにより複数エージェントが同時に別の修正案を試すことができるようになります。 -
MCPによる外部連携
MCPを使うことでウェブサービスやDBなどエージェントから様々な外部サービスに連携できます。これにより便利な機能を持ったエージェントを実行することができるようになります。
必要なものだけを選択する
これらすべての導入が、ループエンジニアリングやグラフエンジニアリングの要件ではありません。必要な再現性、信頼性、監査性、復旧性を見極め、目的に合う機能だけを選ぶことが重要です。
おわりに
進化サイクルの早いIT業界に長年身を置いていると、以前からある実装にバズりそうな名前を付けて革新的テクノロジーのように扱われだすトレンドをよく目にします。今や生成AIは新しいトレンドに巨額の投資マネーが流入する異常な市場ですからそれはムリもありません。
グラフエンジニアリングというキーワードが新たなメインストリームとして受け入れられるのか、それとも単に車輪の再発明にグラフエンジニアリングという名前を付けてバズらせただけということなのか、皆さんはどうお感じになられますか? (今のところ筆者は後者寄りです。)
とは言え、一つ言えることは、グラフベースのマルチエージェントオーケストレーションが出だしたころは、まだコーディングエージェントもなければ、エージェントスキルもない時代。それに加えて現在のハーネスやループの中で重視されている、「LLMの処理完了定義をきちんと定量化して厳密な終了判定を行う」という考えもあまり定着していなかったように感じることを考えると、グラフエンジニアリングというキーワードが出てきたおかげで、エージェントのフレームワークAPIが進化すべき方向性が少し見えてきたのではないでしょうか。
:::