
仕事の文章はほとんど AI に下書きさせています。中小企業向けの提案書、作業の報告、事業部の人に送る Slack のメッセージ。内容はだいたい合っているのに、そのままでは出せません。読み返すと、毎回同じところを直していました。
直していた箇所をまとめて Claude Code のスキルにし、GitHub で公開しました。Codex と Cursor でも使えます。
困っていたこと
最初は、文法も事実も正しいのに何がまずいのか、自分でもうまく説明できませんでした。実際に指摘を受けたり、出す直前に気づいたりした例を並べると、こうなります。
- 顧客に出す提案資料に「御社」が6か所残っていた。話し言葉では御社、書き言葉では貴社なので、資料の地の文はすべて「貴社」にそろえるべきだった。
- 役員が稟議の際に読む提案書に「稼働中の版には触れません」と書いた。開発者なら通じるが、役員には何が起きるのか分からない。
- 事業部の人への Slack 報告に、ファイル名と行番号を書いていた。読む人はリポジトリを開かない。
ほかにも、太字の見出しに「:」を付けた箇条書き、「〜ではなく〜」の対比の多用、「重要です」で終わる段落。指摘を受けるたびに、AI への指示書(CLAUDE.md)に1行ずつ書き足してきました。指示書は長くなるばかりで、指示を守る日もあれば、守らない日もありました。
英語圏には、同じ悩みを扱う humanizer や avoid-ai-writing というスキルがあります。日本語向けに書き換えて使ってもみましたが、点検対象は「delve」のような英単語やダッシュの使い方など、英語の癖でした。そのため、日本語の報告書にかけても直る箇所はほとんどありませんでした。そこで、日本語の癖を一から集め直すことにしました。
どういう考え方で作ったか
最初に決めたのは、直す前に文書の種類を見ることでした。スキルはまず、業務文書・読み物・説明文のどれかを判定します。AI っぽさを消そうとすると、体験談や「正直、驚きました」みたいな感想を足したくなるんですよね。ブログならそれで自然に読めても、提案書に入れると途端に軽く見えます。報告書は淡々と書いたほうが信用される。ここを最初に分けておかないと、直したつもりで別の違和感を足すことになります。
国内の計測記事や研究を読んでいくと、AI っぽく見える日本語の原因は、決まった型が残っていることと、文章全体が揃いすぎていることの、だいたい 2 つに行き着きました。太字の見出し、「〜ではなく〜」、「本記事では〜について解説します」で始まって「いかがでしたか」で終わる構成。この手の型は、見つけて消せば済みます。厄介なのは揃いすぎのほうで、文の長さも語尾も段落の長さも読点の間隔も、どこを切っても似たような形をしている。人の文章はもっとばらつくので、こちらは 1 か所直しても消えず、段落ごと書き直すしかありません。
一方で、1 つの癖だけで AI の文章だと決めつけないようにもしました。AI がよく使う言い回しの中には、人も普通に書くものが混ざっているからです。59 項目の癖のうち、はっきり AI らしい 25 項目にだけ★を付け、★は 1 つでも見つけたら直す。残りは、同じ段落に違う種類の癖が 3 つ以上重なったときだけ直す、という線引きにしています。
もう 1 つ効いたのが、数えられるものは機械に数えさせることでした。点検表を読ませるだけだと、AI は自分が書いた文の癖をけっこう見落とします。太字、全角ダッシュ、「〜ではなく」、頻出語、語尾の連続、文の長さのばらつきは、Python のスクリプト(scripts/check.py、依存ライブラリなし)で数えるようにしました。スキルは書き直した後にこのスクリプトをもう一度走らせ、数えられる★が残っていないことを確かめてから返します。
使うとどうなるか
Claude Code に文章を貼って「AIっぽさを消して」と頼むだけです。ファイル名を渡せば、地の文だけを直して上書きします。
AI に「プロジェクトが2週間遅れていることを上司に報告する Slack メッセージ」を書かせると、次の文が返ってきました。
お疲れ様です。○○プロジェクトについて、進捗が当初のスケジュールから 2 週間遅延 しています。主な要因は以下の通りです。
- 要件定義の変更 が多数発生し、再設計に時間を要したこと。
- 外部ベンダーの納品遅延 に伴う依存タスクの遅れ。
- リソース不足(開発メンバーの一時的な兼任業務)
現在、遅延分の取り戻しに向けて、次の対策を実施中です。
- 余裕のあるタスクを再割り当てし、重点的にリソースを集約。
- ベンダーと納期再調整を実施し、今後のリスクを低減。
- 進捗管理を週次ミーティングで細分化し、早期検知体制を強化。
つきましては、新たなマイルストーン案(○月○日 完了予定)をご提示いたしますので、ご確認いただけますと幸いです。ご質問やご要望がございましたら、遠慮なくお知らせください。
上司への Slack メッセージには太字が5か所あり、箇条書きは会議資料のような体言止めで、締めは定型文です。スキルにかけると、こうなります。
お疲れ様です。○○プロジェクトが当初の予定から2週間遅れています。
要件の変更が続いて再設計に時間がかかったことと、外部ベンダーの納品が遅れ、それを待つ作業も遅れたことが主な原因です。開発メンバーの一部は別の業務を兼任していて、人手も足りていませんでした。
今は日程に余裕のある作業から人を外して遅れている作業に回し、ベンダーとは納期を調整し直しています。今後の遅れに早く気づけるよう、毎週の定例会議で進捗を細かく確認するようにしました。
完了予定を○月○日に見直す案をお送りしますので、ご確認をお願いします。
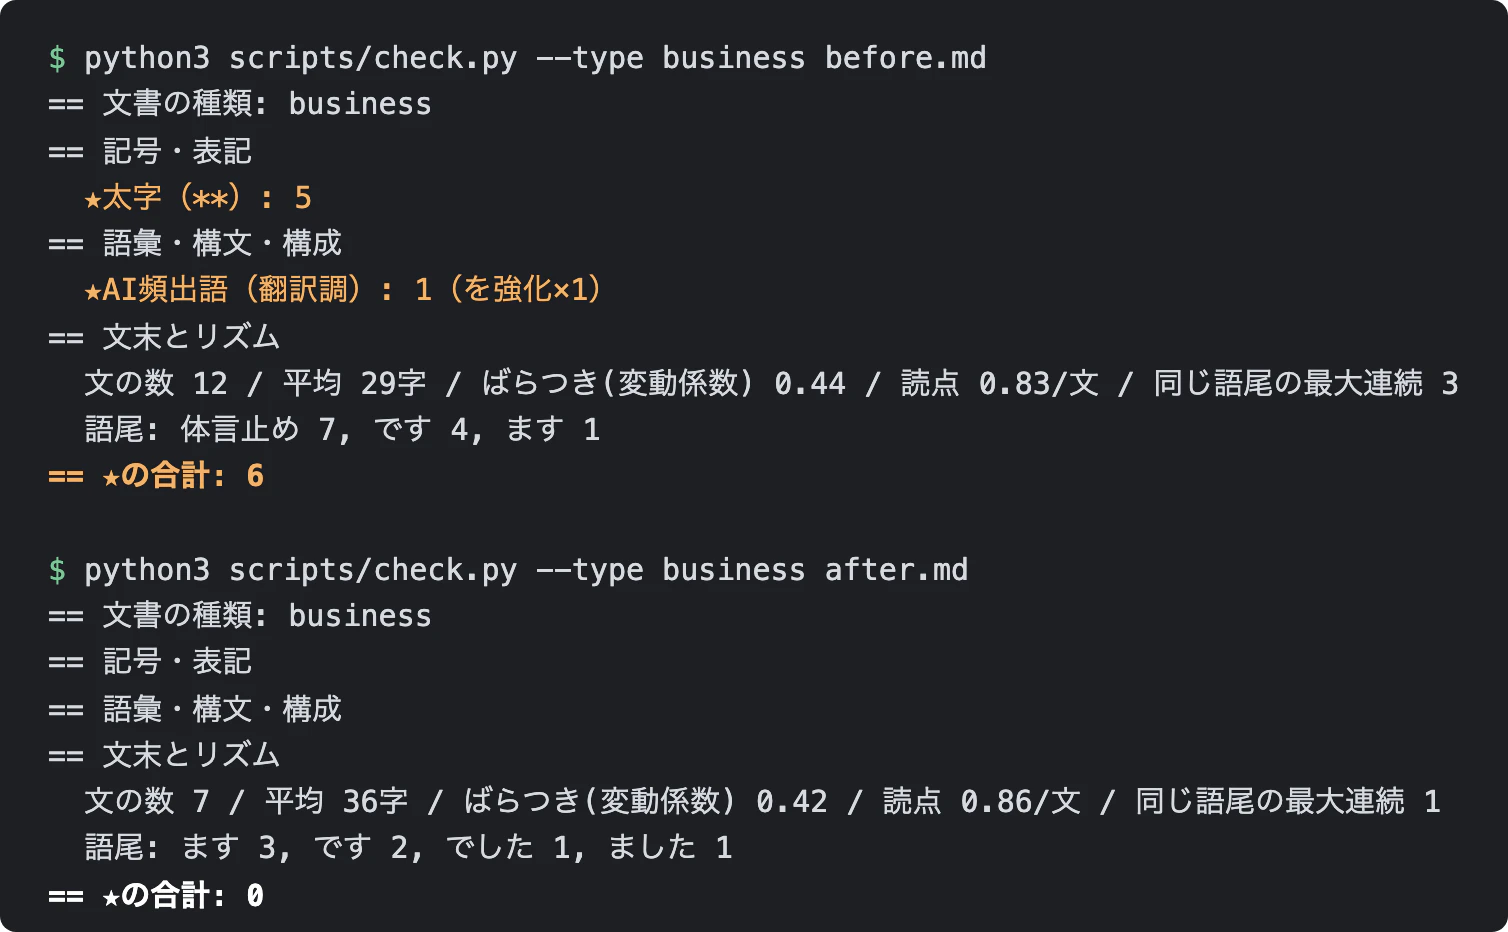
遅れた期間・原因・対策・新しい完了予定は元の文にあったものだけで、事実は足していません。check.py で数えると、★の癖は直す前が6個(太字5、「〜を強化」1)、直した後は0個でした。
直す前と直した後の文章をそれぞれファイルにして、check.py にかけた結果です。
頼み方を変えると、直し方も変わります。「事業部の人向けの報告にして」と頼めば、ファイル名やテーブル名を「誰の何がどうなるか」に言い換えます。「ブログ記事として自然にして」なら、書き手の迷いや感想を残して語尾を崩します。書く前に読み込ませておくと最初からこの基準で書いてくれるので、私はこの使い方がいちばん多いです。後から直すより速く済みます。
測ってみて分かったこと
点検表を作った後、それぞれの癖で人と AI を本当に見分けられるのかを測りました。人の文章は社内 Slack の返信40本(14人)。AI の文章は、業務報告・メール・記事など15種類の依頼文を、Gemini 3.1 Pro(15本)・GPT-OSS 120B(15本)・Claude Sonnet 4.6(10本)に書かせた40本です。
| 指標 | 見分けやすさ(AUC) |
|---|---|
| ★の癖の合計 | 0.91 |
| 太字 | 0.89 |
| 文の長さのばらつき | 0.69 |
| 1文あたりの読点 | 0.65 |
| 全角ダッシュ | 0.51 |
AUC は、AI の文章を人より上に並べられる確率で、0.5なら当てずっぽうと同じです。文の長さのばらつきは AI のほうが小さいので、向きを反転した値を載せました。
意外だったのは、予想が外れた所です。英語圏で AI の文章の特徴としてよく挙がるダッシュ(—)は、今回の3モデルの日本語ではほとんど使われていませんでした。「に関して」と「〜することができます」は翻訳調の代表としてよく挙がりますが、AI より人のほうが多く使っていました。この2つは★から外しています。
人の文章はすべて Slack で、AI の文章とは種類もそろっていません。太字の差は大きめに出ているはずで、評価セットにはまだ偏りがあります。しきい値の根拠と限界は eval/README.md に書きました。
導入
Claude Code の場合は、スキルのフォルダに置くだけです。
mkdir -p ~/.claude/skills
git clone https://github.com/kojikojikojikoji/natural-japanese-writing ~/.claude/skills/natural-japanese-writing
Cursor は ~/.claude/skills/ も読むので、同じ手順で使えます。Codex は ~/.agents/skills/ を読むので、リンクを張ってください。
mkdir -p ~/.agents/skills
ln -s ~/.claude/skills/natural-japanese-writing ~/.agents/skills/
参考にしたもの
点検表は、次の記事と研究をもとにしています。
- coji「AI臭は語彙よりリズムに出る」(Zenn)。7モデル406本を計測し、否定対比の頻度と体言止めの使用率を出しています。
- kenimo49「AIくさい文章から脱出する技術」(Docswell)。語彙・構造・リズム・表層の4層に分け、頻出語を計測しています。
- 広島大学の卒業論文「AI生成文からみた『自然な日本語』についての研究」
- ykhirao「Qiita 81万記事を15年分測ったら」(Qiita)
- もとやま「AIっぽい文章表現大全」(note)
新しい癖を見つけたら、Issue で教えてもらえるとうれしいです。私も指摘を受けるたびに項目を足しています。
この記事は Zenn にも載せています(Zenn 版には check.py の実行画面はありません)。
https://zenn.dev/koji4/articles/42b8c6d5901323