
 対象読者
- S3Vectorsでベクトル検索やRAGを始めてみたまたはこれから始める方
- 「検索すれば、意味が近い順で文書が必ず返ってくる」と思っている方
- メタデータフィルタでテナントIDとかで検索を絞り込みたい方
🤔 意味が近い文書が抽出されないっ!
S3Vectorsは文章を数字の並び(ベクトル)にしたものを保存し、意味の近いものを探せるサービスです。このS3Vectorsでフィルタをかけて検索すると、意味が近い文書があるのに検索結果に含まれないことがあります。
そんなことがあってたまるか!それバグでしょ!
と思う人もいるかもしれませんが、落ち着いてください
まず前提としてS3Vectorsの検索はそもそも近似です。そこから順を追って説明いたします。
📖 公式には「近似」「90%超」と書いてある
S3Vectorsで検索に使うQueryVectorsのAPIリファレンスには冒頭に次の説明があります。
Performs an approximate nearest neighbor search query in a vector index using a query vector.(質問のベクトルを使ってベクトルインデックスに近似最近傍検索を行う)
つまりS3Vectorsの検索はANN(近似最近傍検索)で行われています。
「近似」なので精度は100%ではありません。どのくらいの精度なのかはAmazonS3のFAQに書かれています。
S3 Vectors delivers over 90% average recall for most datasets. Average recall measures the quality of query results—90% means the response contains 90% of the ground truth closest vectors, that are stored in the index, to the query vector. However, because actual performance may vary depending on your specific use case, we recommend conducting your own tests with representative data and queries to validate that S3 vector indexes meet your recall requirements
要約するとこうなります。
- ほとんどのデータで平均recall(本当に近いものをどれだけ拾えたかの割合)は90%を超える
- 90%とは本当に近いベクトルのうち9割が検索結果に含まれるという意味
- 実際の性能は使い方で変わるので自分のデータと質問で試すことを勧める
裏を返すと"本当に近いベクトルの1割弱は結果に入らないことがある"と公式に書かれているわけです。
本題はフィルタをかけたときにこれより大きく漏れることがある点でその理由もANN検索のやり方を知るとしっくりきます。
🗂️ ANN(近似最近傍検索)とは?
ここで何やら難しい言葉が出てきましたね
ANNは一言で言うと「全部とは比べずにだいたい近いものを探す」検索です。
なんと大雑把な検索なんでしょうね。
でもここ大事かつ複雑なので図書館の本棚に例えて説明して行きます。
全部読むか?棚を絞るか?
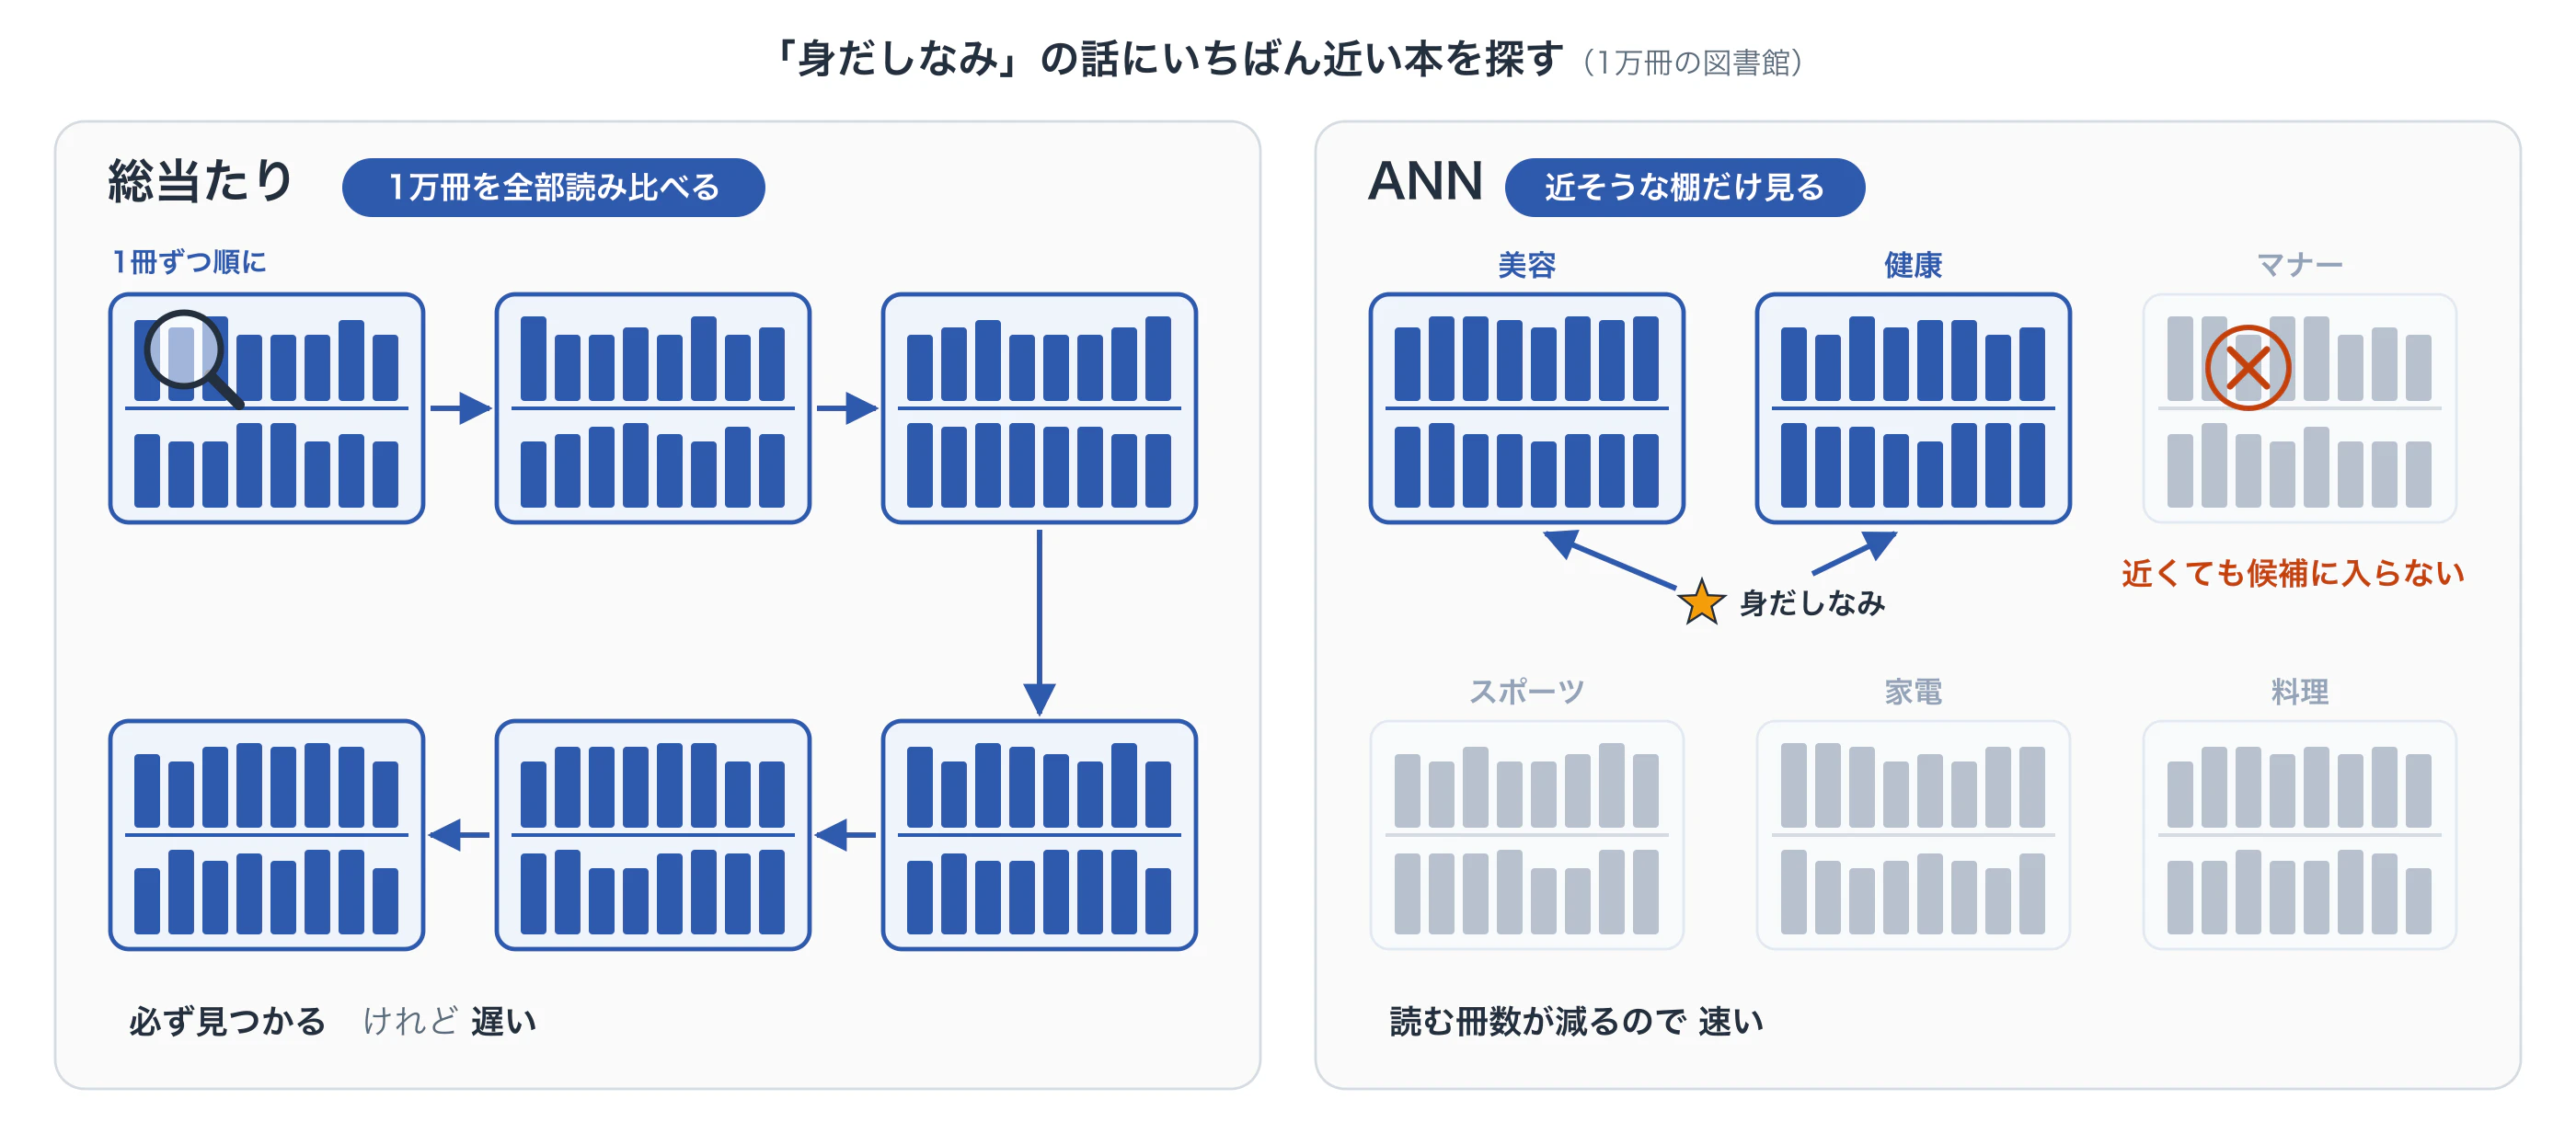
1万冊の本がある図書館で「身だしなみ」の話にいちばん近い本を探すとします。
1つ目のやり方は1万冊を1冊ずつ開いて読み比べる方法です。(総当たり式)必ずいちばん近い本が見つかりますが本が増えるほど時間がかかります。
2つ目のやり方がANN(近似最近傍検索)です。本をあらかじめ「美容」「スポーツ」「家電」のような棚に分けておき、質問に近そうな棚だけを見に行きます。読む冊数が減るので速く返せます。そのかわり見に行かなかった棚にある本はどんなに質問に近くても候補に入りません。
件数が数百万、数億になると総当たりは現実的ではないのでベクトルデータベースの多くはANNを使っています。
近いのに出てこない理由
棚分けはベクトルの位置をもとに機械的に行われます。たいていはうまく分かれますが境目にある本も出てきます。「メンズコスメで身だしなみを整える」記事は美容の棚にもビジネスの棚にも入りそうです。
もしこの本が質問から少し離れた棚に入れられていたらどうなるでしょうか。見に行く棚の数には限りがあるのでその棚にたどり着く前に探索が終わることがあります。本当は近い本なのに結果に入らない。ANNの取りこぼしはこうして起きます。
見に行かなかった棚の本はそもそも比べられていません。
棚型とグラフ型
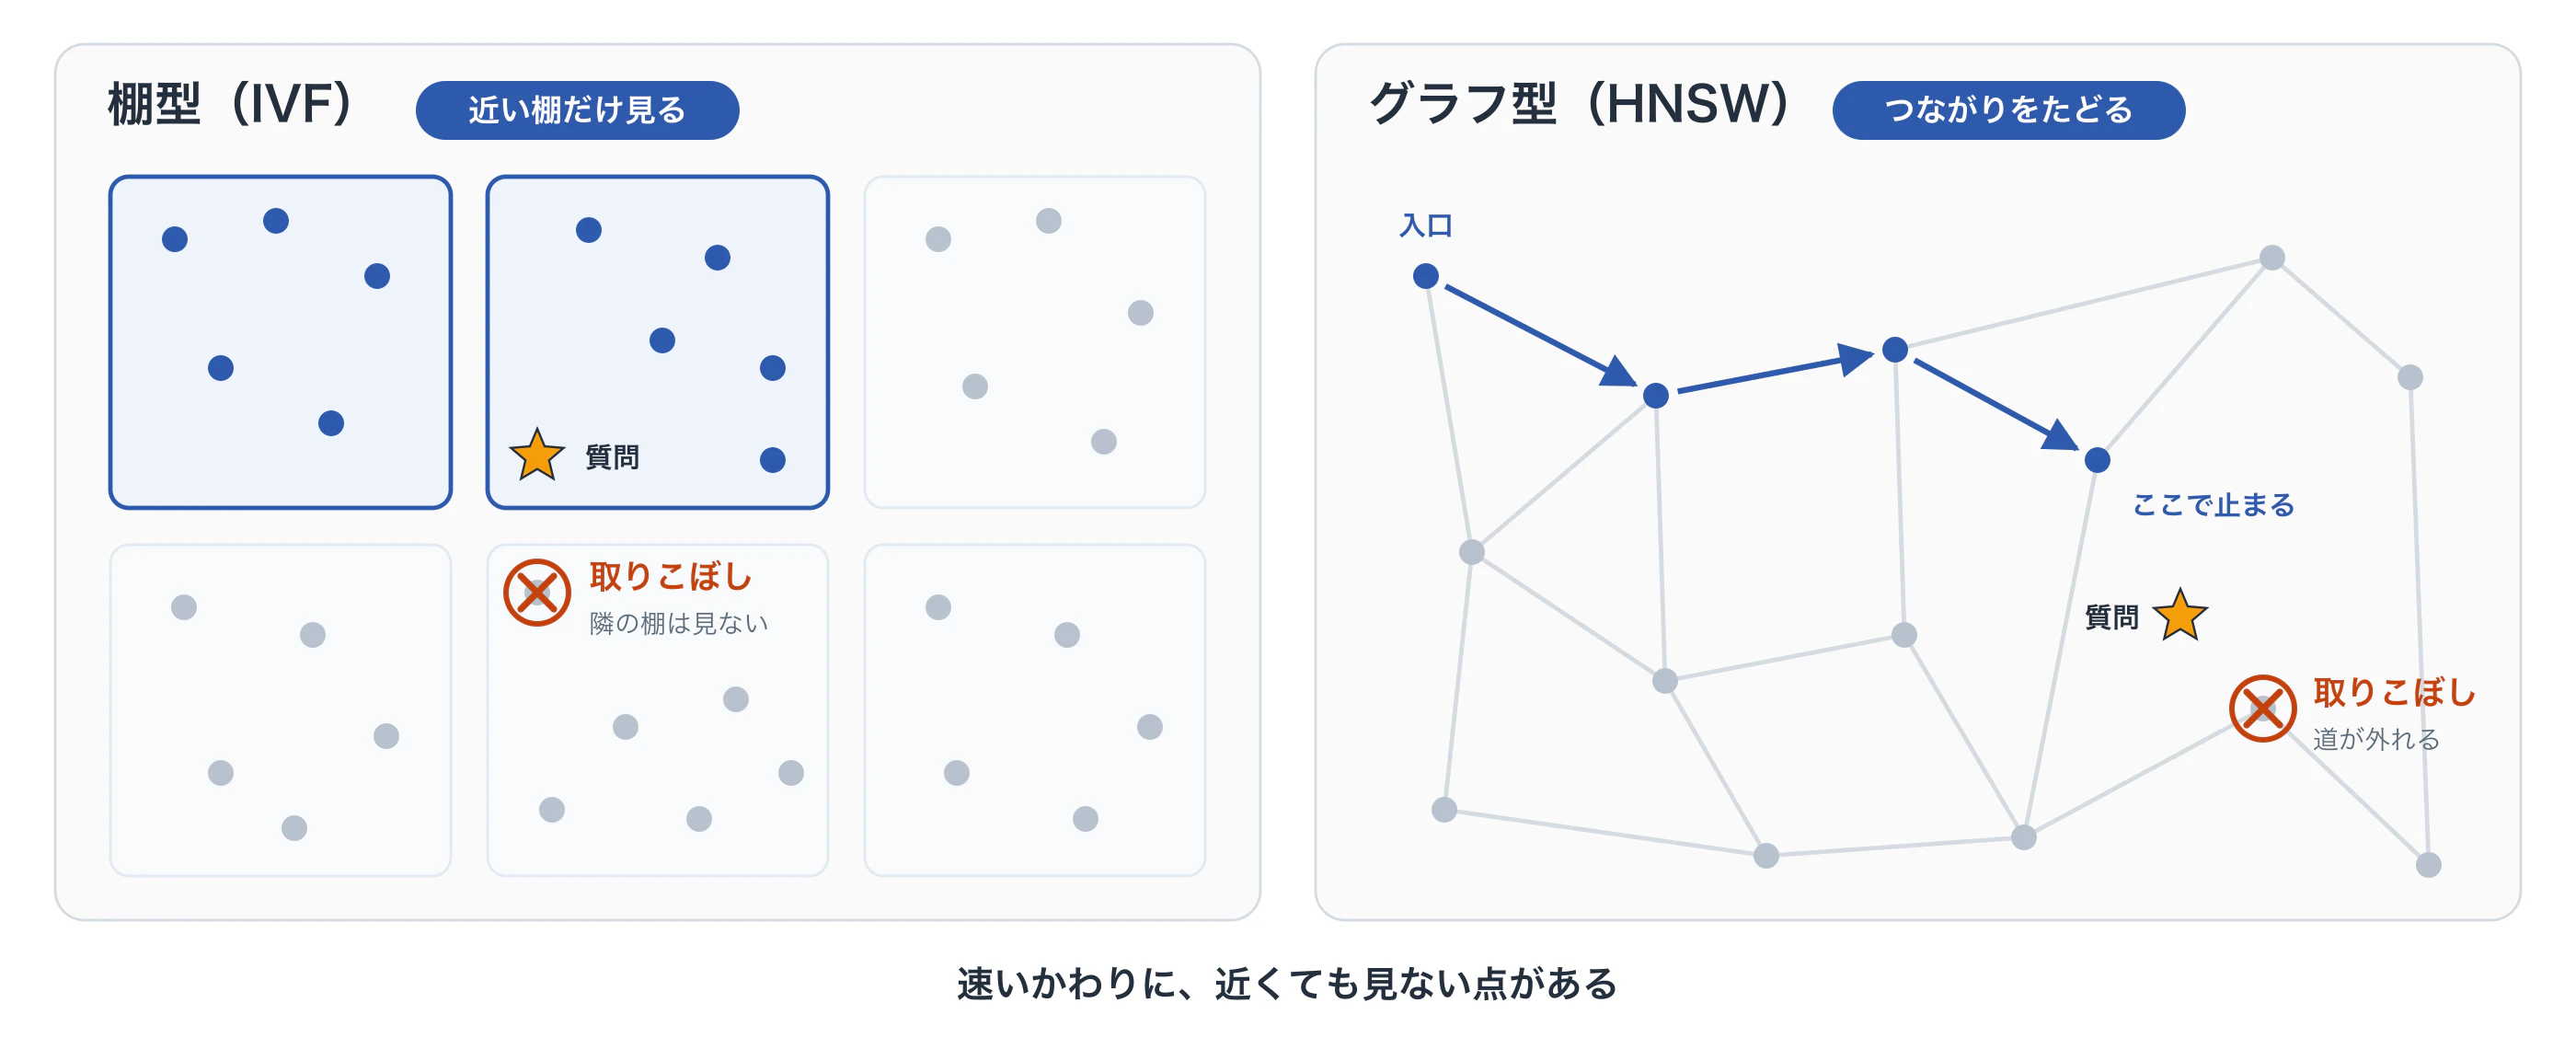
ANNのやり方には代表的なものが2つあります。棚型(IVF)はいまの本棚の例えそのものです。ベクトルを区画に分けておき質問に近い区画から決まった数だけ開けて中を比べます。
グラフ型(HNSW)は似ているベクトル同士を矢印でつないでおき質問に近い方へ矢印をたどっていく方式です。たどる道によっては本当に近いものの手前で止まってしまいます。
どちらも速さと引き換えに少しの取りこぼしを受け入れる方式です。
実際にS3Vectorsがどの方式を採用しているかは公式には明示されていません。
🧪 検証内容
次の条件で検索し、総当たりの正解と突き合わせました。
| 項目 | 内容 |
|---|---|
| データ | livedoorニュースコーパスの記事を約500字ずつに区切った1万チャンク |
| 埋め込みモデル | TitanTextEmbeddingsV2(1024次元) |
| 距離の測り方 | コサイン距離 |
| インデックスのモード | ENHANCED |
| リージョン | 東京(ap-northeast-1) |
| 質問の数 | 40本 |
| topK | 100 |
| 正解の作り方 | フィルタに合う全チャンクと総当たりで類似度を計算 |
| フィルタ | フィルタなし、強くまとまった100件、まとまった100件、散らばった100件の4種類 |
| 繰り返し回数 | 3周 |
📊 取りこぼしやすい傾向
該当100件のタグで絞って検索した結果です。「まとまった」はタグの付いたチャンクのベクトルが近くに集まっている、「散らばった」は全体にばらけている、という意味です。
| フィルタ | 付け方 | 正解上位100件のうち返った件数(平均) |
|---|---|---|
| フィルタなし | 1万チャンク全部が対象 | 95.6件 |
| フィルタあり 強くまとまった100件 | 各カテゴリの中で、ベクトルの中心に近い100チャンク | 97.3件 |
| フィルタあり まとまった100件 | 各カテゴリの中から無作為に選んだ100チャンク | 91.2件 |
| フィルタあり 散らばった100件 | 1万チャンク全体から無作為に選んだ100チャンク | 77.9件 |
ベクトルの値が散らばっているタグほど取りこぼしやすい傾向にありました。散らばった100件は公式の「90%超」を下回りました。
1回の検索で見る範囲はほぼ決まっている(?)
1回の検索で見る範囲はほぼ決まっているようです。散らばったタグで絞った検索では、topKを100から1000に増やしても返ってくる結果は同じで、見る範囲は広がりませんでした。
散らばると範囲の外に正解が残る
探索方法詳細は公式に明示されていないため、探索法については推測です。
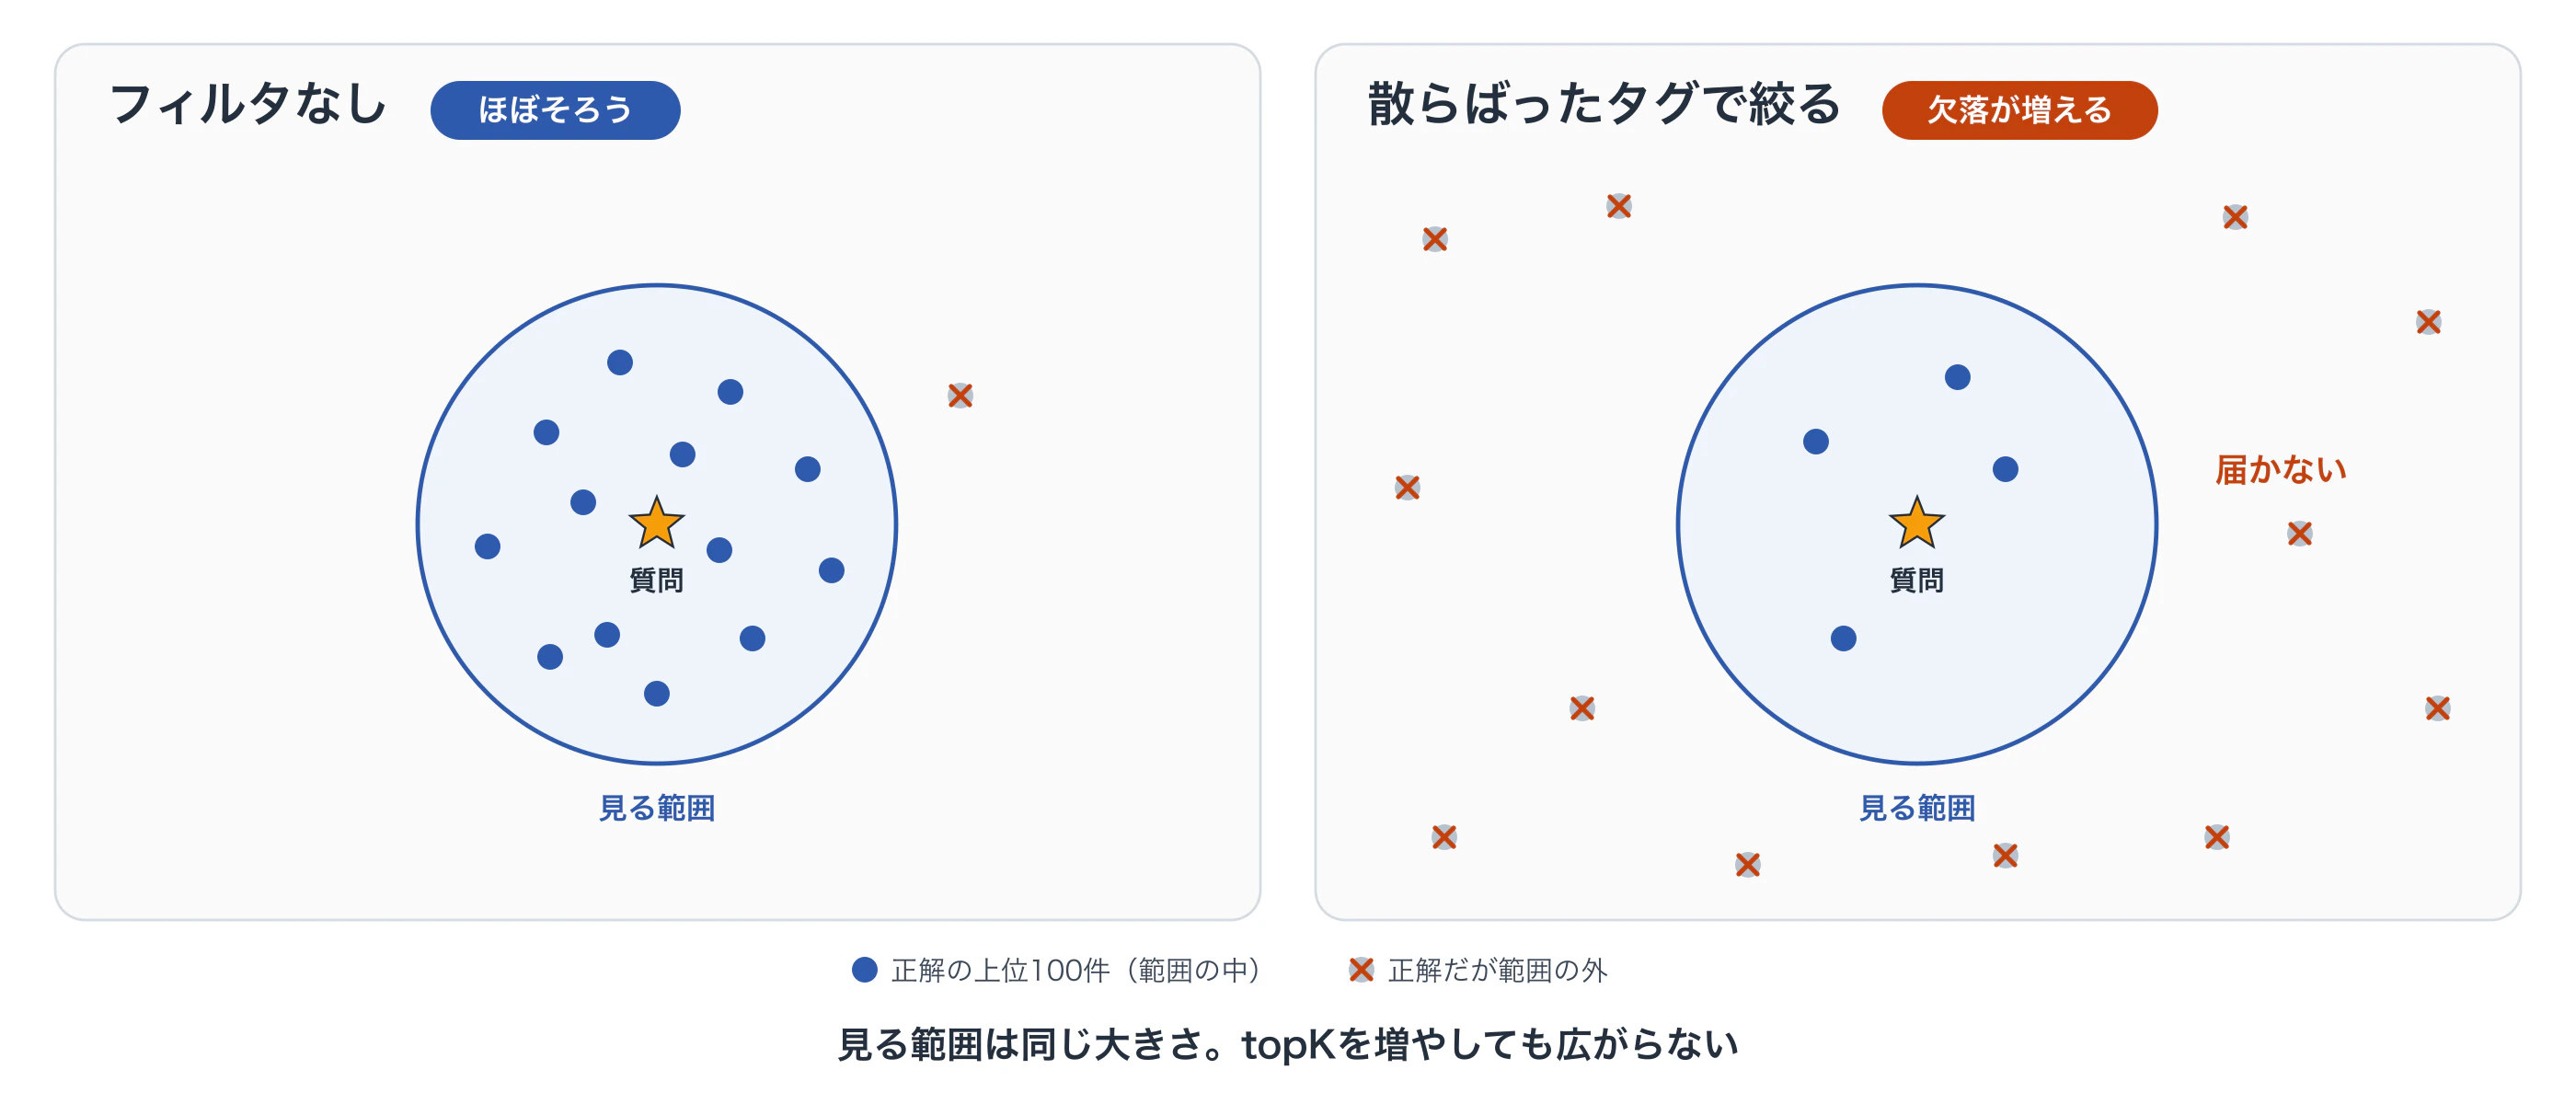
フィルタなしなら、正解の上位100件は質問のすぐ近くに集まっているので決まった探索範囲の中でほぼそろいます。タグで絞ると正解の100件は遠くの棚にも散っていて探索範囲の外にある分には届きません。見なければいけない範囲は広いのに見る範囲は同じままなので欠落が増えると推測しました。
📏 規模を変えて測ってみた
別の検証として規模を1,000〜20,000件に変え、タグの散らばり具合を5段階に振って測りました。ENHANCEDモード、topK=100、質問40本で、正解は総当たりで決めています。
| フィルタ(該当件数) | 総件数4,000件以下 | 5,000件 | 10,000件 | 20,000件 |
|---|---|---|---|---|
| フィルタなし(全件) | ほぼ100% | 86% | 95% | 94% |
| カテゴリ(総件数の約1/9) | ほぼ100% | 87% | 95% | 94% |
| まとまった100件 | 100% | 88% | 95% | 98% |
| 中間(半分ランダム、100件) | 100% | 79% | 85% | 85% |
| 完全に散らばった100件 | 100% | 73% | 79% | 75% |
4,000件まではどの条件でも取りこぼしがほぼなく、5,000件から出始めました。5,000件以上ではタグが散らばるほどrecallが下がりました。フィルタなしは公式の「90%超」どおりですが散らばったタグで絞ると下回ります。
🛡️ 対策
1. 意味がまとまる軸でフィルタを使う
カテゴリのように話題がまとまるタグなら、散らばったタグより取りこぼしは少なめでした。テナントIDや作成者のようにベクトルの値が散らばるタグでの絞り込みは要注意です。
2. 散らばるタグはインデックスを分ける
テナントIDのようにデータのベクトルが散らばりそうなタグで絞り込むなら、テナント毎にインデックスを分けてフィルタなしで検索できる形にするのも手かもしれません。
3. 検証では総当たりの結果と比べる
本番前に代表的な質問で総当たりの正解と検索結果を突き合わせ、抽出の欠落がないかを確かめておきましょう。今回の取りこぼしもこのやり方で見つけました。
🍜 締め
SQLで「結果が1割弱漏れます」と言われたらとんでもないことですよね?でもS3Vectorsってそういうものなんです。正確にはS3Vectorsが悪いわけではなくANNってそういうものなんです。しかもフィルタの付け方しだいでは2割くらい漏れることもあります。事前に取りこぼしがあることを把握したうえでワークロードに合っているかを設計の時点で確かめておくことが大切 ですね。