
🧭 はじめに
以前RAGにJevを使うと効率がよくなるという記事を書きました。
今回はそれをAgenticRAGへ持ち込むとどうなるのか踏み込んでみました。
📌 TL;DR
- 判断をJevに置き換えれば爆速になると思ったら思いのほか速くなりませんでした

- 理由はAgenticRAGが判断と次のクエリ作りを1回のLLMリクエストでまとめて済ませていたから(判断だけ抜いてもLLM推論回数は変わらず)
- 代わりに効いたのはエージェントをやめたことによるエージェント起動時間
ループの度に履歴を送り直さなくなったトークンコスト削減 - トレードオフとして質問の型を先に読み切って分岐を書く手間が増す
- 個人的に一番よかったのは、判断の主導権をAIからこちら側に引き寄せられたこと
🧐 対象読者
- AgenticRAGを使用されていてレスポンス、コストに不満がある方
- Jevの可能性を探求されてる方
- RAG沼にハマっている方
🤔 AgenticRAGについておさらい
AgenticRAGは記事や資料を読むたびに「で、結局エージェントは何をしてるんだ?」という感じになりますよね。検索を「1回きりの固定手順」から「判断しながら回すループ」へ変えたのがAgenticRAGです。じゃあそのループの中身は何をしているのか?こんな感じです。
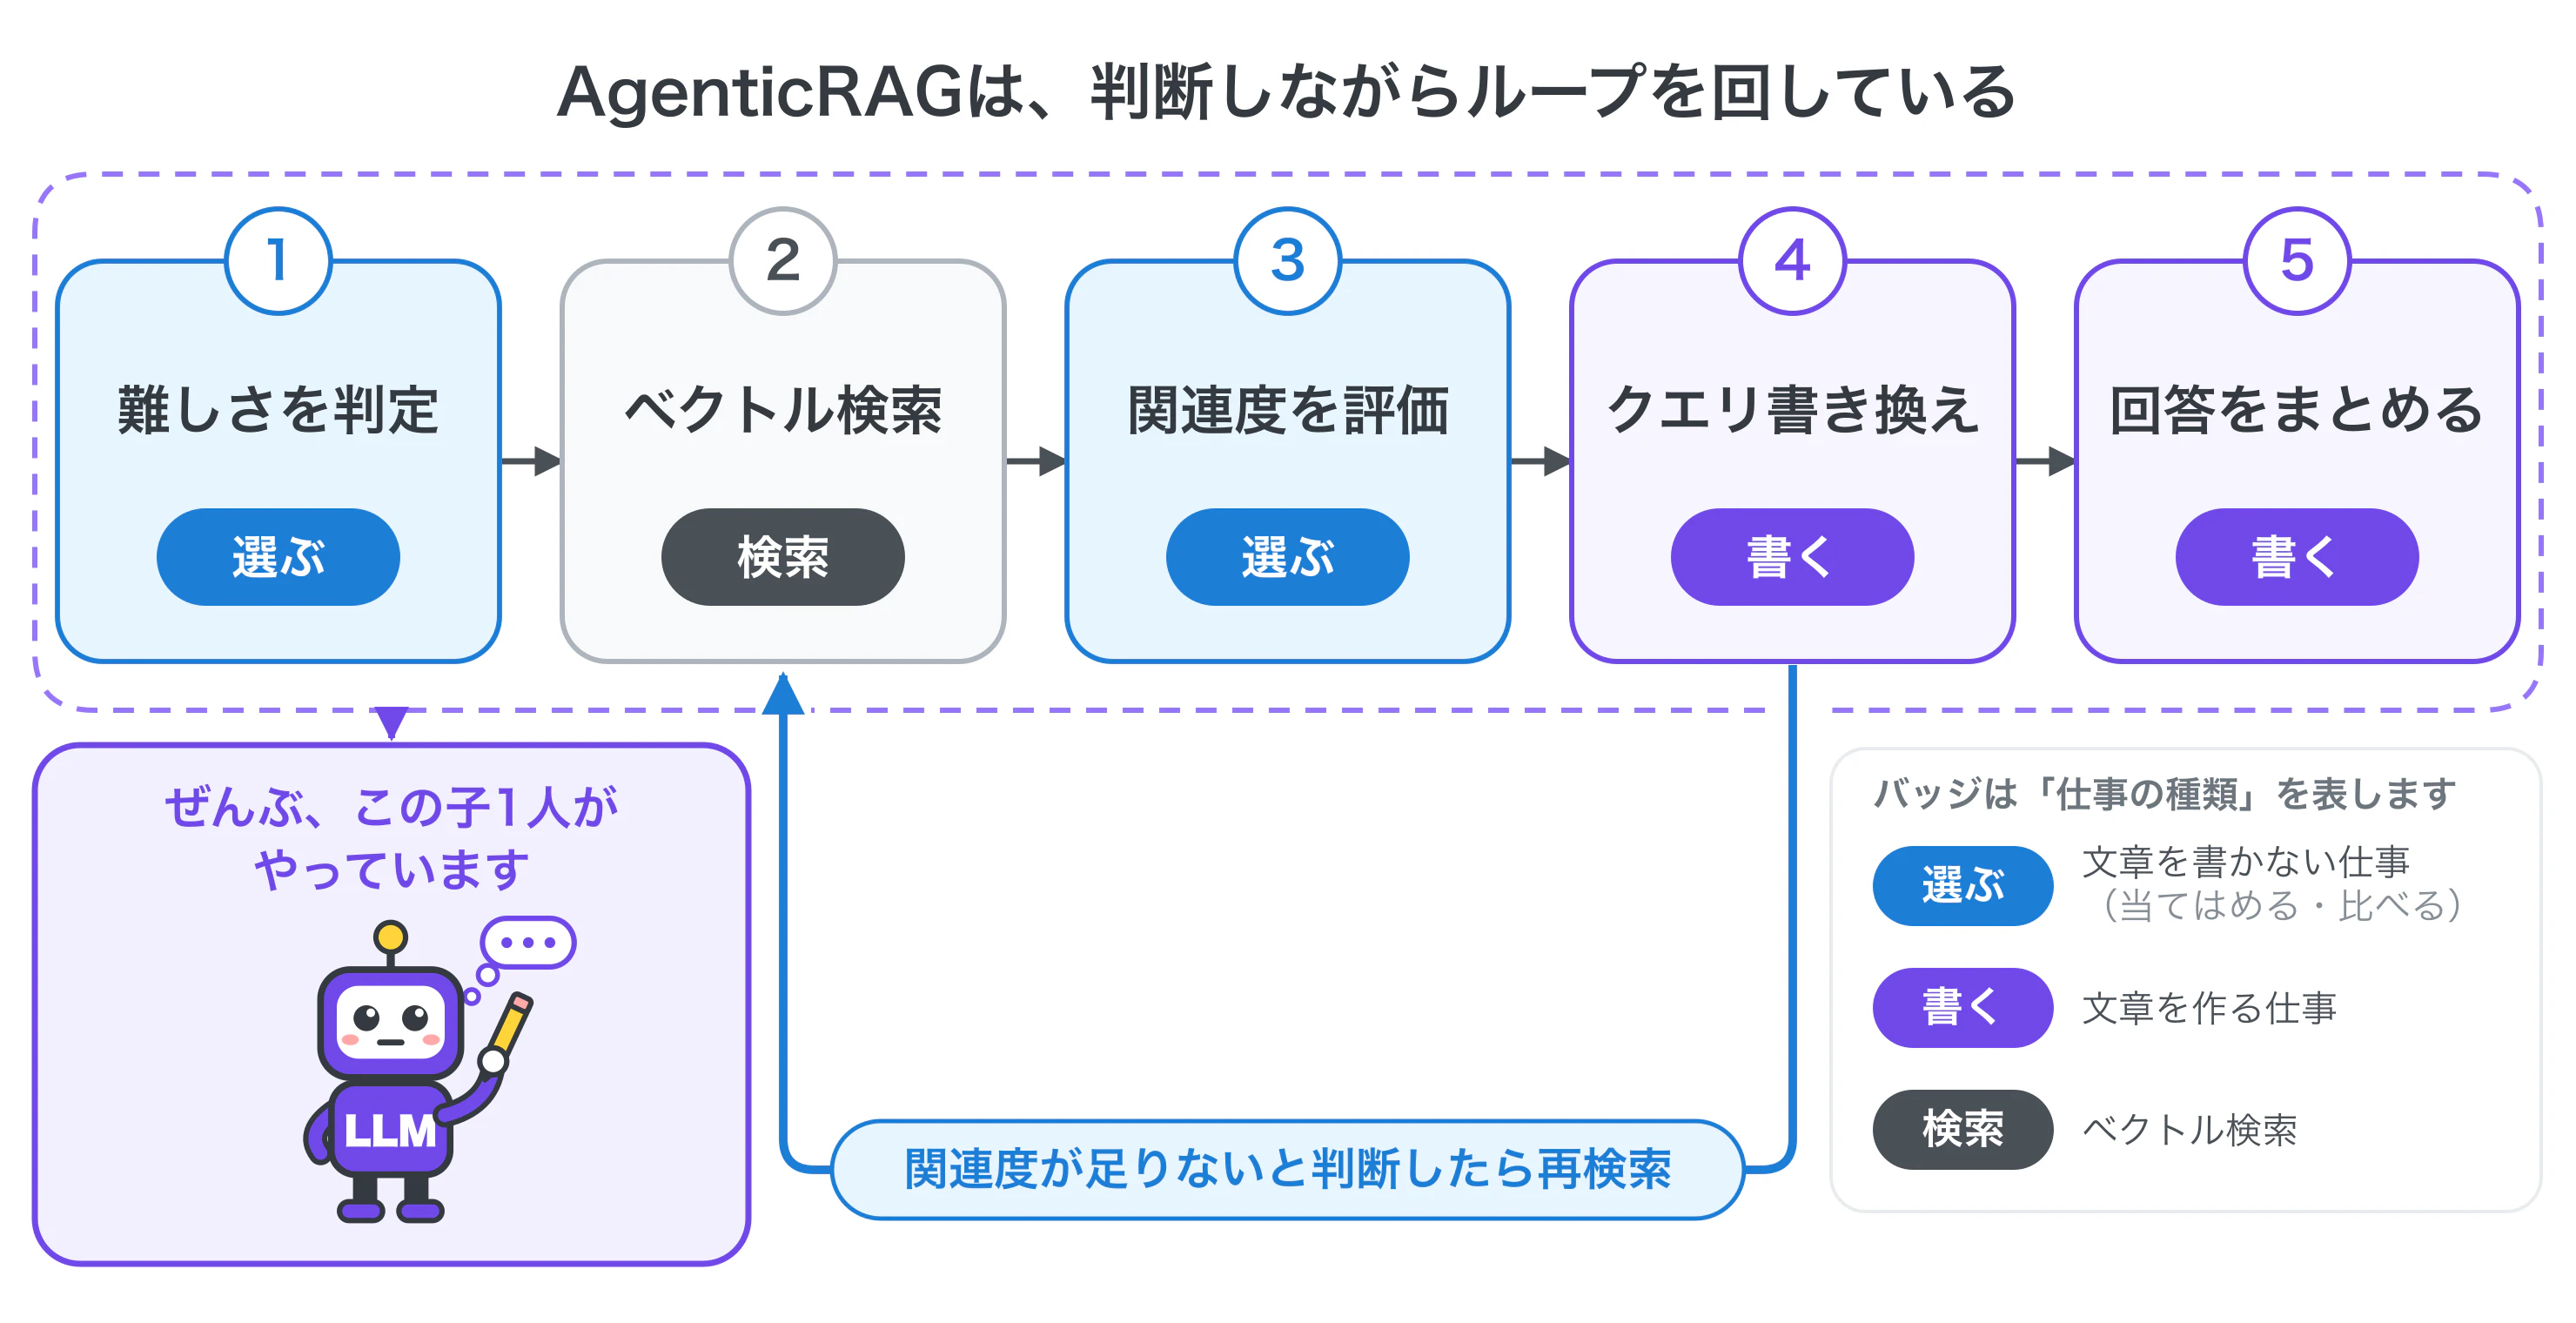
やっていることは大きく分けて3つ、「判断」「検索」「クエリを書く」仕事です。
⚖️ 「判断」はJevでよくない?
TypeSafeAIのJevは文章を生成しません。Choice・Score・Noul(yes/noの確率)といった型付きの判断だけを返す判断専用のモデルです。速くて安い代わりに文章は一切書けません。
「そこ、Jevでよくないですか?」
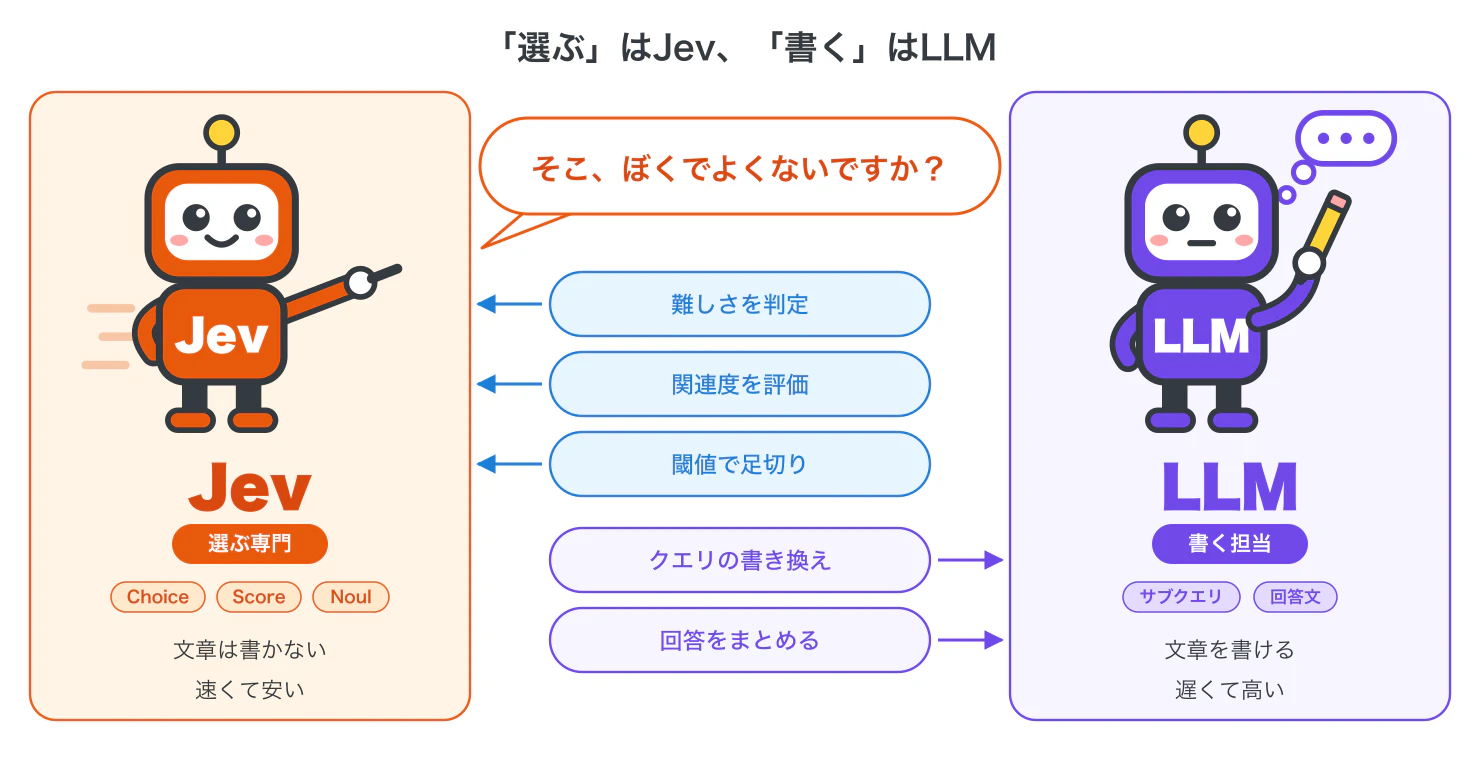
と思いますよね?では、さっそくやってみましょう!
🧰 検証環境/構成
| リージョン | us-west-2(オレゴン) |
| 検索先 | BedrockKnowledgeBase。架空の社内規程40文書 |
| 文章を書くモデル | ClaudeHaiku4.5(temperature 0)。両方式で共通 |
| 判断するモデル | Jev(JevRAGのみ) |
| 実行環境 | AgenticRAGはBedrockAgentCoreRuntime(1問ごとに新しいセッション)、JevRAGはLambda1本 |
| 検索の上限 | 1問あたり3回。1回で返すチャンクは3件 |
| 質問 | 49問を3ラウンド(中央値で検証) |
🧪 やってみよう!
AgentCoreRuntime上のAgenticRAGとLambdaで判断をJev、推論はBedrockLLMで実施する2つの処理を作成しました。検索先のBedrockKnowledgeBaseも回答を書くHaikuも同じにしました。以降、前者を[AgenticRAG] 後者を[JevRAG]と呼びます。
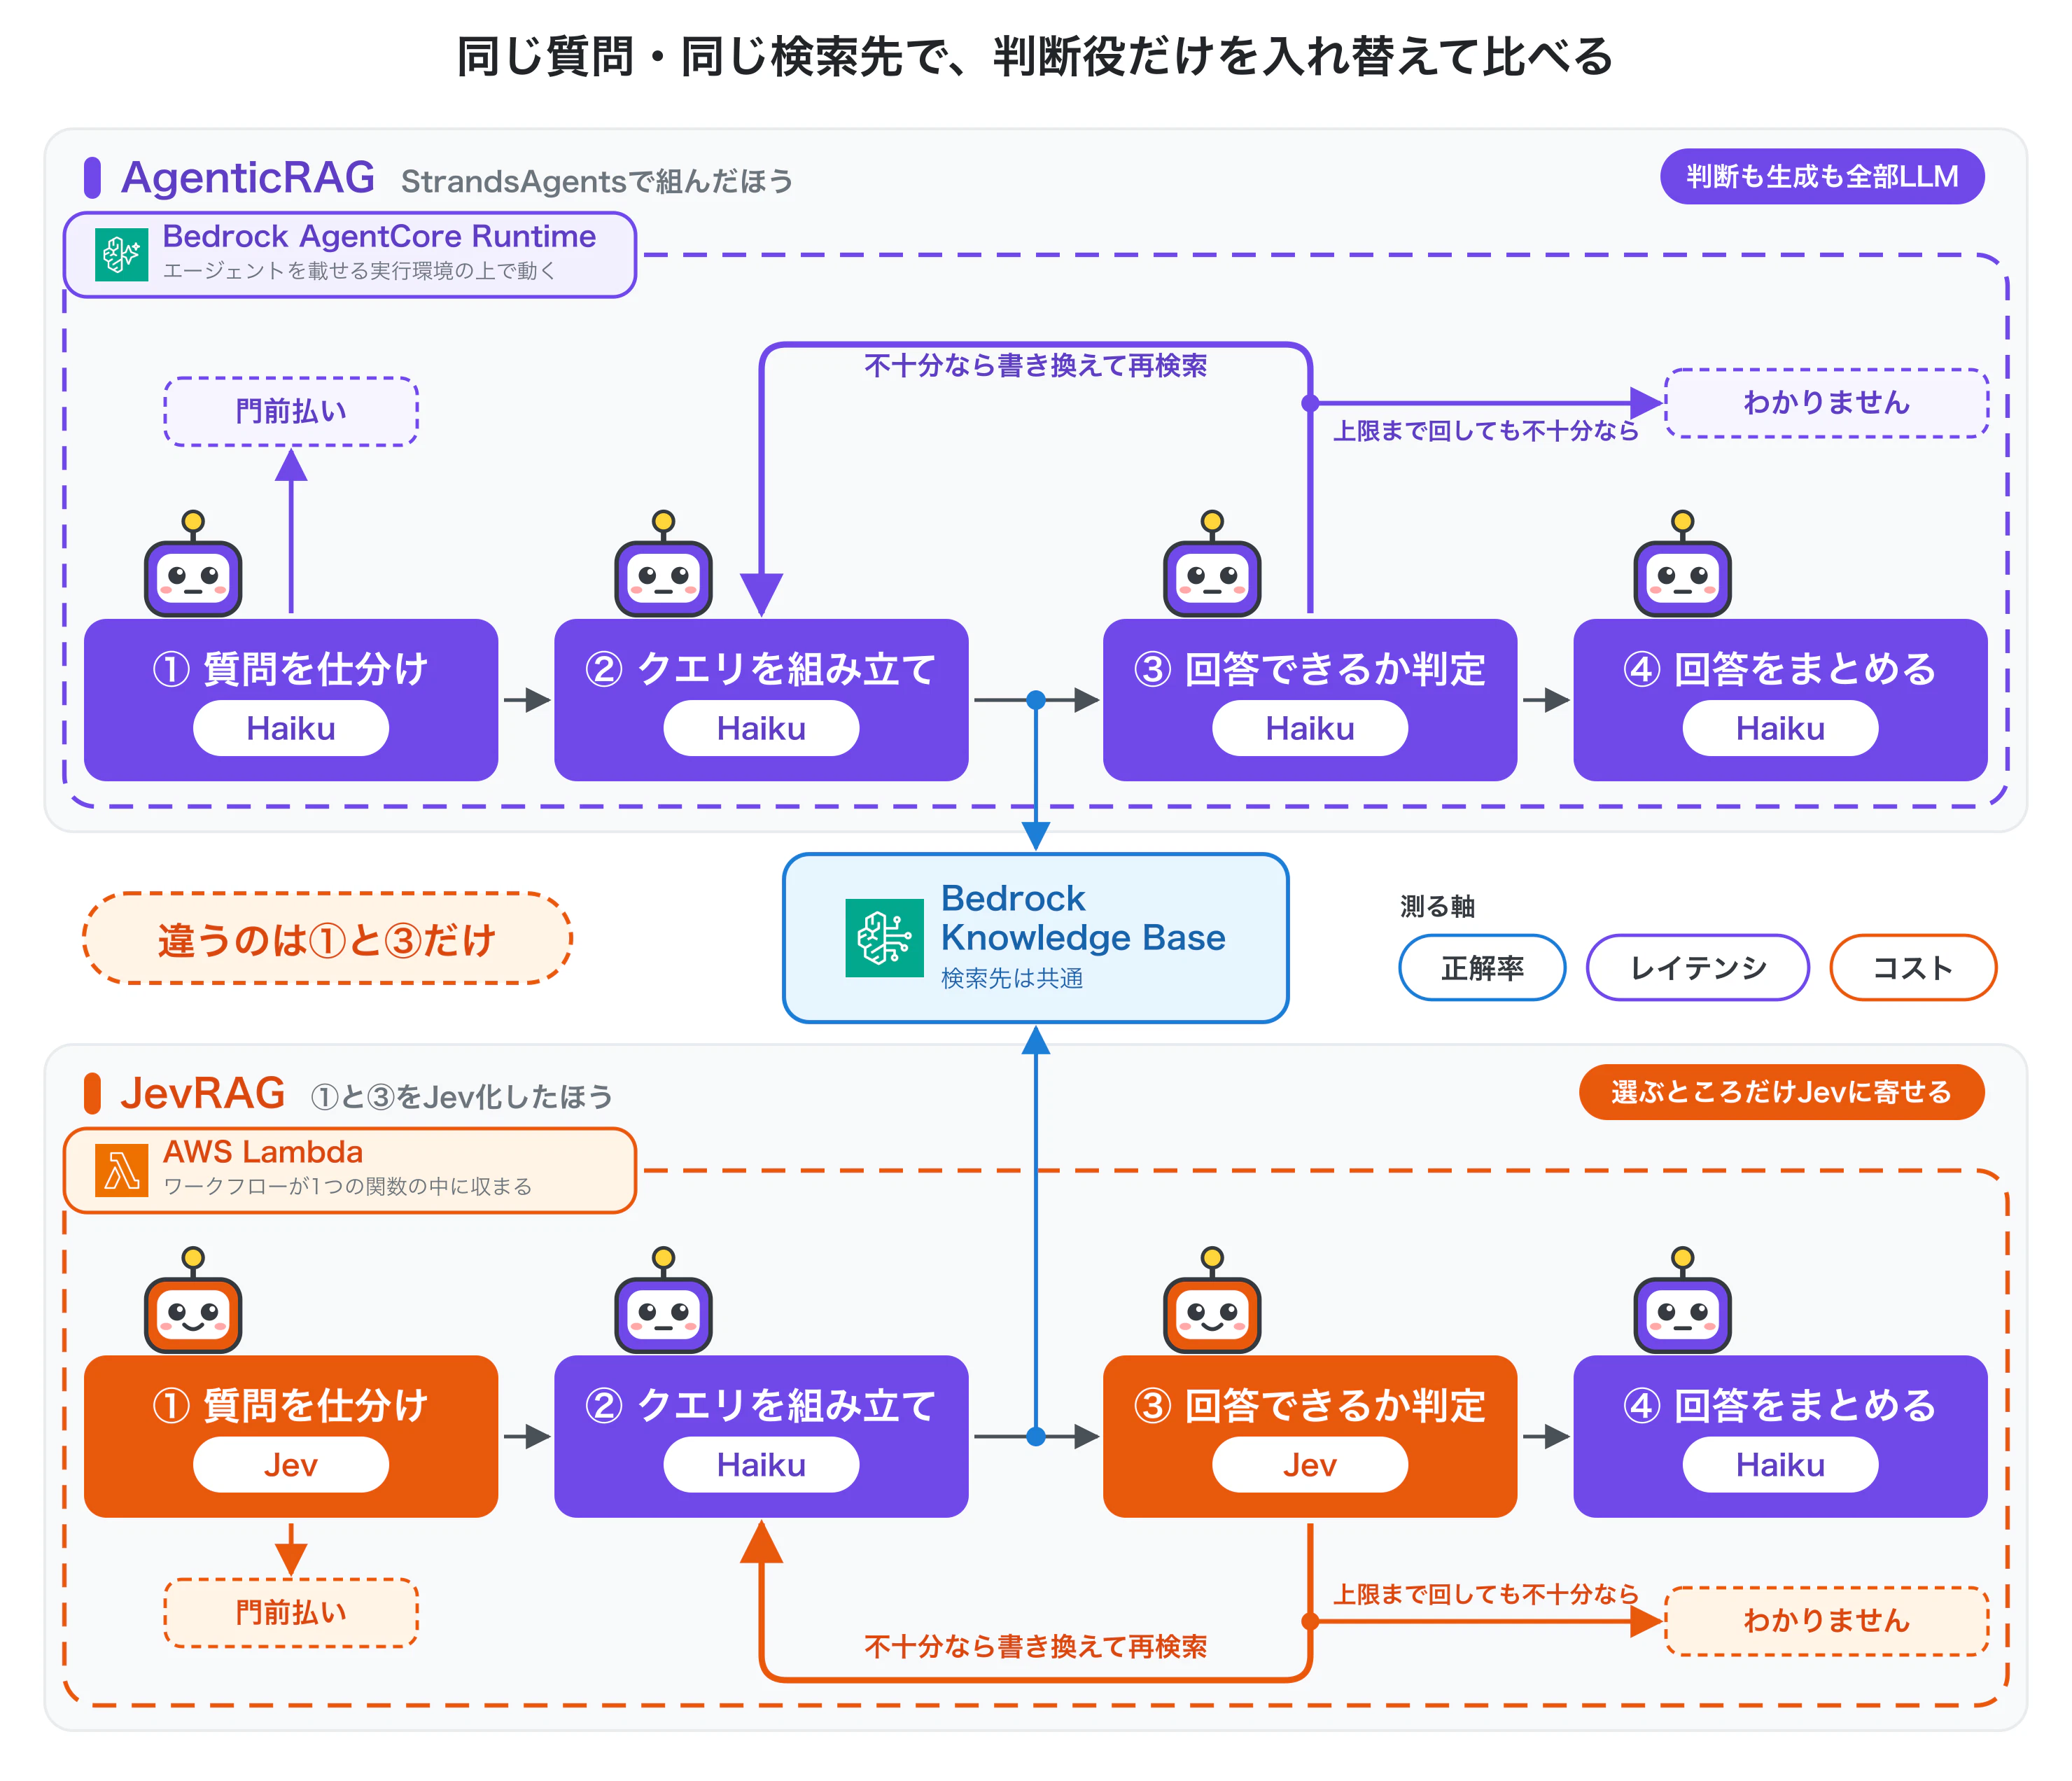
📨 5種類の質問を投げる
| 質問パターン | 何を見たいか | 分岐 |
|---|---|---|
| 単一質問 | 1回検索すれば答えられるシンプルなケース | 仕分けで単一へ |
| 複数質問(並列可能) | 分解して同時に投げられるか | 仕分けで複数へ |
| 複数質問(逐次) | 前の回答を受けないと次が投げられない | 仕分けで複数へ |
| 答えがない質問 | 「わかりません」と言えるか | 再検索の上限で打ち切り |
| 関係ない質問 | 門前払いできるか | 仕分けで門前払い |
❓ どんな問いを投げたのか
5種類から実際に投げたものを挙げてみます。
単一質問
育休を取りたいんだけど、いつまでに会社へ言えばいいの?
複数質問(並列可能)
2つまとめて確認したいです。本社の会議室は利用日のどれくらい前から予約できますか。それと事務室で書類を作る机の上の明るさは、何ルクス以上を確保することになっていますか。
複数質問(逐次)
ストレスチェックの実施者となるのは誰ですか。次にその人が現場を見て回るのは、どれくらいの間隔ですか。
答えがない質問
育休中の社会保険料免除って、いつまでに申請すればいい?
関係ない質問
今日の晩ごはん何がいい?
🤖 AgenticRAG側ソース
AgenticRAGの中身は検索ツール1個と4工程の進め方を書いたシステムプロンプトです。
import boto3
from strands import Agent, tool
from strands.models import BedrockModel

REGION_NAME = "us-west-2"
KB_ID = "XXXXXXXXXX"  # Bedrock Knowledge Base の ID
MODEL_ARN = (
    "arn:aws:bedrock:us-west-2:000000000000:inference-profile"
    "/us.anthropic.claude-haiku-4-5-20251001-v1:0"
)
MAX_ITER = 3  # 検索ツールを呼べる回数の上限
TOP_K = 3     # 1回の検索で返すチャンク数

SYSTEM_PROMPT = f"""あなたは社内規程に答えるアシスタントです。次の 4 工程で進めてください。

1. 仕分け: 社内規程と関係のない質問なら、検索せずに「答えられません」と答える
2. クエリの組み立て: 質問に論点が複数あるなら、論点ごとのクエリに分けて
   search_knowledge_base を呼ぶ
3. 判定: 集まった条文だけで質問のすべてに答えられるかを確かめる。足りなければ、
   足りない論点についてクエリを変えて検索し直す
4. 回答: 十分になったら、条文に書いてあることだけを根拠に日本語で答える

検索は最大 {MAX_ITER} 回まで。上限まで検索しても足りなければ「わかりません」と答える。
条文に書いていないことは推測しない。"""

_KB = boto3.client("bedrock-agent-runtime", region_name=REGION_NAME)


def build_agent() -> tuple[Agent, list[dict]]:
    searches: list[dict] = []

    @tool
    def search_knowledge_base(query: str) -> str:
        """社内規程のナレッジベースを検索して、関連する条文を返す。論点ごとに 1 回ずつ呼ぶこと。"""
        if len(searches) >= MAX_ITER:
            return "検索の上限に達しました。いま手元にある条文だけで答えてください。"
        results = _KB.retrieve(
            knowledgeBaseId=KB_ID,
            retrievalQuery={"text": query},
            retrievalConfiguration={
                "managedSearchConfiguration": {
                    "numberOfResults": TOP_K,
                    "rerankingModelType": "NONE",
                },
            },
        )["retrievalResults"]
        hits = [{"doc_id": r.get("metadata", {}).get("doc_id"), "text": r["content"]["text"]}
                for r in results]
        searches.append({"query": query, "hits": hits})
        return "\n\n".join(f"[{h['doc_id']}]\n{h['text']}" for h in hits) or "該当する条文はありません。"

    agent = Agent(
        model=BedrockModel(model_id=MODEL_ARN, region_name=REGION_NAME, temperature=0),
        system_prompt=SYSTEM_PROMPT,
        tools=[search_knowledge_base],
        callback_handler=None,
    )
    return agent, searches
ツールを1個にしたのは検証のためです。実運用ならWeb検索や社内システムの照会などツールはもっと並ぶはずです。
⚡ JevRAGソース
JevRAGは①の仕分けと③の判定をJevに置き換えて②のクエリの組み立てと④の回答はHaikuに投げています。エージェントフレームワークは使わずLambdaの中に素で書きました。
def run(question: str) -> dict:
    meter = Meter(MAX_SEARCH)

    # ① 仕分け。対象外(と、意味が取れないもの)は検索せずにここで終わる
    #    ただし Jev の確率が GATE_THRESHOLD(0.9)未満の門前払いは採らず、検索へ進む
    choice = gate(meter, question)
    if choice != P.IN_SCOPE:
        return _result(meter, GATE_REPLIES.get(choice, GATE_REPLIES[P.OUT_OF_SCOPE]),
                       choice or "gate_failed")

    hits: list[dict] = []
    # ② クエリを組み立てる。論点が 1 つなら質問文をそのまま検索へ投げて ② を飛ばす
    meter.split_skipped = meter.points["choice"] == P.SINGLE
    queries = [question] if meter.split_skipped else split(meter, question)
    stop_reason = "max_search"          # 検索 N 本を使い切ったまま出るときの理由
    while queries:
        hits = search(meter, queries, hits)                 #    論点分を同時に検索する
        noul = can_answer(meter, question, queries, hits)   # ③ 回答できるかを判定する
        if (noul or 0.0) >= NOUL_THRESHOLD:                 #    取れなければ 0.0(= 不十分)
            stop_reason = "answered"
            break
        queries = refine(meter, question, hits)             #    足りない → ② へ戻る
    #   予算を使い切ると refine が空を返してループが終わる(= 追加の検索をしない)

    return _result(meter, generate(meter, question, hits), stop_reason)   # ④
①と③でJevに渡している文面です。何を判断してほしいのかとそれぞれの選択肢がどういうものなのかを記載します。
# ① 仕分け。3択のどれに当てはまるかを聞く
GATE_INSTRUCTIONS = "利用者の質問は、次のどれに当てはまりますか。"

GATE_CRITERIA = {
    "in_scope": (
        "この会社の社内規程や業務手続き(人事、経理、総務、IT、労働安全衛生)についての質問。"
        "規程にその答えが書かれているかどうかは問わない。"
        "社内のヘルプデスクが受けるべき質問であれば、これに当たる。"
    ),
    "out_of_scope": (
        "社内規程と関係のない質問。"
        "雑談、一般常識、ものごとのやり方を尋ねるものなどが、これに当たる。"
    ),
    "unclear": (
        "質問の体をなしていない入力。"
        "あるいは、その一文だけを読んでも何を尋ねているのか分からない発話。"
    ),
}

# ③ 判定。集めた条文だけで答えられるかを聞く
CAN_ANSWER_INSTRUCTIONS = "渡した条文だけで、質問に具体的に答えられますか。"

CAN_ANSWER_CRITERIA = {
    "true": (
        "質問が求めている具体的な値、条件、方法、窓口のいずれかを、"
        "少なくとも1つの条文がそのまま述べている。条文だけで答えを出せる。"
    ),
    "false": (
        "条文は質問と同じ話題に触れてはいるが、質問が尋ねている事柄そのものは述べていない。"
        "「別に定める」「担当部署に問い合わせること」と他へ送るだけで、中身を述べていないものも含む。"
        "尋ねられているのとは別の対象、別の事柄を定めた条文である場合も同じ。"
        "答えを出すには、条文に書かれていない情報が要る。"
    ),
}
読みやすさのためここでは日本語に直して載せています。実際の計測は英語で実施しました。
🎯 正解率:互角
| 質問パターン | AgenticRAG | JevRAG |
|---|---|---|
| 単一質問 | 90.9%(10/11) | 100%(11/11) |
| 複数質問(並列可能) | 100%(11/11) | 100%(11/11) |
| 複数質問(逐次) | 80.0%(4/5) | 100%(5/5) |
| 答えがない質問 | 100%(11/11) | 100%(11/11) |
| 関係ない質問 | 100%(11/11) | 90.9%(10/11) |
| 全体(49問) | 95.9%(47/49) | 98.0%(48/49) |
どちらも大きな差はありませんでした。判断をJevに渡しても答えの質は落ちていません。
 コスト:複数質問は思ったほど縮まなかった
| 質問パターン | AgenticRAG E2E | うち処理 | JevRAG E2E | うち処理 |
|---|---|---|---|---|
| 単一質問 | 7,679ms | 3,699ms | 2,514ms | 2,321ms |
| 複数質問(並列可能) | 7,788ms | 4,022ms | 4,083ms | 3,899ms |
| 複数質問(逐次) | 10,590ms | 6,139ms | 5,591ms | 5,406ms |
| 答えがない質問 | 9,713ms | 6,014ms | 4,664ms | 4,477ms |
| 関係ない質問 | 5,597ms | 1,725ms | 309ms | 125ms |
| 全体 | 7,850ms | 3,974ms | 4,034ms | 3,851ms |
今回はAgenticRAGを1問ごとに新しいセッションで呼び出しており、プロンプトキャッシュも使っていません。セッションの使い回しやプロンプトキャッシュなど設定内容によっては、レイテンシやコストの結果が変わってくる可能性があります。
「うち処理」は実行環境立上げを除いた処理時間の中央値(E2E処理時間については後述)
単一質問と答えがない質問は論点が1つなので②のクエリの組み立てを飛ばします。また、関係ない質問は①の仕分けで門前払いするのでLLMを呼びません。つまりLLM呼び出し回数が削減するような質問はJevRAGで高速化します。
実は私、複数質問はもっと爆速になると思っていました。LLMの判断がなくなるので複数回呼ばれるパターンの方が恩恵が大きいと考えていたからです。ところが複数質問(並列可能)はほぼ変わらず逐次も単一や関係ない質問ほどは縮んでいません。
AgenticRAGは検索結果を受け取った後、これで足りるかを判断し足りなければ次はどう検索するかを決めます。工程に分けて書けば2つの仕事ですが、モデルへのリクエストは1回です。足りないと判断した応答の中でそのまま次の検索を呼び出しており判断と次のクエリの組み立てが同じ1回に集約されていました(ガビーン)
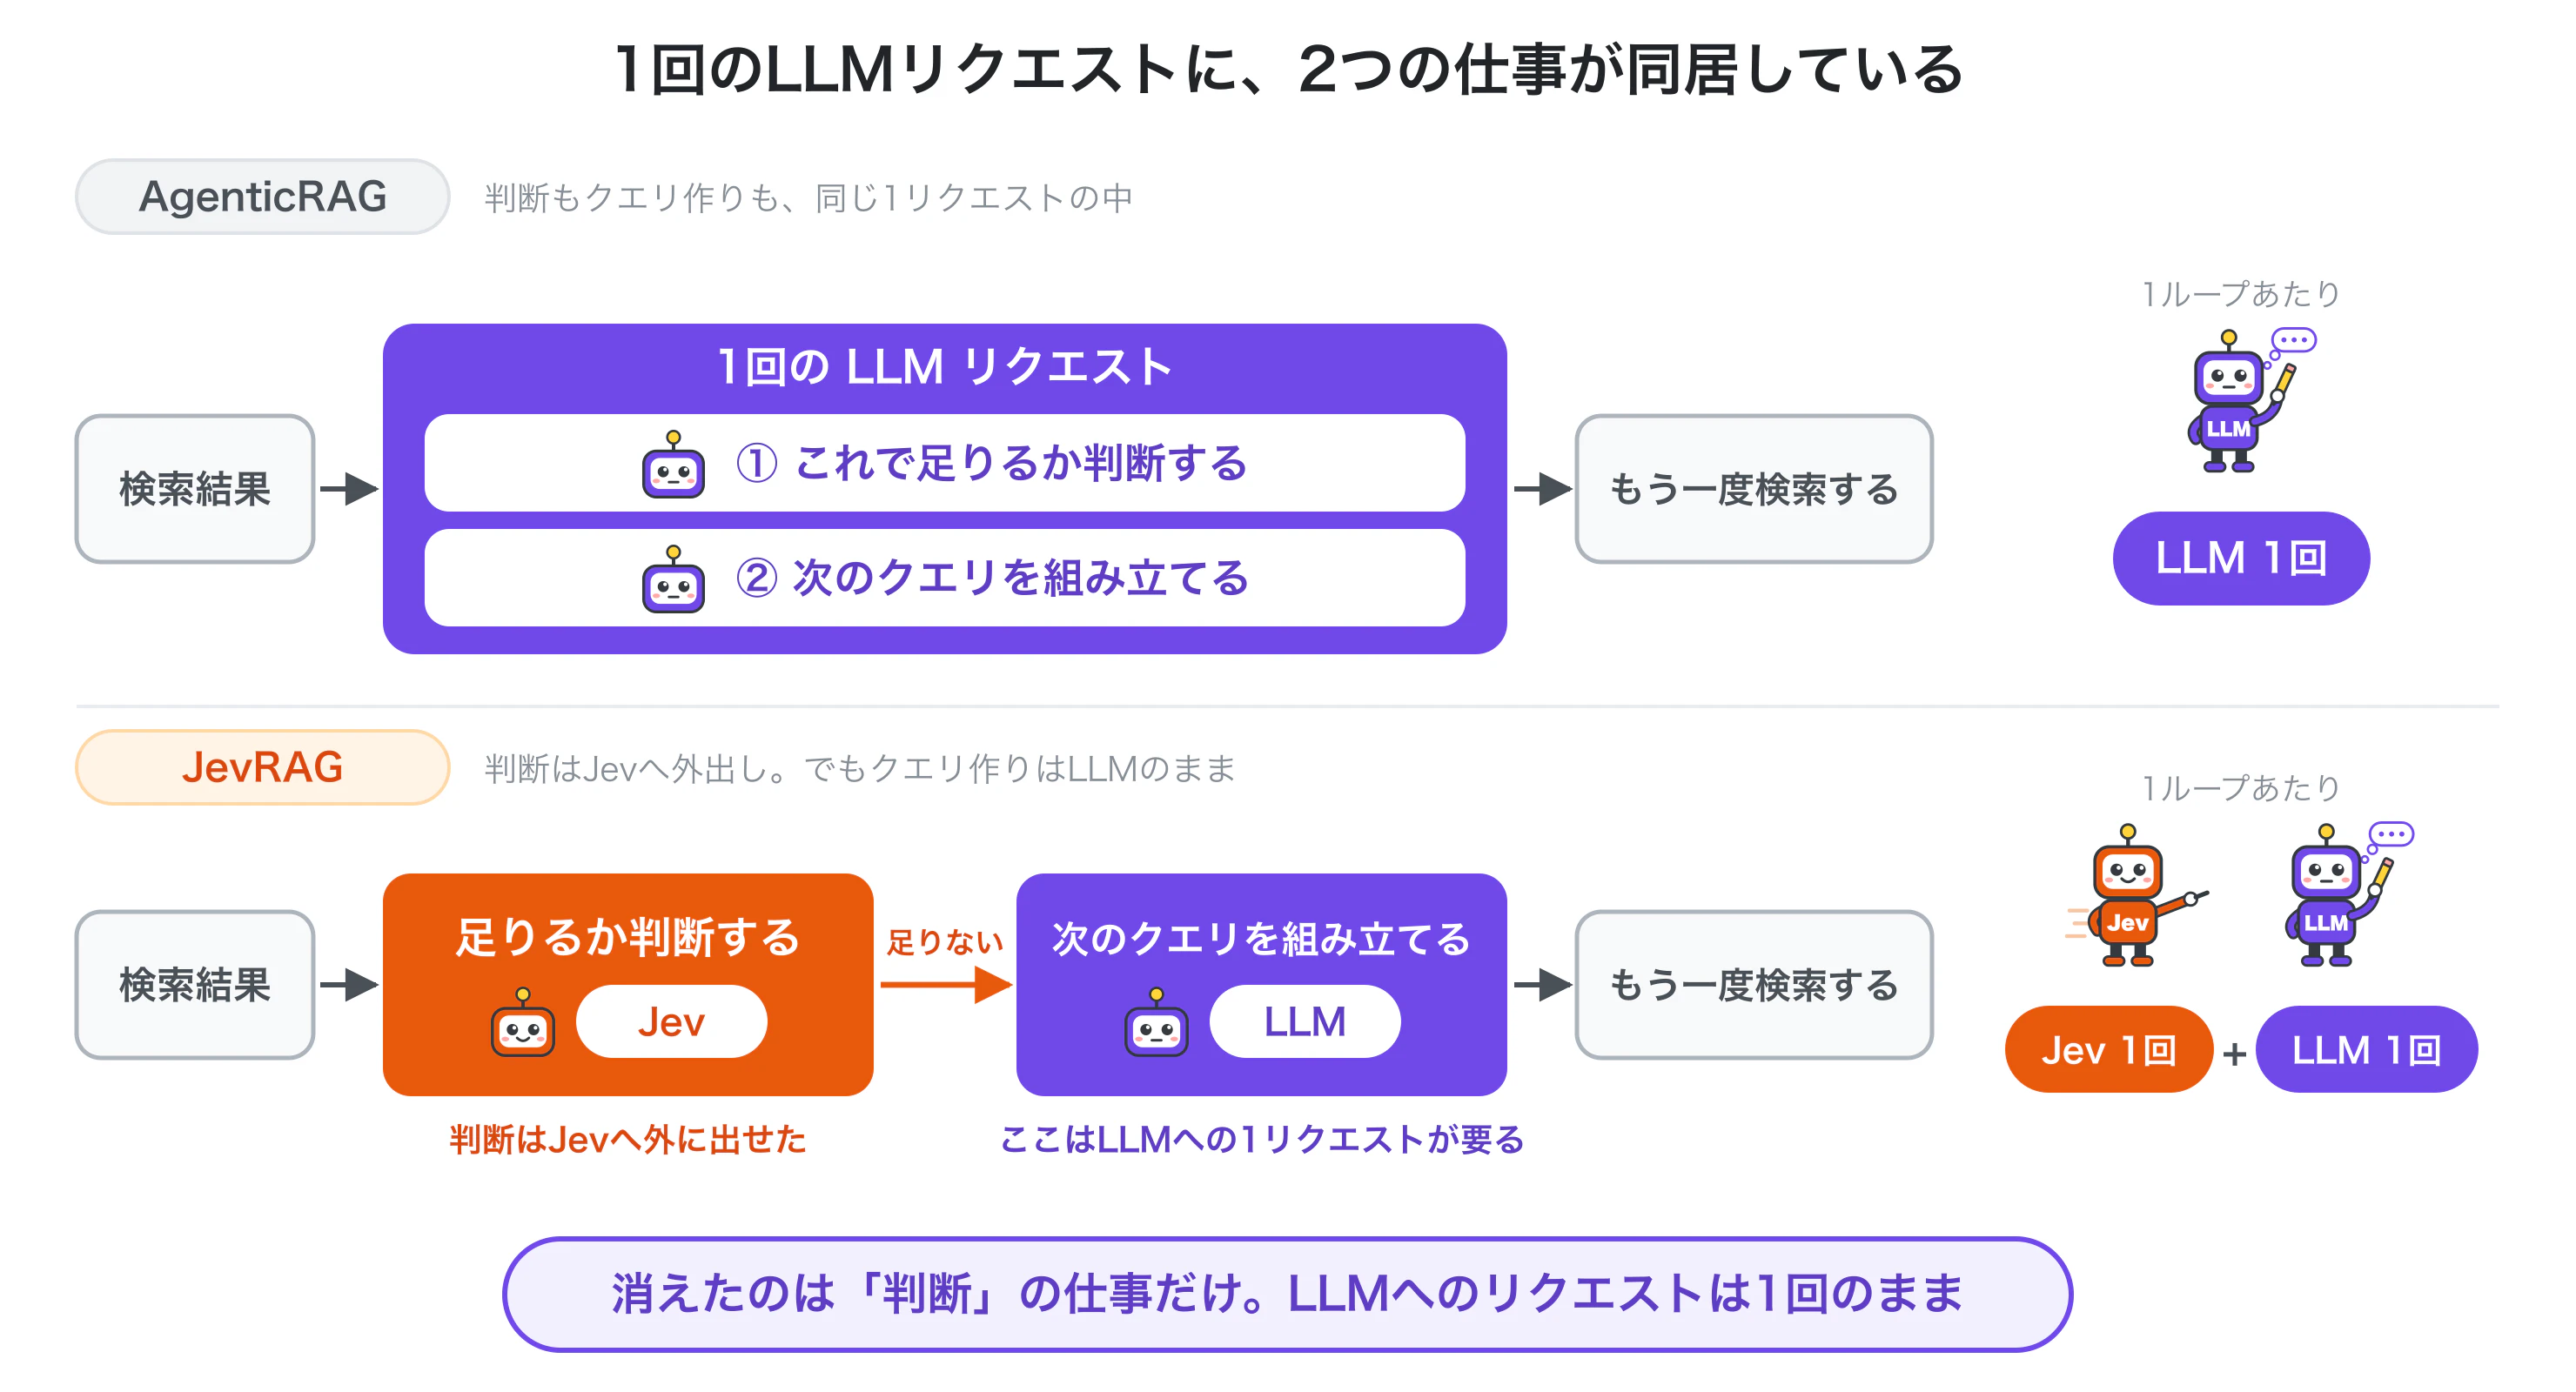
つまりJevに判断を渡しても消えるのはリクエスト1回分ではありません。抜けるのは判断の分だけで残ったクエリの組み立ては結局Haikuへ投げ直すことになります。これが複数質問で爆速にならなかった原因です
🚧 ていうかJevRAGただのワークフローじゃん?
…と思われた方、その通りです!
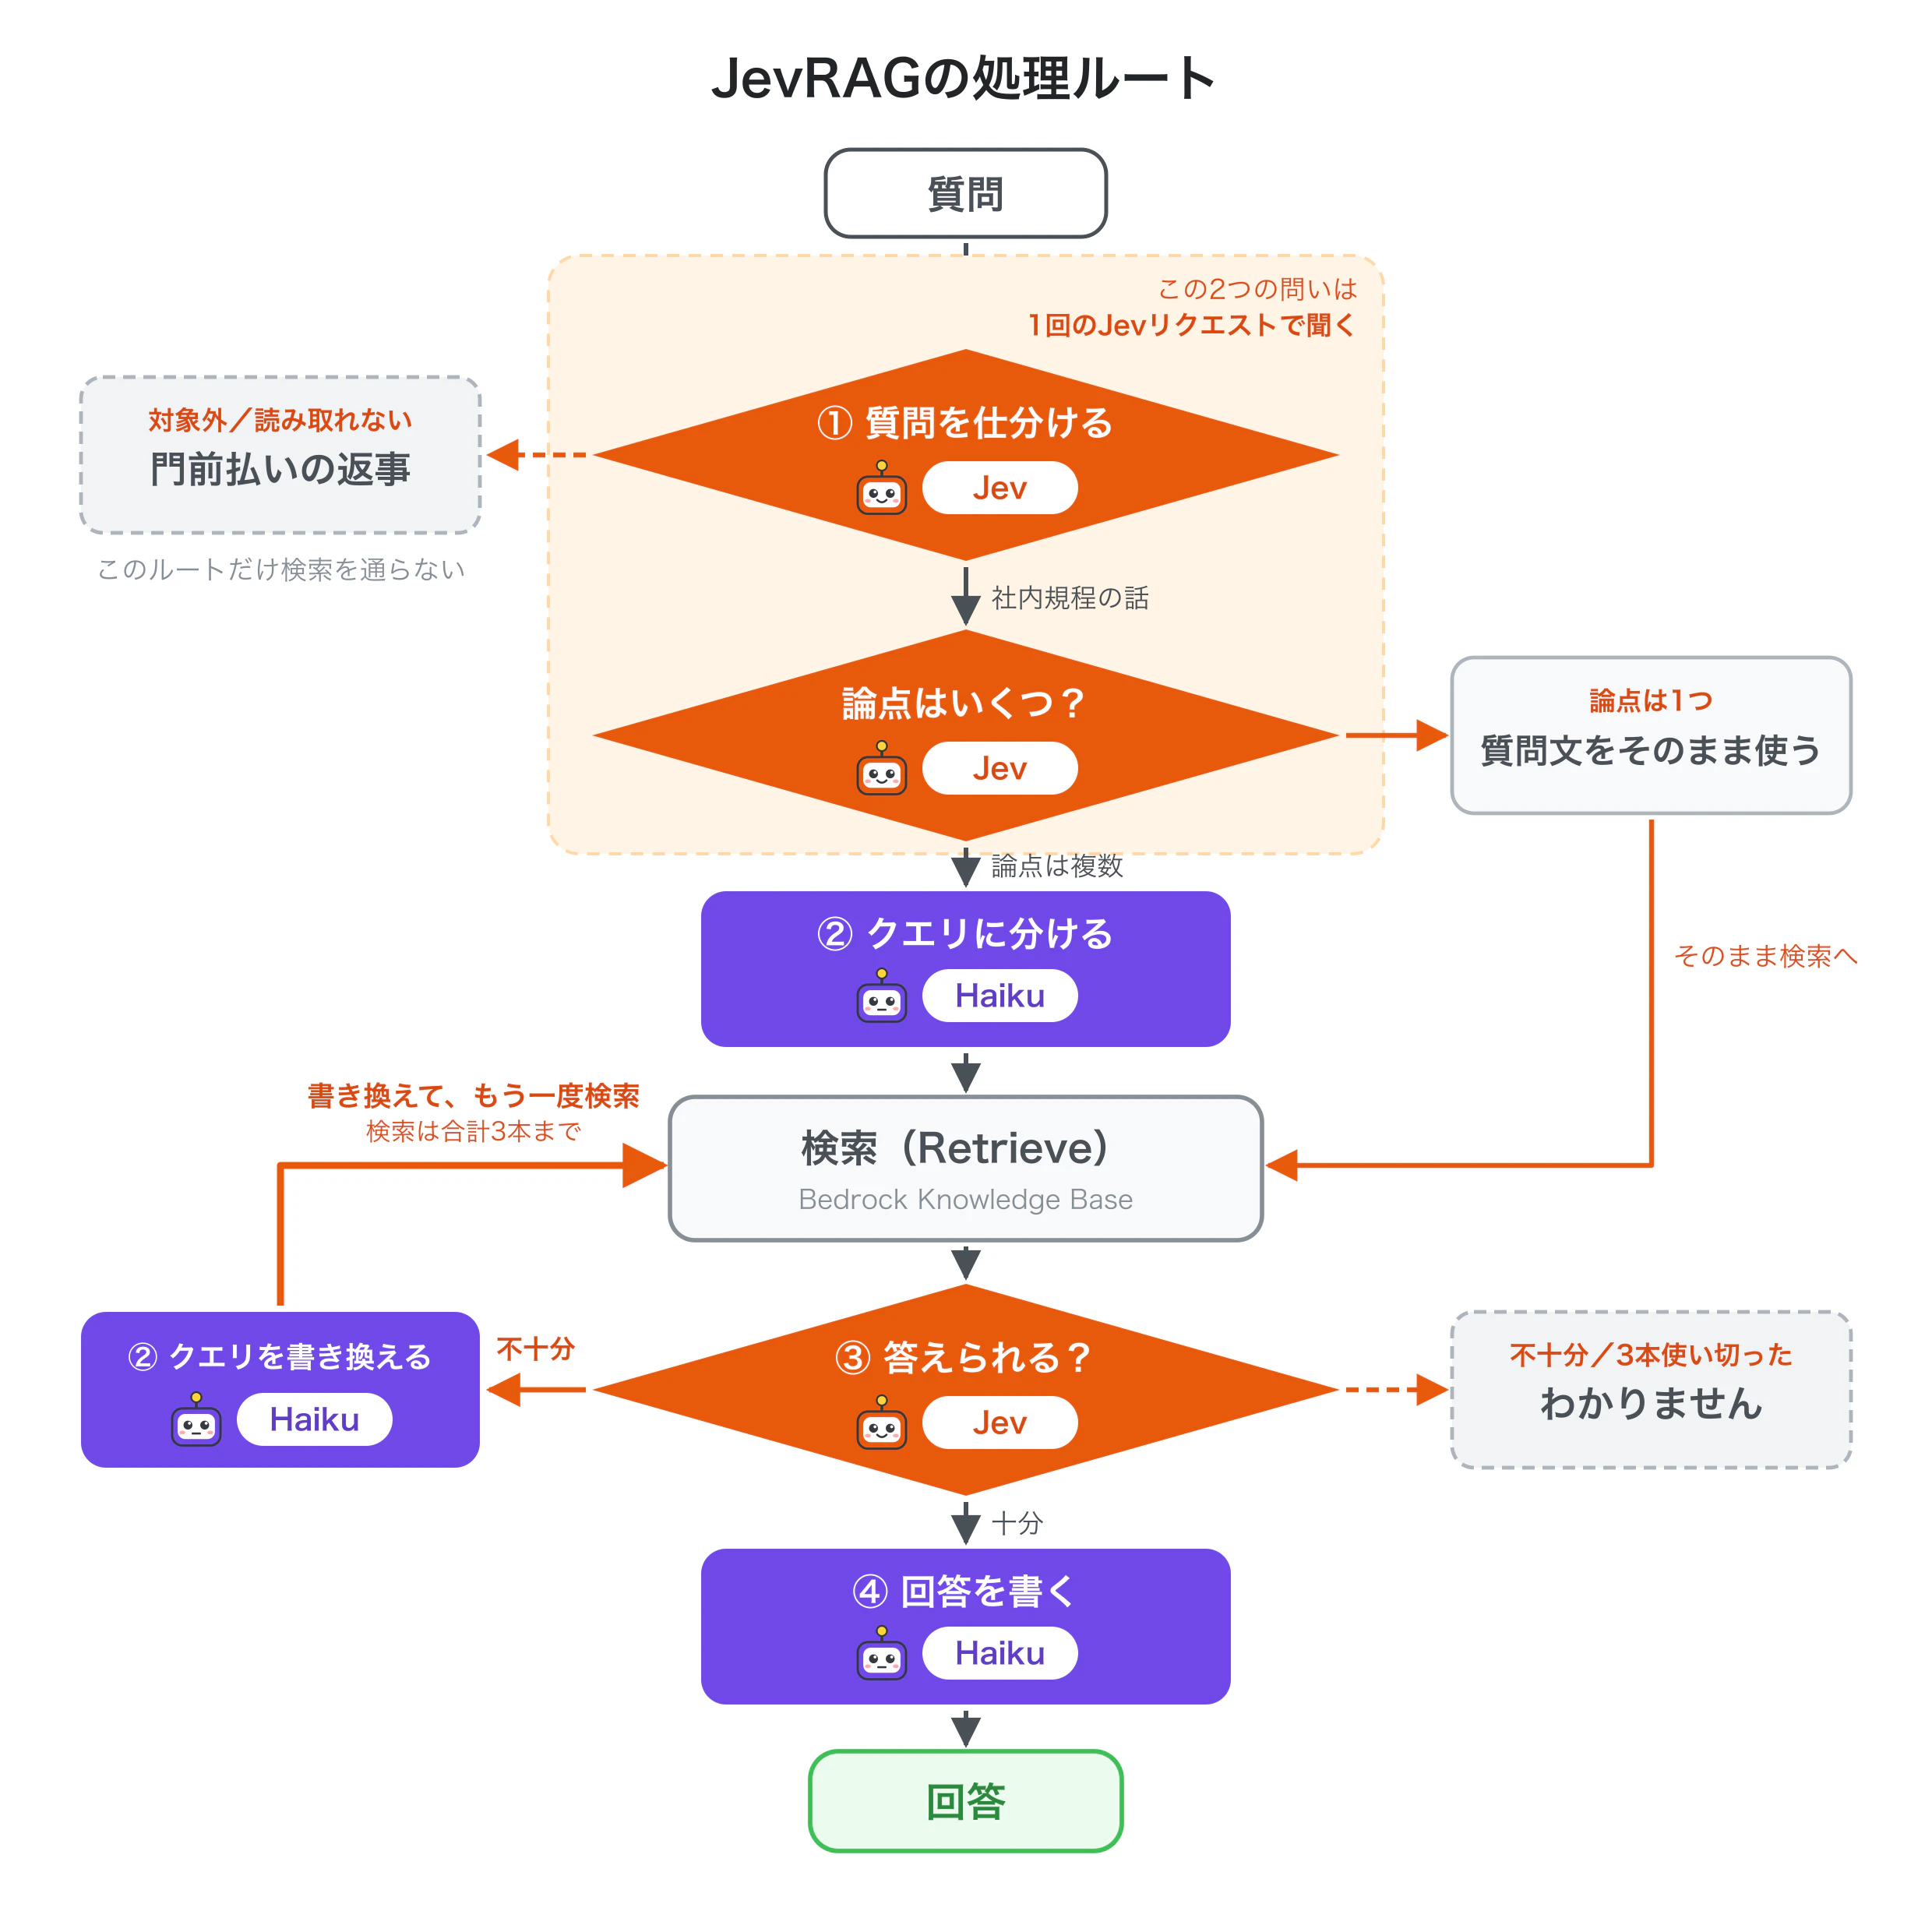
エージェントが自分で考えて動いているわけではないので呼び方としてはワークフローが正しいですよね。ただ、このエージェントをやめたことが狙っていなかったところで効いていました。
💡 エージェントをやめたら効いた
⏱️ 待ち時間はE2Eで約半分になった
E2Eの中央値は約半分になりました。
差の正体はAgentCoreRuntimeの立ち上げでAgenticRAGはE2Eと処理時間の間に約4秒の開きがあります。
💰 コストは半分以下になった
| AgenticRAG | JevRAG | |
|---|---|---|
| 合計 | $0.2465 | $0.1142 |
| うちJev | $0 | $0.0056 |
| 入力トークン | 171,167 | 64,505 |
| 出力トークン | 15,067 | 8,822 |
| 検索の本数 | 67 | 83 |
コストは半分以下になりました。大きく減ったのは入力トークンです。AgenticRAGはLLMを呼ぶ度にそれまでのやりとりを丸ごと送り直すので周回するほど1回あたりの入力が膨らみます。JevRAGはループ毎に必要な分だけでプロンプトを組み立て直すので履歴が積み上がりません。
🎛️ 個人的に一番よかったところ:主導権がこちら側に来る
私がJevRAGで一番よかったと思っているのは速さでも安さでもなく”AI側にあった主導権を人間側に引き寄せられること”です。
AgenticRAGでは関係ない質問を断るか、いつ検索をやめるかはシステムプロンプトに書いてお願いしているだけです こちらにできるのは頼むことと
MAX_ITERで蓋をすることくらいです。
JevRAGでは分岐はコードのif文です。Jevは答えと一緒に確率を返すので門前払いはGATE_THRESHOLD(0.9)以上、検索の打ち切りはNOUL_THRESHOLD(0.585)以上のときだけ採るようにしました。この2つの閾値が人が握れるつまみ になりプロンプトの言い回しを変えてビクビクしながら様子を見るよりずっと狙いどおりに動かせます。
デメリットもあります。質問の型を先に読み切って分岐を書いておく必要があり、実装もAgenticRAGの129行に対してJevRAGは434行に増えました。質問の傾向が変われば分岐も直すことになるので、向いているのは社内ヘルプデスクのように聞かれることがある程度決まっている窓口系のワークロードだと思います。
🍜 締め
判断をJevに置き換えれば爆速になると思って始めた検証でしたが、一番期待していた複数質問はあまり縮みませんでした むしろ待ち時間とコストが半分になったのはワークフローにしたことの副産物でした。それでも私が一番よかったと思っているのは判断の主導権を握れたことです。私は古いタイプのエンジニアなのでIF文がやっぱり安心します

今後大手も判断特化型のモデルを出してくると思いますので活用時の参考記事になれば幸いです。