
この記事はAWSにおけるマルチテナントシステムを作っている人(これから作る人)向けの記事です。また「ノイジーネイバーってなに?美味しいの?」という人にもおすすめの記事となっております。
📢 ノイジーネイバー(Noisy Neighbor)とは
1つのシステムを複数の顧客(テナント)で共有していると、困ったことがちょいちょい起きます。特定のテナントが派手に使っただけで関係ない別のテナントまで遅くなったりエラーになったりするやつです。これをノイジーネイバー(うるさい隣人)問題と呼びます。
ノイジーネイバーの被害は全体に及びます。しかもテナントごとに計測していないと「なんか遅い...?」という感覚症状はあるものの明確な原因に行き着くことがなかなか困難という特徴もあります。
ノイジーネイバーと一口に言っても詰まる場所も対策もけっこう違います。この記事ではマンションの迷惑住人に例えて6つのパターンに分けて、それぞれの特徴と対策を紹介してみます。
🏠 一戸建てとマンション
一戸建てはシングルテナントです。いわゆるサイロ型で土地も回線もゴミ置き場もぜーんぶ自分専用です。隣の家が何をしていようと関係ありません。快適ですがその分家賃は高いという特徴があります
マンションはマルチテナントです。家賃が安い代わりにエレベーターや廊下や宅配ボックスといった共用部をみんなで分け合います。自分の部屋にいる分には何も起きません。トラブルが起きるのはいつも共用部です
🏢 クラウド荘へようこそ
舞台は6階建てのマンション「クラウド荘」です。共用部を食い潰す迷惑住人が6世帯も住んでいます。

では一人ずつのぞいてみましょう
📶 回線占有くん(スループット型)

症状
1つのテナントのクライアントがAPIを大量に叩き続けてAPIGatewayのスロットル枠やLambdaの同時実行数を使い切ります。1テナントで食い潰せば他のテナントの枠はもうありません。巻き添えになった側は429(Too Many Requests)を返されたりLambdaがスロットルされて処理が落ちたりします。
類似事象
ALBの後ろのECSやEC2でも同じことが起きます。1テナントの大量リクエストがCPUを使い切って全テナントのレスポンスが遅くなったりします。
対策
APIGatewayの使用量プランでAPIキー(テナント)毎にレートとバーストを決めておくのが基本となります。テナントを識別できるヘッダーやキーがあるならWAFのレートベースルールで抑止することが可能です。Lambdaの予約済み同時実行数は関数単位の上限なのでテナントの分離には使えません。同じ関数を使う他のテナントも一緒にスロットルされちゃいます。
🗑️ 粗大ゴミおじさん(単発重量型)

症状
RDSに1つのテナントが重い集計クエリを1発投げて全件スキャンとか巨大なJOINとか月次レポートとかやっちゃうやつです。CPUとIOPSをしばらく独り占めするので他のテナントは軽いCRUDのクエリまで待たされてAPI全体のレイテンシが跳ね上がります。回線占有くんと違って回数では見つかりません。DatabaseInsightsでクエリ単位のコストを見て初めて「お前かーーっ!」となります。
類似事象
OpenSearchでも同じことが起きます。1テナントの重い集計クエリ(巨大なaggregationやワイルドカード検索)が共有クラスターのCPUとJVMヒープを独占して他テナントの軽い検索まで遅くなったりサーキットブレーカーで落とされたりします。
対策
重い処理は本番の書き込み系から切り離すことで対策します。集計やレポートはリードレプリカに逃がすかAthenaやRedshiftのような分析向けの基盤に流します。DBエンジンのクエリタイムアウト(PostgreSQLならstatement_timeout)を設定しておいて想定外に重いクエリは途中で止めるのも良いです。
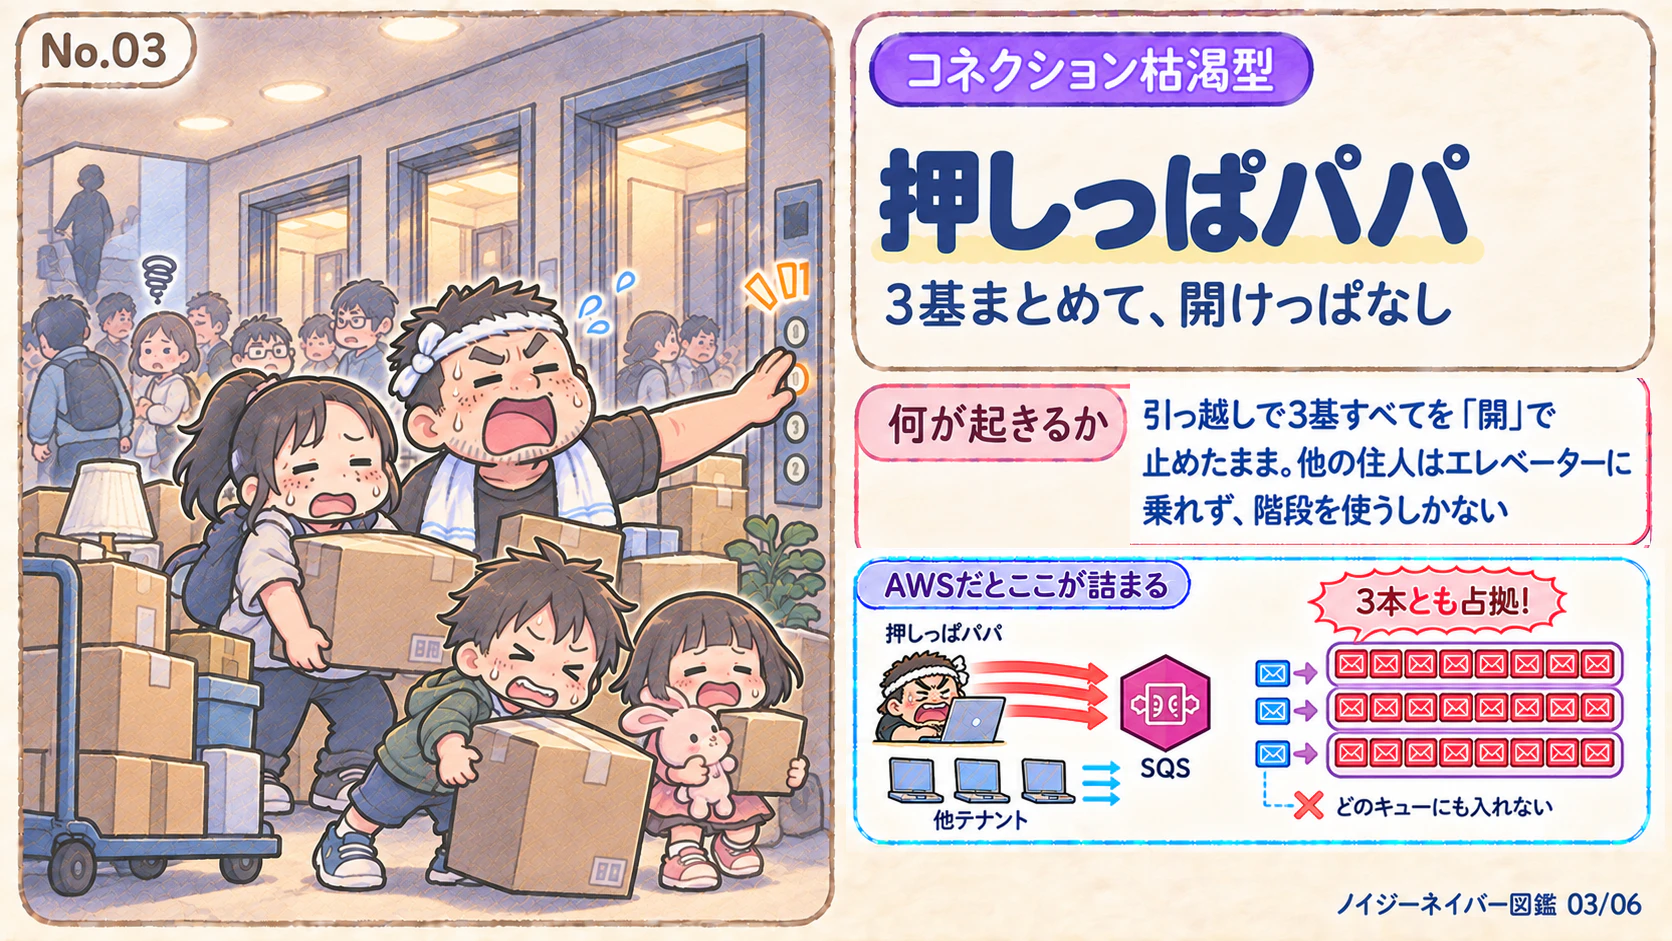
🛗 押しっぱパパ(コネクション枯渇型)
症状
SQSのキューに1つのテナントが大量のメッセージを一気に投入してワーカーの処理枠を占拠します。キューを複数本に分けていても埋まれば同じことです。他のテナントのメッセージは後ろに並んだまま処理されません。通知が届かないとかバッチが終わらないとかいう形で遅延が何時間にも伸びます。帯域やCPUのグラフを見ても何も出ないのがいやらしいところでキューの滞留時間をテナント別に見ないと気づけません。
類似事象
RDSの接続数でも同じことが起きます。1テナントのアプリがmax_connectionsを掴んで返さず他のテナントがtoo many connectionsで接続できなくなります。
対策
テナント別の公平性とタイムアウトを入れます。キューをテナントごとに分ける手もありますがテナント数が多いと正直つらいです。ここはSQSのフェアキューを使いましょう。標準キューでメッセージにテナントIDをメッセージグループIDとして付けておくと1テナントのメッセージが大量に滞留してもSQSが他のテナントのメッセージを先に配信してくれます。RDSの接続ならRDSProxyで接続をまとめてアイドル接続のタイムアウトを短くしておきます。
📦 廊下ジャック夫婦(ホットパーティション型)

症状
DynamoDBのテーブルで特定テナントのパーティションキーにアクセスが集中します。DynamoDBにはパーティション単位の上限があるのでテーブル全体のキャパシティは余っているのにその一角だけスロットリングされます。同じパーティションに同居している他のテナントは巻き添えを食らいます。
類似事象
S3でも同じことが起きます。プレフィックス単位のリクエスト上限に1テナントのキーが集中して、503 SlowDownが返ってきます。
対策
ホットなキーを分散します。DynamoDBならパーティションキーにサフィックスを付けて書き込みを散らします。テーブルのキャパシティを増やす前にまずどのキーが熱いのかを見るのが先です。テーブルのキャパシティを増やしても1パーティションの上限は変わらないので解決しないので注意。
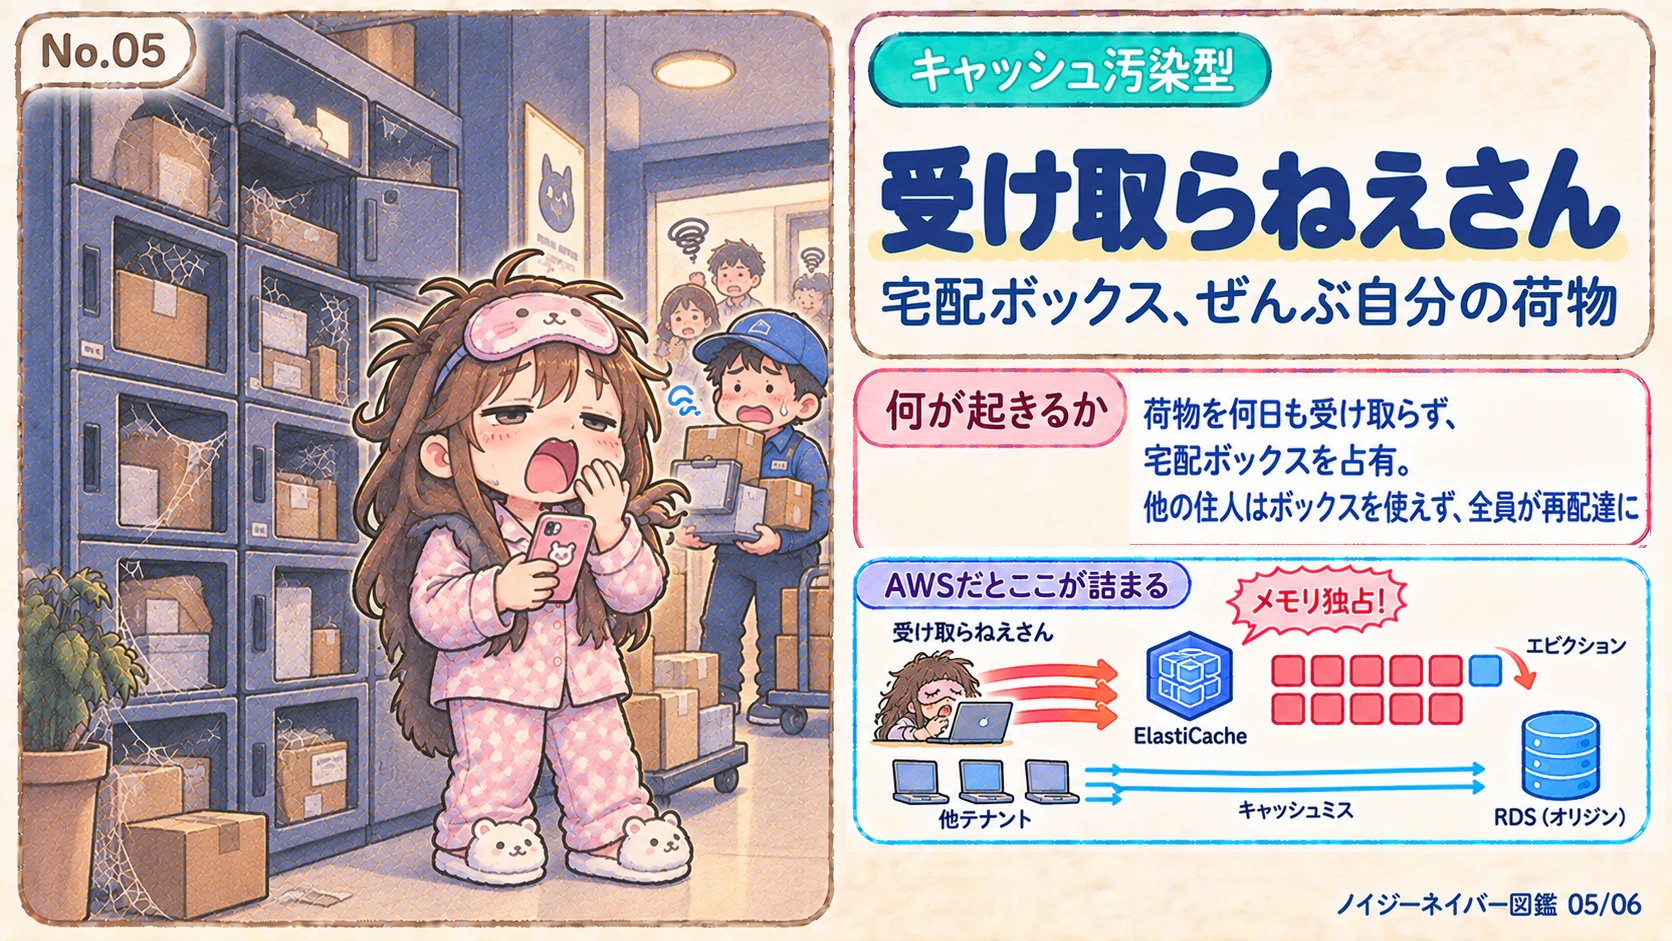
📮 受け取らねえさん(キャッシュ汚染型)
症状
ElastiCacheに1つのテナントのキーが溜まり続ける事象。TTLを付けていなかったり値が巨大だったりするのが原因でメモリが埋まるとmaxmemory-policyに従って他のテナントのキーが追い出されます。これがエビクションです。本人のキャッシュはちゃんと効いているのが皮肉なところです 追い出された側は毎回RDSまで取りに行くことになります。
類似事象
CloudFrontでも同じことが起きます。1テナントのユニークなURLがキャッシュを埋めて他のテナントのヒット率が下がります。
対策
TTLとエビクションを制御します。すべてのキーにTTLを必ず付けます。これがないとmaxmemory-policy頼みになって誰のキーが追い出されるかを制御できません。桁違いに大きいテナントはノードやクラスターごと分けてしまうのが早いです。
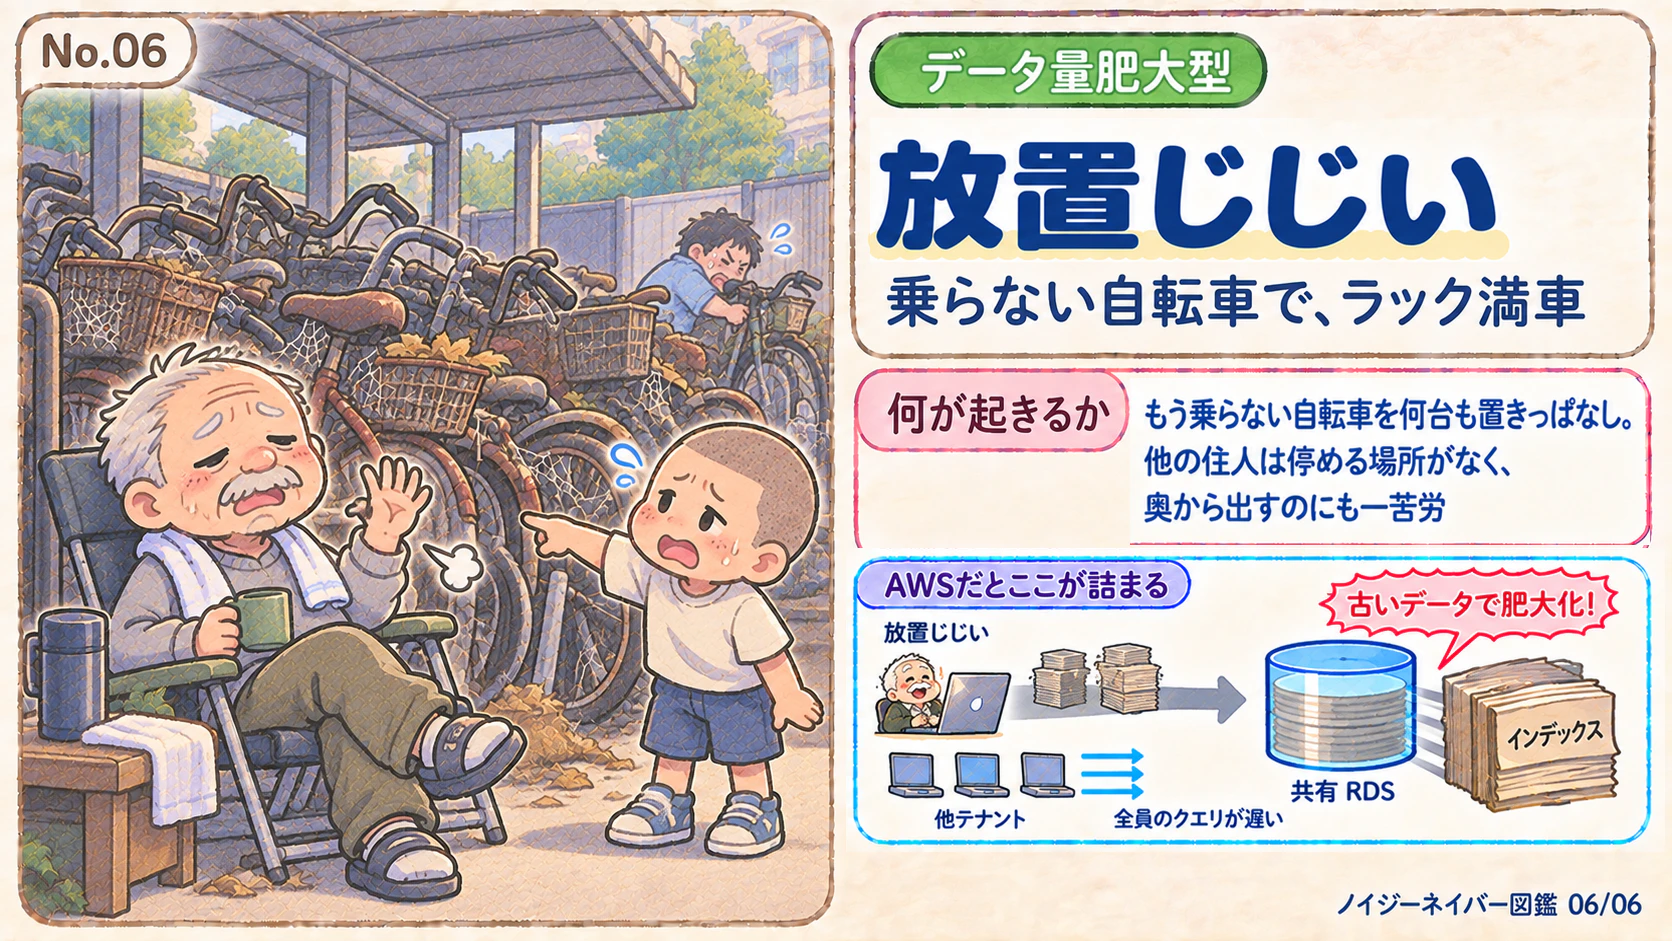
🚲 放置じじい(データ量肥大型)
症状
RDSの同じテーブルに1つのテナントの古いレコードが溜まり続けます。ログや履歴や論理削除済みのデータがその正体でテーブルとインデックスがじわじわ肥大化します。他のテナントのクエリは遅くなりますしバックアップの時間も伸びます。気づいたときにはメンテナンスウィンドウに収まらなくなっています。
類似事象
DynamoDBでも同じことが起きます。1テナントの古いアイテムが溜まってスキャンの時間とストレージ課金が増え続けます。
対策
アーカイブと整理を仕組みにします。保持期間を決めて古いレコードはS3に逃がして必要ならAthenaで参照します。RDSのテーブルはパーティション分割しておきます。DynamoDBならTTL属性を付けておけば勝手に消えてくれます。
🍜 締め
ノイジーネイバーのタチの悪いところは当事者も悪を持ってやっているわけではないのに全く悪くないユーザーに不利益を被ってしまう点ですね。また単純なアラームでは検知できず一見インフラ上は平気な顔をして運用し続ける点です。ここはノイジーネイバーを意識した監視を行うことが必要となってきます。
ノイジーネイバーは種類によって拡張で対応できるものもあればテナント単位の制御ルール等で防止するもの、データのアーカイブやメンテナンスで対応するもの多岐に渡ります。しっかりと原因を突き止め適切な対処をしていきたいところですね。
あなたの管理するクラウドシステムにも迷惑隣人が住んでいるかもしれません。まずはテナント別のメトリクスという防犯カメラを付けて誰が何を占領しているのかを見えるようにするところから始めてみてください