
👋 はじめに
RAGのあちこちにJevを差し込んでどこがどう変わるのか測ってみました!
🎯 対象購読者
- ぶっちゃけJevってRAG検索に使えるの?と思っている方
- RAG検索を愛している方
⚡ Jevってなに?
JevはTypeSafe AIが2026年9月15日に公開したモデルです。
解説記事はもうたくさん出ているのでここではざっくり説明します。一言で言うとテキストを生成しないAIモデルです。「状態」と「型付きの質問」を渡すと答えを確率付きで一発で返すだけ。文章は書きません。
| 項目 | 内容 |
|---|---|
| レスポンス | 約70〜500ms |
| 料金 | 入力$0.042/100万トークン、出力は無料 |
| 質問の型 | 選択肢・yes/no・段階評価(スコア) |
| 特徴 | 複数の質問を1リクエストで並列処理 |
| 提供状況 | early access |
🗺️ 何を検証したか?
RAG検索の流れは「質問 → ベクトル検索 → リランク → LLMが回答」ですよね。
このうちJevを差し込めそうな場所は「検索より前/リランク/LLMを呼ぶ直前」の3か所、それぞれにJevを配置して速度とコストが改善するか検証してみました。
| # | 検証 | 確かめたいこと | 差し込む場所 |
|---|---|---|---|
| 1 | リランキング | 並べ替えの精度で、専用リランカーに追いつけるか | リランク |
| 2 | 「回答できません」の判断 | 答えが載っていないとき、LLMを呼ぶ前に止められるか | LLMの直前 |
| 3 | 1と2を1回のリクエストで | まとめても精度は落ちないか。どれだけ速く安くなるか | リランク |
| 4 | 対象外の質問を門前払い | 「今日の晩ごはん何がいい?」を検索もせずに弾けるか | 検索より前 |
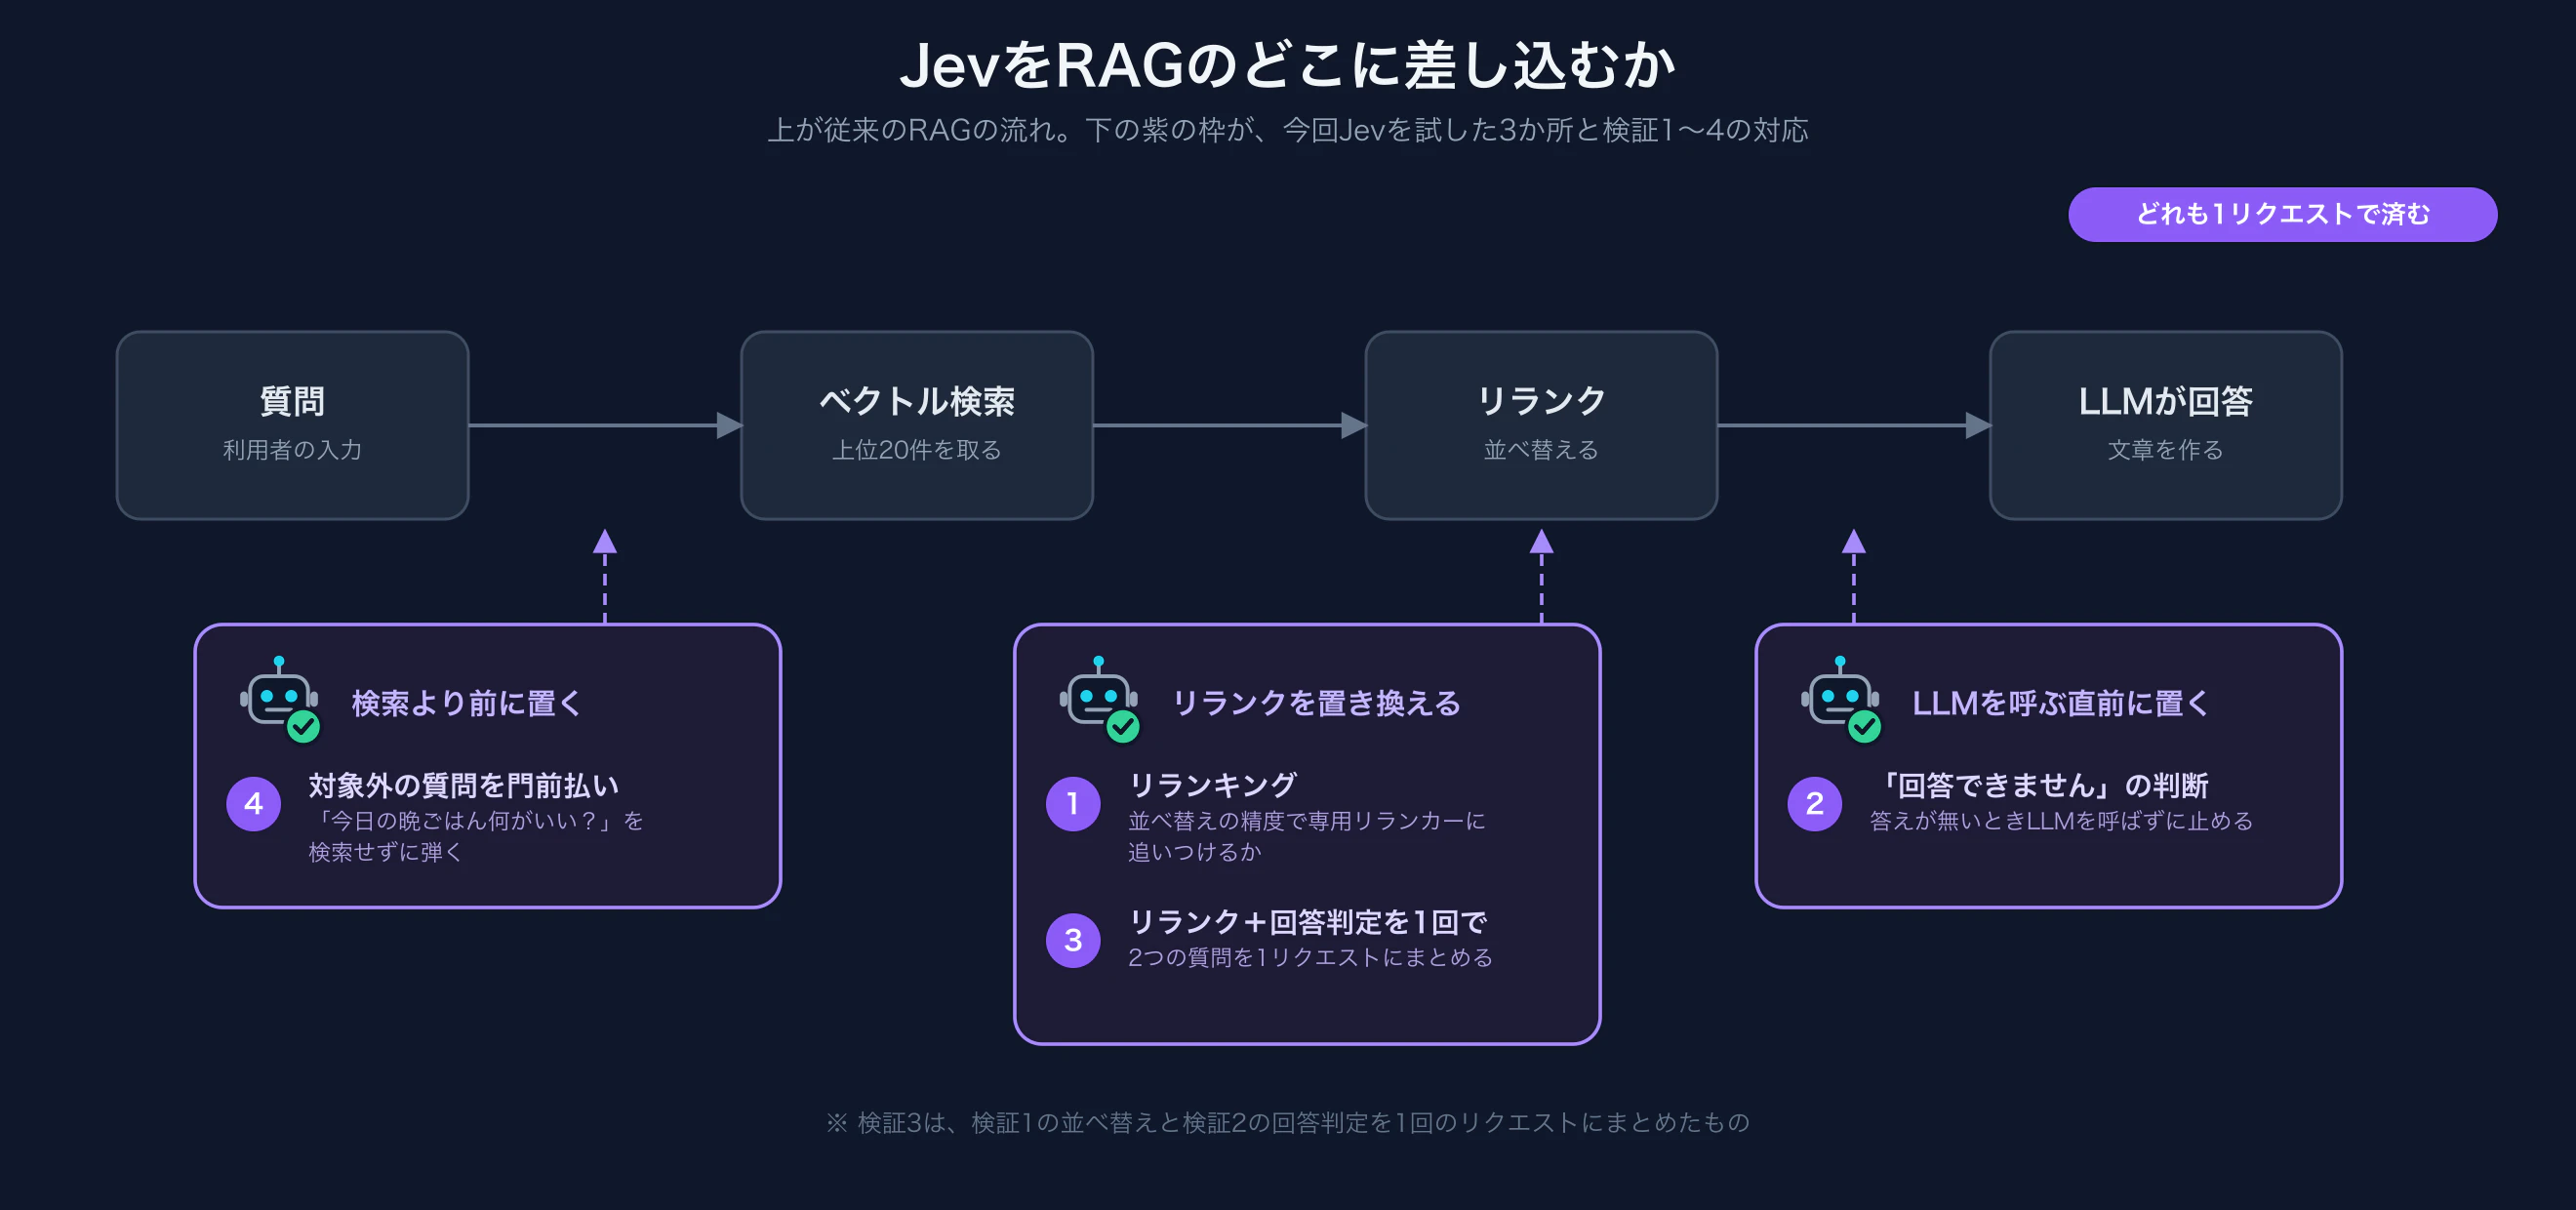
これらを動かして速さとコストを比べました。
🧪 検証の準備
🗂️ データセット
まず「この質問の答えはこのチャンクに書いてある」という正解データが要ります。架空の会社の社内規程・業務手順で人事・経理・総務・IT・安全衛生の5分野×8文書×10チャンク、40文書400チャンクです。どの事実をどのチャンクに書いたか、どの事実はあえて書かなかったかを記録しながら書いています。だから正解ラベルはその記録から機械的に決まります。各質問についてベクトル検索で上位20件を取って2つのラベルを付けました。
| ラベル | 内容 |
|---|---|
| 関連度 | 0:無関係 / 1:同じ分野 / 2:同じ規程の別の事項 / 3:まさにこれ |
| 答えを含むか | このチャンクだけで質問に答えられるか(yes / no) |
とはいえ、記録の付け忘れがあればそのまま間違った正解データになります。そこで2通りでダブルチェックしました。
- 人間の目:ニアミスの質問14本について、上位に来たチャンクを全部自分で読む
- 別のAI:記録を見せない状態で、Claude Opus 5に判定させる
内容はほぼ一致して人間同士で付け合ったときのばらつきと同じ水準で正解データとして使えると判断しました。
| 質問の種類 | 質問 | 検索で一番上に来たチャンク | 答えられる? | 件数 |
|---|---|---|---|---|
| 回答可能 | 「交通費精算の締め日は?」 | 交通費精算は毎月25日までに申請すること。 | ○ 25日 | 60件 |
| ニアミス | 「育休中の社会保険料免除って、いつまでに申請すればいい?」 | 育児休業期間中の社会保険料は、本人の申出により免除される。手続きは人事部にて行う。 | × 期限が書いてない | 40件 |
| 完全に無関係 | 「今日の晩ごはん何がいい?」 | 社員食堂の営業時間は11時から14時までとする。 | × そもそも話が違う | 20件 |
ニアミスとは、質問の話題にはぴったり合っているのに肝心の答えだけが書かれていないチャンクを指します
🖥️ 検証環境
| 項目 | 内容 |
|---|---|
| リージョン | 東京(ap-northeast-1) |
| 呼び出し元 | 日本のローカルPC |
| 検索 | DynamoDB(ベクトル検索、上位20件を取得) |
| Embedding | Amazon Titan Text Embeddings V2(1024次元) |
| リランカー | Cohere Rerank 3.5 / Amazon Rerank 1.0(Bedrock) |
| 比較用LLM | Claude Haiku 4.5 |
| 回答生成LLM | Claude Haiku 4.5 |
| Jev | jev-1.13.0(直API、Python SDK typesafe-sdk 0.7.0) |
※数値は検証時点(2026/09)のものです。
🔀 検証1:リランキング
🔧 リランクのやり方
Cohere Rerank 3.5 / Amazon Rerank 1.0:Bedrockのリランク機能に質問と20件のチャンクを渡して並べ替えます。
Claude Haiku 4.5:20件のチャンクに番号を振って渡し、「関連度の高い順に番号を並べて」と頼みます。
Jev:20件のチャンクそれぞれに「この質問との関連度は?」という段階評価の質問を作り、20問まとめて1リクエストで投げてます
{
  "model": "jev-1.13.0",
  "state": {
    "query": "交通費精算の締め日は?",
    "items": [
      { "id": "item_0", "title": "旅費交通費規程", "text": "交通費精算は毎月25日までに申請すること。" },
      { "id": "item_1", "title": "旅費交通費規程", "text": "交通費精算の申請は、経費精算システムに利用日、利用区間、用務先および目的を入力して行う…" }
      // … item_19まで
    ]
  },
  "questions": {
    "rel_0": {
      "type": "score",
      "instructions": "item_0 の text は、query にどれくらい関連しているか。",
      "criteria": [
        "0 - 無関係。query とまったく関係がない",
        "1 - 同じ分野でゆるく関係する程度",
        "2 - 同じ対象だが、query が聞いているのとは別の事項を扱っている",
        "3 - query が聞いているのと同じ対象の同じ事項。答えが書いてあるかどうかは問わない"
      ]
    }
    // … rel_19まで、チャンクごとに1問ずつ
  }
}
段階評価のcriteriaは0点から順に並べた説明文の配列です。3点の説明に「答えが書いてあるかどうかは問わない」と入れて関連度に答えの有無が混ざらないようにしました。並べ替えは返ってきたscoreの降順です。
📏 何で測るか
結果を見る前に3つの指標を説明しておきます。
| 指標 | 何を見るか | 満点 |
|---|---|---|
| Recall@1 | 答えのチャンクが1位に来た割合 | 1.000 |
| Recall@5 | 答えのチャンクが上位5件に入った割合 | 1.000 |
| nDCG@5 | 上位5件の並び順が、関連度の高い順にどれだけ近いか | 1.000 |
📊 結果
| 手法 | Recall@1 | Recall@5 | nDCG@5 | 速さ | 1,000クエリ |
|---|---|---|---|---|---|
| リランクなし | 0.800 | 1.000 | 0.814 | ― | ― |
| Cohere Rerank 3.5 | 0.950 | 1.000 | 0.884 | 198ms | $2.00 |
| Amazon Rerank 1.0 | 0.850 | 0.967 | 0.819 | 337ms | $1.00 |
| Claude Haiku 4.5 | 1.000 | 1.000 | 0.960 | 981ms | $2.73 |
| Jev | 0.983 | 1.000 | 0.965 | 290ms | $0.25 |
まずHaikuは論外(1秒近くかかるうえに値段も一番高い)並べ替えのためだけにLLMを呼び出し排除はメリットがなさそうです。そしてリランカー2種とJevは精度も速度も大差無し。差が出たのは値段でJevは8分の1。Jevいいじゃん!!となりそうですがこの精度はあまり当てになりません。リランクなしのRecall@5が1.000ということは、ベクトル検索をかけた時点で答えが上位5件に入っていたということです。リランカーの出番がそもそも無かったという感じでした。
400チャンクという規模が小さすぎました。精度をちゃんと比べるならもっと大きなコーパスで測り直す必要があります。
🙅 検証2:「回答できません」を判断できるか
チャンクは取れても答えが載っていなければ意味がないんですよね。 ニアミスの質問を「答えられない」と判断できればLLMを呼ばずに「その情報は見つかりませんでした」と返せる為コスト削減になりますよね。
🔧 判断方法
リランクスコアの閾値:リランカーが返した最大スコアが閾値未満なら回答不可とします。RAGでは昔からある方法ですね。 閾値はテストを開ける前の40問で決めました。Cohereが0.672、Amazonが0.0006手法ごとにスコアの水準が違うので別々に決める必要があります。
ClaudeHaiku4.5:質問と上位5件のチャンクを渡して「この情報だけで答えられるか」をyesかnoで答えさせます。
Jev:上位5件のチャンクと一緒にyes/noの質問を投げます。
渡す5件は、3手法ともCohereRerank 3.5で並べ替えた上位5件です。
{
  "model": "jev-1.13.0",
  "state": {
    "query": "育休中の社会保険料免除って、いつまでに申請すればいい?",
    "items": [
      { "id": "item_0", "title": "育児・介護休業規程", "text": "育児休業期間中の社会保険料は、本人の申出により免除される。手続きは人事部にて行う。" }
      // … item_4まで
    ]
  },
  "questions": {
    "can_answer": {
      "type": "noul",
      "instructions": "items の text は、query に答える根拠を含んでいるか。",
      "criteria": {
        "true": "items のどれかが、質問の求める値・条件・方法・窓口を直接述べており、items だけで答えられる",
        "false": "items は質問と同じ話題に触れているが、質問が聞いている事項そのものは書いていない。または参照先だけを示している(「別に定める」「担当部署に確認」など)。または別の対象・別の事項についての定めである。答えるには書かれていない情報が要る"
      }
    }
  }
}
📊 結果
| 手法 | 正解率 | ニアミスの見逃し率 | 回答可能の誤遮断率 | 追加の時間 | 追加のコスト |
|---|---|---|---|---|---|
| Cohere Rerank 3.5の閾値 | 65.0% | 25.0% | 53.3% | +0ms | +$0 |
| Amazon Rerank 1.0の閾値 | 65.8% | 95.0% | 3.3% | +0ms | +$0 |
| Claude Haiku 4.5 | 98.3% | 2.5% | 1.7% | +584ms | +$1.04 |
| Jev | 99.2% | 0.0% | 1.7% | +263ms | +$0.05 |
Cohereはニアミスの4分の1を通し、答えられる質問の半分を弾いています。逆にAmazonは誤遮断こそ少ないものの、ニアミスの95%を素通ししました。実際に起きたのがこの2問です。
| 質問 | 答えは? | 検索1位のチャンク | Cohere | Jev |
|---|---|---|---|---|
| 防災用に置いてある非常食って、賞味期限のどのくらい手前で新しいのと取り替えるの? | 書いてない | 「備蓄する食料および飲料水は、賞味期限が切れる前に新しいものに入れ替える。備蓄品の入替えの時期は…総務部が定め」(防災備蓄品管理規程) | 0.8306 → 通す | 0.09 → 止める |
| しばらく長い休みに入る予定。どれくらいの間システムに入らないでいると、自分のIDを止められちゃうの? | 書いてある | 「情報システム部は…45日間にわたりログインの記録が無いアカウントを停止する」(アカウント・パスワード管理規程) | 0.3305 → 弾く | 0.95 → 通す |
Cohereの学習データ仕様「すべての質問に正例が最低1つ必要」とあるため答えがどこかにある前提のモデルに答えの無い質問を判断するのはリランクモデルには難しいのかもしれませんね。対してHaikuとJevはどちらもほぼ取りこぼしませんでした。Jevは見分ける力は脅威の0.983でJevのほうが2倍速くて20分の1の値段です。
💸 表に出てこない大きい効果
実は「回答できません」の判定が当たったらその先のLLM呼び出しが丸ごと消えるんですよね。上記の表には現れないコスト削減なんですよね。Haiku4.5に回答を作らせると1回あたり1.5秒ほどかかって、1,000回で$1.37です。 答えられない質問1問で比べるとこうなります。
| 判定 | 回答生成 | 合計 | |
|---|---|---|---|
| Jevなし | ― | 1,459ms | 1,459ms |
| Jevあり | 263ms | 呼ばない | 263ms |
5分の1以下です。「見つかりませんでした」を返すのに1.5秒待たせる必要がなくなります。
コストはもっと極端です。Jevの判定は1,000クエリで$0.05、回答生成は1回$0.00137。1,000問のうち37問止められれば、それだけでJev代が回収できます。もちろん答えられる質問は263ms遅くなります。ただ止めた1問あたりの見返りが大きいので、答えられない質問が数%でも混ざるなら入れる価値はありそうですね。
🧩 検証3:リランクと回答判定、まとめてやれない?
ここまで来ると欲が出てきます Jevは質問を並列で処理できるのでリランクと回答判定を1回のリクエストでまとめてやれるんじゃね?ということで各チャンクに対して2つの質問を同時に投げます。
{
  "model": "jev-1.13.0",
  "state": {
    "query": "育休中の社会保険料免除って、いつまでに申請すればいい?",
    "items": [
      { "id": "item_0", "title": "育児・介護休業規程", "text": "育児休業期間中の社会保険料は、本人の申出により免除される。手続きは人事部にて行う。" }
      // … item_19まで
    ]
  },
  "questions": {
    "rel_0": {
      "type": "score",
      "instructions": "item_0 の text は、query にどれくらい関連しているか。",
      "criteria": ["0 - 無関係。…", "1 - 同じ分野でゆるく…", "2 - 同じ対象だが、別の事項…", "3 - 同じ対象の同じ事項…"]
    },
    "ans_0": {
      "type": "noul",
      "instructions": "item_0 の text は、query に答える根拠を含んでいるか。",
      "criteria": {
        "true": "その item の text が、質問の答えになる規則・条件・数値・手続き・担当者を直接述べている",
        "false": "その item の text は質問と同じ話題に触れているが、質問が求める規則・条件・数値・手続き・担当者を述べていない。または別の話題である"
      }
    }
    // … item_19まで、チャンクごとに2問ずつ(計40問)
  }
}
これで関連度で並べ替えつつ、noulがいちばん高いチャンクでも0.755に届かなければ回答不可、という切り方ができます。増えたのはyes/noの質問だけで、リクエストは1回のままです。
3つの構成で比べました。
| 構成 | nDCG@5 | 回答判定の正解率 | 速さ | 1,000クエリあたりコスト |
|---|---|---|---|---|
| ① リランカー → リランクスコアの閾値 | 0.884 | 65.0% | 198ms | $2.00 |
| ② リランカー → Jevで回答判定 | 0.884 | 99.2% | 468ms | $2.05 |
| ③ Jevの1回でリランク+回答判定 | 0.960 | 99.2% | 292ms | $0.34 |
③の回答判定は②と1問も違わず並べ替えも①②より上です。速さは②の6割、値段は6分の1。リランカーの呼び出しが丸ごと消えるのが効いています。
🚪 検証4:対象外の質問を門前払い
RAG検索において「今日の晩ごはん何がいい?」とか「sdfghjk」みたいな関係ない質問や意味不明な質問はそもそも検索する必要すらないですよね。
なので検索の前にJevで「この質問は対象範囲か?」を聞いて対象外ならEmbeddingも検索もリランクもLLMもまとめてスキップしてみました。
{
  "model": "jev-1.13.0",
  "state": { "query": "今日の晩ごはん何がいい?" },
  "questions": {
    "gate": {
      "type": "choice",
      "instructions": "利用者の質問は、どの区分に当てはまるか。",
      "criteria": {
        "in_scope": "この会社で働くことについて、社員が社内のヘルプデスクに聞くような質問。ヘルプデスクが扱うのは… ← 扱う規程を全部書き下す(下のnote参照)",
        "out_of_scope": "この会社で働くことと明らかに関係がない。雑談、一般知識、娯楽、料理、私生活、社内のヘルプデスクが受けないハウツーの質問",
        "unclear": "意味を成さない入力、または単体では何を聞いているのか分からない発話"
      }
    }
  }
}
返ってくるのは選んだラベルと、ラベルごとの確率です。通す条件は「確率がいちばん高いラベルがin_scope」で、閾値は使っていません。
{ "gate": { "type": "choice", "choice": "out_of_scope", "confidence": 1.0,
            "probabilities": { "out_of_scope": 1.0, "unclear": 0.0, "in_scope": 0.0 } } }
選択肢のcriteriaはラベルごとの説明文です。対象範囲はコーパスから推測させるのではなく、このシステムは何に答えるものかをここに文章で書いておきます。
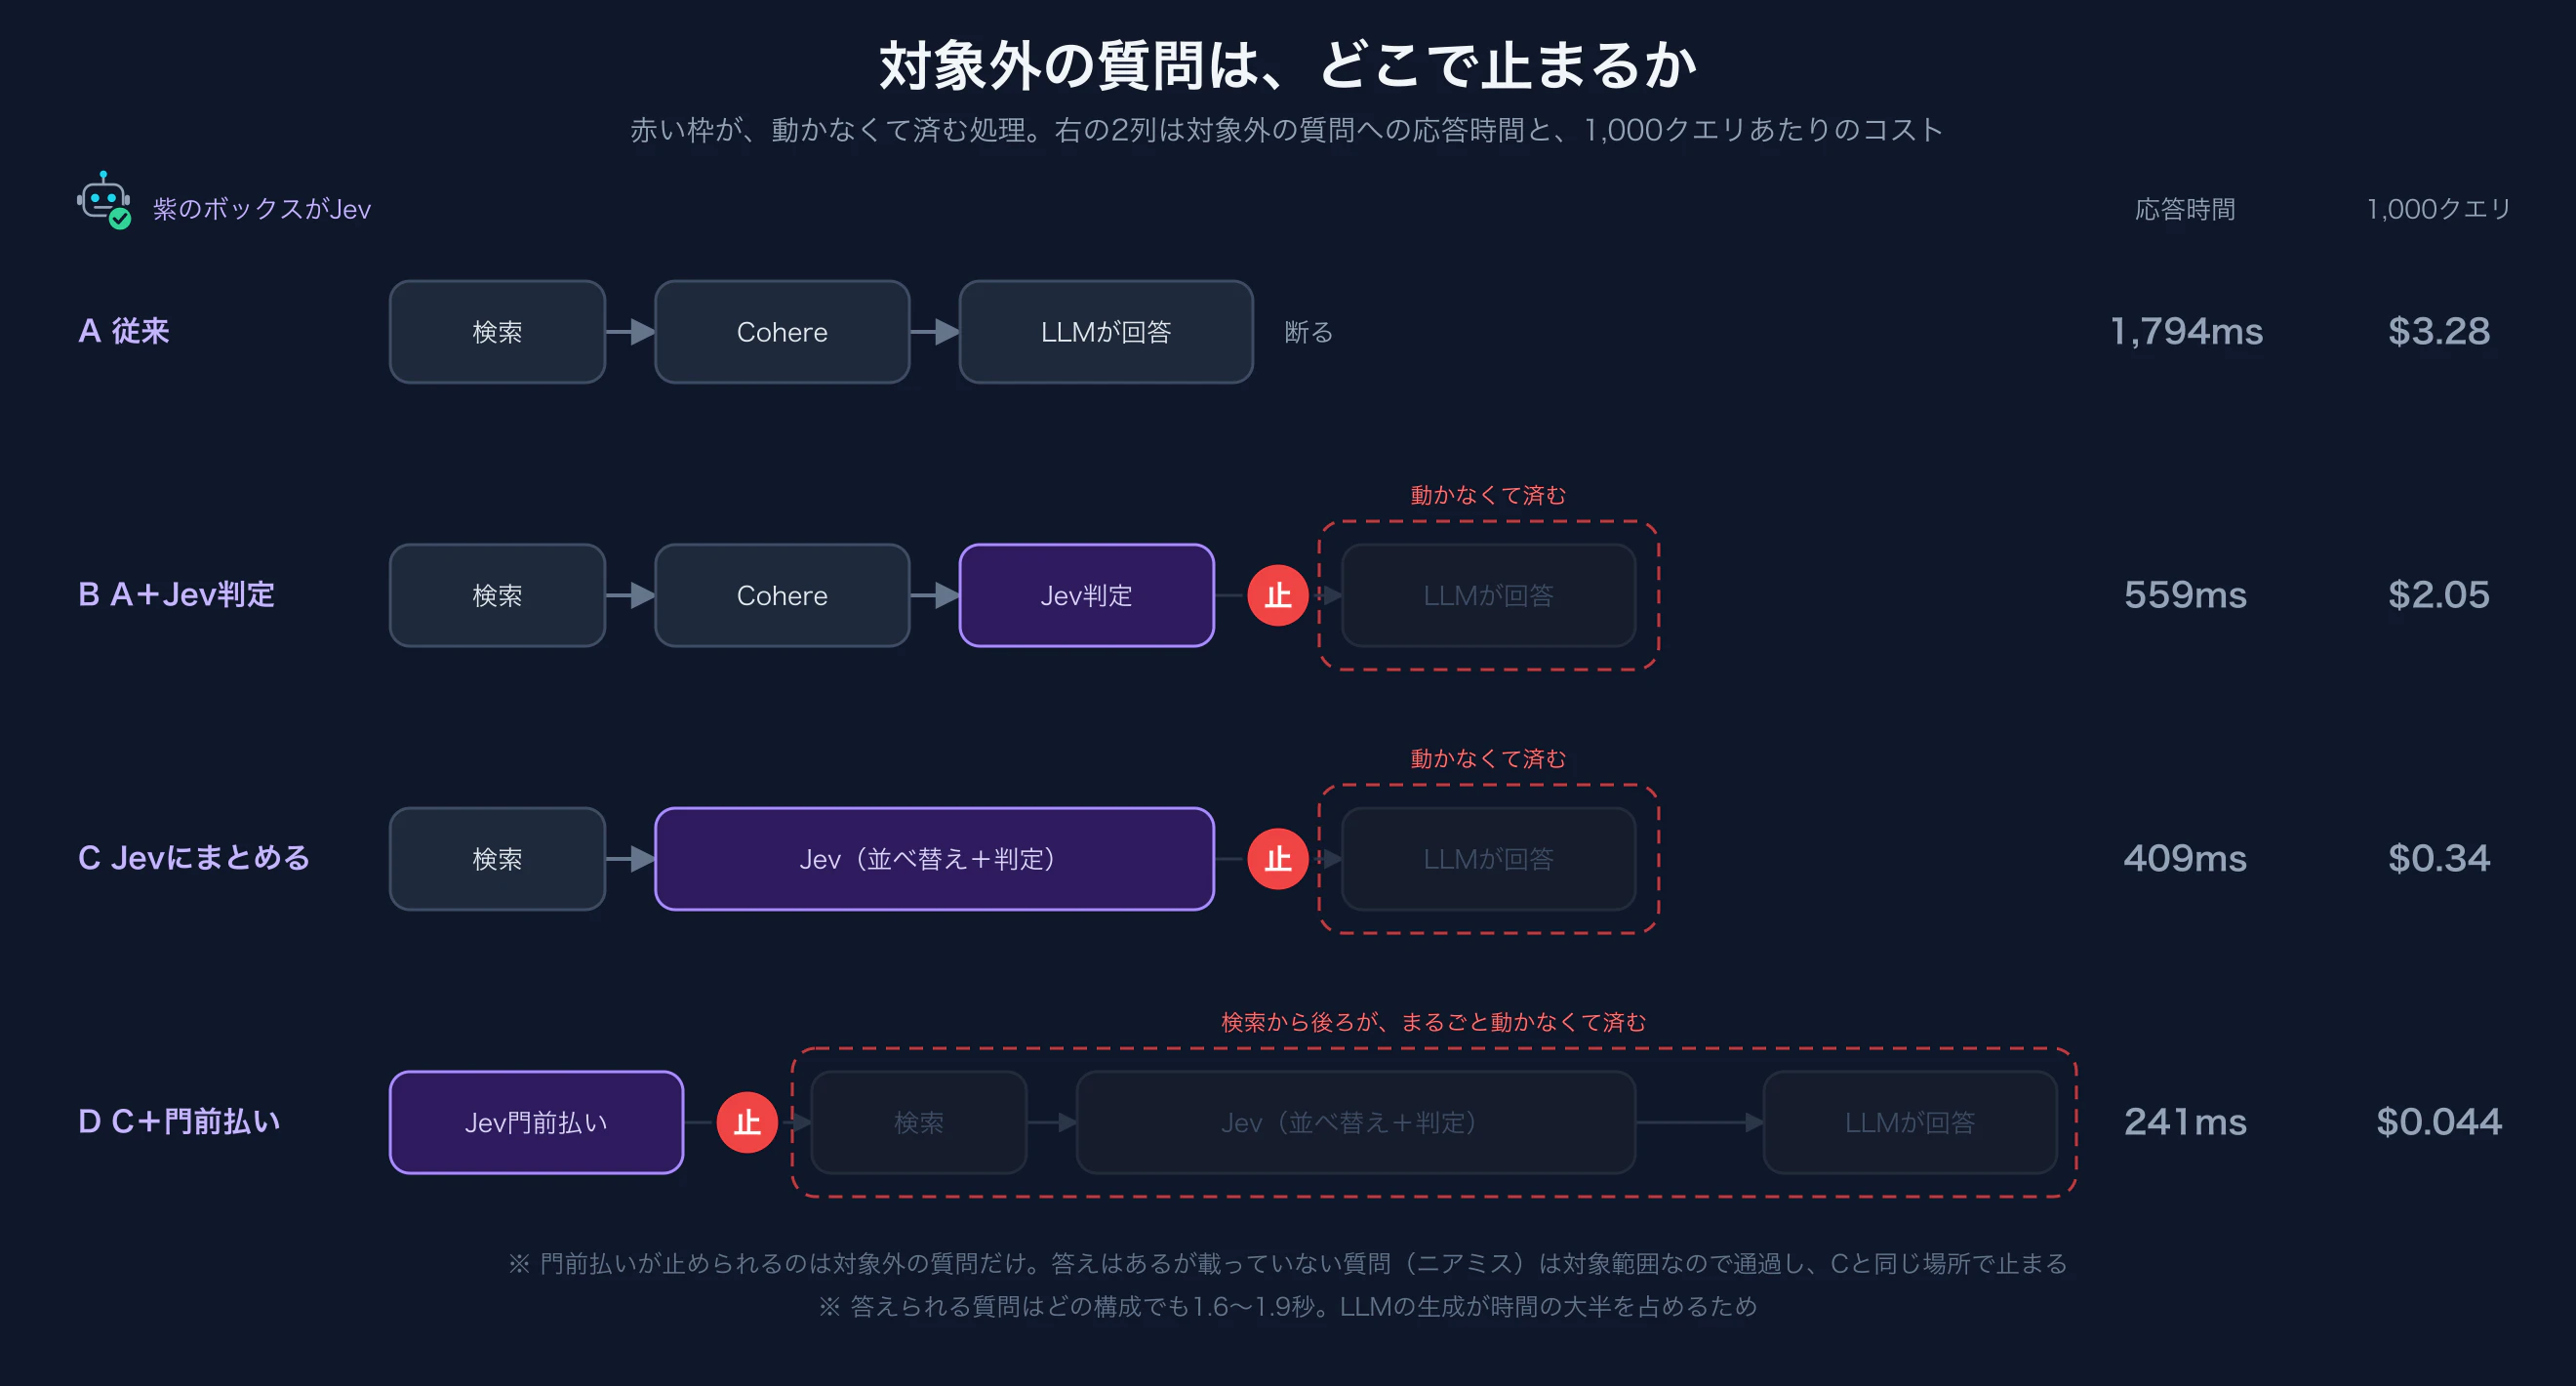
| 構成 | 対象外の質問への応答時間 | 1,000件あたりコスト |
|---|---|---|
| 門前払いなし(検索→リランク→LLMが断る) | 1,794ms | $3.28 |
| Jevで門前払い | 241ms | $0.044 |
聞くのは1問だけなので一瞬で返ってきます。検索にもLLMにも流さずに済むので値段は75分の1になりました。
精度は対象範囲の質問100件のうち誤って止めたのが2件。無関係な20件は19件止めました。通してしまった1件は
「Pythonで写真フォルダを毎晩バックアップするスクリプトを書いて」
対象範囲に書いた「データのバックアップ」に引っ張られたようです。
意味を成さない入力10件は全部unclear。ただし「詳細を教えて」のような継続の発話も5件ともunclearでした。初回か継続かはアプリ側で分かるので継続時は会話履歴も渡すか、門前払い自体をスキップするのがおすすめです。
対象範囲の書き方で成績がはっきり変わりました。最初は「人事・経理・総務・IT・安全衛生」の5語だけで、これだと34問中5問を誤って止めています。「インフルにかかったら何日会社に行っちゃだめ?」のように、会社や規程という言葉が出てこない質問が弾かれました。
扱う規程を全部書き下した文面に直したら0件に。実際に使ったin_scopeはこれです。
この会社で働くことについて、社員が社内のヘルプデスクに聞くような質問。ヘルプデスクが扱うのは、休暇と勤怠、育児休業と介護休業、慶弔休暇と慶弔見舞金、人事評価、採用と試用期間、休職、退職。通勤費と出張費、経費精算、仮払いと小口現金、請求書と支払い、備品の購入、法人カード、予算。福利厚生、社員証などの貸与品、会議室と社用車、郵便物と宅配便、来客、入退館、災害用の備蓄。情報セキュリティ、アカウントとパスワード、貸与パソコン、ソフトウェア、リモート接続、メールとチャット、システム障害とセキュリティ事故、データのバックアップ。健康診断、ストレスチェック、産業医、長時間労働、労災と通勤災害、感染症、避難訓練、オフィス環境。言い回しがくだけていても、会社や規程という言葉が出てこなくても、規程に答えが書かれていなくても、ここに入る
コーパスから察してもらうのではなく、何に答えるシステムなのかを言葉で書く。5語では足りませんでした。
💰 まとめ:速さとコスト
Jevを入れた3か所それぞれで、入れる前と後を並べます。
| Jevを置く場所 | やること | 速さ | 1,000件あたりコスト |
|---|---|---|---|
| リランキング | Cohereを置き換える | 198ms → 290ms | $2.00 → $0.25(8分の1) |
| 回答不可の判定 | LLMを呼ぶ前に止める | 1,459ms → 263ms(5.6倍速い) | $1.37 → $0.05(27分の1) |
| 門前払い | 検索する前に止める | 1,794ms → 241ms(7.4倍速い) | $3.28 → $0.044(75分の1) |
1行目は全クエリ、2行目は答えが載っていない質問、3行目は対象外の質問について、それぞれ1,000件あたりの値です
リランキングは置き換えなので比べる相手はCohereです。速さはむしろ少し負けていて効くのは値段だけ。それでも8分の1になります。残りの2つは足し算で、比べる相手は「Jevを入れなかった場合」です。
- 回答不可の判定:検索もリランクも済ませたうえで、LLMだけ止める → 27分の1
- 門前払い:検索すらせずに止める → 75分の1
止める位置が早いほど効く、という関係です。
判定そのものにもお金はかかります。1,000クエリで$0.05。ただLLMを1回止めるごとに$0.00137が浮くので、1,000問のうち37問(3.7%)止まれば判定代はそれだけでまかなえます。答えられない質問がそれ以上混ざるなら、あとは丸ごと得ですね。
🍜 締め
JevでRAGの速度改善、コスト削減は可能と思われます。体感的な爆速を感じられるのは対象外、範囲外質問に限定されると思われます。(LLMが入るとやはり待つことに変わりない)
これまでLLMに判断させていたところをJevに任せるとレイテンシもコストも下がります。また検索前に門前払いすることで判断そのものを速くするより後ろの処理をまるごと呼ばずに済ませる効果は大きいです。答えられない質問を手前で止めれば、検索もリランクもLLMも走りません。
ただし弾いてはいけない質問を弾くと信頼の問題になります。ここは慎重に閾値を決める必要があります。また正しい質問に対しては多少のレイテンシ/コスト像になる為、実績ベースで回答不可質問がどの程度あるかを分析した上で導入を決めた方が良いです。
リランクの精度については今回のデータでは何とも言えません。手作りの小さなコーパスでは差が出きらなかったので導入を判断するなら実データでしっかり計測する必要があります。
まだ検証できておりませんが以下のような使い方も面白そうなので今後いろいろ検証していきたいです。
[LLMのモデル選定]
リランクにjevを採用することで不要なチャンクを切り落として回答につながる純度の高いチャンクが残り、このチャンクであれば今までLLMにSonnetを使用していたものをHaikuでも十分な回答ができる可能性もあります。応用編として回答判定の確信度でSonnet/haikuとモデルを分けて最適なモデル選択もできるかもしれません。
[ガードレール判定]
今回の門前払いはホワイトリスト的的な扱いでしたが、ブラックリスト的なガードレール的な用途も考えられます。こちらはAmazonBedrockガードレールでも代用が効きそうなため比較検証のやりがいがありそうです。