
Qwen公式が出している Qwen Code CLI をローカルの Qwen 35B につないだら、同じ「hello.pyを作る」タスクをエージェントとして4回走らせ、3回失敗しました(別に疎通確認を1回)。
成功したのは llama-server 3.6 --jinja -c 32768 の1パターンだけでした。失敗した3回は、壊れ方がそれぞれ違います。tool call が発火せずコードを文章で返す。生の <tools> テキストをそのまま吐く。文脈不足で 19374 > 8192 のエラーで落ちる。
一番意外だったのは、同じ Ollama バックエンドでも claw-code では動いた tool call が、Qwen Code CLI では壊れたことです。Qwen純正の CLI だからローカル Qwen との相性はいいはず、という予想は見事に外れました。
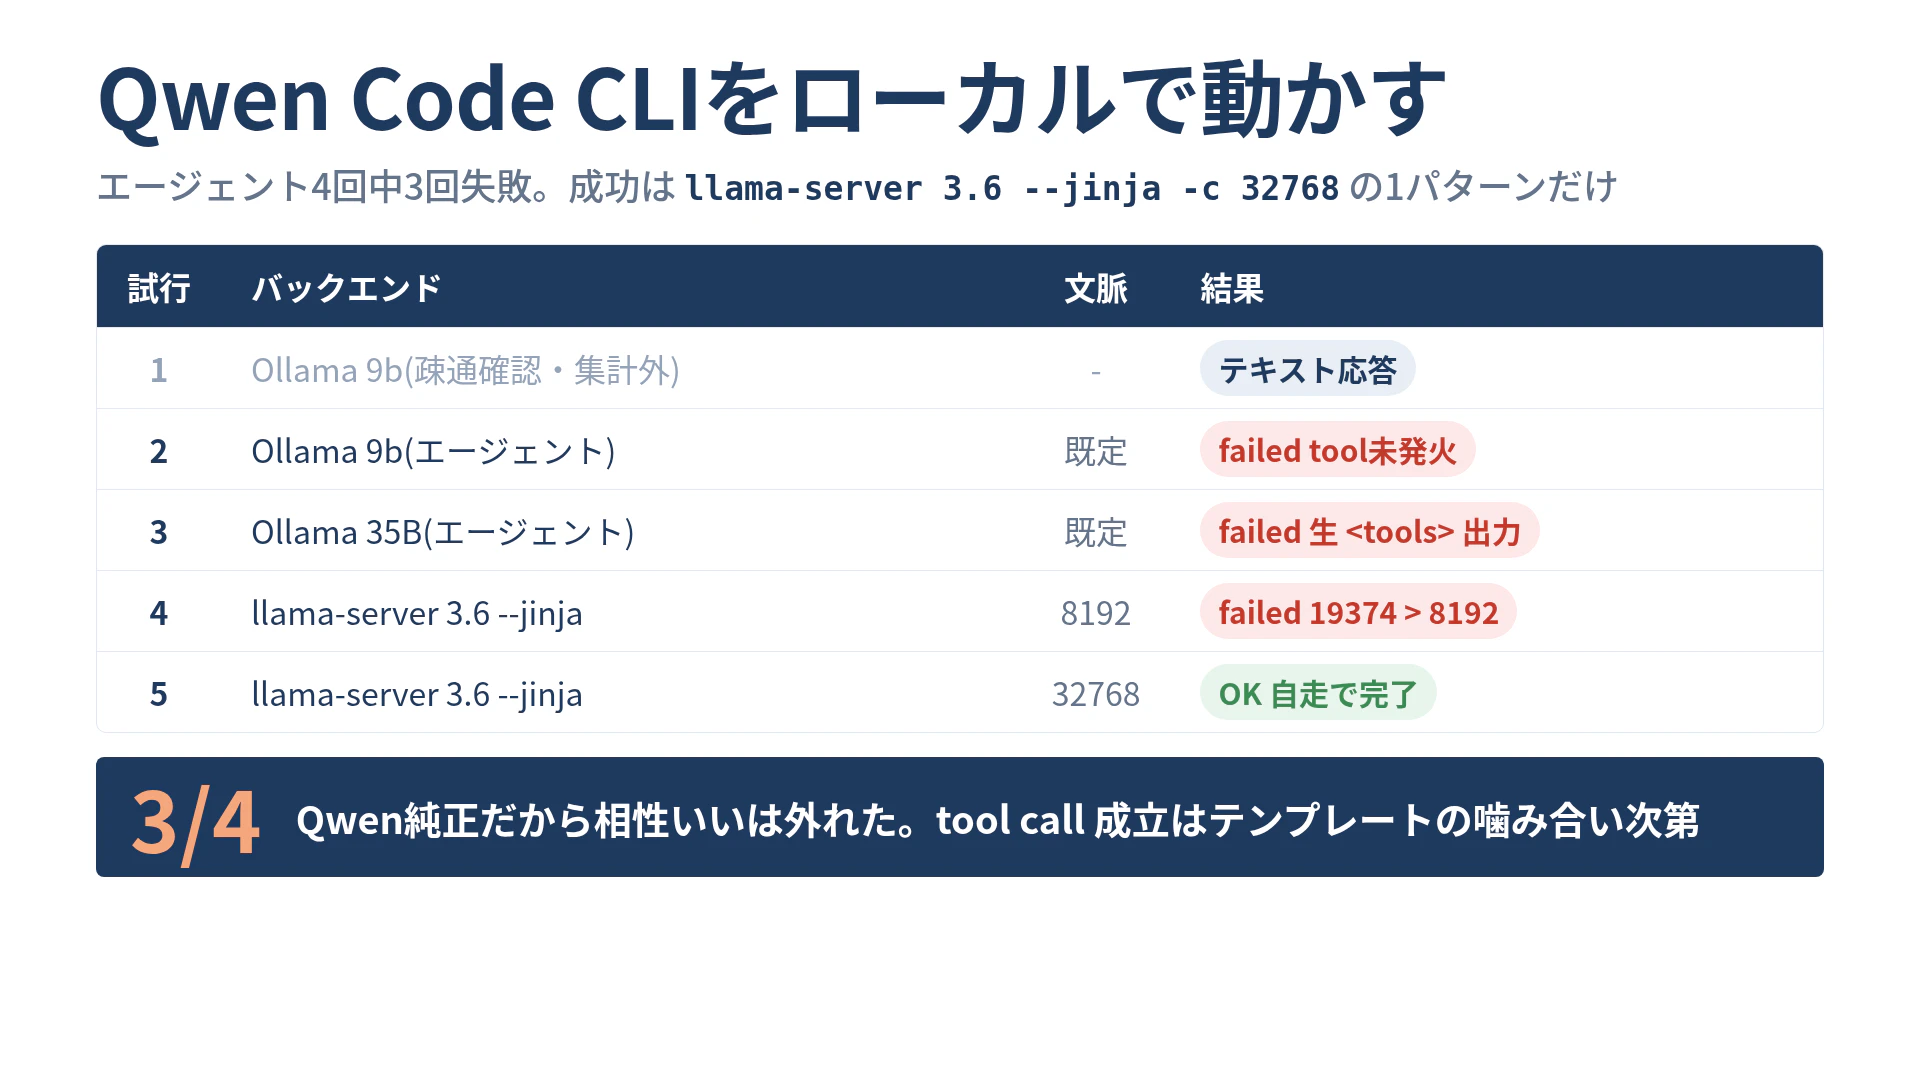
相性を決めていたのは、バックエンドの設定だけでした。
- 別軸との棲み分け: 姉妹記事「Qwen Code CLIをClaudeの隣に置いたら、2タスクで置き換わった」は Claude Code との置換の話、「ネットにもAPIにも繋がず、ローカルQwen 35Bでコーディングエージェントを動かす」は claw-code 中心のエージェント一般論、「4070のローカルQwen 35Bは速くて賢いか」は7問の品質比較でした。本稿は Qwen Code CLI 専用、ローカル Qwen 接続の成否5パターンに絞っています
-
測定は私の手元です: 5試行は 2026年6月15日に、私の環境(GPU は RTX 4070)で実施しました。試行4のエラーログ(
19374 tokens exceeds 8192)も残っています。同じ結果は拙著『RTX 4070でQwen 35Bを2.8倍速くする』第9章「2エージェントCLI比較。自走度の限界を測る」にも載せています。合わせて、Alibaba公式の qwen-code GitHubリポジトリ(Apache-2.0、検証に使ったのは v0.18.1)と llama.cpp の--jinjaオプション、Ollama 公式の ChatTemplate 扱いを引用しました
Qwen Code CLI は Gemini CLIフォーク + Qwen公式
Qwen Code CLI は、QwenLM が公開しているエージェント CLI です。中身は GoogleのGemini CLIをフォークしたもので、Apache-2.0ライセンス、本記事で動かしたのは v0.18.1 です。
| 観点 | Qwen Code CLI |
|---|---|
| 出自 | QwenLM / Gemini CLIフォーク |
| ライセンス | Apache-2.0 |
| 検証バージョン | v0.18.1 |
| 承認モード | Plan / Default / Auto-Edit / Auto / YOLO の5モード |
| 拡張機能 | SubAgents、ヘッドレス実行、Fork(background agents) |
承認モードが5段階に分かれていて、SubAgents やヘッドレス実行、作業を背後に逃がす Fork まで持っている。自走を任せるための足回りは、エージェント CLI の中でも手厚い方です。
ただし、この厚みはあとで文脈消費量として跳ね返ってきます。
5回試行の内訳
同じ「hello.pyを作る」タスクを、バックエンドを変えながら5回試した結果が以下です。
| 試行 | バックエンド | 文脈 | 結果 |
|---|---|---|---|
| 1 | Ollama 9b(疎通確認) | - | 成功(テキスト応答) |
| 2 | Ollama 9b(エージェント) | 既定 | 失敗(toolが発火せず、コードを文章で返す) |
| 3 | Ollama 35B(エージェント) | 既定 | 失敗(生の <tools> テキストを吐く、ファイル未生成) |
| 4 | llama-server 3.6 --jinja | 8192 | 失敗(文脈不足: 19374 > 8192) |
| 5 | llama-server 3.6 --jinja | 32768 | 成功(hello.py 作成、自走で完了) |
試行1は疎通確認で、hello.py は作らずテキスト応答で終わりました。エージェントとして走らせた試行2〜5の4回のうち、hello.py を自走で作れたのは試行5の1回だけです。
「同じ Qwen 35B を同じローカルマシンに置いて、CLI を Qwen Code CLI に揃えた」という条件でも、バックエンドの設定が1つズレると tool は発火しません。失敗を分けていたのは設定差で、モデルは同じでした。
試行2〜3: Ollama 既定テンプレートの壁
試行2は、Ollama で動く Qwen 9b を Qwen Code CLI の裏に置いた構成です。普通に質問には答えますが、「hello.py を作って」と頼むと、ファイル作成の tool を呼ばず、「こう書けば動きます」というコードの文面だけを返してきました。
試行3の 35B も同じです。それどころか、本来 JSON で出すべき tool 呼び出しが、生の <tools> というタグ付きテキストとして出力されました。ファイルは当然作られません。
原因は、Ollama 側の既定チャットテンプレートが Qwen Code CLI と噛み合わないことです。モデルが tool call のつもりで出した <tools>...</tools> ブロックが、OpenAI 互換 API が期待する tool_calls: [...] フィールドに整形されず、ただの文字列として CLI まで素通ししてしまう。
同じ Ollama バックエンドでも、claw-code(ultraworkers 製の Rust CLI)は tool call を発火できました。Qwen 純正だから相性がいいだろう、という最初の予想は外れたことになります。
tool call を成立させる本当の条件は、チャットテンプレートの整形が噛み合うかどうかでした。モデルと CLI の「純正度」は関係ありません。Qwen のネイティブ出力形式を、Qwen Code CLI の期待する JSON へ整形してくれるテンプレートがいるかどうか。ここが成否を決めていました。
試行4: llama-server に切り替えても、文脈でこける
Ollama で噛み合わないなら、llama-server を --jinja 付きで立て直すのが条件1になります。llama.cpp 公式ドキュメントの通り、--jinja を付けると、モデル同梱の Jinja チャットテンプレートに切り替わります。Qwen のネイティブ形式がちゃんと tool_calls フィールドに整形されるようになり、tool call が発火し始めます。
ところが試行4は、ここでまた落ちました。エラーはこうです。
400: request (19374 tokens) exceeds the available context size (8192 tokens)
リクエストが、いきなり19374トークン。まだ何の仕事もしていない、最初の一発目でこれです。Qwen Code CLI のシステムプロンプトと tool 定義だけで、約19,374トークンを消費していました。
-c 8192 ではまったく足りません。システムプロンプトを読み込む段階で既にオーバーしているからです。tool call のテンプレートは直った、でも入り口の context size で死ぬ。この時点では、まだ hello.py の中身を考える工程にすら到達していません。
試行5: --jinja + 32768トークンで、やっと成功
試行5は -c 32768 に増やして、同じ構成を立て直したものです。
llama-server -m qwen36.gguf -ngl 99 --cpu-moe -c 32768 \
  --jinja --alias qwen36 --host 0.0.0.0 --port 18080
これでようやく、Qwen Code CLI が tool を発火し、hello.py を自走で作りに行きました。ファイルも作られ、終了まで走ります。
比較のため、claw-code を同じローカル Qwen に当てたときのトークン消費も見ておきます。システムプロンプト + tool 定義のサイズは、こうでした。
| CLI | system+tool のトークン消費 | 必要 context |
|---|---|---|
| claw-code | 約1,453トークン | 既定でも十分 |
| Qwen Code CLI | 約19,374トークン |
-c 32768 必須 |
実に13倍の差があります。Qwen Code CLI は自走の仕組みを厚く積んでいる分だけ、入り口のシステムプロンプトも tool 定義も重くなります。承認5モード・SubAgents・ヘッドレス実行・Fork(background agents)という4点の積み上げです。だから -c 8192 では足りず、-c 32768 が最低ラインになります。
Qwen Code CLI 公式の README でも、Qwen3-Coder 系列のモデルに最適化されている旨は書かれていますが、ローカル接続時に --jinja + 大文脈が必須である点は、OSS バックエンド側の挙動に依存します。llama.cpp 側の --jinja オプションドキュメントと、Ollama 側のチャットテンプレート仕様(モデル同梱の Modelfile に書かれる TEMPLATE ブロック)の両方で、tool call フォーマット整形の挙動が決まります。
必須レシピ: --jinja と 大文脈
5試行から導けるのは、Qwen Code CLI をローカル Qwen で動かすための必須レシピ2つです。
条件1: --jinja 付きの llama-server
Ollama の既定テンプレートでは、tool-call の形式が Qwen Code CLI と噛み合いません。試行3のように、本来 JSON で出すべき tool 呼び出しを、生の <tools> タグ付きテキストで吐いてしまい、ファイルが作られません。解決は、--jinja を付けた llama-server に切り替えることです。モデル同梱の Jinja テンプレートに乗せ替えれば、tool_calls: [...] に整形されて CLI まで届きます。
条件2: 32768トークンの大文脈
試行4と5の違いは、文脈サイズだけです。8192では溢れ、32768で通りました。Qwen Code CLI のシステムプロンプトと tool 定義だけで約19,374トークンを食うので、-c 8192 では話にならない。最低 -c 32768 を確保しておく必要があります。
この2条件が揃って、はじめて Qwen Code CLI が走り出します。片方だけでは、どちらも試行4か試行3の状態で止まります。
Qwen 純正だから相性いいは外れた
ここが counter-intuitive な測定結果でした。
「Qwen公式が出しているQwen Code CLI だから、ローカル Qwen との相性はいいはず」という素朴な期待は、設定ガチャの前では無力でした。相性を決めていたのは、以下の3つです。提供元が同じかどうかは、相性に効いていません。
-
チャットテンプレートが tool call を扱える形で出力できること(モデル同梱 Jinja + llama-server
--jinja) - CLI 側の tool 定義 + システムプロンプトが収まる context 長があること(Qwen Code CLI なら最低 32768)
- CLI の tool 呼び出しフォーマットと、モデルの出力フォーマットが整形で噛み合うこと
純正度は、1〜3のどれも保証してくれません。むしろ、純正だと期待してしまう分、Ollama 既定で動かないときに「え、何で」と手が止まります。設定ガチャに勝つには、公式の README を鵜呑みにせず、--jinja と -c 32768 を自分で指定する必要があります。
claw-code と Qwen Code CLI の性格比較
同じローカル Qwen 35B を両方の CLI に当てた比較表です。
| 観点 | claw-code | Qwen Code CLI |
|---|---|---|
| 出自 | ultraworkers / Rust | QwenLM / Gemini CLIフォーク |
| Ollamaで tool-call | 動く | 壊れる(--jinja 必須) |
| system+tool の文脈消費 | 約1,453トークン | 約19,374トークン(13倍) |
| 自走の制御 | 権限モードと tool 制限 | 承認5モード、SubAgents、ヘッドレス、Fork |
claw-code は、Ollama 既定でもすんなり tool call が通ります。文脈消費も軽く、設定でハマる余地が少ないです。かわりに、承認の粒度やサブエージェント、バックグラウンド実行といった「自走を厚くする」機能は薄めです。
Qwen Code CLI は反対で、入り口のハードルは高いけれど、自走を長く安全に回すための足回りが分厚くなっています。SubAgents で役割を分けたり、ヘッドレスで CI に組み込んだり、Fork で作業を背後に逃がしたりという使い方ができます。文脈消費の13倍は、この厚みの代償です。
安全に自走させたいなら、Auto-Edit(編集だけ自動で許し、シェル実行は除外する)あたりが現実的な落としどころでした。
正直に書く、自走の限界
「自走」と聞くと、目標を1つ渡せば、達成するまでモデルが勝手にループを回し続けてくれる姿を想像するかもしれません。けれど、claw-code にも Qwen Code CLI にも、そういう意味での目標達成ループ(達成を別に判定し、未達なら作業を続ける外側のループ)は、ありませんでした。
両者にあるのは、あくまで「1つのタスクの中で道具を何度も呼ぶ」エージェントループです。Qwen Code CLI の承認自動化や予算制御は、その単一タスク内ループを安全に長く回すための仕組みであって、目標を自分で追い続ける仕組みではありません。
これは、誇張せずに記録しておくべき限界です。検証時点(2026年6月、claw-code と Qwen Code CLI v0.18.1、既定の承認モード)での両ツールの位置づけは、人が渡した1タスクを道具を使いながら自分でこなす存在であって、監督なしで目標を追い続ける存在ではありませんでした。将来 SubAgents や Fork の設計が更新されれば、この境界線は動くかもしれません。
ローカルなら課金はゼロ
Qwen Code CLI には、もともとホスト側の無料利用枠がありましたが、2026年4月15日に廃止されました(QwenLM/qwen-code の告知 issue #3203)。クラウドで叩く場合は、既定で有料になります。
けれど、本記事でやったように自分の GPU の llama-server につなぐ場合、その課金はそもそも関係ありません。ローカル接続なら、何回叩いても課金はゼロ。動かしているのは自分の電気だけです。無料枠の廃止というニュースは、ローカルで動かす私たちには、ほとんど無風でした。
RTX 4070 の 12GB VRAM + CPU-MoE で Qwen 35B が走る環境を持っていれば、Qwen Code CLI の試行を何回でも空振らせても、財布は痛みません。設定ガチャに付き合うコストは、電気代だけで済みます。
まとめ: ローカル Qwen Code CLI の勝ち筋
- Qwen Code CLI をローカル Qwen で動かすには、
llama-server --jinja -c 32768が最低ラインです - Ollama 既定テンプレートでは tool call が壊れます。
claw-codeでは動いても、Qwen Code CLI では動きません - Qwen 純正だから相性いい、という予想は外れます。相性を決めるのはチャットテンプレートと context 長です
- 自走の厚み(承認5モード、SubAgents、Fork)は Qwen Code CLI の強みですが、
-c 8192では入り口にすら立てません
ローカル LLM を Qwen Code CLI の頭脳にしたい方は、まず --jinja と -c 32768 を自分で指定するところから始めてみてください。Ollama で試して「動かない」と結論づける前に、llama-server への切り替えをおすすめします。
本記事の背景にある RTX 4070 でのローカル Qwen 35B の実運用詳細 — VRAM 12GB で 35B を押し込む CPU-MoE 構成、速度を稼ぐ3フラグ、claw-code と Qwen Code CLI の章別詳細 — は、こちらにまとめました。