
はじめに
この記事は個人の学習用として作成してます。間違いがあればご指摘ください。
- 前回はWebサーバーとAPIサーバーを1台ずつ構築し、VPC内で通信できるところまで確認した。
- 今回はAPIサーバーを複数台に増やし、ALBとAuto Scalingを組み合わせて、1台のEC2に障害が発生してもサービスを継続できる構成を作成した。
- 構築後はALBのDNS名に対して
/healthを実行し、APIから正常なレスポンスが返るところまで確認した。
今回のポイントは「EC2を2台に増やす」ことではなく、複数AZへの配置、ALBによる振り分け、ヘルスチェック、Auto Scalingによる台数維持を組み合わせて単一障害点を減らすこと。
今回作成した構成
                         Internet
                            |
                            v
                  Application Load Balancer
                         api-alb
                      HTTP : 80
                            |
                            v
                     Target Group
                        api-tg
                       /      \
                      /        \
             Availability     Availability
                Zone A           Zone C
                   |                |
            Private Subnet   Private Subnet
                   |                |
              API EC2          API EC2
                   \                /
                    \              /
                     Auto Scaling
                  api-auto-scaling

                  Desired : 2
                  Minimum : 2
                  Maximum : 4
- ALBをユーザーからのアクセスを受け付ける入口として利用する。
- ターゲットグループにAPIサーバーを登録し、ALBから正常なEC2へリクエストを転送する。
- APIサーバーはプライベートサブネットに配置し、インターネットから直接アクセスさせない。
- Auto Scaling GroupでAPIサーバーを最低2台維持し、必要に応じて最大4台まで増やせる構成とした。
- APIサーバーを複数AZへ配置することで、EC2単体だけでなくAZ障害も意識した構成にする。
今回の作業の流れ
- 冗長化前の構成で単一障害点を確認する
- APIサーバーを配置する別AZのプライベートサブネットを用意する
- APIサーバー用の起動設定を揃える
- ターゲットグループを作成する
- ALBを作成する
- ALBのリスナーからターゲットグループへ転送する
- Auto Scaling Groupを作成する
- 希望するキャパシティを2、最小2、最大4に設定する
- APIサーバーを複数のプライベートサブネットへ配置する
- ターゲットグループで2台が正常になっていることを確認する
- ALBのDNS名へアクセスし、APIレスポンスを確認する
1. 冗長化前の単一障害点を確認する
目的
- 冗長化する前に「何が停止したらサービス全体が停止するのか」を整理する。
- 前回までの構成ではAPIサーバーが1台だったため、そのEC2が停止するとAPIを利用できなくなる。
Web
 |
 v
API EC2 1台
 |
 × 停止
 |
API利用不可
- EC2を単純に2台に増やしても、同じAZへ配置するとAZ障害には対応できない。
- サーバー台数だけでなく、配置するAZも分ける必要がある。
冗長化を考えるときは「何台あるか」だけでなく「同じ障害でまとめて停止しないか」を確認する。
2. 別AZのプライベートサブネットを利用する
目的
- APIサーバーを複数のAZへ分散することで、1つのAZに障害が発生した場合の影響を減らす。
- APIサーバーは外部ユーザーから直接アクセスさせる必要がないため、プライベートサブネットに配置する。
作業
- 既存VPC内で異なるAZのプライベートサブネットを確認する
- Auto Scaling GroupでAPIサーバーを配置するサブネットとして複数AZのプライベートサブネットを指定する
AZ-A
└─ Private Subnet
   └─ API EC2

AZ-C
└─ Private Subnet
   └─ API EC2
インターネット向けALBを配置するサブネットと、APIサーバーを配置するサブネットは役割が異なる。ALBはインターネットからアクセスできるPublic Subnet、APIサーバーはPrivate Subnetに配置する。
3. APIサーバーの起動設定を揃える
目的
- Auto ScalingがEC2を新しく起動した場合でも、毎回同じ構成のAPIサーバーを作れるようにする。
- AMI、インスタンスタイプ、Security Groupなどの設定を共通化する。
作業
- APIサーバーとして利用するAMIを指定する
- インスタンスタイプを設定する
- API用Security Groupを設定する
- Auto Scalingから利用する起動設定として保存する
Auto Scalingでは「既存EC2をそのまま増やす」のではなく、新しいEC2を同じ設定で再作成できることが重要になる。
4. ターゲットグループを作成する
目的
- ALBがリクエストを転送するAPIサーバーをまとめて管理する。
- EC2の正常性をヘルスチェックし、異常なEC2へ通信を送らないようにする。
ALB
 |
 v
api-tg
 ├─ API EC2-1
 └─ API EC2-2
作業
- ターゲットタイプとしてEC2インスタンスを利用する
- APIサーバーが待ち受けるポートを設定する
- ヘルスチェックでAPIが正常に応答できるパスを設定する
- 後ほどAuto Scaling Groupと関連付ける
今回の最終確認では、api-tg に2台のEC2が登録され、両方とも正常になっていることを確認した。
ターゲットグループを作成できたことだけでは確認として不十分。登録したターゲットが healthy / 正常 になっているところまで確認する。
5. Application Load Balancerを作成する
目的
- ユーザーからのアクセスを1つの入口で受け付け、複数のAPIサーバーへ振り分ける。
- APIサーバー個別のIPアドレスをユーザーに意識させない。
- 障害が発生したEC2への通信を止め、正常なEC2へリクエストを送る。
Client
  |
  v
 ALB
 / \
v   v
EC2 EC2
作業
- Application Load Balancerを作成する
- インターネット向けとして設定する
- 複数AZのPublic Subnetを指定する
- HTTP:80のリスナーを作成する
- デフォルトアクションとして
api-tgへ転送する
今回の構成では、
- ALB名:
api-alb - リスナー:HTTP:80
- 転送先:
api-tg - 登録ターゲット:2台
となっている。
6. ALB用Security Groupを設定する
目的
- インターネットからALBへのHTTP通信を許可する。
- APIサーバーへの直接アクセスではなく、ALB経由の通信に制限する。
通信の考え方
Internet
   |
   | HTTP:80
   v
ALB Security Group
   |
   | HTTP
   v
API Security Group
   |
   v
API EC2
- ALB側では利用者から必要なポートを許可する。
- APIサーバー側ではALBのSecurity Groupを通信元として許可する。
- APIサーバーを
0.0.0.0/0へ公開しない。
Security Groupの通信元に別のSecurity Groupを指定すると、IPアドレスを固定して管理せず「ALBから来た通信だけ許可する」という制御ができる。
7. Auto Scaling Groupを作成する
目的
- APIサーバーの必要台数を自動的に維持する。
- EC2が停止した場合に新しいEC2を起動し、必要な台数へ戻す。
- 将来的に負荷が増えた場合、台数を増やせる構成にする。
今回の設定
- 希望するキャパシティ:2
- 最小キャパシティ:2
- 最大キャパシティ:4
- APIサーバー用の複数プライベートサブネットを指定
- ターゲットグループ
api-tgと関連付ける
Minimum 2
   ↓
[EC2] [EC2]

負荷増加時

[EC2] [EC2] [EC2] [EC2]
                     ↑
                  Maximum 4
各値の意味
- 最小キャパシティ:最低限維持するEC2台数
- 希望するキャパシティ:通常時に維持したいEC2台数
- 最大キャパシティ:スケールアウトできる上限
今回の目的は最低2台を維持することなので、希望するキャパシティと最小キャパシティを2に設定した。
8. Auto ScalingでEC2が起動したことを確認する
確認観点
- Auto Scaling Groupの「インスタンス管理」で2台存在する
- インスタンスのライフサイクルが
InServiceになっている - ターゲットグループへ2台登録されている
- ヘルスチェックが2台とも正常になっている
作成直後はEC2一覧だけを見るのではなく、Auto Scaling Group、ターゲットグループ、ALBのリソースマップを順番に確認する。
9. ALBのリスナーとターゲットの関連付けを確認する
最終的な関連付けは次の流れになる。
HTTP:80 Listener
      |
      v
Default Rule
      |
      v
Target Group
   api-tg
   /   \
  v     v
EC2    EC2
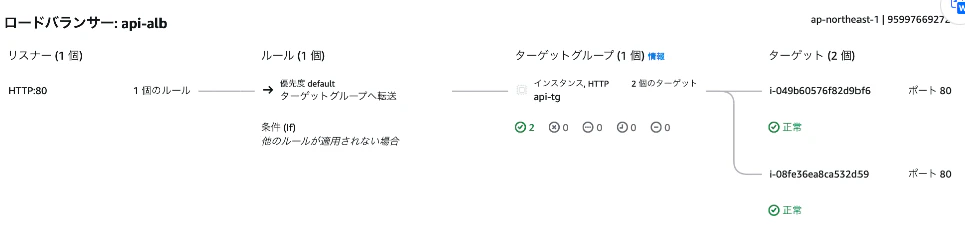
今回のリソースマップでは、
- リスナー:1
- ルール:1
- ターゲットグループ:1
- ターゲット:2
- 異常ターゲット:0
となっている。
10. ロードバランサー経由でAPIの疎通確認を行う
ALBには固定のEC2 Public IPではなくDNS名が付与される。
MacからALBのDNS名へ直接アクセスして確認した。
curl http://<ALBのDNS名>/health
curl はHTTPリクエストを送り、WebサーバーやAPIのレスポンスをターミナル上で確認するために利用する。
今回の結果は、
{"message":"API接続に成功しました"}
となり、
Mac
 ↓
ALB
 ↓
Target Group
 ↓
API EC2
 ↓
JSON Response
まで通信できることを確認した。
ブラウザだけでなくcurlを利用すると、HTTP通信そのものが成功しているかを簡単に確認できる。
何が止まったらサービスが停止するのか
今回の構成を作る上で、個々のAWSサービスが停止したときの影響を整理した。
API EC2が1台停止
EC2-A ×
EC2-B ○
- ターゲットグループのヘルスチェックでEC2-Aを異常として判定する
- ALBは正常なEC2-Bへ通信する
- Auto Scalingが必要台数を下回ったことを検知し、新しいEC2を起動する
API EC2が1台停止しただけでは、サービス全体を止めない構成になる。
1つのAZが停止
AZ-A ×

AZ-C
└ API EC2 ○
- APIサーバーを別AZへ配置していれば、正常なAZ側へ通信を継続できる。
- 複数AZへ配置する理由は、EC2障害だけではなくAZ単位の障害へ備えるためでもある。
API EC2がすべて停止
- ALBの転送先が存在しなくなるためAPIを利用できなくなる。
- Auto Scalingが新しいEC2を起動し、ヘルスチェックに合格するまでサービス影響が発生する。
ALBの設定を誤る
- リスナーやターゲットグループへの転送設定が誤っていると、EC2が正常でもユーザーからAPIへ到達できない。
- ALBは入口となるため、設定変更時の影響範囲が大きい。
Security Groupを誤る
- ALBからAPIサーバーへの通信を許可していなければ、ターゲットがUnhealthyになる。
- EC2やアプリケーション自体が正常でも、ネットワーク制御によってサービス停止状態になる場合がある。
同じアプリケーション障害が全EC2へ入る
- Auto Scalingはサーバー台数を維持する仕組みであり、不具合のあるアプリケーションを修正する仕組みではない。
- 同じAMIや設定に問題がある場合、新しくEC2を作り直しても同じ障害が再現する。
冗長化は「何が壊れても絶対に止まらない」という意味ではない。どの障害まで耐えられる構成なのかを決めることが重要になる。
再度構築するときの作業順
- VPCと既存ネットワークを確認する
- 複数AZのPublic / Private Subnetを確認する
- APIサーバー用Security Groupを確認する
- APIサーバーを同一構成で起動できる設定を作る
- ターゲットグループを作成する
- ヘルスチェックを設定する
- ALB用Security Groupを作成する
- ALBを複数Public Subnetに作成する
- HTTP:80リスナーを作成する
- リスナーからターゲットグループへ転送する
- Auto Scaling Groupを作成する
- 複数Private Subnetを指定する
- 希望2・最小2・最大4を設定する
- Auto Scaling Groupとターゲットグループを関連付ける
- EC2が2台起動することを確認する
- ターゲットグループで2台が正常になることを確認する
- ALBのDNS名に
curlでアクセスする - APIレスポンスが返ることを確認する
今回つまずいたところ
Auto Scaling Groupを作成したがEC2一覧で起動を確認できなかった
- Auto Scaling Group作成後、EC2のインスタンス一覧だけでは起動を確認できず、設定に問題があるのか判断できなかった。
- Auto Scaling Groupの希望するキャパシティが2、スケーリング制限が2〜4であることを確認した。
- その後、ターゲットグループとALBのリソースマップを確認し、EC2が2台登録され正常になっていることを確認した。
Auto Scalingの確認ではEC2一覧だけを見るのではなく、「Auto Scaling Group → インスタンス管理 → ターゲットグループ → ヘルスチェック」の順で確認すると原因を切り分けやすい。
ターゲットグループの「作成成功」と「正常」を混同した
- ターゲットグループの作成が成功していても、EC2への通信が成功しているとは限らない。
- 登録済みターゲットが
healthy / 正常になっていることまで確認して、初めてALBから転送可能な状態だと判断する。
Public SubnetとPrivate Subnetの役割を整理した
- インターネット向けALBを配置するサブネットと、API EC2を配置するサブネットを同じものとして考えないようにした。
- ALBは外部からリクエストを受けるPublic側、APIサーバーは外部から直接アクセスさせないPrivate側に配置する。
今回学んだこと
- 冗長化ではEC2の台数だけでなくAZを分ける必要がある
- ALBは複数のEC2へアクセスを振り分ける入口になる
- ターゲットグループはALBの転送先となるEC2を管理する
- ヘルスチェックによって異常なEC2を通信対象から外せる
- Auto Scalingは必要なEC2台数を自動的に維持する
- 希望・最小・最大キャパシティにはそれぞれ役割がある
- APIサーバーをPrivate Subnetへ置くことで直接公開を避けられる
- Security Group同士を使ってALBからAPIへの通信だけを許可できる
- 「作成成功」だけではなく、実際の疎通とヘルスチェックまで確認する必要がある
- 障害時に何が残り、どこまでサービスを継続できるのかを考えることが冗長化設計では重要になる
この構成でできること
- APIサーバーを最低2台稼働させる
- ALBから複数APIサーバーへアクセスを振り分ける
- 異常なEC2を自動的に通信先から除外する
- EC2が不足した場合にAuto Scalingで新しいEC2を起動する
- 最大4台までAPIサーバーを増やせる
- EC2単体障害によるサービス停止リスクを下げる
- 複数AZへ配置することでAZ障害の影響を軽減する
- APIサーバーをインターネットへ直接公開しない構成にできる
今後改善したい点
- ALBをHTTPS化し、ACMの証明書を利用する
- Auto ScalingのCPU使用率などを利用したスケーリングポリシーを設定する
- CloudWatchでALB、EC2、Auto Scalingのメトリクスを監視する
- ALBアクセスログを取得する
- EC2を実際に1台停止し、ALBの切り替えとAuto Scalingの自動復旧を確認する
- NAT Gatewayを1つしか利用していない場合、外向き通信側の単一障害点についても検討する
今回の構成でAPIサーバーは冗長化できたが、システム全体が完全に冗長化されたわけではない。DB、NAT Gateway、監視、デプロイ方式など、他レイヤーにも単一障害点が残っていないか確認する必要がある。
まとめ
- 今回はALB、ターゲットグループ、Auto Scaling Groupを組み合わせ、APIサーバーを複数台で稼働させる構成を作成した。
- ALBのDNS名に対して
/healthを実行し、2台のターゲットが正常な状態でAPIレスポンスを取得できることを確認した。 - 単にサービスを作成するだけでなく、「どこが単一障害点になるのか」「1台止まった場合に何が起きるのか」という観点を持って構成を見ることが、冗長化を理解する上で重要だと学んだ。
追加学習
障害試験:EC2を1台終了してAuto Scalingの自動復旧を確認
目的
- 冗長化構成を作成しただけで終わらせず、実際にEC2が1台停止した場合でもサービスを継続できるか確認する。
- Auto Scalingが希望するキャパシティ「2」を維持し、新しいEC2を自動的に起動できることを確認する。
なぜこの確認を行ったか
- EC2を2台配置していても、障害発生時にALBやAuto Scalingが想定どおり動かなければ冗長化したとは判断できない。
- 「1台を意図的に終了 → 残り1台で稼働 → 新しいEC2を自動生成 → 2台構成へ復旧」という一連の動作まで確認することにした。
実施したこと
- Auto Scalingで稼働しているEC2のうち1台を意図的に終了する。
- Auto Scalingのアクティビティ履歴から、異常なインスタンスの代替として新しいEC2が起動されたことを確認する。
- ターゲットグループを確認し、新しく起動されたEC2を含む2台が
Healthyに戻ることを確認する。
EC2 × 2
   ↓
1台を終了
   ↓
EC2 × 1
   ↓
Auto Scalingが新しいEC2を起動
   ↓
ターゲットグループへ登録
   ↓
EC2 × 2 / 両方Healthy
今回、新しいインスタンスIDでEC2が自動作成され、最終的にターゲットグループの2台がどちらもHealthyへ戻った。単純な再起動ではなく、Auto Scalingによる置き換えが実行されたことを確認できた。
エビデンス
障害発生直後
-
EC2を1台終了し、一時的に1台だけ稼働している画面
→ 想定内容:「障害発生直後」のエビデンス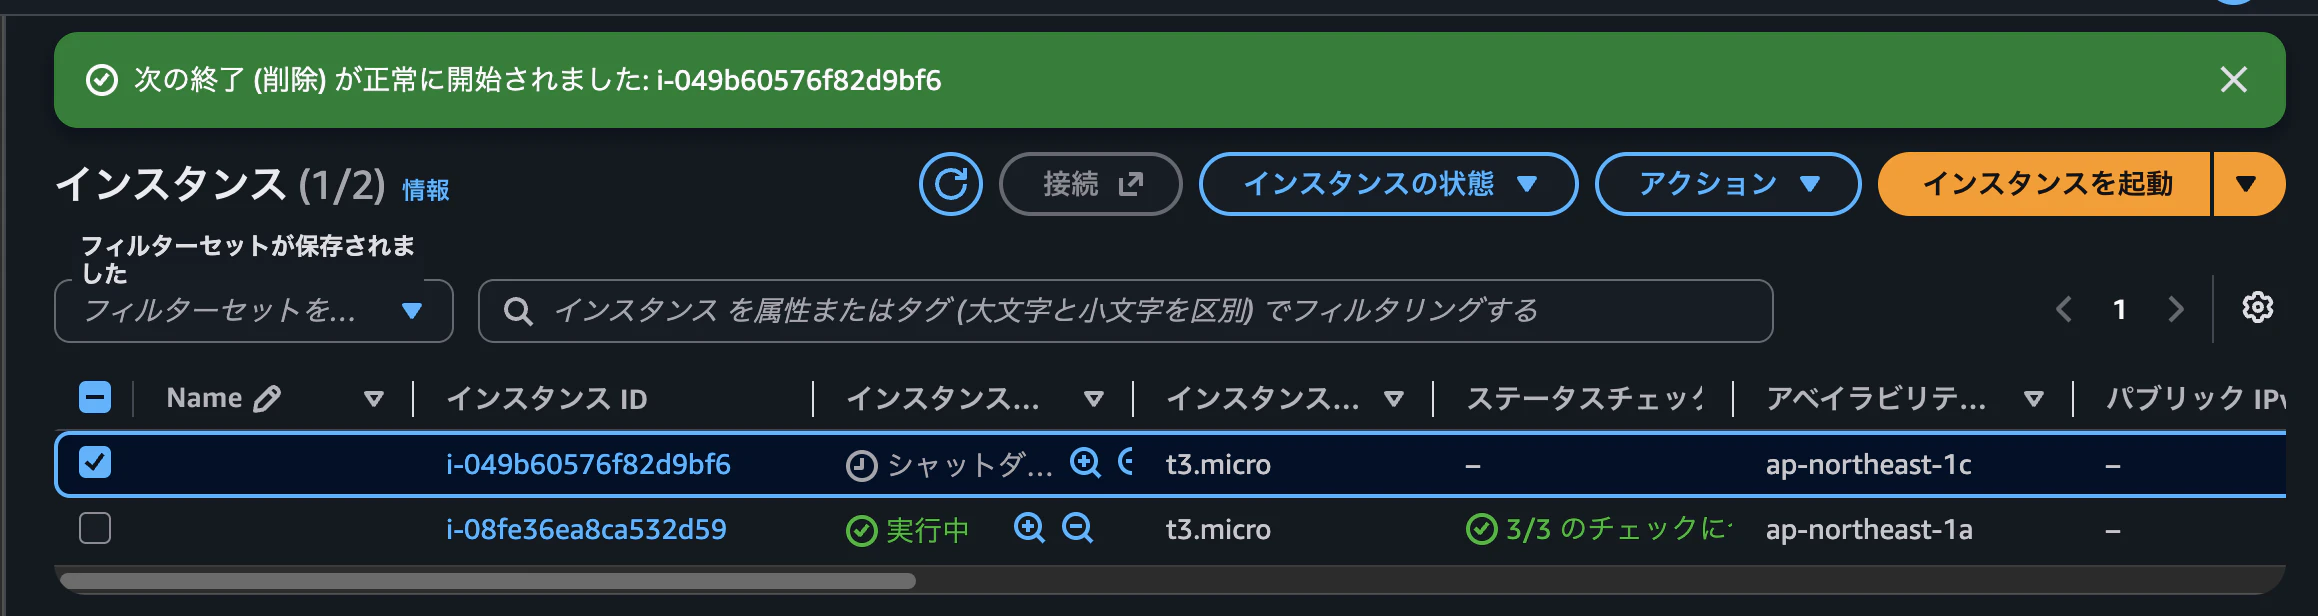
復旧完了
-
ターゲットグループで2台とも
Healthyになった画面
→ 「自動復旧完了」として想定したのエビデンス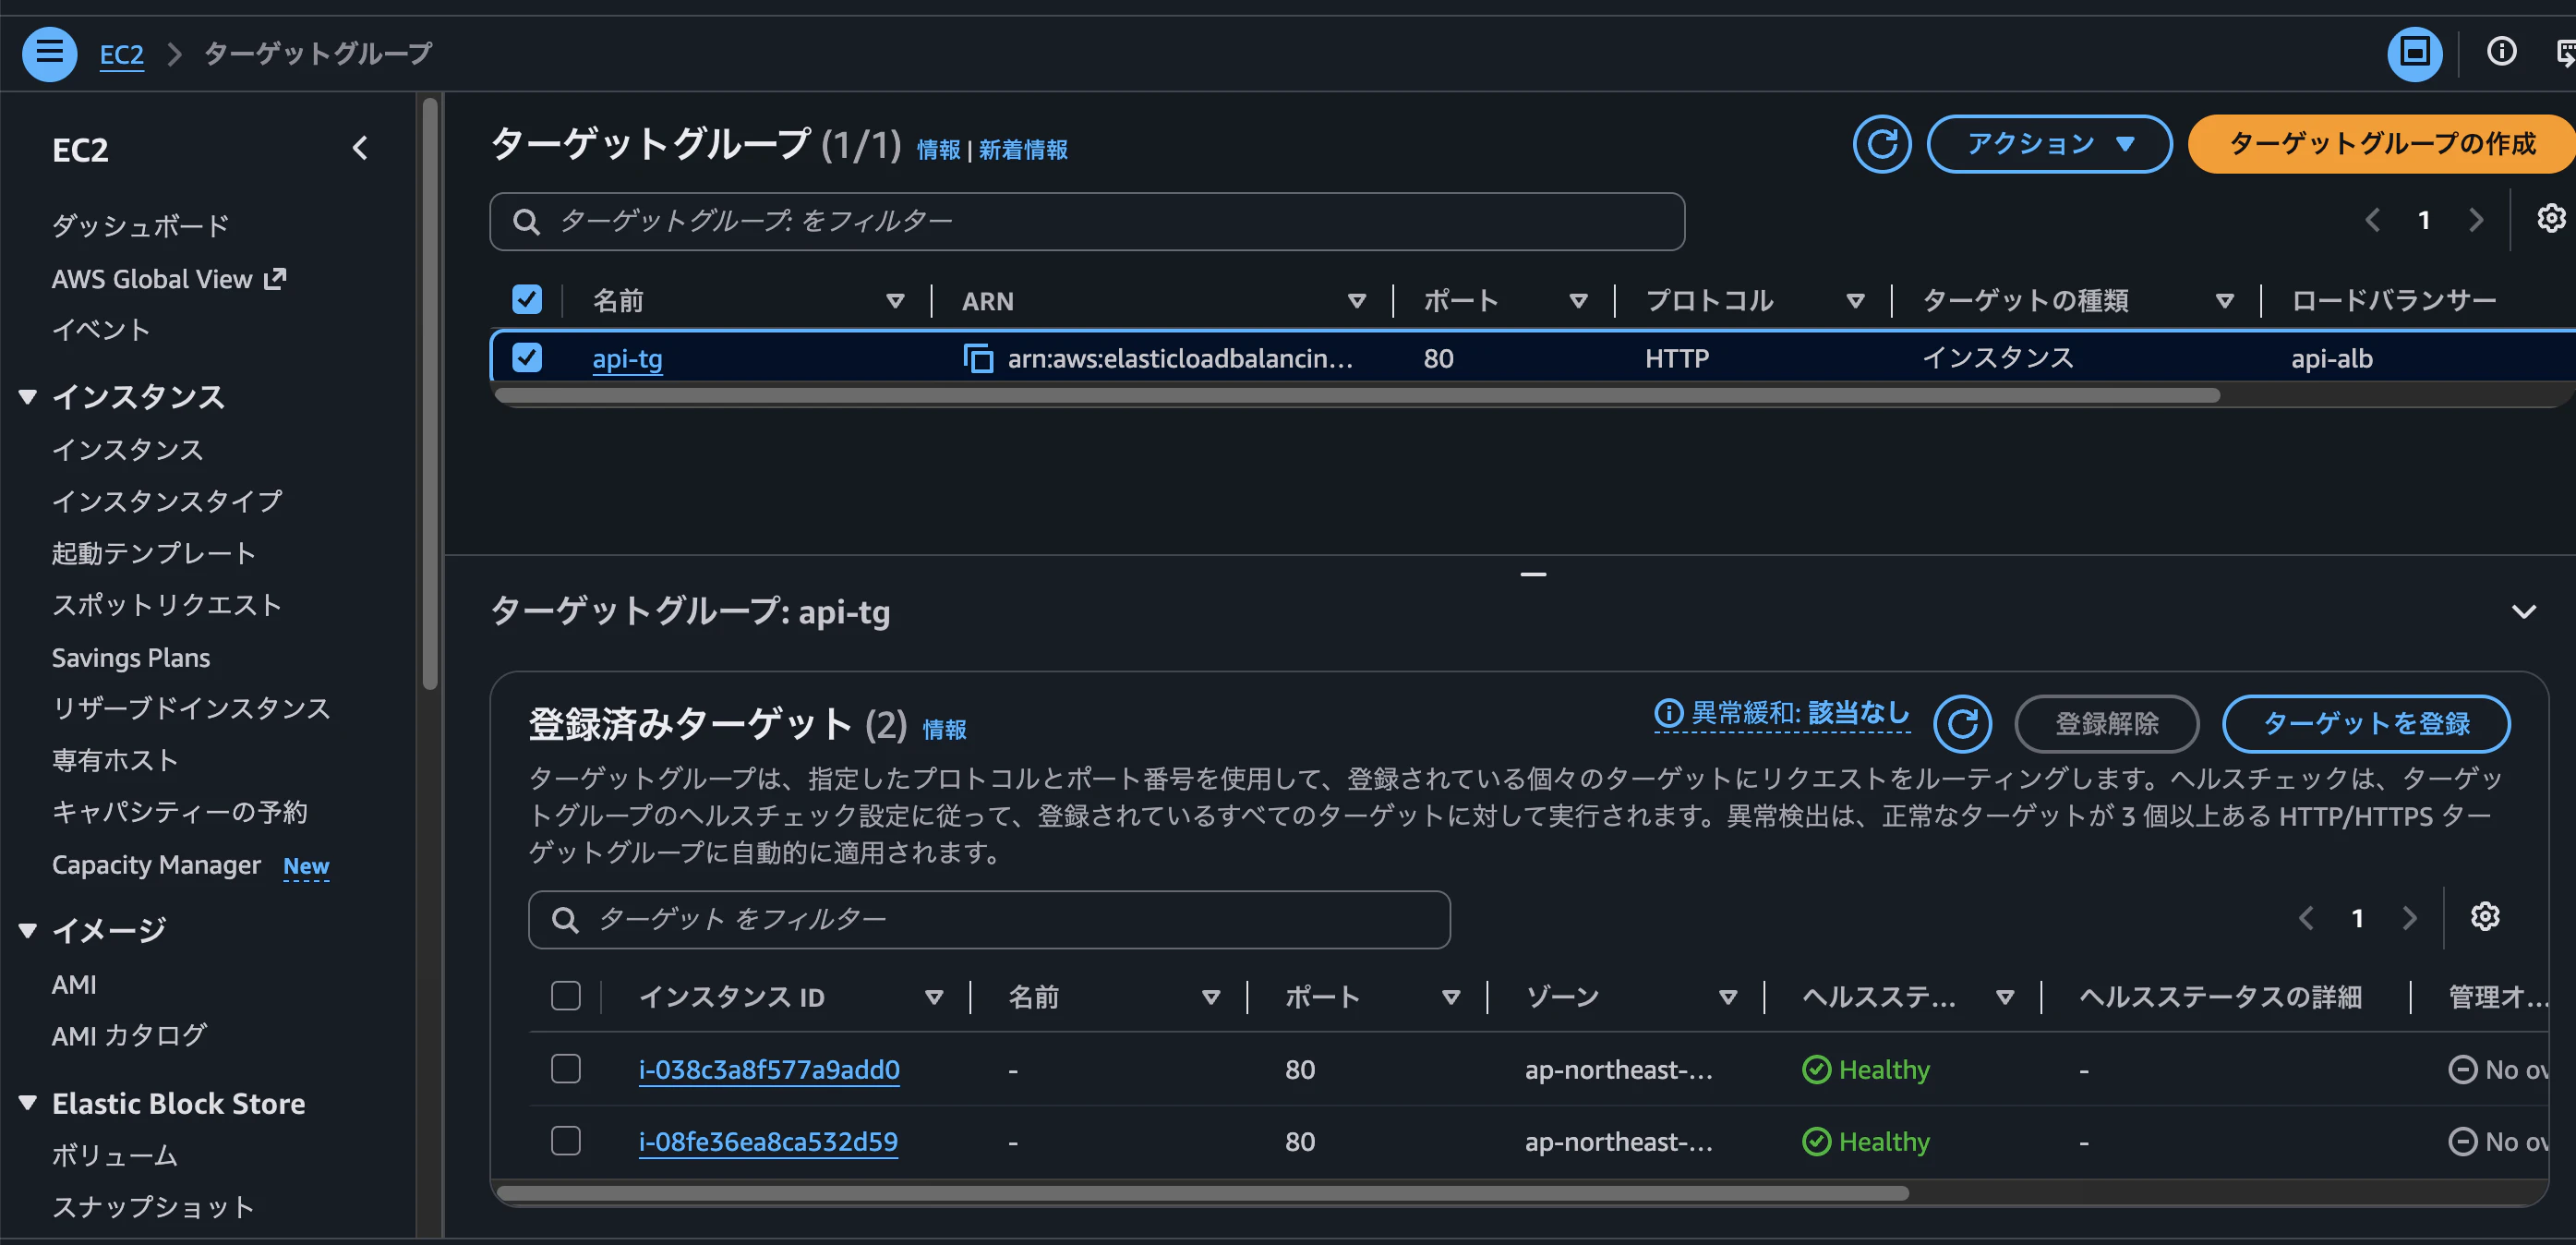
わかったこと
- Auto ScalingはEC2の台数を増減するだけでなく、異常になったEC2を新しいEC2へ置き換え、希望する台数を維持できる。
- ALBとターゲットグループを組み合わせることで、異常なEC2を通信先から外し、正常なEC2を利用できる。
- 冗長化は「複数台作った」だけではなく、実際に障害を発生させて復旧まで確認することが重要だと理解した。