
はじめに
AIコーディングを使い始めてから、ずっと引っかかっていたことがあります。
「AIで開発速度が何倍にも上がる」と言われる一方で、最後にはだいたいこう言われます。
最終的な判断と責任は人間が持つ。
それ自体は正しいと思います。
でも、AIが人間よりはるかに速くコードを書き、Issueを処理し、PRを作れるようになったとき、そのPRを人間が全部読んで判断する運用は本当にスケールするのか? という疑問が残りました。
もしAIが1日に100本、1000本と変更を作れるなら、人間がその全部をコードレビューするモデルは、AIではなく人間がボトルネックになります。
そこで逆に考えました。
人間が本当に決めなければならないことだけ残して、それ以外はAIに持たせられないか。
その実験として作ったのが Human-on-Exception です。
きっかけは「それ、人間がやる必要ある?」だった
普段はWebエンジニアとして働きつつ、個人でもAIを使った開発をいろいろ試していました。
AIを使って実装を進めているうちに、コードを書くことだけでなく、設計、Issue分割、テスト、ドキュメント更新、PR修正までかなりAIに任せられることが分かってきました。
そこで、今までテックリードやエンジニアの価値だと思っていたものに対して、何度も同じ疑問が出ました。
- アーキテクチャを考えるのは、毎回人間である必要があるのか
- DDDやレイヤ分割を適用するのは、人間の仕事である必要があるのか
- Issueを分割して依存順を決めるのは、人間がやらないといけないのか
- 単体テストやドキュメントを人間が細かく読む必要があるのか
- PRを人間が1行ずつレビューしないと「責任を持った」と言えないのか
もちろん、AIは間違えます。
でも人間も間違えます。テストも100%ではありません。レビューを増やしても、不具合が完全にゼロになることはありません。
だったら目指すべきは「絶対に失敗しない開発」ではなく、
意味を勝手に変えないこと、失敗を検知できること、検知したら修正できること、そしてそのループを人間の注意力に依存しすぎないこと
なのではないか、と考えるようになりました。
Human-on-Exception の基本方針
Human-on-Exception の一番大きなルールはこれです。
Humans decide intent and boundaries. AI owns execution.
日本語にすると、
人間は意図と境界を決める。AIは実行を持つ。
という考え方です。
人間が決めるのは、主に次のようなものです。
- 何を作りたいか
- どこまでを今回のScopeにするか
- 複数の意味が成立する場合、どれを正とするか
- 何を同じ意味として扱い、何を別概念として残すか
- セキュリティ、プライバシー、コストなどのリスクを許容するか
逆にAI側が持つのは、
- repositoryの調査
- 設計
- Issue作成と分割
- 実装
- テスト
- 静的解析
- ドキュメント更新
- PR作成
- レビュー指摘の分類と修正
- 再検証
です。
つまり、「人間が最後に全部読む」のではなく、AIが決めてはいけない意味だけを人間へ返すようにしています。
最初はレビュー工程だけを強くすればよいと思っていましたが、実際には要件の曖昧さ、仕様補完、更新漏れ、再検証、マージ条件まで含めて設計する必要がありました。
まず、普通の開発工程をそのまま分解した
Human-on-Exceptionがやっているのは、開発工程そのものをなくすことではありません。
各工程で、人間が本当に必要なところだけ残すことです。
- 要件を決める — 何を作るか・どこまで作るか(Intent / Scope)を人間が決める
- 仕様を決める — AIがrepositoryを調べ、意味が分かれるところだけ人間に質問する
- コードを書く — AIが設計・実装・テスト・docs更新まで行う
- レビューする — 実装AIとは別contextのAIが、diffと変更されるべき範囲を確認する
- マージ条件を確認する — tests、docs、survey、review、最新headのchecksなど、必要な証拠が揃ったらマージする
この中で、人間に戻す必要がある判断を切り出すのがQuestionsです。
Questions は「分からないこと一覧」ではない
この仕組みで重要なのが Questions です。
最初は自分も、AIが分からないことを人間に質問するためのファイルとして作っていました。
ただ、使っていくうちに変わりました。
今は、
Questions = AIに決定権がないことだけを人間へ返すための「判断待ち一覧」
として扱っています。
たとえば、frameworkの構成、file placement、普通のlayer分割、transactionの張り方などは、repositoryのルールからAIが決められるなら人間に聞きません。
一方で、
「この記録は後からマスターが変わったとき、過去の確定記録まで意味が変わるのか?」
「この操作は本人の記録なのか、代理で登録する記録なのか?」
のように、ユーザーへの約束そのものが変わる場合は人間へ戻します。
ここで前提にしているのは、要件定義の粒度は人によってかなり違うということです。
数行の箇条書きだけ渡す人もいれば、画面仕様やAPI、DB設計までかなり細かく決めてから渡す人もいます。Human-on-Exceptionでは、人間に最初から「正しい粒度の要件書」を書くことは求めません。
入力が粗ければ、AIがrepositoryや既存ルールを調べたうえで、実装可能になるまで不足している意味の決定だけをQuestionsとして切り出します。逆に、すでに十分決まっている部分はそのまま使います。
つまり、入力の粒度を人間側で揃えるのではなく、途中で実装可能な仕様契約(Decision Contract)の粒度へそろえるイメージです。
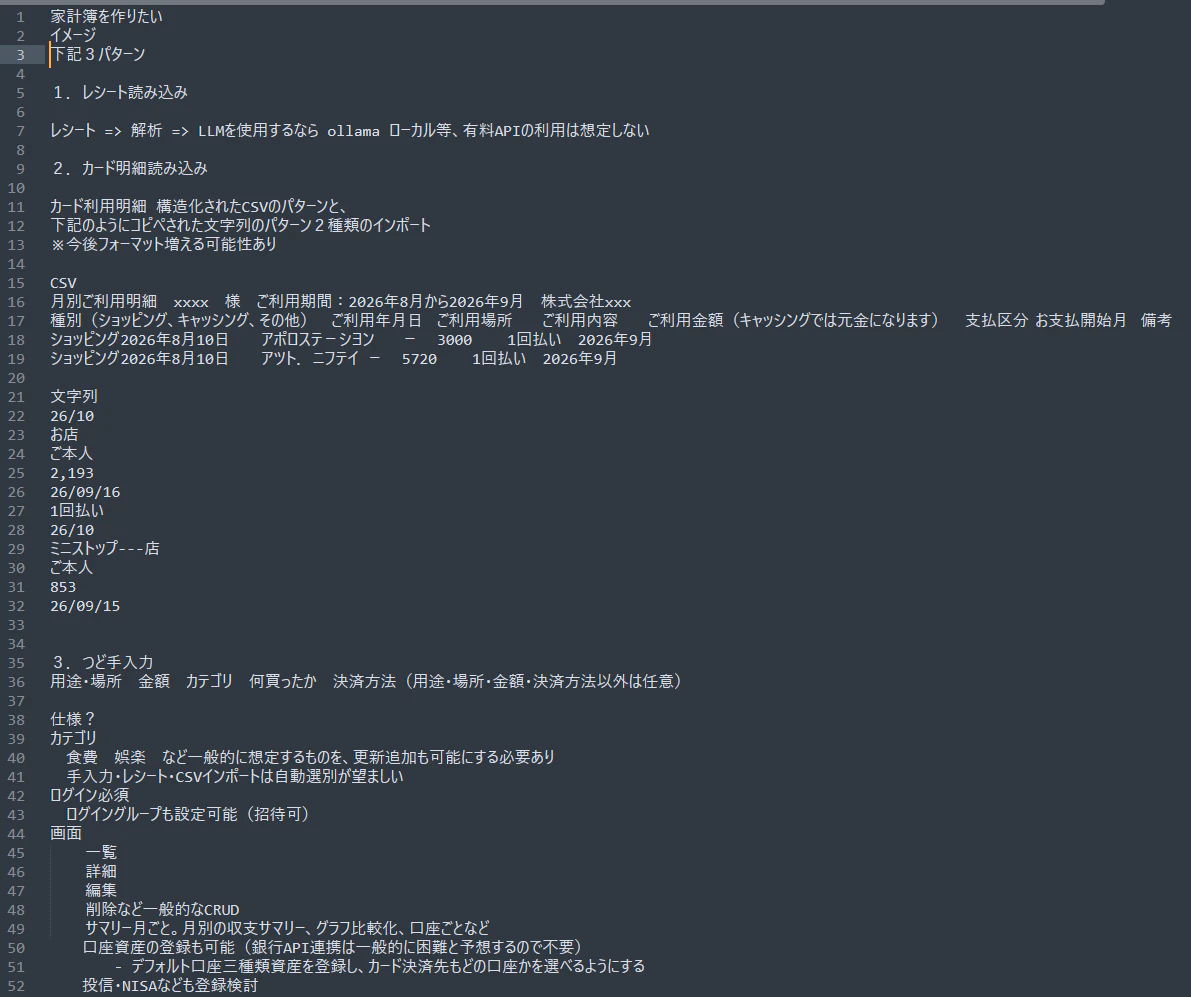
最初に渡した要件はこの程度でした。DB設計やAPI設計、Issue分割までは指定していません。
このPromptから、AIは「収入を月次収支に含めるか」「クレジットカードを資産として扱うのか支払手段として扱うのか」「利用月と支払月のどちらを集計基準にするか」「レシート画像を保存するか」といった、実装ではなくプロダクトの意味が変わる論点をQuestionsとして出しました。

たとえば『8月に利用して9月に支払うカード明細を、どちらの月の支出として扱うか』は、実装方法ではなく家計簿の集計ルールそのものなので、人間へQuestionとして返します。
ここで面白かったのは、最初のQuestionsに全部答えたら終わりではなかったことです。
たとえば「収入も扱う」と回答すると、今度は「収入には何を必須項目とするか」「支出カテゴリと収入カテゴリは同じ概念なのか」という新しい論点が生まれます。
そのため Human-on-Exception では、
Questions → Answers → 再調査 → 必要なら追加Questions
を、意味の未決がなくなるまで繰り返します。
「元の質問に全部答えたから仕様確定」という扱いにはしていません。
5つのPromptは、その工程を動かす入口
実際の操作用には5つのPromptを用意しています。
- Define Questions — 要件から仕様上の未決を探し、人間にしか決められない論点を抽出
- Apply Answers / Create Issue — 回答を仕様・受け入れ条件(AC)へ落とし、再調査して未決事項が0ならIssue化
- Implement Issue / PR — コード、テスト、docs、PRまでAIが実行
- Resolve PR Review Findings — 別AIのレビュー指摘を「修正が必要」「誤検知」「人間判断が必要」に分類し、修正と再検証を行う
- Merge — テスト、ドキュメント、survey、レビュー、最新コミットのチェック結果など、マージ条件を確認してmerge
重要なのは、これを「5回人間が承認するワークフロー」にはしていないことです。
すでに許可された工程はAIが継続します。人間へ戻すのは、意味やリスクの判断が新しく必要になったときだけです。
「最後は人間が責任を持つ」をどう解釈したか
自分が一番モヤモヤしていたのは、「責任を持つ = 最後に人間がコードを全部読む」になっていないかということでした。
AI開発における人間の責任を、
何を正しいとするか、どこまで自動で進めてよいか、どのリスクを許容するかを決めること
と捉えるなら、コードレビューそのものを人間の必須ゲートにする必要はありません。
その代わりに、人間の目視に依存しすぎず品質を確認できる仕組みを重ねます。
テストを信仰しない。でもテストは重要
テストだけで100%の正しさは証明できません。仕様が間違っていれば、その間違いを正しくテストすることもできます。
なので、1つの検証方法に全部を背負わせません。
- Questions / AC — 何が正しいかを定義
- System Test / FE contract — 外から見える振る舞いを確認
- Unit test / static analysis — 内部の破壊を拾う
- Independent AI Review — テストで想定していない穴を探す
- omitted-file audit / docs — 更新漏れや契約の不整合を確認
テストを減らすのではなく、人間がテストの細部を全部読む必要をなくす方向です。
独立AIレビューは「同じチャットでセルフレビュー」ではない
reviewerは実装AIとは別session / 別contextで動かします。
見るのはPRのdiffだけではありません。今回の変更なら本来どのファイルまで更新されるべきかを先に考え、diffにないtest、API type、fake、flow/UI/validation/DB docsまで確認します。
これをSoT and omitted-file auditと呼んでいます。CIがgreenでも拾いにくいrace conditionや、frontend/backend間の解釈差、assert漏れなどが見つかることがあります。
AI reviewerも100%ではないので、独立性の違う複数の検証を重ね、未実施・pending・確認不能を成功扱いしないようにしています。
repository全体を毎回読ませない
長時間AI開発ではcontext量も問題になります。
そのため、基本の入口を
core feature → Pack / Flow → テスト → 実装 → 必要なルール
に絞っています。Packは、AIに必要な実装コンテキストを狭く渡すための索引です。
情報の役割も分けています。conceptは目的、ADRは設計判断、Policyは反復基準、Questionsは意思決定履歴、Issue ACは今回のtarget contract、code/tests/docsは現在の挙動を持ちます。
current state と「変更後の正解」を分けた
既存repositoryでは、実装 → システムテスト → Flow → coverageの順で「今どうなっているか」を確認します。
ただし、それを「今後もそうあるべき」の根拠にはしません。変更後の正解は、受け入れ済みの回答 / Issue AC + 有効な決定事項です。
これを分けないと、既知bugまで「現在のSoTだから正しい」と保存してしまいます。
これで人間が不要になる、とは思っていない
Human-on-Exceptionは「人間はいらない」という話ではありません。
むしろ、人間の注意力を、本当に人間にしか決められない場所へ集中させたいという発想です。
まだ課題もあります。
- 複数AIエージェントを並列実行したときの競合
- 長期運用で増えるADR / Policyの整理
- property-based testやfuzzingなど、追加できる機械的検証
- modelやtoolが変わってもrulesが同じように守られるか
- AIそのものの見落とし
「完全自動開発が完成した」とは思っていません。
ただ、少なくとも自分の個人開発では、人間がコードを書き、全diffを読み、全testを確認しないと開発できないという前提はかなり崩れました。
おわりに
Human-on-Exception を作り始めた理由を一言でいうと、たぶんサボりたかったからです。
100行の要件を毎回全部読みたくない。
大量のdiffを全部レビューしたくない。
docsの同期漏れを目視で探したくない。
unit testのためだけに本番コードを歪めたくない。
でも、雑にAIへ丸投げして壊れるのはもっと嫌でした。
だから、意味のある判断だけ人間がする。意味のない作業はできるだけAIへ渡す。
その方向で半年ほど個人開発を続けた結果、今の形になりました。
AIがどこまでエンジニアの仕事を変えるのかは、自分にもまだ分かりません。
ただ、AIが速くなるほど「人間が全部を見る」開発モデルは苦しくなると思っています。
だったら、人間を高速化するだけではなく、人間が見る必要のあるもの自体を減らす開発プロセスを考えてもいい。
そのための自分なりの実験です。
使ってみた感想も、「ここは危ないんじゃないか」というツッコミも歓迎です。