
はじめに
生成AIの活用領域は、テキストチャットから音声へと広がっています。
特にコールセンターやカスタマーサポートでは、
- オペレーター不足
- 問い合わせ件数の増加
- 24時間対応へのニーズ
- 応対品質の均一化
- FAQ・マニュアル検索の効率化
といった課題から、AIを活用した顧客対応への期待が高まっています。
市場の背景と関連する技術に関しては、以下の動画も参考になりました。
デロイトの日本版「グローバルコンタクトセンターサーベイ2024」では、海外企業全体の 83%が2025年までに生成AIをコンタクトセンター業務へ本格導入済み、または導入予定としています。デロイトは生成AIを、単に質問へ答えるだけでなく、問題解決や手続き完了まで支援する「見届け型サポート」につながる技術として位置付けています。
グローバルコンタクトセンターサーベイ2024
さらに2026年のSalesforce調査では、顧客サービス組織におけるAIエージェント利用率が 2025年の39%から2026年には66%へ上昇しています。また導入企業の70%が、60日以内に何らかの測定可能な価値を確認したとしています。
New Research: AI Service Agents Are Scaling and Delivering CSAT
日本でも OKI電気さんが、次世代コンタクトセンターシステム「CTstage®シリーズ」の新商品として、AIを活用した「CTstage AIコンシェルジュ」を発表されました。
音声AIの技術動向
2024年10月1日に OpenAI が Realtime API を発表し、低遅延の Speech-to-Speech アプリケーションを開発できるようになりました。
その後 2025年8月28日に Realtime API が正式版となり、gpt-realtime が登場。SIPによる電話接続、Remote MCP、画像入力などが追加され、「デモ用音声AI」から「業務用音声エージェント」にかなり近づきました。
そして 2026年7月8日に GPT-Live が発表され、GPT-Live-1 / GPT-Live-1 mini が ChatGPT Voice に導入されました。ここで大きいのが、単に音声をリアルタイム処理するだけでなく、聞きながら話せる Full Duplex(全二重)アーキテクチャになったことです。
さらに、つい先日の 2026年9月10日に GPT-Live-1 が API で一般提供されました。
コールセンターで進むAI活用
音声AIはどのように進化してきたか
従来の音声AI
従来の音声AIでは、一般的に次のような構成が使われます。
ユーザーの音声
↓
STT(Speech-to-Text)
↓
LLM
↓
TTS(Text-to-Speech)
↓
AIの音声
まず STT(Speech-to-Text) でユーザーの音声をテキストに変換します。
次に、そのテキストを LLM(Large Language Model) に入力し、回答文を生成します。
最後に TTS(Text-to-Speech) で生成された回答文を音声へ変換し、ユーザーに返します。
この方式は、それぞれの処理を独立したサービスやモデルとして組み合わせられるため、柔軟にシステムを構成できるというメリットがあります。
一方で、
- 音声認識
- LLMによる回答生成
- 音声合成
という複数の処理を順番に実行するため、処理ごとに待ち時間が発生します。また、ユーザーの発話途中での割り込みや、相づち、自然な話者交代などを実現するには、アプリケーション側で追加の制御が必要になります。
OpenAI Realtime API の登場
OpenAI は 2024年10月に Realtime API を発表しました。
Realtime API は、音声をいったんテキスト化してから処理する従来の構成ではなく、音声を入力し、音声で応答する Speech-to-Speech のリアルタイム対話を構築するためのAPIです。
従来のような、複数の処理をアプリケーション側で組み合わせる必要がなく、Realtime API を介して音声を直接モデルへ入力し、そのまま音声レスポンスを受け取ることができます。
また、WebRTC や WebSocket などの低遅延通信を利用できるため、音声アシスタントやリアルタイム翻訳、カスタマーサポートなど、人との自然な会話が求められる用途を想定した仕組みになっています。
GPT-Live の登場
2026年7月、OpenAI は新しい音声モデル GPT-Live を発表しました。
GPT-Live の大きな特徴は、Full Duplex(全二重) の音声対話に対応していることです。
OpenAI Realtime でも、かなりレスポンスの良い処理を実装することができてはいましたが、「ターン制」である点は否めない部分がありましたが、GPT-Live では、聞くことと話すことを同時に行うことができる真のリアルタイムな会話へと進化したと思います。
単に双方向というだけではなく
- ユーザーが話している途中でAIが短く相づちを打つ
- AIが話している途中でユーザーが割り込む
- ユーザーが少し考えている間は、そのまま待つ
- 会話のテンポや間を考慮して、話すか聞き続けるかを判断する
といった、人間同士の会話に近いインタラクションを実現できるようになりました。OpenAI はこの仕組みを、従来のターンベースの音声モデルとは異なる Continuous Interaction(継続的な対話) と説明しています。
Full Duplex による自然な会話
GPT-Live 以前の音声モデルでも、音声を直接入力して音声を生成することで、従来の
STT → LLM → TTS
という構成より低遅延な音声対話は可能でした。
そのため、gpt-realtime で実装を行った際「Full Duplex通信できた」と勘違いしていました。
しかし、実際にはユーザーの発話終了を判断してからAIが応答する必要があり、「どちらが話す番なのか」というターン管理が重要な「ターン制」からは完全に脱却できてはいませんでした。
GPT-Live では、モデル自身が音声の流れを継続的に処理します。
ユーザー ───────話す──────────→
↓
GPT-Live
↑
AI ──相づち───回答────────→
このように入力音声と出力音声を同時に扱えるため、短い相づちや割り込みなども含めた、より自然な会話が可能になります。
このページの中に、GPT-Live-1 を体験できるコンテンツがあります。
gpt-realtime と GPT-Live-1 の比較
| 観点 | gpt-realtime | GPT-Live-1 |
|---|---|---|
| 主な登場時期 | 2025年8月 | 2026年7月 / API 9月 |
| 基本用途 | リアルタイム音声AI | 自然なリアルタイム会話 |
| 音声入出力 | ○ | ○ |
| 割り込み | 対応 | より自然にモデル自身が処理 |
| 同時に聞く・話す | リアルタイム処理 | Full Duplexが中核 |
| 間・相づち | VAD等を利用 | 会話そのものとして扱う |
| 深い推論 | 音声モデル側で処理・ツール利用 | バックエンドモデルへ委任可能 |
| RAG/外部処理 | Tool Call等 | Delegationとの相性がよい |
| 電話 | SIP対応 | Telephony対応 |
変化を短くいうと、gpt-realtime は低遅延で反応が早いという進歩でしたが、GPT-Live-1 では、双方向通信になったことで、自然なリアルタイムな会話 まで進歩したといえます。
Sionic AI STORM Platform の RAG との接続
弊社 Sionic AI は、「すべての企業がAIを活用できる未来へ」を掲げ、企業向けAIエージェント構築プラットフォーム「STORM Platform」を開発・提供するAI企業です。
2023年に韓国・ソウルで設立され、2025年には日本法人「サイオニックエーアイ株式会社」を東京に設立しました。
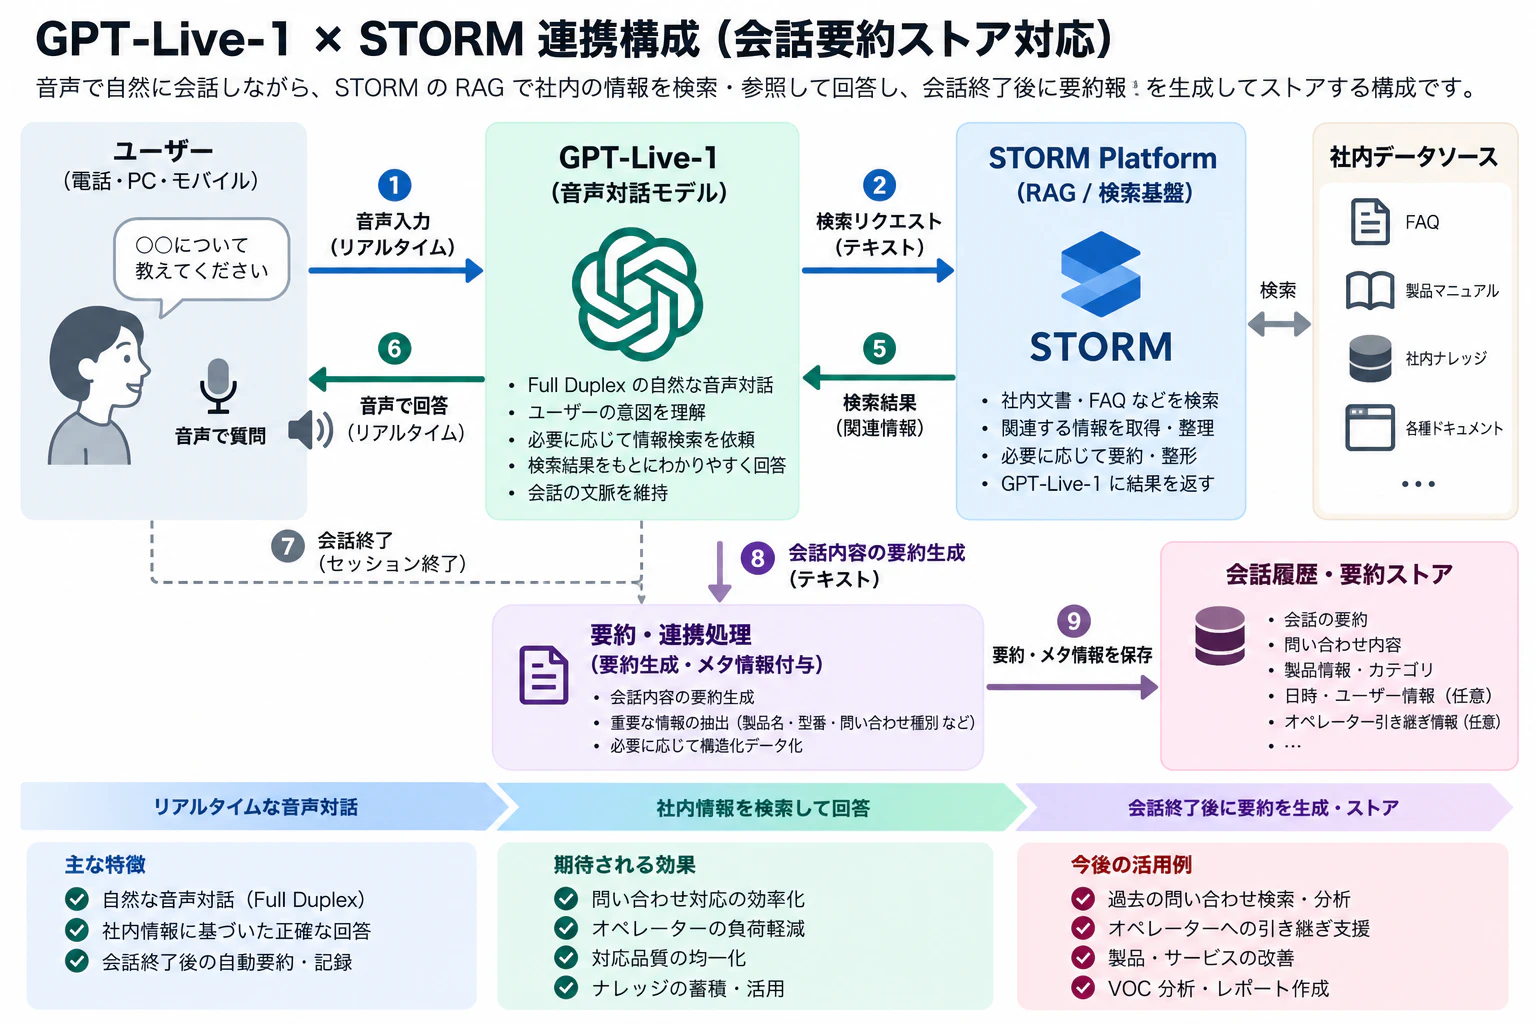
今回、GPT-Live-1 と STROM の RAG を接続した簡単なコールセンターっぽいデモを作成しました。
現時点では、残念ながら STROM Platform ではGPT-Live-1 をサポートできていないので、対話自体は、GPT-Live-1 の API を直接使用し、GPT-Live-1 から STROM の RAG を使う構成としました。
録音デモ
ターン制ではなく、割り込みができているのが確認できると思います。
0:33 ぐらいで先回りして、RAGを検索してほぼ待ち時間なしで回答しています。
次回以降
今回は、音声AI・コールセンターのAI 活動の状況と関連する技術動向として GPT-Live-1 と 弊社 STORM Platform の RAG との接続をご紹介させていただきました。
次回以降、より実装面のご紹介(反応があれば)をさせていただこうと思います。