
はじめに
最近、RAG(Retrieval-Augmented Generation)の進化系として Graph RAG (Knowledge Graph RAG) が注目されていますね。
「グラフ構造を使うと精度が上がるらしいけど、実装が難しそう...」と感じている方も多いのではないでしょうか。
今回は、DifyとローカルLLM環境を用いて、グラフDBと連携したRAGシステムを実際に構築してみたいと思います!
システムの全体像から、Docker構成、FastAPIによるバックエンド実装、そしてNeo4jのCypherクエリまで、順を追って丁寧に解説していきます。
対象読者
- Difyで一歩進んだRAG(Graph RAG)を試してみたい方
- グラフデータベース(Neo4j)とLLMをどう連携させるのか興味がある方
- ローカル環境(Docker)で手軽にRAGシステムを動かしてみたい方
この記事でわかること
- アーキテクチャ: Dify, Neo4j, FastAPI, Ollamaを組み合わせたGraph RAGの全体像
- 実装コード: PDFからデータを投入し、検索するまでの具体的なロジック
- クエリ: ベクトル検索とグラフ探索を組み合わせたCypherクエリの書き方
1. システムアーキテクチャ
まずは全体の構成を見てみましょう。
本システムは完全ローカル環境(Docker)で動作する構成を目指しました。
コンポーネント構成
それぞれの役割は以下の通りです。
| コンポーネント | 技術スタック | 役割 |
|---|---|---|
| UI / Workflow | Dify | チャット画面やRAGのワークフローを管理します。 |
| Backend API | FastAPI | 検索やデータ投入のロジックを実行する司令塔です。Difyからのリクエストをここで受け取ります。 |
| Graph DB | Neo4j | 論文データ(Paper)とチャンク(Chunk)をグラフ構造として保存します。ベクトル検索もここで行います。 |
| LLM | Ollama | 最終的な回答生成を行うローカルLLM(Llama 2など)です。 |
| Embedding | Sentence-Transformers | テキストをベクトル(数値の列)に変換するモデルです。 |
2. インフラ構築 (Docker Compose)
開発環境の再現性を確保するため、サービスをDocker Composeで定義しています。
これなら docker compose up 一発で環境が立ち上がるので便利ですよね。
docker-compose.yml
name: graph-rag-mvp

services:
  neo4j:
    image: neo4j:5.26.0-community
    container_name: neo4j
    restart: unless-stopped
    ports:
      - "7474:7474"
      - "7687:7687"
    environment:
      NEO4J_AUTH: neo4j/${NEO4J_PASSWORD:-testpassword}
    volumes:
      - neo4j_data:/data
      - neo4j_logs:/logs
      - neo4j_plugins:/plugins
    networks:
      - rag-net

  knowledge-api:
    build:
      context: ../knowledge-api
      dockerfile: Dockerfile
    container_name: knowledge-api
    restart: unless-stopped
    ports:
      - "8000:8000"
    environment:
      NEO4J_URI: bolt://neo4j:7687
      NEO4J_USER: ${NEO4J_USER:-neo4j}
      NEO4J_PASSWORD: ${NEO4J_PASSWORD:-testpassword}
      EMBED_MODEL_NAME: ${EMBED_MODEL_NAME:-sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2}
      CHUNK_SIZE: ${CHUNK_SIZE:-800}
      CHUNK_OVERLAP: ${CHUNK_OVERLAP:-100}
      TOP_K: ${TOP_K:-5}
      VECTOR_DIM: ${VECTOR_DIM:-384}
      MAX_FILE_SIZE_MB: ${MAX_FILE_SIZE_MB:-50}
      INDEX_NAME: ${INDEX_NAME:-chunk_embedding_index}
      CANDIDATE_MULTIPLIER: ${CANDIDATE_MULTIPLIER:-5}
      CANDIDATE_OFFSET: ${CANDIDATE_OFFSET:-20}
      EXTERNAL_KB_API_KEY: ${EXTERNAL_KB_API_KEY:-my-dify-kb-key}
    depends_on:
      - neo4j
    volumes:
      - knowledge_data:/app/data
    networks:
      - rag-net

  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    profiles:
      - ollama
    restart: unless-stopped
    ports:
      - "11434:11434"
    volumes:
      - ollama_data:/root/.ollama
    networks:
      - rag-net

volumes:
  neo4j_data:
  neo4j_logs:
  neo4j_plugins:
  knowledge_data:
  ollama_data:

networks:
  rag-net:
    name: graph-rag-mvp-net
環境変数の設定項目
設定ファイルでよく使う変数は以下の通りです。
| 変数名 | 設定値例 | 説明 |
|---|---|---|
NEO4J_URI |
bolt://neo4j:7687 |
Dockerネットワーク内のサービス名を指定して接続します。 |
EMBED_MODEL_NAME |
sentence-transformers/... |
Hugging Faceのモデル名です。自動でダウンロードされるので楽ちんです。 |
VECTOR_DIM |
384 |
Embeddingモデルの次元数です。インデックス作成時に必要になります。 |
EXTERNAL_KB_API_KEY |
my-dify-kb-key |
Difyと連携するための合言葉(APIキー)です。 |
2.5 Difyの起動とネットワーク連携
Dify本体は公式のDocker Composeを利用して起動し、Graph RAG用のコンテナ群とはネットワーク経由で連携させます。
手順
-
Difyの取得と起動:
git clone https://github.com/langgenius/dify.git cd dify/docker docker compose up -d -
ネットワークの疎通確認:
-
Docker Desktop (Mac/Windows):
host.docker.internalを使うことで、Difyコンテナからホスト上のポート(Graph RAG APIの8000番)にアクセスできます。特別なネットワーク設定は不要です。 -
Linux:
host.docker.internalがデフォルトでは使えないため、docker-compose.ymlでextra_hostsを設定するか、DifyとGraph RAGのコンテナを同じDockerネットワークに参加させる必要があります。
-
Docker Desktop (Mac/Windows):
今回は最も手軽な Docker Desktop環境 を前提とし、Difyから http://host.docker.internal:8000 でAPIにアクセスする構成として解説を進めます。
3. 実装詳細:データ投入 (Ingestion)
ここからは実装の中身に入っていきます。
まずはPDFからテキストを抽出し、グラフ構造としてNeo4jに格納するプロセス(Ingestion)です。
処理フロー
-
PDF解析:
PyMuPDFを使ってテキストを抽出します。 - チャンク分割: 長い文章を一定文字数(例: 800文字)で分割します。文脈が切れないように、少しだけ前後を被らせる(オーバーラップ)のがコツです。
- ベクトル化: Sentence-Transformersでテキストをベクトルに変換します。
-
グラフ格納:
PaperノードとChunkノードを作成し、それらを線で繋ぎます。
グラフ構造モデル
今回はシンプルに、以下のような親子関係からスタートします。
-
Nodes:
(:Paper),(:Chunk) -
Relation:
(:Paper)-[:HAS_CHUNK]->(:Chunk)
イメージとしては、「論文(Paper)」という親が、複数の「断片(Chunk)」という子供を持っているような構造ですね。
4. 実装詳細:検索 (Retrieval)
次に、検索プロセスです。
Difyからのリクエストを受け、Neo4jに対してハイブリッド検索(ベクトル + グラフ)を実行します。
Cypherクエリ(検索ロジック)
ここがGraph RAGの肝となる部分です!
ベクトル検索で「意味が近いチャンク」を見つけ、そこからグラフを辿って「親の論文情報」を取得します。
// 1. ベクトルインデックス検索
CALL db.index.vector.queryNodes($index_name, $k_candidates, $query_embedding)
YIELD node, score

// 2. フィルタリング(スコア閾値など)
WHERE score >= $min_score

// 3. グラフパターンマッチ(Chunk -> Paper)
MATCH (p:Paper)-[:HAS_CHUNK]->(node)

// 4. 結果返却
RETURN p.paper_id AS paper_id,
       p.title AS title,
       node.text AS text,
       score
ORDER BY score DESC
LIMIT $top_k
拡張性(引用関係の検索)
後からクエリを変えるだけで検索ロジックを拡張できるようにします。
例えば、将来的に「引用されている論文も一緒に探したい!」となった場合は、以下のようにクエリを書き足すだけでOKです。
// 引用論文も同時に取得する例
MATCH (p:Paper)-[:HAS_CHUNK]->(node)
OPTIONAL MATCH (p)-[:CITES]->(cited_paper:Paper)
RETURN p.title, cited_paper.title, ...
データ構造を大きく変えずにロジックを進化させられるのは、グラフDBならではの強みと言えると思います。
5. API実装 (FastAPI)
Difyの「External Knowledge API」仕様に合わせたエンドポイントを実装します。
エンドポイント仕様
-
URL:
POST /retrieval - Auth: Bearer Token
-
Response:
records配列を含むJSON
実装コード例
from fastapi import FastAPI, Header
from pydantic import BaseModel

app = FastAPI()

class RetrievalRequest(BaseModel):
    knowledge_id: str
    query: str

@app.post("/retrieval")
def retrieval(
    request: RetrievalRequest,
    authorization: str | None = Header(default=None)
):
    # 1. 認証
    if authorization != f"Bearer {settings.API_KEY}":
        return {"error": "Unauthorized"}, 401

    # 2. 検索実行 (Neo4j)
    results = run_graph_rag_search(request.query)

    # 3. Dify形式へ整形
    records = []
    for row in results:
        records.append({
            "content": row["text"],
            "score": row["score"],
            "metadata": {
                "source": row["title"],
                "paper_id": row["paper_id"]
            }
        })

    return {"records": records}
Neo4j ベクトルインデックスの自動生成
アプリ起動時に「インデックスあるかな?」と確認し、なければ自動で作るロジックを入れておくと便利です。
def ensure_index(driver, dim):
    query = f"""
    CREATE VECTOR INDEX chunk_embedding_index IF NOT EXISTS
    FOR (c:Chunk) ON (c.embedding)
    OPTIONS {{ indexConfig: {{
      `vector.dimensions`: {dim},
      `vector.similarity_function`: 'cosine'
    }}}}
    """
    driver.execute_query(query)
6. Dify連携設定
最後に、Dify側の設定です。
手順
-
外部ナレッジAPIの登録:
-
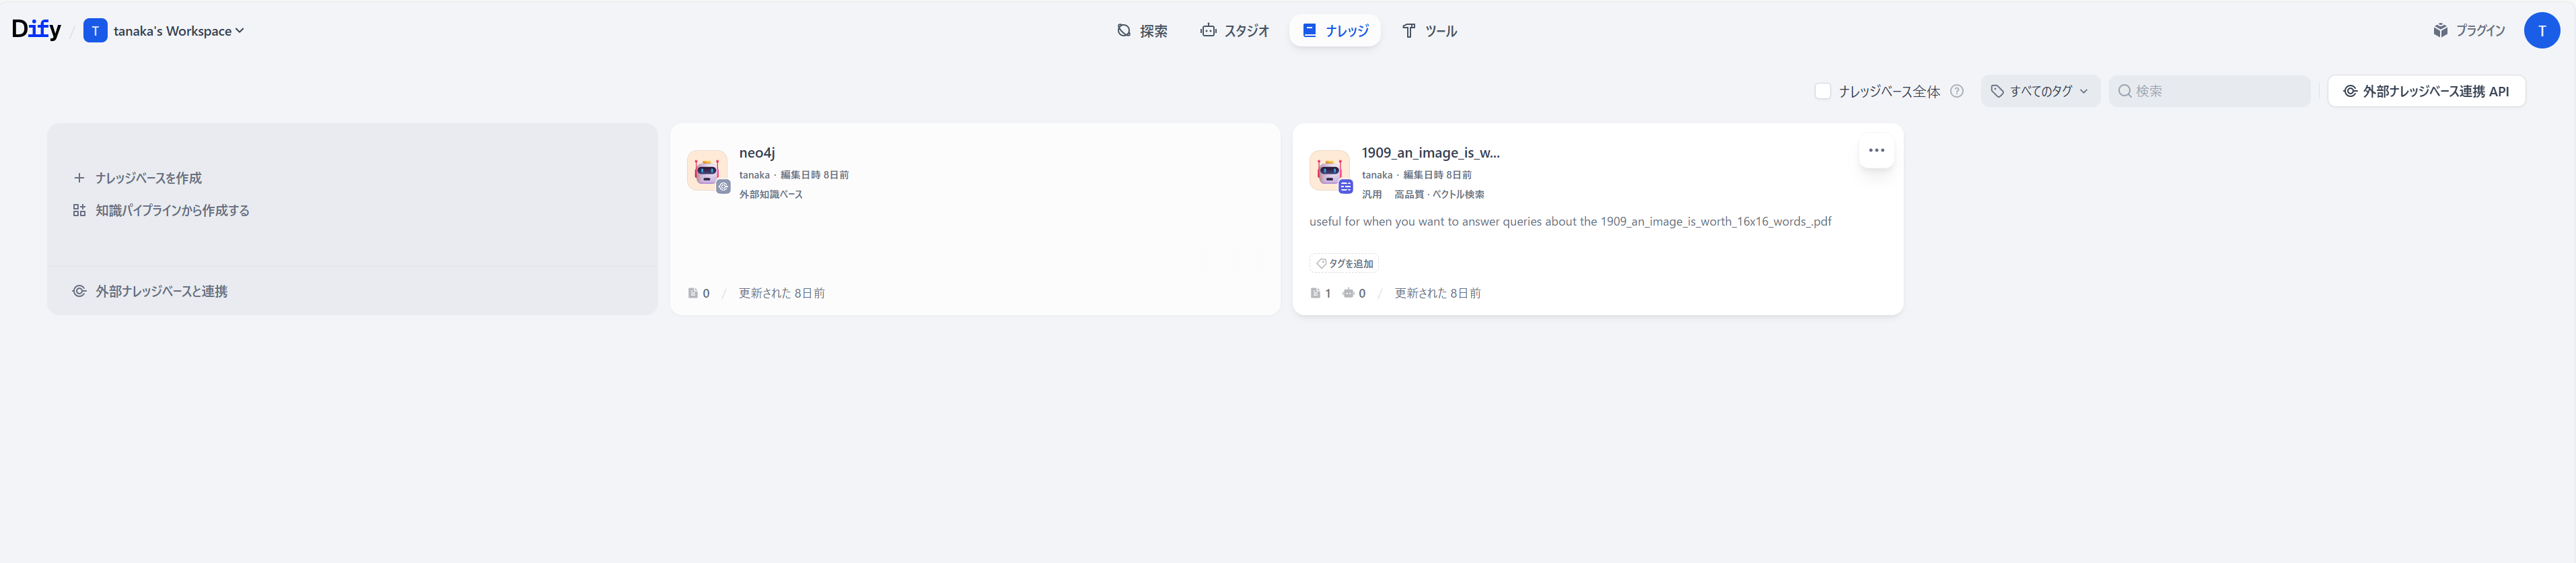
[ナレッジ] > [外部ナレッジ連携 API] を開きます。

-
外部ナレッジベースAPIを追加をクリックします。
-
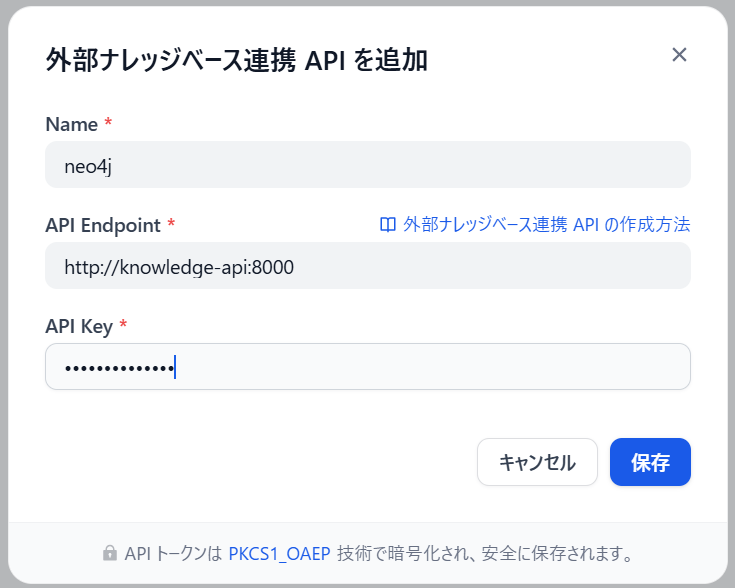
Name、エンドポイント、APIキーを指定します。
- Name: 任意の名前
- Endpoint:
http://knowledge-api:8000(FastAPIのエンドポイントを指定する。IPアドレスはコンテナサービス名のknowledge-apiを指定する。) - API Key:
my-dify-kb-key(composeで設定した環境変数の値を指定する。)
-
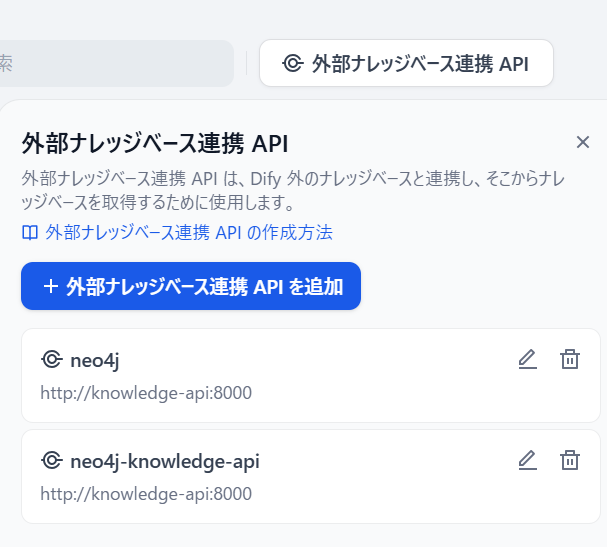
正常に連携ができると外部連携が追加されます。
-
-
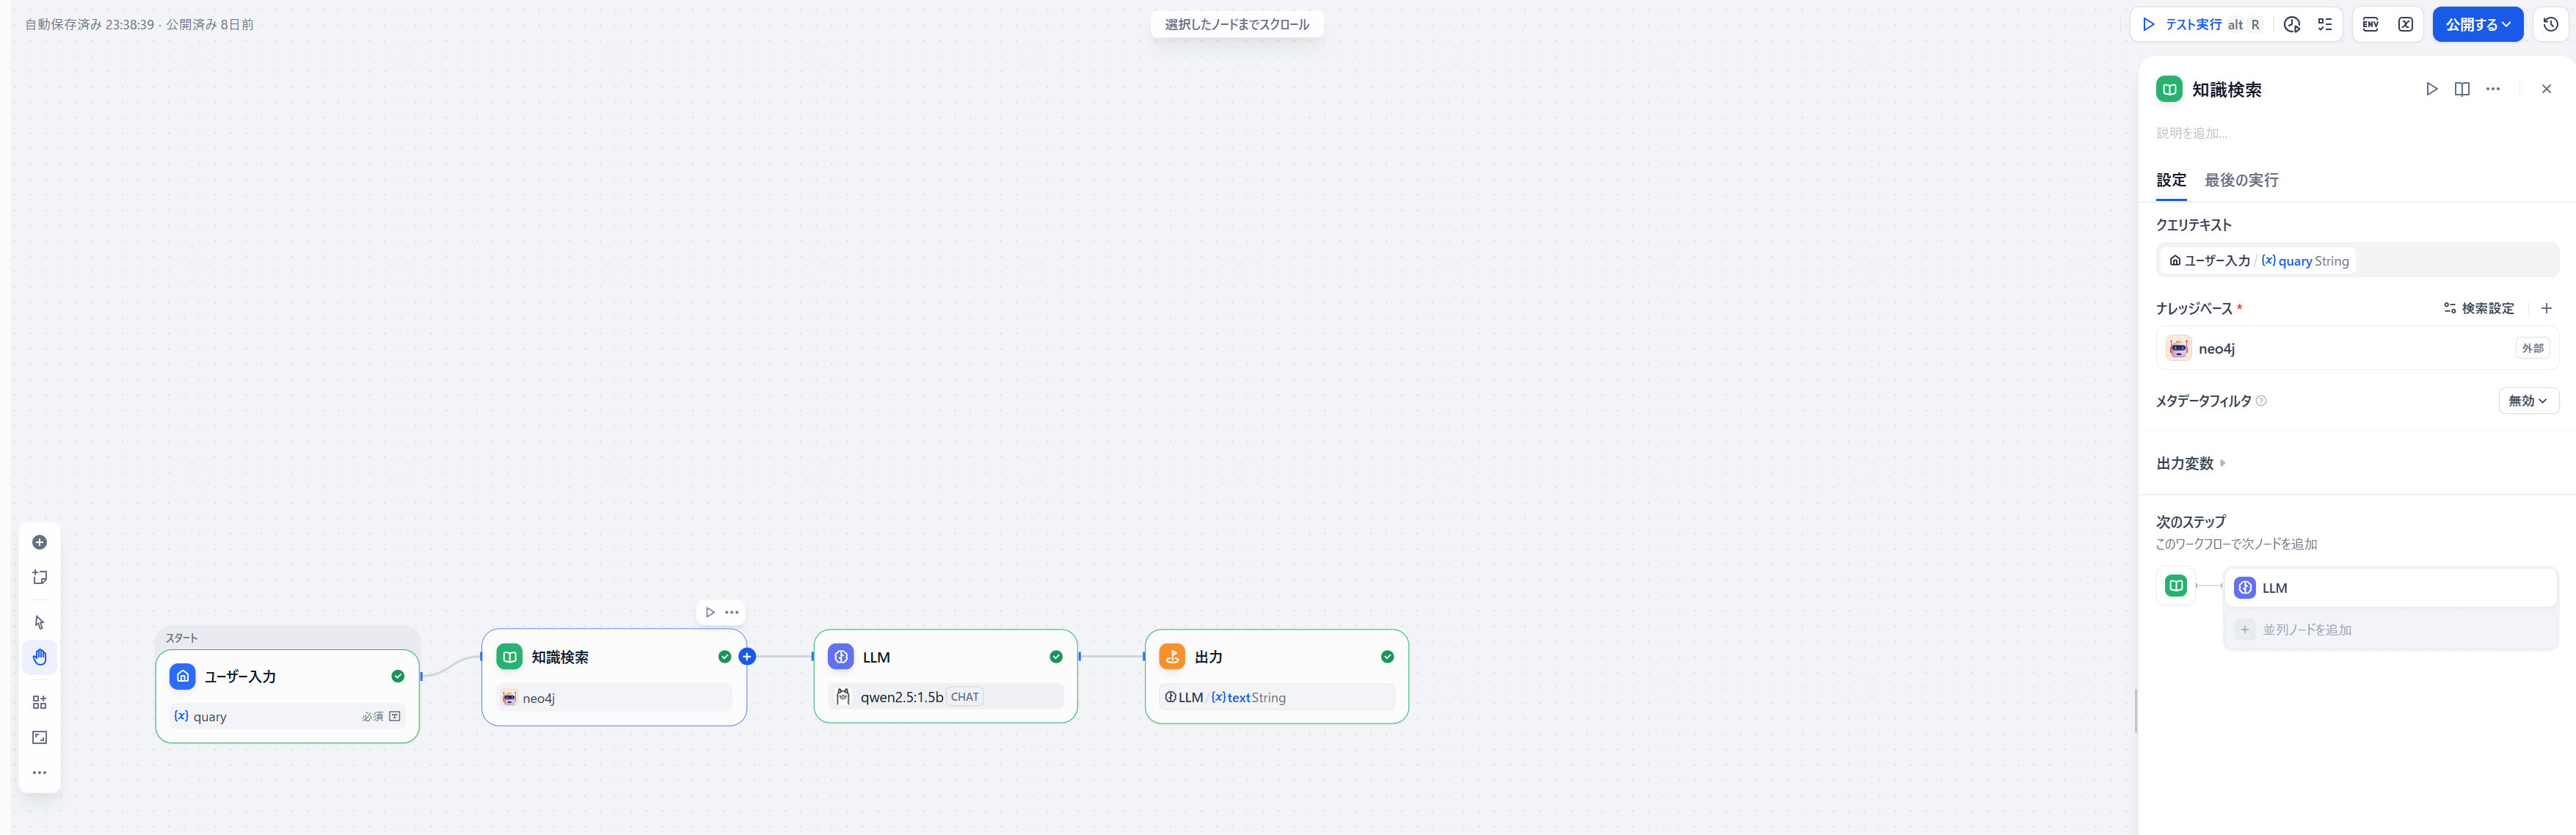
外部ナレッジ連携APIをワークフローで呼び出す:
- 知識検索のノードを追加します。
- ナレッジベースで先ほど追加した外部ナレッジベースを指定すれば完了です。
APIサーバー詳細解説
以下に本システムで設計・実装が必要となるAPIサーバーについての詳細を解説します。
主要コンポーネント
┌─────────────┐
│  PDF File   │
└──────┬──────┘
       │
       ▼
┌──────────────────────┐
│ PDF Extraction       │  ← pdf_extractor.py
│ (PyMuPDF)            │
└──────┬───────────────┘
       │ PageText[]
       ▼
┌──────────────────────┐
│ Text Chunking        │  ← chunker.py
│ (Fixed size + overlap)
└──────┬───────────────┘
       │ chunks[]
       ▼
┌──────────────────────┐
│ Embedding Generation │  ← embedder.py
│ (sentence-transformers)
└──────┬───────────────┘
       │ embeddings[]
       ▼
┌──────────────────────┐
│ Neo4j Storage        │  ← neo4j_repo.py
│ (Graph Database)     │
└──────────────────────┘
       │
       ▼
┌──────────────────────┐
│ Vector Search Index  │
│ (Cosine Similarity)  │
└──────────────────────┘
データモデル
Neo4j グラフスキーマ
Paper ノード
紙(学術論文、文書)を表すノードです。
属性:
-
paper_id(STRING, PRIMARY KEY) - 採番されるドキュメント ID- 形式:
paper_YYYYMMDD_XXXX(例:paper_20260119_0042) - 採番方法: UTCの当日日付 + 0-9999 のランダム値
- 形式:
-
title(STRING) - ドキュメントのタイトル(ファイル名から抽出) -
source_path(STRING) - アップロード時のファイルパス -
source_hash(STRING) - ファイルの SHA-256 ハッシュ値- 重複検出に使用
- 同じ
source_hashのファイルは既存 Paper にマージ
-
embed_model(STRING) - 埋め込みに使用したモデル名- 例:
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2
- 例:
-
vector_dim(INTEGER) - 埋め込みベクトルの次元数- デフォルト: 384 (multilingual-MiniLM の場合)
-
created_at(STRING) - ISO 8601 形式のタイムスタンプ
制約:
CREATE CONSTRAINT paper_id_unique IF NOT EXISTS
FOR (p:Paper)
REQUIRE p.paper_id IS UNIQUE
Chunk ノード
テキスト断片を表すノードです。Paper から分割されたテキストセグメントです。
属性:
-
chunk_id(STRING, PRIMARY KEY) - チャンク ID- 形式:
{paper_id}_{page}_{chunk_index} - 例:
paper_20260119_0042_1_0
- 形式:
-
paper_id(STRING) - 親の Paper ID(外部キー) -
page(INTEGER) - ソース PDF のページ番号(1-indexed) -
chunk_index(INTEGER) - Paper 内でのチャンク番号(0-indexed) -
text(STRING) - チャンクのテキスト内容 -
embedding(LIST) - テキストの埋め込みベクトル- 長さ:
vector_dim(通常 384) - 正規化済み (L2 norm = 1)
- 長さ:
-
created_at(STRING) - ISO 8601 形式のタイムスタンプ
制約:
CREATE CONSTRAINT chunk_id_unique IF NOT EXISTS
FOR (c:Chunk)
REQUIRE c.chunk_id IS UNIQUE
リレーションシップ
HAS_CHUNK 関係
-
Paper→Chunkへの有向エッジ - 意味: Paper が複数の Chunk を保有する
- 用途: Paper から全 Chunk への走査、削除時のカスケード削除
MATCH (p:Paper)-[:HAS_CHUNK]->(c:Chunk)
ベクトルインデックス
chunk_embedding_index
Neo4j 5.11+ の VECTOR INDEX
定義:
CREATE VECTOR INDEX chunk_embedding_index IF NOT EXISTS
FOR (c:Chunk)
ON (c.embedding)
OPTIONS {
  indexConfig: {
    `vector.dimensions`: 384,
    `vector.similarity_function`: 'cosine'
  }
}
用途:
- 質問文の埋め込みベクトルとチャンク埋め込みの余弦類似度検索
-
db.index.vector.queryNodes()で呼び出し
パラメータ:
-
vector.dimensions: 埋め込みモデルの出力次元数 -
vector.similarity_function: 類似度の計算方法-
'cosine': 推奨(正規化埋め込み向け) -
'euclidean': ユークリッド距離 -
'dot_product': 内積
-
データ処理フロー
取り込み処理 (Ingestion Pipeline)
┌─────────────┐
│ ①Upload PDF │
└──────┬──────┘
       │
       ▼
┌─────────────────────────────────┐
│ ②Validate & Save               │
│ - PDF Content-Type 確認         │
│ - ファイルサイズ確認           │
│ - SHA-256 ハッシュ計算          │
└──────┬──────────────────────────┘
       │
       ▼
┌─────────────────────────────────┐
│ ③Check Duplication             │
│ - source_hash から既存 Paper検索│
│ - 存在時: スキップまたはマージ  │
└──────┬──────────────────────────┘
       │ (新規の場合)
       ▼
┌─────────────────────────────────┐
│ ④Extract Text from PDF         │
│ - PyMuPDF で ページ単位抽出     │
│ - PageText (page_number, text)  │
└──────┬──────────────────────────┘
       │
       ▼
┌─────────────────────────────────┐
│ ⑤Chunking                       │
│ - chunk_size: 800文字           │
│ - chunk_overlap: 100文字        │
│ - Sliding window で分割         │
└──────┬──────────────────────────┘
       │ chunks[]
       ▼
┌─────────────────────────────────┐
│ ⑥Generate Embeddings           │
│ - sentence-transformers 使用   │
│ - L2 正規化                     │
│ - batch 処理                    │
└──────┬──────────────────────────┘
       │ chunk_ids[], embeddings[]
       ▼
┌─────────────────────────────────┐
│ ⑦Store to Neo4j                 │
│ - Paper ノード作成              │
│ - Chunk ノード作成              │
│ - HAS_CHUNK 関係作成            │
└─────────────────────────────────┘
PDF 抽出 (pdf_extractor.py)
入力: PDF ファイルパス
出力: PageText[]
@dataclass(frozen=True)
class PageText:
    page_number: int  # 1-indexed
    text: str         # 抽出されたテキスト
処理:
- PyMuPDF (
fitz) で ページ単位にテキスト抽出 - 各ページのテキストを
PageTextオブジェクトで保持 - ページ番号は 1 から開始
エラーハンドリング:
- PDF 解析失敗 → RuntimeError 発行
テキスト分割 (chunker.py)
入力: テキスト、chunk_size (800)、chunk_overlap (100)
出力: list[str] (チャンク文字列の列)
アルゴリズム:
1. テキスト前後の空白を削除
2. start = 0
3. while start < len(text):
     - end = min(start + chunk_size, len(text))
     - chunk = text[start:end]
     - chunks.append(chunk)
     - if end == len(text): break
     - start = end - chunk_overlap  (オーバーラップ)
特徴:
- 固定長チャンク + スライディングウィンドウオーバーラップ
- チャンク間の文脈を保持(100文字の重複)
- 末尾のチャンクも保証される
例:
テキスト: "AAAABBBBCCCCDDDDEEEEFFFFGGGG" (28文字)
chunk_size=8, overlap=2

チャンク 1: AAAABBBB (0-8)
チャンク 2: BBBBCCCC (6-14)
チャンク 3: CCCCDDDD (12-20)
チャンク 4: DDDDEEEE (18-26)
チャンク 5: EEEEFFFFGGGG (26-28+末尾)
埋め込み生成 (embedder.py)
入力: Iterable[str] (テキストリスト)
出力: list[list[float]] (ベクトルリスト)
モデル:
- デフォルト:
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 - 出力次元数: 384
- 多言語対応
処理:
vectors = model.encode(
    texts,
    convert_to_numpy=True,
    normalize_embeddings=True  # L2 正規化
)
特徴:
- L2 正規化済み(ベクトル長 = 1)
- 余弦類似度計算に最適
- 遅延ロード(初回使用時に初期化)
検索処理 (Retrieval)
┌──────────────┐
│ ①Query Text  │
└──────┬───────┘
       │
       ▼
┌──────────────────────┐
│ ②Generate Embedding  │
│ (同じモデル使用)    │
└──────┬───────────────┘
       │ query_embedding
       ▼
┌──────────────────────┐
│ ③Vector Search       │
│ - db.index.vector    │
│   .queryNodes()      │
│ - k_candidates 検索  │
└──────┬───────────────┘
       │ candidates
       ▼
┌──────────────────────┐
│ ④Filter & Rank       │
│ - paper_id フィルタ  │
│ - score フィルタ     │
│ - top_k 選出        │
└──────┬───────────────┘
       │ results
       ▼
┌──────────────────────┐
│ ⑤Return Results      │
│ (metadata付き)      │
└──────────────────────┘
ベクトル検索クエリ
CALL db.index.vector.queryNodes($index_name, $k_candidates, $query_embedding)
YIELD node, score
WHERE ($paper_id IS NULL OR node.paper_id = $paper_id)
  AND ($min_score IS NULL OR score >= $min_score)
MATCH (p:Paper)-[:HAS_CHUNK]->(node)
RETURN p.paper_id AS paper_id,
       p.title AS title,
       node.chunk_id AS chunk_id,
       node.page AS page,
       node.chunk_index AS chunk_index,
       score AS score,
       node.text AS text
ORDER BY score DESC
LIMIT $top_k
パラメータ:
-
index_name: ベクトルインデックス名 (chunk_embedding_index) -
k_candidates: 候補数(通常:top_k * 5かtop_k + 20の大きい方) -
query_embedding: 質問文の埋め込みベクトル -
paper_id: 特定の論文に限定(オプション) -
min_score: スコア閾値(オプション、0.0-1.0) -
top_k: 返却チャンク数
スコア計算:
- 余弦類似度 (Cosine Similarity) で計算
- 正規化埋め込み:
similarity = dot_product(query, chunk) - 範囲: -1.0 ~ 1.0 (通常は 0.0 ~ 1.0)
設定パラメータ
主要設定(settings.py)
| パラメータ | 環境変数 | デフォルト | 説明 |
|---|---|---|---|
embed_model_name |
EMBED_MODEL_NAME |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
埋め込みモデル名 |
vector_dim |
VECTOR_DIM |
384 | ベクトル次元数 |
chunk_size |
CHUNK_SIZE |
800 | チャンクサイズ (文字数) |
chunk_overlap |
CHUNK_OVERLAP |
100 | チャンク間オーバーラップ (文字数) |
max_file_size_mb |
MAX_FILE_SIZE_MB |
50 | アップロード可能な最大ファイルサイズ (MB) |
top_k |
TOP_K |
5 | デフォルト検索結果数 |
index_name |
INDEX_NAME |
chunk_embedding_index |
ベクトルインデックス名 |
candidate_multiplier |
CANDIDATE_MULTIPLIER |
5 | k_candidates = top_k * 5 |
candidate_offset |
CANDIDATE_OFFSET |
20 | k_candidates = top_k + 20 |
neo4j_uri |
NEO4J_URI |
bolt://neo4j:7687 |
Neo4j 接続 URI |
neo4j_user |
NEO4J_USER |
neo4j |
Neo4j ユーザー名 |
neo4j_password |
NEO4J_PASSWORD |
testpassword |
Neo4j パスワード |
k_candidates の計算
k_candidates = max(
    top_k * settings.candidate_multiplier,      # top_k * 5
    top_k + settings.candidate_offset            # top_k + 20
)
例:
- top_k=5: k_candidates = max(25, 25) = 25
- top_k=1: k_candidates = max(5, 21) = 21
- top_k=10: k_candidates = max(50, 30) = 50
理由:
- ベクトル検索の不完全性を補う
- インデックス候補から top_k を厳密に選出
API エンドポイント
/retrieve (POST)
用途: 汎用検索エンドポイント
リクエスト:
{
  "query": "質問文",
  "top_k": 5,
  "paper_id": "paper_20260119_0042",  // optional
  "min_score": 0.5  // optional
}
レスポンス:
{
  "query": "質問文",
  "results": [
    {
      "paper_id": "paper_20260119_0042",
      "title": "論文タイトル",
      "chunk_id": "paper_20260119_0042_1_0",
      "page": 1,
      "chunk_index": 0,
      "score": 0.8524,
      "text": "チャンクのテキスト..."
    }
  ]
}
/retrieval (POST)
用途: Dify External Knowledge API との連携
リクエスト:
{
  "knowledge_id": "kb_123",
  "query": "質問文",
  "retrieval_setting": {
    "top_k": 5,
    "score_threshold": 0.5
  }
}
ヘッダー:
Authorization: Bearer {EXTERNAL_KB_API_KEY}
レスポンス:
{
  "records": [
    {
      "content": "チャンクのテキスト...",
      "score": 0.8524,
      "metadata": {
        "paper_id": "paper_20260119_0042",
        "title": "論文タイトル",
        "chunk_id": "paper_20260119_0042_1_0",
        "page": 1,
        "chunk_index": 0
      }
    }
  ]
}
データストレージ
ディレクトリ構造
$DATA_DIR/
├── pdfs/           # アップロードされた PDF
│   ├── paper_20260119_0042.pdf
│   └── ...
├── text/           # 抽出されたテキスト (デバッグ用)
│   ├── paper_20260119_0042.txt
│   └── ...
環境変数:
-
DATA_DIR: デフォルト/app/data
Neo4j ストレージ
- グラフデータベース: Neo4j 5.11+
- ベクトルストレージ: VECTOR INDEX(オンメモリ + ディスク永続化)
- 通信プロトコル: Bolt (bolt://neo4j:7687)
スキーマ初期化
実行方法
neo4j_repo.ensure_schema(vector_dim=384)
実行内容:
- Paper ノードの
paper_idユニーク制約作成 - Chunk ノードの
chunk_idユニーク制約作成 -
chunk_embedding_indexベクトルインデックス作成
べき等性: IF NOT EXISTS で何度実行しても安全
データ一貫性と制約
ユニーク制約
| 制約 | 対象 | 意義 |
|---|---|---|
paper_id_unique |
Paper.paper_id | ドキュメント一意性 |
chunk_id_unique |
Chunk.chunk_id | チャンク一意性 |
リレーション制約
- Paper ノード削除時:
DETACH DELETEで関連 Chunk も自動削除 - Chunk ノードは独立して削除可能
8.3 重複排除メカニズム
source_hash ベース重複検出:
existing = neo4j_repo.find_paper_by_source_hash(source_hash)
if existing:
    # 既存 Paper が見つかった場合
    # - リロード時は新規 Paper 作成をスキップ
    # - または既存 Paper に Chunk をマージ
参考資料
外部リンク
- Sentence Transformers: https://www.sbert.net/
- PyMuPDF Documentation: https://pymupdf.readthedocs.io/
まとめ
今回は、DifyとNeo4jを組み合わせてGraph RAGを実装する方法について解説しました。
- Graph RAGのメリット: 文脈(論文間の関係性など)を保持した検索が可能になります。
- 構成: Dify (UI) + FastAPI (Logic) + Neo4j (DB) という疎結合なアーキテクチャを採用しました。
- 拡張: クエリベースで検索ロジックを柔軟に変更・拡張できるのが大きな魅力です。
少しハードルが高そうに見えるGraph RAGですが、こうして分解してみると意外とシンプルに実装できることが分かります。
ぜひ皆さんも、この機会にGraph RAGの世界に足を踏み入れてみてください!