
こんにちは。NetAppのSales Specialistの小寺です。
Upstage AI 株式会社(以下、Upstage)のプロダクトである「Upstage Document Parse」をAmazon FSx for NetApp ONTAPに保管されたデータを使って検証しました。
1. はじめに
背景
研究論文や業務資料など大量の文書が日々生成されています。これらの文書には、意思決定に不可欠な表や図のデータが含まれていますが、手動で抽出するのは非効率です。
課題
想定される課題は以下の通りです。
・数百〜数千のPDFなどの文書から表データを手作業で抽出するのは時間とコストがかかる
・日本語PDFに対応した高精度な解析ツールが少ない
解決策
Amazon FSx for NetApp ONTAP(以降、FSx for ONTAP) + Upstage AI + Pythonによる自動化を行う。
2. システム概要とアーキテクチャ
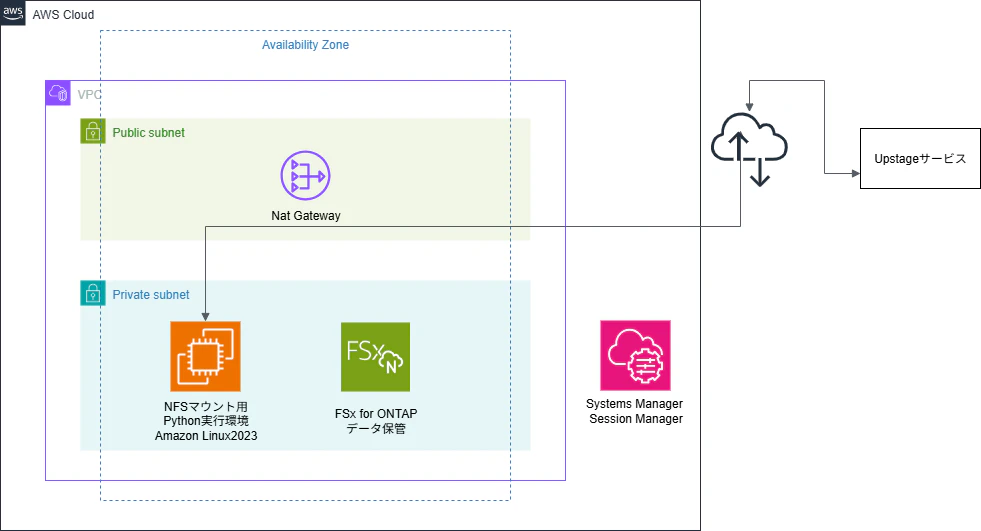
2.1 アーキテクチャ
FSx for ONTAP → EC2(Python) → Upstage AI → 構造化データ → HTMLで表示できるよう整形
2.2 利用サービス
・ストレージ: Amazon FSx for NetApp ONTAP
・処理基盤: Amazon EC2 (Amazon Linux 2023)
・AI解析: Upstage AI Document Parse API
・言語: Python 3.9
・出力形式: CSV、JSON、HTML
3. 技術選定の理由
各サービスの選定理由です。
3.1 FSx for ONTAP
・NFSによる高速ファイルアクセス
・NetApp独自の階層化・重複排除・圧縮機能によるコスト最適化
・ARP機能がありランサムウェアからのデータ保護が可能
3.2 Upstage AI
Upstage Document Parseを利用しました。
以下が利用するメリットと考えています。
・日本語PDFに特化した高精度解析
・表構造の正確な認識能力
・APIの使いやすさとレスポンス速度
・他のOCRサービスとの精度比較結果
4. 実装手順詳細
4.1 環境構築
Amazon FSx for NetApp ONTAPの構築
(1) 事前にFSx for ONTAPをNFSマウントするためにEC2を起動します。SSM利用をするため、Nat Gatewayも合わせて起動します。
※FSx for ONTAPの起動時間が10分以上かかるため、最初にEC2を起動させておくのがお勧めです。
(2)FSx for ONTAPを起動します。検証のためシングルAZとし、マウントパスは/vol1としました。
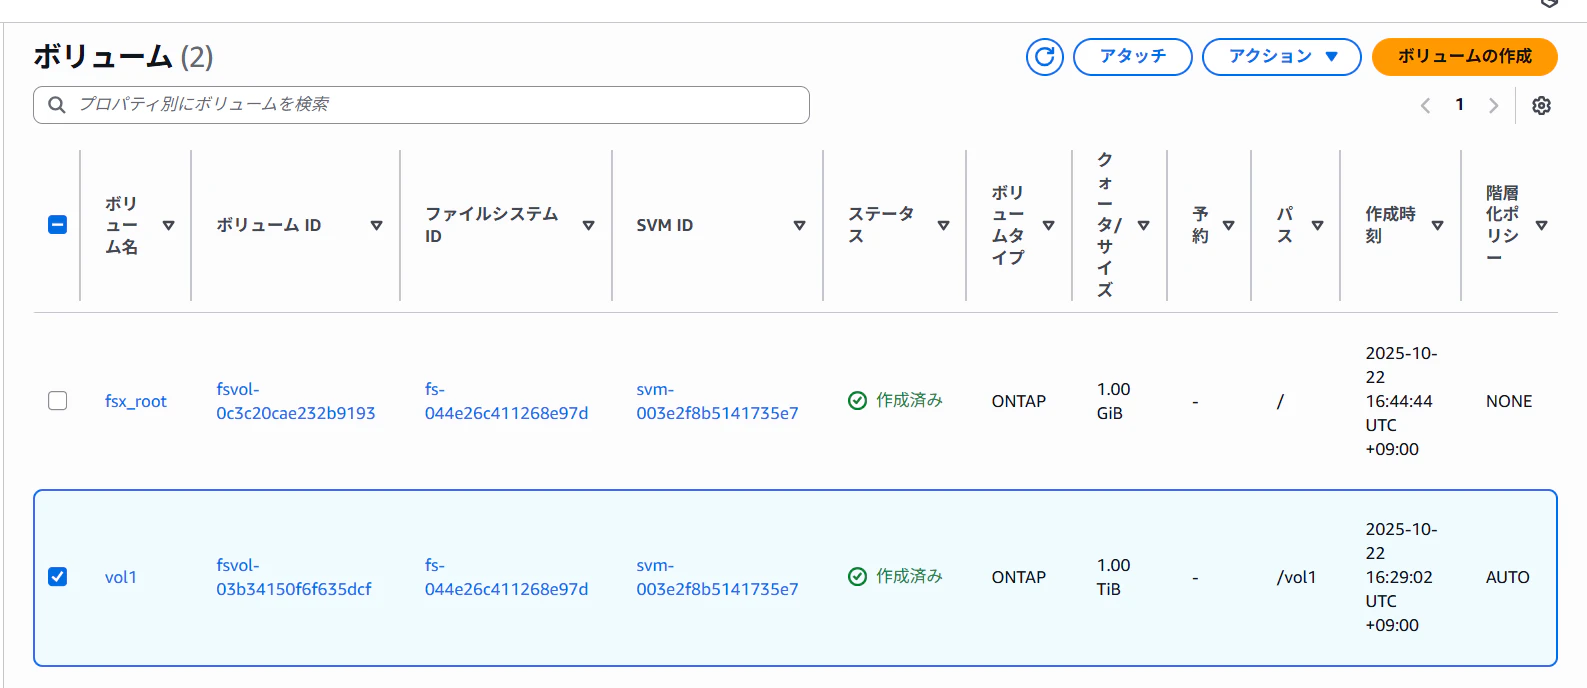
(3)EC2へのマウントを行うため、アタッチを選び、コマンドを確認します。

(4) SSMから(3)でコピーしたコマンドを実行します。
※FSx for ONTAPのセキュリティグループには、NFSマウントのためEC2からの2049/tcpをインバウンドに許可しておきます。
4.2 検証用のPDFファイル
allganize/RAG-Evaluation-Dataset-JAの日本語用PDFファイルをダウンロードしました。
4.3 依存関係のインストール
pip3 install beautifulsoup4 pandas requests boto3 pillow
4.4 API認証
Upstage API キーの取得と設定
(1)Upstageのサイトからアカウントを作成します。
(2) DashboardのAPI keysからAPIキーを作成・取得します。
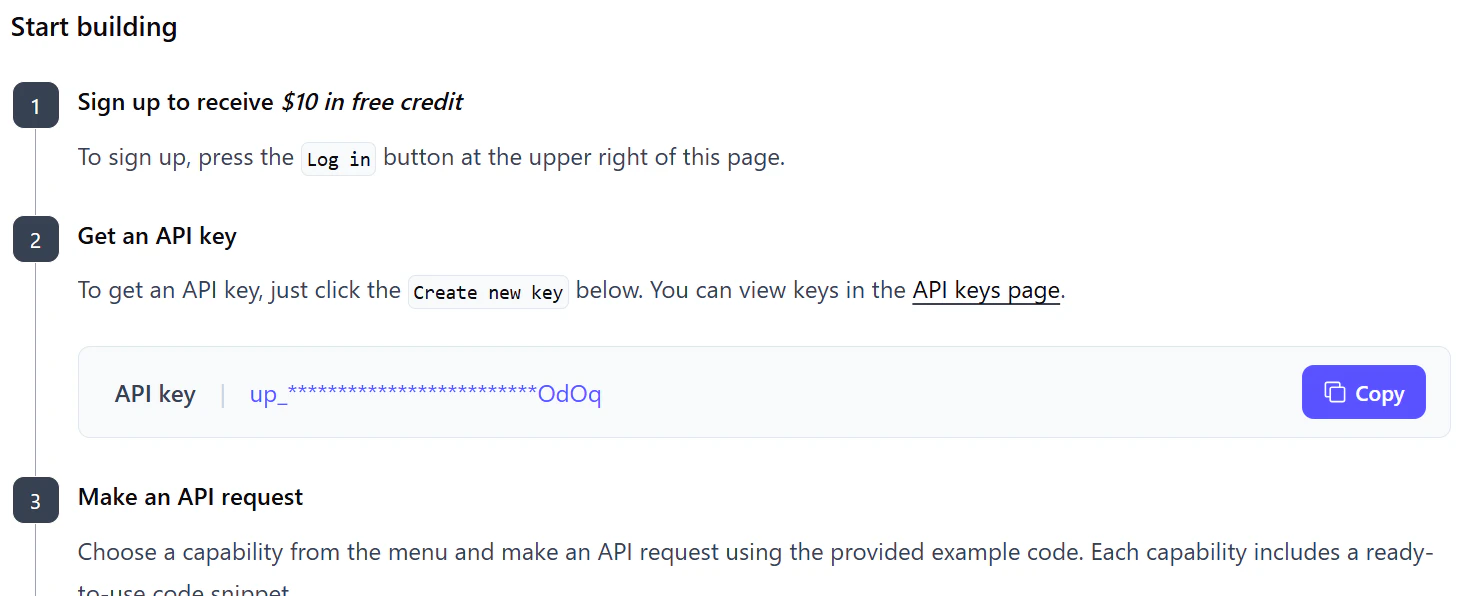
(3)環境変数を設定します。
export UPSTAGE_API_KEY="up_**************************OdOq"
5. 実装コード
EC2上で実行したPythonの主な処理
def main():
    # 環境変数から設定を取得
    UPSTAGE_API_KEY = os.getenv('UPSTAGE_API_KEY')
    FSX_MOUNT_PATH = os.getenv('FSX_MOUNT_PATH', '/fsx')
    OUTPUT_DIR = os.getenv('OUTPUT_DIR', '/tmp/extracted_charts_tables')

    if not UPSTAGE_API_KEY:
        raise ValueError("UPSTAGE_API_KEY environment variable is required")

    # クライアントの初期化
    extractor = UpstageChartTableExtractor(UPSTAGE_API_KEY)
    fsx_manager = FSxONTAPManager(FSX_MOUNT_PATH)

    try:
        # PDFファイルを検索
        pdf_files = fsx_manager.list_pdf_files("documents")

        if not pdf_files:
            logger.warning("No PDF files found")
            return

        # 各PDFファイルから図表を抽出
        for pdf_file in pdf_files[:3]:  # 最初の3ファイルのみ処理(テスト用)
            try:
                logger.info(f"Extracting charts and tables from: {pdf_file}")

                # 図表を抽出
                charts_tables_data = extractor.extract_charts_and_tables(pdf_file)

                total_items = (charts_tables_data['table_count'] +
                             charts_tables_data['chart_count'] +
                             charts_tables_data['image_count'])

                if total_items > 0:
                    # ファイル情報を追加
                    charts_tables_data['source_file'] = pdf_file
                    charts_tables_data['processed_at'] = time.time()


                    # ローカルにJSON保存
                    output_file = f"{OUTPUT_DIR}/{file_name}_charts_tables.json"
                    os.makedirs(OUTPUT_DIR, exist_ok=True)
                    with open(output_file, 'w', encoding='utf-8') as f:
                        json.dump(charts_tables_data, f, ensure_ascii=False, indent=2)

                    # 図表をファイルとして保存(HTML表示機能付き)
                    saved_files = extractor.save_charts_tables_as_files(
                        charts_tables_data,
                        f"{OUTPUT_DIR}/{file_name}_files",
                        pdf_file
                    )

                    logger.info(f"Extracted from {pdf_file}:")
                    logger.info(f"  - Tables: {charts_tables_data['table_count']}")
                    logger.info(f"  - Charts: {charts_tables_data['chart_count']}")
                    logger.info(f"  - Images: {charts_tables_data['image_count']}")
                    logger.info(f"  - CSV files: {len(saved_files['csv_files'])}")
                    logger.info(f"  - HTML files: {len(saved_files['html_files'])}")

                    # HTMLファイルのパスを表示
                    if saved_files['html_files']:
                        logger.info(f"  - HTML Report: {saved_files['html_files'][0]}")
                        print(f"\n📊 修正版HTML表示レポートが生成されました: {saved_files['html_files'][0]}")
                        print("ブラウザでファイルを開いて結果を確認してください。")
                else:
                    logger.info(f"No charts or tables found in {pdf_file}")

            except Exception as e:
                logger.error(f"Error processing {pdf_file}: {str(e)}")
                import traceback
                logger.error(f"Traceback: {traceback.format_exc()}")
                continue

    except Exception as e:
        logger.error(f"Main process error: {str(e)}")
        raise

if __name__ == "__main__":
    main()
API接続
 def __init__(self, api_key: str):
        """
        Upstage Document Parser 図表抽出専用クライアントの初期化

        Args:
            api_key (str): Upstage API キー
        """
        self.api_key = api_key
        self.base_url = "https://api.upstage.ai/v1/document-ai"
        self.headers = {
            "Authorization": f"Bearer {api_key}"
        }
6. 実行結果
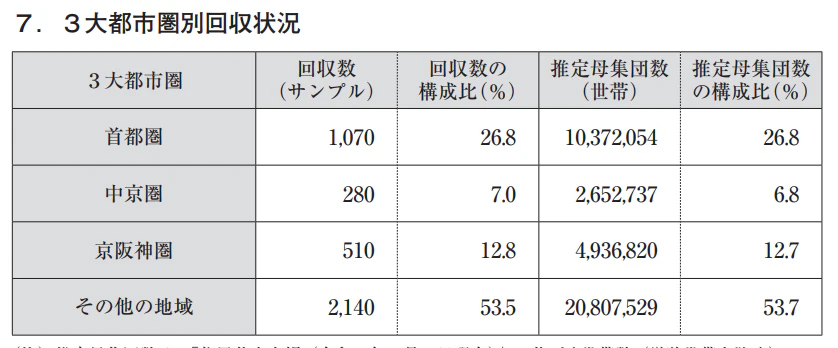
サンプル(1)
元PDF
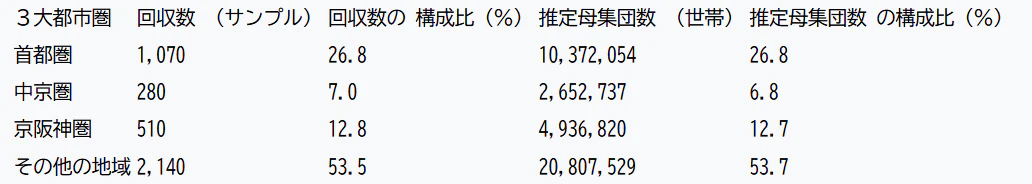
抽出した表
API結果(展開してください)
{
      "type": "table",
      "id": "table_4",
      "content": {
        "html": "<br><table id='23' style='font-size:18px'><thead><tr><td>3大都市圏</td><td>回収数 (サンプル)</td><td>回収数の 構成比(%)</td><td>推定母集団数 (世帯)</td><td>推定母集団数 の構成比(%)</td></tr></thead><tbody><tr><td>首都圏</td><td>1,070</td><td>26.8</td><td>10,372,054</td><td>26.8</td></tr><tr><td>中京圏</td><td>280</td><td>7.0</td><td>2,652,737</td><td>6.8</td></tr><tr><td>京阪神圏</td><td>510</td><td>12.8</td><td>4,936,820</td><td>12.7</td></tr><tr><td>その他の地域</td><td>2,140</td><td>53.5</td><td>20,807,529</td><td>53.7</td></tr></tbody></table>",
        "markdown": "",
        "text": ""
      },
      "coordinates": [
        {
          "x": 0.1151,
          "y": 0.3982
        },
        {
          "x": 0.798,
          "y": 0.3982
        },
        {
          "x": 0.798,
          "y": 0.5679
        },
        {
          "x": 0.1151,
          "y": 0.5679
        }
      ],
      "page": 3
    }
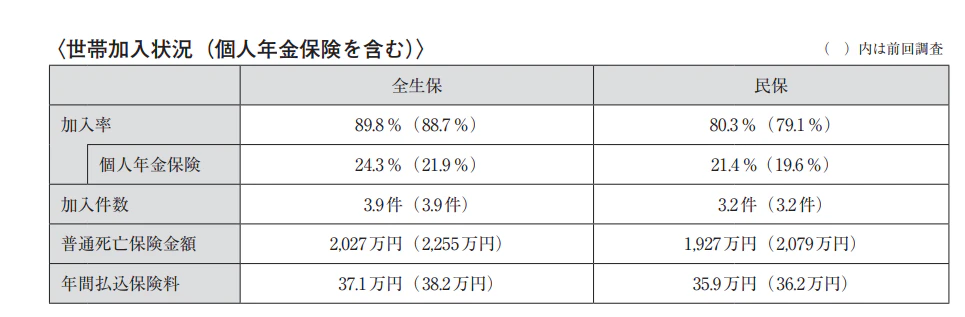
サンプル(2)
元PDF
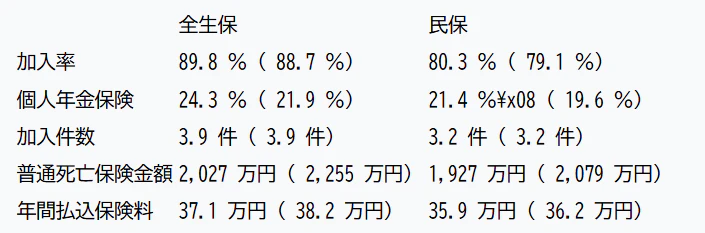
抽出した表
API結果(展開してください)
{
      "type": "table",
      "id": "table_7",
      "content": {
        "html": "<br><table id='92' style='font-size:14px'><thead><tr><td></td><td>全生保</td><td>民保</td></tr></thead><tbody><tr><td>加入率</td><td>89.8 %( 88.7 %)</td><td>80.3 %( 79.1 %)</td></tr><tr><td>個人年金保険</td><td>24.3 %( 21.9 %)</td><td>21.4 %\b( 19.6 %)</td></tr><tr><td>加入件数</td><td>3.9 件( 3.9 件)</td><td>3.2 件( 3.2 件)</td></tr><tr><td>普通死亡保険金額</td><td>2,027 万円( 2,255 万円)</td><td>1,927 万円( 2,079 万円)</td></tr><tr><td>年間払込保険料</td><td>37.1 万円( 38.2 万円)</td><td>35.9 万円( 36.2 万円)</td></tr></tbody></table>",
        "markdown": "",
        "text": ""
      },
      "coordinates": [
        {
          "x": 0.1158,
          "y": 0.2839
        },
        {
          "x": 0.8737,
          "y": 0.2839
        },
        {
          "x": 0.8737,
          "y": 0.4256
        },
        {
          "x": 0.1158,
          "y": 0.4256
        }
      ],
      "page": 9
    }
サンプル(2)では、個人年間保険の「21.4%」の後に「\b」の不要文字が入っていました。
7. 実行時エラーの対応
Kiroに作成してもらったpythonをEC2上で実行した際にいくつかエラーが発生したので、対応をまとめます。
・APIパラメータエラー
パラメータの段階的削除+再試行ロジック
・表構造崩れ
BeautifulSoupでHTML解析
・日本語文字化け
UTF-8-SIGを指定し、CSV出力
8. 運用時の考慮事項
今後、本番運用に向けて改善点を挙げてみます。
・監視: CloudWatchでAPIレスポンス時間をモニタリグ
・セキュリティ: Upstageとの連携はAPIキーでおこないます。本検証では環境変数に入れていましたが、AWS Secret Managerを利用するのが望ましいです。
・スケーラビリティ: SQS+Lambdaで非同期化を行う。処理の量に応じたAWS Batchの利用など。
また改善した結果をお伝えできればと思います!