
自作の監査プロンプト集を、9月30日に v1.0.0 として出しました。今回の修正は155項目、変更したファイルは12本です。手を動かしたのは自分ではなく、並列に走らせた AI エージェントたちでした。
ただ、並列にすれば片付くわけではありませんでした。同じ論点を渡した3体が、3通りの答えを書いてきた場面もあります。この記事は、AI エージェントに大量の修正を任せる前に人間が決めておくことを、実際に踏んだ順に書いた記録です。先に言ってしまうと、決めることは「割り方」「持ち場」「食い違いの採り方」の3つでした。
直したのは、AIに監査させるためのプロンプト集です
自作で ai-audit-prompts を作っています。AI支援開発の品質を担保するための、監査・レビュー用プロンプト集です。
- 何ができるかの紹介ページ: https://ishizakahiroshi.com/work.html?id=ai-audit-prompts
- リポジトリ(Star をいただけると励みになります): https://github.com/ishizakahiroshi/ai-audit-prompts
同じ悩みを持っている方は、下記で入ります。インストールも設定ファイルもありません。
git clone https://github.com/ishizakahiroshi/ai-audit-prompts.git
使うときは、監査したいリポジトリで AI エージェントにこう頼むだけです(README の例そのままです)。
<repo>/docs/README_activation.md を読み、監査対象に合う正典promptを選んで実行して。
監査対象に合わせて、アプリとソースコード、管理下のサーバー、資料と実装の差異、の3本の正典から1本が選ばれます。既定では始める前に、選んだ正典と引数、書き換えの有無の要約が出て、承認を待ちます。OS に依存するものはありませんが、サーバー診断が対象にしているのは Linux / Unix 系のサーバーだけで、Windows Server は今の版の対象外です。
この話には前があります。9日前に全項目を確認したはずのセキュリティ基準の pin が、新版の公開から4日で1本古くなっていたので、修正案132件を「事実」と「ルール適合」の2つの目で反証してから適用しました。
前回の記事: 9日前の「最新」が、もう古かった。自作の監査プロンプト集を、AIの群れに直させた話
24日後に同じことを聞いたら、今度はリンクが死んでいた
前回、pin の一覧には確認日を書きました。2026-09-01 です。
24日後の9月25日、同じ問いをもう一度投げました。最近のセキュリティの流れに沿っているか、腐っていないか、間違っていないか。今回は「今のルールを正しいものとして扱わない」を条件に足しています。ルールに照らして合っているかではなく、業界の実態に照らして監査が本当に正しく回るのかを見たかったからです。
腐っていたのは OWASP の2本でした。ASVS と API Security のページが404になっていました。プロジェクトページの置き場所が /projects/<slug> へ移っていて、古い URL が消えていたんです。版そのもの(ASVS 5.0.0 と API Security Top 10 2023)は今も現行です。
版は合っているのに、リンクだけ死ぬ。9日で1本古くなった前回とは、腐り方が違いました。
正直こたえたのは、腐りより誤りのほうです。重いものを抜き出すと、こうなります。
- サーバー診断で「読むだけ」のつもりで許可していた
docker inspectとsystemctl show -p Environmentは、既定で環境変数を出力する。秘密値が入っていれば、そのまま監査レポートへ書き写される - 公開ポートを見る例の
ss -tlnpは TCP の待ち受けしか見ないので、UDP と unix socket を落とす - 既定のスコープ「調査まで」が検証コマンドを一律に禁じていて、再現テストで確かめる手段が、既定のままでは使えなかった
- 指摘を却下する条件が「既存の防御がこのファイルのこの行にある」だけで、迂回できないかを考えさせていなかった
- レポートの既定の保存先が対象リポジトリの中で、public リポジトリなら未修正の脆弱性が次の push で公開される
監査のためのプロンプトが、監査結果そのものを間違わせる。書いたのは自分です。これは堪えました。
調査は14の切り口で並列に走らせ、候補を「事実」と「契約」の2つの目で反証し、最後に抜けを探す批評を足しました。エージェントは77体、6.3時間、サブエージェントのトークンは約1,227万です。候補209件のうち確定189件、却下8件、未確認12件。重大度 high は23件ありました。
1つ目: 175件の取りまとめを、1体に任せない
189件はそのままでは直せません。同じ箇所への指摘が重なっているので、まず束ねる必要があります。
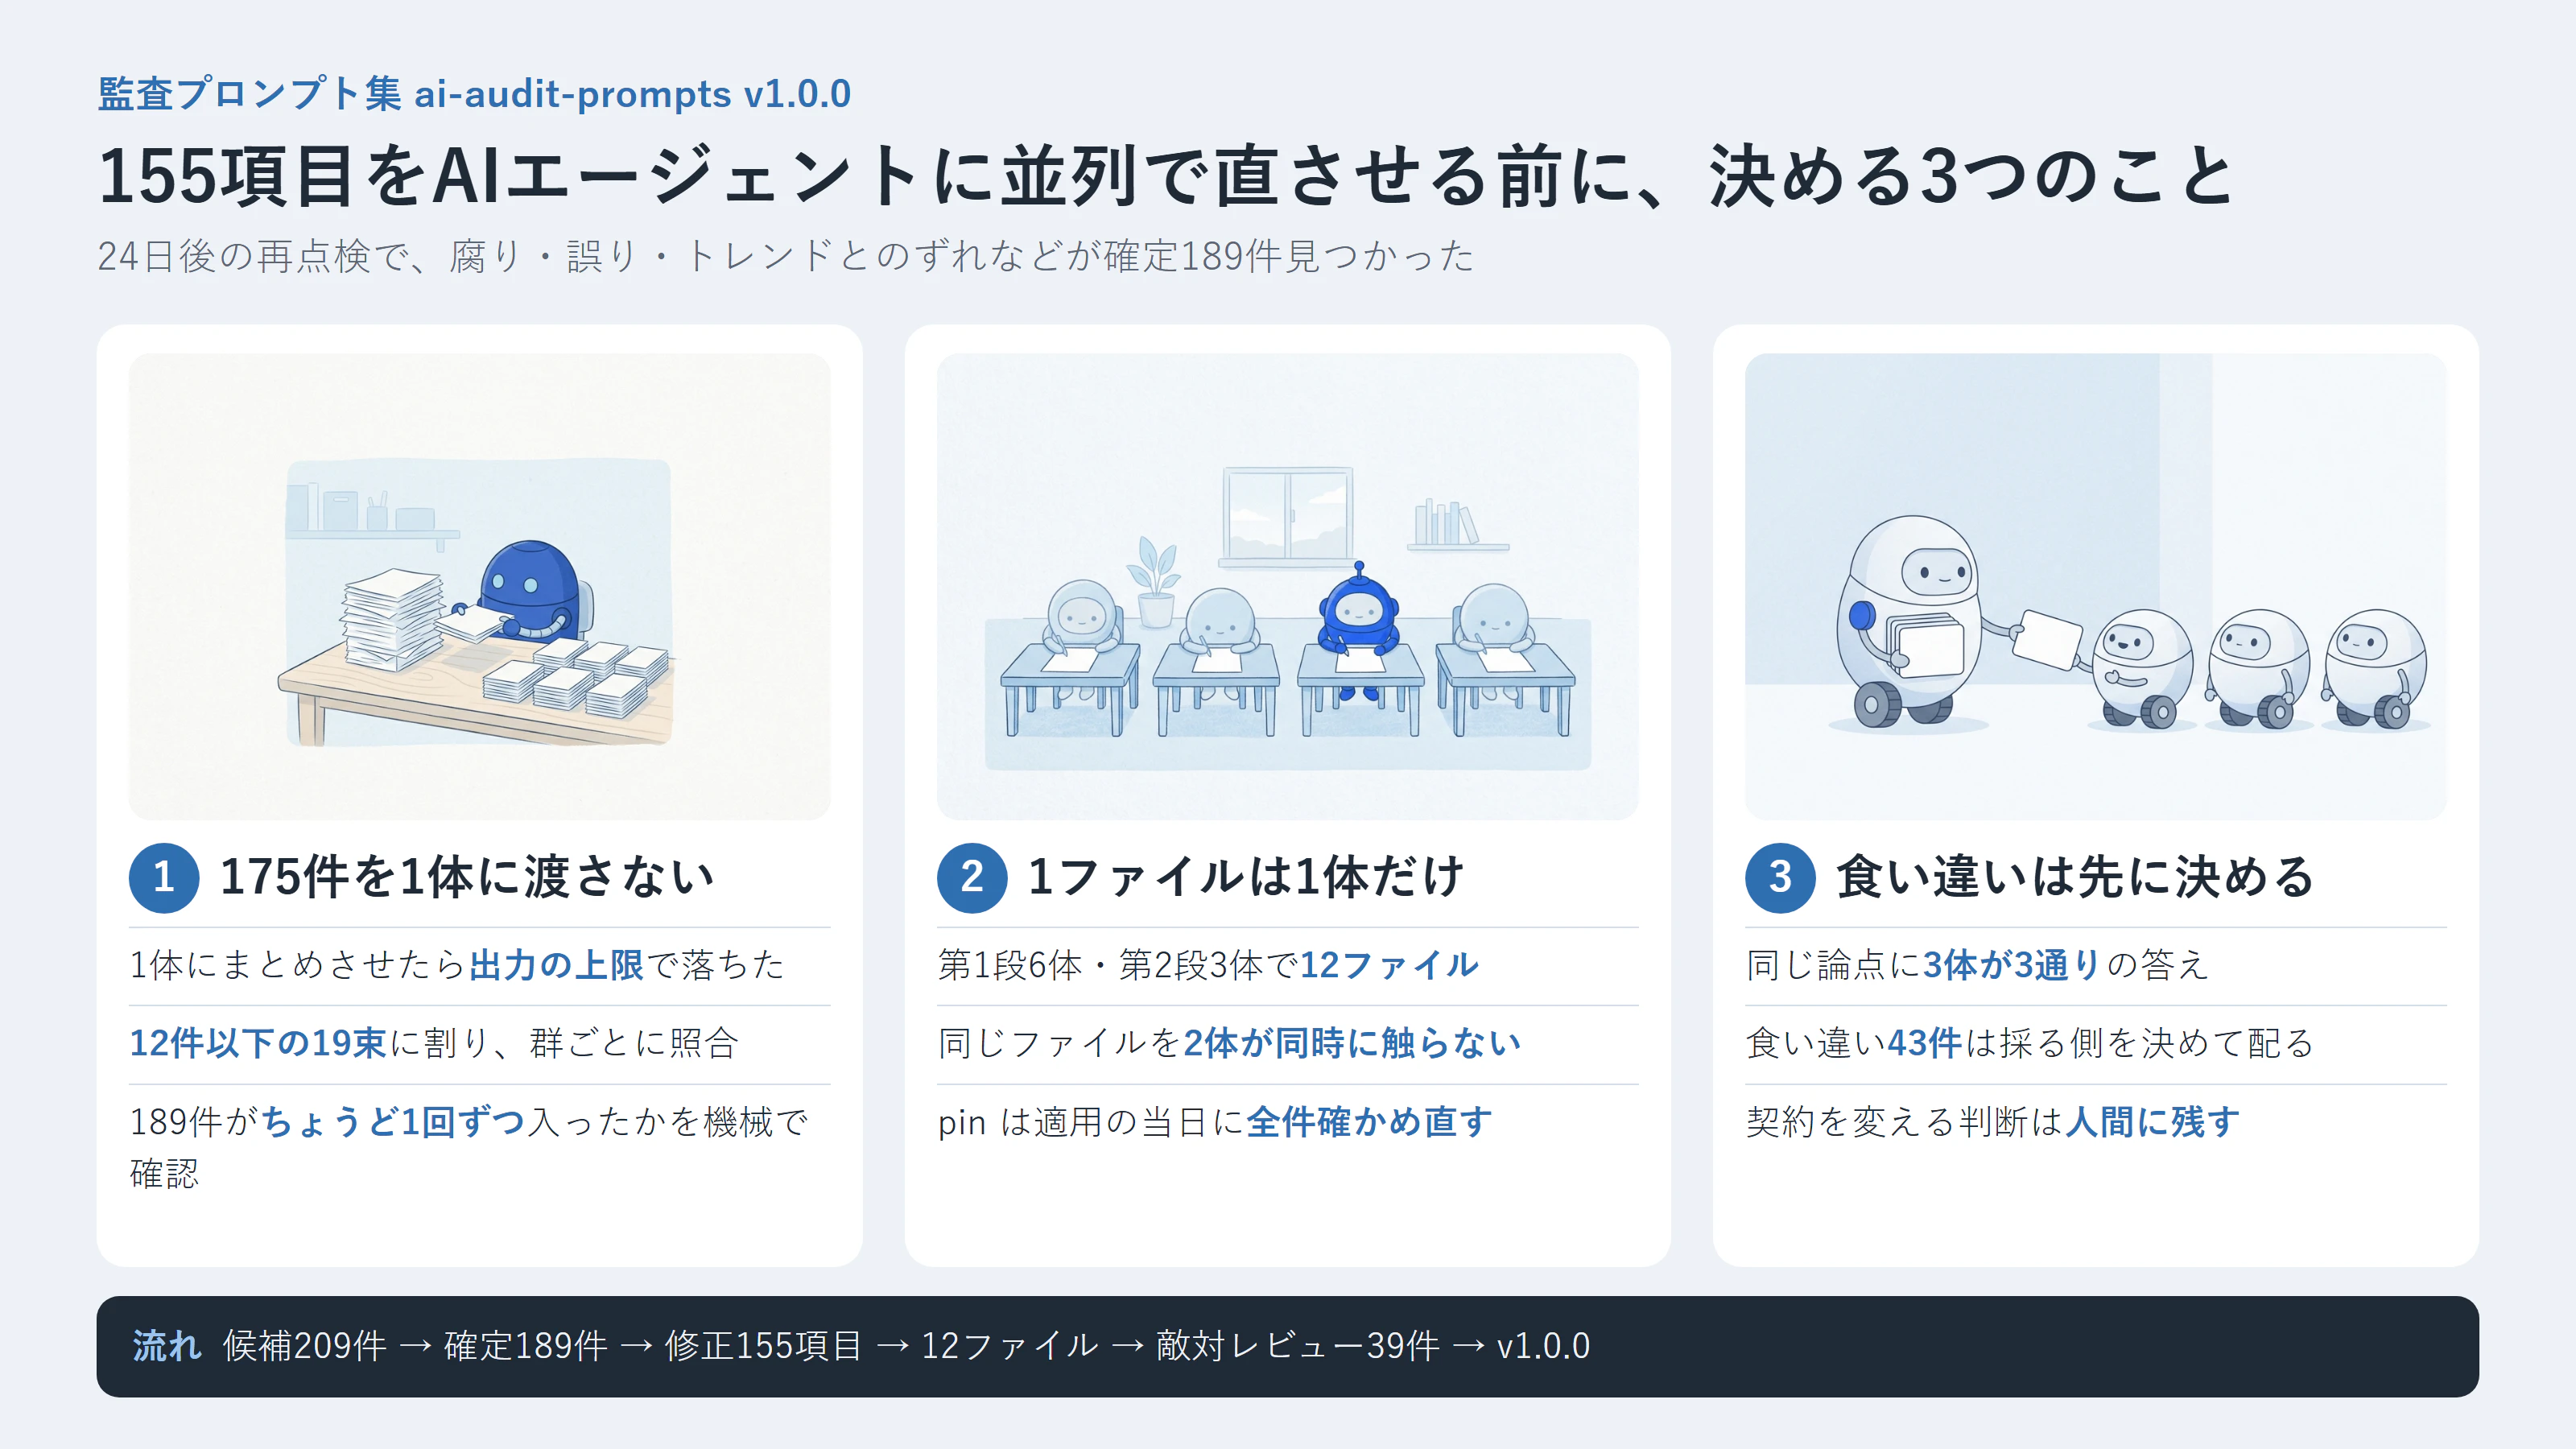
最初は、候補175件を1体のエージェントに渡して「重複をまとめて」と頼みました。出力が 64,000 トークンの上限に当たって落ちました。そりゃそうだ、という量です。
そのときは束ねないまま検証へ進めたので、検証のエージェントが50体に膨らみました。落ちた処理を黙って迂回すると、後ろの段が太ります。
取りまとめをやり直すときは、確定189件を12件以下の束に割りました。19束です。束ごとに1体が項目へまとめ、ファイルの群ごとに別の1体が照合する2段構成にしています。
確定189件
  → 12件以下の束に割る(19束)
  → 束ごとに項目へまとめる
  → ファイルの群ごとに照合する(4群)
  → 修正項目155件
最後に、189件の ID が155項目の「統合元」にちょうど1回ずつ入っているかを機械で確かめました。欠落0、重複0、未確認と却下の混入0。束ねるのは AI に任せても、漏れの確認までは任せません。
途中で、モデルが替わった
この取りまとめは9月27日に Claude Fable 5.1 で始めました。23体のうち15体が終わったところで、週の利用上限に当たって止まりました。
2日後、Claude Opus 5.5 に交代して、同じ実行を同じ引数で再開しています。終わっていた15体はキャッシュから返り、止まっていた8体だけが走り直しました。日付の引数は9月27日のまま据え置いています。変えるとキャッシュが効かなくなるからです。
1つの成果物の中に、2つのモデルの出力が混ざったことになります。束ねの15体は Fable 5.1、残りの束ね4体と照合4体は Opus 5.5 です。どの段をどちらが出したかは作業記録に残しました。…と書いたけど、その記録が間違っていた話は後で出てきます。
2つ目: 1つのファイルは、1体だけが編集する
155項目の行き先は12ファイルです。項目ごとにエージェントを立てると、同じファイルを何体もが同時に書き換えることになります。それはやりたくありませんでした。
そこで持ち場をファイル単位で切りました。第1段は6体です。アプリ監査の正典、サーバー診断の正典、資料と実装の突合の正典、共通契約をまとめた正本2本、routing と README 日英などに1体ずつ。残りの1体は pin の確かめ直し専任です。第2段は3体で、pin の確かめ直しの結果と、次の節で書く決定事項を反映し、CHANGELOG をまとめました。
各エージェントには、ファイル別の項目索引から自分の担当 ID を引かせ、さらに詳細の一覧を自分のファイル名で grep させて漏れを拾わせています。
pin は、4日前の修正案をそのまま信じませんでした。適用の当日に、両方の正典の pin を全件、公式の一次情報で確かめ直しています。結果、9件は修正案どおりではなく、確かめた値で入れ直しました。
3つ目: 食い違う項目は、先に決めて全員に配る
ここがいちばん痛かったところです。
155項目には、項目どうしで言っていることが食い違う点が43件ありました。それぞれに「どちらを採るか」の方針を付けてあったのですが、その中に、方針が「owner が決める」のまま、決定の記録が無い論点がありました。サーバー診断で、kubectl と DNS の照会を「外への通信の例外」に入れるかどうかです。
第1段の3体は、それぞれ別の答えを書いてきました。
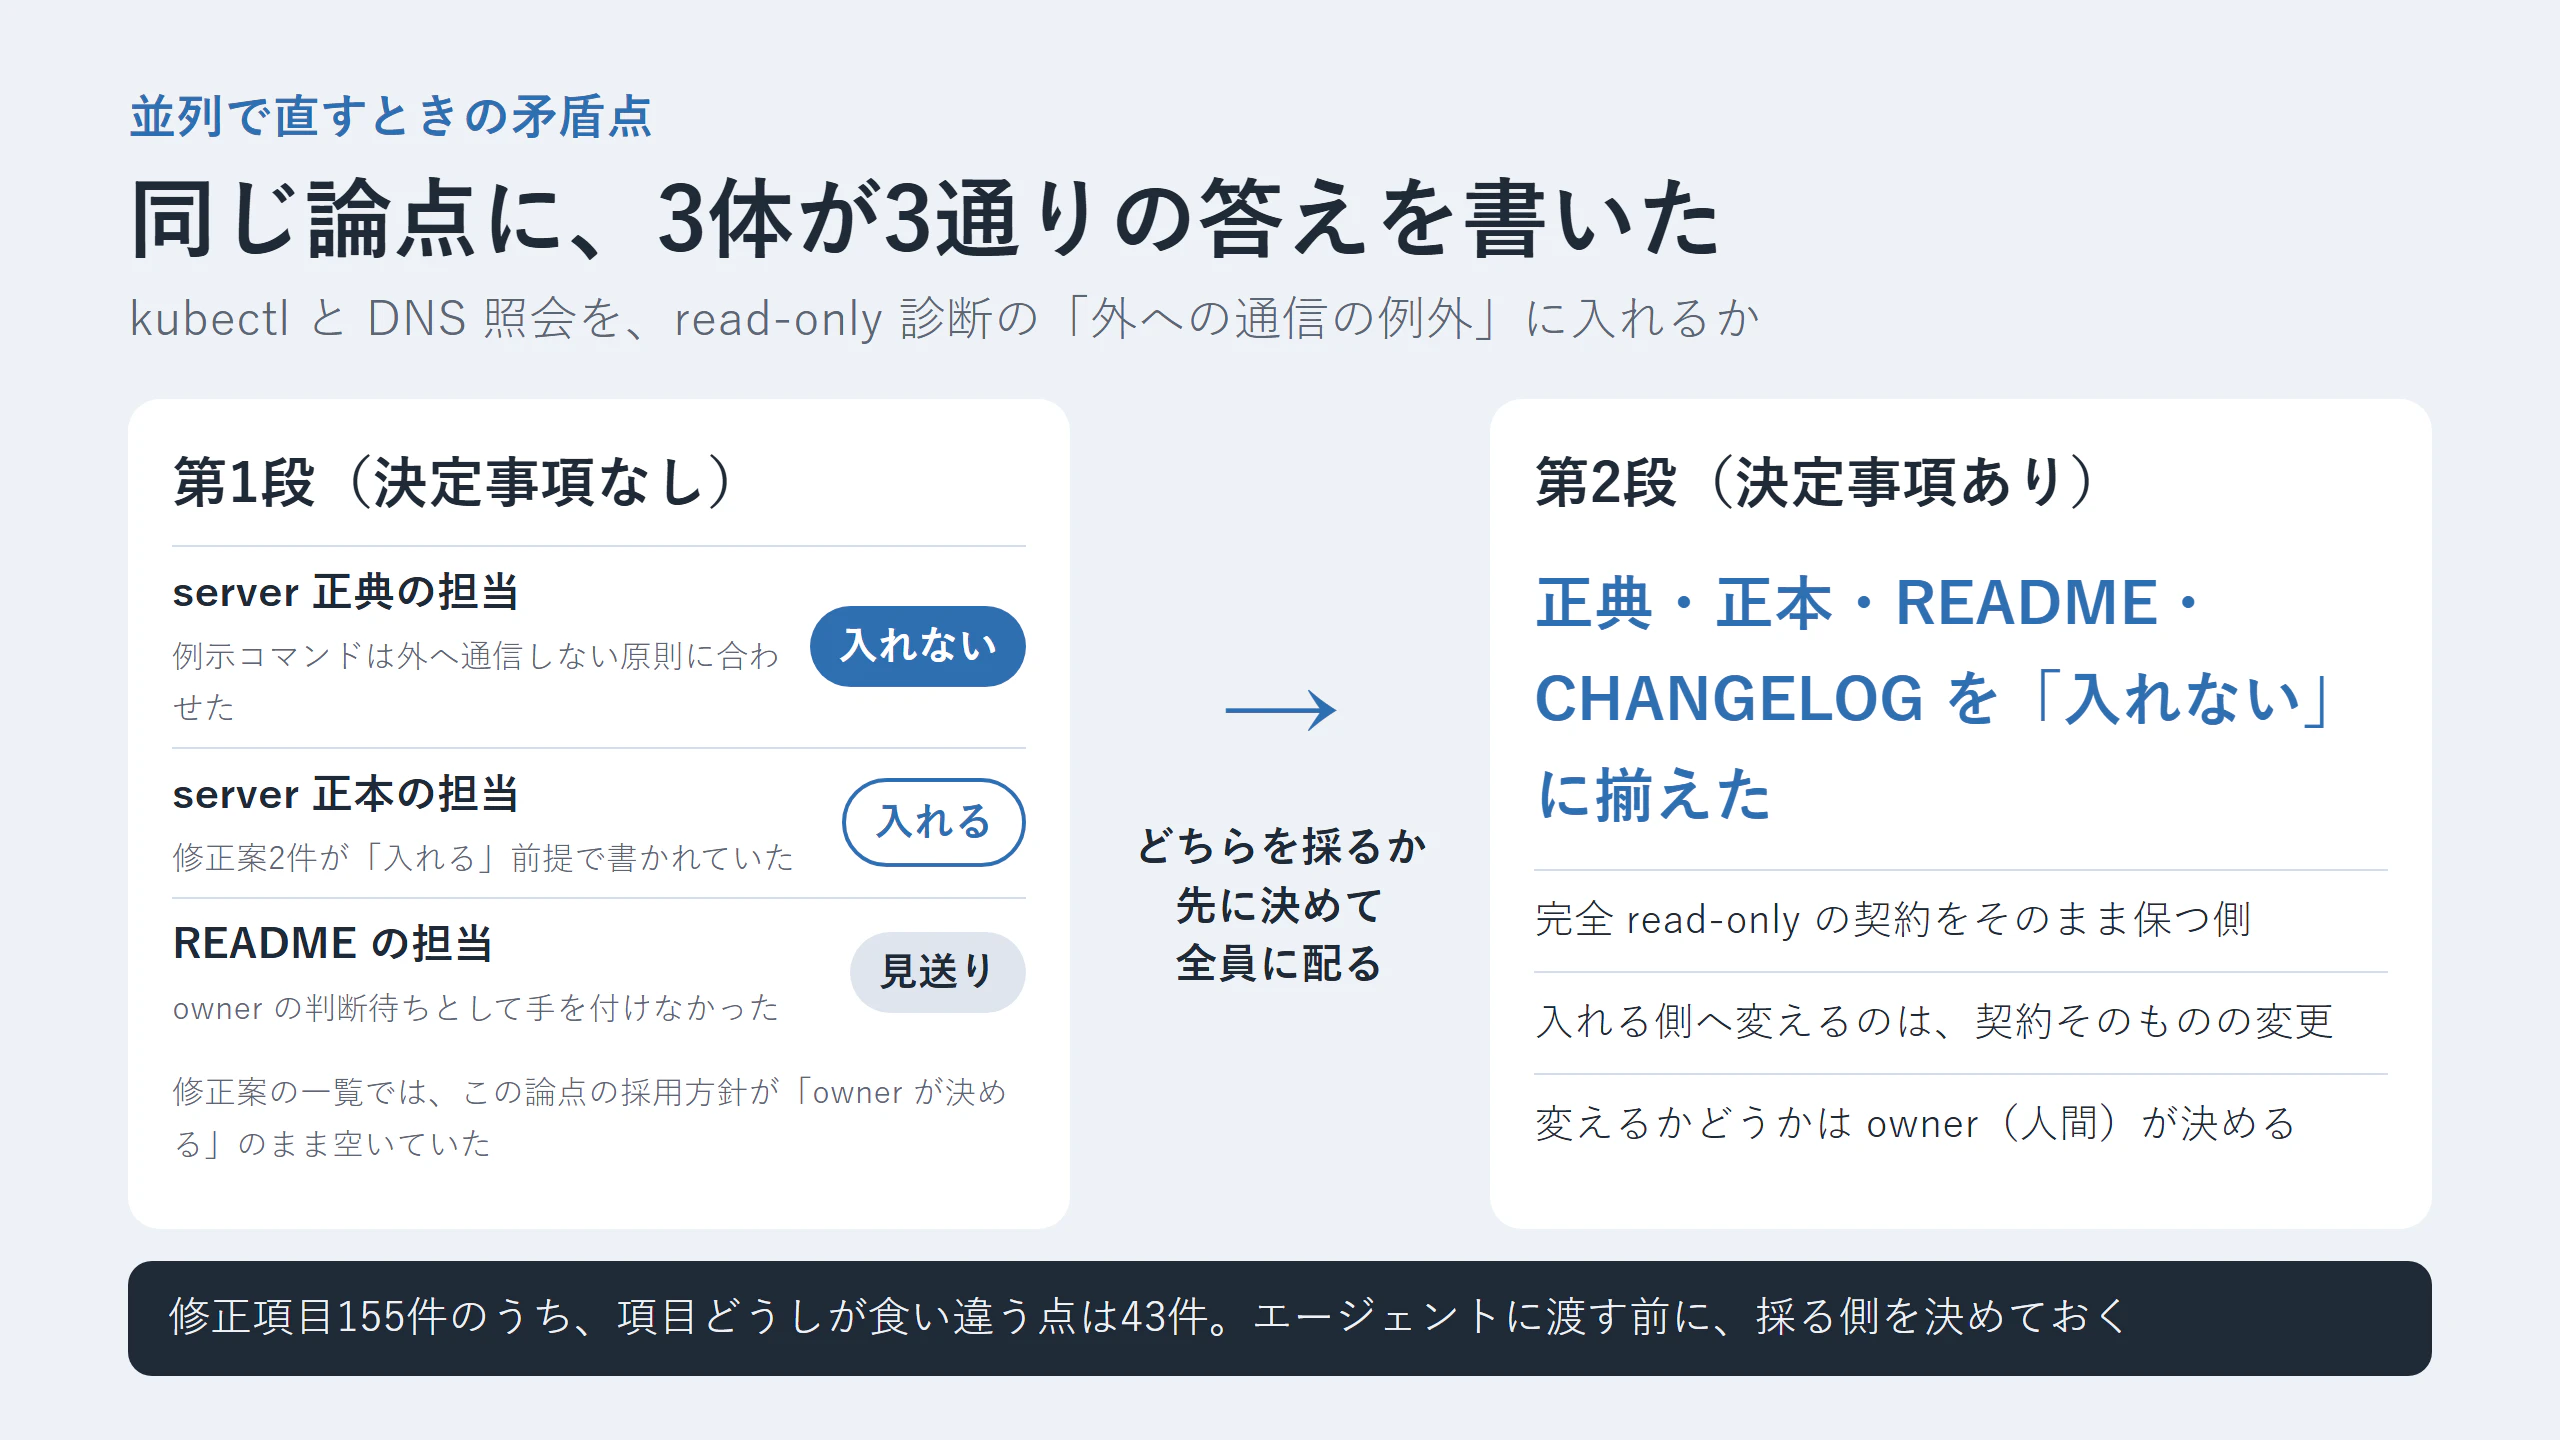
サーバー診断の正典の担当は「入れない」、共通契約の正本の担当は「入れる」、README の担当は「見送り」。3体で3通りです。
怖いのは、どれも筋が通っていたことでした。正典の担当は「例示のコマンドは外へ通信しない」という設計原則に合わせた。正本の担当は、修正案のうち2件が「入れる」前提で書かれていたので、それに合わせた。README の担当は、owner の判断待ちなので触らなかった。1体ずつ見れば、誰も間違っていません。並べた瞬間に矛盾になります。
第2段に入る前に、食い違いの採り方を1枚の決定事項にまとめて、全員に配りました。kubectl と DNS は例外に入れない。サーバー診断の観点は18。修正後の確認は「適用後確認」と呼ぶ。独立検証の表記は「あり / 一部 / なし」。こういう細かい決定を全部です。第2段で、正典・正本・README・CHANGELOG は同じ側に揃いました。
「入れない」側を採ったのは、完全 read-only という今の契約を変えないためです。入れる側へ動かすのは契約そのものの変更なので、そこは owner の自分が別に決めることにして、まだ動かしていません。
次にやるなら、第1段の前にこの決定事項を作ります。食い違いの一覧を読んで採る側を決めてから配れば、第2段で揃え直す手間はそもそも出ません。
直したあとに、読むだけのレビューを5体走らせた
適用が終わったら、まず機械の検査です。git diff --check、公開している Markdown 22本の構造チェック、秘密情報のスキャン、正典に載っている URL 78件の死活、README 日英の行ごとの構造比較。URL は75件が200で、W3C の2件は bot 判定の403だったので本文を取り直して中身を確かめました。
URL の確認で1つ拾いものがありました。URL の直後に全角の括弧が空白なしで続くと、GitHub の自動リンクが括弧の中の日本語まで URL に含めてしまいます。7か所あったので、URL と括弧の間に半角の空白を入れました。
そのうえで、読み取り専用のエージェントを5体、敵対レビューに回しました。担当は、アプリ監査の正典の前半と後半、サーバー診断の正典と正本、資料と実装の突合の正典、残りの正本と routing と README と CHANGELOG です。指摘は39件、high は0件でした。
39件は、各ファイルの担当に反証を試みさせてから反映しています。反証で落ちたものは0件で、全件を入れました。
印象に残ったものを2つ書きます。
1つは、サーバー診断で許可している dnf の照会です。-C を付けても、dnf は実行のたびに自分のログを書きます。zypper も --no-refresh 付きで同じでした。「何も書かない」は守れません。かといって許可リストから外すと、RHEL 系で更新の状態を判定するいちばんの手段を失います。なので、ログインや sudo と同じ「避けられない記録」として明記し、実行したコマンドと書き込み先をレポートに残す形にしました。
もう1つは件数です。CHANGELOG に「pin を全50件確認」と書いたら、数え方で49件にも54件にもなると指摘されました。件数は外しました。何を数えたかまで書けない数字は、書かないほうがいい。
ただ、このレビューの独立性は「一部」です。別の文脈で走らせてはいても、同じモデルの系統が読んでいます。リポジトリの定義に沿って、そう記録しました。
「どのAIがやったか」の記録が、別のモデル名になっていた
途中でモデルが替わったので、どの段をどのモデルが出したかは大事な情報です。ところが作業記録を見たら、9月27日に Fable 5.1 が始めた実行が claude-opus-5[1m] として残っていました。
原因は観察で確かめました。Claude Code の settings.json の env に、モデル名が固定値で書いてありました。記録に使っている自作ツールは、モデルを引数で渡さないとこの環境変数を読み、実際に動いているモデルとは照らし合わせません。しかも記録した値を返さず、警告も出しません。記録した AI 本人には、気づく手段がありませんでした。
直したのは3か所です。設定から固定のモデル名を消す。ツール側は、モデルが決まらないときに警告を出し、記録した値を返す。作業手順のひな形に、モデルを引数で渡す形を入れる。
古い記録の行は書き換えていません。誤っていたという事実を、作業の記録のほうに残しました。
v1.0.0 にした。リリース本文は1分だけ壊れていた
版番号は、AI の推奨は v0.9.0 でした。v1.0.0 にしたのは自分の判断です。
タグを打って GitHub Release を作ったら、本文がおかしなことになっていました。CHANGELOG の冒頭が、逆順に並んでいたんです。原因はこれでした。
$e = -1
for ($i = $s + 1; $i -lt $lines.Count; $i++) {
  if ($lines[$i] -like '[1.0.0]: *') { $e = $i; break }
}
$body = $lines[($s + 1)..($e - 1)] -join "`n"
-like はワイルドカードなので、[1.0.0] の角括弧が「1 か . か 0 のどれか1文字」という文字クラスとして読まれます。比較リンクの行に一致せず、$e は -1 のまま。PowerShell の .. は終わりが始まりより小さいと逆向きに数えるので、$lines[($s + 1)..-2] は節の最初の行から先頭へ向かって逆順に拾い、最後に末尾の2行まで拾っていました。
約1分後に、完全一致で範囲を取り直して gh release edit --notes-file で差し替えています。本当に直すべきだったのは角括弧より、見つからなかったときに -1 のまま範囲へ流したことのほうです。見つからなければ、そこで止める。1行で済む話でした。
紹介動画も作り直しました。ここも AI の推奨は「作らない」で、作り直すと決めたのは自分です。AI は音量を数値で測っていましたが、誰も耳で聴いていなかったので、YouTube に上げる直前で止めてもらい、聴いてから公開しました。23秒です。
ai-audit-prompts はこんなときに刺さります
- AI に「監査して」と頼んだら勝手にコードを直された経験があり、既定は調査までに留めたい人
- 自分が管理しているサーバーを、設定変更も再起動もさせずに点検させたい人
- 顧客向けの資料や仕様書と、いまの実装がずれていないかを突き合わせたい人
- 監査レポートが「概ね問題なし」で終わり、何を調べて何を調べていないのかが分からない人
- 今回から、git の履歴に残った秘密、LLM の出力が描画される経路、web サーバーやリバースプロキシの設定と公開ツリーも見るようになりました
いずれかに心当たりがあれば、clone して docs の正典を AI エージェントに渡すだけで試せます。インストールも設定ファイルも要りません。
- 紹介ページ(スクショと機能一覧): https://ishizakahiroshi.com/work.html?id=ai-audit-prompts
- リポジトリ(Issue / PR 歓迎): https://github.com/ishizakahiroshi/ai-audit-prompts
Star をいただけると開発の励みになります。使ってみて「ここが不便」があれば、Issue でも X の DM でも大歓迎です。
あわせて読みたい
- 監査プロンプトをAIツール別に持つのをやめた。10本を対象別3本へ統合した設計(今回 v1.0.0 で固めた「対象別の正典3本」が、どうやってできたかの話です)
- 「監査して」と頼んだら、コードが書き換わっていた(既定を「調査まで」にした事故の話です。今回はその既定のままで、検証コマンドは走らせられるように直しました)
- AIコード監査の「修正済み」が分からない。findingをC管理にして結果報告を作業ハブにした(監査後の対応状況を追う設計の話です。今回、その状態に「見送り」を足しました)
おわりに
並列にして速くなったのは、書く手のほうでした。どちらの側を採るか、どの版で出すか、音を聴いてから上げるか。決めるところは、結局こちらに戻ってきます。
次にどこが腐るのかは分かりません。とりあえず、確認日だけは書き続けます。
📎 図解版・関連リンクをまとめたページがあります:
https://ishizakahiroshi.com/articles/2026/2026-09-30_audit-prompts-v1-parallel-fix/
※ ヘッダー画像とインフォグラフィックの絵は AI(画像生成)で作成しています。
※ 本文の挿絵も AI(画像生成)で作成しています。
書いた人: ishizakahiroshi
群馬の北部で、保護猫2匹と暮らす、在宅エンジニア(何でも屋)
https://ishizakahiroshi.com/
https://github.com/ishizakahiroshi
X(業務委託・各種相談はこちら):
https://x.com/ishizakahiroshi
バックエンド・インフラ・AI連携まわりで、業務委託のご相談を受け付けています。フルリモートです。スポットや週2〜3時間からでも歓迎で、いろんな案件に携われたらうれしいです。こんな相談、歓迎です。