

サーバーが落ちたことに、自分で気づけた記憶があまりありません。だいたい「サイトが見られないんですけど」と誰かに言われて知ります。言われるまでの時間は、運が良ければ数時間、悪ければ翌朝までです。
監視を入れていない理由も毎回同じでした。入れるほうが面倒だからです。とくにレンタルサーバー(共有ホスティング)は、root 権限が無い、パッケージを入れられない、常駐プロセスを置けない。監視エージェントを常駐させる前提の道具は、この 3 行でほぼ全部脱落します。
それで、その 3 つを最初から前提にした死活監視を Go で書きました。この記事は、その実装の中身と、途中で決めたことの理由です。

先に結論。この道具が答える問いは 1 つだけです
長い記事になるので、要点だけ先に置きます。
- 各サーバーで cron から 1 回だけ動いて終わる agent が、基本的な指標を集めて HMAC 署名付きで POST する
- 受信側の monitor がそれを保存し、レポートが届かなくなったら 1 回だけ知らせる。直ったらもう 1 回知らせる
- 受信側にデータベースは要らない。1 行 1 レポートの JSONL と、状態を持つ JSON が 1 枚だけ
- root 権限もパッケージ導入も要らない。agent はサーバーへ一切書き込まない
- グラフもクエリ言語も無い。答えるのは「まだ報告してきているか」だけ
「CPU 使用率が 90% を超えたら鳴らす」型の監視ではありません。閾値を組み立てるところから逃げています。逃げた理由が、この記事のいちばん大事な部分です。
heartpost という死活監視ツールを作りました
自作で heartpost という、レンタルサーバーと小規模 VPS の死活監視だけを担う OSS を作っています。サーバーが黙ったことに、人より先に気づく。それだけの道具です。
- 何ができるかの紹介ページ: https://ishizakahiroshi.com/work.html?id=heartpost
- リポジトリ(Star をいただけると励みになります): https://github.com/ishizakahiroshi/heartpost
同じ悩みを持っている方は、下記で入ります。パッケージレジストリには置いていないので、GitHub Releases から実行ファイルを取ってきます。
gh release download --repo ishizakahiroshi/heartpost --pattern '*-linux-amd64.zip'
unzip heartpost-*-linux-amd64.zip -d heartpost && cd heartpost
cp config/monitor.example.toml monitor.toml
zip の中には heartpost-agent と heartpost-monitor の 2 つの実行ファイル、設定サンプル 3 つ、SSH 経由の設置スクリプト、systemd のユニットが入っています。
起動の仕方は、受信側と監視される側で違います。
受信側(Linux VPS)は、設定を書いてから monitor を起動します。止めるのは Ctrl+C か SIGTERM で、graceful shutdown します。
./heartpost-monitor -config ./monitor.toml
監視したいサーバー側(FreeBSD の共有ホスティング、または Linux)は、自分で SSH して置いてもいいのですが、付属スクリプトが実行ファイルと設定を配って crontab に 1 行足すところまでやります。手元のマシンから実行します。
./scripts/install-agent.sh \
  --host user@web01.example.com \
  --binary ./heartpost-agent \
  --config ./agent.toml \
  --secrets ./agent_secrets.toml
共有ホスティングが FreeBSD なら、--binary には freebsd-amd64 の zip に入っているほうの agent を渡します。crontab の行はマーカーコメントで置き換える作りなので、2 回流しても agent が 2 本にはなりません。
Linux の VPS を systemd で回したい場合のユニットとタイマーも同梱していますが、こちらは実機での確認がまだ済んでいません。手元で書いて入れたところまでです。cron で回すほうは実際に動かしています。
対応 OS は正直に書いておきます。リリースしているのは linux/amd64・linux/arm64・freebsd/amd64 の 3 つだけです。macOS 向けのビルドは配布していません(Go なので GOOS=darwin でビルドは通るはずですが、こちらで動かして確かめていないものを配るのはやめました)。Windows は対象 OS ではありません。開発機で走らせることはできますが、後述する鍵ファイルの権限チェックが機能しないので警告が出ます。
置いたら、あとはブラウザで一覧を開くだけです。普段は見に行かなくて済むようにするのが目的なので、見に行く用事はほとんど起きません。
監視で難しいのは「値が変になったこと」ではなく「何も来なくなったこと」です
作りはじめる前に、いちばん時間を使ったのがここでした。
値の異常を知らせる仕組みは、世の中に山ほどあります。CPU が張り付いた、ディスクが 90% を超えた、レスポンスが遅い。どれも「サーバーが動いていて、値を報告できる」ことが前提になっています。
ところが、本当に困るのはサーバーが完全に止まったときです。そして完全に止まったサーバーは、異常値すら送ってきません。
受信側から見ると、この 2 つは見分けがつきません。
- 全台が健康で、報告する異常が何も無い
- 全台が死んでいて、報告する主体が居ない
どちらも「何も届かない」です。届かないことを異常として扱う仕組みが無いと、監視画面はいちばん静かなときにいちばん健康そうに見えます。
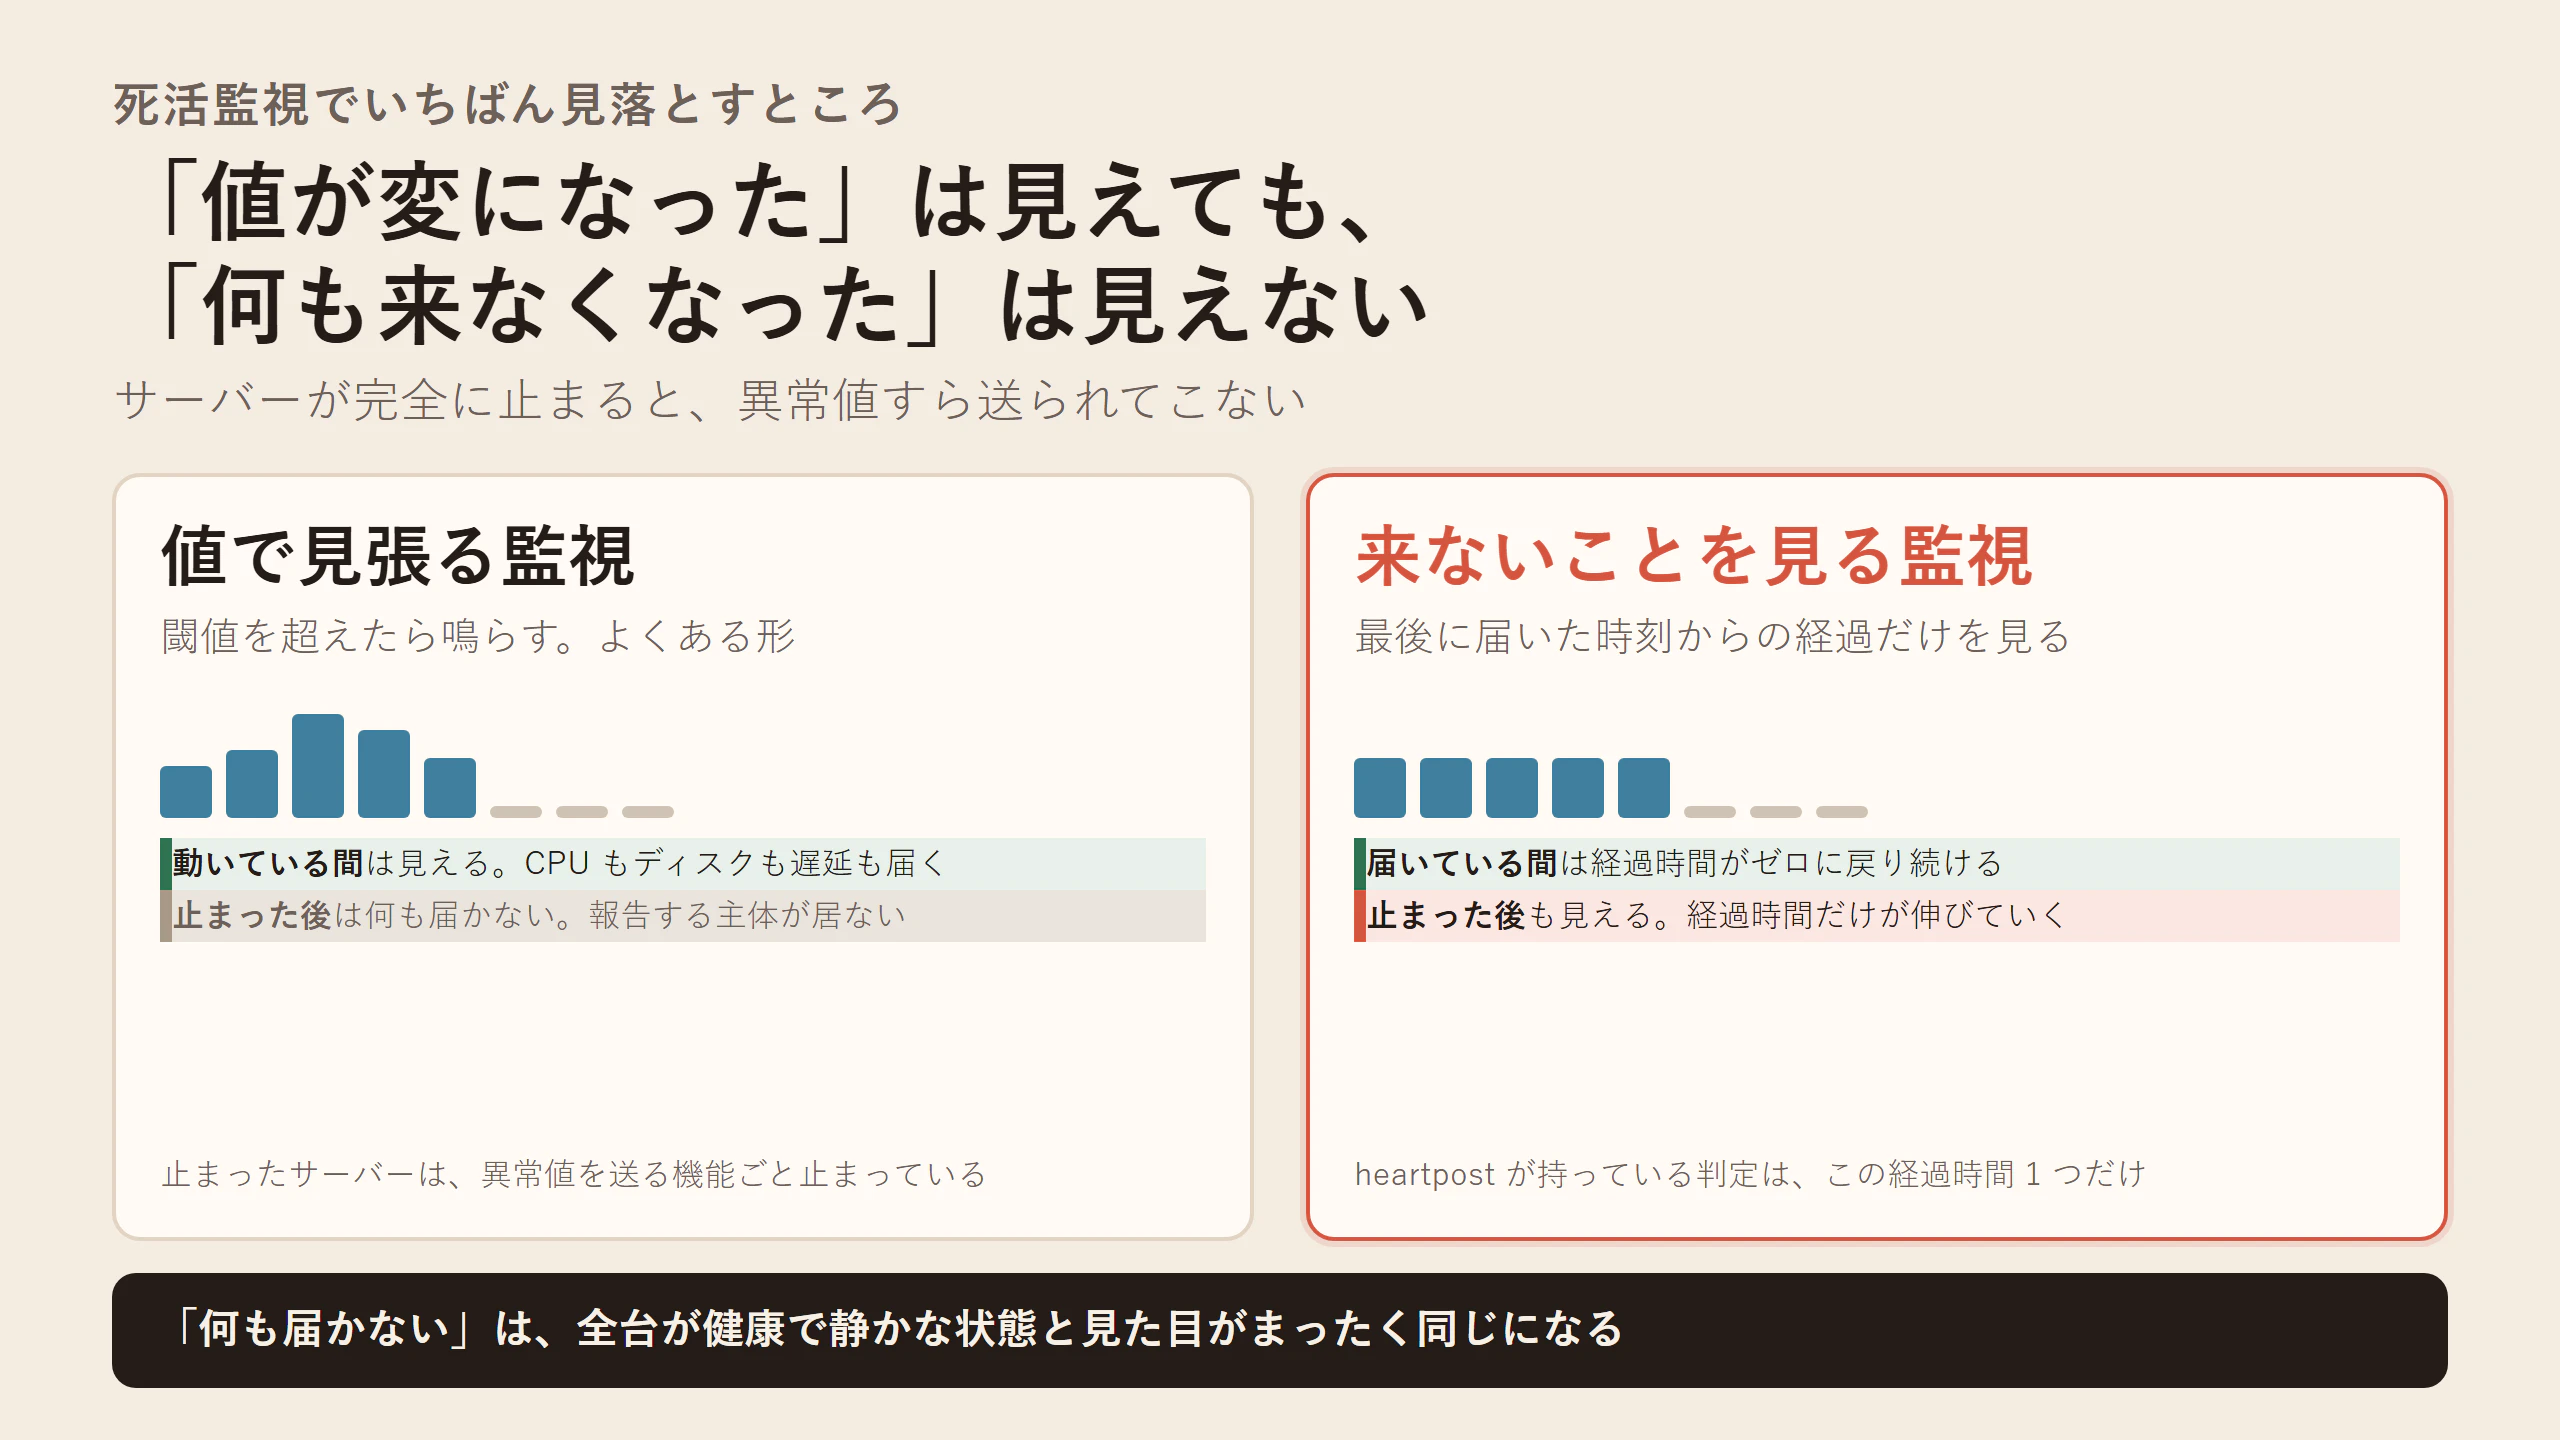
上の図は、同じ 1 台のサーバーを 2 通りの監視で見たときに、それぞれ何が見えているかを並べたものです。値で見張るほうは、サーバーが動いている間しか観測できません。経過時間だけを見るほうは、止まった後も「何分だまっているか」が伸び続けるので、そこだけが見え続けます。
だから heartpost は、閾値の判定をほとんど持っていません。持っているのは「最後に受け取った時刻」と「そこから何秒経ったか」だけです。値そのものは保存して画面に出しますが、値で鳴らすことはしません。
やることを 1 つに絞ると、外れる可能性のある場所もそのぶん減ります。
レンタルサーバーは、監視を入れる側の前提を全部壊してきます
共有ホスティングの制約は、だいたいこの 3 つに集約されます。
-
root 権限が無い。
/etcにも/usr/local/binにも置けない -
パッケージを入れられない。
aptもpkgも無い。Go のツールチェインも無い - 常駐プロセスを置けない。置けたとしても、規約か監視プロセスの kill で落とされる
多くの監視 SaaS やセルフホスト型の監視基盤は、「エージェントをサービスとして常駐させる」ところから始まります。この時点で選択肢から外れます。
使えるものは、たいてい 2 つだけ残ります。ホームディレクトリと、crontab です。
なので実行ファイル 1 個をホームの下に置いて、cron から呼ぶ形にしました。これは妥協ではなく、結果的に良いほうへ転びました。
常駐しないと決めたら、いくつかの問題が勝手に消えました
one-shot にしたことで消えた問題が 3 つあります。
1 つ目。監視プロセスが死んでいたことに気づけない問題が消えます。 常駐型の監視エージェントは、それ自身が落ちると当然何も送らなくなります。そして受信側から見た「エージェントが落ちている」は「サーバーが落ちている」と同じ形で届きます。one-shot なら、そもそも起動しなくなったこと自体が欠報として出ます。区別する必要が無くなります。
2 つ目。メモリリークの心配が消えます。 数秒で終わって死ぬプロセスは、リークする時間がありません。共有ホスティングのメモリ上限は厳しいので、これは効きます。
3 つ目。設定の再読み込みが要らなくなります。 毎回起動時に読むので、設定を書き換えたら次の実行から効きます。SIGHUP のハンドリングも、設定のホットリロードも書かなくて済みます。
代わりに増えた仕事は、二重起動の防止でした。前回の実行が終わっていないのに次の cron が来ることがあります。ファイルロックで、後から来たほうを待たせずに降ろしています。
unlock, err := filelock.Acquire(lockPath)
if err != nil {
    if errors.Is(err, filelock.ErrLocked) {
        // 前回の実行がまだ終わっていない。cron は次の周期でまた起動するので、
        // 待たずに降りる。二重に集めて二重に送るほうが害が大きい。
        return fmt.Errorf("another agent is already running (lock: %s)", lockPath)
    }
    return fmt.Errorf("acquire lock %s: %w", lockPath, err)
}
defer unlock()
待たせない理由は、待っているあいだに次の cron が来るからです。詰まったときに列を作る作りにすると、共有ホストで一番迷惑なプロセスになります。
全体の構成
登場人物は 2 つだけです。

図にすると、左に監視される側のサーバーが並び、右に受信する monitor が 1 台だけ立ちます。矢印は 1 方向で、monitor からサーバーへ向かう線はありません。出口は webhook 1 本と一覧画面 1 枚だけです。
cron(5 分ごと)                          自分の VPS
  heartpost-agent  --HMAC 署名付き JSON-->  heartpost-monitor  --> webhook
  (共有ホスト・root なし)                 (JSONL をディスクへ・画面 1 枚)
リポジトリの構成はこうなっています。
heartpost/
├── cmd/
│   ├── heartpost-agent/     収集して送るほう(one-shot)
│   └── heartpost-monitor/   受けて保存して判定するほう(常駐)
├── agentsig/                HMAC 署名の計算。送信側と検証側が同じものを呼ぶ
├── report/                  ワイヤ仕様(JSON のキー・ヘッダ名・パス・時刻書式)
├── collector/
│   ├── rental/              共有ホスティング向け 9 項目
│   └── vps/                 Linux VPS 向け 8 項目
├── core/
│   ├── receiver/            受信・保存・死活判定・画面
│   └── notify/              webhook 通知
├── internal/filelock/       二重起動の防止
├── config/                  設定サンプル 3 つ
└── deploy/systemd/          ユニットとタイマー(実機未検証)
テストを含めて Go のコードは 7,000 行台です。外部依存は TOML パーサ 1 つだけにしています。
ワイヤ仕様は先に凍らせました。稼働中の agent は勝手に直らないので
ここが実装の中でいちばん神経を使った部分です。
agent は監視したいサーバーの台数だけ散らばっていて、それぞれが cron で動いています。monitor 側の JSON のキー名を 1 つ変えると、全台を入れ替え終わるまで受信できない期間ができます。しかも入れ替えは SSH で 1 台ずつです。
なので「変えてはいけないもの」をパッケージとして切り出して、そこに書いてある定数を送信側と受信側の両方が参照する形にしました。
// Package report は agent から monitor へ送るレポートの形を定める。
//
// ここに書かれている JSON のキー名、HTTP ヘッダ名、既定のパス、時刻の書式は
// **ワイヤ仕様**であり、送信側と受信側の両方が同じ定義を参照する。
package report

const (
    HeaderAgentID    = "X-Agent-Id"
    HeaderTimestamp  = "X-Agent-Timestamp"
    HeaderSignature  = "X-Agent-Signature"
)

const DefaultPath = "/api/agent/report"
const TimeFormat = time.RFC3339

type Payload struct {
    AgentID    string                     `json:"agent_id"`
    AgentLabel string                     `json:"agent_label"`
    AgentType  string                     `json:"agent_type"`
    ReportedAt string                     `json:"reported_at"`
    Collectors map[string]json.RawMessage `json:"collectors"`
}
そのうえで、この形を golden test で固定しています。期待する JSON をファイルとして持っておいて、生成結果と 1 バイト単位で比べるテストです。キーをリネームすると、意図があってもなくても必ず落ちます。
落ちること自体が目的です。「うっかり」でここを通り抜けられないようにしておかないと、半年後の自分が普通に直します。
もう 1 つ、地味に効いている設計があります。収集に失敗した項目は、null ではなくエラーを持つオブジェクトを入れることです。
// ErrorKey は collector の収集失敗を表すオブジェクトのキー。
//
//	"collectors": {"disk": {"_error": "df: command not found"}}
const ErrorKey = "_error"
null にしてしまうと、「そのサーバーでは対象外だから取っていない」と「取ろうとして失敗した」が受信側で区別できません。前者は正常で、後者は直す対象です。同じ見た目にすると、直すべきものが永久に画面から消えます。
署名の計算は 1 箇所にしか置きません
送信側と受信側で HMAC の実装が別々にあると、片方だけ直したときに全 agent が認証に失敗します。しかも失敗の見え方は「全台が同時に欠報」なので、原因を探す順番として署名はかなり後ろに来ます。
なので関数を 1 つだけ用意して、両方がそれを呼びます。
// Compute は HMAC-SHA256(key, tsStr + "." + body) を 16 進数文字列で返す。
func Compute(key, tsStr string, body []byte) string {
    mac := hmac.New(sha256.New, []byte(key))
    mac.Write([]byte(tsStr + "."))
    mac.Write(body)
    return hex.EncodeToString(mac.Sum(nil))
}

// Verify は定数時間比較で判定する。
func Verify(key, tsStr string, body []byte, signature string) bool {
    expected := Compute(key, tsStr, body)
    return hmac.Equal([]byte(signature), []byte(expected))
}
タイムスタンプを署名対象に混ぜているのは、署名済みのリクエストをそのまま送り直す攻撃を弾くためです。受信側は X-Agent-Timestamp を見て、現在時刻から前後 120 秒を超えていたら中身を見ずに落とします。
比較に hmac.Equal を使っているのは、== だと先頭から一致した文字数で処理時間が変わるためです。実害が出るほど測れる状況かというと微妙ですが、標準ライブラリに定数時間比較が用意されているものを、わざわざ危ないほうで書く理由もありません。
このプロジェクトの設計ルールを書いた文書には「hmac.New の出現箇所が agentsig パッケージだけであること」という機械的な検査条件を書いています。ルールを文章で書いても守れないので、grep 1 回で確かめられる形に落としました。
受信側は「安いものから」落とします
署名の検証はボディ全体を舐めるので、それなりにコストがかかります。だから検証の順番を、安いものから並べました。

上の図は、その順番を上から並べたものです。7 番目でようやく署名の計算に入り、そこへ到達する前に 6 段階ぶんふるい落としています。順番はこうです。
- HTTP メソッドが POST か
-
X-Agent-Idがあり、パスとして安全な形か - 送信元 IP が allowlist に入っているか(設定していれば)
- ボディが上限(既定 1MB)を超えていないか
- タイムスタンプと署名のヘッダが揃っているか
- タイムスタンプが許容範囲(既定 120 秒)に入っているか
- 署名が一致するか
- JSON としてパースできるか
- ヘッダの agent_id と、本文が名乗る agent_id が一致するか
ボディ長の上限を先に見るのは、上限が無いと 1 通で monitor のメモリを埋められるからです。http.MaxBytesReader で読む前に切ります。
9 番目の「ヘッダと本文の agent_id の一致」は、あとから足しました。署名はヘッダの agent_id に紐づく鍵で検証するので、本文だけ別の agent を名乗らせると、正しい署名のまま他人のファイルへ追記できてしまいます。
もう 1 つ、応答の作り方で意識したことがあります。
key := h.cfg.AgentKeys[agentID]
// 未知の agent_id と署名不一致は同じ応答にする。どの agent_id が登録済みかを
// 応答の差から探れないようにするため。
if key == "" || !agentsig.Verify(key, tsStr, body, sig) {
    h.cfg.logf("heartpost: report rejected (signature) agent=%s", agentID)
    writeJSONError(w, http.StatusUnauthorized, "unauthorized")
    return
}
「そんな agent は登録されていない」と「鍵が違う」を区別して返すと、総当たりで登録済みの agent_id を列挙できます。ログには区別して書き、外へ返す応答は同じにしました。
X-Forwarded-For の扱いも同じ発想です。このヘッダは誰でも付けられるので、既定では一切見ません。設定で明示的に有効にして、かつ TCP の接続元がループバック(=同じホストのリバースプロキシ)のときだけ読みます。
署名は、リトライのたびに計算し直す必要があります
これは実装中に踏んだ落とし穴です。
agent は送信に失敗したらリトライします。最初はごく普通に、ボディと署名を 1 回作ってループの外に置いていました。
これだと、リトライで時間が経ったぶんだけ受信側の許容窓(120 秒)から外れて弾かれます。1 回目の失敗が「monitor が重くてタイムアウト」だった場合、2 回目は署名が古すぎて 401 になります。落ちている理由が途中ですり替わるので、ログを見ても分かりません。
for attempt := 0; attempt <= cfg.Monitor.RetryCount; attempt++ {
    // ...
    tsStr := strconv.FormatInt(time.Now().Unix(), 10)
    sig := agentsig.Compute(cfg.Monitor.APIKey, tsStr, body)
    // 以下、リクエスト組み立て
}
リトライ回数の既定は 1 回にしています。cron はどのみち 5 分後に来るので、落ちている monitor を共有ホストから叩き続ける意味がありません。
鍵ファイルが 600 でなければ、警告ではなく起動を止めます
共有ホスティングは、他人のアカウントと同じ OS の上に同居しています。ホームの下が同一ホストの別ユーザーから読める設定になっていることも珍しくありません。
API キーが読まれると、他人が自分の名前でレポートを投げられます。投げられると何が起きるかというと、本当は落ちているサーバーが「生きている」と表示され続けます。監視の文脈では、これがいちばん困る壊れ方です。
なので API キーは設定本体と別のファイルに分けて、モードが 600 以外なら起動そのものを止めます。
func checkSecretsPerm(path string, mode fs.FileMode, goos string) (string, error) {
    if goos == "windows" {
        return fmt.Sprintf("cannot verify permissions of %s on windows; ...", path), nil
    }
    if perm := mode.Perm(); perm&0o077 != 0 {
        return "", fmt.Errorf(
            "%s is readable by group or others (mode %04o); this file holds the API key on a shared host. run: chmod 600 %s",
            path, perm, path)
    }
    return "", nil
}
警告に落とさなかった理由は 1 つで、警告はログに流れて誰も見ないからです。自分で書いた警告を自分で読み飛ばした経験が何度もあります。読み飛ばせない場所は「起動しない」しかありませんでした。
Windows だけ素通りさせているのは、Go の fs.FileMode が Windows の実 ACL を表さないからです。ここで嘘の判定をするより、判定できないことを警告して通すほうが正直だと考えました。本番の対象 OS でもありません。
欠報の判定は、今の状態ではなく「前回どちらを通知したか」で決めます
死活監視でいちばん壊れやすいのは、判定そのものより通知の回数です。5 分ごとに判定して、そのたびに「落ちています」を送る監視は、3 時間後には全員がミュートしています。ミュートされた監視は、無いのと同じです。
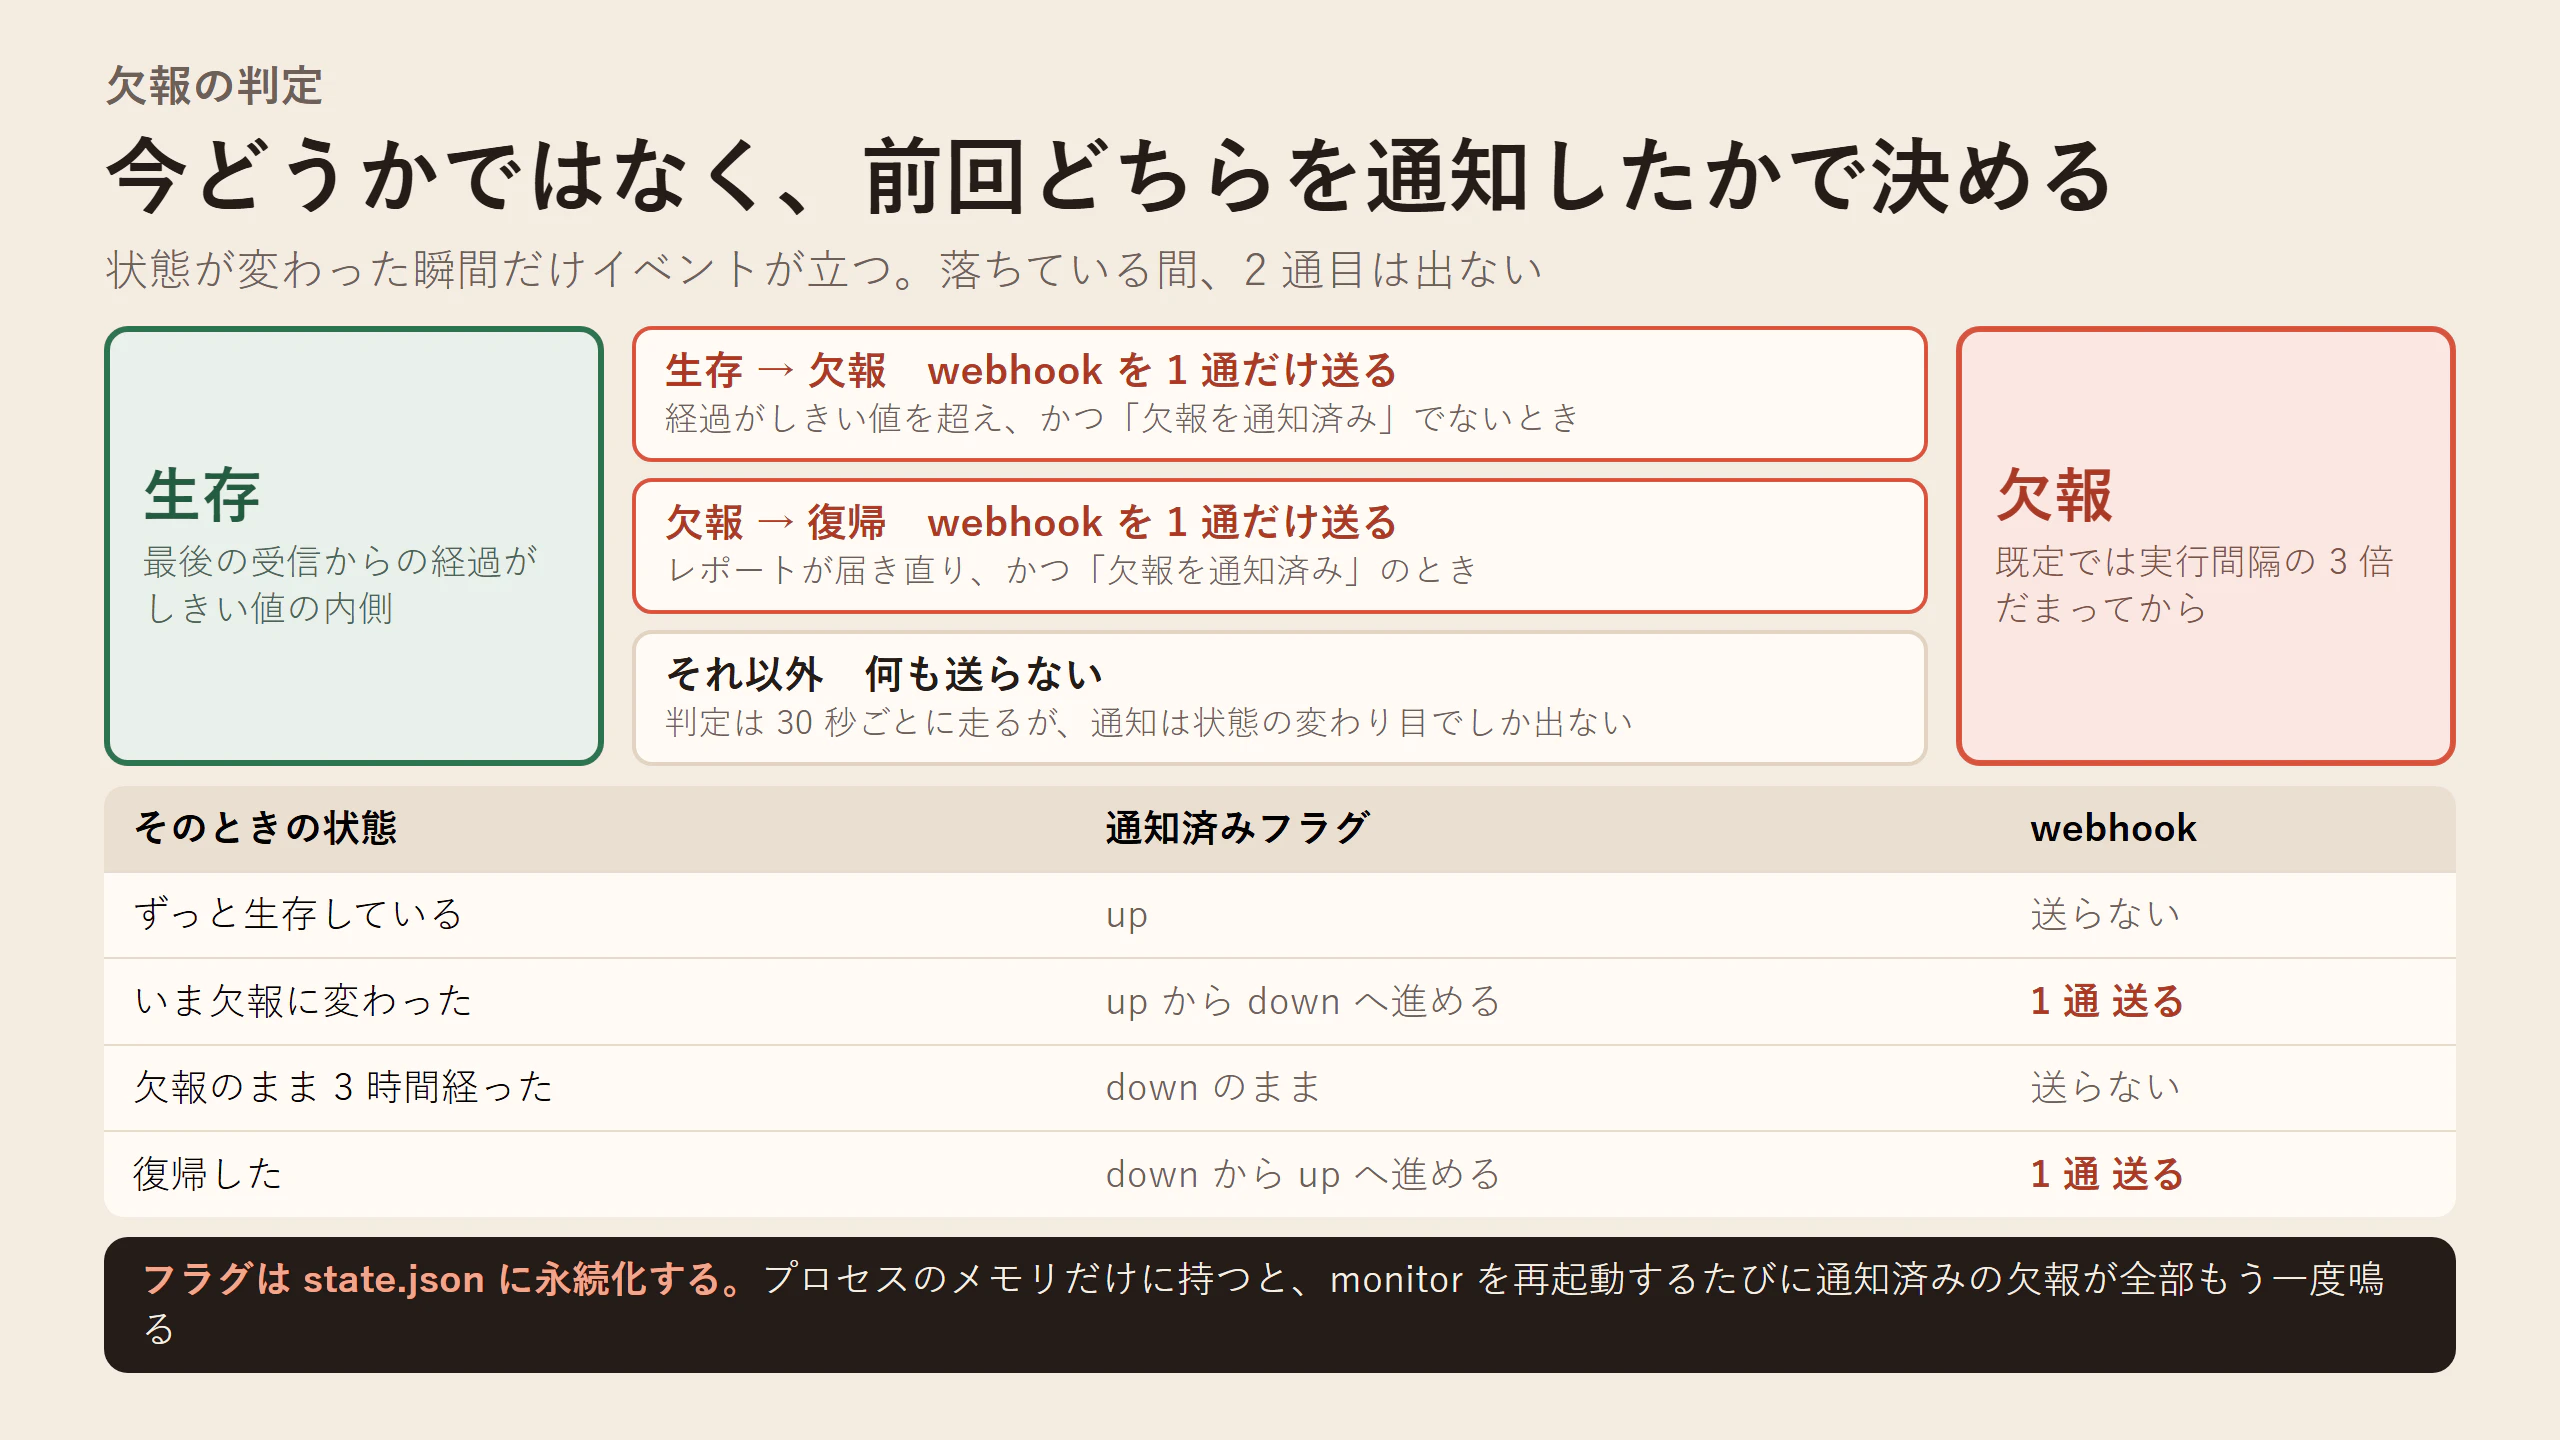
上の図の下半分の表がその判定です。「欠報のまま 3 時間経った」の行だけ webhook が出ていないのが、この設計の要点になります。状態としては落ちたままですが、前回すでに欠報を通知しているので、そこからは何も送りません。
なので、通知するかどうかを「今 down かどうか」では決めていません。「前回どちらを通知したか」で決めます。
switch {
case down && notified != NotifyDown:
ev = ¬ify.Event{Kind: notify.KindDown, ...}
case !down && notified == NotifyDown:
ev = ¬ify.Event{Kind: notify.KindRecovered, ...}
}
状態が変わった瞬間だけイベントが立ちます。落ちているあいだ判定は 30 秒ごとに走りますが、2 通目は出ません。復帰したら 1 通だけ出て、また静かになります。
この notified は state.json に永続化しています。monitor を再起動したときに、既に通知済みの欠報がもう一度飛ぶのを防ぐためです。プロセスのメモリにだけ持っていると、デプロイのたびに全部鳴ります。
もう 1 つ、しきい値の既定を実行間隔の 3 倍にしました。
// 3 倍にしているのは、1 回の取りこぼし(cron の遅延・一時的なネットワーク断)で
// 鳴らないようにするため。1 倍にすると誤報だらけになり、誰も見なくなる。
const DefaultIntervalMultiplier = 3
共有ホストは、バックアップの時間帯に重くなります。cron が数分ずれることも、1 回丸ごと飛ぶこともあります。1 回の取りこぼしで叩き起こされる監視は、2 週間で信用を失います。
通知に失敗した欠報を、送れたことにしない
ここは細かい話ですが、書いておきます。
webhook の POST が失敗することがあります。通知先が落ちている、ネットワークが詰まっている、トークンが切れている。
このとき、通知済みフラグを進めてしまうと その欠報は永久に誰にも届きません。状態はもう down になっているので、次の判定では「変化なし」と見なされます。
if err := c.notifier.Notify(ctx, *ev); err != nil {
    c.printf("heartpost: notify failed agent=%s kind=%s: %v", st.AgentID, ev.Kind, err)
    // 通知済みフラグは進めない。状態(down 表示)だけ更新する。
    if err := c.store.SetLiveness(st.AgentID, down, downSince, notified); err != nil {
        c.printf("heartpost: state update failed agent=%s: %v", st.AgentID, err)
    }
    continue
}
画面の表示(down)は更新して、通知済みフラグだけ据え置きます。次の判定でもう一度送りに行きます。
「送信の成功」と「状態の更新」を 1 つのフラグでまとめて持つと、この分岐が書けなくなります。似た値だからといって 1 個にまとめると、あとで必ず困る種類の値でした。
受信側にデータベースを置きませんでした
想定している規模は、数台から十数台です。1 台あたり 5 分に 1 通なので、10 台でも 1 日 2,880 通。テキストで足ります。
保存はこうしています。
<data_dir>/
├── reports/
│   ├── report_web-01_20260904.jsonl   1 行 1 レポートの追記ログ
│   └── report_web-02_20260904.jsonl
└── state.json                          agent ごとの最新状態と通知済みフラグ
JSONL は追記だけです。日付でファイルが変わるので、保持期間の判定はファイル名を見るだけで済みます。retention を過ぎたファイルは、受信のついでに削除します。
state.json の書き込みだけは、少し気を使いました。
// saveStateLocked は state.json を temp + rename で置き換える。
// 途中で落ちても壊れた state.json を残さないため。
tmp := s.statePath() + ".tmp"
if err := os.WriteFile(tmp, b, 0o600); err != nil { ... }
if err := os.Rename(tmp, s.statePath()); err != nil { ... }
上書きの途中で電源が落ちると、半端に書けた JSON が残ります。次の起動でパースに失敗して、monitor が上がらなくなります。監視が監視されないところで壊れるのは避けたかったので、一時ファイルに書いてから rename しました。同一ファイルシステム内の rename はアトミックです。
ファイルのモードは JSONL も state.json も 0600 にしています。レポートには収集したホストの情報が入っているので、monitor プロセス以外に見せる理由がありません。
SQLite すら使わなかったのは、「導入のハードルを 1 つも増やさない」を優先したからです。使う人がデータベースの面倒を見はじめた時点で、この道具は当初の目的から外れます。
agent_id は正規表現で絞ったうえで、パス連結の直前でもう一度見ます
保存先のファイル名に agent_id がそのまま入ります。ということは、agent_id はパス生成の入力です。
まず入口で形を絞ります。
// テナント形式のような意味づけは強制しない。ここで絞るのは「ファイル名として安全か」
// の 1 点だけ。`.` を許さないので `..` も `./` も通らない。
var agentIDPattern = regexp.MustCompile(`^[A-Za-z0-9][A-Za-z0-9-]{0,63}$`)
英数字とハイフンだけ、64 文字以内、先頭は英数字。ドットを許していないので .. は作れません。
そのうえで、連結の直前でもう一度見ます。
func safeJoin(base, name string) (string, error) {
    baseClean := filepath.Clean(base)
    joined := filepath.Clean(filepath.Join(baseClean, name))
    if joined != baseClean && !strings.HasPrefix(joined, baseClean+string(filepath.Separator)) {
        return "", fmt.Errorf("receiver: path escapes base directory: %q", name)
    }
    return joined, nil
}
入口の検証が 1 つ抜けただけで base の外へ書けてしまう作りにしたくなかった、というだけです。入口のバリデーションは、リファクタで消えます。消えても、ここで止まります。
agent_id にテナント名の接頭辞のような意味を持たせなかったのも意識的です。受信側が要求するのは「パスとして安全な識別子であること」だけで、命名の規約は使う人の自由にしました。
集めるのは 17 項目。全部読むだけです
共有ホスティング向けに 9 項目、Linux VPS 向けに 8 項目あります。
| 対象 | 項目 |
|---|---|
| 共有ホスティング(9) | ホスト情報 / 負荷平均 / メモリ / ディスク / cron / プロセス / CPU / ネットワーク / アクセスログ |
| Linux VPS(8) | システム / プロセス / cron / systemd サービス / 証明書の残日数 / SSH ログ / nginx ログ / 適用可能な更新 |
全部、設定で 1 つずつ切れます。しかも「書いていない項目は有効」にしているので、collector が増えたときに設定ファイルを触らなくて済みます。
[collectors.jobs]
# ここに書いていないものは有効のまま。新しい collector が追加されても
# このファイルを編集せずに動く。無効にしたいものだけ false を書く。
apache_log = false
collector のインターフェースには、収集する側の意図を型として書いています。
type Collector interface {
    Name() string
    Collect(cfg Config) (interface{}, error)
}
戻り値しかありません。サーバーへ書き込むメソッドが無いので、collector を足す人が「ついでに直す」を実装できない形になっています。設計ルールの表にも「collector は読むだけ。サーバーへ書き込む処理を持たせない」と 1 行だけ書いてあります。
外部コマンド(df / ps / hostname / uname など)を呼ぶ collector があるので、そこはタイムアウト付きのヘルパー経由に統一しました。共有ホストで df が返ってこないことは実際にあります。ハングした 1 コマンドで agent 全体が固まると、次の cron がロックで降ろされ続けて、静かに監視が止まります。
func RunWithTimeout(timeout time.Duration, name string, args ...string) ([]byte, error) {
    if timeout <= 0 {
        timeout = 10 * time.Second
    }
    ctx, cancel := context.WithTimeout(context.Background(), timeout)
    defer cancel()
    return exec.CommandContext(ctx, name, args...).Output()
}
CPU の collector には 1 秒のサンプリング待ちがあるのですが、これも全体タイムアウトで中断できるようにチャネルを渡しています。one-shot だからといって、途中で切れない待ちを作ると全体の予算が守れません。
実行間隔としきい値は、別のマシンの別のファイルにあります
これは実装の話ではなく、運用で必ず踏む落とし穴なので書いておきます。
-
agent 側: crontab の行(既定
*/5 * * * *) -
monitor 側:
liveness.agent_interval(既定5m)。しきい値はこの 3 倍
この 2 つは連動していません。片方だけ変えると、すぐ鳴りすぎるか、いつまでも鳴らないかのどちらかになります。

上の図は 5 分間隔のときの時間軸です。15 分の受信を最後に 3 回連続で届かず、30 分の判定でようやく欠報になります。そこから先はいくら黙っていても 2 通目は出ず、45 分に届き直したところで復帰が 1 通だけ出ます。
とくに危ないのは、間隔を延ばしたときに monitor 側を忘れるパターンです。cron を 30 分間隔に変えて monitor が 5 分のままだと、正常に動いているサーバーが 15 分ごとに落ちたことになります。数回鳴ったところで通知を切って、そのまま忘れます。
夜間バッチだけ監視したい、のように間隔が違う agent が混ざる場合のために、agent ごとの上書きも用意しました。
[agents.db-01]
label = "db-01 (nightly cron)"
down_threshold = "26h"
24 時間ではなく 26 時間にしているのは、日次バッチの開始が多少ずれても鳴らないようにするためです。しきい値は「想定される最大の間隔」より少し広く取るものだと思っています。
設定ファイルのキーを打ち間違えたら、起動を止めます
TOML のキーを 1 文字間違えても、たいていのパーサは黙って無視します。無視された設定は、既定値のまま動きます。
監視ツールでこれをやると、allowed_ips を allowed_ip と書いた人が「IP 制限をかけたつもりで全開放」の状態になります。しかも動いているので気づけません。
return nil, fmt.Errorf("config: unknown key(s) in %s: %s", path, strings.Join(keys, ", "))
知らないキーがあったら起動しません。同じ発想で、通知先の設定にもガードを入れています。
if cfg.NotifyWebhookURL == "" && !cfg.NotifyDisabled {
    return nil, errors.New("config: notify.webhook_url が未設定です。通知先を置かないなら notify.disabled = true を明示してください")
}
webhook_url を書き忘れただけの monitor は、受信も判定も画面表示も完璧にこなしたうえで、誰にも何も知らせません。動いているので、壊れていることに気づく手がかりがありません。
「通知しない」を選ぶこと自体は許しますが、明示的に書かせます。書いてあれば、起動ログにも警告が出ます。
この monitor 自身が落ちたら、誰も気づけません
正直に書いておくべき穴です。
heartpost は「レポートが来なくなったこと」を検知します。ですが、この monitor 自身が止まったことは検知できません。止まった monitor の見た目は、全台が健康で静かな世界とまったく同じです。
これは後から直せる穴ではありません。1 点にまとめて判定する死活監視は、構造としてこの穴を持ちます。中で二重化しても、二重化した両方が同じホストで死ねば同じことです。
なので隠さずに、README と紹介ページの両方に書きました。そのうえで、認証なしで応答する /healthz を用意しています。
mux.HandleFunc("/healthz", func(w http.ResponseWriter, r *http.Request) {
    w.Header().Set("Content-Type", "application/json; charset=utf-8")
    _, _ = w.Write([]byte(`{"status":"ok"}` + "\n"))
})
ここを外部の死活監視サービスか、別ホストの cron から見ておきます。無料の外形監視でも、別のサーバーの curl を仕込むだけでも構いません。この monitor ではない何かであることだけが条件です。
一覧画面のほうには Basic 認証を掛けています。/healthz は状態を返さず、生きていることだけを返すので認証の外に置きました。
ルールは README ではなく、破る人が必ず開く場所に置く
最後に、コードそのものではない話を 1 つ。
このリポジトリの CLAUDE.md(AI エージェント向けの指示書)には、設計ルールの本文を書いていません。書いてあるのは索引の表だけです。
| ルール | 正本(本文はここ) | 機械検査 |
|---|---|---|
| ワイヤ仕様は破壊的に変えない |
report/report.go の定数とコメント |
golden test |
| 署名の計算は 1 箇所にしか置かない | agentsig/agentsig.go |
hmac.New の出現箇所が agentsig だけであること |
| collector は読むだけ |
collector/collector.go のインターフェース定義 |
なし(レビュー時に見る) |
| 鍵ファイルは 600 でなければ起動しない | cmd/heartpost-agent/config.go |
なし(起動時にエラーで落ちる) |
ルールの本文は、それを破る人が必ず開くファイルの中に、コメントとして置いてあります。ワイヤ仕様の話は report.go の冒頭に、署名の話は agentsig.go の冒頭に。
理由は単純で、別のファイルに書いたルールは読まれないからです。report.go を編集しようとしている人は report.go を開いています。CLAUDE.md や CONTRIBUTING.md は開いていません。
そして可能なものには機械検査を付けます。golden test が落ちる、grep で数えられる、起動時にエラーで止まる。文章で書いた規約は、人間が守るぶんには 3 か月しか持ちませんでした。AI エージェントに書かせるなら、なおさら文章だけでは足りません。
あわせて読みたい
- 自前サーバーを立てる直前で、何やってるんだ俺、と気づいた(そもそも自分でサーバーを持つかどうかを迷っていた頃の話です。結局この monitor を置く先になりました)
- 本番サーバーには、触らせない。SSHで脆弱性を診断させて、直すのは人間にした話(本番のサーバーに対して読むだけに徹する、という今回の collector の方針は、このときの結論を引き継いでいます)
heartpost はこんなときに刺さります
- 値の異常ではなく「そもそも報告が来なくなったこと」に気づきたい人
- root 権限もパッケージ導入も無いレンタルサーバーを持っていて、監視を諦めていた人
- 鳴りっぱなしの監視に疲れて、結局通知を切ってしまった経験がある人
- 監視のデータを外部サービスに預けたくない、けれど時系列データベースの面倒は見たくない人
いずれかに心当たりがあれば、Releases の zip を展開して monitor を 1 台建てるところから試せます。設定ファイルは受信側 1 つと、監視するサーバーごとに 2 つ(本体と鍵)です。データベースの用意は要りません。
- 紹介ページ(スクリーンショットと機能一覧): https://ishizakahiroshi.com/work.html?id=heartpost
- リポジトリ(Issue / PR 歓迎): https://github.com/ishizakahiroshi/heartpost
- リリース(linux/amd64・linux/arm64・freebsd/amd64): https://github.com/ishizakahiroshi/heartpost/releases/tag/v0.1.0
Star をいただけると開発の励みになります。使ってみて「ここが不便」があれば、Issue でも X の DM でも大歓迎です。
おわりに
作ってみて意外だったのは、削るほうが難しかったことです。
グラフを出したくなります。閾値のアラートを足したくなります。通知先を Slack と Discord とメールに分けたくなります。どれも 1 日あれば書けるので、書きたくなる。
でも、そのたびに「これは、まだ報告してきているかを答えるのに要るか」と聞き直しました。ほとんど要りませんでした。要らないものを足さなかったぶん、設定ファイルが短くなって、起動が速くなって、壊れる場所が減りました。
v0.1.0 はまだ、自分の環境で動きはじめたところです。systemd のユニットは実機で確認できていませんし、メール通知は見送りました。必要になった時点で判断します。
しばらくは、通知が来ない日が続くことを確認する日々になります。何も起きないことを確認するために道具を書いた、というのは少し変な話ですが、たぶんこれで合っています。
※ ヘッダー画像とインフォグラフィックは AI(画像生成)で作成しています。
書いた人: ishizakahiroshi
群馬の北部で、保護猫2匹と暮らす、在宅エンジニア(何でも屋)
https://ishizakahiroshi.com/
https://github.com/ishizakahiroshi
X(業務委託・各種相談はこちら):
https://x.com/ishizakahiroshi
バックエンド・インフラ・AI連携まわりで、業務委託のご相談を受け付けています。フルリモートです。スポットや週2〜3時間からでも歓迎で、いろんな案件に携われたらうれしいです。こんな相談、歓迎です。