

この記事は2024年12月5日に執筆されたものです。
こんにちは、InflabのDevOpsエンジニアのPokaです。
私にとって初めての会社であるInflabに入社して、早くも3か月が過ぎようとしています。
今回は、AI/MLの専門職がいない私たちのようなスタートアップが、機械学習/AIを活用した自動スパムフィルタリングシステムを導入し、改善してきた過程を紹介します。
Inflearnのスパムフィルタリングの始まり
スパム問題の浮上
Inflearnの成長とともに、さまざまなスパム性のあるコンテンツが投稿されるようになりました。当初は運営チームが手作業でこうした投稿を一つひとつ確認し、スパムとして処理していました。
しかしプラットフォームが拡大するにつれ、すべての投稿を手作業で管理することは次第に非効率で、多くの時間を要する作業になっていきました。
初期対応:GPTと禁止ワードリストの活用
最初の試み
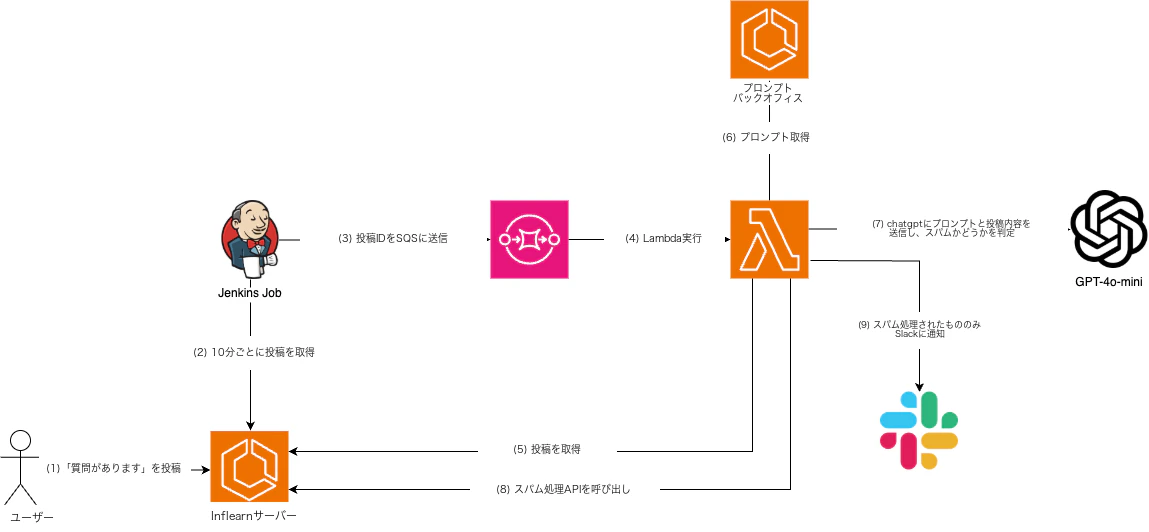
DevOpsチームのJakeさんとJaceさんが、GPT-4o mini モデルと禁止ワードリストを使ってスパムかどうかを判定するシステムを構築しました。
この構成を選んだのは、スパムフィルタリングがまだ初期段階で、コスト効率の良いアプローチが必要だったからです。
スパムのパターンを見つけ出す仕組みで、新しいパターンが見つかるたびにプロンプト管理用のバックオフィスへ例示データを追加するFew-Shot方式でフィルタリングを改善していきました。
限界
この方法は特定のパターンをブロックするには有効でしたが、新しいスパムの種類が見つかるたびに手動でパターンを追加しなければならないという制約がありました。
また、特定の掲示板によく投稿されるスパムパターンを基準に例示データや禁止ワードを追加していたため、すべての掲示板に一貫して適用するのは困難でした。
さらに、スパムフィルタリングの初期段階で安価なモデルを使っていたため、性能の低いAIではスパム投稿を効果的にブロックできないという限界もありました。
機械学習の導入:適応型スパムフィルター
機械学習による自動化
次のステップとして、新しい種類のスパムを学習して処理できる適応型スパムフィルターを構築しました。
スパムをより確実に抽出するため、TfidfVectorizer でデータをベクトルに変換しました。スパム投稿で意味なく使われている単語の重みを下げ、重要な単語だけを取り出すためです。
ベクトル化するのは、テキストデータをベクトルに変換すると各単語を数値にマッピングでき、テキストの特徴を数値で表せるからです。
簡単に言えば、膨大なテキストを地図上に配置して、重要な位置だけがはっきり見えるようにする作業に似ています。
新しい投稿のベクトルがスパム投稿のベクトルに近いほど両者は似ており、スパムである可能性が高いと考えられます。
こうした前処理によって、機械学習モデルがデータを効果的に処理・分析できる土台を整えました。
モデル選定の背景
- データセットの制約: 当時利用できるデータセットの量が多くなかったため、少ないデータでも学習できる必要がありました。
- 計算速度: スパム投稿は作成後できるだけ早く見つけ出さないと、一般ユーザーへの被害を最小限に抑えられません。そのため高速な計算が求められました。
- 継続学習のしやすさ: 新しい種類のスパムが追加されても、継続的に学習できる必要がありました。
- モデルサイズの制約: モデルのサイズが大きくならないようにする必要がありました。
上記の条件に適したモデルとして、SGDClassifierを選びました。
このモデルは必要な計算量が多くないため、GPUなしでCPUだけでも高速に推論できました。
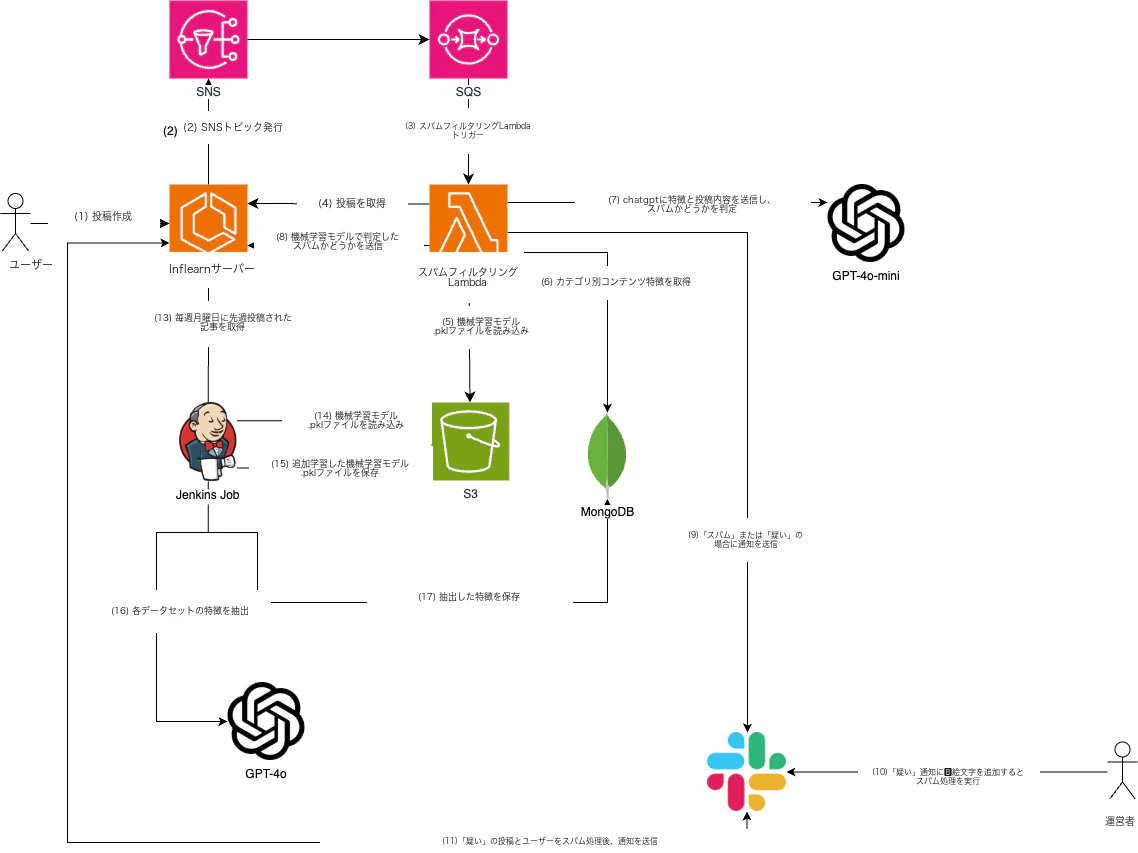
投稿作成のイベントは特定の時間帯に集中する傾向があるため、サーバーを常時稼働させる代わりに、サーバーレス関数上でイベント駆動で動作するように設計しました。
最初のモデル学習はローカル環境で約2〜3時間かけて行いました。
実際のデプロイ環境では、サーバーレス関数であるAWS Lambdaで動作するように、TfidfVectorizer と SGDClassifierを含むscikit-learnライブラリをLambda Layerとして追加しました。
おかげで、Pythonコードに修正があるときはコードだけを素早くデプロイできました。
Python + Lambda Layerの組み合わせにより、コールドスタートは約2.8秒で済みました。また、一度起動すればピーク時間帯にはほとんどコールドスタートなしで実行されることを確認しました。
その結果、1,024 MBのメモリを割り当てたLambda関数で、モデルの推論にかかる時間はわずか0.2〜0.6ミリ秒です。
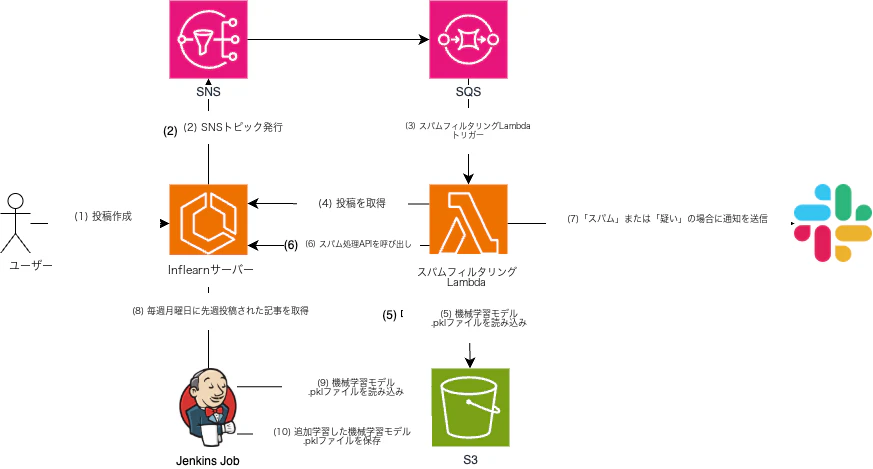
学習済みのベクトルとモデルファイルはS3に保存して利用しています。さらにJenkinsのcronジョブで新しい投稿を定期的にモデルへ追加学習させ、新しい種類のスパムにも自動で適応できるようにしました。
スパムフィルタリングのプロセス
- 投稿が作成されるたびにSNS Topicを発行。
- そのTopicがSQSに届く。
- SQSがスパムフィルタリングLambdaを呼び出す。
- 機械学習モデルがスパムかどうかを判定。
判定プロセス
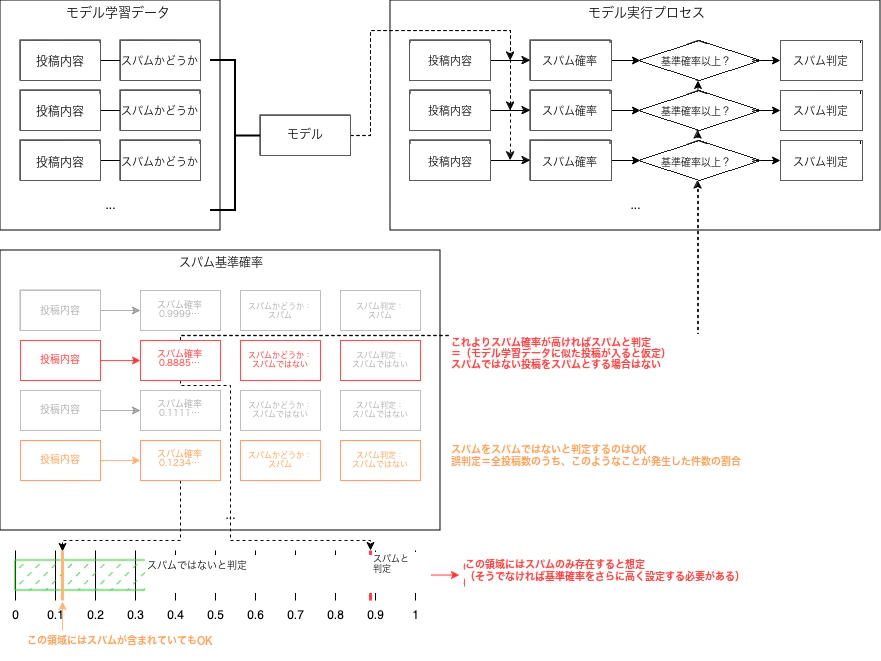
機械学習の導入にあわせて、スパム検出のプロセスに「スパム」「疑い」「正常」という3つの段階を追加しました。
各段階には固有のしきい値を設定してコンテンツを評価します。投稿が「スパム」段階のしきい値を超えた場合は、スパムとして確定します。
リアルタイムモニタリング
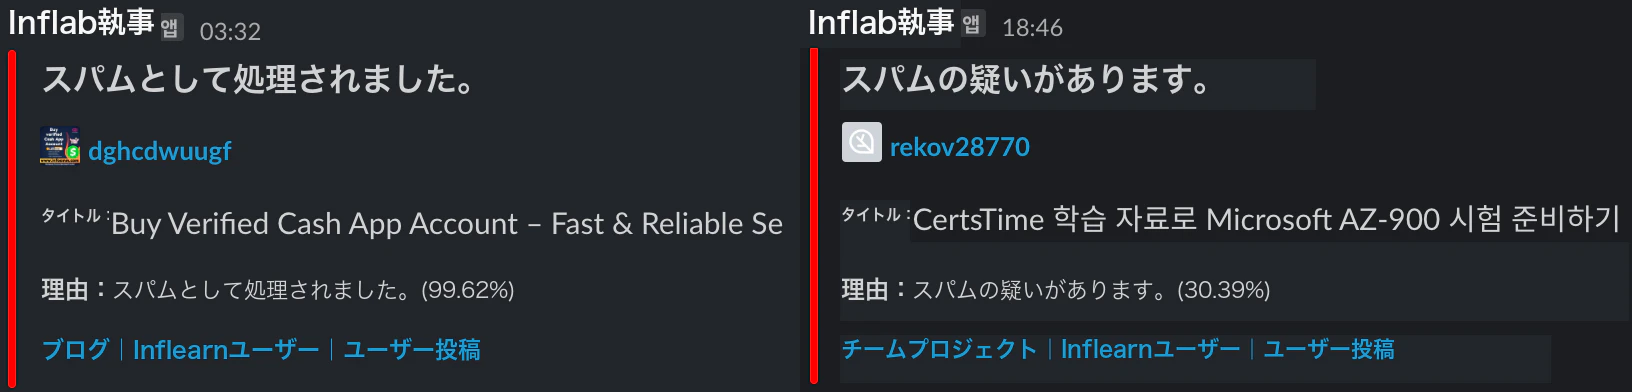
「スパム」または「疑い」の段階に分類された場合は、運営チームがリアルタイムで状況をモニタリングできるよう、Slackに通知が送られるように構成しました。
多言語スパムへの対応:ChatGPTの力を借りる

さまざまな言語への対応
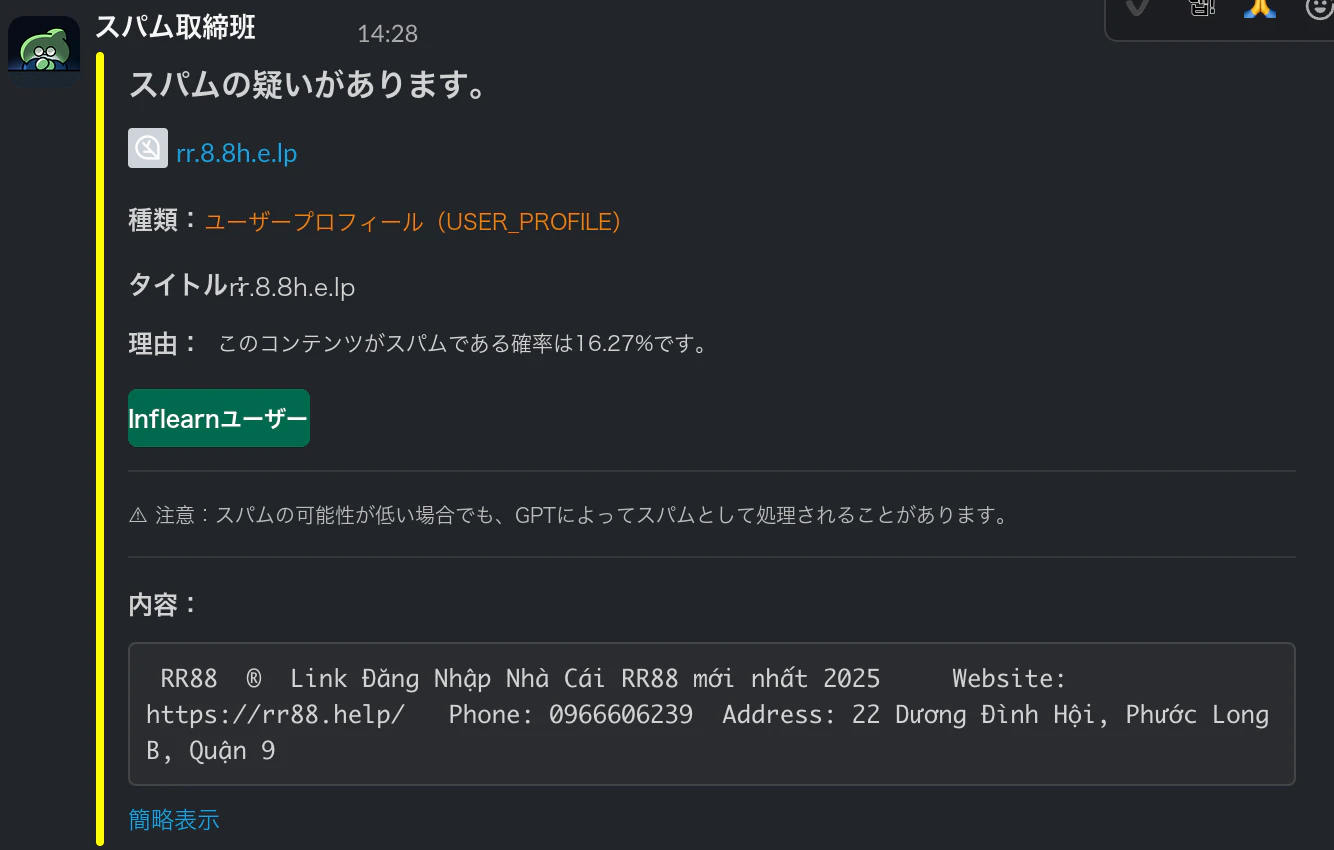
機械学習モデルは韓国語と英語では優れた性能を示しましたが、タイ語、モンゴル語、中国語、日本語など、さまざまな言語で書かれたスパム投稿には苦戦しました。
新しいアプローチ
機械学習とChatGPTを組み合わせて、多言語のスパムに対応できる仕組みを用意しました。
また、スパムを効果的に判定するため、GPTには次のようなプロンプトを与えました。
- 役割
- コンテンツ審査の専門家
- 行うこと
- 入力されたコンテンツをスパムまたは正常に分類
- スパムと見なす場合
- 広告、宣伝、欺瞞的な内容を含む
- 単純な誤字や一般的な話題はスパムと見なさない
- 正常なデータと見なす場合
- 通常の会話
- 不明確な会話
- 出力形式
-
{
  "is_spam": 0 or 1,
  "reason": "スパムと判断した理由を50文字以内で韓国語で記述"
}
-
このプロンプトでGPTがやるべきことを明確に指示し、スパム判定の確実性を高めました。あわせて出力形式を固定し、トークン量を減らしました。
「疑い」タイプのスパム処理プロセスの簡素化
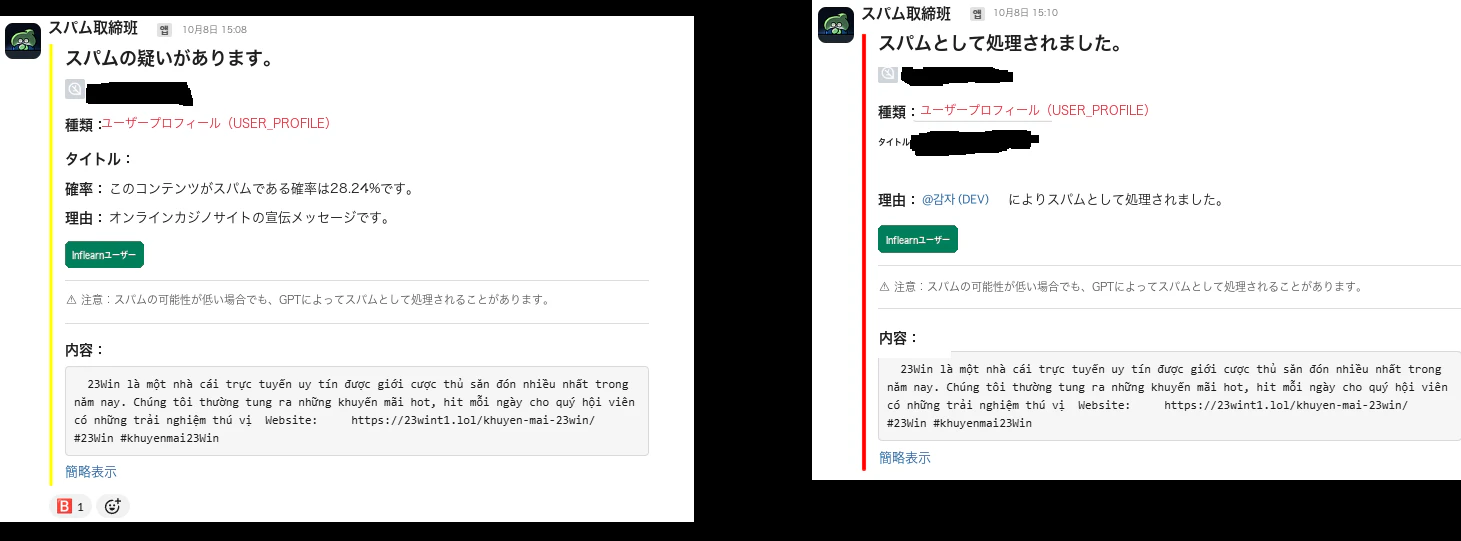
投稿が「疑い」段階に分類されると、運営チームは自分で内容を確認してからadminページで投稿とユーザーをブロックし、確認済みの印として🅱️絵文字を付けていました。
この作業を簡素化するため、スパム疑いの通知に🅱️絵文字が付くと、その投稿とユーザーが自動でブロックされるようにしました。
スパムの傾向の変化に応じた新たな対応策
新しい種類のスパム
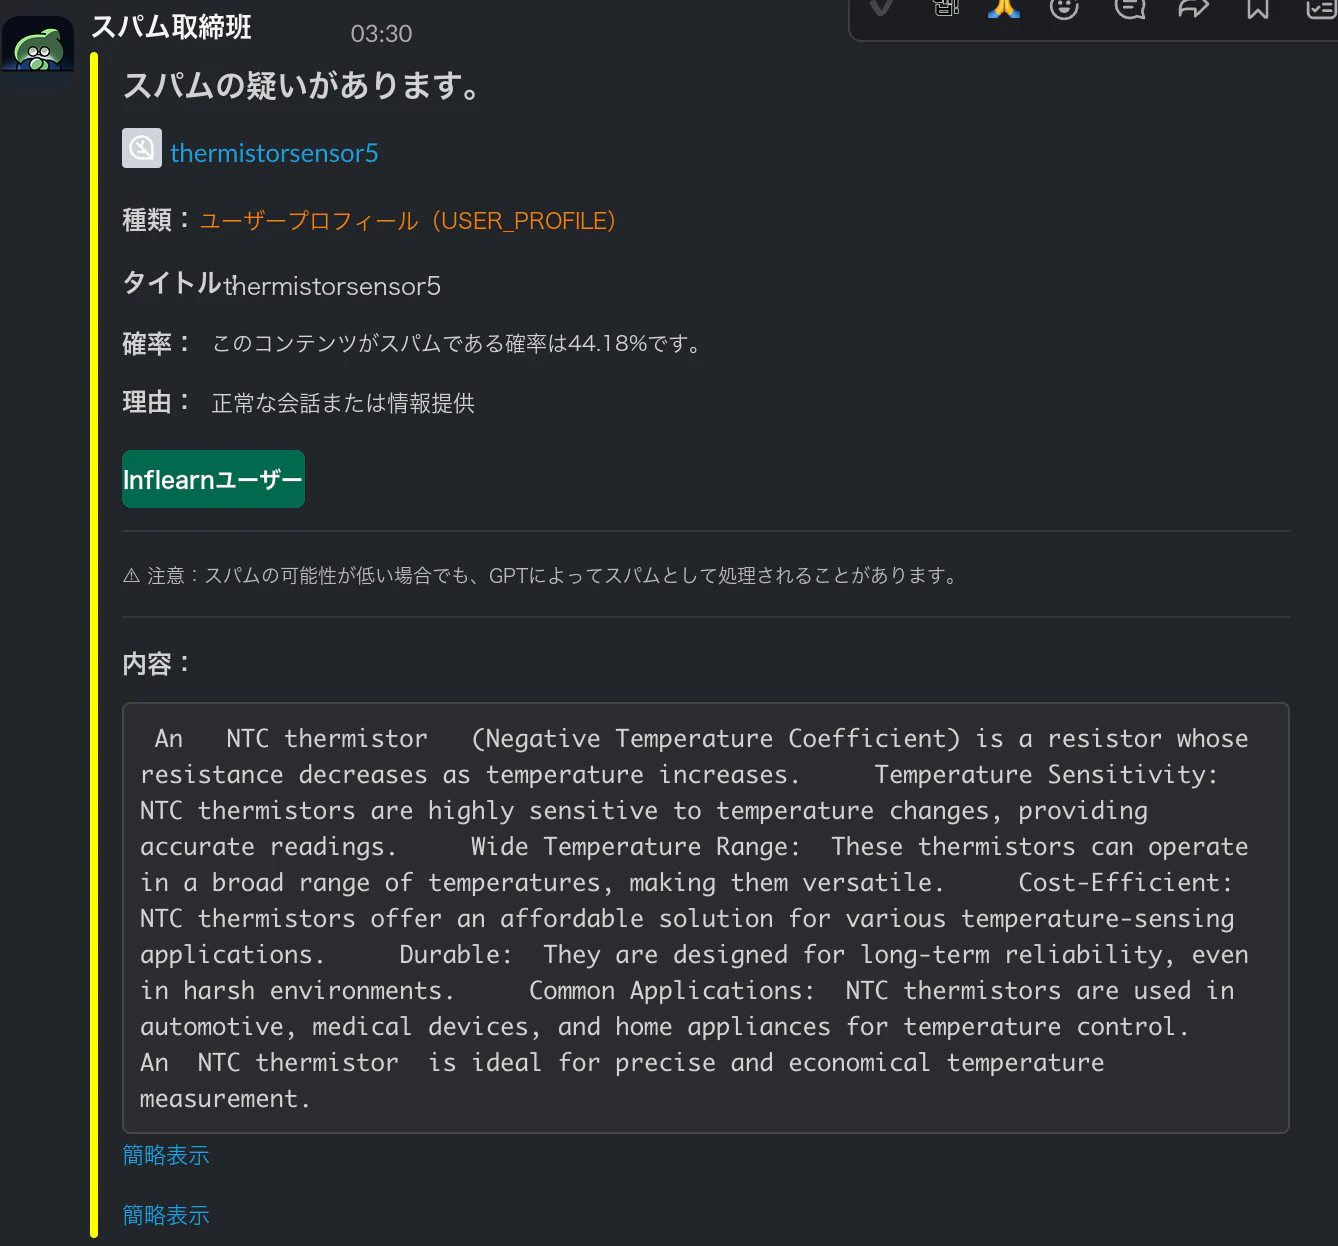
スパムコンテンツのブロックが改善されるにつれ、一般的な投稿を装って無関係なリンクを埋め込んだものや、体験談を装った宣伝投稿など、さまざまな種類のスパムが現れ始めました。
これを効果的にブロックするため、Karrotのテックミートアップで公開された Zero Shot With Auto Generate Prompt の手法を適用することにしました。
データの特徴を抽出するプロンプト
カテゴリーごとに、既存のスパムデータと正常データそれぞれの特徴をより詳しく抽出するため、GPT-4oモデルで分析し、その結果をMongoDBに保存しました。
週に1回、Jenkinsジョブで既存の特徴と先週のスパム・正常データの特徴を比較し、新しい特徴があれば追加するように設計しました。
また、特徴の抽出ではさまざまな条件のエッジケースを考慮しました。たとえば、宣伝目的の投稿は自動でスパムとして処理すべきですが、学習者がプロジェクトの成果物を共有するような一般的なコミュニティ活動はスパムとして処理してはいけません。こうした条件を明示し、過度な一般化を避けてfalse positiveを減らせるようにしました。
スパム判定プロンプト
こうしてMongoDBに保存した特徴を取得し、GPT-4o mini のプロンプトに含めました。そのうえで、各カテゴリーとの関連性や、学習者によるプロジェクト成果物の共有のような一般的なコミュニティ活動かどうかなどを段階的に判定させ、精度を高めました。
成果
自動スパム処理システムを導入したことで、これまで抱えていた多くの問題が解消されました。
スパム処理件数
毎日手作業で行っていたスパム対応のほとんどが今では自動化され、手作業で対応するのはごく一部の案件だけになりました。
これによって、CXチームからも強い支持を得られるようになりました。
スパムアカウントの登録数
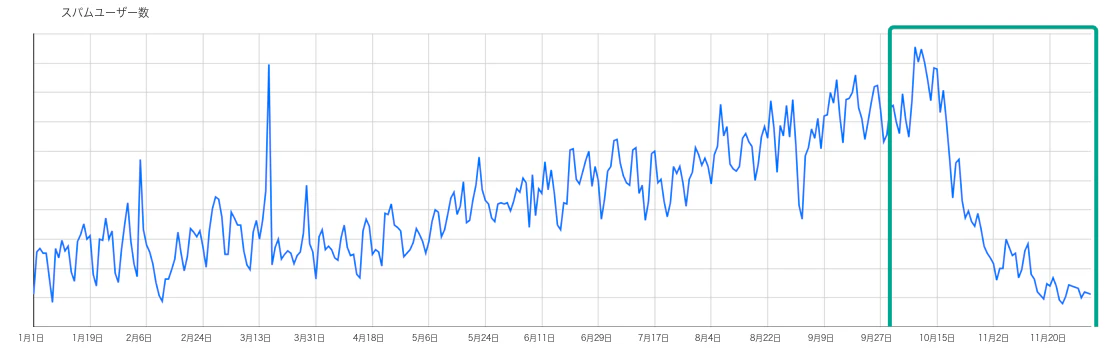
スパムアカウントが自動で処理されるようになり、もはやスパム投稿をしても無意味だと判断したのか、スパムアカウントの作成リクエストは次第に減っていきました。
現在では、1日に作成されるスパムアカウント数がシステム導入前と比べて76%減少しています。
コスト
このように大量のリソースを使うソリューションは、かなりのコストがかかるだろうと考える方が多いと思います。
しかし、私たちが構築したAWS Lambda、SNS、SQS、S3、そしてChatGPT APIの費用をすべて合わせても、投稿1件がスパムかどうかを判定するのにわずか0.05ウォンしかかからないことが確認できました。
おわりに
本記事では、Inflearnが直面したスパム投稿の問題を解決するために作った自動スパムフィルタリングシステムが、どのように発展してきたかを紹介しました。
最初は禁止ワードが含まれているかを確認するだけのシンプルな構成でした。そこからChatGPTでスパムパターンを検知するようにし、さらに機械学習モデルとChatGPTを組み合わせて、さまざまな種類のスパムをフィルタリングできるよう改善しました。
こうした改善によって、次々に現れる新しい種類のスパムを自動でブロックできるようになりました。その結果、サービス運営チームの手間が減っただけでなく、低品質なリンクへ誘導するスパム投稿を削除してSEO指標を改善するといった効果も得られました。
今後はプロンプト管理用のバックオフィスを高度化し、サービス運営チームでもスパム投稿の特徴を簡単に確認・修正できるようにシステムを改善していく予定です。
以上、Inflearnのスパムフィルタリングの歩みを紹介しました。
最後まで読んでいただき、ありがとうございました。