

この記事は2023年10月31日に執筆されたものです。
こんにちは。InflabのDevOpsエンジニア、SunBです。
2023年9月、Inflearnに字幕とスクリプトの機能が追加されました。皆さん、活用されていますか?
今回追加された字幕機能は、動画の音声データをもとに自動で字幕を生成する部分と、
こうして生成された字幕を受講画面に表示する部分の、大きく2つに分けられます。
今日は、このうち私が実装を担当した字幕生成の部分について、どのような技術をベースに、どのような過程を経て実装したのかをお話ししたいと思います。
2日で字幕機能を作ってデモする
まず、「DevOpsエンジニアが字幕機能を実装したの?」と思われる方もいらっしゃると思うので、今回の字幕機能の実装プロジェクトがどのように始まったのかをご紹介します。
Inflabでは今年から、Infthonという名前で社内ハッカソンを開催しています。応募者をランダムに4人チームに振り分け、約2日間でアイデアの議論とMVPの実装を行ったあとに発表する、という形式でハッカソンが行われました。
ところが偶然(?)、Inflearnの講座プレイヤーやVODインフラを多く手がけていたFE開発者のPapicoと私が同じチームになり、自然と講座の再生に関するアイデアを議論することになりました。そして第1回Infthonのテーマだった「チームの生産性向上、またはAIを活用したサービス改善」に最も合っていると考えた講座のAI字幕機能を、アイデアとして選ぶことになりました。
まず、AIベースの字幕生成機能を実装するための最低限の条件として考えたのは、次のとおりです。
- 字幕生成がオフラインで動作すること(データの外部送信を防ぐ)
- 字幕生成にコンピューティングリソース以外の追加費用がかからないこと(オープンソースモデルを自前で実行)
- 字幕生成にかかる時間が動画の長さを超えないこと(ライブデモができるくらい速いこと)
これらの条件を満たす技術を探してみたところ、OpenAIのWhisperというモデルが目に留まりました。
Whisper以外に検討対象だった技術は、以下のとおりです。
- KoSpeech: Archived
- OpenSpeech + KsponSpeech: 自分たちで学習させてモデルを作るには、技術への理解度もまだ低く、時間もかなりかかると予想された
- KakaoのPORORO: Archived
- MetaのSeamlessM4T: テスト用の講座を使ったPoCの過程で、SeamlessM4T largeモデルはWhisper large-v2モデルに比べて精度が劣ることを確認
- NaverのCLOVA SpeechなどのAPIベースのサービス: データの外部送信とAPI料金が発生
Infthon以前にも、MacWhisperなどのツールを通じて、OpenAIのWhisperというSTTモデルの存在とその高い精度については知っていましたが、深く調べたことはありませんでした。
実装期間が2日と短かったため、具体的な理解よりも、素早い適用とデモができるかどうかを中心に作業を進めました。
その結果、すべての処理が私のMac上でオフラインで動作するように構成しました。その過程で、Pythonで実装されたOpenAIのWhisperは遅すぎたため、代わりにwhisper.cppというC++に移植されたバージョンを使いました。
こうして、
- 動画をアップロードすると
- ffmpegを使って16-bit WAVの音声データを抽出し
- whisper.cpp + large-v2モデルを使って字幕を書き起こし、それをsrtファイルとして保存し
- 受講画面でこのsrtファイルを再生するところまで
を短期間で実装できました。
さらに、FE開発者のPapicoの活躍により、スクリプトの表示と再生位置の移動機能、字幕の修正依頼機能と修正依頼の管理機能までデモし、第1回Infthonで1位という栄誉を手にすることができました。
こうして楽しい経験として幕を閉じたと思っていたのですが……
正式プロジェクトとして採用
ある意味当然のことながら、字幕機能はすぐに正式プロジェクトとして採用され、新たなスタートを切ることになります。
Infthonですでにデモまで終えていたので大きな心配はありませんでしたが、引っかかる点が3つありました。
- Shaka Playerでm3u8のHLSプレイリストとsrt字幕ファイルを同時に表示すると、字幕の同期がずれる問題
- AWSのインフラでWhisperをまだ動かしたことがなかった点
- 韓国語字幕の1行あたりの長さと改行位置が適切でなく、読みにくい問題
1つ目は、FE開発者のPapicoが字幕表示部分をShaka Playerの機能を使わずにReactで新たに実装する方法で、きれいに解決してくれました!
2つ目と3つ目は、そのまま現実の問題として降りかかってくることになります。
インフラ上でWhisperを動かす
最初に解決しなければならなかったのは、Infthonのときとは違って今回は実際のユーザーに向けてサービスを提供する必要があるため、私たちのインフラ上で機能が動作するようにしなければならないという点でした。
エンコーディングインフラの改善記録
字幕生成インフラについてお話しする前に、まず動画エンコーディングインフラを改善した過程をご紹介します。
私たちは2022年10月まで、動画のエンコーディングにAWS MediaConvertを使っていましたが、コスト削減とエンコーディングオプションのカスタマイズのために、EC2 c6i.xlarge Spot InstanceベースのAWS Batch構成に移行しました。
MediaConvertのReserved Queueなど、さまざまな代替案や試みもありましたが、予約したエンコーディングの開始が遅すぎたり、4Kなど一部のオプションが使えないといった制約があったりして、要件を満たすのは難しいと判断し、自分たちで構成する方向を選びました。
結果として、インフラ構成の変更は効果がありました。長さ28分の1080p動画を540p、720p、1080pにエンコードする場合、AWS Batchを使ったときとMediaConvertを使ったときにかかる時間と費用は、以下のとおりでした。
| AWS Batch (ECS EC2 c6i.xlarge Spot) | MediaConvert (On-Demand Pro) | 差 | |
|---|---|---|---|
| 時間 | 約10分 | 約7分 | 約3分 (x0.7) |
| 費用 | 約$0.021 | 約$1.895 (SD x 1, HD x 2) | 約$1.874 (x90.2) |
動画の長さに対するエンコーディング時間には大きな差はありませんが、費用はなんと90倍以上の差があることを確認しました。
AWS Batch構成の中でのEC2インスタンスタイプごとの費用と性能の分析結果は、以下のとおりでした。(長さ28分の1080p動画を540p、720p、1080pにエンコードする場合、Spot Instance未適用)
| インスタンスタイプ | オンデマンドの1時間あたりの費用 (A) | エンコーディングの実行時間 (B) | 実際の費用 (A x B) |
|---|---|---|---|
| c6i.xlarge | $0.192 | 10分 | $0.032 |
| c6g.xlarge | $0.154 | 12分47秒 | $0.033 |
| c6i.2xlarge | $0.384 | 5分57秒 | $0.038 |
| c6i.4xlarge | $0.768 | 4分23秒 | $0.056 |
| g5g.xlarge | $0.5166 | 5分1秒 | $0.043 |
| g5.xlarge | $1.237 | 3分15秒 | $0.067 |
エンコーディングインフラと同じ構成でwhisper.cppを試す
上記の改善したエンコーディングインフラをもとに、字幕インフラも同じ構造で構成しようと試みました。
AWS Batchベースで、c6i.xlargeインスタンス上で28分の動画に対してwhisper.cppを実行してみたところ、結果はなんと69分3秒と、予想よりもはるかに遅いものでした。
Infthonのデモ用に、Mac Studio(M1 Ultra)で同じ動画をwhisper.cppで実行したときにかかった時間は3分30秒でした。
これを確認して、すぐにGPUインスタンスのPoCに取りかかりました。
GPUインスタンスのPoC
最初は、g5インスタンスより安いARMベースのg5g.xlargeインスタンスを使ってみようとしました。
ところが、NVIDIAドライバーやCUDAのバージョンをいくら変えて試しても、PyTorchでCUDAが認識されない問題がありました。
CUDA 11のPython cuDNNライブラリはARMアーキテクチャをサポートしておらず、PyTorchの正式版はCUDA 12をサポートしていなかったため、PyTorch Nightly + CUDA 12 cuDNNの構成を試しましたが、torch.cuda.is_available() が False を返す状態が続きました。
そんな中、AWS BatchではまだARMアーキテクチャベースのGPUインスタンスをサポートしていないというドキュメントを見つけ、g5gインスタンスの利用はひとまず諦めました。
その後、g5.xlargeインスタンスでOpenAIのPythonベースのWhisperを実行してみたところ、7分17秒かかりました。
動画の長さに比べれば許容できる時間でしたが、Mac Studioでwhisper.cppを使ったときに3分30秒だったことを考えると、ほかに方法がないかと考えるようになりました。
そしてSeamlessM4Tについて検索していたところ、偶然Hacker NewsでWhisperXに言及しているコメントを見かけました。
WhisperXへの移行
WhisperXを使って、g5.xlargeインスタンスで28分の動画の字幕生成を試してみたところ、59秒で完了し、最も速い結果となりました。その出力結果も、Whisperやwhisper.cppと比べて精度が劣るということはなく、それぞれに長所と短所がある様子でした。
以下は、出力結果を比較した当時に書いたメモの一部です。
Whisper、WhisperXはg5.xlargeで、whisper.cppはMac Studioで抽出したバージョン
3つともかなり違いがあるが、どれか1つが最も優れているというわけではなく、それぞれにうまく書き起こせている部分がある。
WhisperXが正確に抽出した部分
- 뽑았는데 (Whisper: 꼽았는데)
- 등허리 (Whisper: 등어리)
- 복부 (Whisper: 복구)
whisper.cppが正確に抽出した部分
- Eye Reflect (WhisperX: I Reflect)
Whisperが正確に抽出した部分
- Z-Remesh (WhisperX: gremesher)
- 아이리플렉트 (WhisperX: I Reflect)
WhisperXはほかの2つよりはるかに速く実行でき、音節単位でalignするので行の再構成に有利であり、字幕の修正依頼機能の有効性も比較的高くなると推定されることを考えると、WhisperXを使うのが最も良いと思われる。
ただし、ときどき複数の文を早口で話す部分で抜け落ちる文があるが、精度が低いと判断して意図的に除外しているように見える。
まとめ
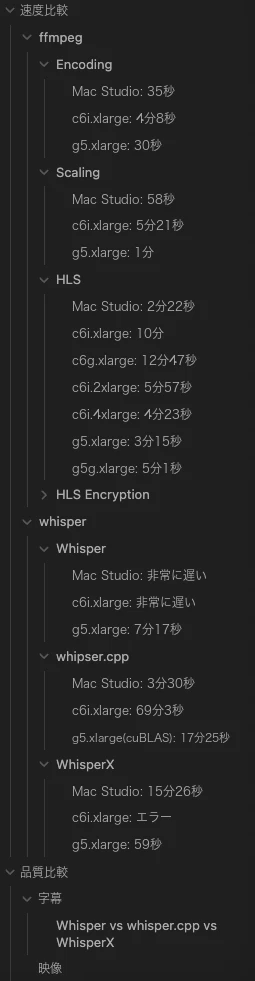
最初に試したwhisper.cpp + c6i.xlargeを基準に、試した組み合わせとの差をまとめると次のとおりです。(large-v2モデルを使って28分の音声データを書き起こした場合)
| ツール | マシン | 実行時間 | 差(速度) |
|---|---|---|---|
| whisper.cpp | c6i.xlarge | 69分3秒 | - (x1) |
| Whisper | c6i.xlarge | 時間がかかりすぎて計測を中断 | - |
| WhisperX | c6i.xlarge | 実行中にエラーが発生 | - |
| whisper.cpp | Mac Studio | 3分30秒 | 65分33秒 (x19.7) |
| Whisper | Mac Studio | 時間がかかりすぎて計測を中断 | - |
| WhisperX | Mac Studio | 15分26秒 | 53分37秒 (x4.5) |
| whisper.cpp(cuBLASビルド) | g5.xlarge | 17分25秒 | 51分38秒 (x4) |
| Whisper | g5.xlarge | 7分17秒 | 61分46秒 (x9.5) |
| WhisperX | g5.xlarge | 59秒 | 68分4秒 (x70.2) |
最終的に、WhisperX + g5.xlargeの組み合わせを選びました。
こうして最初の絶望を乗り越え、速度を70倍以上改善し、インフラ上で字幕生成機能が正常に動作するようにしました。
その過程でGPUインスタンスや動画エンコーディングに関する分析も行い、エンコーディング関連のプロセスも改善されました。
(試行錯誤の跡)
字幕の長さと読みやすさの改善
字幕をどう生成するかという課題は、音声データからテキストを抽出するだけでは終わりませんでした。
whisper.cpp、Whisper、WhisperXのいずれにも、--max_line_width のような1行の長さを制限するオプションがあったのですが、問題はこのオプションが動作しないことでした。(……)
韓国語だから動作しないのだろうと推測しています。
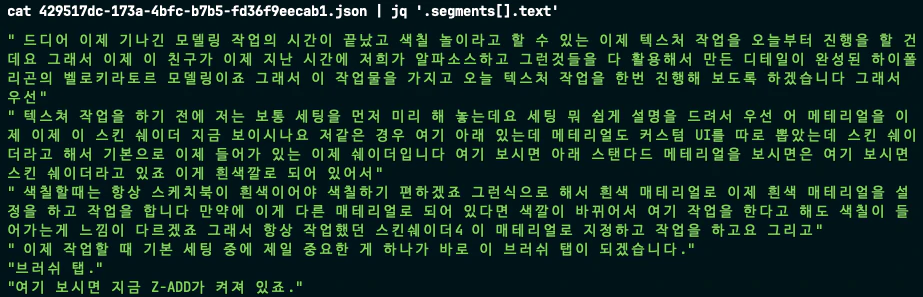
そのため、モデルが出力した字幕データを見ると、行ごとに長さがバラバラで、文の終わりで改行されることもほとんどなく、そのせいで読みやすさは最悪の状態でした。
これを改善するために、ピリオド/疑問符/感嘆符があれば改行する案、一定の文字数以上なら単純に空白を基準に半分に分割する案、形態素解析によって行を再構成する案など、さまざまな方法を模索しました。
そんな中、WhisperXに移行してから音節単位で時間を追跡できるようになったことで、いっそすべての行を新しく作り直そうと考えるようになります。その後、以下のような基準を定め、WhisperXの実行から行の構成までを一度に行うPythonスクリプトを実装しました。
- WhisperXが時間の追跡に失敗した音節の時間は、時間の追跡に成功した最も近い前後の音節の時間、または文の開始・終了時間から線形補間する。(wav2vecの韓国語モデルベースだったため、ハングル以外は音節の時間を追跡できないという問題がありました。)
- 直前の単語までの1行が0.5秒未満であれば、ほかのどの条件を満たしていても改行しない。
- 直前の単語までの1行が10秒を超えたら、今回の単語から改行する。
- 今回の単語で1行が10文字を超え、かつ形態素解析の結果で文の数に変化があれば、今回の単語から改行する。
- 今回の単語で1行が50文字を超えたら、今回の単語から改行する。
- 文の開始が直前の文の終わりから0.5秒以内の場合は、文の開始時間として直前の文の終了時間を代わりに使う。
実は、このうち形態素解析をもとに文の数を計算し、それを使って改行する部分は最後に作った基準です。
この基準を決めるまでは、WhisperXをCLIで実行したあと、JSONで保存されたデータを読み込んで行を構成する部分をすべてGoで実装していました。
しかし、形態素解析と文の数の計算にKiwiを使うことになったため、WhisperXをPython内で直接実行するようにし、行を構成する部分までPythonで実装し直しました。
そして、こうして書いたPythonスクリプトを実行し、最終的に構成された字幕データをストレージに保存するという、AWS Batch内での1つのジョブのライフサイクルを管理する部分だけをGoが担う構造にしました。
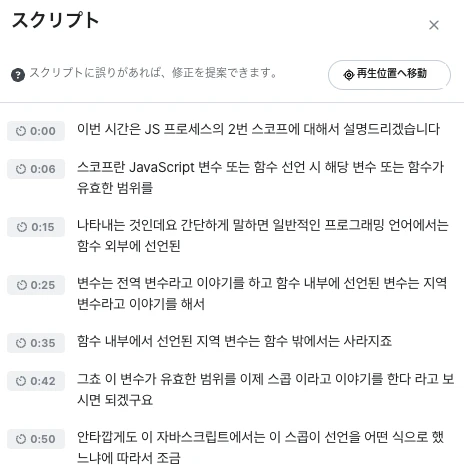
こうして、現在提供している字幕のように、読みやすさが大きく改善された字幕データを生成できるようになりました。
GPUインスタンス不足の問題を回避する
問題になっていた部分はすべて解決したと思い、実際にこれまでアップロードされた講座を対象に字幕を一括生成する作業を行おうとしました。
ところが、AWS Batchにジョブを投入していくら待っても、EC2インスタンスが起動しませんでした。Spot Requestを確認してみると、ソウルリージョンにg5.xlargeインスタンスのSpot Capacityがなく、起動できていなかったのです。

Spot Instanceとは?
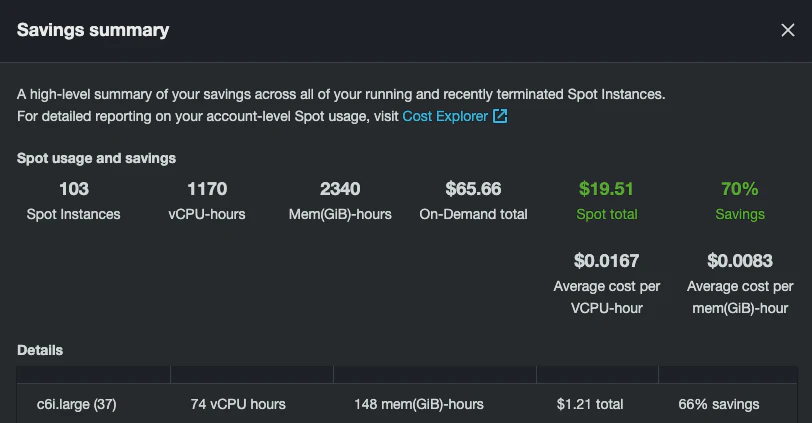
Spot Instanceは、AWSで使われていないコンピューティングリソースを最大90%割引した価格で提供する機能です。
実行中のSpot Instanceがときどき中断されることもありますが、AWS Batchなどを使ってワークフローの耐障害性を確保していれば、Spot Instanceを適用するだけで60%以上のコスト削減効果を得られます。
実際に、動画エンコーディングインフラにSpot Instanceを適用することで平均70%のコストを削減できていたので、そもそも費用のかさむGPUインスタンスを使ううえで、Spot Instanceの適用は必須でした。
Spot Capacityを求めて
GPUインスタンスが足りないという話はよく耳にしていましたが、実際に経験したのは初めてでした。そうして3日待っても起動しないのを見て、別の方法を探し始めました。
まず、Spot Placement Scoreという機能を使ってみました。米国のバージニア、オハイオ、オレゴンリージョンはg5.xlargeインスタンスが最も安く、Placement Scoreも高く出ていたので、まずはバージニアリージョンに行ってみました。
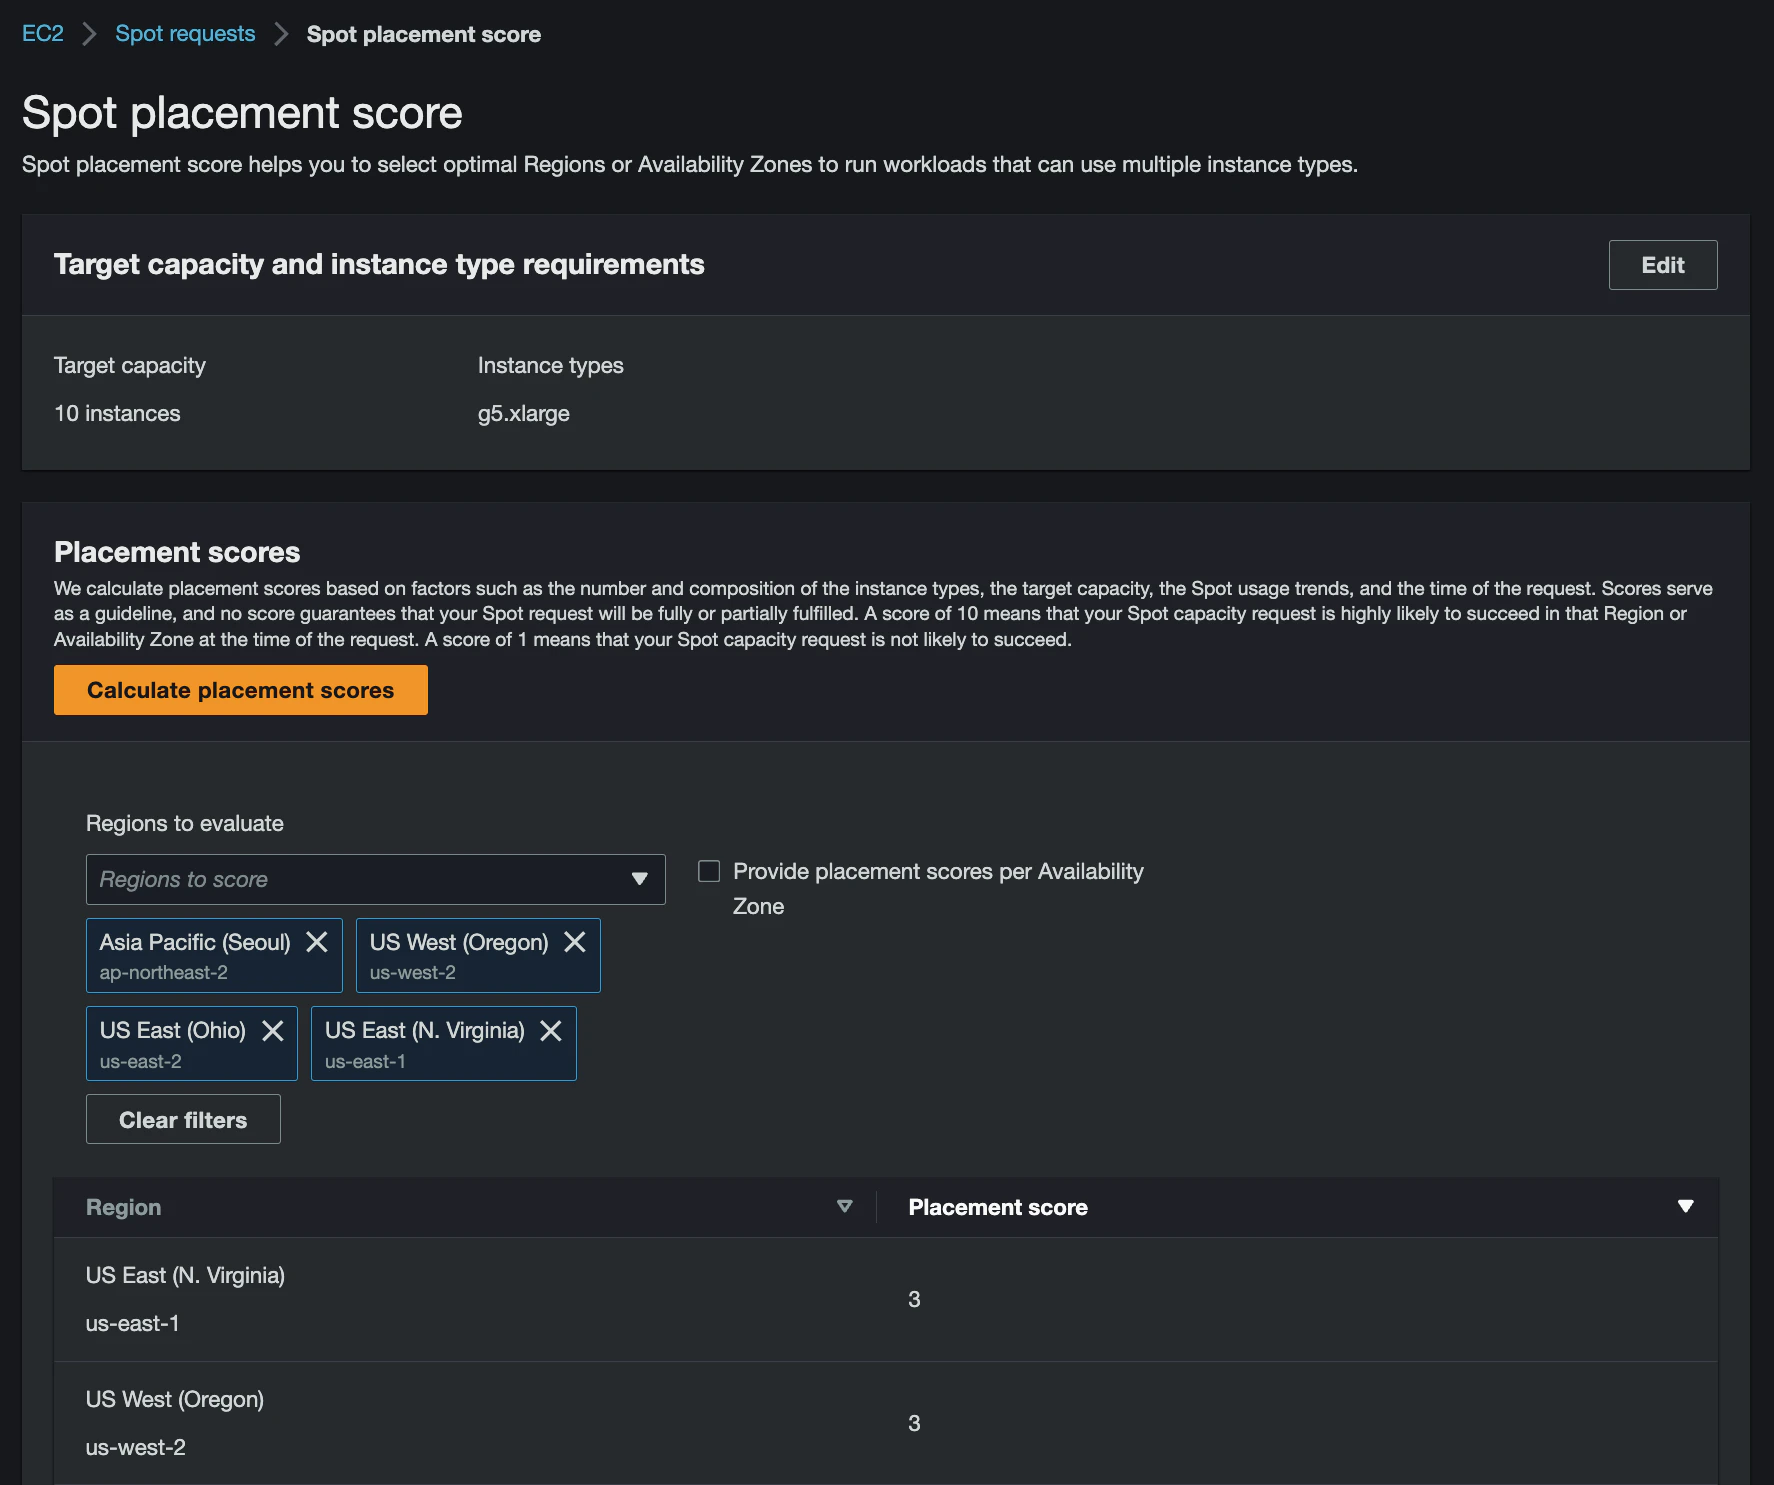
初めて使うリージョンだったので何もなく、VPC、Subnet、EIP、NAT Gatewayをはじめ、AWS Batch関連の各種リソースなどをすべて新しく作成しました。そして実行してみると、同じようにSpot Capacityがないというエラーが発生しました。
しまった!!と思い、すぐ隣のオハイオリージョンにも同じ構成を作ってみましたが、やはりSpot Capacityがないというエラーが発生しました。(……)
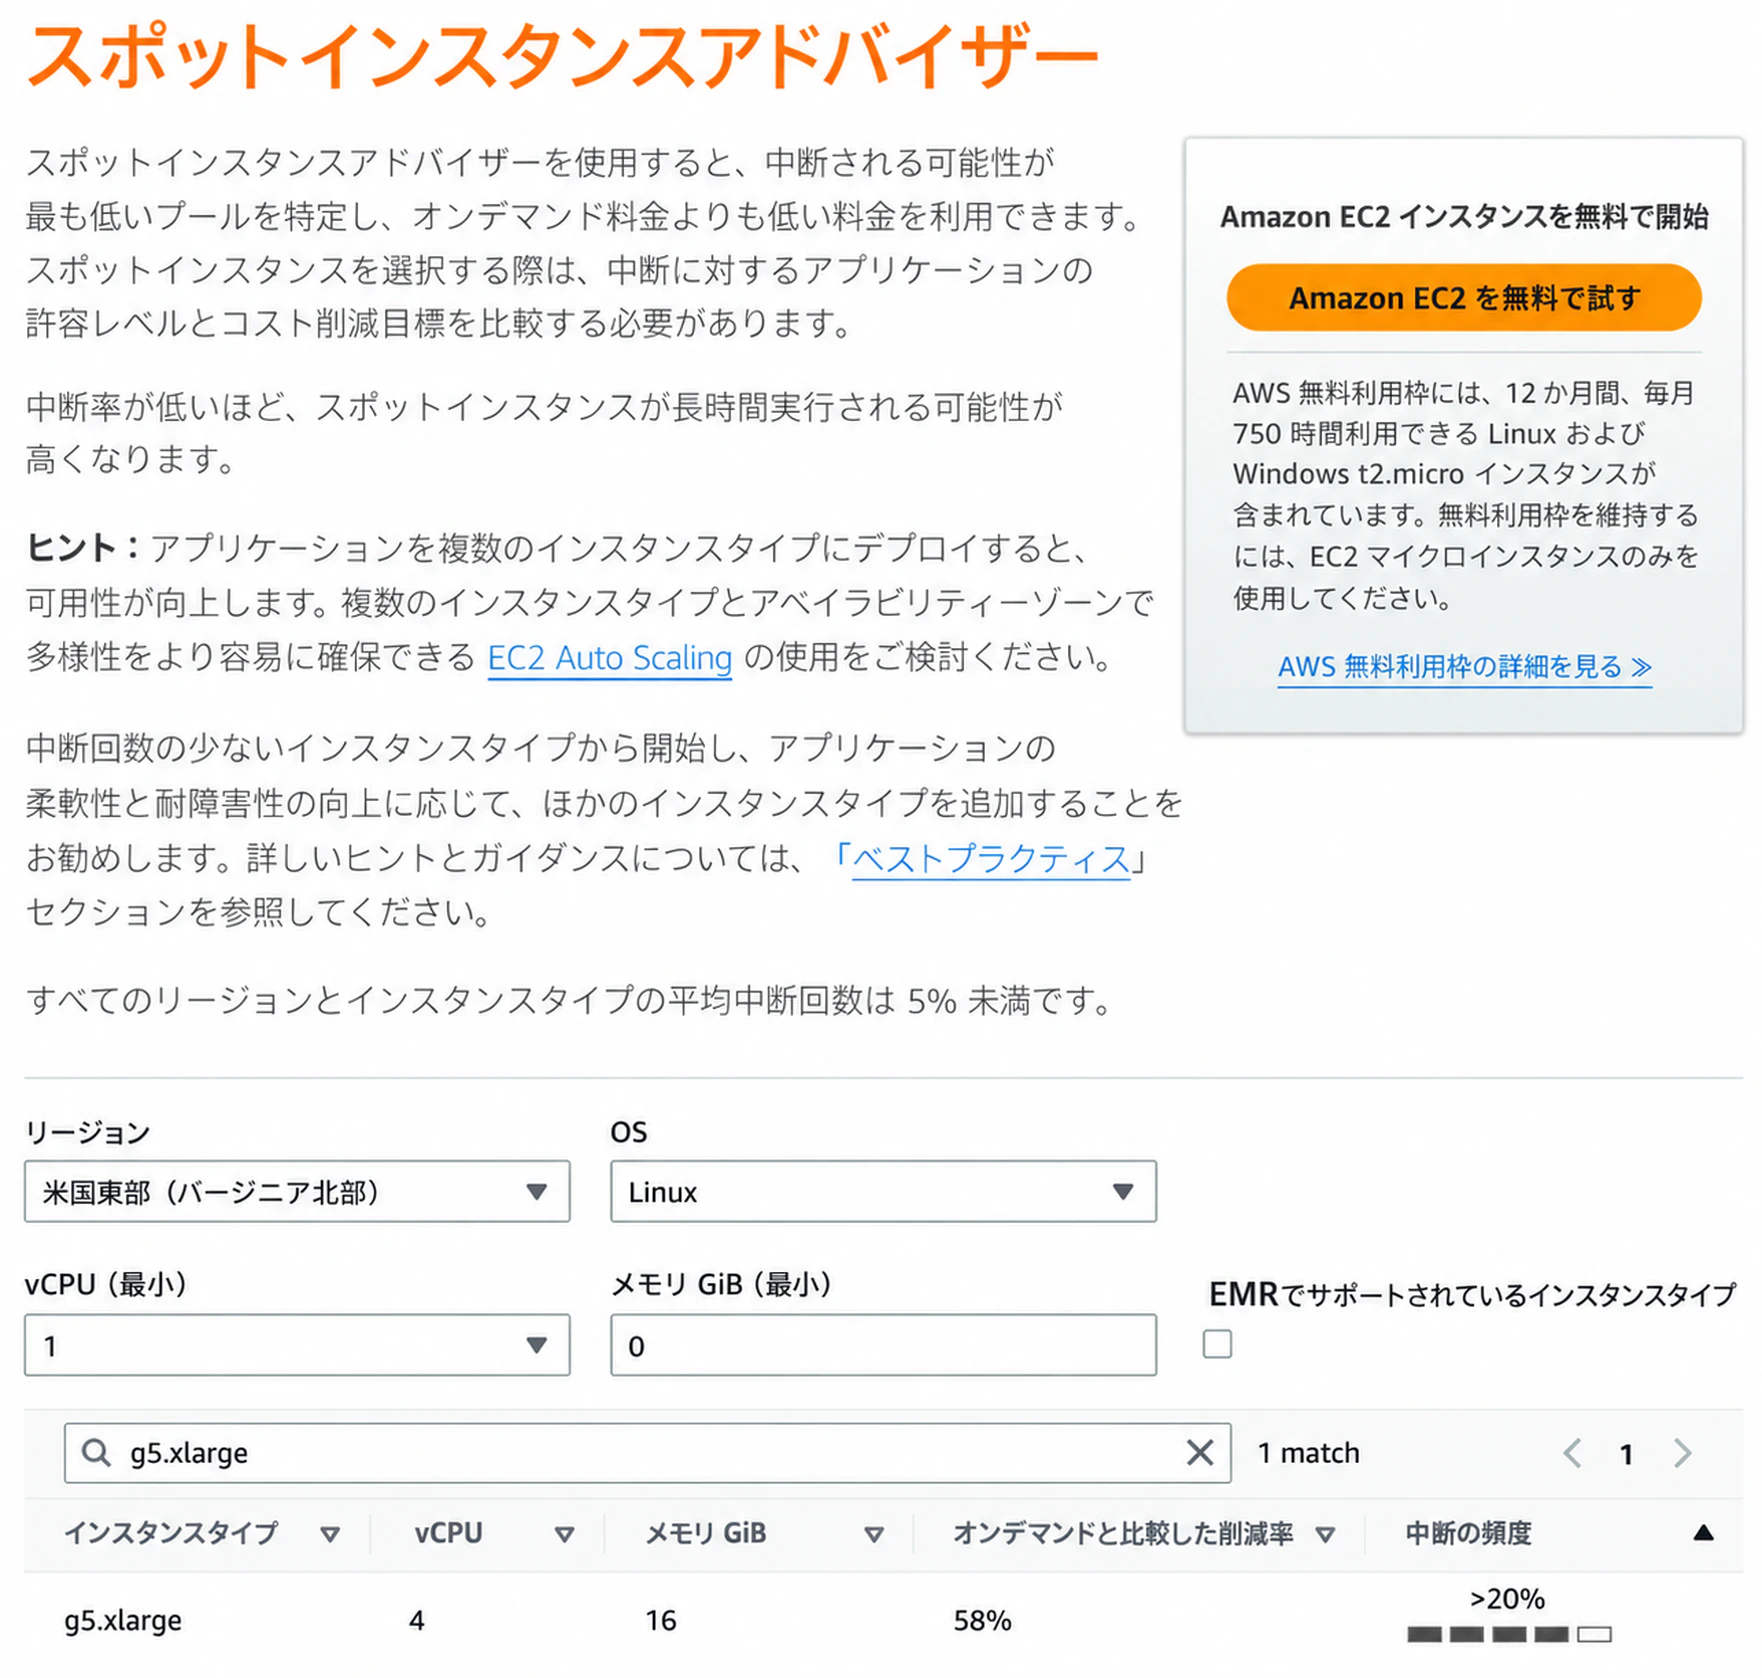
Placement Scoreは当てにならないなと思って調べてみたところ、スポットインスタンスアドバイザーというものを見つけました。
g5.xlargeスポットインスタンスの中断頻度が低いリージョンを探してみると、オレゴンリージョンが低いことが分かりました。
バージニア、オハイオリージョンに作ったものはすべて削除し、オレゴンリージョンに構成して実行してみると、ようやく字幕生成ジョブが動き始めました。
一括処理のために2,000台のg5.xlargeインスタンスを同時に起動する計画でしたが、オレゴンリージョンでさえインスタンス不足で最大500台ほどしか起動できませんでした。それでも、約4時間で字幕の一括生成を完了できました。
一括処理のコスト
| 基盤 | 単価 | 費用 | 差 |
|---|---|---|---|
| AWS Batch (g5.xlarge Spot) | - | $807.22 | - (x1) |
| AWS Batch (g5.xlarge On-Demand) | - | 約$2,690 | 約$1,883 (x3.3) |
| OpenAI Whisper API | $0.006 / minute | 約$8,700 | 約$7,893 (x10.8) |
| Naver CLOVA CSR API | $0.012 / minute | 約$17,400 | 約$16,593 (x21.6) |
字幕の一括生成作業にかかった費用は $807.22 で、約24,000時間に及ぶ動画の音声データをAPIベースのサービスで処理する場合と比べて、10分の1以下のコストで字幕を生成できる構成を実現できました。
結論
以上のような過程を経て、約2か月で字幕生成機能を無事に実装することができました。
Infthonをきっかけに、2日でアイデアの選定から技術調査を経てデモ用の実装までを終え、その後の2か月間でそれをユーザーにリリースできるレベルまで引き上げるために、さまざまな試みをした貴重な経験でした。
字幕生成に関する技術的な部分も注目に値しますが、特に強調したいのは、1人が短期間で行ったにしては、インフラ関連の作業量がかなり多かったという点です。
何のリソースもないリージョンを3回も渡り歩き、VPCからAWS Batch環境までを一晩で構成できたのは、何かが準備されていなければ不可能なことです。
特に、受講権を持つユーザーにのみ字幕データを提供しなければならない部分や、字幕のストレージをS3からMongoDBに移行する作業など、本文には書いていない数多くのインフラ作業がありました。それらに触れなかったのは、ほとんど悩むことなく素早く対応できたからです。
これが可能だったのは、これまで懸命に構築してきたIaCのおかげだと言えると思います。
私たちがどのようにIaCを構築したかについては、(今度こそ本当に)近日公開予定の「Inflab IaC構築記(Part 1)」の記事でご覧いただけます。
AWS CDKからTerraformへの記事でTerragruntとTerratestについての記事を予告しておきながら、1年以上新しい記事を投稿できなかった理由について詳しく書いていますので、IaCに興味のある方はぜひ読んでみてください!
ありがとうございました。