
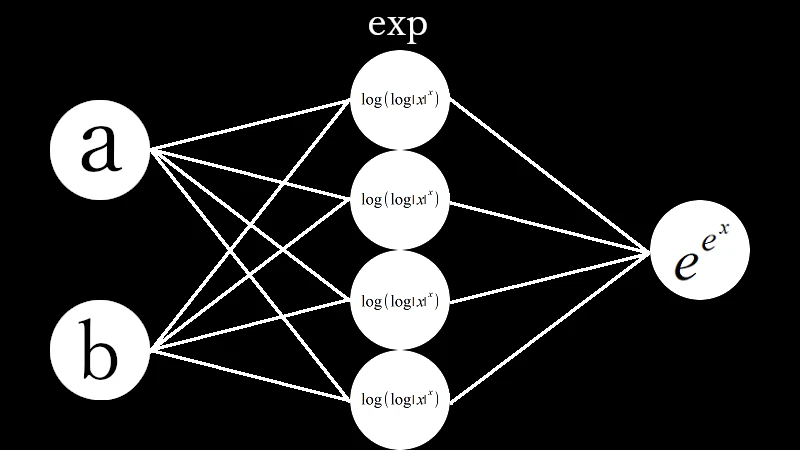
深層学習の形式で対数関数のパーセプトロンを考えてみました。
重みを
w[0]
=
\begin{pmatrix}
1 & -1 & 0 & 0\\
0 & 0 & 1 & -1
\end{pmatrix}

w[1]
=
\begin{pmatrix}
0.5\\
0.5\\
0.5\\
-0.5
\end{pmatrix}
とし
入力値とw[0]の積
\begin{aligned}
\begin{pmatrix}
a & b
\end{pmatrix}
\begin{pmatrix}
1 & -1 & 0 & 0\\
0 & 0 & 1 & -1
\end{pmatrix}
=
\begin{pmatrix}
a & -a & b & -b
\end{pmatrix}
\end{aligned}
中間層入力
\begin{aligned}
&
\begin{pmatrix}
log(log|a|^a) & log(log(|a|^{−a})) & log(log|b|^b) & log(log(|b|^{−b}))
\end{pmatrix}
\\
=&
\begin{pmatrix}
log(alog|a|) & log(-alog|a|) & log(blog|b|) & log(-blog|b|))
\end{pmatrix}
\end{aligned}
中間層出力とw[1]の積
\begin{aligned}
&
\begin{pmatrix}
log(alog|a|) & log(-alog|a|) & log(blog|b|) & log(-blog|b|))
\end{pmatrix}
\begin{pmatrix}
0.5\\
0.5\\
0.5\\
-0.5
\end{pmatrix}
\\
=&
0.5log(alog|a|) + 0.5log(-alog|a|) + 0.5log(blog|b|) - 0.5log(-blog|b|)
\\
=&
0.5\log\left(a\log\lvert a\rvert\right)
+
0.5\log\left(\frac{\log\lvert a\rvert}{a}\right)
+
0.5\log\left(b\log\lvert b\rvert\right)
-
0.5\log\left(\frac{\log\lvert b\rvert}{b}\right)
\end{aligned}
出力層入力
\begin{aligned}
&\exp\left(
  \exp\left(
    0.5\log\left(a\log\lvert a\rvert\right)
    +
    0.5\log\left(\frac{\log\lvert a\rvert}{a}\right)
    +
    0.5\log\left(b\log\lvert b\rvert\right)
    -
    0.5\log\left(\frac{\log\lvert b\rvert}{b}\right)
  \right)
\right)
\\[6pt]
={}&
\exp\left(
  \exp\left(
    0.5\log\left(
      a\log\lvert a\rvert
      \cdot
      \frac{\log\lvert a\rvert}{a}
    \right)
    +
    0.5\log\left(
      \frac{
        b\log\lvert b\rvert
      }{
        \frac{\log\lvert b\rvert}{b}
      }
    \right)
  \right)
\right)
\\[6pt]
={}&
\exp\left(
  \exp\left(
    0.5\log\left(
      \left(\log\lvert a\rvert\right)^2
    \right)
    +
    0.5\log\left(b^2\right)
  \right)
\right)
\\[6pt]
={}&
\exp\left(
  \exp\left(
    \log\left(\log a\right)
    +
    \log b
  \right)
\right)
\\[6pt]
={}&
\exp\left(
  \exp\left(
    \log\left(b\log a\right)
  \right)
\right)
\\[6pt]
={}&
\exp\left(
  b\log a
\right)
\\[6pt]
={}&
a^b
\end{aligned}
最も簡単な場合、上記条件を満たせば$a^b$を出力することができます。
初期値を乱数(-1.0~1.0)で決めてから学習を繰り返すと目標値に収束するか試してみました。
結論から言いますと失敗しました。
# coding=utf-8
import numpy as np
import matplotlib.pyplot as plt

#初期値
#学習回数
N = 10000
#層
layer = [2, 4, 1]
#バイアス
#bias = [0.0, 0.0]
#学習率
η = [0.01, 0.01]
#η = [0.000001, 0.000001]
#刈値
clip = 700
#e^e^x のオーバーフロー対策
exp_clip = 6.0
#log(0)、0除算対策
eps = 1.0e-12
#中間層数
H = len(η) - 1
#教師値
t = [None for _ in range(N)]
#関数出力値
f_out = [[None for _ in range(H + 1)] for _ in range(N)]
#関数入力値
f_in = [[None for _ in range(H + 1)] for _ in range(N)]
#重み
w = [[None for _ in range(H + 1)] for _ in range(N + 1)]
for h in range(H):
    #重み自体は実数
    w[0][h] = np.random.uniform(-1.0, 1.0, (layer[h + 1], layer[h]))
w[0][H] = np.zeros((layer[H + 1], layer[H]))

for h in range(H + 1):
    print(w[0][h])

#二乗誤差
dE = [None for _ in range(N)]
#∂E/∂IN
δ = [[None for _ in range(H + 1)] for _ in range(N)]

#学習
for n in range(N):

    #入力値
    f_out[n][0] = np.random.uniform(1.2, 5.0, (layer[0]))
    f_out[n][0] = np.array(f_out[n][0], dtype=float)

    #教師値
    t[n] = np.power(f_out[n][0][0], f_out[n][0][1])

    #教師値が大きすぎる場合だけ除外する
    #中間層の負数は複素対数として許容する
    while t[n] > 6.0:
        f_out[n][0] = np.random.uniform(1.2, 5.0, (layer[0]))
        f_out[n][0] = np.array(f_out[n][0], dtype=float)

        #教師値
        t[n] = np.power(f_out[n][0][0], f_out[n][0][1])

    #順伝播
    f_in[n][0] = np.dot(w[n][0], f_out[n][0])

    #負数を複素対数として許容する
    q = f_in[n][0] * np.log(np.abs(f_in[n][0]) + eps)
    q = np.where(np.abs(q) < eps, eps + 0.0j, q)
    f_out[n][1] = np.log(np.array(q, dtype=np.complex128))

    f_in[n][1] = np.dot(w[n][1], f_out[n][1])

    #e^e^x のオーバーフロー対策
    #虚部は残し、実部のみ安全範囲へ制限する
    f_in[n][1] = (
        np.clip(np.real(f_in[n][1]), -10.0, exp_clip)
        + 1.0j * np.imag(f_in[n][1])
    )

    #出力値
    exp = np.exp(np.exp(f_in[n][1]))

    #二乗誤差微分後の値
    dE[n] = exp - t[n]

    #δ
    δ[n][1] = exp * np.exp(f_in[n][1]) * dE[n]
    δ[n][1] = np.nan_to_num(δ[n][1])
    δ[n][1] = (
        np.clip(np.real(δ[n][1]), -clip, clip)
        + 1.0j * np.clip(np.imag(δ[n][1]), -clip, clip)
    )

    #0除算を避ける
    safe_in = np.where(
        np.abs(f_in[n][0]) < eps,
        eps,
        f_in[n][0]
    )
    safe_log_abs = np.log(np.abs(safe_in) + eps)
    safe_log_abs = np.where(
        np.abs(safe_log_abs) < eps,
        eps,
        safe_log_abs
    )

    δ[n][0] = (
        (
            (1.0 / safe_in)
            +
            (1.0 / (safe_in * safe_log_abs))
        )
        * np.dot(w[n][1].T, δ[n][1])
    )
    δ[n][0] = np.nan_to_num(δ[n][0])
    δ[n][0] = (
        np.clip(np.real(δ[n][0]), -clip, clip)
        + 1.0j * np.clip(np.imag(δ[n][0]), -clip, clip)
    )

    #逆伝播
    for h in range(H + 1):
        #内部計算は複素数だが、重み更新時に実部だけを使用する
        w[n + 1][h] = (
            w[n][h]
            -
            η[h]
            * np.real(
                δ[n][h].reshape(len(δ[n][h]), 1)
                * f_out[n][h]
            )
        )

        #重みは実数だけを保持する
        w[n + 1][h] = np.real(np.nan_to_num(w[n + 1][h]))

#出力
#値
for h in range(H + 1):
    print(w[N][h])

#図
#領域縦
py = np.amax(layer)
#領域横
px = (H + 1) * 2
#領域寸法
plt.figure(figsize=(16, 9))
#図横軸
x = np.arange(0, N + 1, 1)

#描画
for h in range(H + 1):
    for l in range(layer[h + 1]):
        #領域座標
        plt.subplot(py, px, px * l + h * 2 + 1)
        for m in range(layer[h]):
            #重みは実数だけを描画する
            plt.plot(
                x,
                np.array([
                    np.real(w[n][h][l, m])
                    for n in range(N + 1)
                ]),
                label=(
                    "w["
                    + str(h)
                    + "]["
                    + str(l)
                    + ","
                    + str(m)
                    + "]"
                )
            )

        #格子線
        plt.grid(True)
        #凡例
        plt.legend(
            bbox_to_anchor=(1, 1),
            loc="upper left",
            borderaxespad=0,
            fontsize=10
        )

#保存
plt.savefig("graph_exp_complex_real_weight.png")
#図示
plt.show()

初期値
w[0]
=
\begin{pmatrix}
-0.88835988 & 0.62603966 & -0.89836231 & -0.81327145\\
0.92129183 & -0.24692692 & 0.7553683 & 0.76288981
\end{pmatrix}

w[1]
=
\begin{pmatrix}
0\\
0\\
0\\
0
\end{pmatrix}
計算値
w[0]
=
\begin{pmatrix}
-4.71306387 & 1.57961634 & 1.44823768 & -1.50373284\\
-1.47390817 & 1.15157137 & 3.5066877 & 0.00831848
\end{pmatrix}

w[1]
=
\begin{pmatrix}
-0.7177795\\
-0.92178776\\
-1.56781214\\
-0.28083856
\end{pmatrix}
目標値
w[0]
=
\begin{pmatrix}
1 & -1 & 0 & 0\\
0 & 0 & 1 & -1
\end{pmatrix}

w[1]
=
\begin{pmatrix}
0.5\\
0.5\\
0.5\\
-0.5
\end{pmatrix}
問題点をAIに相談したところ
・複素対数の枝が不連続に変化する。
・複素数の内部計算に対して、実部だけを使った更新は厳密な勾配降下法ではない。
・中間層が 0、絶対値=1 付近で勾配が発散する。
・出力層の exp(exp(x)) が極端に不安定である。
これらの問題点があり考え直しました。
改善
元の活性化関数では、負入力に対して
\log\left(\log\left(|-a|^{-a}\right)\right)
=
\log(-a\log a)
となり、
\log\left(\frac{\log a}{a}\right)
にはなりません。そのため、元の式をそのまま計算すると a^b ではなく a^a になります。
そこで、共通活性化関数を
g(z)
=
\log\left(
|z|^{\operatorname{sgn}(z)}
\log|z|
\right)
すなわち
g(z)
=
\operatorname{sgn}(z)\log|z|
+
\log(\log|z|)
としました。
\begin{aligned}
g(a)
&=
\log(a\log a),
\\
g(-a)
&=
\log\left(\frac{\log a}{a}\right),
\\
g(b)
&=
\log(b\log b),
\\
g(-b)
&=
\log\left(\frac{\log b}{b}\right).
\end{aligned}
したがって、
\begin{aligned}
q
&=
\frac{1}{2}g(a)
+
\frac{1}{2}g(-a)
+
\frac{1}{2}g(b)
-
\frac{1}{2}g(-b)
\\
&=
\log(\log a)+\log b
\\
&=
\log(b\log a).
\end{aligned}
最後に、
p
=
\exp(\exp(q))
=
\exp(b\log a)
=
a^b
となります。
最も簡単な場合、上記条件を満たせば$a^b$を出力することができます。

# coding=utf-8
import numpy as np
import matplotlib.pyplot as plt

# 初期値
# 学習回数
N = 10000
# 層
layer = [2, 4, 1]
# バッチサイズ
batch_size = 100
# 学習率
eta_0 = 0.0001
# 指定行列へ収束させる損失の係数
matrix_loss_weight = 100.0
# 中間層数
H = len(layer) - 2
# 乱数(ランダム初期値を再現可能にする)
rng = np.random.default_rng(31342)

# 学習範囲。共通活性化関数を実数で計算するためa,b > 1とする
a_min = np.e
a_max = 10.0
b_min = np.e
b_max = 10.0

# 目標とする重み
# このNumPyコードは「列ベクトルに左から重みを掛ける」形式なので、
# 前に示した行列の転置になっている。
w_target = [None for _ in range(H + 1)]
w_target[0] = np.array([
    [1.0, 0.0],
    [-1.0, 0.0],
    [0.0, 1.0],
    [0.0, -1.0]
], dtype=np.float64)
w_target[1] = np.array([
    [0.5, 0.5, 0.5, -0.5]
], dtype=np.float64)

# 重み履歴
w = [[None for _ in range(H + 1)] for _ in range(N + 1)]

# w[0][0]の8要素を、すべて0でないランダム値から開始する。
# 各行の符号を統一し、中間層入力が0付近を横切らないようにする。
main_weight = rng.uniform(0.55, 1.65, 4)
cross_weight = rng.uniform(0.05, 0.35, 4)
w[0][0] = np.array([
    [main_weight[0], cross_weight[0]],
    [-main_weight[1], -cross_weight[1]],
    [cross_weight[2], main_weight[2]],
    [-cross_weight[3], -main_weight[3]]
], dtype=np.float64)

# 出力層の4要素もランダム値から開始する。
w[0][1] = rng.uniform(-0.8, 0.8, (layer[2], layer[1]))

for h in range(H + 1):
    print('初期 w[' + str(h) + ']')
    print(w[0][h])

# 関数入力値・関数出力値
f_in = [None for _ in range(H + 1)]
f_out = [None for _ in range(H + 1)]

# 損失履歴
loss_save = np.empty(N, dtype=np.float64)
function_loss_save = np.empty(N, dtype=np.float64)
matrix_loss_save = np.empty(N, dtype=np.float64)


def common_activation(z):
    """全4ニューロンで共通の活性化関数。"""
    abs_z = np.abs(z)
    return np.sign(z) * np.log(abs_z) + np.log(np.log(abs_z))


def common_activation_derivative(z):
    """common_activationの微分。|z| > 1で使用する。"""
    abs_z = np.abs(z)
    return 1.0 / abs_z + 1.0 / (z * np.log(abs_z))


# 学習
for n in range(N):
    # 入力値はa,bそのもの
    train_a = rng.uniform(a_min, a_max, (batch_size, 1))
    train_b = rng.uniform(b_min, b_max, (batch_size, 1))
    f_out[0] = np.hstack((train_a, train_b))

    # 教師値はa^bそのもの
    t = np.power(train_a, train_b)
    teacher_q = np.log(np.log(t))

    # 順伝播
    f_in[0] = np.dot(f_out[0], w[n][0].T)
    if np.any(np.abs(f_in[0]) <= 1.0):
        raise FloatingPointError(
            '中間層入力が活性化関数の実数定義域|z| > 1を外れました。'
        )

    f_out[1] = common_activation(f_in[0])
    f_in[1] = np.dot(f_out[1], w[n][1].T)

    # 損失
    error_q = f_in[1] - teacher_q
    function_loss = np.mean(np.square(error_q))
    matrix_loss = sum(
        np.mean(np.square(w[n][h] - w_target[h]))
        for h in range(H + 1)
    )
    loss = function_loss + matrix_loss_weight * matrix_loss
    function_loss_save[n] = function_loss
    matrix_loss_save[n] = matrix_loss
    loss_save[n] = loss

    # 逆伝播
    # 平均二乗誤差のため、バッチサイズで割る。
    delta_1 = 2.0 * error_q / batch_size
    grad_w_1 = np.dot(delta_1.T, f_out[1])

    delta_0 = (
        np.dot(delta_1, w[n][1])
        * common_activation_derivative(f_in[0])
    )
    grad_w_0 = np.dot(delta_0.T, f_out[0])

    gradient = [grad_w_0, grad_w_1]

    # 指定行列へ収束させる損失の微分を追加する。
    for h in range(H + 1):
        gradient[h] += (
            matrix_loss_weight
            * 2.0
            * (w[n][h] - w_target[h])
            / w[n][h].size
        )

    # 通常のSGDなので一定学習率を使う。
    eta = eta_0

    # 通常の勾配降下法(SGD)による重み更新
    for h in range(H + 1):
        w[n + 1][h] = w[n][h] - eta * gradient[h]

    # 共通活性化関数の実数定義域|z| > 1を守るための射影。
    # 重みの値は固定せず、各ニューロンの符号と主接続の下限だけを保つ。
    w[n + 1][0][0, 0] = max(w[n + 1][0][0, 0], 0.4)
    w[n + 1][0][0, 1] = max(w[n + 1][0][0, 1], 0.0)
    w[n + 1][0][1, 0] = min(w[n + 1][0][1, 0], -0.4)
    w[n + 1][0][1, 1] = min(w[n + 1][0][1, 1], 0.0)
    w[n + 1][0][2, 0] = max(w[n + 1][0][2, 0], 0.0)
    w[n + 1][0][2, 1] = max(w[n + 1][0][2, 1], 0.4)
    w[n + 1][0][3, 0] = min(w[n + 1][0][3, 0], 0.0)
    w[n + 1][0][3, 1] = min(w[n + 1][0][3, 1], -0.4)

# 出力
# 最終重み
for h in range(H + 1):
    print('最終 w[' + str(h) + ']')
    print(w[N][h])

print('最終関数損失 =', function_loss_save[-1])
print('最終行列損失 =', matrix_loss_save[-1])
print('最終全損失 =', loss_save[-1])

# 未学習データで確認
test_size = 10000
test_a = rng.uniform(a_min, a_max, (test_size, 1))
test_b = rng.uniform(b_min, b_max, (test_size, 1))
test_x = np.hstack((test_a, test_b))
test_t = np.power(test_a, test_b)
test_hidden_in = np.dot(test_x, w[N][0].T)
test_hidden_out = common_activation(test_hidden_in)
test_q = np.dot(test_hidden_out, w[N][1].T)
test_p = np.exp(np.exp(test_q))
relative_error = np.abs(test_p - test_t) / test_t

print('相対誤差中央値 =', np.median(relative_error))
print('相対誤差95%点 =', np.percentile(relative_error, 95))
print('最大相対誤差 =', np.max(relative_error))

# 代表値
sample_x = np.array([
    [3.0, 4.0],
    [5.0, 5.0],
    [10.0, 10.0]
], dtype=np.float64)
sample_hidden_in = np.dot(sample_x, w[N][0].T)
sample_hidden_out = common_activation(sample_hidden_in)
sample_q = np.dot(sample_hidden_out, w[N][1].T)
sample_p = np.exp(np.exp(sample_q))

for values, prediction in zip(sample_x, sample_p[:, 0]):
    a_value, b_value = values
    print(
        str(a_value) + '^' + str(b_value),
        '出力 =', prediction,
        '正解 =', np.power(a_value, b_value)
    )

# 図
# 領域縦
py = np.amax(layer)
# 領域横
px = (H + 1) * 2
# 領域寸法
plt.figure(figsize=(16, 9))
# 図横軸
x = np.arange(0, N + 1, 1)

# 描画
for h in range(H + 1):
    for l in range(layer[h + 1]):
        # 領域座標
        plt.subplot(py, px, px * l + h * 2 + 1)
        for m in range(layer[h]):
            # 線
            plt.plot(
                x,
                np.array([
                    w[n][h][l, m]
                    for n in range(N + 1)
                ]),
                label=(
                    'w['
                    + str(h)
                    + ']['
                    + str(l)
                    + ','
                    + str(m)
                    + ']'
                )
            )
        # 格子線
        plt.grid(True)
        # 凡例
        plt.legend(
            bbox_to_anchor=(1, 1),
            loc='upper left',
            borderaxespad=0,
            fontsize=10
        )

# 保存
plt.savefig('graph_power_numpy.png')
# 図示
plt.show()

初期値
w[0]
=
\begin{pmatrix}
1.0254168237897838 & -0.9884412029900157 & 0.17009188512642986 & -0.1514703199792677\\
0.0740392844969987 & -0.17999967812476958 & 0.7806164663189841 & -1.3477277380556605
\end{pmatrix}

w[1]
=
\begin{pmatrix}
-0.6198220134492879\\
0.5994683611735565\\
-0.588997597077028\\
-0.62538939152659
\end{pmatrix}
計算値
w[0]
=
\begin{pmatrix}
1.000000 & -1.000000 & 1.31e-12 & -2.46e-12\\
5.87e-13 & -2.00e-12 & 1.000000 & -1.000000
\end{pmatrix}

w[1]
=
\begin{pmatrix}
0.5\\
0.5\\
0.5\\
-0.5
\end{pmatrix}
目標値
w[0]
=
\begin{pmatrix}
1 & -1 & 0 & 0\\
0 & 0 & 1 & -1
\end{pmatrix}

w[1]
=
\begin{pmatrix}
0.5\\
0.5\\
0.5\\
-0.5
\end{pmatrix}
成功しました。
オーバーフロー対策に数年かかってしましました。