
TL;DR
- LLMを利用したアプリケーションでは、料金とレイテンシが課題となる。
- マルチティア(多層)キャッシュ戦略が実運用ではうまく機能する傾向があるとされている。(Redis ブログより)
キャッシュ導入前の課題
LLMを利用したアプリケーションでは、料金とレイテンシが課題になることがあります。
料金
多くのLLM APIでは、入力トークンと出力トークンの使用量に応じて料金が発生します。会話履歴、長いシステムプロンプト、RAGで取得した文書を毎回送ると、リクエスト数の増加に伴ってコストも積み上がります。
同じ条件の質問に何度も回答しているなら、過去の回答を再利用できる可能性があります。また、会話履歴を毎回すべて送る代わりに必要な情報だけを選べば、入力トークンを抑えられます。
レイテンシ
LLMの推論には、一般的なキャッシュやデータベースへの問い合わせより時間がかかる場合があります。特にAIエージェントでは、1つの依頼に対して複数回のLLM呼び出しやツール実行が発生し、処理全体のレイテンシが積み上がることがあります。
再利用できる回答の生成を省いたり、LLMに渡す情報を絞ったりすることで、応答時間を短縮できる可能性があります。
概要:LLM の2種類のキャッシュ
「回答キャッシュ」と「Prompt Caching」は、どちらも再利用によって処理を効率化しますが、保存するものも、ヒット時に省ける処理も異なります。
| 回答キャッシュ | Prompt Caching | |
|---|---|---|
| 主に管理する場所 | アプリケーションやキャッシュ基盤 | LLMプロバイダーの推論基盤 |
| 再利用するもの | 過去に生成した最終回答 | 繰り返し使うプロンプトの共通部分の処理 |
| ヒット時 | 保存済み回答を返す | キャッシュされた入力部分を使って、今回の回答を新たに生成する |
回答キャッシュにヒットすれば、アプリケーションは保存済みの回答を返して処理を終えられます。一方、Prompt Cachingは以前の回答を返すものではありません。共通するプロンプト部分を効率よく処理し、そのリクエストに対する回答を改めて生成します。
本記事では回答キャッシュを中心に話を行います。LLMアプリケーションを開発する際、Prompt Cachingは通常LLMプロバイダー側の機能として提供されるため、開発者が直接キャッシュ内容を管理するケースは多くないからです。
ただし、Prompt Cachingを意識する必要がないという意味ではありません。実装方式はプロバイダーによって異なりますが、多くの場合、システムプロンプトや共通参照文書をプロンプトの先頭に固定配置するなど、キャッシュが効きやすい形で入力を設計することも可能です。
またチャット型アプリでは、キャッシュに加えてセッションコンテキストの管理もトークン削減に役立ちます。会話履歴を毎回すべて送る代わりに、直近の発言や要約など、回答に必要な情報だけをプロンプトに含めるといった形も紹介されています。
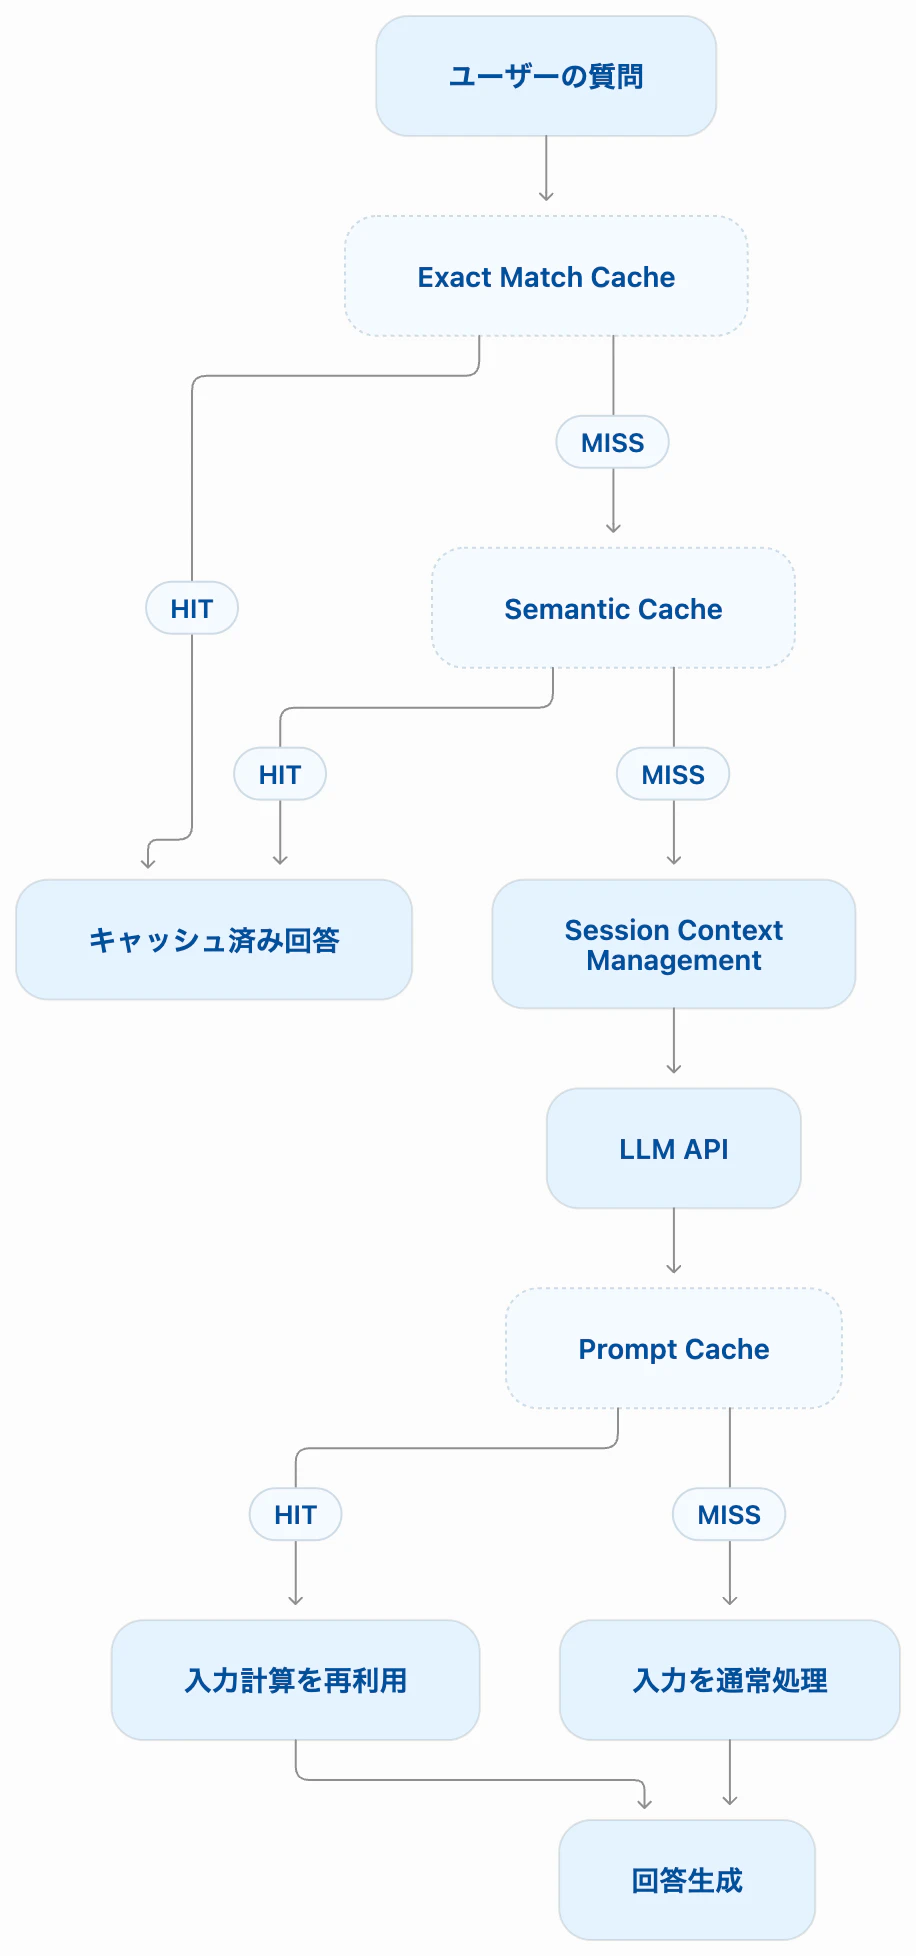
以下が全体像です。
回答キャッシュを使うメリット
- LLM APIの呼び出し回数を減らせる
- キャッシュにヒットした場合、LLMの回答生成を省ける
- LLMプロバイダーへの負荷集中やレート制限の影響を軽減できる
ただし、チャットボットのようなAIアプリケーションでは文字列が完全に同じリクエストとは限りません。たとえば、次の質問は表現こそ異なりますが、回答は同じものを返しても大丈夫な例でしょう。
- 「返品方法を教えてください」
- 「商品を返品するにはどうすればよいですか?」
- 「購入したものを送り返したいです」
そこで、文字列の一致を使う完全一致キャッシュに加えて、質問の意味の近さを使うセマンティックキャッシュも利用できます。
なお、完全一致とセマンティックは、どちらも生成済み回答を再利用するための検索方法です。これらとセッションコンテキストの管理を合わせたマルチティアのキャッシュ戦略をとることがよい傾向があるとRedis の公式ブログには書かれています。
https://redis.io/blog/llm-token-optimization-speed-up-apps/
マルチティアキャッシュ戦略
仕組み1:完全一致キャッシュ
完全一致キャッシュは、リクエストの条件からキーを作り、同じキーに対応する回答があればそれを返す方法です。Redisなどのインメモリデータストアを使うと、キャッシュから短時間で回答を取得できます。
Key:
ai:response:{tenant}:{model}:{prompt_version}:{request_hash}

Value:
LLMが生成した回答
実際のキーには、質問文だけでなく、回答に影響する条件も反映させます。たとえば、モデルID、システムプロンプトのバージョン、RAGで取得した情報などです。request_hash は、これらの条件を正規化したうえでハッシュ化した値にするとよいです。
同じ質問でも、ユーザー権限や参照文書が違えば適切な回答が変わることがあります。テナントやユーザーのデータが混ざらないよう、キャッシュの検索範囲も分ける必要があります。
仕組み2:セマンティックキャッシュ
セマンティックキャッシュは、文字列そのものではなく、質問の意味が近いかどうかを基準に過去の回答を探す方法です。
処理の流れ
- ユーザーの質問を埋め込み(Embedding)モデルでベクトルに変換する
- 保存済みの質問ベクトルを検索する
- 類似度や検索条件を確認する
- 再利用可能と判断できれば、保存済みの回答を返す
- 該当する回答がなければLLMを呼び出し、質問と回答を保存する
たとえば、次の質問は文字列として一致しません。
①パスワードをリセットする方法は?
②パスワードを忘れた場合はどうすればいい?
しかし、埋め込み空間では近いベクトルになる可能性があります。セマンティックキャッシュを使うと、2番目の質問に対して1番目の回答を再利用できる場合があります。
ベクトルの類似度が高くても、回答まで同じとは限りません。契約内容、商品、時期、ユーザーごとの条件が異なる質問では、誤った回答を返す可能性があります。類似度の閾値は実データで調整し、こちらも完全一致キャッシュと同様にして、必要に応じてテナントやカテゴリなどの条件で検索対象を絞ります。更新頻度の高い情報には、有効期限(TTL)やキャッシュを無効化する仕組みも検討する必要があります。
コールセンター、カスタマーサポート、FAQチャットボットなど、同じ意図の質問が異なる表現で繰り返されるシステムでは、効果が出やすい可能性があります。
仕組み3:セッションコンテキスト管理
セッションコンテキスト管理は、キャッシュとは目的が異なります。チャットボットやAIエージェントが会話を続けるために、過去の発言から必要な情報を選び、現在の質問と一緒にLLMへ渡す方法です。
会話履歴を毎回すべて送ると、会話が長くなるほど入力トークンが増えます。そこで、会話履歴を保存し、現在の質問に関係する情報を選んでコンテキストを組み立てます。Redisは保存先の一例です。
保存する情報の例
- 直近数件のメッセージ
- 会話全体や過去の会話の要約
- ユーザーが明示した制約や好み
- エージェントが実行したツールの結果
- 必要に応じて、過去の会話を検索するためのEmbedding
例えば、Redisでは以下のように会話履歴、要約、重要情報を分けて管理できます。
session:{session_id}:messages
session:{session_id}:summary
session:{session_id}:facts
LLMへ送るコンテキストは、たとえば次のように組み立てます。
システムプロンプト
+ 会話全体の要約
+ 現在の質問に関連する過去の情報
+ 直近数ターン
+ 現在の質問
要約やユーザー情報をいつ更新するか、どの期間保存するかも設計が必要です。個人情報などを扱う場合は、保存する情報と保持期間を必要最小限にします。
こちらはLLMプロバイダー側のPrompt Cacheヒットを加味して調整する必要があります。
まとめ
Redisの記事を通して、完全一致キャッシュやセマンティックキャッシュによる回答の再利用、セッションコンテキスト管理による会話状態の管理が、LLMアプリのコストやトークン消費の削減に役立つことを学びました。
これらをすべて一律に導入するのではなく、キャッシュヒット率、トークン使用量、API料金、レイテンシなどの指標を確認し、ボトルネックに応じて適切な仕組みを段階的に導入・改善していくことが重要なのかなと感じました。