
要約
- 検証環境で計画的に障害を 2 回起こし、AWS DevOps Agent と私のどちらが早く正確に原因を特定できるかを競いました。原因を特定した時刻はほぼ同じでした
- 複数の AWS アカウントに分かれた SaaS 基盤で、アラームが鳴ったら AWS DevOps Agent が自動で原因を調べる仕組みを作りました。調査結果は Slack に投稿されます
- 2026年9月のupdateによりSlack で Agent をメンションするだけで、人間が Agent に調査を頼めるようになりました
- Agent の課金は、Agent が動いた秒数に対する従量制です。どのアラームで自動調査を走らせるかが、そのまま費用を決めます。今回の 2 障害では、調査 1 回あたり 3〜5 USD でした
- Agent instructions を適切に設定することで、Agent の調査時の空振りが減ります。今回効いたのは「アラームがあるアカウントとリソースがあるアカウントは違う」と「IAM などグローバルサービスの CloudTrail イベントは us-east-1 で探す」の 2 つです
- 障害を直す判断と操作は人間に残しています
はじめに
博報堂テクノロジーズでSREをしている 宮田 です。
我々のチームは、複数の SaaS を運用しています。SaaS ごとにインフラ構成が違うため、アラームが鳴ったときのトラブルシューティングには、その SaaS の知識が必要です。機能によっては別のメンバーのほうが詳しいこともあり、対応が属人化している部分もあります。自分が詳しくない領域で障害が起きると、詳しい人に聞きながら調べることになります。
障害対応を効率化し、属人化を減らしたい。それがこの記事のモチベーションです。そのために DevOps Agent を導入し、一次調査を任せました。
なぜ AWS DevOps Agent か
選んだ理由は 2 つあります。
1 つは、複数の AWS アカウントを横断して調べられることです。私たちの SaaS は、サービスごとに複数のアカウントに分かれています。Agent 自身がアカウントをまたいで調べられることが必須でした。
もう 1 つは、調査のたびに環境を一から説明し直さなくてよいことです。Agent は、自分が調べて分かった環境の知識を memory という領域に自動で蓄積します。人間が書いた運用知識は、Agent instructions という常設の指示文に置きます。Agent instructions は毎回の調査で必ず参照されます。
これらの仕組みをAWSのマネージドサービスで作ることができるAWS DevOps Agentを選びました。
構成
AWS DevOps Agent は Agent Space という単位で動きます。Agent Space はプロダクトごとに 1 つ作り、監視を集約しているアカウントに置きました。この置き方は、AWS Summit のセッション(CNS319)で紹介されたベストプラクティスを参考にしています。
Agent は、監視アカウント以外のアカウントを、クロスアカウント用の IAM ロールで参照します。このロールの権限は読み取りが中心です。Agent の役割は調査と提案までに絞って設定しています。本番環境の変更、IAM の変更、Terraform apply は人間が行います。
Agent への入り口は 2 つです。人間が Slack から頼む経路と、アラームから自動で起動する経路です。順に説明します。
Slack から Agent を呼ぶ
最初に実装した 2026 年 8 月の時点では、DevOps Agent の Slack 連携は一方向だけでした。Agent が調査結果を Slack に投稿することはできますが、Slack から Agent に頼む手段はありませんでした。そこで、Amazon Q Developer in chat applications(旧 AWS Chatbot)を入り口にした経路を自作しました。Slack からコマンドで Lambda を呼び出し、その Lambda が DevOps Agent の Webhook に調査依頼を投げる形です。
2026 年 9 月に、Slack 連携に双方向モードが追加されました。設定は 3 手順です。まず、DevOps Agent のコンソールで Slack チャンネルの関連付けを開き、双方向モード を有効にします。
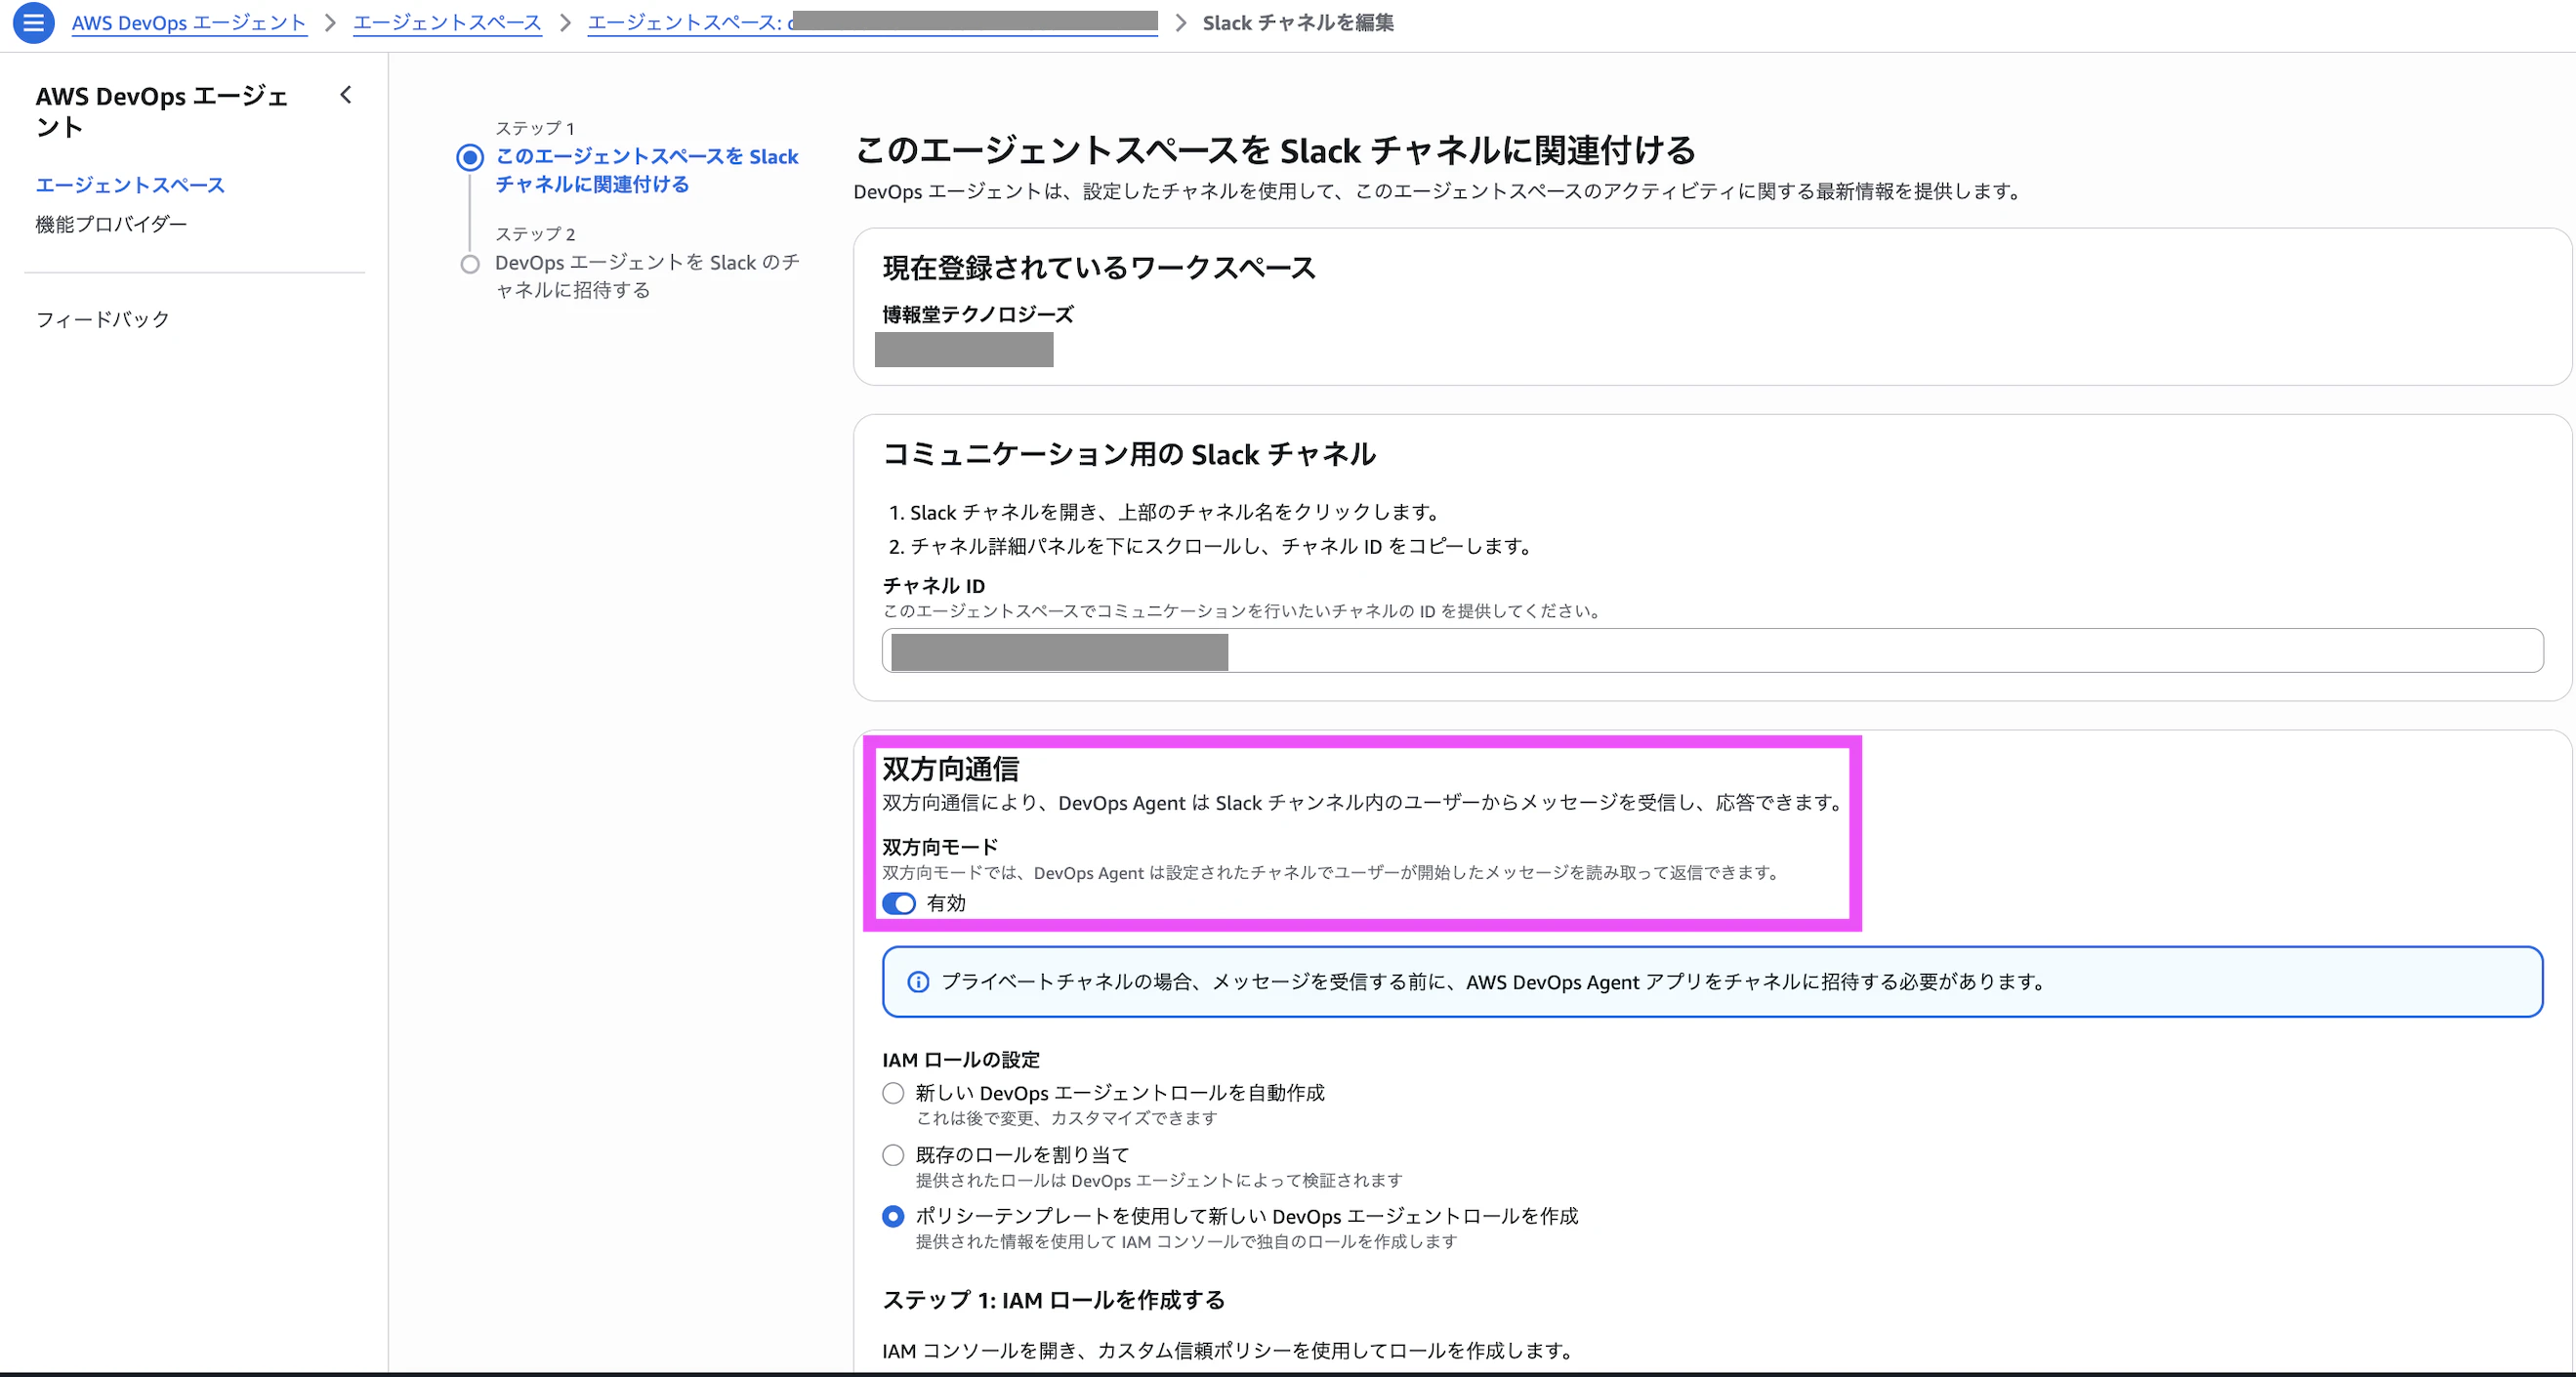
あわせて IAM ロールを設定します。次に、対象の private チャンネルに Agent のアプリを招待します。最後に、そのチャンネルで setup というメンションを一度送ります。以後は、Agent をメンションするだけで調査を頼めます。
実際に頼んだ例です。
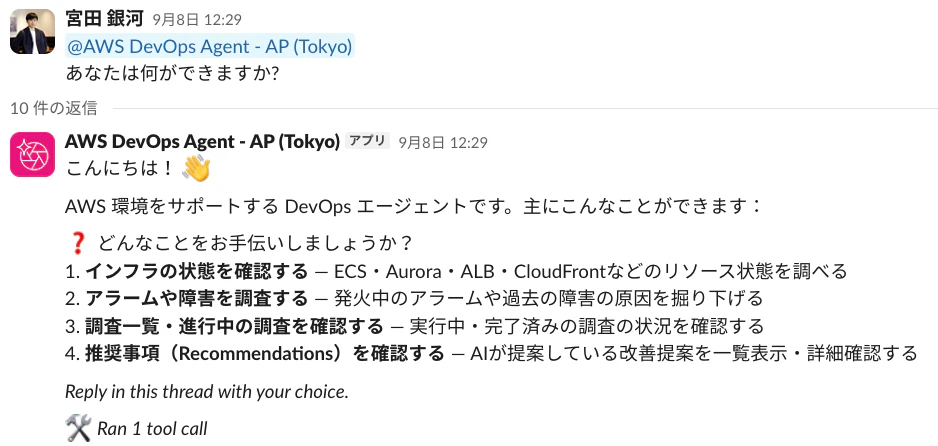
この自己紹介の文面は、Agent instructions に書いておいた内容がそのまま使われています。Slack から呼んだ Agent も、コンソールで動く Agent と同じ指示を読んでいることが分かります。
アラームが鳴ったら Agent が自動で調べる
Slack からの経路は不要になりましたが、アラームと Agent をつなぐ Lambda は引き続き使っています。流れはこうです。CloudWatch アラームの状態が変わると、EventBridge がそのイベントを拾って Lambda を起動します。Lambda は、そのアラームが自動調査の対象かをタグで判定します。対象なら、アカウント ID や直近のメトリクスを添えて、DevOps Agent の Webhook に調査依頼を投げます。この構成は AWS の公式ブログで紹介されているものと同じです。Lambda のコードは aws-samples のサンプルを元にしています。サンプルから変えたのは、対象アラームをタグで絞ること、復旧時は投げないこと、リソースがあるアカウントの ID を依頼に添えること、の 3 点です。
この Lambda で決めていることは 2 つです。
- 自動調査の対象アラームを絞ります。業務が止まる経路の critical アラームに限定しました
- アラームが復旧(OK 状態への遷移)したときは、Agent に投げません。復旧を調べても結論が出ないためです
別々のアラームは、別々の調査依頼として投げます。そのため、1 つの障害で critical アラームが 2 本鳴ると、Agent の調査も 2 回走ります。
障害原因の特定の早さを AWS DevOps Agent と競ってみた
検証環境で計画的に障害を起こし、Agent と私のどちらが早く正確に原因を特定できるかを競いました。ただし、何を壊すかは私にも知らされない形で行っています。壊し方はあらかじめ複数通り用意しておき、スクリプトがそこからランダムに 1 つ選んで実行します。原因を知っている人が復旧するリハーサルにならないようにするためです。
実施にあたっては、次の点に配慮しました。手順書と復旧スクリプトを用意し、同じ環境を使う他チームとは実施範囲を事前に合意しました。既存データには手を触れず、他チームの作業時間帯も避けています。
比較した障害は 2 回で、人間側は私 1 人です。その規模の話として読んでください。
先に前提を書きます。私はこのシステムに関わったので、構成をよく知っています。下の表では、私と Agent の原因特定がほぼ同時に見えます。このシステムに詳しくない人が同じ障害に当たれば、原因特定までもっと時間がかかったはずです。Agent は誰が呼んでも同じ速さで、同じ範囲を調べます。
障害A: 定期処理の停止
IAM ロールに Deny ポリシーが付与され、定期処理が失敗するようになった障害です。
| 時刻 (日本時間) | システム | 私 | DevOps Agent |
|---|---|---|---|
08:58:33 |
障害を注入 | ||
09:04:33 |
アラーム発火、Agent に依頼 | 調査を開始 | |
09:04:38 |
通知に気づき調査を開始 | ||
09:15:00 |
原因を特定 | ||
09:15:03 |
原因を特定 | ||
09:15:30 |
Deny ポリシーを削除して復旧 | 復旧はしない |
障害の注入は、スクリプトが IAM ロールに Deny ポリシーを付与する操作です。私が特定した原因は、ロールに付いた Deny ポリシーでした。Agent は CloudTrail の PutRolePolicy イベントから、同じ Deny ポリシーを名指しで特定しています。
障害B: コンテナの全タスク停止
コンテナのタスク数が 0 に設定され、サービスが全断した障害です。
| 時刻 (日本時間) | システム | 私 | DevOps Agent |
|---|---|---|---|
14:08:14 |
障害を注入 | ||
14:16:48 |
アラーム発火 | ||
14:16:50 |
Lambda が Agent に依頼 | 調査を開始 | |
14:16:53 |
通知に気づき調査を開始 | ||
14:22:30 |
原因を特定し、タスク数を戻す | ||
14:22:49 |
原因を特定し、再発防止策を提案 | ||
14:24:40 |
回復を確認 |
障害の注入は、スクリプトがコンテナのタスク数を 0 に設定する操作です。Lambda はアラーム発火の 2 秒後に Agent へ依頼を送っています。私が特定した原因は、タスク数が 0 になっていることでした。Agent は、タスク数が 0 になった時刻と、それが通常のデプロイではないことを特定しました。あわせて、冗長化の下限、複数 AZ への分散、オートスケール、変更へのガードといった構成側の再発防止策を提案しています。
結果をどう見るか
原因を特定した時刻は、私と DevOps Agent で 2 回ともほぼ同じでした。前提に書いたとおり、これは私がこのシステムに詳しいからです。詳しくないメンバーが呼んでも Agent の速さと範囲は変わりません。ここが属人化を減らすうえでの利点です。
一方で、復旧まで含めると人間のほうが早かったです。私は原因を特定した直後に、Deny ポリシーの削除やタスク数の復元を自分で行いました。Agent は原因候補と根拠を並べますが、戻す操作はしません。すぐ直せるという点では、まだ人間に強みがあります。
見ている範囲も違いました。障害B で私が見たのは、アラームの内容と、CDN とコンテナの状態でした。Agent は同じ時間に、メトリクス、タスクの状態、デプロイ定義、CloudTrail、過去 30 日分の操作履歴を突き合わせていました。同じ量を同じ時間で 1 人の人間が見るのは難しいです。そのうえで Agent は、「今なぜ落ちたか」だけでなく「なぜ落とせる構成なのか」まで踏み込み、構成側の再発防止策を挙げてきました。チームの改善計画と重なる内容でした。
今は互角に見えます。ただ、memory が溜まり、システムが複雑になり、LLM が賢くなっていけば、原因特定の早さと範囲では勝負にならなくなると思っています。LLM の進化の速さを見ていると、任せられる部分は早めに任せたほうがよさそうです。
試してわかったこと
Agent instructions を設定すると、調査の空振りが減る
Agent instructions は、Agent が毎回の調査で必ず読む指示文です。ここには、私たちの環境に固有の事実を書きます。Agent は AWS の一般的な知識で調査を進めるので、環境が一般的な前提から外れている部分では、見当違いの場所を調べて時間を使います。これが空振りです。
Agent instructions を設定しないまま動かすと、この空振りが調査のたびに繰り返されます。「私たちの環境はここが一般的な構成と違う」という点を書いておくと、Agent は最初から正しい場所を見に行きます。書く量は多くなくてよく、Agent が実際に空振りした箇所を 1 行ずつ足していくのが確実だと思います。
今回の検証で Agent instructions に書く必要があると分かったことが 2 つあります。
アラームがあるアカウントと、リソースがあるアカウントは違う。 私たちの構成では、アラームは監視アカウントに定義されています。リソースの実体は別のアカウントにあります。これを教えないと、Agent はアラームが鳴った監視アカウントの中を調べて、対象のリソースが見つからずに空振りします。
グローバルサービスの CloudTrail イベントは us-east-1 で探す。 IAM のようなグローバルサービスのイベントは、CloudTrail のイベント履歴では us-east-1 リージョンにしか出ません。Agent はアラームが鳴ったリージョンだけを探していました。「グローバルサービスの CloudTrail イベントは us-east-1 で探す」と 1 行足したところ、Deny ポリシーの付与イベントに到達できるようになりました。人間が気づいたことを書き留める場所があるから、次から当たるようになります。
Agent の出力について分かったことも 2 つあります。
確認できなかったことを、理由をつけて残す。 Agent は「この権限がなく、この情報を確定できなかった」と書いてきます。何があれば断定できたかまで書いてあるので、Agent に与える権限を見直す判断材料になります。
目立つが関係ないエラーを切り捨てる。 ログで目立っていたエラーを、障害前の期間と発生頻度を比べて「いつも出ているもの」と判断していました。人間が調査すれば真っ先に飛びつくものでした。
コスト
DevOps Agent の課金は、Agent が稼働した時間に対する秒単位の従量制です。単価は一律で、1 エージェント秒あたり 0.0083 USD です。1 時間あたりに換算すると約 29.88 USD になります(公式価格ページ、2026 年 9 月時点)。AWS Support のプランによっては、月ごとの利用クレジットが付きます。
単価が決まっているので、今回の 2 障害の費用は調査時間から計算できます。調査開始から原因特定までの時間で計算しました。
| 障害 | 調査時間 | 費用 |
|---|---|---|
| 障害A: 定期処理の停止 | 10 分 30 秒(630 秒) | 約 5.2 USD |
| 障害B: コンテナの全タスク停止 | 5 分 59 秒(359 秒) | 約 3.0 USD |
原因特定の後も Agent が調査を続けた分は、この計算に含んでいません。この 3〜5 USD は、原因特定まで 10 分前後の調査にかかった額です。同じ調査を人間が行った場合の時間と比べて、高いか安いかを判断してください。
調査はアラーム 1 本につき 1 回走ります。1 つの障害で critical アラームが 2 本鳴れば、調査も 2 回分の費用がかかります。「アラームが鳴ったら Agent が自動で調べる」の節で挙げた項目は、そのまま費用を決める項目でもあります。対象アラームを何本にするかで、調査の回数が決まります。復旧時も走らせるかで、回数が倍になるかが決まります。
今後
- Agent が memory に蓄積した知識で、2 回目以降の調査が速く正確になるかを、再発した障害で測りたいと思います
- GitHub 連携を使い、調査結果を踏まえた修正 PR を Agent に作らせたいと思います。PR のマージは人間が行います
おわりに
今までは、トラブルが起きたときに、複数人でオンライン会議をつなぎながら「ああでもない、こうでもない」と調べていました。そこに DevOps Agent を入れて、Agent の調査結果を見ながらみんなでトラブルシューティングをしていく。そういう使い方もできるのではと思いました。
Agent は、関係のある CloudTrail、Config、CloudWatch Logs などのログを瞬時に並列で集めて、整理して提示し、原因の候補まで出してくれます。人間が気づかないようなことに気づいて、教えてくれます。これを人がやるのは難しいです。一方で、直す判断と操作は人間が持ったままです。Agent が調べ、人間が決めて直す。この分担が、今の私たちにはちょうどよいと感じています。
8 月に自作した Slack 中継の経路は、1 か月で標準機能に置き換わりました。何を自前で持ち、何をサービスに任せるかは、定期的に見直す前提で作るのがよさそうです。