
1枚の巨大チップで、なぜ「層ごと」に考えるのか

画像: huggingface.co より
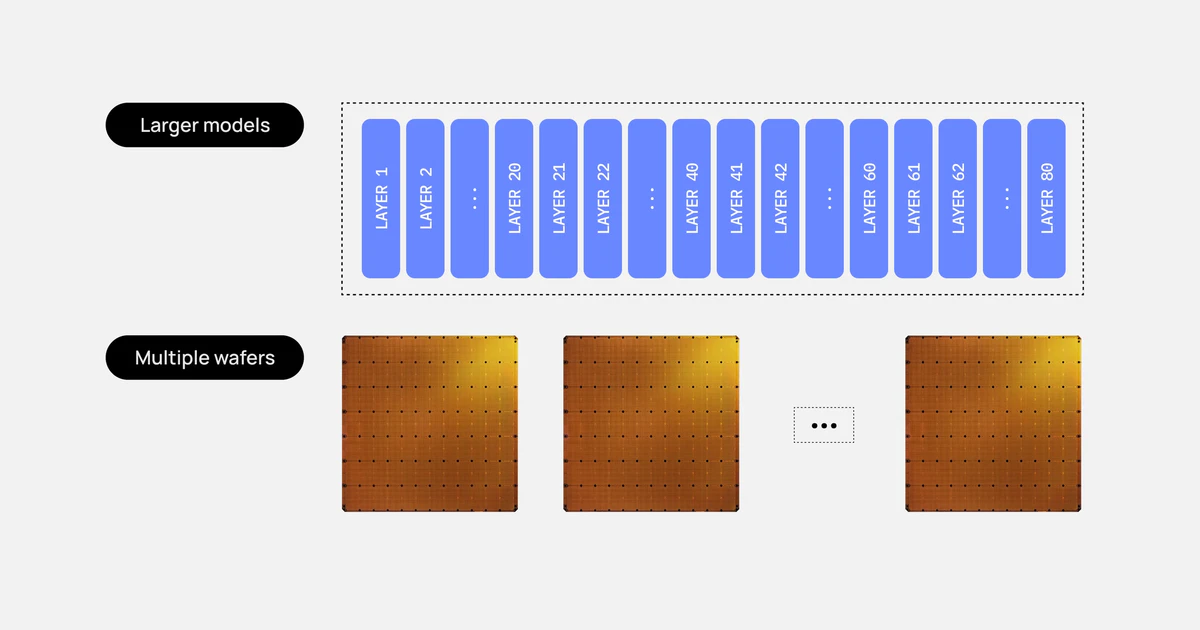
画像: www.cerebras.ai より
Cerebras の話を初めて見ると、まず感覚が追いつきません。普通は GPU を複数枚つないで巨大モデルを動かしますが、ここでは「1 枚のウェハ」を 1 つの計算単位として扱い、その上にモデルを並べます。しかも単に速いだけではなく、3 兆パラメータ級のモデルを前提に、何枚必要かを層の構成から逆算しているのが特徴です。
この発想の入口は、モデルの重みがとにかく大きいという事実です。Cerebras のブログでは、WSE-3T 1 枚のオンチップメモリは 44GB とされ、3T パラメータを 4 ビットで持つと重みだけで 1.5TB になります。ここで重要なのは、全体を一度に載せるのではなく、層あたりのサイズへ割り戻すことです。巨大な塊を、チップが受け持てる粒度へ落とし込むわけです。
ここで素直に「重みを全部どこかに置いて、必要なときに読む」で済めば楽ですが、推論ではそう単純ではありません。毎回読み出しに行くと待ち時間が膨らみますし、特に長いコンテキストを扱うと状態も増えます。だから Cerebras は、モデルを層単位で切り、層そのものをできるだけチップ上に置いたまま動かす方向へ寄せています。これが、枚数の議論を先に始める理由です。
同じ問題意識は、MoE や長文処理を扱う他社の解説でも見えます。Modal の記事では、推論のボトルネックは「重みを何度も使うこと」と「リクエストごとの状態をどう持つか」だと説明されます。Cerebras の場合は、その整理をさらに物理配置まで押し進めている。層の種類ごとに必要な余白が変わるので、まず層を数え、次に枚数を決める順番になるのです。
44GBに収めるための手計算が先に来る
今回の説明で使われている例では、3T パラメータを 4 ビットで持つ前提が置かれています。単純計算なら 3 兆 × 4 ビットで 12 兆ビット、つまり 1.5TB です。これを 93 層で割ると、1 層あたりはおよそ 16GB。ここまでで、ようやく「1 層を 44GB のウェハに載せられるのか」が見えてきます。
ただし、実際の答えは単純な割り算では終わりません。Cerebras の説明では、層が dense か linear-attention かで扱いが変わります。dense 層は KV cache を別途要し、linear-attention 層は固定サイズの状態で済むため、同じ 16GB の層でも必要な余白が違う。つまり、同じ 1 層でも「そのまま 1 枚に載るか」「2 層まとめて載るか」が分かれるのです。
この差が、枚数の逆算を面白くしています。もし全層を同じものとして扱えば、必要枚数はかなり大ざっぱになります。しかし実際には、重みのサイズだけでなく、各層が抱える状態量まで見ないといけない。推論で本当に効くのは、重みの総量よりも、今動いているリクエストの状態をどれだけ保持できるかだからです。ここが GPU の単純なメモリ計算と違うところです。
Cerebras のブログでは、層ごとの余白を踏まえて、ある種類の層は 1 枚に 1 層、別の種類は 1 枚に 2 層ずつ収めるという考え方を採っています。読んでいる側としては、まだ「なぜその配分で最適なのか」が気になりますが、少なくともここで示されているのは、ウェハ枚数が「総パラメータ ÷ 総容量」ではなく、「層の種類 × その層の状態量」で決まるということです。次の疑問は自然に浮かびます。では、その配分で本当に 59 枚に収まるのか。
パイプラインに流すと、チップは遊ばない
枚数が決まっても、まだ終わりではありません。ウェハ同士をどうつなぐかで、実効性能は大きく変わります。Cerebras はモデルをパイプラインとして実行し、あるウェハが前の層を計算し、その出力の活性値だけを次へ渡します。重みそのものを毎回動かすのではなく、通るのは中間結果だけです。ここが「チップに置いたまま」という思想の実装部分です。
この設計は、1 リクエストだけなら理解しやすい反面、待ち行列が気になります。1 枚目が終わるまで 2 枚目が待つなら、並べた枚数が無駄になるのではないか。Cerebras はそこを、複数リクエストを同時に流すことで解消します。あるステージが A を処理している間に、別のステージが B や C を処理する。単発処理ではなく、流れ作業にするわけです。
さらに、同時にどれだけ流せるかは KV cache の余りで決まります。Cerebras の記事では、1 つの dense 層用ウェハに残る空き容量から、1 リクエスト分の cache サイズを見積もり、そこから同時処理できるリクエスト数を算出しています。つまり、枚数は単なる必要量ではなく、同時接続数の上限を決める装置でもある。ここがサーバ台数の話とかなり違います。
日本の現場で見ると、この考え方はかなり実務的です。RAG、コード生成、社内文書検索のどれでも、単発の最短応答だけでなく、何人同時に捌けるかが導入可否を左右します。しかも、リクエストごとのコンテキスト長が伸びるほど KV cache が効いてくる。Cerebras の 59 枚という数字は、単に「載るかどうか」ではなく、「載せた後に何本の問い合わせを同時に流せるか」を含んだ数字として読んだほうが自然です。
59枚という数字が示すもの
ここまでで見えてきたのは、Cerebras が層の種類からウェハ枚数を逆算するのは、単なる言い換えではないということです。重みの総量を割るだけでは足りず、dense 層と linear-attention 層で必要な状態量が異なるため、1 枚あたりの役割が変わります。だから、まず層を細かく分類し、そこから配置を決める。巨大モデルを扱うための設計が、ほとんど配線図のような粒度まで降りてくるわけです。
ただ、ここまでの話だけでは、59 枚に至る内訳はまだ見えていません。Cerebras の公式ブログは、3T 級モデル、93 層、44GB という骨格に加えて、その内訳と前提条件まで書いています。そこを詰めるには、次に「どの種類の層が何層あり、それぞれ 1 枚に何層ずつ載るのか」という内訳が必要になります。
その内訳が分かると、話はもう少し面白くなります。59 枚という数字は偶然ではなく、層の種類ごとのメモリ余白、KV cache の取り方、そして並列リクエストの上限まで含めた結果だからです。なぜ 60 でも 58 でもなく 59 なのか。その答えは、もう一段だけ深いところにあります。
👉 続き(核心はここから)は PaPoo で読めます: https://papoo.work/doc/8aacb9086e56cfeb