
はじめに
スマホのカメラを手牌に向けるだけで、点数計算まで進めるWebアプリ「mjtensu」を個人で作っています。牌の認識はサーバに送らず、すべてブラウザの中で動かしているので、iPhoneでも軽く動くモデルが必要になります。
この記事は、その認識部分のうち、牌の種類を見分ける分類器の話です。分類器は2つあり、1つはグレースケールの画像から34種類の牌を見分ける「牌種分類器」、もう1つはカラー画像から赤5かどうかだけを判定する「赤5分類器」です。どちらも同じ種類のモデル(回転同変CNN)から出発し、同じような手順で軽くしていったのですが、落ち着いた形はずいぶん違うものになりました。
この記事では、2つの分類器をそれぞれどう軽くしたかと、なぜ違う形になったと考えているかを書きます。検出器も含めると調べたことは40件を超えたので、全体は実験の木で見せ、本文では採用までの道筋だけを追います。
目次
- 牌を認識する流れと、2つの分類器の役割
- 回転同変CNNと、それを軽くするための道具
- 試した実験の全体像
- 牌種分類器は、空間を残してチャネルで補った
- 赤5分類器は、チャネルの混ぜ合わせを残して空間を潰した
- 2つの分類器を並べてみる
- 今の構成と、この先
1. 牌を認識する流れと、2つの分類器の役割
カメラ画像から点数計算に使える手牌になるまでは、次の流れで処理しています。
牌の位置を見つける検出器と、種類を見分ける分類器を分けているのは、検出器の学習に種類のラベルがない画像も使えるのと、認識を間違えたときに、位置と種類のどちらで間違えたのかを別々に調べられるからです。検出器はNanoDetという軽量な検出モデルで、こちらは主に、自分で撮った実写とBlenderで作った合成データを足すことで精度を上げました。モデルの構造はほとんど変えていないので、この記事では扱いません。
赤5を牌種分類器と別にしているのは、赤5の判定には色が要るからです。牌種分類器はグレースケールで形だけを見ているので、赤5も普通の5として扱い、5と判定された牌だけをカラーのまま赤5分類器に回しています。
2. 回転同変CNNと、それを軽くするための道具
切り出した牌は、上下左右の向きがそろっていません。普通のCNNでも、回転させた画像で学習すればある程度は対応できますが、mjtensuでは最初から回転同変CNNを使っています。回転同変CNNは、画像を回したときに同じ模様を同じ重みで扱えるように作られたモデルで、ここでは45°刻みの8方向(C8)に対応したものを使っています。8方向の間の角度は、回転させた画像での学習で埋めています。
精度には不満がなかった一方で、速さには問題がありました。回転同変CNNは内部で8方向分の特徴を持ち続けるので、ブラウザで動かす形式(ONNX)に変換すると、その8方向分がそのままチャネルとして展開されます。そのため、パラメータ数から想像するよりも計算が重くなります。分類器は検出された牌の枚数だけ動くので、17枚ほ
どの牌(和了形14枚とドラ表示牌3枚など)を毎回処理するiPhoneでは、この重さがそのまま効いてきました。
軽くするための道具として、この記事で何度も出てくるのが、畳み込みの分解(以下、DW/PW化)です。最終的にできあがった2つの分類器の構造を、先に図で見せておきます。
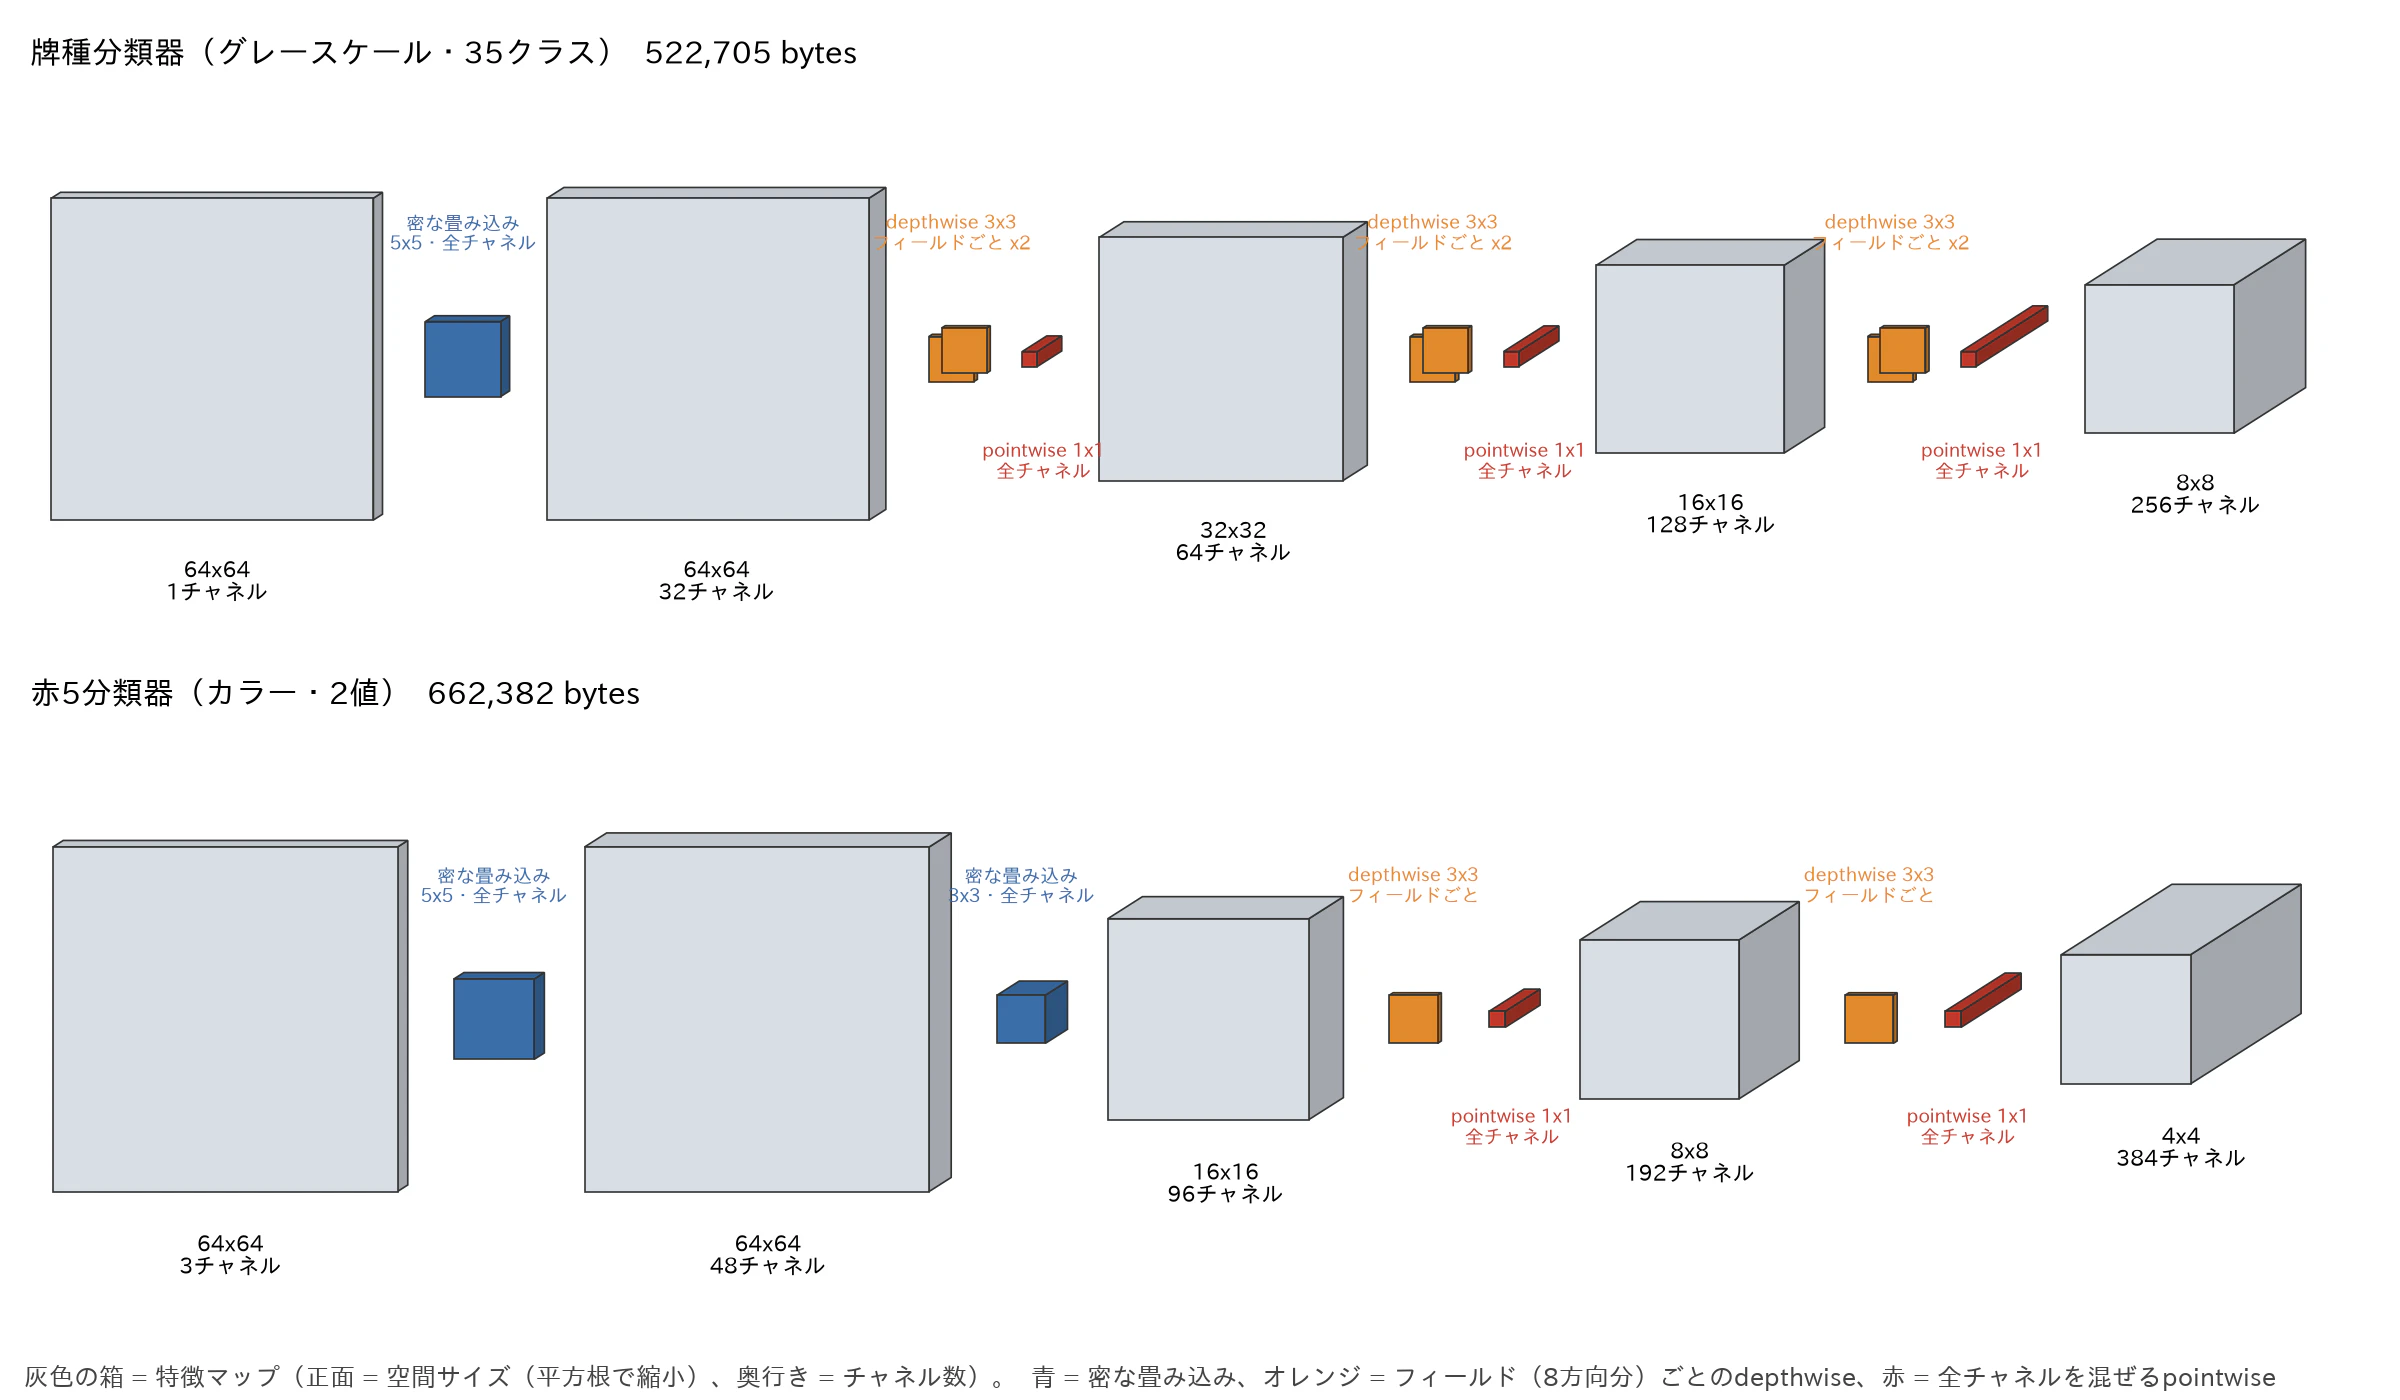
灰色の箱は各段の特徴マップで、正面の大きさが空間のサイズ、奥行きがチャネル数を表しています(空間のサイズは、小さい箱が見えなくならないよう平方根で縮めています)。箱と箱の間にあるのが、畳み込みのカーネルの形です。
普通の畳み込みは、青い立方体のように、空間の3×3(1段目だけ5×5)と入力の全チャネルを一度に見ます。この記事では、これを「密な畳み込み」と呼びます。DW/PW化は、この立方体を、空間の3×3をまとまりごとに別々に見るオレンジの薄い板(depthwise)と、空間は1×1だけで全チャネルを混ぜる赤い棒(pointwise)の2つに置き換えることです。普通のCNNのdepthwiseは1チャネルずつ処理しますが、回転同変CNNでは8方向分の特徴がひとまとまりになっているので、そのまとまり(以下フィールド)を単位にして分けています。空間を見る役とチャネルを混ぜる役を分けるぶん、計算もパラメータも大きく減りますが、そのかわり、空間とフィールドをまたいだ関係を同時に見ることはできなくなります。オレンジの板に付いた「×2」は、1フィールドから2フィールド分の出力を作る設定で、分解で減った表現力を少し取り戻すためのものです。
図の数字は、空間のサイズと出力のチャネル数です。回転同変CNNでは8方向分をひとまとまりとして数えるので、この記事で「幅 4/8/16/32」と書いたときは、1〜4段目のフィールドの数を指します。実際のチャネル数はその8倍で、図の 32/64/128/256 ch がそれにあたります。
上下の分類器で、青い立方体が残っている段と、箱の大きさが小さくなっていく速さが違っているのが分かると思います。この違いがどこから来たのかが、4章以降の本題です。
3. 試した実験の全体像
2つの分類器で試した実験を、木の形にまとめると次のようになります。太線が採用までの道筋で、本文ではこの線だけを追います。点線は、採用はしなかったものの、次の判断に使った知見です。
牌種分類器のほうは、一度普通のCNNを試してから、回転同変CNNに戻ってきています。この回り道で分かったことが、そのあとの削り方を決めました。
木だけでは、それぞれの構成がどのくらいの性能だったのかが分からないので、牌種分類器で試した構成を1枚の図に並べておきます。横軸がiPhoneでの1枚あたりの推論時間、縦軸が、斜めから写したときの歪みや切り出し位置のずれなど、学習では見せていない15通りの条件のうち、一番成績の悪かった条件での正解率(以下、最悪条件の正解率)で、円の直径がモデルのファイルサイズです。左上にあって円が小さいほど、速く、崩れにくく、ダウンロードも軽いモデルということになります。
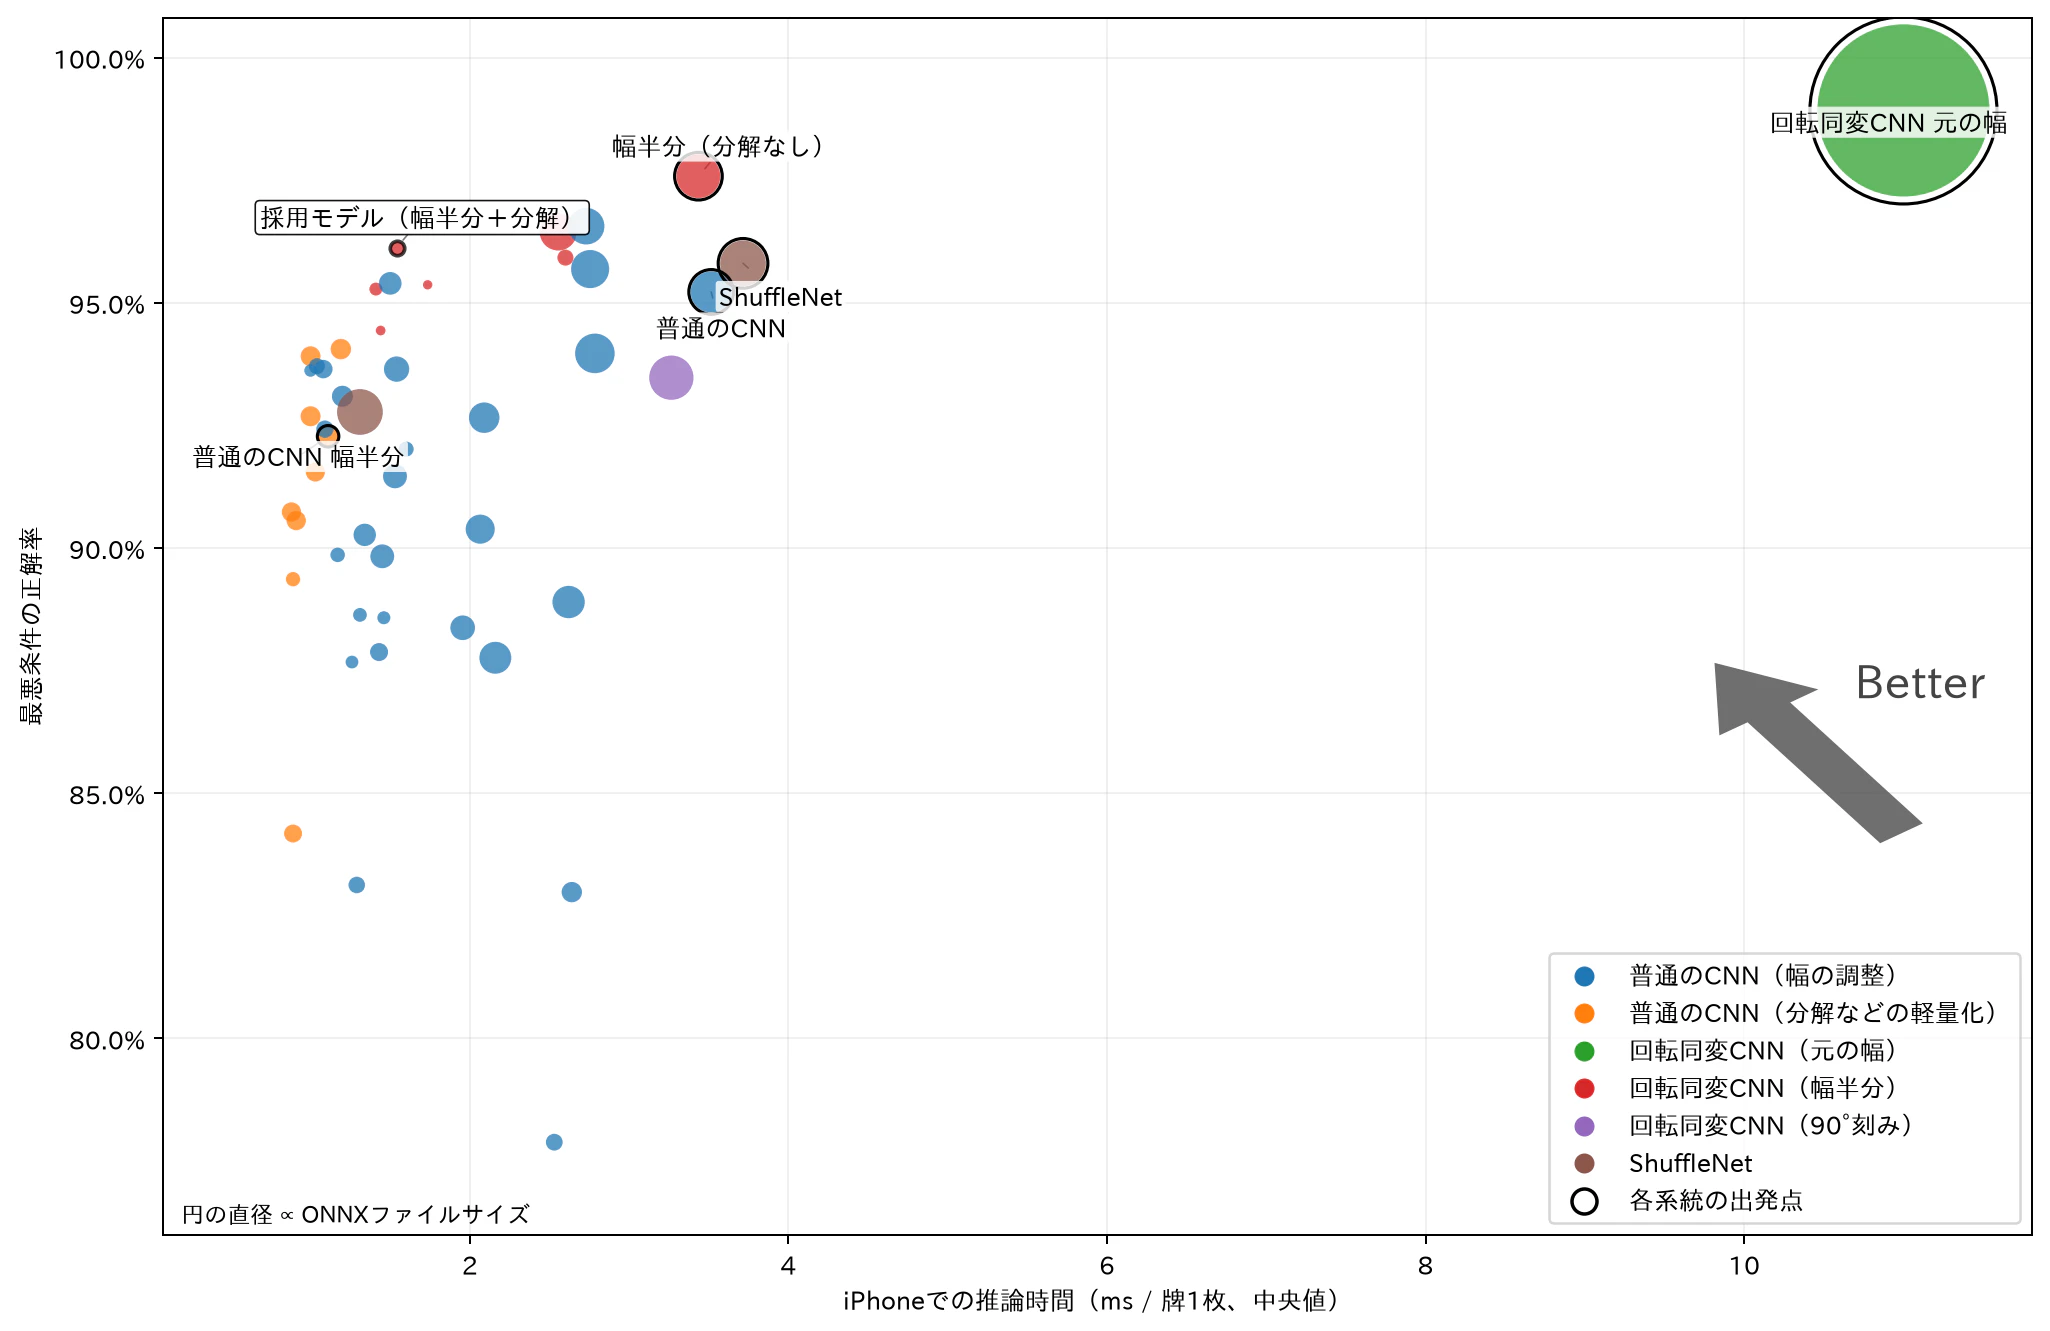
青とオレンジが普通のCNN、茶色がShuffleNet、赤が幅を半分にした回転同変CNNで、黒い輪の付いた点が、それぞれの系統で出発点にした構成です。普通のCNNは、軽く速くしようとすると最悪条件の正解率が大きくばらつき、回転同変CNNと同じ高さに届くのは、幅を広げて推論時間が2.7ms前後、ファイルサイズが1.3MB前後まで重くした構成だけでした。一方、回転同変CNNは、幅を半分にした時点で上のほうに出ていて、そこから分解して軽くしても、大きくは高さを落とさずに、左の小さい円まで寄せることができました。枠付きのラベルを付けた「採用モデル」が、今アプリに載せているモデルです1。
4. 牌種分類器は、空間を残してチャネルで補った
普通のCNNでは、崩れにくさが足りなかった
回転同変CNNが遅かったので、まずは普通のCNNで軽くする方向を試しました。速くはなるのですが、3章の図のとおり、崩れにくさを回転同変CNN並みにしようとすると、幅を広げて遅く大きなモデルにするしかありませんでした。ブラウザで動かすアプリでは、ファイルの大きさがそのまま初回のダウンロード時間になるので、これは避けたいところです。
回転は構造に任せることにした
そこで考えたのが、回転への強さを重みに覚えさせるのをやめる、ということでした。
畳み込みのフィルタ(カーネル)は、1枚1枚が何かの模様に反応するように学習されます。フィルタの枚数には限りがあるので、そのうち何枚を何に使うかが、見分けられる模様の数に直結します。
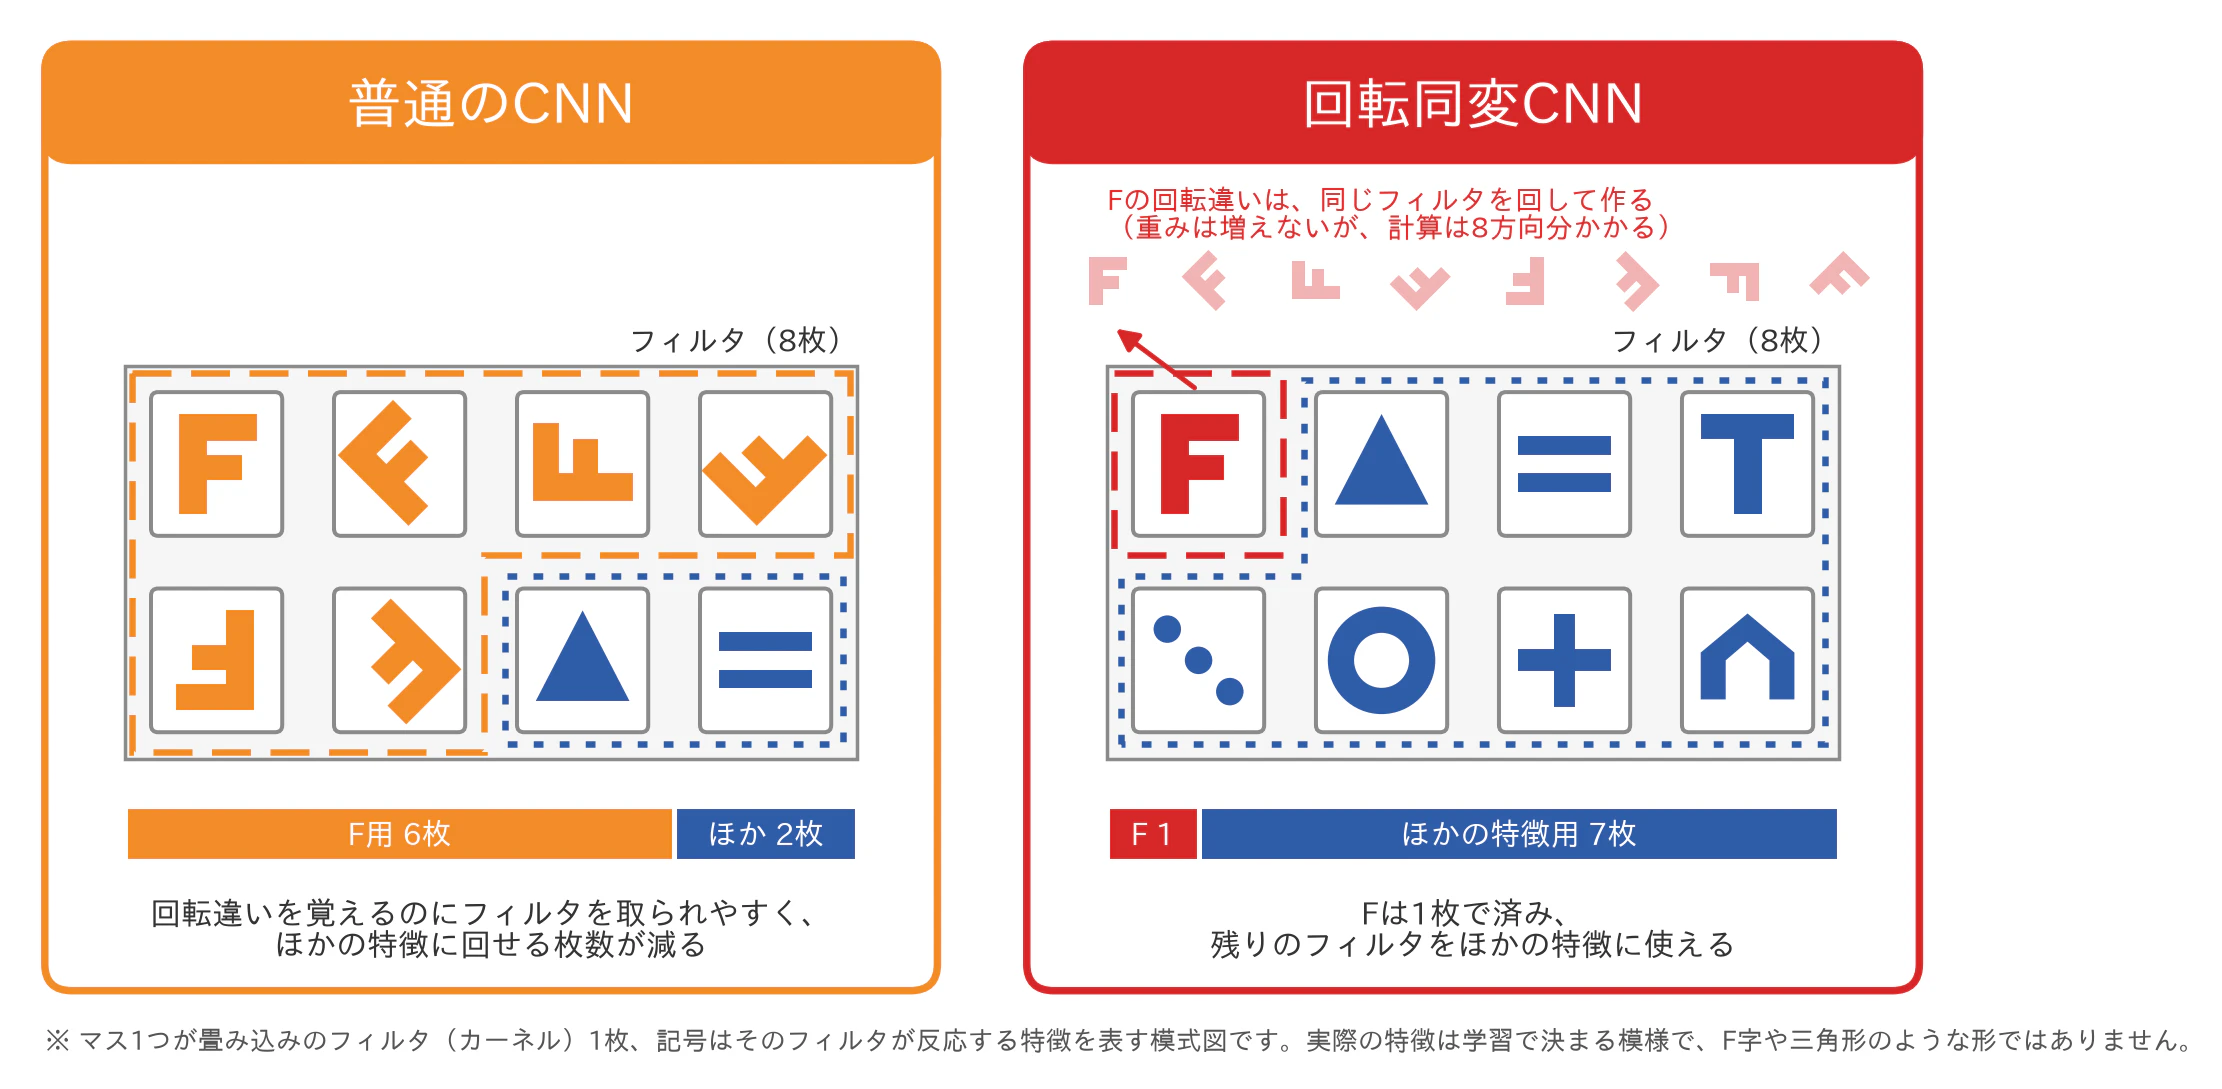
普通のCNNは、回転した牌の見え方をすべて学習データから覚えるので、学習の結果として、似た模様の回転違いのフィルタを何枚も持ちやすくなります。回転同変CNNは、1枚のフィルタを8方向に回して使い回すので、回転違いのためにフィルタを増やす必要がなく、残りを牌の模様の見分けに使えます。ただし、回した8方向分の計算はかかるので、2章で書いたとおり、軽くなるのは重みの数で、計算量ではありません。
ただ、普通のCNNを試したのは無駄ではなく、回転同変CNNに持ち帰れる知見が2つ残りました。
- 早く縮小すると萬子が崩れる:MobileNetやShuffleNetのように早めに解像度を落とす構造では、斜めから写した萬子を取り違え、縮小を遅らせるほど精度が戻りました。
- 削ってもチャネルで戻せる:畳み込みを分解すると精度は落ちますが、そのあとでチャネル数を増やすと戻る傾向がありました2。
回転同変のまま幅を半分にする
回転同変CNNに戻って、まず各段の幅を半分(8/16/32/64 → 4/8/16/32)にしました。以下、これをC8 narrowと呼びます。比べるために、90°刻みの4方向に対応した回転同変CNN(C4)も同じチャネル数で用意しました。
| 指標 | C8(元の幅) | C8 narrow | C4 |
|---|---|---|---|
| 最悪条件の正解率 | 0.9892 | 0.9758 | 0.9347 |
| iPhoneでの推論時間 | 11.0 ms | 3.435 ms | 3.265 ms |
| ファイルサイズ | 6.26 MB | 1.59 MB | 1.61 MB |
C8 narrowは、崩れにくさをほとんど落とさずに、推論時間を約1/3、ファイルを約1/4にできました3。C4は速さがほぼ同じで、最悪条件の正解率が4ポイントほど低かったので、8方向のまま幅を削るほうを選びました。
分解すると少しずつ崩れ、チャネルで取り戻した
C8 narrowからさらに軽くした道のりを、図にまとめます。
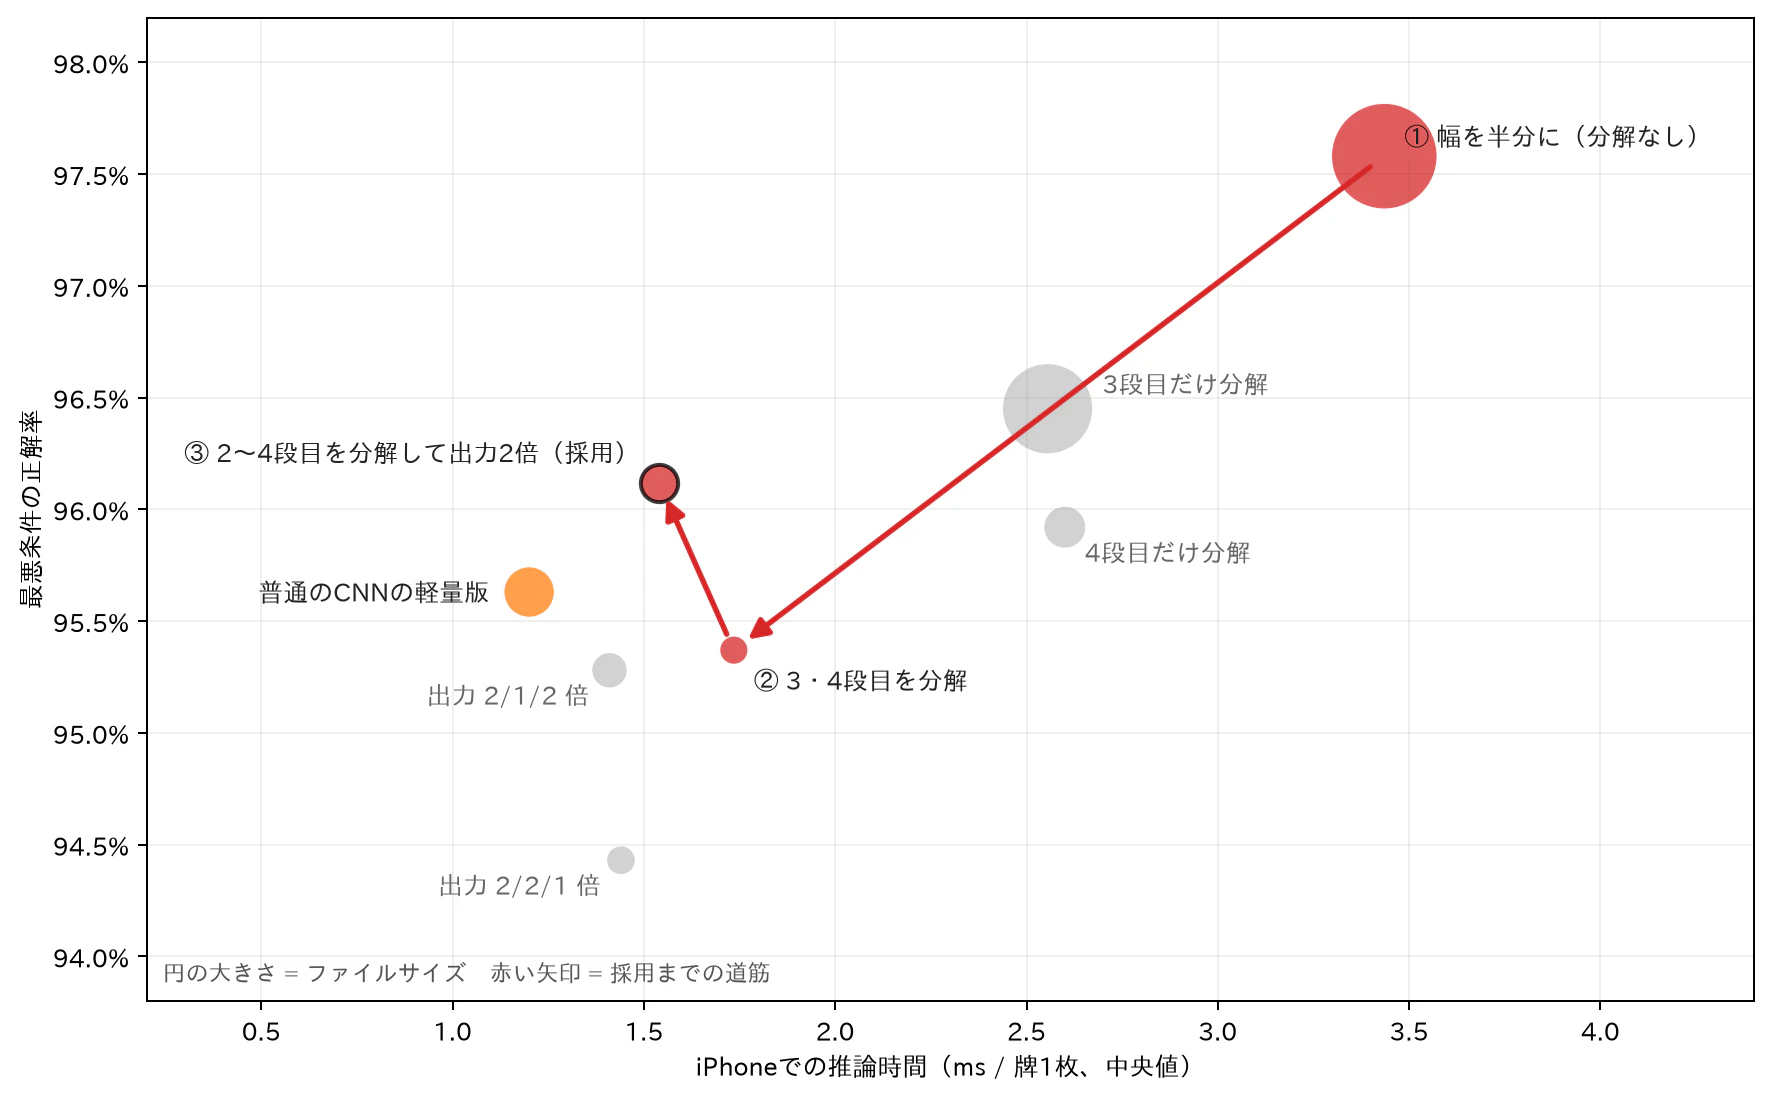
後段の3段目と4段目を分解すると(②)、推論時間はほぼ半分になった一方で、最悪条件の正解率は2ポイントほど下がりました。どちらか片方だけ分解しても、少しずつ下がります。
普通のCNNで見た「削ってもチャネルで戻せる」を当てはめて、3段目と4段目のdepthwiseの出力を2倍(2章の図の「×2」)にすると、崩れにくさはかなり戻りました。ただ、その分だけ遅くなり、推論時間は2ms前後まで延びました。
この結果を見て、計算の配分を変えることにしました。2段目は3・4段目より解像度が大きいので、計算が重い段です。ここを分解して浮いた計算を、後段のチャネル数に回せば、崩れにくさを保ったまま速くできるのではないかと考えました。
まず2段目だけを分解して、depthwiseの出力を1・2・4倍で比べました。速さと崩れにくさの釣り合いが一番よかったのは2倍だったので、2段目は2倍に固定しました。そのうえで3・4段目の倍率を振ると、2/2/2倍(③)で崩れにくさが戻り、推論時間はさらに短くなりました。
図の数値
| 構成 | 最悪条件の正解率 | iPhoneでの推論時間 | ファイルサイズ |
|---|---|---|---|
| ① 分解なし(C8 narrow) | 0.9758 | 3.435 ms | 1.59 MB |
| 3段目だけ分解 | 0.9645 | 2.555 ms | 1.35 MB |
| 4段目だけ分解 | 0.9592 | 2.600 ms | 0.58 MB |
| ② 3段目と4段目を分解 | 0.9537 | 1.735 ms | 0.34 MB |
| ③ 2〜4段目を分解、出力 2/2/2 倍(採用) | 0.9612 | 1.54 ms | 0.52 MB |
| 2〜4段目を分解、出力 2/1/2 倍 | 0.9528 | 1.41 ms | 0.47 MB |
| 2〜4段目を分解、出力 2/2/1 倍 | 0.9443 | 1.44 ms | 0.35 MB |
| 普通のCNNの軽量版 | 0.9563 | 1.20 ms | 0.72 MB |
決め手は「普通のCNNと同じくらいの速さ」
速さの目安にしたのは、普通のCNNで軽く作ったときの速さ(1.2ms前後)です。回転同変CNNでも、ここから大きく離れない1.5ms前後の範囲に収めたかったので、その中で一番崩れにくかった③を採用しました4。
採用モデルは1.54msで、ファイルは0.52MBと、同じくらいの速さの普通のCNN(0.72MB)より小さくなりました。空間の解像度は最後の8×8まで残し、フィールドをまたぐ混ぜ合わせを分解で削り、その分をチャネル数で補う。これが牌種分類器での削り方です。
傾けても崩れにくくなったのか
最後に、同じくらいの速さの普通のCNN(幅を半分にして後段だけ分解したもの)と、2つの評価で比べました。
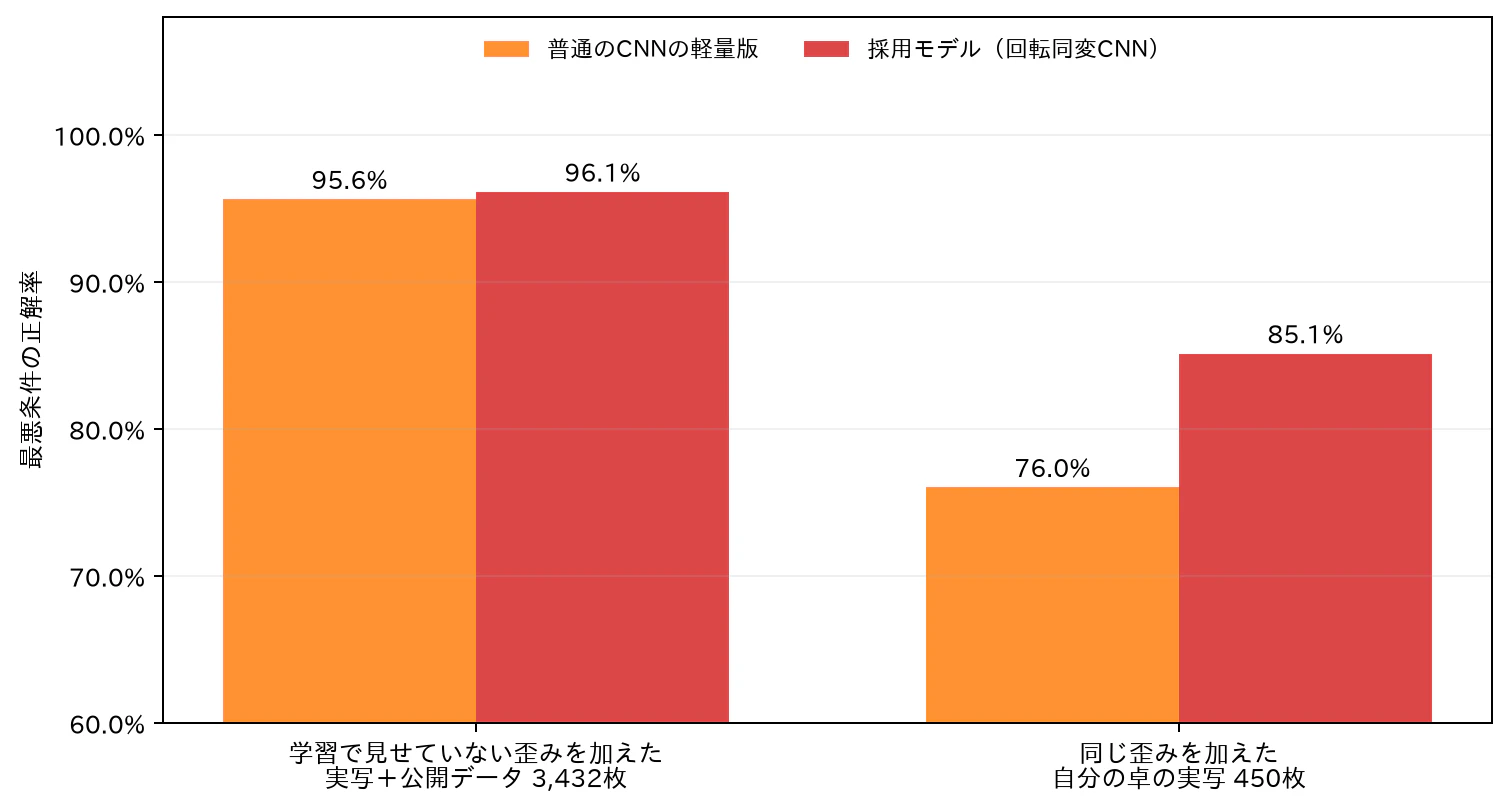
学習では回転しか見せていないのに、圧縮・透視・切り直し・ずらしを加えた評価(左)で、どちらも96%前後を保てていました。学習で見せていない幾何的な歪みへの堅牢性は、どちらも十分にあると考えています。
差が出たのは、同じ歪みを自分の卓の実写にかけたとき(右)でした。照明や影、牌の厚み、切り出しのずれといった実写の要素に歪みが重なると、差が開くようです。ただ、この評価は450枚しかないので、差の大きさはまだ言い切れません5。
5. 赤5分類器は、チャネルの混ぜ合わせを残して空間を潰した
赤5分類器も、牌種分類器と同じ回転同変CNNで作っています。赤5かどうかは主に色で決まるので、普通のCNNでも足りるかもしれません。ただ、赤い部分は牌の種類ごとに形も位置も違い、牌の向きによって画面上のどこにでも来ます。普通のCNNが回転にどこまで対応できるかは、学習してみないと分かりません。そこで、回転への対応は牌種分類器で実績のある構造に任せ、それ以外の条件の検討に集中することにしました。
一番重いのは赤5分類器だった
赤5分類器は、カラーの64×64画像から、赤5かどうかの2通りに分ける回転同変CNNです。以前のモデルはファイルが約6.3MBあり、ブラウザで読み込むモデルの中で一番大きく、牌種分類器の10倍以上でした。
評価では、約11.6万枚の牌画像で、赤5と普通の5を取り違えた件数を数えています。以下、これを「誤り件数」と呼びます6。
ここから採用までの道のりを、先に図で見せておきます。
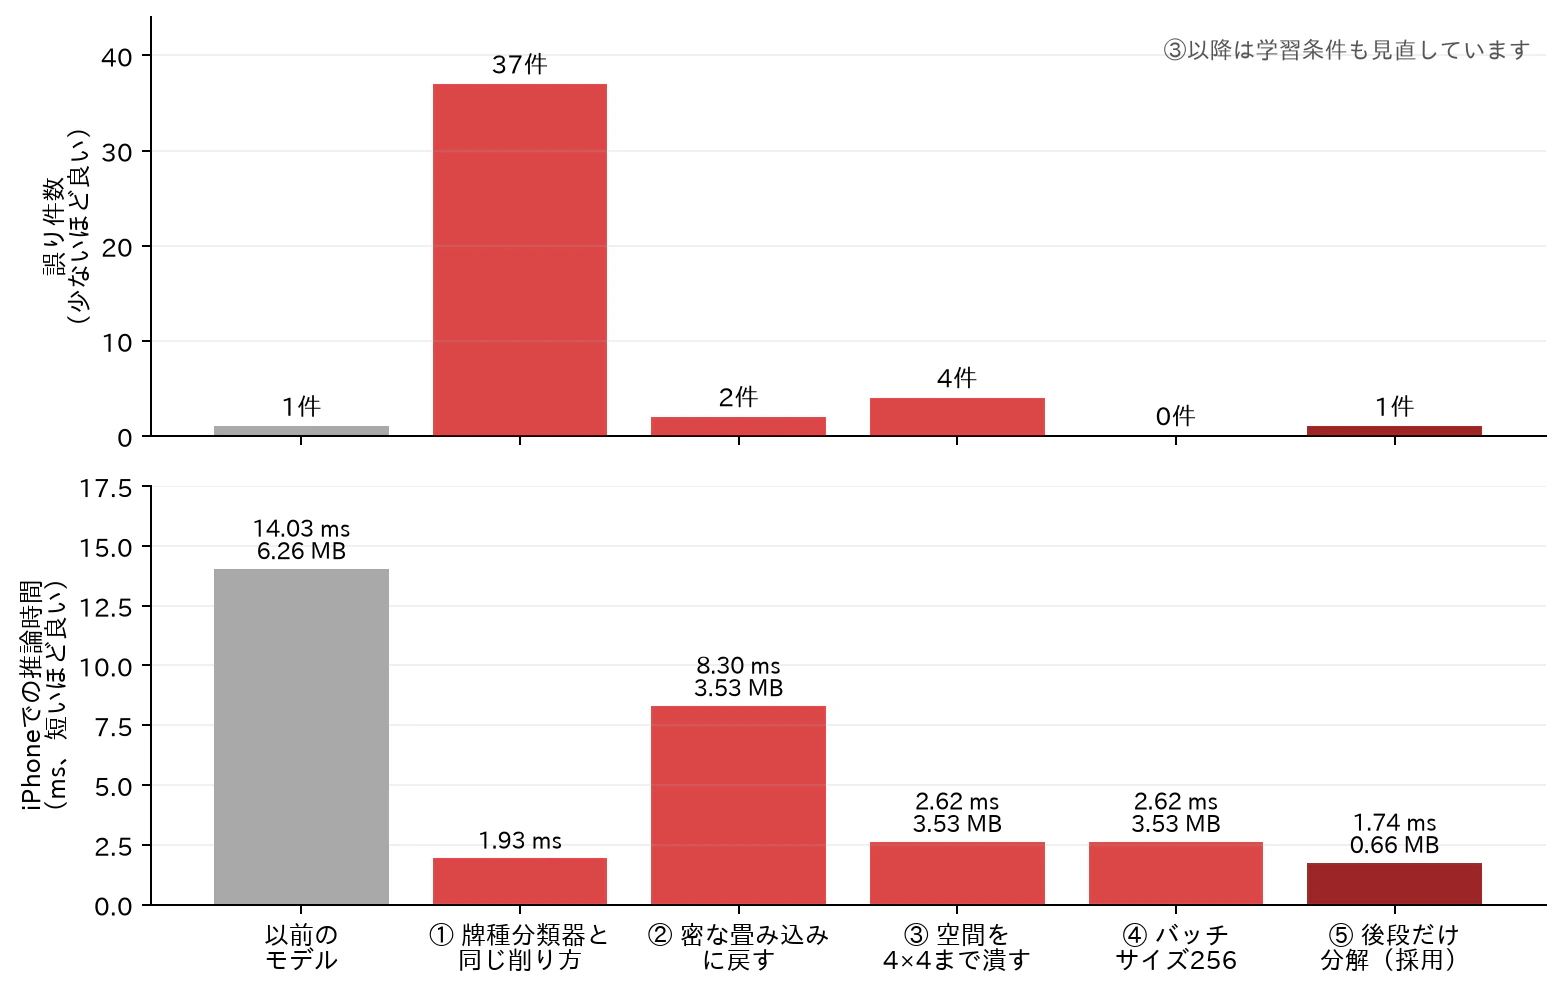
牌種分類器と同じ削り方では、誤りが37件に増えた
最初は、牌種分類器でうまくいった削り方をそのまま当てました(①)。ファイルは小さく、推論も速くなりましたが、誤り件数は1件から37件に増えました。
幅ではなく、分解が原因だった
原因が「幅が足りない」のか「分解したこと」なのかを分けるため、両方を振って比べました。
分解したまま幅を広げると、誤りは8件まで減りましたが、それ以上は減りませんでした。一方、同じ幅のまま密な畳み込みに戻すと、2件になりました(②)。効いていたのは、幅より分解のほうでした。
幅と畳み込みの形を振った結果
| 構成 | 誤り件数 | ファイルサイズ | iPhoneでの推論時間 |
|---|---|---|---|
| 分解あり 幅4/8/16/32(①) | 37 | — | 1.925 ms |
| 分解あり 幅6/12/24/48 | 8 | 1.022 MB | 3.430 ms |
| 分解あり 幅8/16/32/64 | 23 | 1.703 MB | 5.465 ms |
| 密な畳み込み 幅6/12/24/48(②) | 2 | 3.527 MB | 8.300 ms |
| 密な畳み込み 幅8/16/32/64 | 1 | 6.257 MB | 14.030 ms |
失っていたのは、色の手がかりだった
分解したモデルの誤りは、すべて「赤5を普通の5と判定した」ものでした。
赤5かどうかは、R・G・Bのどれか1つを見ても分かりません。
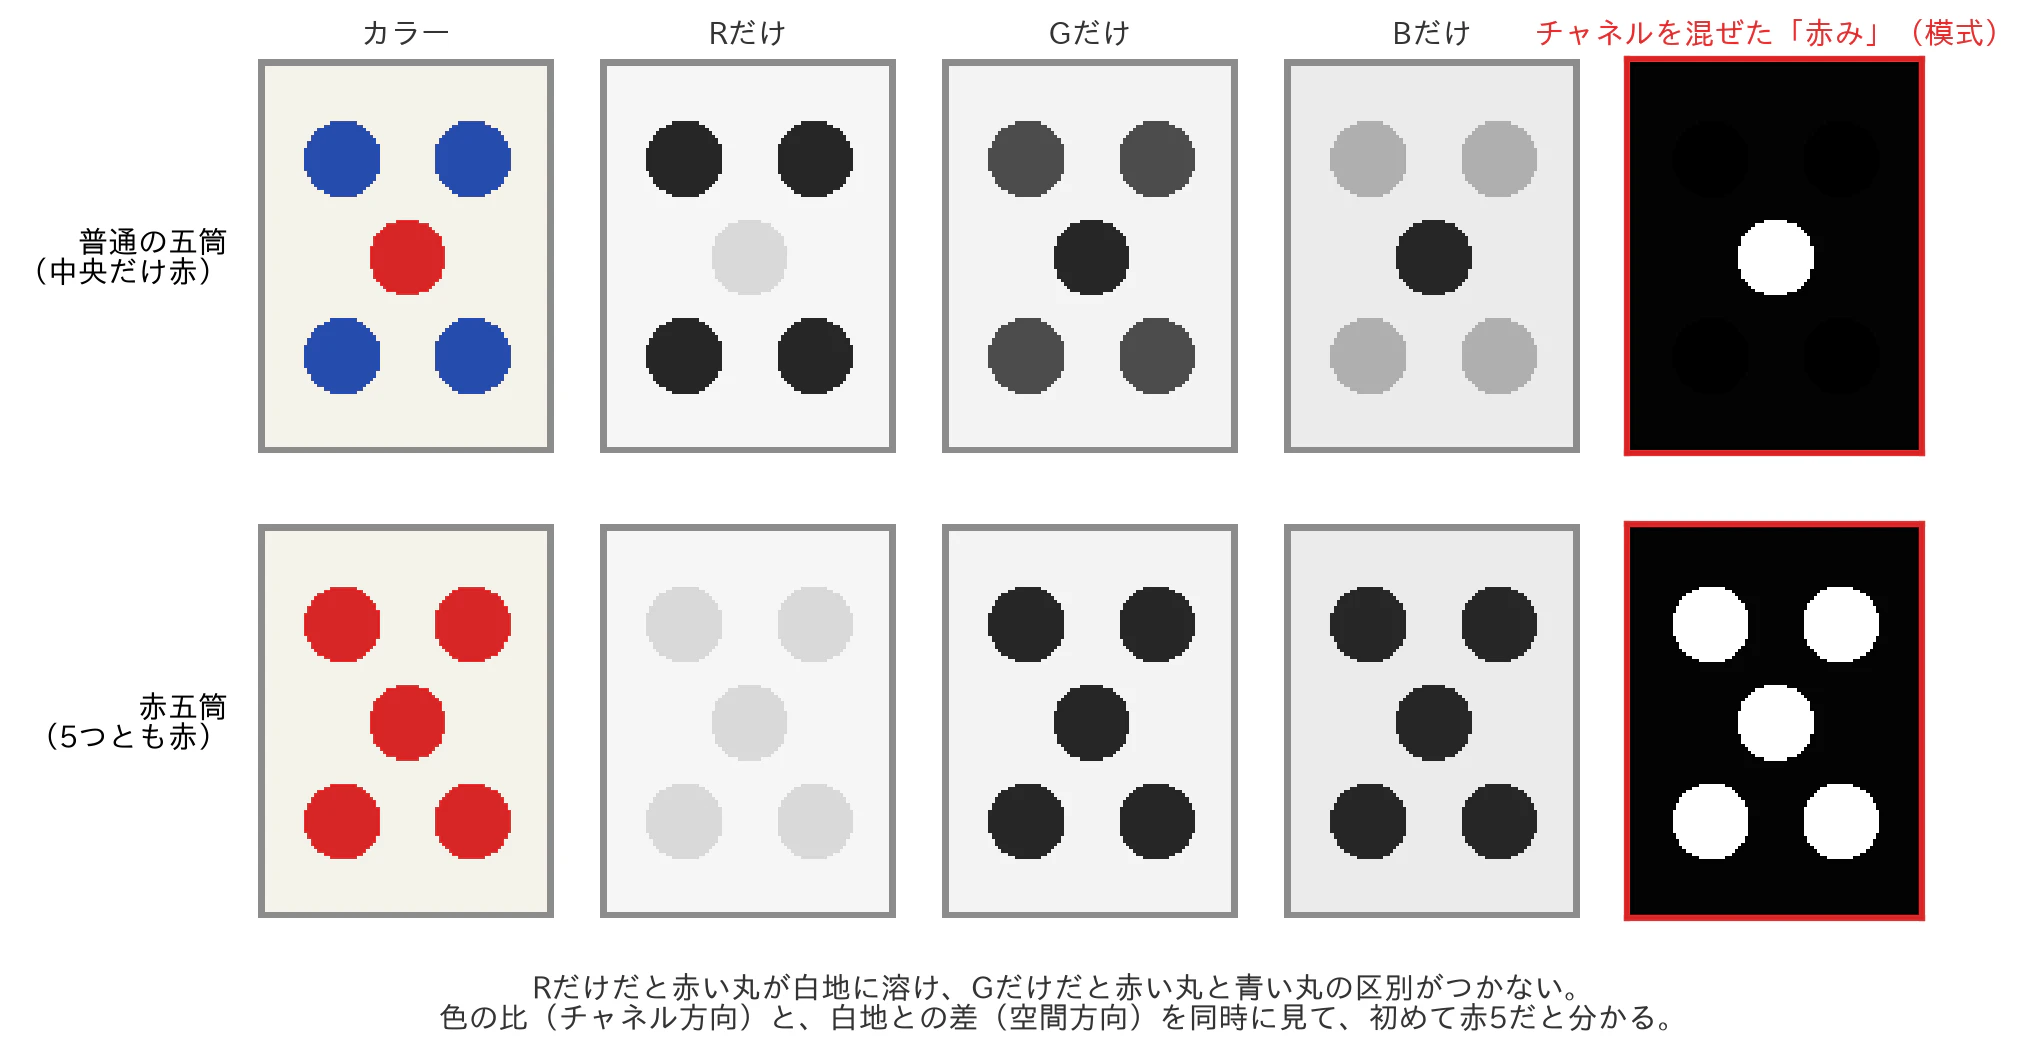
Rだけを見ると、赤い丸も白地も明るいので、赤い丸が白地に溶けてしまいます。Gだけを見ると、赤い丸も青い丸も同じように暗く、区別がつきません。赤5だと分かるのは、RがG・Bに比べて強いという色の比(チャネル方向)と、丸と白地の差(空間方向)を、同時に見たときです。
分解した畳み込みは、空間方向はフィールドごとに見て、チャネル方向は1×1で混ぜる、というように2つを別々に処理します。両方を同時に見る密な畳み込みをやめたことで、この手がかりを失ったのではないか、と考えました。
確かめるために、赤みの成分(YCbCrのCr)を手で計算して、入力に足してみました。すると赤5の見逃しは0件になり、仮説と合う結果になりました。ただ、今度は普通の5を赤5と判定する誤りが出てきたので、この方向はやめて、ネットワークの中で空間とチャネルを同時に混ぜるほうを選びました。
空間は4×4まで潰せた
密な畳み込みは精度が出ますが、iPhoneで8ms以上かかります。ただ、見分けたいのは色です。牌種分類器のように細かい形を読む必要はないはずなので、チャネルを混ぜる計算が増える分は、空間を削って帳尻を合わせることにしました。混ぜ合わせは密なまま残し、各段の縮小を強めて、空間の計算を減らします(③)。
最後の特徴マップを4×4まで潰すと、推論時間は2.62msまで縮み、誤り件数はむしろ減りました。牌種分類器では最後まで残した空間の解像度が、赤5分類器ではほとんど要らなかったことになります。
途中で、学習のバッチサイズ(1回の更新で使う画像の枚数)も振り直しました。牌種分類器で良かった128より、256のほうが良く、誤り件数は0件になりました(④)。
空間の潰し方とバッチサイズを振った結果
| 最後の特徴マップ(バッチサイズ128) | 誤り件数 | iPhoneでの推論時間 |
|---|---|---|
| 縮小を強めない(比較用) | 8 | 8.080 ms |
| 8×8まで縮小 | 7 | 4.465 ms |
| 4×4まで縮小 | 4 | 2.620 ms |
| バッチサイズ(4×4まで縮小) | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|
| 誤り件数 | 4 | 0 | 5 | 10 | 6 |
空間を潰したあとなら、分解できた
ただ、縮小を強めても重みの数は変わらないので、ファイルは3.5MBのままでした。そこで、空間を4×4まで潰したあとの3・4段目だけを分解しました(⑤)。
牌種分類器と同じ削り方では崩れた分解ですが、今度は誤り件数が1件に収まりました。以前のモデルと比べると、次のようになります。
| 指標 | 以前のモデル | 採用モデル |
|---|---|---|
| 誤り件数 | 1 | 1 |
| ファイルサイズ | 6.26 MB | 0.66 MB |
| iPhoneでの推論時間 | 14.03 ms | 1.735 ms |
ファイルは約1/9.5、iPhoneでの推論は約1/8になりました7。前段では密にチャネルを混ぜ、空間を潰したあとの後段だけを分解する。これが赤5分類器での削り方です。
6. 2つの分類器を並べてみる
ここで、2章の構造図に戻ります。同じ図の段の位置を上下でそろえ、2つの分類器の違いを書き込みました。箱の正面には、入力の牌をその段の大きさまで縮小した画像を貼っています。
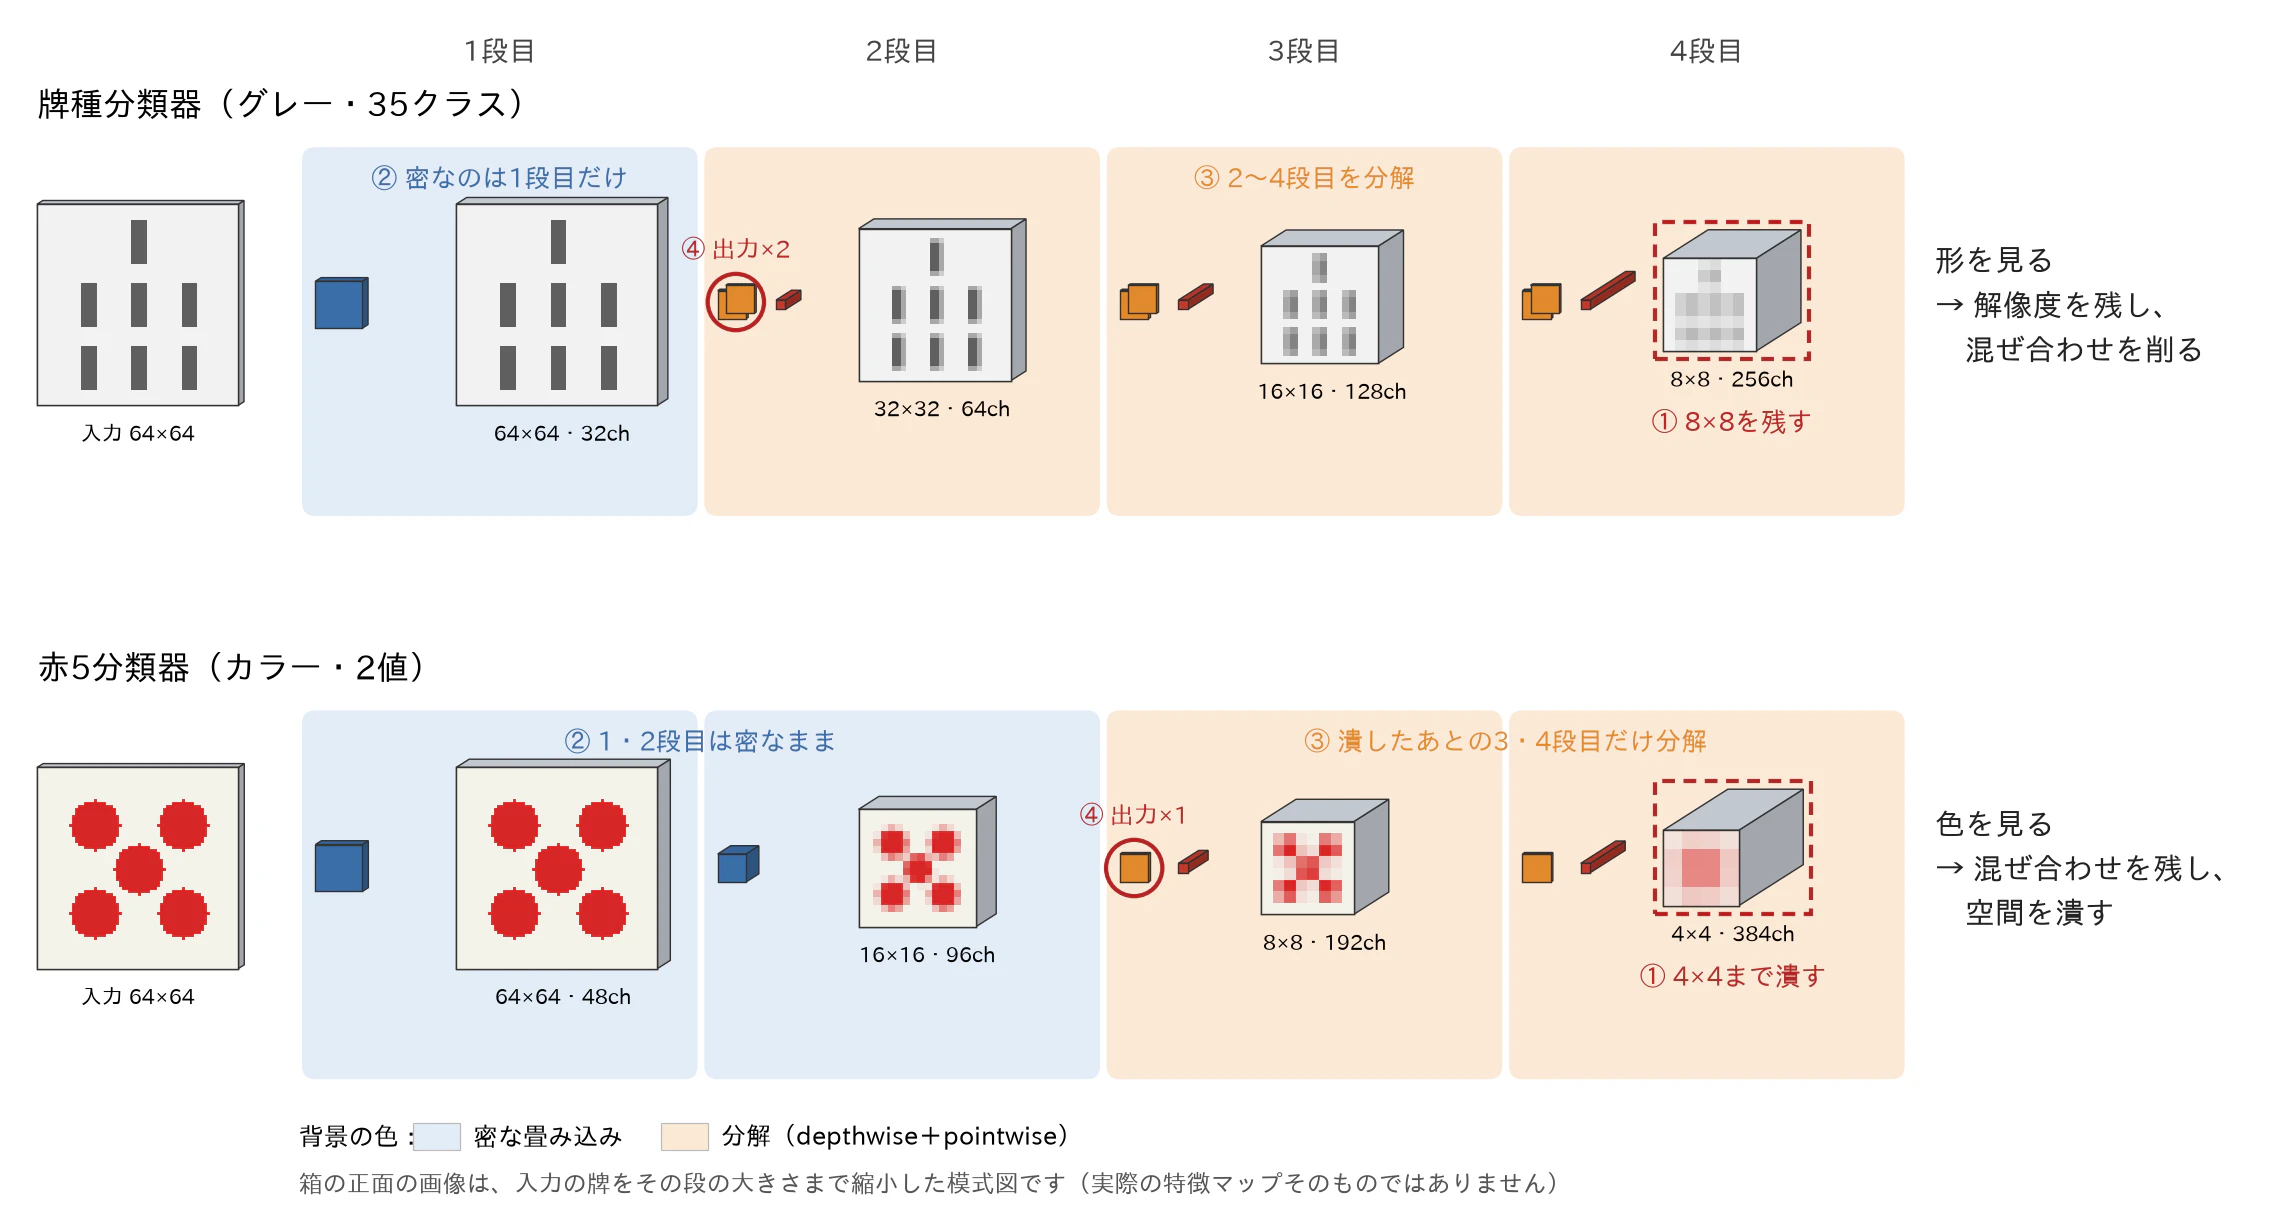
牌種分類器は、最後の8×8でも牌の線の本数が読み取れる大きさを残し、そのかわり2段目から分解しています。赤5分類器は、1・2段目では空間とチャネルを密に混ぜ、4×4まで潰してから分解しています。4×4では牌の形はほとんど残りませんが、赤いことは分かります。
図の①〜④を、表にまとめると次のようになります。
| 牌種分類器 | 赤5分類器 | |
|---|---|---|
| 入力 | グレースケール | カラー |
| 見分けるもの | 牌の細かい形(35通り) | 赤いかどうか(2通り) |
| ① 最後の特徴マップ | 8×8まで残す | 4×4まで潰す |
| ② 密な畳み込み | 1段目だけ | 1・2段目に残す |
| ③ 分解した段 | 2〜4段目 | 3・4段目(空間を潰したあと) |
| ④ depthwiseの出力 | 2倍(効いた) | 1倍(2倍は効かなかった) |
| ファイルサイズ | 522,705 bytes | 662,382 bytes |
振り返ると、2つの分類器の違いは、それぞれが何を見分けるかで説明がつきます。牌種分類器は、普通のCNNで早く縮小すると萬子が崩れたことから、空間の解像度を最後まで残しました。分解して崩れたあとは、計算の重い2段目を削り、浮いた分を後段のチャネルに回しています。赤5分類器は、牌種分類器の削り方をそのまま当てて崩れたところから出発しています。その結果を見て、チャネルはしっかり混ぜる必要がある、一方で色の判定なら細かい形は要らない、と考えて空間を削りました。ただ、これは今回の実験の結果から言えることで、設計の原理として示せたわけではありません8。
それでも、「回転同変CNNならこう削る」「分解すれば軽くなる」のような一律の削り方では、どちらかの分類器が崩れます。実際に赤5分類器は一度崩れました。うまくいかなかった結果を見て、そのモデルが何を見分けているのかを考え直したことで、削る場所が決まりました。
7. 今の構成と、この先
今アプリに載せているモデルは、次の3つです。
| 役割 | モデル | ファイルサイズ |
|---|---|---|
| 検出器 | NanoDet Plus M320 | 4,734,123 bytes |
| 牌種分類器 | 回転同変CNN 幅4/8/16/32、2〜4段目を分解(出力2倍) | 522,705 bytes |
| 赤5分類器 | 回転同変CNN 幅6/12/24/48、4×4まで縮小、3・4段目を分解 | 662,382 bytes |
| 合計 | 5,919,210 bytes |
ブラウザが最初に読み込むモデルは、合計で約5.9MBになりました。参考までに、同じくブラウザで麻雀牌を認識するOSSのRiichiCamでは、検出モデル1つで76.8MBありました9。
削る余地としては、後段を分解できるなら、縮小をMaxPoolに置き換えたり、4段目をなくして3段目から一気に縮小したりする構成もありえます。ただ、赤5分類器は以前のモデルの約1/9.5まで小さくなったので、いったんここで止めました。今は検出器がモデル全体の8割を占めているので、次に軽くするならそちらだと考えています。
おわりに
牌種分類器と赤5分類器は、同じ回転同変CNNから出発し、同じように分解やチャネル数の調整という道具を使って軽くしていきましたが、最後は削った場所がほぼ逆の形に落ち着きました。細かい形を見分ける牌種分類器は空間の解像度を最後まで手放せず、色を見分ける赤5分類器はチャネルの混ぜ合わせを手放せなかった、というのが今回の実験から読み取れたことです。
牌種分類器では、一度普通のCNNを試してから戻ってきています。遠回りではありましたが、そこで分かった「早く縮小すると崩れる」「削ってもチャネルで戻せる」という2つの知見がなければ、回転同変CNNのままこの形にはたどり着けなかったと思います。そして赤5分類器では、その牌種分類器の削り方をそのまま当てたことで、かえって何を残すべきかがはっきりしました。
-
正解率は、すべての構成を同じ評価セット(自分の卓の実写と公開データセットを合わせ、牌の種類ごとに100枚ずつそろえた3,432枚)に、学習では見せていない15通りの歪みを加えて評価し直した値です。歪みは、横・縦の圧縮(0.75〜0.85倍)、左右・上下からの透視変換、検出器の切り出しを模した切り直し、±2ピクセルのずらしなどで、学習時のデータ拡張は0〜360°の回転だけです。上のほうの構成は96%前後に集まっていて、この評価だけでは細かい差は見分けにくい点に注意してください。どれか1種類の牌の正解率が95%を下回った構成は、牌種分類器として使えないので図から外しています(2構成)。推論時間の一部は、同じ構造の別のモデルで測った値を流用しています。点ごとの元データは tools/recognition/classifier_maps/points.csv です。 ↩
-
たとえば、幅を半分にした普通のCNNで後段の2つの段の3×3を1×1に置き換えると、萬子の正解率は0.867から0.447まで下がりました。この値は、この記事のほかの表とは別の、当時の評価セットで測ったものです。 ↩
-
C8(元の幅)とC8 narrowは別のGPUで学習しています。そのため、1ポイント未満の精度差は、モデルの違いによるものとは扱っていません。 ↩
-
2/2/2 倍と 2/1/2 倍の差は、平均で0.3ポイント、最悪条件で0.8ポイントほどしかありません。どちらも学習の乱数の初期値(seed)を1通りに固定した1回の学習結果なので、この差はseedの違いで入れ替わる程度のものかもしれません。また、今回の分解は、全フィールドをまとめて見る密な畳み込みと、フィールドごとに分けるdepthwiseの両端だけで比べていて、数フィールドずつまとめる中間の分け方は振れていません。ただ、このあとに赤5分類器の検討が控えていて、牌種分類器は置き換え前の軽量版と同じくらいの速さのまま、傾けても崩れにくくなったので、優先度を考えてここで止めました。 ↩
-
比べた普通のCNNは、幅を半分にして後段だけ分解したもので、採用モデルと同じ条件(バッチサイズ128、150エポック、seed固定)で学習しています。評価で加える歪みは、3章の図の注と同じ15通りです。一番悪い条件での正解率は、実写と公開データセットを合わせた3,432枚の評価では軽量版0.956・採用モデル0.961、同じ15通りの歪みを自分の卓で撮った実写450枚にかけた評価では0.760・0.851でした。前者は両方が96%前後にそろっていて、モデルの差を見分けるには余裕が足りません。後者は実際の使い方に近い一方で、牌の種類によっては3枚しかないので、数ポイントの差は誤差の範囲かもしれません。また、どちらの評価も幾何的な歪みだけで、明るさの変化やぼけ、反射は含んでいません。実際の使い方に近く、枚数も十分な評価セットを作るのが次の課題です。 ↩
-
誤り件数の母数は、ラベルを確認済みの116,080枚です。実写241枚と電球色24枚は、それぞれ手で確認した評価用の画像です。 ↩
-
14.03msは、以前のモデルと同じ構成・同じ幅のモデルを別に学習して測った値で、以前のモデルの重みそのものをiPhoneで測ったわけではありません。 ↩
-
どちらの分類器も、採用の判断は、学習の乱数の初期値(seed)を1通りに固定した1回の学習結果にもとづいています。 ↩
-
比較しているのはファイルサイズだけで、精度は比べていません。サイズは、コミット dd2b413 時点のファイルについてGitHubが表示する値です。なお、現在のRiichiCamはブラウザ内での検出をやめています(archive/legacy-browser-detector)。 ↩