
シュトゥットガルトで優れたパフォーマンスを発揮するには、VLAの学習データは上海を越えて拡張されなければならない
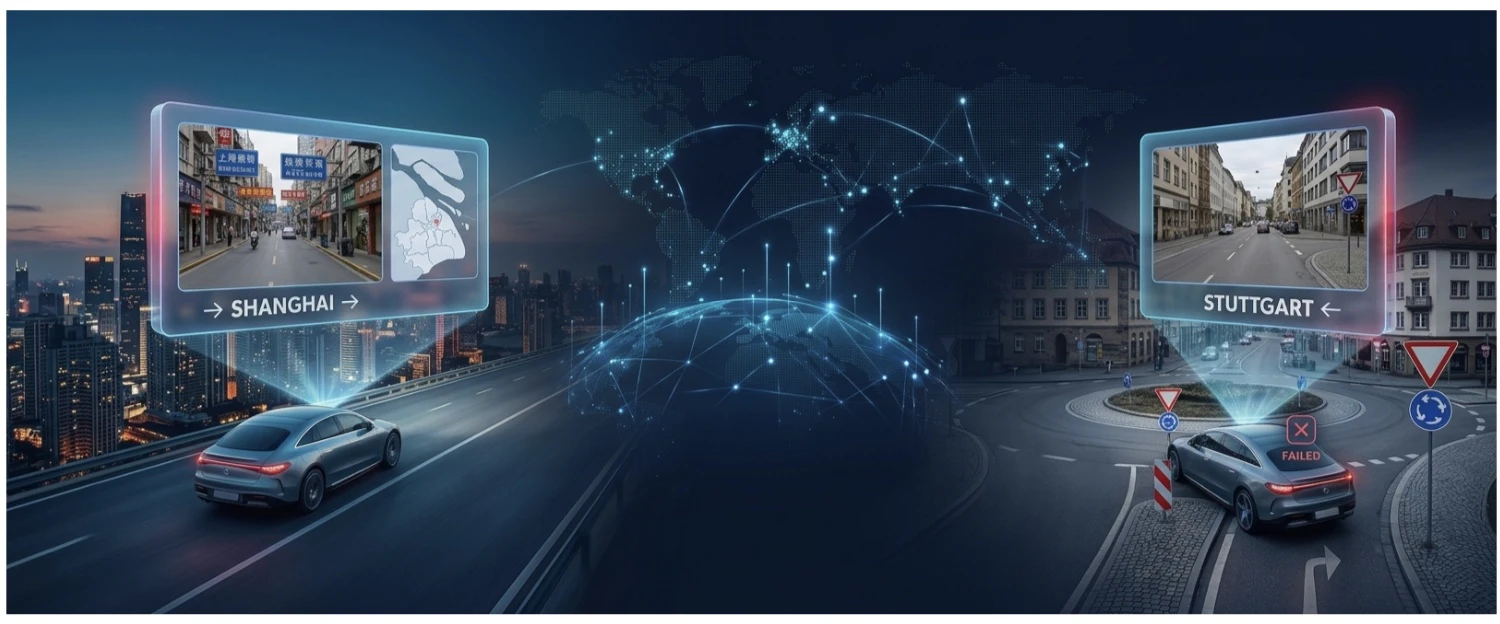
中国国外で失敗するVLAモデル
Redditで議論されているように、中国の特定のロボタクシーは約3,000 TOPSの演算能力を備えていると報告されているのに対し、欧州の一部の車両は概ね750 TOPSにとどまっています。しかし、演算能力が大きいからといって、主に中国の走行データで学習されたVLAモデルが、欧州や北米の道路で必ずしも優れたパフォーマンスを発揮できるとは限りません。
VLAモデルは、知覚・推論・行動を統合して自動運転を進化させます。しかし、演算能力単体では、学習データにおける地理的偏りを補うことはできません。
十分な地理的多様性がなければ、VLAの学習データパイプラインは、モデルが対象地域外にデプロイされた際に苦戦する可能性があります。この記事では、その課題にどのように対処すべきかを解説します。
なぜ地理的カバー率がVLA学習データパイプラインの課題となるのか
VLA(Vision-Language-Action)モデルは、学習時に見ているデータに対しては優れて機能する一方で、異なる地域にデプロイされるとパフォーマンスが低下することがあります。
自動運転において、地理的カバー率は、モデルが未遭遇の状況下でどれだけ良好に機能できるかに直結します。この問題についてさらに詳しく見ていきましょう。
VLAにとって地理が極めて重要である理由
VLAモデルはマルチモーダルな観察を通じて運転行動を学習します。その学習データは、道路の見た目、交通の挙動、そして異なる環境が運転の意思決定にどう影響するかをモデルに教えます。
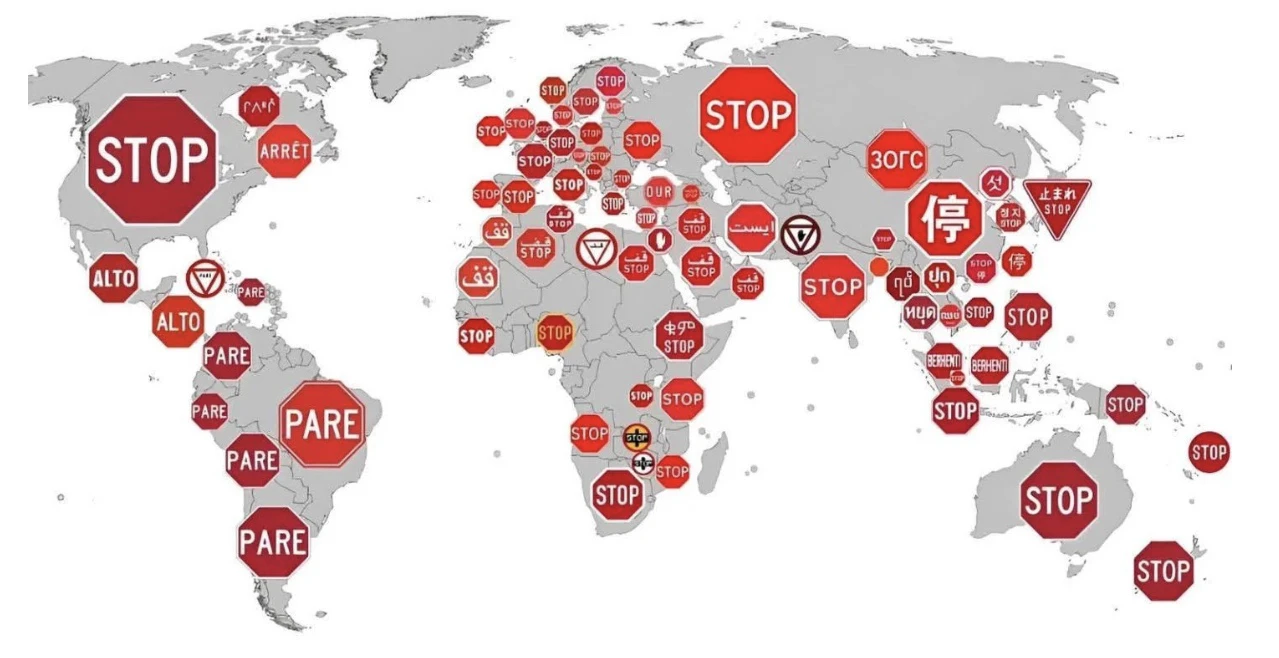
世界各地の一時停止標識
ここで、市場ごとの違いを考えてみてください。道路のレイアウト、車線表示、交通標識、車両の種類、歩行者の挙動、天候、インフラなどは、中国、欧州、米国で大きく異なります。
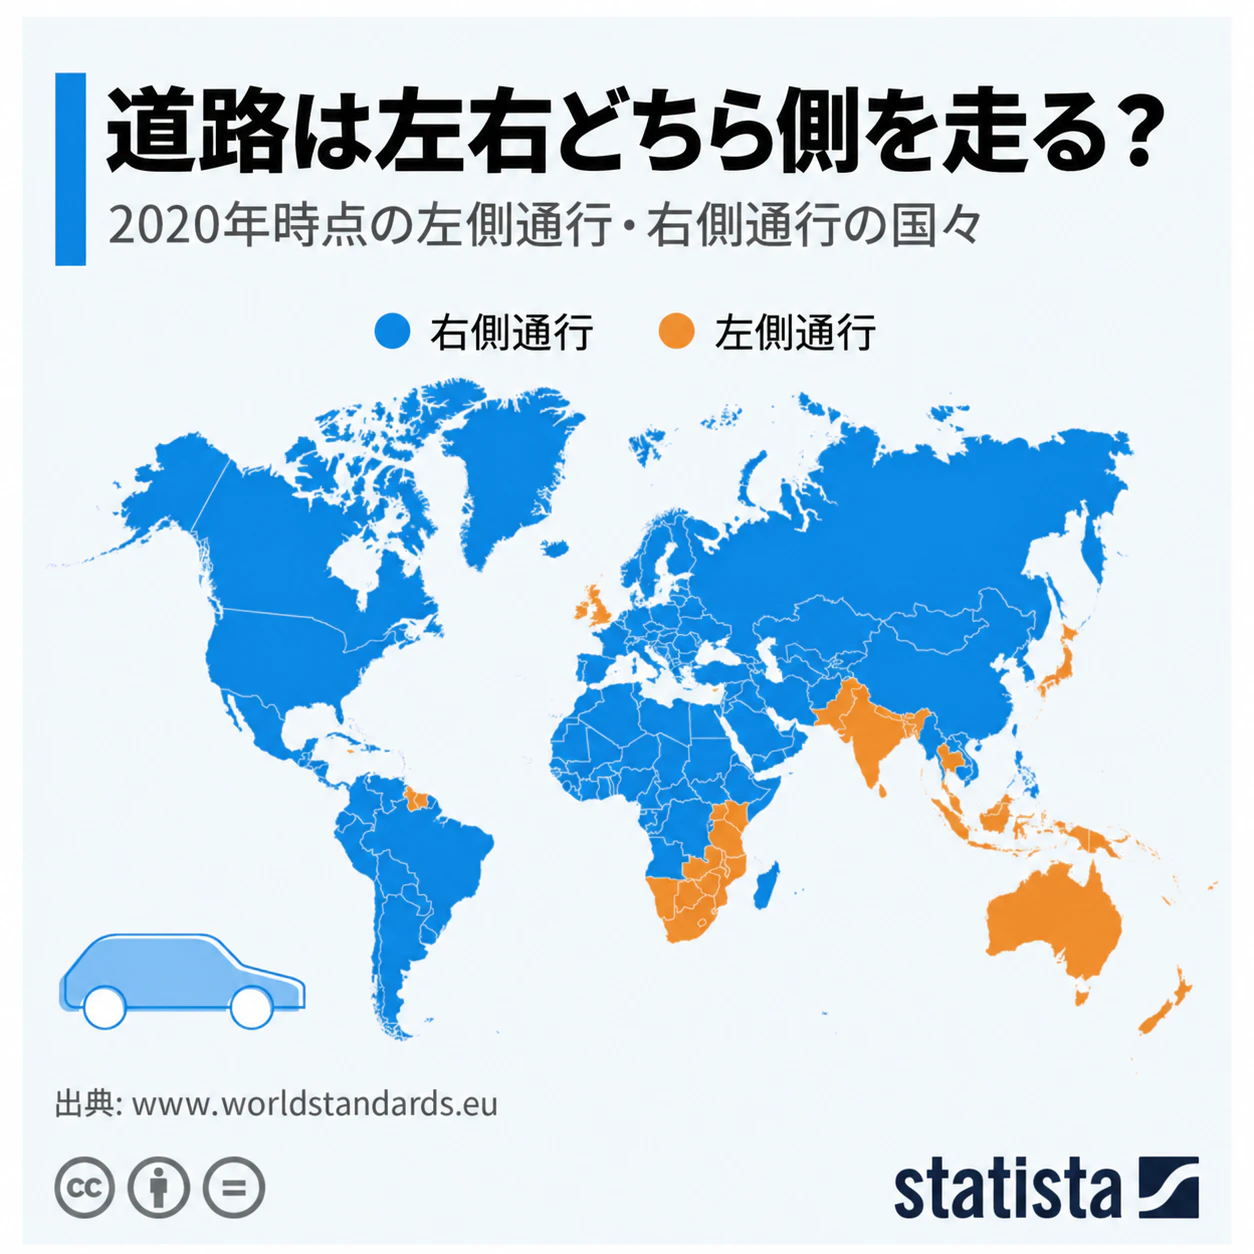
世界各地の左側通行と右側通行
車両が通行する道路の側でさえ国によって異なり、右側通行の国もあれば左側通行の国もあります。これらの違いは、モデルがシーンをどのように解釈し、正しい軌道を予測するかに影響を与えます。
中国、ドイツ、またはカリフォルニアに集中したマルチモーダルAIデータ収集フリート(実験・走行車両群)では、車両が他の場所で遭遇する条件を自動的にカバーすることはできません。そのため、VLA学習データパイプラインには、明確な評価軸として地理的カバー率が必要です。
地域横断的なAI学習データセットは、単に学習サンプル数を最大化するのではなく、モデルの運用が想定される国々を適切に反映している必要があります。
ロングテール現象も地理的に分散している
自動運転のシナリオにおける「ロングテール(発生頻度は低いが多様なケース)」もまた、地理的に分散しています。積雪のある道路はある地域で一般的であり、複雑なラウンドアバウト(環状交差点)は別の地域に多く、特定の歩行者や交通パターンは特定の都市に集中することがあります。
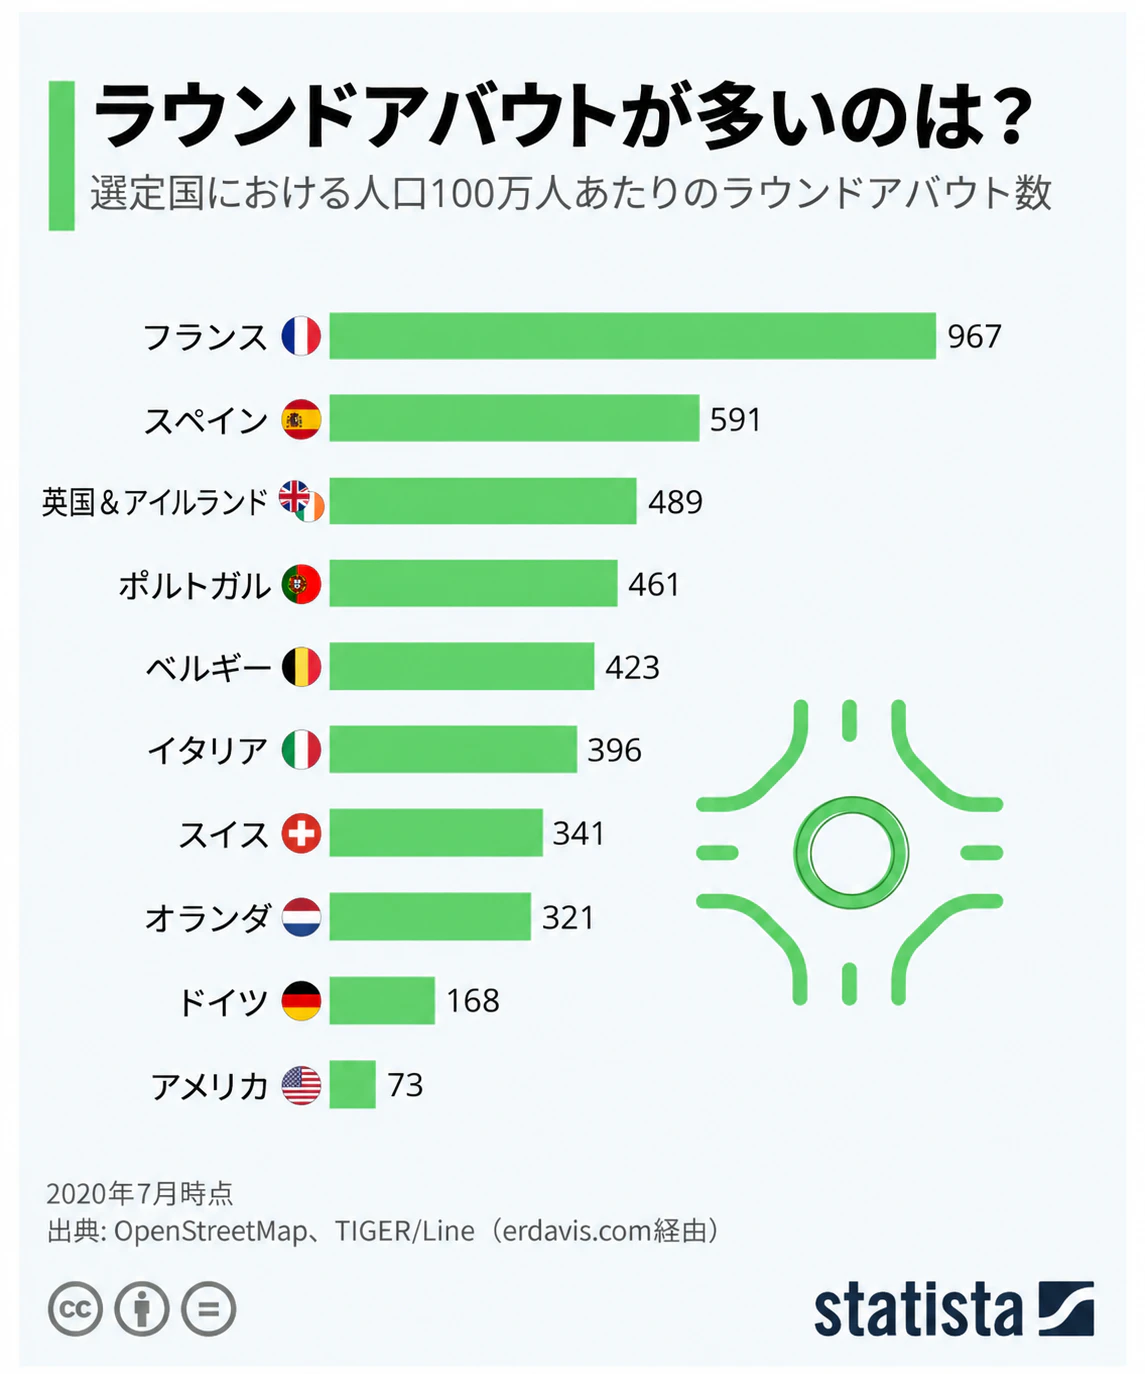
ラウンドアバウトを好む国々
同一エリアからの映像を増やすだけでは、自動運転データにおける地理的多様性を達成することはできません。エンジニアには、国、気候、道路の種類、インフラ全体にわたってカバー範囲を広げるターゲットを絞ったデータ収集が必要です。
こうした盲点は、従来のシナリオ、センサー、アノテーションの欠陥と併せて評価されるべきです。そうでなければ、モデルは机上では十分に学習されているように見えても、実際に運用が必要な市場への準備が不十分なままになってしまいます。
なぜ物理フリート(実際の走行車両群)だけでは不十分なのか
同期されたセンサーデータを収集するためには物理フリートが引き続き不可欠ですが、地理的カバー率を拡大するための最も効率的な方法であるとは限りません。
フリートデータが抱える地理的スケーリングの問題
関心のあるすべての市場で物理フリートを構築するには、車両、現地の運用、インフラ、そして規制上の承認(特に欧州ではデータ法による制限)が必要となります。これにより、国際的なデータ収集は高コストかつ低速化します。
また、フリートデータは企業がすでに展開している場所を反映する傾向があります。特定の数カ国に集中したフリートは、何百万もの有用な走行サンプルを生成できる一方で、他の市場のカバー率は限定的なままとなります。これが、データの入手可能性と、自動車向けVLAモデルの実際の運用が必要な場所との間の不均衡につながります。
特定シナリオをキャプチャするために車両を派遣することも非効率的になる場合があります。学習データセットに欧州のラウンドアバウトの映像が不足していることが判明した場合、対象となる全事例をキャプチャするためにフリートを配備すると、数週間から数か月かかることがあります。
公開ウェブデータがフリート記録を補完する
倫理的かつ法的なウェブスクレイピングを介して収集された公開データは、地理的カバー率を調査・拡大するためのスマートな方法を提供します。ストリートレベルの画像、運転動画、地図、その他の視覚的ソースは、既存のフリートデータセットに含まれていない道路環境を明らかにすることができます。
例えば、主要なウェブデータプロバイダーであるBright Dataは、YouTube動画(一人称視点のドライバー動画を含む)やGoogle Maps ストリートビュー、その他多数のウェブソースからのマルチモーダルAIデータ収集をサポートしています。
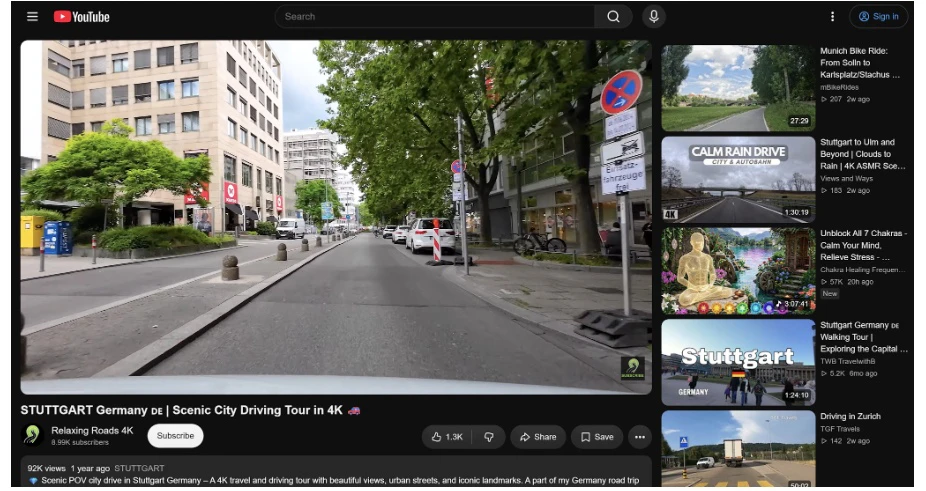
シュトゥットガルトでの4K・30分間のYouTubeドライブPOV(一人称視点)動画
これにより、エンジニアリングチームは追加の物理データ収集にリソースを投入する前に、新しいエリアを調査し、より広範な地域横断的AI学習データセットを構築できるようになります。
なお、ウェブデータソースは量産車からの同期されたカメラ、LiDAR、レーダーの記録を完全に置き換えるものではありません。これらは、VLA学習データパイプラインにおいてフリートデータを補完し、モデルのパフォーマンスを向上させる役割を果たします。
VLA開発のための地域横断的AI学習データセットの構築
地理的に多様なVLAデータセットを構築する際、物理フリートであれウェブベースのソースであれ、すべての地域から同量のデータを収集する必要はありません。そうではなく、学習データが不足している領域に体系的に対処することが重要です。
地理的シナリオの発見から始める
まずはVLAモデルがどこで運用されるかをマッピングすることから始めます。それらの要件を既存のデータセットと比較し、カバー率が低い道路、気候、交通パターン、運転条件を特定します。目的は、多様性を一般的な目標ではなく測定可能なプロパティ(指標)にすることです。
例えば、欧州でのデプロイを準備しているチームは、異なる道路レイアウト、稀な天候条件、ユニークな標識、あるいは特殊な走行ルールを持つ国々からのサンプルをより多く必要とする可能性があります。
フリートが存在しない市場からの収集
地理的カバー率の問題が特定されたら、地理的に分散されたウェブデータ収集パイプラインを使用して、物理フリートのカバーがないエリアから道路、環境、視覚データを収集します。
関連するソースには、YouTube、Bilibili、Vimeoの走行映像や、Google Maps ストリートビューのスクリーンショットなどがあります。
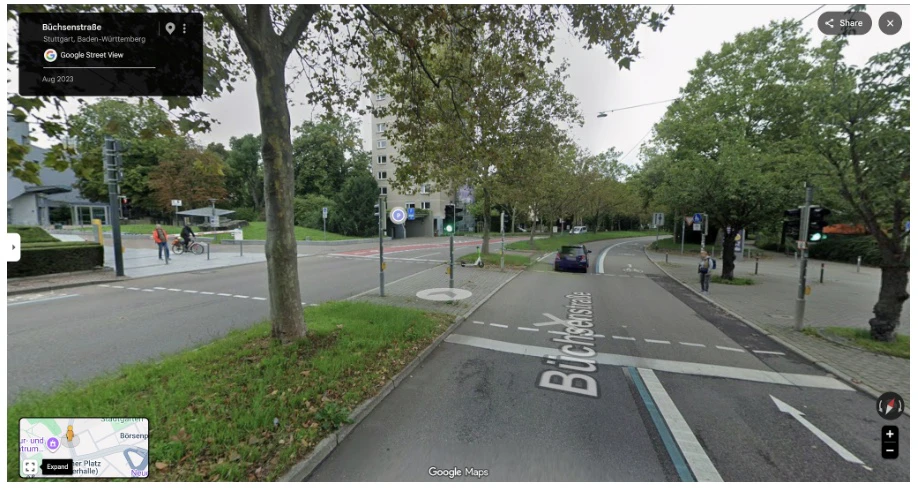
Bright Dataで収集可能なシュトゥットガルトの道路のGoogle Maps ストリートビューのスクリーンショット例
このタイプの収集では、グローバル市場全体で大規模なカバー率を持つ信頼できるプロキシプロバイダーを選択してください。Bright Dataを使用すると、195カ国にわたる4億以上のプロキシIPにアクセスでき、国、州、都市、さらには正確な緯度/経度レベルまでの細かなジオターゲット設定が可能です。
マルチモーダルAIデータ収集パイプラインを自前で構築したくない場合は、ウェブデータセットプロバイダーの活用を検討してください。Bright Dataは、ペタバイト規模のAI最適化データを提供するデータセットマーケットプレイスを提供しています。
生の収集データを学習シグナルに変換する
ウェブデータは、特定のモデル要件に結び付けられたときに初めてVLA学習にとって有用になります。収集された素材を、道路の種類、天候、交通状況、インフラ、および自動運転に関連するその他のシナリオによってフィルタリングします。
また、収集データに関連付けられた地理的メタデータとソースのトレーサビリティ(出所)を保持してください。これにより、VLA学習データパイプライン全体でデータの追跡可能性が維持されます。その後、これを独自のセンサー記録と組み合わせてカバー率の限界を特定し、最も重要なエリアに対して物理データの収集を向けるようにします。
国際デプロイのための実用的なVLAデータワークフロー
地理的カバー率がなぜ重要であるか、そして外部のウェブデータが物理フリートをどのように補完できるかを理解した後のステップは、これらの原則を再現可能なワークフローに落とし込むことです。
ステップ #1: 既存のVLA学習データセットを監査する
まず、学習データセットおよび検証データセット全体で、国、都市、気候、道路の種類、シナリオの分布を算出します。大規模なデータセットであっても、ごく少数のエリアに大きく偏っている可能性があるからです。
表現力(データ量)が不足しているデプロイ市場を発見します。また、真に多様なサンプルと、環境のカバー範囲を広げずにデータ量だけを増加させるほぼ重複したサンプルとを分離します。
ステップ #2: 外部データで地理的偏りを補解消する
不足しているシナリオを踏まえ、関連する道路シーン、走行動画、ストリートレベルの画像、環境条件をウェブソースから検索します。地理的に分散されたプロキシインフラを利用すれば、予備的なデータ収集のためだけに物理車両を配置することなく、それらのデータを収集できます。
夜間の道路、冬のコンディション、見慣れない交差点の設計、地域の道路インフラなど、データセットにおける特定の疑問に答えるソースを優先します。この外部情報を独自のセンサーデータと組み合わせて、より強力な地域横断的AI学習データセットを構築します。
ステップ #3: 成果をモデル開発にフィードバックする
モデル評価結果を活用して、どの地理的・環境的シナリオで追加データが必要かを特定します。学習セットまたは検証セットにターゲットをしぼったサンプルを追加し、以前は表現が不十分だった条件においてパフォーマンスが向上するかどうかを測定します。
デプロイ範囲が拡大するにつれて、このプロセスを繰り返します。地理的カバー率は、新しい市場に入る際だけに扱うものではなく、VLA学習データパイプライン内での継続的なモデル品質の指標として扱います。
次のVLA学習実行の前に監査すべき項目
次回のモデル学習を行う前に、このチェックリストを使用して地理的分析を実行し、具体的なデータ収集の優先順位に落とし込んでください。
・次回のVLAまたはADAS(先進運転支援システム)モデル実行前に、学習セットの地理的分布を監査する。
・フリートの道路および環境カバー率が最も低い5つのデプロイ対象市場をリストアップする。
・各市場においてデータが不足している優先度の高いシナリオを3つ特定し、どのウェブソースから関連データを提供できるかを決定する。
・1つの市場に対して地理分散型のデータ収集をテストし、そのカバー率を既存のフリートデータと比較する。
・結果を利用して、どこで物理的な収集が必要か、どこで外部ウェブデータが地域横断的AI学習データセットを改善できるかを判断する。
・収集されたデータを広範なVLA学習データパイプラインに接続し、地理的メタデータとソースの出所を保持する。
結論
このブログ記事では、学習地域外でのVLAのパフォーマンスは、利用可能な演算能力だけでなく、地理的データのカバー率に依存することを学びました。
信頼性の高いVLA学習データパイプラインは、地理的分布を監査し、不足しているシナリオを特定し、ウェブからマルチモーダルAIデータを収集し、再学習を行い、ターゲット市場全体で検証を行う必要があります。
Bright Dataはペタバイトスケールで地理分散型データを提供し、あらゆる場所に物理フリートを配置することなく、自動運転データにおける地理的多様性を拡大することを支援します。Bright Dataのビデオデータインフラを利用して、グローバルに分散された学習パイプラインの構築を無料で開始しましょう。