
こんにちは。開発部のMです。
Webアプリ本番環境の移行作業を実施するにあたり、「社内/特定IPからは通常通りアクセスできるが、それ以外のユーザーにはメンテナンス画面を返す」という制御が必要になり実装しました。
要点まとめ
- ALB配下では
$remote_addrにクライアントの生IPが来ないためgeoに直接渡してもIP制御が効かない →mapでX-Forwarded-Forの先頭要素を取り出してからgeoに渡す二段構えにすると解決✅ - メンテナンス画面への振り分けを
error_page 503方式で作るとSSI(include virtual)を使ったページで表示が崩れる →rewrite ... break方式に直すと安定✅ -
rewrite方式で除外リストにメンテナンス画面自身のSSIパスを入れ忘れると無限再帰する → 除外リストに/maintenance.htmlと/include/等を追加すると解決✅ - メンテナンスのON/OFF切り替えで
reloadだと反映されないことがある(原因未特定)→restartにすると確実に反映✅ - ASGと単体インスタンスで設定配布の経路が分かれてしまう → AMI焼き込みではなく**CI/CDパイプライン(CodeDeploy in-place)**にNginx設定も一緒に乗せると解消✅
想定読者
- ALB配下に複数EC2(Auto Scaling Group + 単体インスタンスなど混在構成)を運用している方
- 「特定IPだけ通常表示、それ以外はメンテナンス画面」を実現したいが、
allow/denyだけでは物足りないと感じている方 - ALB配下でNginxの
geoによるIPアクセス制御を検討している方($remote_addrがうまく拾えず詰まった方向け) - SSI(Server Side Includes)を使った構成で、メンテナンス画面制御を入れようとしている方
背景・課題
単純な要件に見えますが、以下の条件が重なると考慮点が増えます。
- ALB配下に Auto Scaling Group(ASG)と単体インスタンスが混在 している
- インスタンスごとにNginx設定を個別管理していると、スケールイン/アウトやデプロイのタイミングで設定の有無にばらつきが出る
- メンテナンスON/OFFの切り替えを、デプロイなしで素早く行いたい、という要件がある
構成イメージ
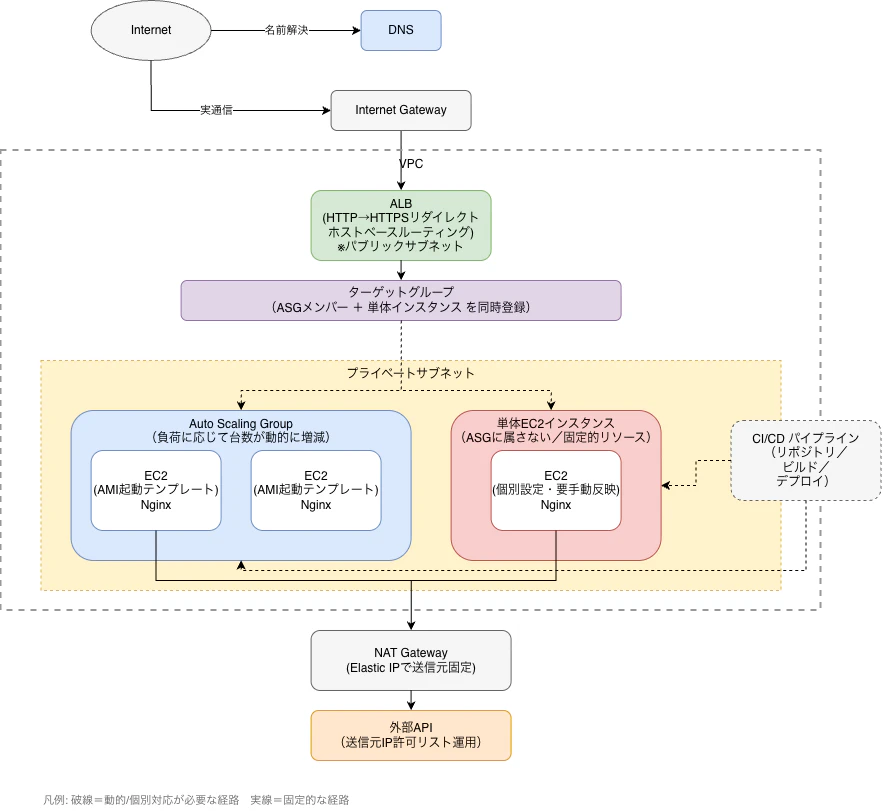
この構成パターンはなぜ生まれるか
「ASGと単体インスタンスの混在」と聞くと特殊なケースに思えるかもしれませんが、実際には Auto Scaling化の移行期に自然発生しやすいパターン です。
- 既存の単体EC2インスタンスをいきなり全台ASG化せず、まず単体インスタンスとASG配下インスタンスを共存させてから段階的に切り替える、という進め方は現実的でよくあります
- ALB配下のターゲットグループは、「ASGによる動的メンバーシップ」と「静的に登録した単体インスタンス」を同時に持てる仕様になっており、これがこの混在構成を成立させています
- ASG配下インスタンスは負荷状況に応じて台数が動的に増減するのに対し、単体インスタンス側は固定的・静的なリソースとして扱われることが多く、素朴に実装すると設定配布の経路そのものが両者で異なってしまいます
なお、Nginxやリバースプロキシによるメンテナンス制御は、ALBより下流(各EC2インスタンス内部)に配置するミドルウェア層の責務であり、ALB自体はホストベースルーティングとHTTPS終端を担うのが一般的な役割分担です。
検討した選択肢
案1: allow / deny ディレクティブ
Nginx標準のIPアクセス制御で、上から順にマッチしたルールが適用されます。
location / {
    allow 203.0.113.0/24;   # このIP帯は許可
    deny  all;               # それ以外は403で拒否
}
最もシンプルですが、以下の理由で見送りました。
- IPごとに許可/拒否の設定行が増え、管理が煩雑になりやすい
- 「許可IP以外にメンテナンス画面を返す」という能動的な制御より、「拒否したら403」という受動的な制御に近く、要件と少しずれる
案2: ALB(リスナールール/ターゲットグループ)側での制御
- ALBのリスナールールでIPベースのルーティングも可能ですが、メンテナンス画面の出し分けロジックをALB側に持たせると、アプリ側の設定と管理場所が分散します
- 素早いON/OFF切り替えのしやすさでNginx側に分があると判断しました
案3: geo モジュール + IP判定(採用)
-
geoディレクティブで許可IPのリストを変数化し、判定結果に応じてメンテナンス画面へ振り分ける構成 - IPリストを1箇所にまとめられ、可読性・保守性が高い
- 設定ファイルの書き換えだけで切り替えられるため、アプリのデプロイを伴わずに素早くON/OFFできる(ただし反映方法には後述の落とし穴がある)
実装:ALB配下でgeoを使うときの落とし穴
落とし穴1: $remote_addr にクライアントの生IPが来ない
ALB配下のNginxでは、$remote_addr にはALBのIPが入ってきます。クライアントの実IPはX-Forwarded-Forヘッダに入っているため、geoディレクティブにそのまま$remote_addrを渡しても意図通りに判定できません。
対策として、mapでX-Forwarded-Forの先頭要素(=オリジナルクライアントのIP)を切り出した独自変数を作り、それをgeoの判定対象にする二段構えにしました。
# X-Forwarded-For の先頭要素(クライアントの実IP)を取り出す
map $http_x_forwarded_for $maintenance_client_ip {
    default "";
    "~^(?<first_ip>[^,\s]+)" $first_ip;
}

# 取り出したIPを許可リストと照合
geo $maintenance_client_ip $maintenance_allowed {
    default 0;
    # 許可元ごとにコメントでグルーピングして管理
    203.0.113.0/24   1;  # 例: 発注元Aのオフィス
    198.51.100.10/32 1;  # 例: 検証用踏み台
}
X-Forwarded-Forは複数プロキシを経由すると値がカンマ区切りで連結されるため、正規表現で先頭要素だけを抜き出しています。ALB配下でNginxのgeoを使うなら、このmap→geoの二段構成はほぼ定石と言えそうです。
なお、X-Forwarded-Forはクライアント側が任意の値を送り込める(偽装できる)ヘッダです。ALB経由のリクエストであればALBが正しい値に上書き・追記してくれますが、この制御はあくまで「ALBを経由したアクセスである」ことが前提になっている点は留意が必要です。
落とし穴2: error_page 503 方式はSSIと競合する
最初はオーソドックスに、許可されていないIPには503を返し、error_pageでメンテナンス画面に内部リダイレクトする方式で実装しました。
# 最初の実装(後で変更することになる)
if ($maintenance_allowed = 0) {
    return 503;
}
error_page 503 /maintenance.html;
一見よくあるパターンですが、SSI(include virtual)を使ったページ構成と組み合わせると異常なレスポンスになる問題に遭遇しました。error_pageによる内部リダイレクトは、SSIのサブリクエスト処理と干渉し、期待通りの静的ページが返らないケースがありました。
対策として、rewrite ... breakで直接メンテナンス画面のURIに書き換える方式に変更しました。
set $maintenance_mode 0;   # 0=平常 / 1=メンテ中。切り替えはこの値を書き換えて反映(反映方法は後述)
set $do_maintenance 0;

if ($maintenance_mode = 1) { set $do_maintenance 1; }
if ($maintenance_allowed = 1) { set $do_maintenance 0; }

# メンテナンス画面自身・静的アセット・ヘルスチェックは対象外にする
if ($uri ~* "^/(maintenance\.html|include/|common/|css/|js/|hc\.static\.html)") {
    set $do_maintenance 0;
}

if ($do_maintenance = 1) {
    rewrite ^ /maintenance.html break;
}
ifを複数積んでフラグ変数を段階的に確定させる書き方は、Nginxのifが本来推奨されない書き方であることを踏まえても、複数条件のAND/OR相当をディレクティブ内で組みたい場合の現実的な妥協点だと考えています。
なぜerror_page方式だとSSIと競合し、rewrite方式だと安定するのかについては、正直なところ自分でもNginx内部の処理レベルで完全に説明しきれてはいません。error_pageの内部リダイレクトは「エラーハンドリングの文脈」を経由するのに対し、rewriteは通常のリクエスト処理の流れの中でURIを書き換えるだけのシンプルな動作です。SSIモジュールが前提とするリクエストのコンテキストと、error_pageが作り出すコンテキストが噛み合わなくなるのではないかと推測していますが、Nginxの公式ドキュメントに明記されているわけではなく、あくまで実際に挙動を変えて確認した経験則です。同じ現象に心当たりのある方がいれば、ぜひ知見を共有していただけると助かります。
落とし穴3: メンテナンス画面自身の除外を忘れると無限再帰する
rewrite方式に変更する際、/maintenance.html自体や、そのページがSSIで読み込むサブリクエストパス(/include/など)を判定の除外リストに入れ忘れると、メンテナンス画面を表示しようとして再度メンテナンス判定に引っかかり、リダイレクトが無限に発生します。
判定基準を$request_uri(クエリ文字列込み)から$uri(正規化されたパス)に変更したのも、この整理のタイミングでした。除外パスの判定はクエリ文字列を含めない方が意図通りに動きます。
落とし穴4: reload では反映が不十分だった
メンテナンスのON/OFFはset $maintenance_modeの値を書き換えて反映する運用にしていますが、この環境ではnginx -s reload(systemctl reload nginx)だと反映が不十分で、systemctl restart nginxが必要でした。
実装時にこれに気づかず、「設定を変えたのに切り替わらない」と切り分けに時間を使いました。以降は切り替え手順をrestartで統一し、運用手順書にもその旨を明記しています。
sudo nginx -t && sudo systemctl restart nginx
なぜreloadで効かないのかは特定できていません。一般論としてnginxのreloadは新しいワーカープロセスを起動して設定を読み直すため、通常はこれで反映されるはずです。効かないケースとして、
- 古いワーカーが既存接続を保持したまま残り、ALBのkeepalive接続がそちらに振られ続ける
-
worker_shutdown_timeoutが長く、古いワーカーの終了が遅れる
といった筋が考えられますが、いずれも検証はできていません。実務上はrestartで確実に反映されるため、原因究明は行わずそのまま運用しています。
restartは瞬断を伴うため、ALB配下で複数台構成の場合は1台ずつ実施するなどの配慮が必要です。同じ症状に当たった場合、まずreloadが効いていない可能性を疑うと切り分けが早いと思います。
IP許可リストの運用
IPリストはincludeで別ファイルに切り出さず、geoブロック内に直接、許可元ごとにコメントで区切って列挙する形にしています。
geo $maintenance_client_ip $maintenance_allowed {
    default 0;
    # 発注元A
    203.0.113.0/24    1;
    # 発注元B(検証用踏み台)
    198.51.100.10/32  1;
    # 社内VPN
    192.0.2.0/28      1;
}
運用していると、当初は個別IPを1件ずつ列挙していましたが、同一発注元からのIPが増えるたびに行が増殖していきました。ある時点で棚卸しを行い、同一発注元の個別IPをCIDR表記にまとめて重複を吸収し、不要になった許可元のブロックを削除しました。IP許可リストは「足し算」だけでなく、定期的な「引き算(棚卸し)」も必要になります。
設定ファイルの配布:ASGと単体インスタンスへの反映方式
「背景・課題」で触れた「ASGと単体インスタンスで設定配布の経路が異なる」問題は、以下の方式で解決しました。
結論:AMIへの焼き込みではなく、CI/CDパイプライン(CodeDeployのin-placeデプロイ)にNginx設定ファイルも一緒に乗せて、アプリコードと同じタイミング・同じ経路で全台に反映する方式にしました。
デプロイフローは以下の通りです(CodeCommit → CodeBuild → S3 → CodeDeploy)。
push → CodeBuild(zip化) → S3 → CodeDeploy(in-place) → 各EC2
appspec.ymlのライフサイクルフックのうち、AfterInstallでNginx設定ファイルをリポジトリから配布先へコピーし、構文チェックしてから無停止でreloadしています。
NGINX_CONF="${APP_DIR}/nginx/studioalice.conf"
NGINX_ENABLED="/etc/nginx/sites-enabled/studioalice"

if [ -f "$NGINX_CONF" ]; then
    cp "$NGINX_CONF" "$NGINX_ENABLED"
    nginx -t && systemctl reload nginx
fi
ポイントは2つです。
-
nginx -tで構文チェックしてから反映することで、設定ミスがあっても既存プロセスを落とさずに済みます。デプロイ経路では無停止性を優先してreloadにしていますが、前述のとおりメンテナンスモードの即時切り替えにはrestartが必要だったため、用途によって使い分けています - ASG配下・単体インスタンスの両方を同じCodeDeployデプロイグループに含めることで、「AMIを焼き直してASGだけ更新する」「単体インスタンスだけ手動で設定を当てる」といった経路の分岐そのものをなくしました
Auto Scaling自体で新規インスタンスが増える瞬間(スケールアウト直後、まだそのデプロイが到達していないタイミング)にどう振る舞うかは、Launch Template側の起動処理(user-data等)の設計に依存する部分であり、アプリケーションのデプロイパイプラインだけでは完全にはカバーしきれない領域として残ります。ここは実運用上、スケールアウトの頻度が低い構成だったため許容しましたが、頻繁にスケールする環境では別途対策が必要になりそうです。
デプロイ時の落とし穴:検証環境のBasic認証で誤検知する
余談ですが、デプロイパイプライン側にも一点工夫があります。検証環境にはBasic認証がかかっており、ヘルスチェック用のスクリプトがアクセスすると401が返ります。これを「デプロイ失敗」と誤判定しないよう、ビルド設定側で「401は許容する」ことを明示的にチェックする処理を入れています。メンテナンス画面制御と直接の関係はありませんが、「本番と検証で認証状態が違う」ことに起因する誤検知は、この手の構成では起きやすい部類のハマりどころなので触れておきます。
まとめ
- ALB配下で
geoによるIP制御をする場合、$remote_addrはALBのIPになるため使えません。mapでX-Forwarded-Forの先頭要素を取り出してからgeoに渡す二段構えが必要です - メンテナンス振り分けを
error_page方式で作ると、SSI構成では思わぬ形で壊れることがあります。rewrite ... break方式のほうが素直に動きます - メンテナンス画面自身と、それが参照する静的パスを除外リストに入れないと無限再帰します
- 設定変更が反映されないときは
reloadが効いていない可能性を疑ってみてください。この環境ではrestartが必要でした - ASGと単体インスタンスが混在する環境では、AMI焼き込みで経路を分けるより、CI/CDパイプラインに設定配布を統合してしまう方がシンプルに解決できる場合があります
- IP許可リストは棚卸し(CIDR化・不要ブロック削除)を定期的にやらないと肥大化します
はつかぜ株式会社では、IT学習や業務に役立つ情報を定期的にお届けしていきたいと思っています。
システム開発のお問い合わせ・ご相談はこちら