
はじめに
本記事は、課題一覧 の
課題No.2 ローカルAIモデルの選定を中心に
Part1 で説明した 最小構成の プラットフォーム と
Part2 で説明した 技術的制約 を考慮して選定した
推論を実現する技術スタックの説明をします。
本記事で説明すること
- RAGとは何か
-
推論の実現方法 - なぜ 量子化モデル としたのか
- 選定した技術スタック
- 用語解説
- まとめ
- おわりに
RAGとは何か
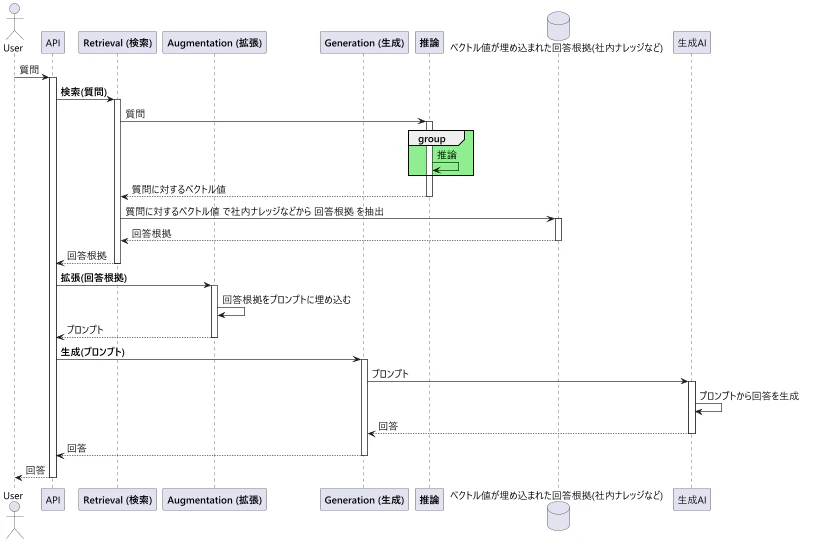
RAGとは、質問に紐付く回答根拠(社内ナレッジなど)を検索し、その検索結果を根拠に生成AIに回答を生成させるシステムです。(RAG)
一般的なRAGアプリケーションの処理フロー
推論 とは何か
上記のシーケンス図を前提として説明します。
推論とは質問をAIモデルに入力して質問に対するベクトル値を取得する一連の処理を指します。
ではこの推論がRAGアプリケーションに、どのように関連しているのかを説明します。
推論 とRAGアプリケーションの関連
RAGアプリケーションの構成は以下となります。
-
Retrieval (検索)
- 質問に紐付く回答根拠を 社内ナレッジなど から検索します。
-
Augmentation (拡張) ※1
- 検索結果である回答根拠をプロンプトに埋め込みます。
-
Generation (生成)
- 回答根拠を埋め込んだプロンプトで生成AI連携して、回答を生成します。
※1.
ここまでが一般的な RAG の説明です。
本機能は一般的な RAG と異なり、検索結果を生成AIのプロンプトへ追加しません。
本機能では Augmentation (拡張) に相当する部分を
質問に対する回答が、コーパスに あるか/ないか を判定する ルーティング判定 として実装しています。
Part3 の RAG要件 でも説明していますが、本機能の Retrieval (検索) は以下の構成となります。
- BM25検索
-
日本語で入力された 質問 に対するトークナイズ(分かち書き)。
-
-
ベクトル検索
-
日本語で入力された 質問 に対する推論。
-
- RRF統合
- BM25検索結果(スコア) と ベクトル検索結果(スコア) を RRF統合 により統合して順位付け。
つまり本機能では ベクトル検索 で 推論 を使用しており
本機能における 推論 のユースケースは以下となります。
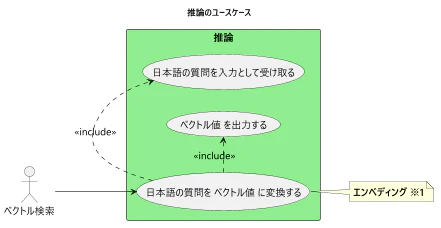
※1.エンベディングとは日本語の質問をベクトル値に変換する処理で ベクトル検索 の入力パラメータになります。
次に 推論 の実現方法に対して検討した内容を説明します。
推論 の実現方法
AIモデル で 推論 を実現する方法
AIモデル とは何か
本機能における
AIモデルとは、「文章をベクトル値に変換」する「学習環境から 変換・出力 された学習済みモデル」を指します。
以下にAIモデルを使用して推論を実現するために検討した 案 を説明します。
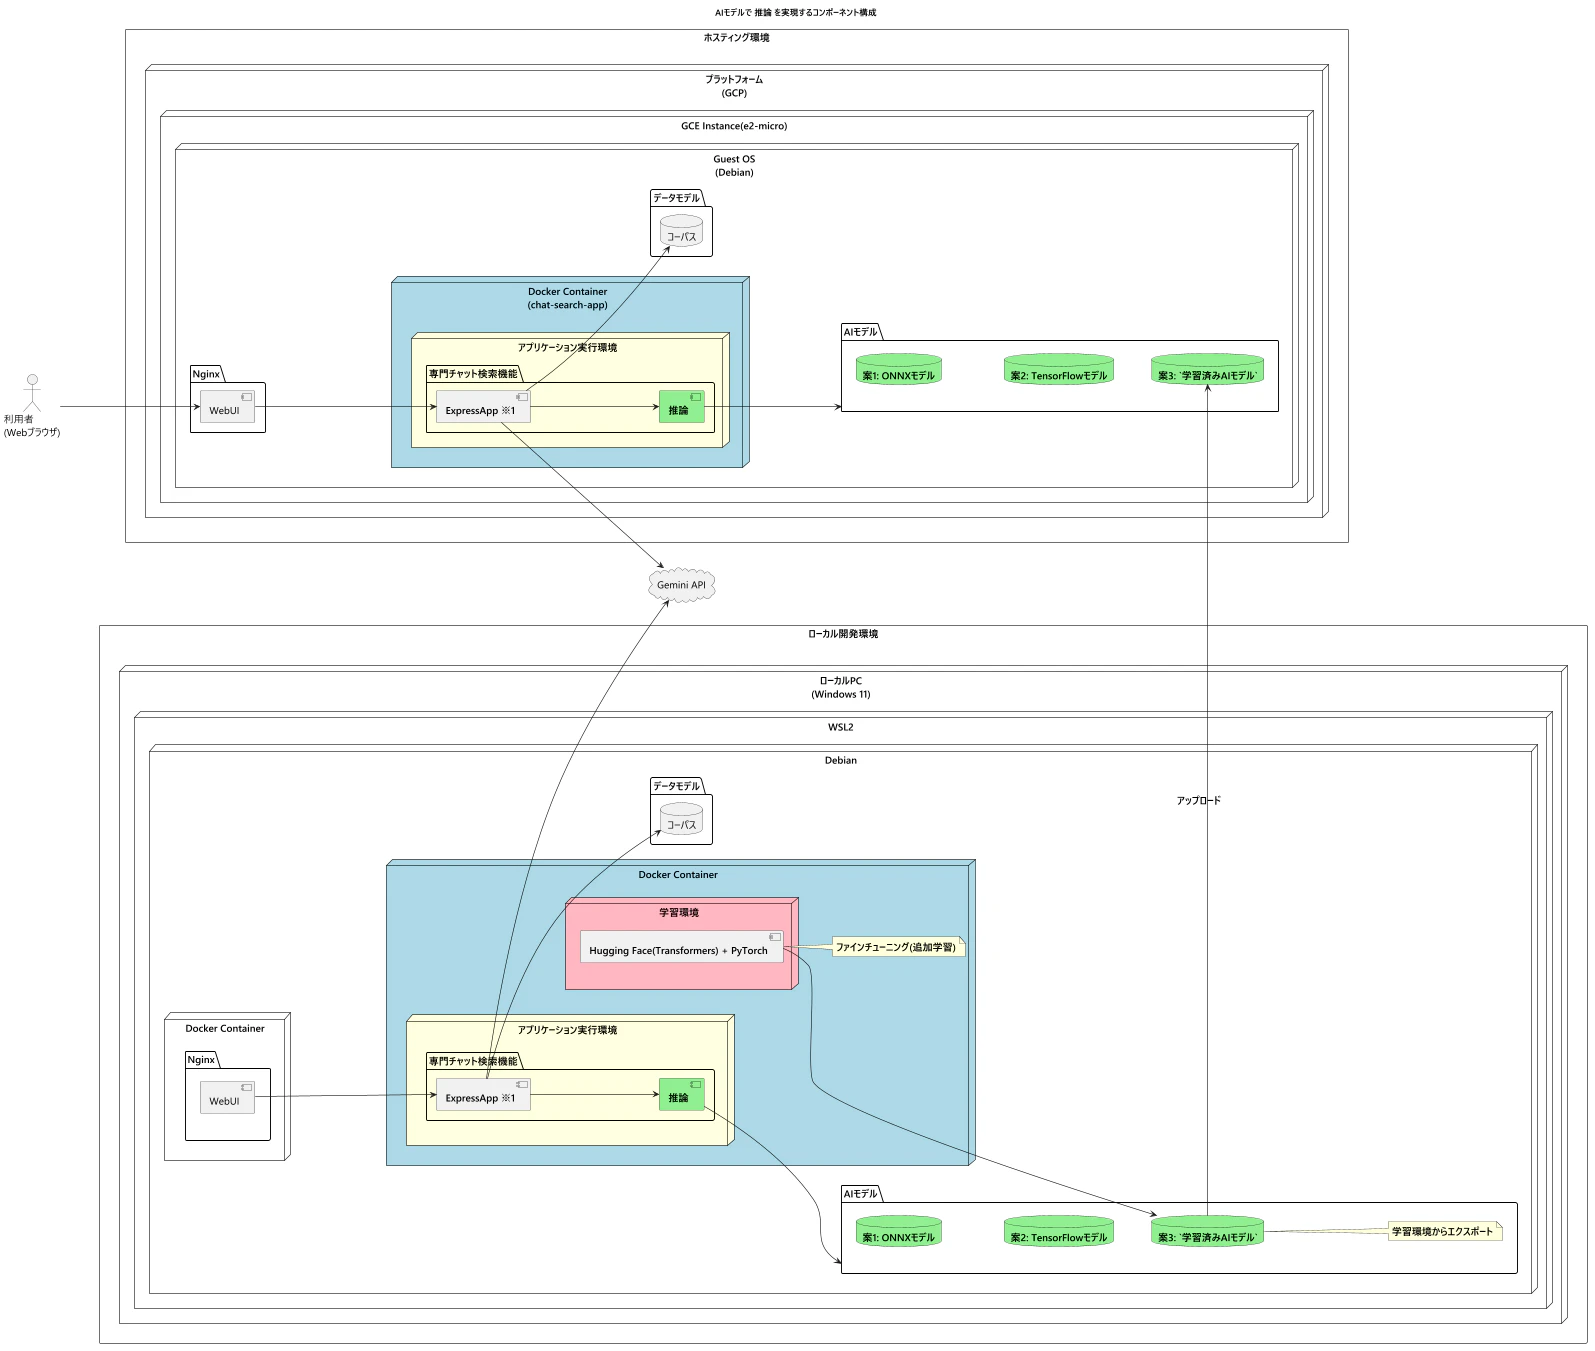
※1.ExpressApp とは Node.js + Express 上で動く本機能の Webアプリケーション 部分を指します。
案1: ONNXモデル
ONNXモデル とは何か
日本語を含む多言語テキストエンベディングモデルmultilingual-e5-small を
Node.js 上で実行できるようにONNXという共通形式で 変換・出力 したAIモデルです。
テキストエンベディングモデルとは、文章をベクトル値に変換するAIモデルを指します。
検討内容
| 検討項目 | 調査結果 |
|---|---|
| 日本語対応 | 可能。 |
| 多言語対応 | 可能。 |
エンベディング |
可能。 |
出力次元数
|
384次元。 |
| 公開している量子化モデル | model_quantized.onnx。 |
| 公開している非量子化モデル | model.onnx。 |
| ローカル実行 |
onnxruntime-node と @xenova/transformers などの 推論ライブラリ を組み合わせることにより可能。 |
| Python環境 | 不要。 |
| e2-micro(1 GBメモリ + Swap領域 4 GB)対応 | 可能。 |
次元数とは出力されるベクトル値の個数です。
384次元は384個の数値になります。
案2: TensorFlowモデル
TensorFlowモデル とは何か
Google が開発した 日本語 を含む多言語テキストエンベディングモデル Multilingual Universal Sentence Encoder を
Node.js 上で実行できるよう TensorFlow.js形式(TF.js形式) で 変換・出力 したAIモデルです。
検討内容
| 検討項目 | 調査結果 |
|---|---|
| 日本語対応 | 可能。 |
| 多言語対応 | 可能。 |
エンベディング |
可能。 |
| 出力次元数 | 512次元。 |
| 公開している量子化モデル | 未配布。 |
| 公開している非量子化モデル | model.json + 重みバイナリファイル一式。 |
| ローカル実行 |
@tensorflow/tfjs-node により可能。※2また、前処理として多言語トークナイズの自前実装が必要。 |
| Python環境 | 量子化モデルを 変換・出力 する場合は必要。 |
| e2-micro(1 GBメモリ + Swap領域 4 GB)対応 | 困難。 ライブラリ自体のメモリ消費が大きく デフォルトで 量子化モデル がないため OOMリスク ※3 が高い。 |
※2.
非量子化モデルのローカル配備を含め
@tensorflow/tfjs-node でTensorFlowモデルを実行できるか確認できていません。
※3.
OOMとは Out Of Memory を指します。
案3: 学習済みAIモデル
学習済みAIモデル とは何か
ローカル開発環境に Python + Hugging Face (Transformers) + PyTorch などで学習環境を構築します。
公開されているAIモデル(multilingual-e5-small など) をダウンロードして ベースモデル とします。
学習環境上で、ダウンロードした ベースモデル に学習データを与え ファインチューニング(追加学習) します。
その後 Node.js 上で実行できるようにONNX形式などに 変換 して エクスポート したAIモデルです。
検討内容
| 検討項目 | 調査結果 |
|---|---|
| 日本語対応 | ベースモデル に依存。 |
| 多言語対応 | ベースモデル に依存。 |
エンベディング |
可能。 |
| 出力次元数 | ベースモデル に依存。 ベースモデル を multilingual-e5-small にした場合は384次元。 |
| 公開している量子化モデル | なし。 学習環境上で ベースモデル を ファインチューニング(追加学習) して ONNXモデル(量子化) としてエクスポートする。 |
| 公開している非量子化モデル | なし。 学習環境上で ベースモデル を ファインチューニング(追加学習) して ONNXモデル(非量子化) としてエクスポートする。 |
| ローカル実行 |
学習済みAIモデル を ONNX形式 でエクスポートしてonnxruntime-node と @xenova/transformers などの 推論ライブラリ を組み合わせることにより可能。 |
| Python環境 |
ファインチューニング(追加学習) と エクスポート の実現をするため ローカル開発環境に Python + Hugging Face (Transformers) + PyTorch などで 学習環境 を構築することが必要。 |
| e2-micro(1 GBメモリ + Swap領域 4 GB)対応 | 可能。 |
エンベディング APIで 推論 を実現する方法
エンベディング API とは何か
推論を提供する Web API サービス です。
つまり ローカル開発環境 や ホスティング環境 に推論を実装する必要がありません。
代表的なサービスとしては、Google が提供するGemini Embeddings APIや、OpenAIが提供するOpenAI Embeddings APIなどがあります。
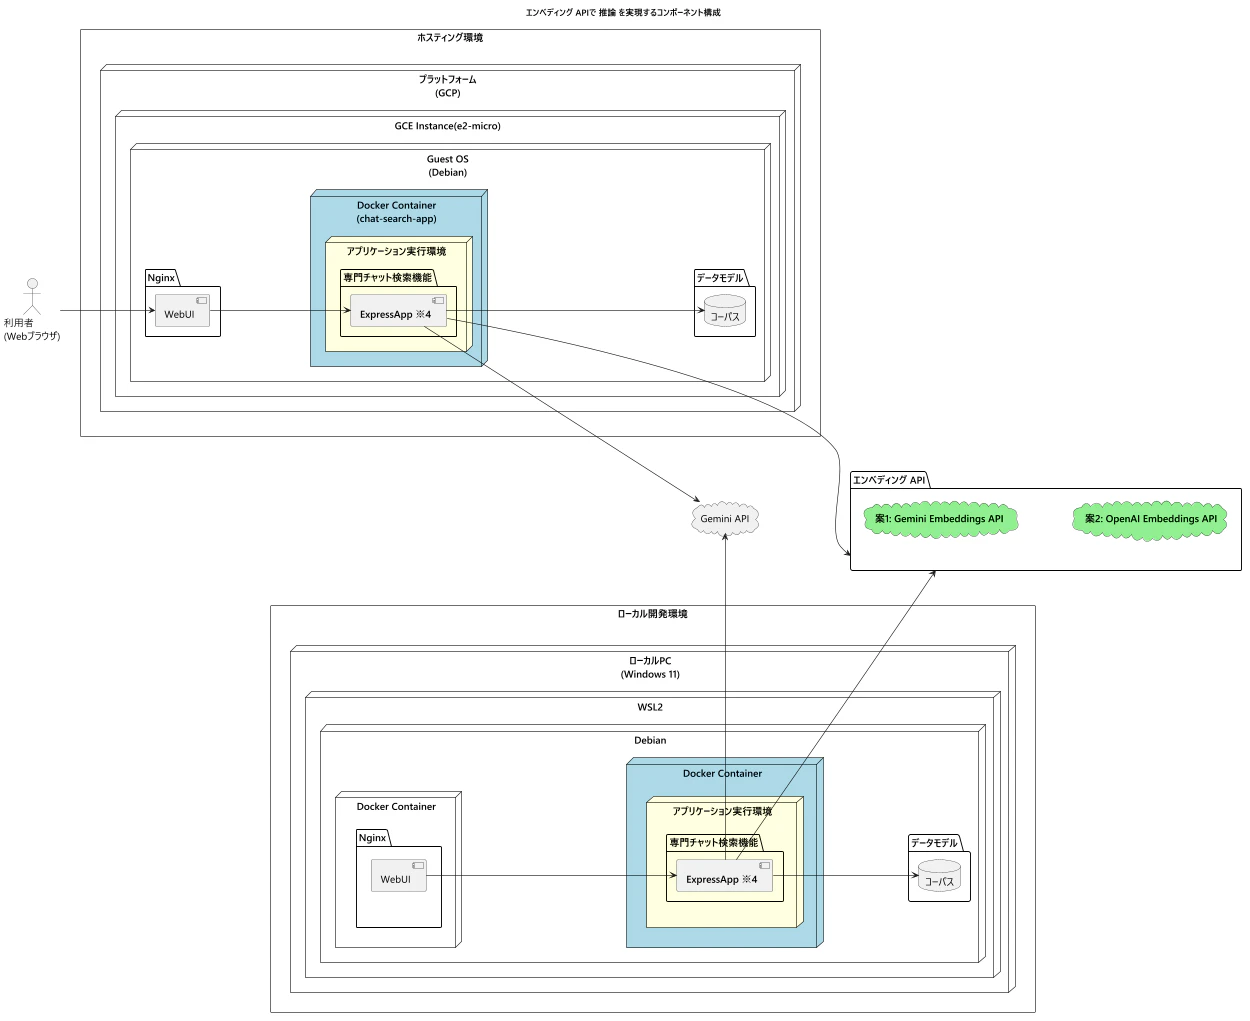
※4.ExpressApp とは Node.js + Express 上で動く本機能の Webアプリケーション 部分を指します。
案1: Gemini Embeddings API
Gemini Embeddings API とは何か
Gemini Embeddings APIは、Google が提供する エンベディング API です。
ベクトル検索 を例に本機能におけるGemini Embeddings APIの使い方を説明します。
- 質問を
Gemini Embeddings APIへ送信。Gemini Embeddings APIで推論を実行して質問に対するベクトル値を返却。- 質問に対する
ベクトル値とコーパス内の各ベクトル値を比較し、意味の近さで検索する。
案2: OpenAI Embeddings API
OpenAI Embeddings API とは何か
OpenAI Embeddings APIは、OpenAI が提供する エンベディング API です。
使い方はGemini Embeddings APIと同じです。
検討内容
検討内容としては Gemini Embeddings API と OpenAI Embeddings API のサービス内容を比較しました。
| 比較項目 | Gemini Embeddings API | OpenAI Embeddings API |
|---|---|---|
| 提供元 | OpenAI | |
| モデル | gemini-embedding-001 | text-embedding-3-small |
| 日本語対応 | 可能。 | 可能。 |
| 多言語対応 | 可能。 | 可能。 |
| 最大入力トークン | 2,048 | 8192 |
| 出力次元数 | 既定3,072次元。 | 既定1,536次元 |
| 次元削減対応 (MRL) | 128〜3,072次元。 推奨は 768/1,536/3,072。 |
dimensions パラメータで1,536次元から短縮可能。 |
| 無料枠 | あり。 | なし。 従量課金。 |
| 料金(100万トークンあたり) | $0.15(有料枠) | $0.02 |
| タスク最適化機能 |
あり。 検索クエリ用 ドキュメント用 など。 |
なし。 |
| 公式 Node.js SDK | @google/genai | openai |
Gemini Embeddings API の無料枠
gemini-embedding-001 は Gemini API の無料枠でも利用できます。
無料枠には RPM(1分あたりのリクエスト数)、TPM(1分あたりの入力トークン数)、RPD(1日あたりのリクエスト数)などの
レート制限 はありますが 1分/100リクエスト といった具体的な制限値を、現時点で確認できませんでした。
また、レート制限を超えた場合は HTTP 429 がGemini Embeddings APIから返却されます。
推論 を実現するために選定した AIモデル
推論 は ONNXモデル をローカルに配備して実現します。
-
ONNXモデル- 選定理由
- 課金が発生しない。
- エンベディング API 側でネットワーク障害が発生した場合の対応が不要。
- ホスティング環境 で使用する プラットフォーム で問題なく使用できる。
- 選定理由
-
TensorFlowモデル- 除外理由
- 公開されている量子化モデルが無い。
- @tensorflow/tfjs-node を利用したローカル実行は確認と検証の必要がある。
- メモリ消費量が多い。
- これらの理由から除外しました。
- 除外理由
-
学習済みAIモデル- 除外理由
- 本機能に必要なものは
推論であって学習ではないため、除外しました。
- 本機能に必要なものは
- 除外理由
- エンベディング API
- 除外理由
-
Gemini Embeddings APIには無料枠があるとはいえ API課金 が発生する可能性がある。 - エンベディング API 側でネットワーク障害が発生した場合、本機能と通信できないリスクと、それに対応する必要がある。
- これらの理由から除外しました。
-
- 除外理由
なぜ 量子化モデル としたのか
ONNXモデル は以下の モデルファイル を提供しています。(量子化モデル/非量子化モデル)
| モデルファイル | ファイル名 | ファイルサイズ | 特徴 |
|---|---|---|---|
| 量子化モデル | model_quantized.onnx | 約118.3 MB | モデル内部に持つ数値パラメータを 8ビット の整数(INT8)に縮小します。 |
| 非量子化モデル | model.onnx | 約470.3 MB | モデル内部に持つ数値パラメータを 32ビット の浮動小数点数(FP32)で保持します。 |
本機能の ホスティング環境 で使用する プラットフォーム は (e2-micro 1 GBメモリ + Swap領域 4 GB) です。
この 最小構成の プラットフォーム に配備する ONNXモデル は 量子化モデル が候補となりますが
量子化モデルを選定しても問題がないことを確認するため、以下の観点で 量子化モデル と 非量子化モデル を 計測 しました。
計測に使用したプログラムは 専門チャット検索機能 から
カテゴリ: onnx、サジェスト: ONNX とは何か? で検索した結果に含まれるcliBenchmark.jsとなります。
ただし、cliBenchmark.jsの計測内容が簡易的であるため ホスティング環境 で実データを使用した計測を別途実施して記事にする予定です。
計測項目
| 計測値 | 内容 |
|---|---|
loadMs |
モデルのロード時間 |
indexMs |
全文書をエンベディングする時間 |
p95Ms |
検索全体の P95 |
rssMB |
RSS の増加量 |
bm25P5 |
BM25検索の Precision@5 |
vectorP5 |
ベクトル検索の Precision@5 |
rrfP5 |
RRF統合後の Precision@5 |
検索全体とは何か
BM25検索 + ベクトル検索 + RRF統合 にかかる処理時間を指します。
P95 とは何か
P95 は 95パーセンタイル の意味で
処理にかかった時間を小さい順に並べて、下から95%目(100回中なら95番目)に位置する値のことです。
言い換えると、「全体の95%のアクセスは、この時間以内に完了している」という境界線を表します。
平均値だけでは、一部の遅い処理が見えにくいため、レスポンスタイムを評価する際に利用します。RSS とは何か
RSS は Resident Set Size の略で、プロセスが物理メモリ上で使用しているメモリ量の目安です。
Precision@5 とは何か
Precision@5 は「検索結果 上位5件の中に正解文書が何件含まれていたか」を表します。
例えば「上位5件中、正解が2件」であれば
Precision@5 = 2 / 5 = 0.4 となります。
計測結果
| 項目 | 量子化 | 非量子化 | 比較 |
|---|---|---|---|
loadMs |
44638.1 | 174596.4 | 約74% 量子化モデルの方が処理時間を短縮。 |
indexMs |
85.2 | 144.3 | 約40% 量子化モデルの方が処理時間を短縮。 |
p95Ms |
7.4 | 15.9 | 約53% 量子化モデルの方が処理時間を短縮。 |
rssMB |
738.4 | 1192.7 | 約38% 量子化モデルの方がメモリ消費量が小さい。 |
bm25P5 |
0.4667 | 0.4667 | 量子化モデルによる精度劣化なし。 |
vectorP5 |
0.4667 | 0.4667 | 量子化モデルによる精度劣化なし。 |
rrfP5 |
0.4667 | 0.4667 | 量子化モデルによる精度劣化なし。 |
比較で算出した 削減率 の計算方法を、非量子化モデルのロード時間を例に以下に説明します。
短縮された割合(削減率) = ((非量子化モデルのロード時間 - 量子化モデルのロード時間) / 非量子化モデルのロード時間) × 100
この計測結果から、使用する ONNXモデル は 量子化モデル model_quantized.onnx を選定することにしました。
選定した技術スタック
以下のシーケンス図は ベクトル検索 から 推論 部分を抽出した図になります。
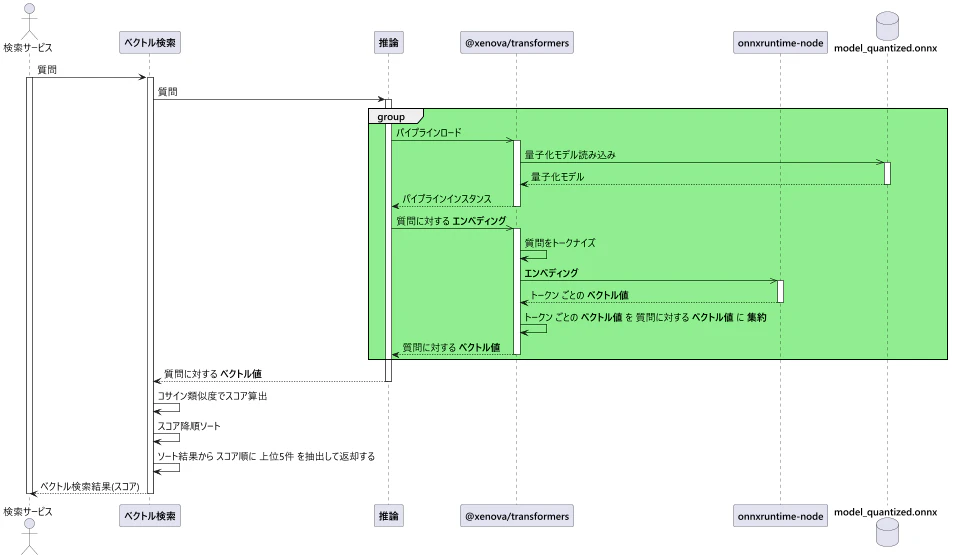
本機能では パイプラインロード ~ パイプラインインスタンス取得 までの処理をシングルトンクラスとしています。
シングルトンインスタンスを取得するタイミングは サーバー起動時の EagerLoad 処理 です。
| 技術スタック | 説明 |
|---|---|
| @xenova/transformers |
ONNXモデル で 推論 を実行するためのコントローラーです。 |
| onnxruntime-node |
ONNXモデル を Node.js 環境 からネイティブ実行する 推論エンジン です。 |
| model_quantized.onnx |
multilingual-e5-small を ONNX形式 に変換して量子化した AIモデル です。 |
それぞれの役割
-
初期処理: @xenova/transformers
- パイプラインロード。 (pipeline API)
- パイプラインインスタンスを取得します。
パイプラインインスタンス とは 前処理 ~ 後処理 までを パイプライン処理 するためのインスタンスです。(パイプライン処理)
- パイプラインインスタンスを取得します。
- パイプラインロード。 (pipeline API)
-
前処理: @xenova/transformers
- 質問を トークン化 します。
- 例: 質問が
猫と遊ぶの場合は["[CLS]", "猫", "と", "遊ぶ", "[SEP]"]のような トークン にします。
- 例: 質問が
- 質問を トークン化 します。
-
モデル実行: onnxruntime-node + model_quantized.onnx
-
onnxruntime-node + model_quantized.onnx
- トークン ごとの
ベクトル値を取得します。
- トークン ごとの
-
onnxruntime-node + model_quantized.onnx
-
後処理: @xenova/transformers
- トークン ごとの
ベクトル値を質問に対するベクトル値に集約します。
- トークン ごとの
Node.js で @xenova/transformers を使用する場合
推論エンジンは onnxruntime-node になります。
理由は、それが @xenova/transformers の仕様だからです。(Hugging Face)
ただし 現在の Transformers.js は公式 NPM パッケージ @huggingface/transformers へ移行しているため
公式の 現行ドキュメントを確認 してください。
用語解説
| 用語 | 役割と意味 |
|---|---|
| multilingual-e5-small | Microsoftが開発した 日本語 を含む 多言語テキストエンベディングモデル です。 |
| 学習 | データから AIモデル のパラメータを調整する処理です。 |
| ファインチューニング |
学習済みモデル を特定用途向けに追加学習することです。 |
Part2 の 用語解説 も参考にして下さい。
まとめ
Part4 では 最小構成の プラットフォーム で 推論 するために選定した技術スタックを説明しました。
Part5 では、外部知識である コーパス に対する検索方法を
課題一覧 の 課題No.3 外部知識に対する検索方法 と紐付けて説明する予定です。
おわりに
実務でもですが テスト仕様書 を書いていると バグ が見つかるように
Qiita に投稿する記事を書いていると同じことが起きます。
生成AIさんの話によると
これは 「他人に説明するために、自分のロジックを客観的に見直す」 ことにより
問題ないと思い込んでいた部分が 浮き彫り になるからだそうです。
全くその通りで、現時点の 浮いてきた課題 は
-
推論- 現在 @xenova/transformers 2.17.2 + onnxruntime-node 1.14.0 の組み合わせで
推論を実現している。 - しかし、@xenova/transformers は Hugging Face へ移管され、npmパッケージも @huggingface/transformers に変更された。
- よって @xenova/transformers から @huggingface/transformers へ移行すべき。
- 現在 @xenova/transformers 2.17.2 + onnxruntime-node 1.14.0 の組み合わせで
-
エンベディング API
- エンベディング API には API課金、ネットワーク障害対応 という デメリット があるが
推論の実装が不要という メリット がある。 - この メリット により
推論する上で重要な メモリやCPU の負荷を エンベディング API 側へ移せる。
- エンベディング API には API課金、ネットワーク障害対応 という デメリット があるが
など、イロイロあります。(笑)
これらの話は別途課題に紐付けて、移行方法や検証結果を記事として公開したいと考えています。